Мы используем куки, чтобы пользоваться сайтом
было удобно.

Думаю, вы знаете, что C++ — язык, который разрешает вам вообще всё. А потом молча смотрит, как вы на этом подрываетесь. Обычно мы привыкли мыслить категориями байтов, но что делать, если стандартная сетка типов кажется слишком расточительной? Когда внутренний перфекционист требует компактности, на помощь приходят битовые поля. Зачем отдавать под скромный флаг "да/нет" целый восьмибитный контейнер, если можно ювелирно отрезать ровно один бит? Поставил двоеточие — и ты повелитель памяти. Но там, где начинается экономия, заканчивается порядок и предсказуемость. Программист остается один на один с тонкостями стандартов и поведением конкретных платформ. Предлагаю вместе заглянуть под капот C++ и подробно разобрать, как на самом деле устроены битовые поля.
Как я докатилась до жизни такой и почему вообще решила поднять эту тему?
Продолжительное время я занималась поддержкой правил MISRA C++ 2023. Да-да, PVS-Studio учится проверять ваши кодовые базы на соответствие этому стандарту. Очередной задачей была поддержка одного из правил, регулирующих совместное использование перечислений и битовых полей. В голове всё выглядело элементарно: нужно было всего лишь проверить, умещаются ли значения enum с фиксированным базовым типом в выделенную ширину бит.
Знаете это обманчивое чувство, когда задача кажется приключением на пару часов, а в итоге утягивает вас в пучину бесконечных разбирательств на неделю? Именно это и произошло со мной. Я сильно зависла над поддержкой этого правила.
Пытаясь распутать этот клубок, я поняла одну вещь: битовые поля в C++ — недооценённая тема, которую следует знать.
Битовое поле в C++ — это инструмент для плотной упаковки данных, который позволяет распределять память внутри структуры или класса не байтами, а отдельными битами. Если обычные типы всегда занимают минимум один байт, то здесь вы сами решаете, сколько битов выделить под конкретную переменную. Это незаменимо при жёстких ограничениях по памяти и при необходимости компактно хранить набор флагов.
Давайте посмотрим на синтаксис записи битовых полей. В зависимости от конкретных технических задач форма объявления может немного меняться, но общая базовая структура выглядит следующим образом:
type-specifier declarator : constant-expression ;Где constant-expression определяет количество битов, выделяемых под конкретное поле.
Конструкция битовых полей достаточно интересная. Мы используем двоеточие: это прямая директива компилятору отменить стандартные правила выделения памяти. В обычном C++ коде минимально адресуемым элементом является байт, который занимает CHAR_BIT бит. Макрос CHAR_BIT определяется имплементацией, но наиболее распространённым значением считается 8. Двоеточие разделяет логическое имя переменной и её фактический размер, принудительно заставляя компилятор "резать" память на микроскопические участки заданной длины.
Такая конструкция экономит память. Как? За счёт ликвидации так называемых "пустых" или "избыточных" битов. Когда происходит объявление обычных переменных, процессор из-за особенностей своей архитектуры округляет их размер вверх до целых байтов. Битовые поля обходят это ограничение через механизм упаковки в общий контейнер.
Чтобы понять, как битовые поля экономят место, сравним два способа хранения одних и тех же данных. Допустим, нам нужно записать три параметра системы:
Итого вся важная информация о состоянии объекта занимает ровно 6 бит.
Вариант 1. Обычная структура
Если мы создадим стандартную структуру на языке C++, компилятор выделит под каждый тип отдельный байт памяти, так как это минимально адресуемый размер:
struct StandardStruct
{
  bool is_active;
  char mode;
  char error_code;
};#include <iostream>
struct StandardStruct
{
bool is_active;
char mode;
char error_code;
};
int main()
{
StandardStruct stStruct;
std::cout << "Sizeof stStruct: " << sizeof(stStruct)
<< "byte(s)" << std::endl;
}Sizeof stStruct: 3 byte(s)Программа заняла 24 бита памяти. Для наших шести единиц информации было выделено 24 ячейки, оставшиеся 18 ячеек просто остаются пустыми, потому что архитектура процессора не умеет работать напрямую с кусками меньше одного байта.
Вариант 2. Структура с битовыми полями
Теперь добавим синтаксис двоеточия. Компилятор берет за основу один базовый тип (контейнер), например unsigned char размером 1 байт (8 бит), и начинает плотно упаковывать поля внутрь него:
struct BitFieldStruct
{
  unsigned char is_active  : 1;
  unsigned char mode       : 2;
  unsigned char error_code : 3;
};#include <iostream>
struct BitFieldStruct
{
unsigned char is_active : 1;
unsigned char mode : 2;
unsigned char error_code : 3;
};
int main()
{
BitFieldStruct stStruct;
std::cout << "Sizeof stStruct: " << sizeof(stStruct)
<< " byte(s)" << std::endl;
}Sizeof stStruct: 1 byte(s)В результате работы этого механизма вся структура сжимается до 1 байта. В памяти это выглядит как единый массив из 8 бит, поделённый на сектора:
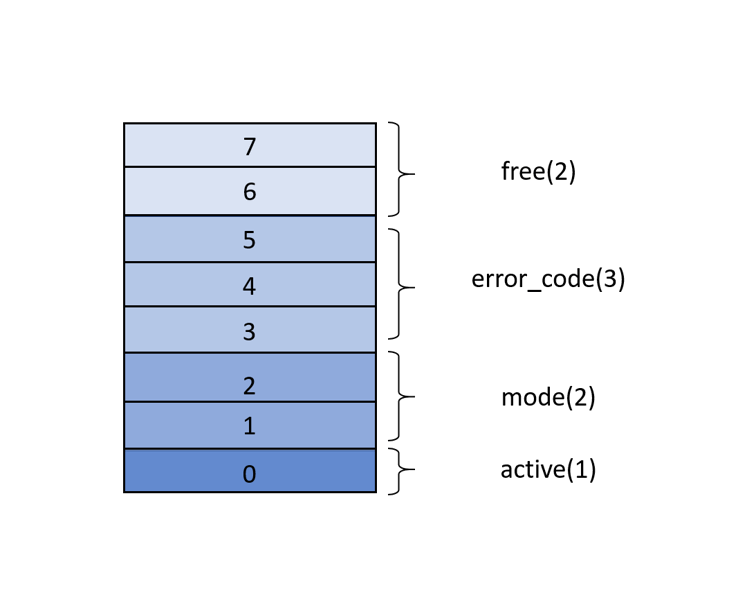
Компилятор берёт на себя всю работу: при чтении или записи переменной mode он автоматически генерирует скрытые побитовые сдвиги и маски, чтобы изолировать нужные 2 бита от остальных данных. В масштабах больших массивов или встроенных систем (микроконтроллеров) такая плотная упаковка позволяет в несколько раз сократить потребление оперативной памяти.
Мы уже вспомнили базовые принципы и синтаксис битовых полей, а теперь давайте погрузимся в особенности работы с ними и разберём правила, которые накладывает язык.
Битовые поля могут существовать исключительно внутри структур или классов. Нельзя объявить битовое поле в качестве переменной посреди функции. К объявлению конкретного битового поля нельзя применять квалификаторы const и/или volatile напрямую, только косвенно при объявлении объекта этой структуры/класса с квалификатором.
Второе, что следует рассмотреть — типы, которые можно использовать при работе с битовыми полями. Стандарт языка разрешает применять этот механизм только к интегральным типам (integral types) и перечислениям (enumerations). Попытка ограничить по битам типы с плавающей точкой (float, double) или сложные объекты (std::string) технически невозможна и приведёт к ошибке компиляции.
При объявлении битовых полей допускаются следующие типы:
1. Интегральные типы (char, wchar_t, char8_t, char16_t, char32_t, bool, short, int, long, long long).
Это стандартный набор для создания масок и флагов. До C++ 14 при использовании int было критически важно явно указывать модификаторы signed или unsigned, иначе интерпретация знакового бита оставалась на усмотрение компилятора. Например, однобитное поле int без явного unsigned может принимать значения 0 и -1 вместо ожидаемых 0 и 1. Для логического bool достаточно выделить ровно 1 бит.
2. Перечисления (enum и enum class).
Механизм подходит для хранения перечисляемых типов с небольшим набором значений. Если enum содержит четыре возможных состояния, под него достаточно выделить 2 бита.
3. std::byte (C++20).
Начиная со стандарта C++ 20, список разрешённых типов официально пополнил std::byte. Если структура предназначена для работы с сырыми данными на аппаратном уровне, использование std::byte явно показывает намерения разработчика и исключает случайные арифметические ошибки.
Третье, что важно рассмотреть, это правила работы. При работе с битовыми полями в C++ существуют четыре главных правила, согласно которым вы не можете:
Давайте разберём на примерах, почему этот механизм живёт по таким законам и к чему приведут попытки их обойти. Для примера возьмём простую структуру:
struct HardwareFlags
{
  unsigned int mode   : 3;
  unsigned int status : 1;
};В основе запрета на взятие адреса и создание указателей лежит фундаментальная особенность компьютерной архитектуры: у отдельного битового поля нет собственного физического адреса в памяти. Архитектура современных процессоров устроена так, что минимальная ячейка памяти, которую компьютер может найти и прочитать по конкретному адресу, это один байт (CHAR_BIT бит). У процессора просто нет технической возможности сослаться на условный 3-й бит внутри байта.
По этой причине мы не можем использовать оператор взятия адреса & к битовому полю:
HardwareFlags flags;
auto address = &flags.mode;
int* ptr = &flags.mode;     // doesn't compile
Поскольку у отдельных битовых сегментов нет индивидуальных адресов в ячейке памяти, получить прямой указатель на такую переменную физически невозможно.
Из невозможности взять адрес логически вытекает следующее ограничение: нельзя создать стандартную ссылку & на битовое поле. Ссылка в языке всегда опирается на указатели и адресацию, а раз нет адреса, то и привязать её не к чему:
HardwareFlags flags;
void checkMode(const unsigned int& m);

unsigned int& ref = flags.mode;        // doesn't compile
checkMode(flags.mode); // doesn't compileОгорчу вас: создать массив из битовых полей тоже не получится. Причина кроется в адресной арифметике. Когда вы создаёте массив, компилятор гарантирует, что его элементы лежат в памяти строго друг за другом. При индексации i-го элемента arr[i] происходит вычисление адреса этого элемента через адресную арифметику относительно начала массива.
struct BrokenStruct
{
  unsigned int items[5] : 2; // doesn't compile
};Несмотря на то, что битовые поля созданы для экономии памяти, их расположение в структурах не зафиксировано в языке. У разработчиков компиляторов есть свобода в том, как именно упаковывать биты, поэтому реальный размер структуры всегда зависит от целевой платформы. Такая гибкость впечатляет, но, чтобы понять её причины, заглянем в стандарт:
Allocation of bit-fields within a class object is implementation-defined. Alignment of bit-fields is implementation-defined. Bit-fields are packed into some addressable allocation unit.
[Note 1: Bit-fields straddle allocation units on some machines and not on others. Bit-fields are assigned right-to-left on some machines, left-to-right on others. — end note]
На практике это означает, что правила размещения диктуются не самим языком, а бинарным интерфейсом приложения (Application Binary Interface, ABI) конкретной операционной системы. Например, во многих Unix-подобных системах используется Itanium ABI, но даже он не определяет порядок расположения битов до конца. В зависимости от операционной системы и архитектуры логика упаковки меняется. Например, компилятор MSVC под Windows и GCC под Linux могут скомпилировать одну и ту же структуру по-разному.
В этом разделе мы разберём особенности работы именно с битовыми полями. Тему выравнивания я затрону лишь вскользь — ей уже посвящён отдельный цикл материалов: первая часть про базовые принципы; вторая и третья о том, как на выравнивание влияют наследование и виртуальность.
Фраза "Bit-fields are packed into some addressable allocation unit" описывает так называемую концепцию единицы выделения памяти (allocation unit). Согласно стандарту C++, единица выделения памяти — это адресуемый блок аппаратной памяти, например байт или машинное слово, в котором последовательно упакованы битовые поля. Точное поведение этой единицы определяются реализацией и в значительной степени зависит от ABI платформы.
Компилятор никогда не выделяет память под отдельные биты "из воздуха". Вместо этого он берёт за основу базовый тип, который вы указали при объявления поля, и на его основе выбирает размер физического контейнера. Например, если вы написали unsigned char, то аллокационным блоком станет 1 байт (8 бит). Если выбрали unsigned int, блок займёт 4 байта (32 бита). Компилятор берёт этот физический контейнер целиком и начинает последовательно, бит за битом, "нарезать" его на указанные логические сегменты, пока в нём не останется свободного места. Как только место заканчивается, компилятор выделяет под следующие поля новую единицу памяти.
Рассмотрим процесс упаковки данных компилятором:
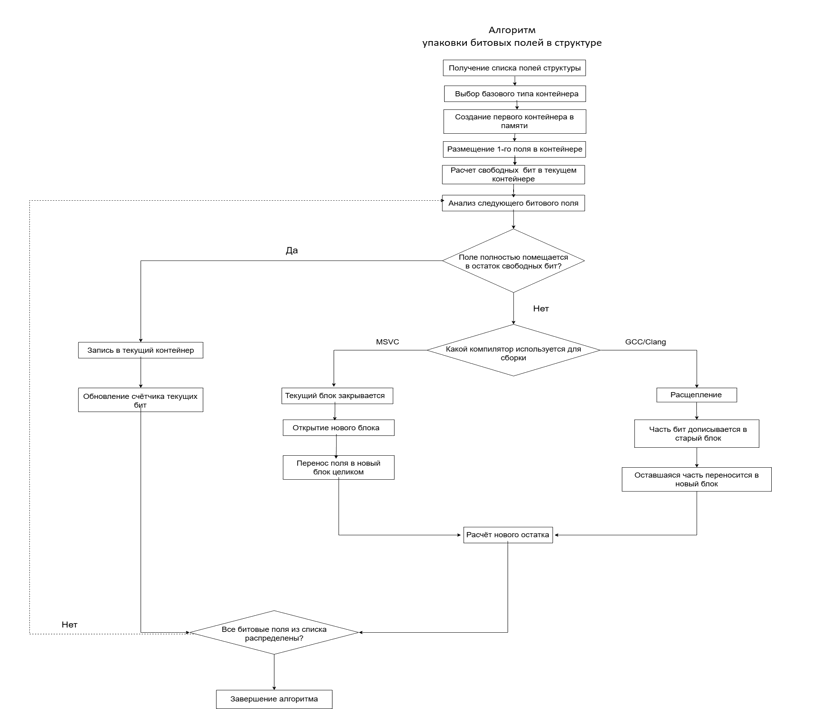
Примечание. Сторона заполнения контейнера (младшие или старшие биты) определяется правилами ABI конкретной архитектуры.
Зачем вообще мы так детально разбираем пошаговый алгоритм работы компилятора? Дело в том, что без понимания этой внутренней кухни битовые поля превращаются в мину замедленного действия. При написании кода расчёт идёт на экономию места, а в итоге на выходе получается структура, которая весит в разы больше обычной. Если битовые поля объявлены хаотично, включается эффект так называемого "раздувания" памяти (sizeof bloat). Компилятор теряет возможность плотно упаковывать данные и начинает добавлять пустые байты.
Обычно к такой скрытой утечке памяти приводят две классические ошибки разработчика:
char, затем int, а потом снова char). При этом "винегрет" критичен только для Windows (Microsoft ABI), где компилятор принудительно открывает новый блок при каждой смене типа, создавая неиспользованные паддинги. GCC и Clang Linux/macOS лишены этого недостатка: они игнорируют смену типов и упаковывают данные непрерывно, минимизируя выравнивающие байты.Чтобы наглядно увидеть масштаб проблемы, давайте сравним два противоположных сценария: как делать категорически нельзя и как делать грамотно.
Пример N1. Неоптимальное расположение (плохое выравнивание)
Представьте структуру, где мы решили сэкономить и перемешали типы. Для примера возьмём компилятор MSVC на платформе Windows:
struct BadPacking
{
  unsigned char a : 4;
  unsigned int b  : 3;
  unsigned char c : 4;
};
Элементы в структуре будут располагаться следующим образом:
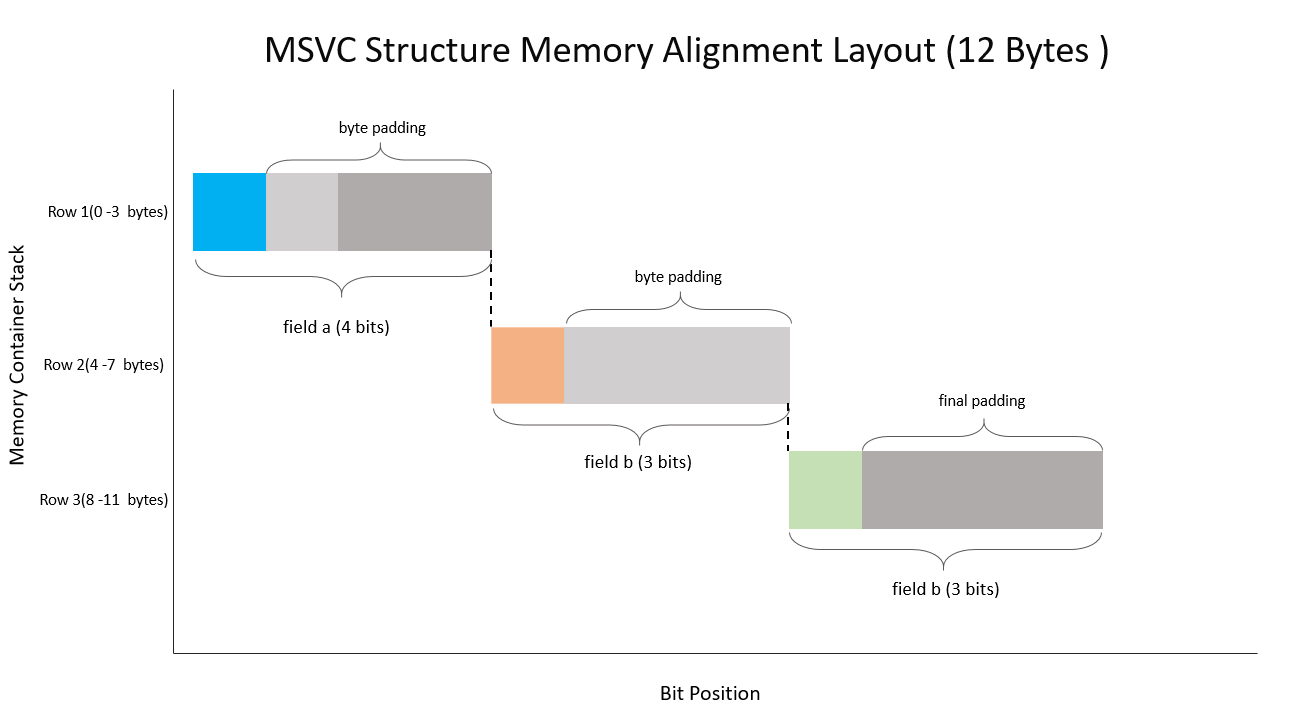
Из-за постоянных прыжков между типами (char > int > char) полностью ломается логика сквозной упаковки. Компилятор MSVC воспринимает смену типа как команду закрыть текущий контейнер (allocation unit). Он прерывает заполнение байта после поля a, забивает остаток паддингом и выравнивает адрес под следующий блок. Затем он открывает 4-байтовый контейнер int для 3-х бит поля b и сразу закрывает его, чтобы открыть блок для типа char. По итогу остаются огромные пустоты. Также компилятор не забывает про правила выравнивания. Чтобы им соответствовать, он выполнит финальное выравнивание всей структуры. В результате sizeof(BadPacking) вернёт 12 байт. В то же время Clang и GCC к такой структуре готовы: они умеют располагать подобные поля максимально компактно.
Пример N2. Оптимизированное расположение (хорошее выравнивание)
Чтобы исправить ситуацию, достаточно соблюсти золотое правило: привести все поля к единому базовому типу и сгруппировать их по смыслу.
struct GoodPacking {
    unsigned int b : 3;
    unsigned int a : 4;
    unsigned int c : 4;
};
Посмотрим, как сейчас будут располагаться элементы в структуре:
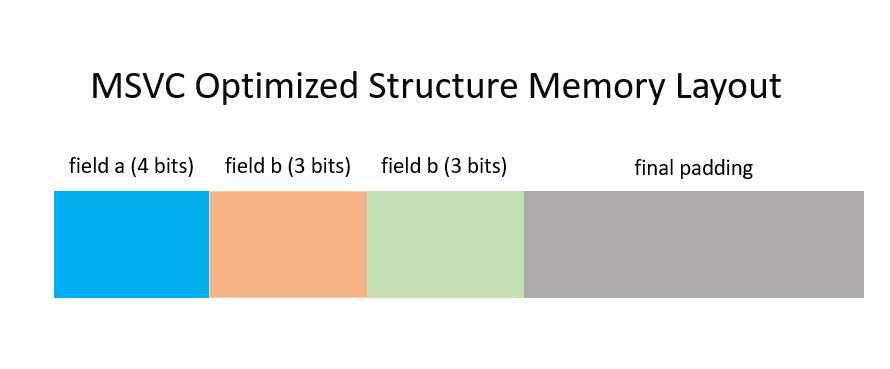
Теперь компилятор оперирует предсказуемыми, одинаковыми блоками по 4 байта. Поле b занимает почти весь первый блок, а поля a и c суммарно требуют всего 8 бит и идеально укладываются вместе во второй блок int. Итоговый размер sizeof(GoodPacking) составит всего 8 байт (ровно два контейнера int). Данные упакованы максимально плотно, процессор читает их без лишних усилий, а мы получили компактную структуру.
При написании драйверов, сетевых протоколов или работе с регистрами процессора часто возникает ситуация, когда реальный железный контроллер имеет дыры в своей битовой структуре. Например, некоторые биты в аппаратном байте зарезервированы производителем чипа на будущее, и отправлять туда свои данные или читать их оттуда нельзя.
Чтобы точно повторить физическую структуру регистра в коде, используют безымянные поля ненулевой длины, выполняющие роль отступов или паддингов:
struct TestController
{
  unsigned char transmit_ready : 1;
  unsigned char                : 3;
  unsigned char receive_ready  : 1;
  unsigned char                : 3;
};
У таких полей нет имени, к ним невозможно обратиться из программы для чтения или записи, однако они физически удерживают за собой место в памяти при генерации структуры. Это позволяет идеально, бит в бит, сопоставить программную структуру C++ с физическими ячейками микроконтроллера, не сдвигая полезные флаги.
Возникают ситуации (аппаратный интерфейс), когда нужно намеренно запретить компилятору упаковывать поля в текущем контейнере. Например, нужно, чтобы следующая порция данных гарантированно началась с нового байта или машинного слова. Для этого используется безымянное битовое поле нулевой длины:
struct Test
{
  unsigned char command : 4;
  unsigned char         : 0;
  unsigned char data    : 4;
};
Поле нулевой ширины служит искусственной границей. Оно сообщает компилятору, что текущая единица выделения памяти закрыта. Следующий за ним элемент ни при каких обстоятельствах не должен разделять оставшиеся биты, даже если там осталось полно свободного места. Одна из важных особенностей при работе с такими полями в том, что полю нулевой длины нельзя давать имя: оно обязано быть безымянным.
Теперь интересно заглянуть под капот и посмотреть, что же там. Внутреннее устройство битовых полей в языке C++ — это зона поведения, определяемого реализацией (implementation-defined behavior). Стандарт C++ абстрагируется от физического слоя, задавая лишь верхнеуровневые правила, а вся черновая работа делегируется связке "компилятор + ABI". Чтобы лучше понимать, как данные физически ложатся в оперативной памяти, необходимо детально разобрать три фундаментальных фактора: порядок размещения бит, архитектурные различия компиляторов и проблему бинарной переносимости.
Первый и ключевой фактор, определяющий физический вид структуры в памяти, — это порядок размещения бит внутри выделенного контейнера. Большинство разработчиков знают, что такое порядок байт. Он показывает, как многобайтовые числа раскладываются по адресам оперативной памяти. Однако на микроуровне существует аналогичная концепция: компилятор сам решает, в каком направлении упаковывать отдельные биты внутри одного конкретного байта или машинного слова. Стандарт C++ намеренно игнорирует этот нюанс, поэтому логика заполнения контейнера целиком зависит от создателей компилятора. На практике применяются два противоположных математических подхода: упаковка от младшего бита к старшему (LSB-first, Little Endian) или от старшего к младшему (MSB-first, Big Endian).
При использовании схемы LSB-first (Least Significant Bit-first) компилятор осуществляет заполнение выделенной ячейки справа налево. Это означает, что упаковка начинается с нулевого, самого младшего бита. Первое объявленное в структуре битовое поле занимает крайние правые разряды, а каждое следующее поле укладывается вплотную к нему, смещаясь влево в сторону увеличения двоичного веса разрядов. Такой подход стандартен для компиляторов GCC, Clang, MSVC при сборке кода под архитектуры x86, x86-64, ARM и т. д.
Противоположная стратегия — MSB-first (Most Significant Bit-first). Тут компилятор упаковывает биты слева направо. Заполнение ячеек начинается с самого верхнего доступного разряда, например, с седьмого бита для однобайтового контейнера. Первое поле структуры занимает высшие разряды на левом краю ячейки, а последующие переменные последовательно вытесняются вниз в сторону младших битов. Такое встречается в компиляторах для сетевых процессоров.
Давайте посмотрим, как это работает на практике. Напишем вот такую структуру:
struct HeaderFlags
{
  uint8_t version : 3;
  uint8_t type    : 2;
  uint8_t id      : 3;
};#include <cstdint>
#include <cstring>
#include <iostream>
struct HeaderFlags
{
uint8_t version : 3;
uint8_t type : 2;
uint8_t id : 3;
};
uint8_t result_byte = 0;
int main()
{
HeaderFlags flags;
flags.version = 1;
flags.type = 2;
flags.id = 4;
std::memcpy(&result_byte, &flags, sizeof(HeaderFlags));
return 0;
}Мы создали структуру HeaderFlags, которая суммарно занимает ровно 1 байт, и заполняем её поля тремя значениями. Чтобы безопасно вытащить упакованный байт наружу и не нарушить правила работы с памятью, используем функцию std::memcpy. Результат копируем в глобальную переменную result_byte.
Теперь посмотрим, как код ведёт себя на разных компиляторах. Чтобы не читать много лишнего ассемблерного кода, применим оптимизацию -O2.
Результат работы компилятора GCC x86-64:
        .globl std::ios_base_library_init()
"main":
        mov     BYTE PTR "result_byte"[rip], -111 ; <=
        xor     eax, eax
        ret
"result_byte":
        .zero   1
В инструкции mov мы получили отрицательное число -111, которое появляется из-за знакового отображения однобайтовых констант в ассемблере x86-64. Если перевести его в привычный беззнаковый формат, мы получим 256 - 111 = 145, что в шестнадцатеричной системе счисления равняется 0x89 (в двоичной — 0b1001'0001). Компилятор полностью вырезал промежуточный код упаковки и сразу записал готовый результат в память. Так как целевая ячейка имеет размер 4 байта, число 0x00000089 разместилось в памяти как последовательность 89 00 00 00. То, что младший байт 89 оказался на первом, наименьшем адресе, подтверждает работу схемы LSB-first (Little Endian).
Если же переключить компилятор на архитектуру MIPS Big-Endian (например, mips-linux-gcc версии 16.1.0), мы увидим совершенно другую картину. Ассемблерный код для этой платформы выглядит следующим образом:
        .globl std::ios_base_library_init()
main:
        lui     $2,%hi(result_byte)
        li      $3,52                 # 0x34
        sb      $3,%lo(result_byte)($2)
        jr      $31
        move    $2,$0

result_byte:
        .space  1
Здесь инструкция li $3, 52 загружает готовую константу 52, что в шестнадцатеричной системе равняется 0x34 (двоичное 0b0011'0100). Компилятор применил стратегию MSB-first и упаковал биты слева направо: поле version ушло в старшие биты 7–5, type заняло позиции 4–3, а id приземлилось в младшие биты 2–0. Схематично порядок размещения бит можно представить так:
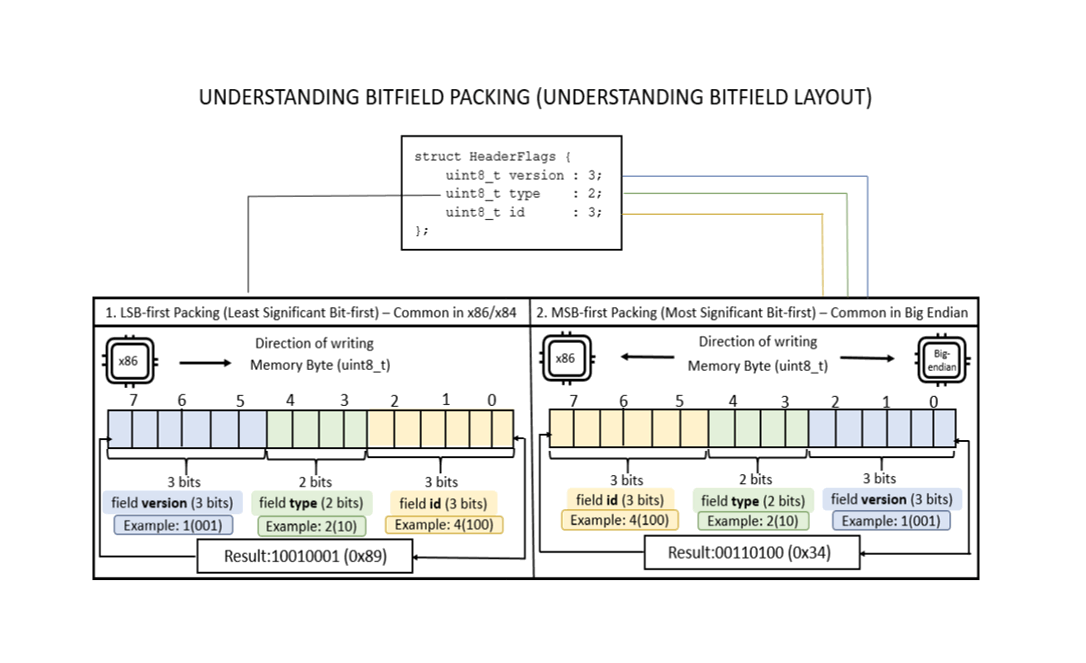
Этот пример доказывает, что физическое представление данных при смене Bit-endianness меняется настолько сильно, что прямая передача сырых байт между системами с разной логикой упаковки полностью разрушает структуру информации. Понимание этого механизма подводит нас ко второму важному фактору: архитектурным различиям компиляторов и роли ABI.
Принято считать, что в рамках одной аппаратной архитектуры поведение базовых типов данных C++ строго детерминировано. Однако в случае с битовыми полями это правило имеет важные нюансы: право на их размещение в памяти остается за компилятором. Если вы скомпилируете одну и ту же структуру под процессор x86-64 на Windows и на Linux, расположение данных в оперативной памяти будет принципиально разным. Физическая укладка битовых полей подчиняется правилам ABI. Напомню, что это официальный стандарт операционной системы, который диктует компилятору, как именно сгруппировать, выровнять и нарезать данные.
Существует множество стандартов ABI, которые по-разному реализуют упаковку данных. Вот некоторые наиболее популярные:
Различия между этими документами сводятся к одному правилу.
Правило. Совместимость разных типов данных
Разработчик имеет право объявить в структуре битовые поля с разными базовыми типами подряд. Подобное смешивание типов — одна из главных причин скрытого "раздувания" памяти, так как компиляторы обрабатывают границы разнородных контейнеров по совершенно разным алгоритмам.
Давайте попробуем сделать такой конфликт. Проведём эксперимент при помощи Compiler Explorer и измерим размер структуры с помощью оператора sizeof. Напишем вот такую структуру;
struct PackagingConflict
{
  uint8_t  mode : 4;
  uint32_t type : 4;
};#include <iostream>
#include <cstdint>
struct PackagingConflict {
uint8_t mode : 4;
uint32_t type : 4;
};
int main() {
std::cout << "--- BITFIELD PACKING SIZES ---" << std::endl;
std::cout << "1. PackagingConflict size: " << sizeof(PackagingConflict)
<< " byte(s)" << std::endl;
return 0;
}Посмотрим вывод программ на компиляторах Clang и MSVC:
--- BITFIELD PACKING SIZES ---
1. PackagingConflict size: 4 byte(s)--- BITFIELD PACKING SIZES ---
1. PackagingConflict size: 8 byte(s)Давайте посмотрим на визуальное расположение элементов памяти:
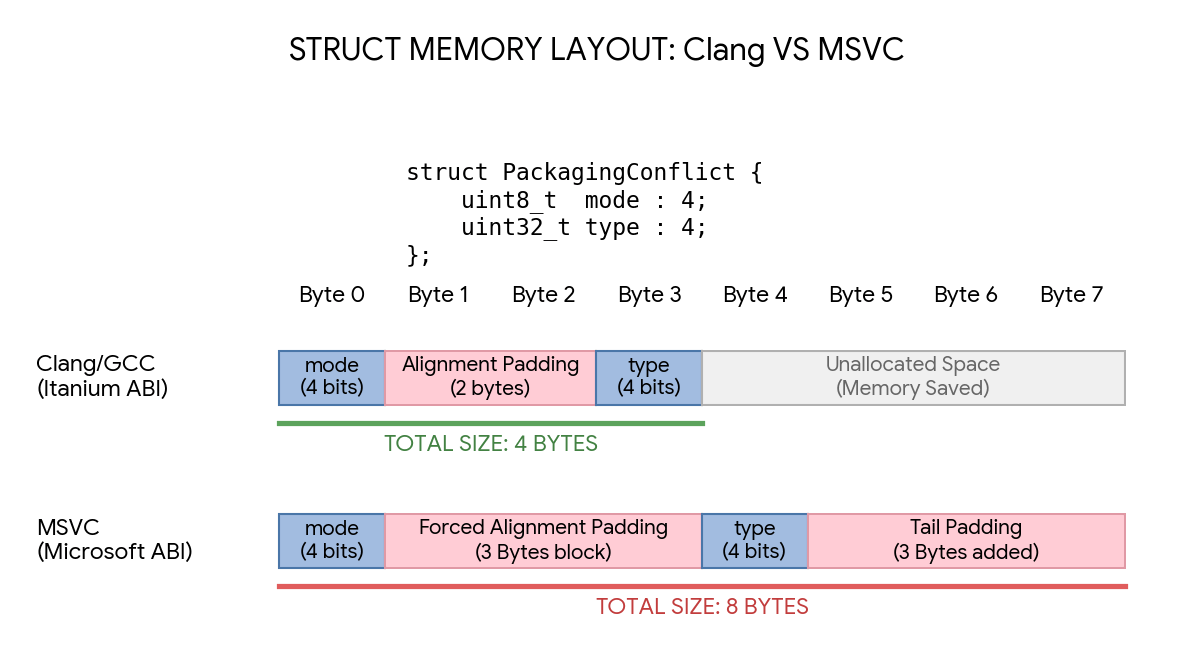
При анализе этой структуры мы сталкиваемся со следующей ситуацией: Clang упаковал её в 4 байта, тогда как MSVC раздул до 8 байт. Так как базовые типы полей отличаются (uint8_t и uint32_t), оба компилятора изначально изолируют их друг от друга, выделяя под mode 1 байт и добавляя 3 пустых байта паддинга, чтобы поле type началось со строго выровненной 4-байтовой границы. Однако дальше Clang применяет оптимизацию Itanium ABI и просто отрезает неиспользуемую часть второго контейнера ради экономии места. В свою очередь, MSVC строго подчиняется правилу Microsoft ABI, согласно которому итоговый размер структуры обязан быть кратен её самому тяжёлому типу (uint32_t, то есть 4 байта), и сохраняет полные 4 байта под оба блока, увеличивая финальный размер всей структуры вдвое.
Вся опасность этой ситуации кроется в том, что при переходе на платформы с разным ABI чёткие физические границы данных в памяти попросту стираются. Скрытые паддинги и разный подход компиляторов к неиспользованному пространству контейнеров полностью меняют внутреннее расположение полей. Это делает битовые поля непригодными для прямого побайтового копирования, записи в файлы или бинарной сериализации. Если структура сохранена по правилам 4-байтовой сборки Clang, а затем прочитана по 8-байтовому шаблону MSVC, чтение произойдёт с неверных смещений, и программа получит повреждённые данные.
Из-за хаоса с выравниванием и порядком бит структуры с битовыми полями обладают нулевой бинарной переносимостью. В компиляторах C++ они реализованы как чёрный ящик: вы пишите лаконичный код, но физический результат отдаёте воле случая.
Существуют три области, где применение битовых полей гарантировано приведёт к ошибкам:
1. Сетевой обмен (Network I/O). Прямая отправка структуры через сокет вида send(sock, &packet, sizeof(packet), 0) — мина замедленного действия. Если сервер работает на Linux (Clang), а клиент на Windows (MSVC), различия в ABI сместят координаты битов, и вместо валидных флагов вы получите кашу.
2. Файловый ввод-вывод (сериализация). Побайтовая запись структур с битовыми полями в файл, например, через fwrite, привязывает данные к конкретному ABI. Согласно стандарту ISO C (раздел 6.7.2.1), порядок размещения битовых полей и паддинга определяется компилятором (implementation-defined behavior). Если записать такую структуру в файл на Linux, а затем прочитать на Windows, программа прочитает из памяти смещённый мусор из-за разницы в правилах Microsoft ABI и System V ABI.
С точки зрения объектной модели C++, C++ 23 частично решает проблему жизненного цикла объектов (object lifetime) с помощью функции std::start_lifetime_as. Однако она лишь легализует создание объекта из сырых байт в памяти, но никак не исправляет разницу в физическом расположении полей между платформами. Кроме того, копирование неинициализированных паддингов структуры при записи в файл формально является чтением неопределённых значений (interminate values), что ведёт к undefined behavior.
3. Драйверы и железо (Hardware MMIO). Раскладка битов в регистрах микроконтроллера определяется аппаратурой и не меняется. В языке C порядок размещения битовых полей, их выравнивание и ширина доступа к памяти зависят от реализации, поэтому описание регистра через битовые поля не гарантирует, что каждое поле совпадёт с нужными битами. При смене компилятора, его версии или флагов сборки поля могут сместиться, и запись попадёт не в те биты регистра.
Для любых задач, где структура данных строго зафиксирована (сеть, файлы, регистры железа), от битовых полей полностью отказываются. Вместо них используют целочисленные типы фиксированного размера (uint8_t, uint16_t, uint32_t) в связке с явными побитовыми сдвигами (<<, >>) и логическими масками (&, |).
Таким образом, из-за различий в ABI компиляторов битовые поля сложно использовать для кроссплатформенного обмена данными в их стандартном виде без выравнивания вручную. Программа, собранная на Linux через GCC или Clang, сформирует структуру данных, которую Windows-приложение на MSVC просто не сможет прочитать, поскольку будет ожидать выравнивание и пустые биты (padding) в совершенно других местах.
В разработке битовые поля С++ используются не ради абстрактной экономии памяти, а для решения конкретных инженерных задач. Можно выделить два основных сценария, где этот инструмент приносит максимальную пользу.
1. Компактные метаданные для миллионов объектов. При проектировании игровых движков, кастомных аллокаторов памяти или баз данных часто требуется хранить техническую информацию (флаги состояния, ID типов, счетчик ссылок) для огромного количества мелких элементов. Если выделять под каждый флаг отдельную переменную, накладные расходы из-за выравнивания памяти компилятором будут огромные. Битовые поля позволяют "спрессовать" несколько независимых признаков в один единственный байт, сводя потребление памяти к минимуму.
2. Оптимизация работы кэша процессора (Cache Lines). Современные процессоры считывают данные из оперативной памяти не поштучно, а большими блоками — кэш-линиями (обычно по 64 байта). Если структура данных слишком раздута, в одну кэш-линию поместится мало полезных объектов, и процессору придётся постоянно простаивать в ожидании медленной RAM (произойдёт cache miss). Плотная упаковка данных с помощью битовых полей позволяет уместить в кэш процессора в несколько раз больше объектов. При их массовом последовательном обходе алгоритм работает в разы быстрее, так как данные берутся из сверхбыстрой кэш-памяти CPU.
Учитывая проблемы с переносимостью, платформозависимостью и ограничениями на взятие адреса, разработчики часто вынуждены искать замену классическим битовым полям. В современном C++ существуют три основные архитектурные альтернативы, каждая из которых решает свою специфическую задачу.
Если нужен стопроцентный контроль над физическим расположением каждого бита, то лучшим выбором будет классический подход, который пришёл из языка C. Вместо того, чтобы полагаться на автоматическую нарезку памяти компилятором, разработчик берёт целочисленный тип фиксированного размера и управляет битами вручную с помощью побитовых операторов (&, |, ~, ^, <<, >>).
Пример:
class DeviceConfig
{
public:
  void set_mode(uint8_t mode)
  {
    data = (data & ~MODE_MASK) | ((mode << 1) & MODE_MASK);
  }

  uint8_t get_mode() const
  {
    return (data & MODE_MASK) >> 1;
  }

private:
  static constexpr uint8_t ENABLE_CLOCK_MASK = 0x01;
  static constexpr uint8_t MODE_MASK         = 0x0E;
  static constexpr uint8_t INTERRUPT_MASK    = 0xF0;

private:
  uint8_t data = 0;
};
Да, этот код сложнее, но его бинарная структура становится полностью независимой от компилятора и ABI. Это делает такой подход правильным для написания сетевых протоколов и драйверов. Единственное, о чём все ещё нужно помнить разработчику, это порядок байт процессора (Byte Endiannes), так как на архитектурах Big Endian многобайтовые значения перевернутся относительно Little Endian.
Если экономия памяти на уровне отдельных структур не является задачей номер один, а на первый план выходит безопасность кода и удобство манипулирования логическими флагами, лучшим решением будет встроенный класс std::bitset.
Контейнер представляет собой фиксированный массив бит, размер которого задаётся на этапе компиляции как параметр шаблона. Он инкапсулирует всю побитовую математику внутри себя, предоставляя разработчику высокоуровневый и безопасный интерфейс.
Рассмотрим пример:
#include <bitset>
#include <iostream>

enum Permission
{
  Read = 0,
  Write = 1,
  Execute = 2,
  Admin = 3,
  MaxPermissions
};

void ManagePermissions()
{
  std::bitset<MaxPermissions> user_rights;
  user_rights.set(Permission::Read);
  user_rights.set(Permission::Write);
  user_rights.flip(Permission::Execute);

  if (user_rights.test(Permission::Write))
  {
    std::cout << "The user can write files.\n";
  }

  std::cout << "Current rights mask: " << user_rights << "\n";
}

int main()
{
  ManagePermissions();
}
Главный плюс std::bitset — это защита от человеческого фактора. Если передать в функцию-член std::bitset<N>::set, std::bitset<N>::reset, std::bitset<N>::flip или std::bitset<n>::test некорректный индекс (например, значение 15 при размере сетки в 4 бита), произойдёт выброс исключения std::out_of_range. При использовании масок такая ошибка привела бы к непредсказуемому чтению чужой памяти или порче соседних данных.
Единственный нюанс: std::bitset изнутри обычно округляет свой физический размер до базового машинного слова процессора, поэтому сэкономить память на микроуровне с его помощью нельзя.
Если необходимо динамически управлять огромным массивом логических флагов, стандартное использование массива bool приведёт к большой потере памяти, так как такой тип занимает целый байт. Для решения этой проблемы в стандартной библиотеке предусмотрена специальная версия — std::vector<bool>.
Этот контейнер устроен не так, как обычные векторы. На уровне стандартной библиотеки он оптимизирован по памяти. Его внутренняя реализация упаковывает элементы типа bool побитово в более крупные целочисленные типы (машинные слова), обычно сжимая по 32 или 64 логических значения в один блок памяти.
Рассмотрим пример работы с большим динамическим массивом:
#include <vector>

std::vector<bool> feature_flags(10000, false);

void process_features()
{
  feature_flags[42] = true;
  if (feature_flags[42])
  {
    // code
  }
}
Несмотря на внешнее удобство, std::vector<bool> — одна из самых спорных фич в стандарте C++, и её использование требует осторожности. Из-за плотной битовой упаковки элементы этого вектора не являются настоящими объектами типа bool в памяти. Как результат, вы не можете взять прямой адрес элемента (код bool *ptr = &feature_flags[0]; не скомпилируется) или передать элемент по ссылке/указателю. Оператор [] здесь возвращает не ссылку, а специальный временный прокси-объект, который имитирует поведение ссылки. Это — плата за сжатие данных в динамической памяти.
Что ж, на этом у меня всё. Что я могу сказать? Битовые поля в C++ — это идеальное воплощение философии языка. Вам дают абсолютную свободу отрезать ровно один бит, но оставляют один на один со скрытыми минами компиляторов и системных ABI. Теперь, когда вы заглянули под капот и знаете, как эта ювелирная экономия памяти уживается с платформозависимым хаосом, иллюзий не осталось. Этот инструмент может стать как мощным оружием для оптимизации кэш-линий и работы с железом, так и скрытой миной при первой же попытке передать структуру по сети. Вы предупреждены, правила низкоуровневой игры понятны, а как именно распоряжаться этой властью над памятью в своих проектах — выбор за вами.


0
0
0


0