Мы используем куки, чтобы пользоваться сайтом
было удобно.
Вебинар: Безопасная разработка и сертификация: практика, инструменты, перспективы - 03.12

Представляем обновлённое издание книги вредных советов для C++ программистов. Мы будем публиковать её в блоге по частям. Всего вас ждёт 60 советов.
В каждой части читателю будет представлен список "советов", которым на самом деле не стоит следовать. Каждый совет сопровождается разбором, чем он вреден, и рассмотрением неочевидных моментов. Материал будет полезен новичкам, изучающим программирование, и развлечёт опытных разработчиков неожиданными нюансами программирования на C++.
Первая версия книги появилась в 2023 году. По прошествии трёх лет захотелось выпустить обновлённый вариант. Были исправлены ошибки, некоторые главы расширились или были переписаны. Появились и новые темы, которые хочется затронуть, например безопасная разработка ПО (РБПО) или генерация кода с помощью ИИ.
Как появилась книга?
Изначально я задумал написать книгу о приёмах, помогающих в написании качественного кода. В ней хотелось рассмотреть такие темы, как оформление текста программ, на что стоит обращать внимание при обзоре кода, что из новых возможностей C++ стоит однозначно использовать, а что сомнительно. Но случайно меня увлекла другая тема, и я решил не сопротивляться потоку вдохновения.
История началась с шуточной публикации на сайте Хабр, где я сформулировал несколько вредных советов и предложил читателям продолжить этот список. Тема понравилась разработчикам, и они поделились массой своих идей о том, как можно создать ужасный код. Я взял часть советов, добавил свои и опубликовал в виде статьи. Там же я дал пояснение по некоторым советам, весь вред которых может быть непонятен новичкам. Так и зародилась тема, которая в итоге превратилась в эту книгу.
Мне понравилось писать о том, как не надо делать, а не о том, как делать правильно. Хотя бы просто для разнообразия. Мне скучно от написания правильных обучающих материалов, особенно по тематике РБПО. Иногда хочется чуть больше юмора и свободного потока мысли.
Дело в том, что я многие годы занимаюсь темой программных ошибок и пишу о том, как их избегать. Это связано с моим участием в разработке и продвижении статического анализатора кода PVS-Studio.
Статический анализатор выдаёт предупреждения на фрагменты кода, которые с большой вероятностью содержат ошибки или не соответствуют используемым стандартам кодирования. PVS-Studio — один из таких инструментов. Его маскот — единорог — ещё не раз промелькнёт в этой книге.
На примере открытых проектов я показываю, какие ошибки и потенциальные уязвимости могут быть выявлены с помощью этой методологии. Но, что ещё важнее, я стараюсь рассказывать, как написать код так, чтобы подобным ошибкам в нём не нашлось места. В общем, вновь и вновь пишу, как лучше оформить код, какой комментарий написать, говорю о пользе обзоров кода и так далее.
Поэтому я и решил развить идею вредных советов и написать книгу. Впрочем, кроме идеи от первоначального списка вредных советов мало что осталось: я убрал или заменил всё слишком очевидное и неинтересное, зато добавил много теоретического материала, который будет полезен не только новичкам, но и опытным разработчикам. Во второй редакции список рассматриваемых тем пополнился.
Нетрудно догадаться, что опыт, как стоит и не стоит писать код, я приобрёл, разрабатывая анализатор PVS-Studio и изучая обнаруженные с его помощью ошибки, поэтому время от времени его упоминание будет всплывать в различных главах. Я настолько пропитался статическим анализом, что многие темы вызывают в моих воспоминаниях примеры реальных ошибок, которыми хочется поделиться для убедительности. А раз они убедительны, то почему бы о них и не написать.
Книга написана с любовью и уважением к читателям без генерации текста с помощью ИИ. Желаю приятного чтения.
Настоящие программисты пишут код на C++!
Нет ничего плохого в написании кода на C++. На этом языке написано множество прекрасных программ, взять хотя бы список приложений с домашней страницы Бьёрна Страуструпа.
"Вот список систем, приложений и библиотек, которые полностью или по большей части написаны на C++. Естественно, он не претендует на полноту. На самом деле, даже если бы я попытался, то не смог бы перечислить и тысячной доли всех крупных C++-программ, а этот список содержит, пожалуй, лишь тысячную долю тех, о которых я слышал. Это список систем, приложений и библиотек, с которыми читатель, возможно, в какой-то степени знаком, и которые могут дать новичку представление о том, что делается с помощью C++, или которые я просто счёл "крутыми"."
Бьёрн Страуструп
Плохо, когда начинают использовать C++ только потому, что это "круто" или это единственный язык, с которым хорошо знакома команда.
Разнообразие языков программирования отражает многообразие задач, стоящих перед разработчиками приложений. Разные языки помогают элегантно решать различные классы задач.
Язык C++ претендует на звание универсального языка программирования. Однако универсальность не означает быстроту и простоту реализации конкретных приложений. Могут существовать языки, на которых проект будет реализован с меньшим вложением сил и времени.
Нет ничего страшного, если команда разработает небольшую вспомогательную утилиту на C++, хотя эффективнее для этого было бы использовать другой язык. Затраты на изучение нового языка могут превышать пользу от его применения.
Другое дело, когда перед командой стоит задача создания нового крупного проекта. В этот момент стоит остановиться и подумать: эффективно ли использовать для неё хорошо знакомый язык C++? не лучше ли выбрать другой?
Если ответ "да, использовать другой язык явно более эффективно", то, возможно, команде рационально потратить время на изучение этого языка. В перспективе это может на порядок сократить затраты на разработку и сопровождение. Или, возможно, стоит поручить этот проект другой команде, которая уже применяет более релевантный для поставленной задачи язык.
Хорошо, но когда стоит выбирать C++? Лучше всего C, а вслед за ним и C++ зарекомендовали себя в задачах системного программирования: операционные системы, драйверы, компиляторы, СУБД. А также там, где ограничены ресурсы: память, процессорное время.
Говоря об ограниченных ресурсах, в первую очередь в голову приходят микроконтроллеры. Да, С++ действительно активно применяется в сфере встраиваемых систем и IoT (интернет вещей). Более того, С и C++ — вернее их подмножества, ограниченные стандартом кодирования, — являются одними из немногих языков, рекомендуемых ГОСТ Р МЭК 61508 для систем с высоким уровнем полноты безопасности (SIL3, SIL4). Впрочем, не будем здесь углубляться в стандарты.
Ресурсы могут быть ограничены и в другом смысле. С++ применяется при написании приложений для воспроизводительных кластеров с огромным объемом памяти. Казалось бы, какие здесь ограничения? Лимиты здесь в затратах на аппаратуру и электроэнергию для дата-центров. Увеличив эффективность кода всего на 5-20%, можно получить в итоге огромную экономию.
Ещё вспоминается история, когда студия Disney в несколько раз сократила время рендеринга, разработав собственные алгоритмы на C++ с использованием SIMD и специализированных структур данных.
Резюмирую: С++ — отличный язык, позволяющий писать высокоэффективные приложения. Плата — сложность изучения языка и высокая дисциплина при написании кода. Выбирайте С++, когда это действительно нужно.
Здесь появляется соблазн сказать, что теперь глубоко знать язык не обязательно, так как для создания кода появился генеративный ИИ (далее — GenAI). Можно смело выбирать С++ и сразу создавать быстрый код. И тут мы подходим к следующему вредному совету.
Глубокое знание языков теперь не нужно. Благодаря GenAI ты можешь создавать эффективные программы на С++, не тратя время на его изучение.
Писать про GenAI — неблагодарное дело. Парадигмы разработки с ИИ развиваются и меняются сейчас так быстро, что в момент завершения работы над книгой что-то может устареть. А когда она будет напечатана, так мне вообще захочется написать главу по-другому. Тем не менее я попробую сформулировать важную мысль, которая должна пережить "золотую лихорадку ИИ".
Не понимая, как работает сгенерированный код, разработчик будет попадать в две ловушки:
Эти проблемы проявят себя при работе с любыми языками, но в случае С++ они более выражены. Сложность С++ является платой за его высокую эффективность. Писать на С++ медленный код — это то самое забивание гвоздей микроскопом.
В этой главе рассмотрим первый пункт, а в следующей отдельно обсудим ошибки и опасность излишнего доверия к сгенерированному коду.
С помощью GenAI можно создавать код, выглядящий элегантным и оптимизированным. Но таков ли он на самом деле? Нужен эксперт, глубоко понимающий С++, который возьмёт ответственность подтвердить, что архитектура проекта верна, а алгоритмы и код эффективны. Без этого развитие проекта быстро свернёт в никуда.
Для примера рассмотрим небольшую функцию, созданную с помощью Claude Opus. Комментарий к функции IsSpanBlank обещает, что код составлен из расчёта облегчить компилятору задачу его векторизации, например, с помощью SSE-инструкций.
Рассматриваемый далее пример взят из статьи "Ревью вайб-кода с гнильцой, который притворяется оптимизированным С++ кодом". В ней приводятся и другие примеры, показывающие необходимость верификации сгенерированного кода человеком. В противном случае вы получите сложный, избыточный и медленный код. Рекомендую не полениться и заглянуть в неё, будет забавно и поучительно.
Суть оптимизации в том, что несколько элементов обрабатываются одновременно, чтобы определить, хранят ли они пробельные символы:
// Check if a span contains only blank characters
// (space, tab, \r, \n)
// SIMD-friendly: processes 8 bytes at a time
inline bool IsSpanBlank(const char* data, size_t len) {
  size_t i = 0;
  // Process 8 bytes at a time
  for (; i + 8 <= len; i += 8) {
    // For each byte, check if it's NOT a blank character
    // Blank chars: space(0x20), tab(0x09), \n(0x0A), \r(0x0D)
    bool all_blank = true;
    for (size_t j = 0; j < 8; ++j) {
      unsigned char c = static_cast<unsigned char>(data[i + j]);
      bool is_blank = (c == ' ' || c == '\t' ||
                       c == '\n' || c == '\r');
      all_blank = all_blank && is_blank;
    }
    if (!all_blank) return false;
  }
  // Handle remaining bytes
  for (; i < len; ++i) {
    unsigned char c = static_cast<unsigned char>(data[i]);
    if (c != ' ' && c != '\t' && c != '\n' && c != '\r') {
      return false;
    }
  }
  return true;
}
Код создаёт впечатление, что ИИ знает, что делает. Внутренний цикл всегда обрабатывает по восемь символов, и предполагается, что эта часть может быть оптимизирована с помощью SIMD-инструкций. Оставшийся хвост символов обрабатывается отдельным простым циклом.
Мне показалось подозрительным, что на самом деле байты обрабатываются всё так же последовательно, и вложенный цикл не несёт чего-то полезного. На мой взгляд, этот код не лучше и не хуже простейшего варианта его реализации:
bool IsSpanBlank_Simple(const char* data, size_t len) {
  for (size_t i = 0; i < len; ++i) {
    unsigned char c = static_cast<unsigned char>(data[i]);
    if (c != ' ' && c != '\t' && c != '\n' && c != '\r') {
      return false;
    }
  }
  return true;
}
Я бы написал именно такой код. Если бы я понимал, что это узкое место и нужно непременно сделать код как можно быстрее, то пошёл бы искать решение, построенное на интринсиках.
Какой-то другой вариант, например, с вложенным циклом, я бы делать не решился. Я хоть что-то и понимаю в оптимизации, но не настолько, чтобы отважиться писать хитрый код с целью подсказать компилятору.
Можно сказать: "Вот! Ты слаб! А Claude Opus взял и сделал. Взял и написал более умный вариант".
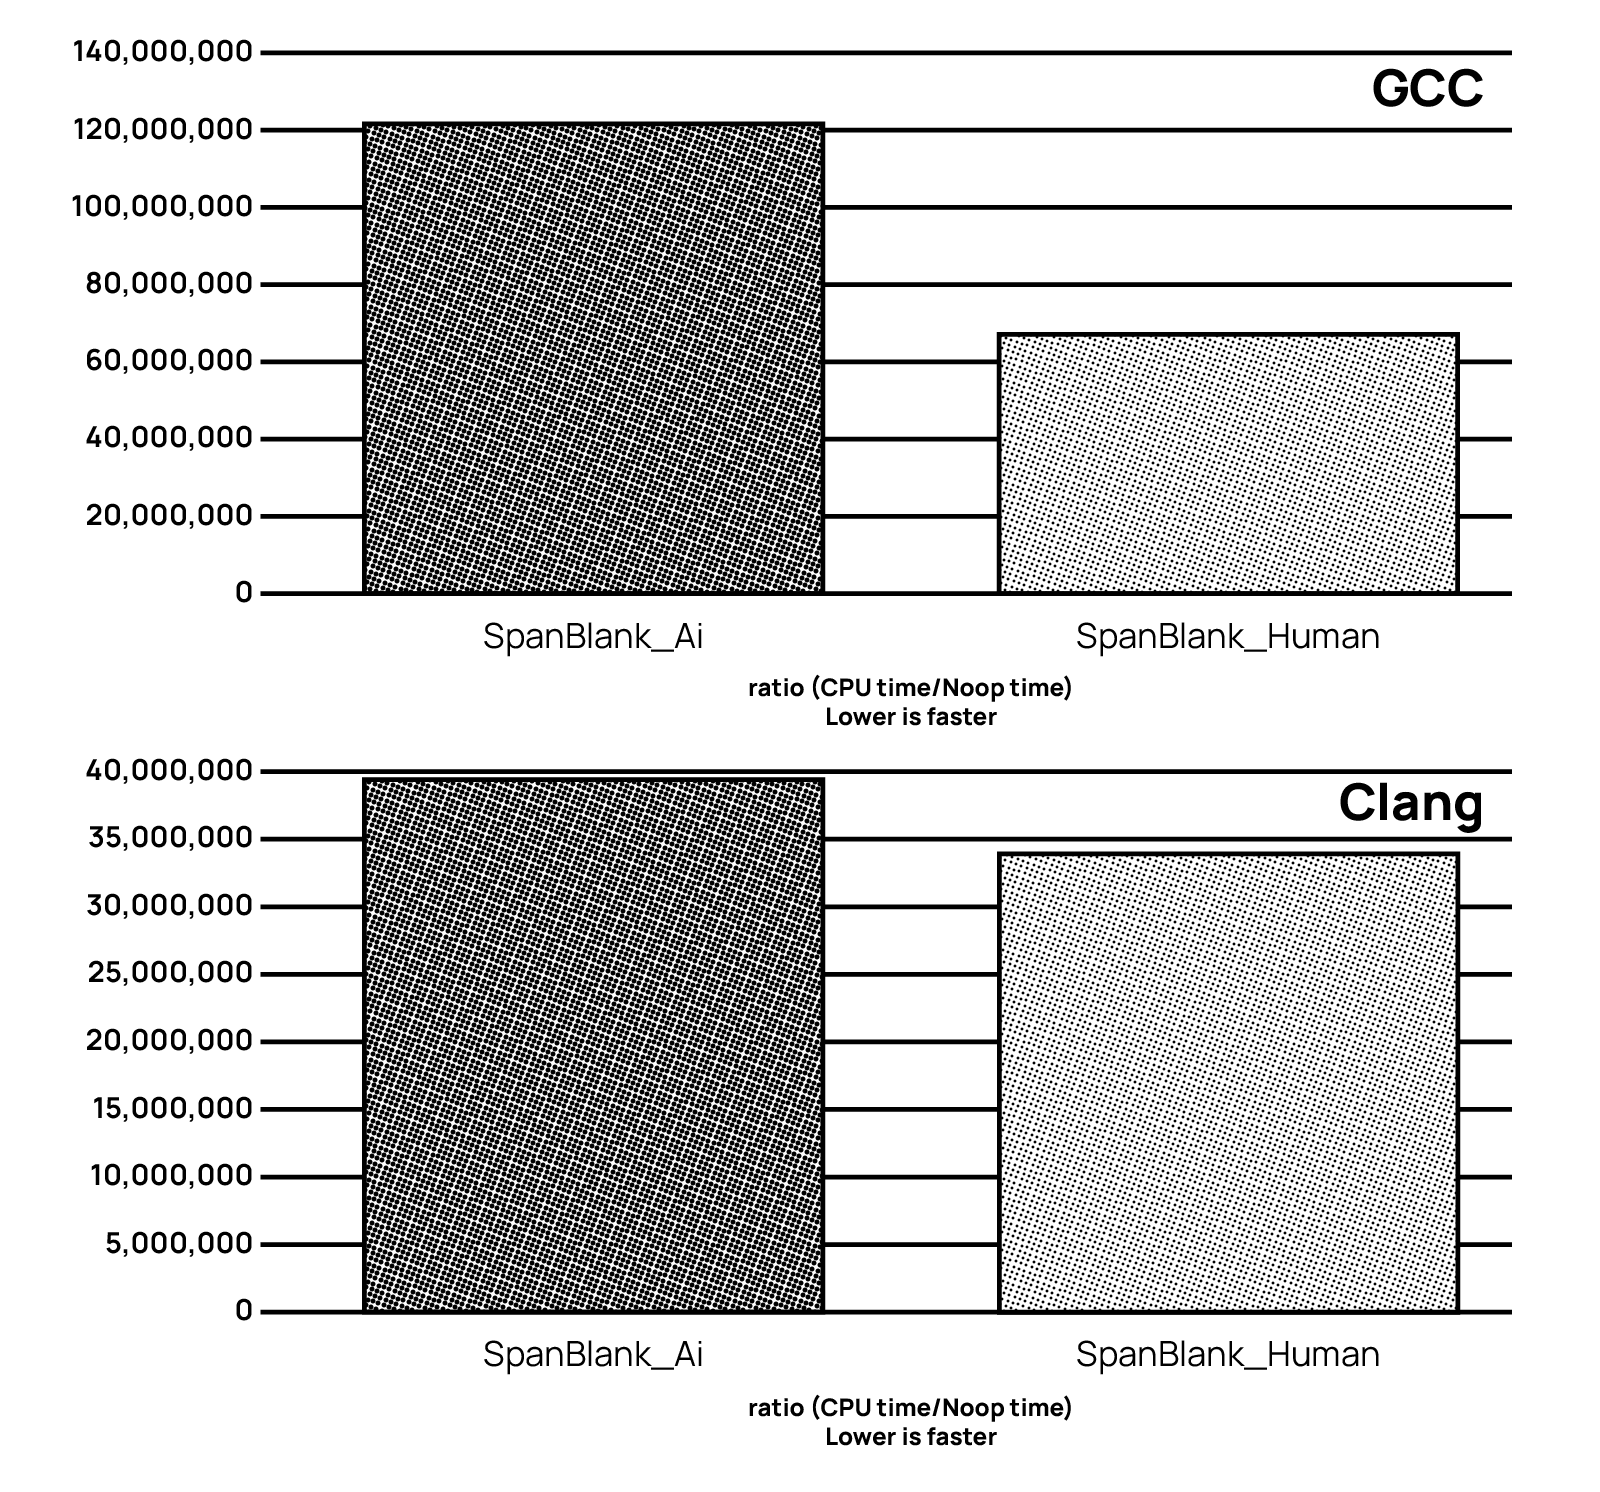
Давайте попробуем сравнить скорость. Мой коллега Филипп, которому стоит доверять в вопросах С++, провёл эксперимент с GCC и Clang:
В обоих вариантах код компилируется с агрессивными оптимизациями -O3. Можно заметить, что для обоих компиляторов простой вариант функции лучше, чем с вложенным циклом.
Быть может, надо какой-то волшебный ключ оптимизации указать, чтобы код оптимизировался лучше? Нет такого ключа. А если и будет, то компилятор без подсказки сам сделает столь же эффективный вариант из простого кода с одним циклом.
Параллельно с коллегой я тоже экспериментировал с двумя рассмотренными и тремя новыми вариантами алгоритма. Я использовал компилятор MSVC. Давайте посмотрим, какие результаты замеров получились.
Во-первых, мне подсказали, что ситуацию можно улучшить, заменив в изначальном варианте || на |. Short-circuit evaluation в нашем случае не помогает, а только вредит. Улучшенная проверка:
bool is_blank = (c == ' ' | c == '\t' | c == '\n' | c == '\r');Во-вторых, я спросил DeepSeek. Он предложил вариант оптимизации, построенный на битовых операциях:
bool IsSpanBlank_Deepseek(const char* data, size_t len) noexcept {
  // Создаём битовую маску для допустимых символов
  // Используем 128-битную маску для ASCII
  static constexpr uint64_t blank_mask_low = []() {
      uint64_t mask = 0;
      mask |= 1ULL << ' ';
      mask |= 1ULL << '\t';
      mask |= 1ULL << '\n';
      mask |= 1ULL << '\r';
      return mask;
  }();

  for (size_t i = 0; i < len; ++i) {
    unsigned char uc = static_cast<unsigned char>(data[i]);
    if (uc >= 64) return false;  // Все blank-символы в ASCII < 64
    if (!((blank_mask_low >> uc) & 1)) return false;
  }
  return true;
}
Напоследок я попросил у DeepSeek оптимизированную функцию, по-настоящему использующую векторизацию. Вот что получилось:
bool IsSpanBlank_Deepseek_SSE(const char* data, size_t len) noexcept {
  // Создаём векторы с допустимыми символами
  const __m128i space = _mm_set1_epi8(' ');
  const __m128i tab = _mm_set1_epi8('\t');
  const __m128i newline = _mm_set1_epi8('\n');
  const __m128i carriage = _mm_set1_epi8('\r');

  size_t i = 0;

  // Обрабатываем по 16 байт
  for (; i + 15 < len; i += 16) {
    __m128i chunk =
      _mm_loadu_si128(reinterpret_cast<const __m128i*>(data + i));

    // Проверяем, что каждый байт является одним из допустимых
    __m128i eq_space = _mm_cmpeq_epi8(chunk, space);
    __m128i eq_tab = _mm_cmpeq_epi8(chunk, tab);
    __m128i eq_nl = _mm_cmpeq_epi8(chunk, newline);
    __m128i eq_cr = _mm_cmpeq_epi8(chunk, carriage);

    __m128i is_blank = _mm_or_si128(_mm_or_si128(eq_space, eq_tab),
                                         _mm_or_si128(eq_nl, eq_cr));

    // Получаем маску и проверяем
    int mask = _mm_movemask_epi8(is_blank);
    if (mask != 0xFFFF) return false;
}

  // Обрабатываем остаток
  for (; i < len; ++i) {
    char c = data[i];
    if (c != ' ' && c != '\t' && c != '\n' && c != '\r') return false;
  }

  return true;
}
Теперь результаты. Хотя 32-битные сборки сейчас неактуальны, ради интереса я и её запустил. Замеры выполнялись на массиве размером 212 мегабайт, заполненном случайными пробельными символами. Выполнение потока привязывается к одному предварительно прогретому ядру.
Win32:
1. Самый простой вариант с одним циклом:                        1.39 сек.
2. Изначальный "оптимизированный код" с вложенным циклом:       1.86 сек.
3. В изначальном варианте операторы || заменены на | :          0.351 сек.
4. Вариант от DeepSeek с оптимизацией на битовых масках:        0.817 сек.
5. Вариант от DeepSeek с оптимизацией на SSE2 интристиках:      0.0449 сек.

Win64:
1. Самый простой вариант с одним циклом:                        0.175 сек.
2. Изначальный "оптимизированный код" с вложенным циклом:       0.309 сек.
3. В изначальном варианте операторы || заменены на | :          0.253 сек.
4. Вариант от DeepSeek с оптимизацией на битовых масках:        0.207 сек.
5. Вариант от DeepSeek с оптимизацией на SSE2 интристиках:      0.0396 сек.
Хорошо заметно, что 64-битный код получился намного эффективнее, кроме случая, где в ход идёт SSE2, но и там в любом случае всё быстро.
Код, сгенерированный Claude Opus для проекта markus, худший из всех вариантов.
Даже самый простой вариант с обыкновенным циклом не только быстрее, но и короче. Дополнительные строки кода пошли только во вред.
В лидерах код на интристиках, но плата за это — ограничение переносимости.
Кто-то скажет, что я зря переживаю. Да, Claude Opus выбрал неудачно решение, но ведь DeepSeek предложил вполне хороший, быстрый и переносимый вариант.
Согласен. Вот только в проекте мы видим неудачный код: он выглядит оптимизированным, но таковым не является. Задача не решена. Нужен эксперт, который это поймёт и выберет другое решение. Чтобы быть таким экспертом, нужно не только хорошо знать С++, но и иметь опыт написания и оптимизации приложений.
Чтение фундаментальных книг по С++ — пустая трата времени. Достаточно обучающих видео, во всём остальном поможет GenAI.
Эта глава для тех, кто только погружается в программирование. Те, кто давно в разработке, могут её пропустить. Или не пропускать и посмотреть, насколько это созвучно с вашими ощущениями и мыслями.
Суть предыдущей главы не в том, чтобы избегать GenAI, а в том, чтобы уметь понимать и контролировать, получается ли создавать код необходимого качества, надёжности, безопасности. Здесь мы приходим к проблеме изучения теории и получения практического опыта программирования.
Вопрос обучения программированию был всегда. Сейчас он стоит острее из-за иллюзии ускорения изменений технологий программирования. Приверженцы GenAI/вайб-кодинга, не стесняясь, пишут в статьях, что знания "годовой давности" уже неактуальны, и сейчас агенты использовать надо совсем по-иному. Возможно, дело в том, что не такие уж это были и "знания"?
По-прежнему актуальны фундаментальные знания в области проектирования систем, ООП, языков, управления коллективом разработчиков и так далее.
Однако суета вокруг GenAI создаёт у неокрепшего разума впечатление, что нет смысла всерьёз вкладываться в самообразование, так как всё равно через год всё устареет. Важнее быстро изучать новое по верхам, а GenAI реализует всё лучше, чем это сделаешь ты.
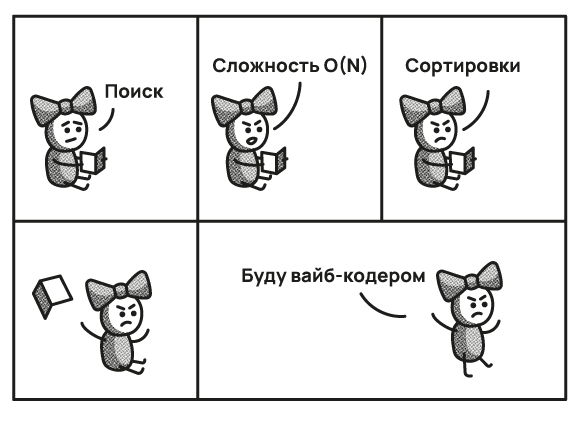
Невозможно верифицировать, получилось ли всё хорошо, правильно и эффективно, не понимая, как всё устроено и работает. Иногда это и не нужно, если это MVP или пет-проект. Но я говорю о промышленной разработке ПО, где задачи и их сложность выходят за рамки "давайте быстро сгенерируем какой-то код". Энтузиасты GenAI-статей часто даже не понимают, о какой проблематике идёт речь — вот ведь код, что ещё надо? Мне нравится цитата на эту тему:
"И вот это, на мой взгляд, сейчас одна из главных проблем. Люди, которые не понимают, как устроено программирование во всей его полноте, сегодня с очень большой уверенностью рассказывают всем остальным, как нужно делать программирование."
Михаил Ларченко. Хороший код больше не важен? Почему разработка катится не туда — мнение техлида.
Мой совет для тех, кто погружается в программирование: учитесь и практикуйтесь в самостоятельном написании кода. Это всё понадобится независимо от того, генерируется код или пишется руками. Это неважно. Важны эксперты, способные брать ответственность за результат работы!
Какие ловушки сейчас есть на пути к обучению программированию?
Я сторонник чтения книг по программированию. При этом я не отрицаю пользу от обучающих видео и других способов обучения. Могу с удовольствием посмотреть доклад с C++-конференции.
Мы сами записываем обучающие видео. Например, недавно записали цикл из 10 уроков в формате лайвкодинга по написанию компилятора. Автор — Юрий Минаев — архитектор в компании PVS-Studio. Тех, кто заинтересуется, ждут шесть часов хардкорного программирования на С++. Доступ бесплатный.
Дело в перекосе в сторону видео-форматов. По моим наблюдениям, читать книги по программированию стало не модно.
У обучающих видео есть два недостатка:
Если подойти к видео с обстоятельностью книг, то будет как-то так...
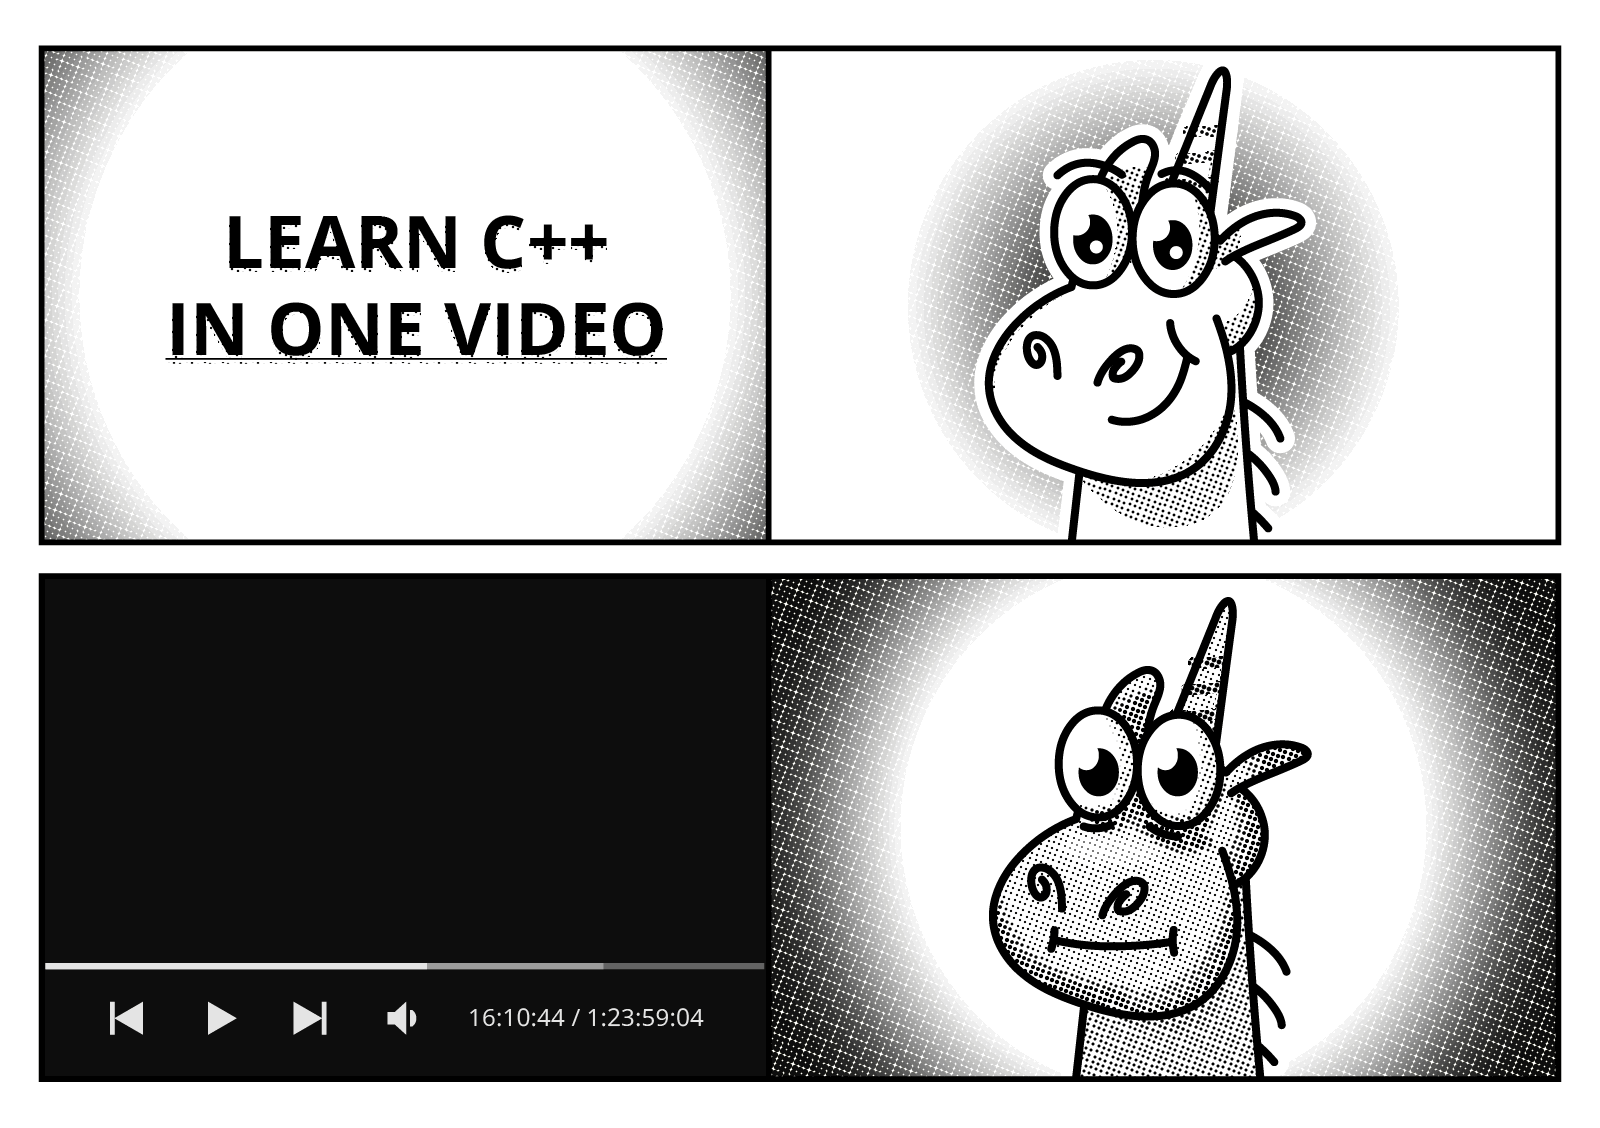
Тяжёлый формат для восприятия. На мой взгляд, видео могут дополнять полученные знания. Они полезны, когда ложатся поверх фундамента знаний, полученных из книг. В противном случае видео формируют неглубокую разорванную картину знаний. Кажется, что человек разбирается в программировании, но такие "лоскутные" знания выйдут боком и ему, и работодателю.
Я встречал таких "программистов" ещё до эпохи GenAI. Первое поверхностное впечатление — они очень крутые. Они могут быстро что-то создать на хакатоне с помощью модных библиотек или удивить какой-то невероятной красотой, использовав где-то игровой движок. Это кажется какой-то магией, особенно если ты сам не работал с этими библиотеками. Но это очарование быстро рассеивается, когда видишь, как человек не может справиться с реальной задачей из-за незнания каких-то базовых алгоритмов или особенностей языка программирования. Сейчас, во времена GenAI, всё будет ещё хуже.
А в чём проблема, если что-то человек не знает, но в целом что-то делает? В неэффективности и ограниченности возможностей. Из-за незнания человек может использовать странные и крайне неоптимальные подходы. Он может вайб-кодить или программировать методом поиска готовых решений в Stack Overflow, но рано или поздно не сможет решить стоящие перед ним задачи. Граница невидима, но она есть.
Кстати, я на собеседовании спрашиваю, какие книги по программированию на C++ читал соискатель. Это не значит, что мы не возьмём человека, если он ответит, что не читал книг, но это повод насторожиться.
Новичок, который с первого дня пишет код с GenAI, не проходит последовательно путь от синтаксиса к архитектуре. Он сразу получает рабочий результат, минуя этап понимания, почему лучше сделать именно так, а не по-другому. Он не набивает шишек и не выносит для себя выводов из проделанного.
Быстрый работающий результат — это прикольно и мотивирующее, но отсутствие понимания того, как устроена система в целом — это проблема. Она проявится позже, когда сгенерируется что-то нерабочее и всё-таки придётся разобраться в причинах.
Обучение программированию, когда код пишет GenAI, не заставляет искать ошибку через отладку и вникание в тонкости работы алгоритма. Это провоцирует устранение проблемы через перегенерацию кода. В реальном проекте отсутствие опыта отладки рано или поздно приведёт в тупик.
Что делать и стоит ли учитывать моё мнение, каждый решает для себя. Мой добрый совет — меньше читайте про ИИ-хайп. Знакомьтесь с классическими книгами по программированию, практикуйтесь писать код самостоятельно и заставьте его работать. Специалисты, понимающие суть, будут нужны и в будущем.
Иногда на новое интересно смотреть сквозь призму старого. Предлагаю цитату из великолепной книги "Совершенный код" С. Макконнелла (издание второе, ISBN 978-5-7502-0064-1).
"За последние десятилетия программисты видели массу инструментов, которые предположительно должны были устранить необходимость программирования. Сначала это были языки третьего поколения, потом — четвертого. Потом — автоматическое программирование. Потом — CASE-средства. Потом — визуальное программирование. Каждое из этих достижений привносило значительные улучшения, и общими усилиями они сделали программирование абсолютно неузнаваемым для тех, кто изучал его до этих нововведений. Но ни одна из этих инноваций не устранила программирования как такового."
...
"Нам всегда будут нужны люди, способные заполнить брешь между задачей реального мира, которую нужно решить, и компьютером, предназначенным для решения этой задачи. Эти люди будут называться программистами независимо от того, манипулируют они машинными регистрами на ассемблере или диалоговыми окнами в Microsoft Visual Basic. Пока у нас есть компьютеры, нам будут нужны люди, которые говорят компьютерам, что делать, и эта деятельность будет называться программированием. Когда вы слышите заявления о том, что "новый инструментарий устранит необходимость компьютерного программирования", бегите! Или хотя бы посмейтесь про себя над этим наивным оптимизмом."
Как говорится, это уже было в "Симпсонах". Год издания книги — 2004.
Если в строковом литерале нужен символ табуляции, смело жмите клавишу Tab. Оставьте \t для яйцеголовых. Не парьтесь.
Речь идёт о строковых литералах, в которых требуется табуляцией отделять одни слова от других:
const char str[] = "AAA\tBBB\tCCC";Казалось бы, по-другому и сделать нельзя. Тем не менее нет предела человеческой безалаберности. Кто-то, не задумываясь, нажимает клавишу Tab вместо того, чтобы использовать \t. Это встречается и в коммерческих приложениях.
Такой код компилируется и даже может работать, однако явное использование символа табуляции плохо сразу по нескольким причинам:
Более того, однажды в реальном приложении я вообще видел приблизительно такой код:
  const char table[] = "\
bla-bla-bla bla-bla-bla bla-bla-bla-bla-bla \n\
      bla-bla-bla       bla-bla-bla\n\
          %s                %d\n\
          %s                %d\n\
          %s                %d\n\
";
  printf(table, "X", 1, "Foo", 2, "Time", 3);
Строка побита на части с помощью \. Явные символы табуляции использовались вперемешку с пробелами. К сожалению, не знаю, как здесь это показать. Поверьте, это смотрелось экстравагантно. Ещё и выравнивание от начала экрана. Бинго! Чего только не насмотришься, разрабатывая анализатор кода!
Явные табуляции, добавленные кнопкой Tab, очень легко "потерять". Если в процессе рефакторинга или автоформатирования они будут заменены на пробелы, то значения перестанут печататься в столбик:
bla-bla-bla bla-bla-bla bla-bla-bla-bla-bla
     bla-bla-bla       bla-bla-bla
         X                  1
         Foo                  2
         Time                  3
По-нормальному этот код следовало оформить как-то так:
const char table[] =
  "bla-bla-bla bla-bla-bla bla-bla-bla-bla-bla\n"
  "     bla-bla-bla       bla-bla-bla\n"
  "         %s\t            %d\n"
  "         %s\t            %d\n"
  "         %s\t            %d\n";

printf(table, "X", 1, "Foo", 2, "Time", 3);
Символы табуляции нужны, чтобы второй столбец выглядел выровненным несмотря на размер названий в первом столбце (X, Foo, Time). Подразумевается, что эти названия всегда короткие, то есть меньше восьми символов. Исправленный код распечатает:
bla-bla-bla bla-bla-bla bla-bla-bla-bla-bla
     bla-bla-bla       bla-bla-bla
         X                 1
         Foo               2
         Time              3
Кто-то может удивиться, что я рассказываю про такие простые и очевидные вещи. Более того, даже исправленный код попахивает и не тянет на хороший пример для книги. Однако раз я сам видел явные символы табуляции в строках, про это стоит рассказать. Даже такое исправление лучше, чем если кто-то будет продолжать нажимать где попало Tab, не понимая, почему это плохо.
Автор — Карпов Андрей Николаевич, к.ф.-м.н.
Андрей Карпов более 19 лет занимается темой статического анализа кода и качества программного обеспечения. Автор большого количества статей, посвящённых написанию качественного кода на языке C++. С 2011 по 2021 год удостаивался награды Microsoft MVP в номинации Developer Technologies. Один из основателей проекта PVS-Studio. Долгое время являлся CTO компании и занимался разработкой С++ ядра анализатора. Сейчас является директором по развитию бизнеса (CBDO) и занимается обучающим маркетингом.
В следующих публикациях вас ждут новые вредные советы для C++ программистов. Подписывайтесь на рассылку статей из нашего блога, чтобы не пропустить их!
Канал автора – "Бестиарий программирования" в Telegram / MAX


0
0
0


0