Мы используем куки, чтобы пользоваться сайтом
было удобно.
Вебинар: Понять себя как тимлида: привычки, роли и стили управления - 21.10


 Оглавление
Вы можете открыть всю документацию по PVS-Studio одной страницей.
Анализатор PVS-Studio активно развивается. Например, наша команда постоянно совершенствует его интеграцию с различными CI/CD системами и средами разработки, добавляет поддержку новых платформ и компиляторов. Однако лучше всего развитие возможностей анализатора показывает график количества диагностик.

Рисунок 1. Увеличение количества диагностик в PVS-Studio
Как видите, мы активно совершенствуем возможности анализатора по выявлению новых паттернов ошибок. Более подробная информация по нововведениям в различных версиях анализатора представлена ниже. Вы также можете почитать об изменениях в PVS-Studio за последний год в нашем блоге.
Мы постарались объединить большинство диагностик в несколько групп, чтобы вы могли получить общее представление о возможностях анализатора кода PVS-Studio.
Так как разделение весьма условно, некоторые диагностики входят в несколько групп. Например, неправильное условие if (abc == abc) можно одновременно интерпретировать и как простую опечатку, и как проблему безопасности, так как ошибка приводит к уязвимости кода при некорректных входных данных.
Некоторым ошибкам, наоборот, места в таблице не нашлось — уж слишком они специфичны. Тем не менее, таблица в целом даёт представление о функциональности статического анализатора кода.
|
Основные диагностические возможности PVS-Studio |
Диагностики |
|---|---|
|
64-битные ошибки |
C, C++: V101-V128, V201-V207, V220, V221, V301-V303 |
|
Адрес локальной переменной возвращается из функции по ссылке |
C, C++: V506, V507, V558, V723, V758, V1017, V1047 |
|
Арифметическое переполнение, потеря значимости |
C, C++: V569, V636, V658, V784, V786, V1012, V1026, V1028, V1029, V1033, V1070, V1081, V1083, V1085, V1112
C#: V3041, V3200, V3204, V3217
Java: V5308, V6011, V6088, V6117 |
|
Выход за границу массива |
C, C++: V557, V582, V643, V781, V1038, V1111
C#: V3106, V3218
Java: V6025, V6079
Go: V8031 |
|
Двойное освобождение ресурсов |
C, C++: V586, V749, V1002, V1006 |
|
Мёртвый код |
C, C++: V606, V607
Java: V6021
JavaScript and TypeScript: V7003
Go: V8021, V8024 |
|
Микрооптимизации |
C, C++: V801, V802, V803, V804, V805, V806, V807, V808, V809, V810, V811, V812, V813, V814, V815, V816, V817, V818, V819, V820, V821, V822, V823, V824, V825, V826, V827, V828, V829, V830, V831, V832, V833, V834, V835, V836, V837, V838, V839
C#: V4001, V4002, V4003, V4004, V4005, V4006, V4007, V4008 |
|
Недостижимый код |
C, C++: V517, V551, V695, V734, V776, V779, V785
C#: V3136, V3142, V3202
Java: V6018, V6019
JavaScript and TypeScript: V7039
Go: V8025 |
|
Неинициализированные переменные |
C, C++: V573, V614, V679, V737, V788, V1007, V1050, V1077, V1086
C#: V3070, V3128
Java: V6036, V6050, V6052, V6090 |
|
Неиспользуемые переменные |
C, C++: V603, V751, V763, V1001, V1079
C#: V3061, V3065, V3077, V3117, V3137, V3143, V3196, V3203, V3220
Java: V6021, V6022, V6023
JavaScript and TypeScript: V7009
Go: V8022, V8038 |
|
Некорректные операции сдвига |
C, C++: V610, V629, V673, V684, V770, V1093
C#: V3134
Java: V6034, V6069 |
|
Неопределенное/неуточняемое поведение |
C, C++: V567, V610, V611, V681, V694, V704, V708, V726, V736, V772, V1007, V1016, V1026, V1032, V1061, V1066, V1069, V1082, V1091, V1094, V1097, V1099
Java: V6128 |
|
Неправильная работа с типами (HRESULT, BSTR, BOOL, VARIANT_BOOL, float, double) |
C, C++: V543, V544, V545, V556, V615, V636, V676, V716, V721, V724, V745, V750, V767, V768, V771, V772, V775, V1014, V1027, V1034, V1046, V1060, V1066, V1084
C#: V3041, V3059, V3076, V3111, V3121, V3148
Java: V6038, V6108
JavaScript and TypeScript: V7011
Go: V8018 |
|
Неправильное представление о работе функции/класса |
C, C++: V515, V518, V530, V540, V541, V554, V575, V597, V598, V618, V630, V632, V663, V668, V698, V701, V702, V717, V718, V720, V723, V725, V727, V738, V742, V743, V748, V762, V764, V780, V789, V797, V1014, V1024, V1031, V1035, V1045, V1052, V1053, V1054, V1057, V1060, V1066, V1098, V1100, V1107, V1115
C#: V3010, V3057, V3068, V3072, V3073, V3074, V3078, V3082, V3084, V3094, V3096, V3097, V3102, V3103, V3104, V3108, V3114, V3115, V3118, V3123, V3126, V3145, V3178, V3186, V3192, V3194, V3195, V3197
Java: V6009, V6010, V6016, V6026, V6029, V6049, V6055, V6058, V6064, V6068, V6081, V6110, V6116, V6122, V6125, V6133, V6134
JavaScript and TypeScript: V7010
Go: V8008, V8015, V8032 |
|
Опечатки |
C, C++: V501, V503, V504, V508, V511, V516, V519, V520, V521, V525, V527, V528, V529, V532, V533, V534, V535, V536, V537, V539, V546, V549, V552, V556, V559, V560, V561, V564, V568, V570, V571, V575, V577, V578, V584, V587, V588, V589, V590, V592, V602, V604, V606, V607, V616, V617, V620, V621, V622, V625, V626, V627, V633, V637, V638, V639, V644, V646, V650, V651, V653, V654, V655, V657, V660, V661, V662, V666, V669, V671, V672, V678, V682, V683, V693, V715, V722, V735, V741, V747, V753, V754, V756, V765, V767, V768, V770, V771, V787, V791, V792, V796, V1013, V1015, V1021, V1040, V1051, V1055, V1074, V1094, V1113
C#: V3001, V3003, V3005, V3007, V3008, V3009, V3011, V3012, V3014, V3015, V3016, V3020, V3028, V3029, V3034, V3035, V3036, V3037, V3038, V3050, V3055, V3056, V3057, V3060, V3062, V3063, V3066, V3081, V3086, V3091, V3092, V3093, V3102, V3107, V3109, V3110, V3112, V3113, V3116, V3118, V3122, V3124, V3132, V3140, V3170, V3174, V3185, V3187, V3228
Java: V6001, V6005, V6009, V6012, V6014, V6015, V6016, V6017, V6021, V6026, V6028, V6029, V6030, V6031, V6037, V6041, V6042, V6043, V6045, V6057, V6059, V6061, V6062, V6063, V6077, V6080, V6085, V6091, V6105, V6112
JavaScript and TypeScript: V7001, V7005, V7007, V7009, V7013, V7014, V7015, V7016, V7017, V7019, V7022, V7024, V7029, V7031, V7032, V7033, V7034, V7035, V7038, V7040
Go: V8001, V8002, V8003, V8004, V8006, V8007, V8008, V8011, V8012, V8016, V8017, V8023, V8027, V8029, V8033, V8034, V8037, V8039 |
|
Отсутствие виртуального деструктора |
C, C++: V599, V689 |
|
Оформление кода не совпадает с логикой его работы |
C, C++: V563, V612, V628, V640, V646, V705, V709, V715, V1044, V1073
C#: V3007, V3018, V3033, V3043, V3067, V3069, V3138, V3150, V3172, V3183
Java: V6040, V6047, V6063, V6086, V6089, V6132
JavaScript and TypeScript: V7020, V7022, V7026, V7029, V7030 |
|
Ошибки из-за Copy-Paste |
C, C++: V501, V517, V519, V523, V524, V571, V581, V649, V656, V666, V691, V760, V766, V778, V1037
C#: V3001, V3003, V3004, V3008, V3012, V3013, V3021, V3030, V3058, V3127, V3139, V3140, V3228
Java: V6003, V6004, V6012, V6021, V6027, V6032, V6033, V6039, V6067, V6072
JavaScript and TypeScript: V7002, V7003, V7004, V7008, V7012, V7023
Go: V8001, V8004, V8005, V8009, V8010, V8012, V8014, V8017, V8019, V8020, V8033 |
|
Ошибки при работе с исключениями |
C, C++: V509, V565, V596, V667, V668, V740, V741, V746, V759, V1022, V1045, V1067, V1090
C#: V3006, V3052, V3100, V3141, V3163, V3164, V5602, V5603, V5606, V5607
Java: V5301, V5302, V5303, V5306, V6006, V6051, V6103, V6118, V6134
JavaScript and TypeScript: V7006
Go: V8007 |
|
Переполнение буфера |
C, C++: V512, V514, V594, V635, V641, V645, V752, V755 |
|
Проблемы безопасности |
C, C++: V505, V510, V511, V512, V518, V531, V541, V547, V559, V560, V569, V570, V575, V576, V579, V583, V597, V598, V618, V623, V631, V642, V645, V675, V676, V724, V727, V729, V733, V743, V745, V750, V771, V774, V782, V1001, V1003, V1005, V1010, V1017, V1055, V1072, V1076, V1113, V1118
C#: V3022, V3023, V3025, V3027, V3039, V3053, V3063, V3225, V3232, V5601, V5608, V5609, V5610, V5611, V5612, V5613, V5614, V5615, V5616, V5617, V5618, V5619, V5620, V5621, V5622, V5623, V5624, V5625, V5626, V5627, V5628, V5629, V5630, V5631
Java: V5305, V5307, V5309, V5312, V5313, V5314, V5315, V5316, V5317, V5318, V5319, V5320, V5321, V5322, V5323, V5325, V5326, V5327, V5328, V5329, V5330, V5331, V5332, V5333, V5334, V5335, V5336, V5337, V5338, V5339, V5340, V5341, V5342, V5343, V6007, V6046, V6054, V6109
JavaScript and TypeScript: V5801, V7013
Go: V5901, V8036 |
|
Путаница с приоритетом операций |
C, C++: V502, V562, V593, V634, V648, V727, V733, V1003, V1104
C#: V3130, V3133, V3177, V3207
Java: V6044
JavaScript and TypeScript: V7021 |
|
Разыменование нулевого указателя/нулевой ссылки |
C, C++: V522, V595, V664, V713, V757, V769
C#: V3019, V3042, V3080, V3095, V3105, V3125, V3141, V3145, V3146, V3148, V3149, V3153, V3156, V3168, V3195
Java: V6008, V6060, V6093 |
|
Разыменование параметров без предварительной проверки |
C, C++: V595, V664, V783, V1004
C#: V3095
Java: V6060 |
|
Ошибки синхронизации |
C, C++: V712, V720, V744, V1011, V1018, V1025, V1036, V1088, V1089, V1114
C#: V3032, V3054, V3079, V3082, V3083, V3089, V3090, V3147, V3167, V3168, V3190, V3223, V5604, V5605
Java: V5304, V6064, V6070, V6074, V6082, V6095, V6102, V6125, V6126, V6129 |
|
Утечки ресурсов |
C, C++: V599, V701, V773, V1020, V1023, V1100, V1106, V1110
Java: V6127 |
|
Целочисленное деление на 0 |
C, C++: V609
C#: V3064, V3151, V3152
Java: V6020 |
|
Ошибки сериализации / десериализации |
C, C++: V513, V663, V739, V1024, V1095
C#: V3094, V3096, V3097, V3099, V3103, V3104, V3193, V5611
Java: V6065, V6075, V6076, V6083, V6087 |
|
Диагностики, созданные по специальным просьбам пользователей |
C, C++: V2001, V2002, V2003, V2004, V2005, V2006, V2007, V2008, V2009, V2010, V2011, V2012, V2013, V2014, V2022 |
Таблица 1 — Возможности PVS-Studio
Как видите, анализатор максимально проявляет себя в таких областях, как поиск ошибок, возникших из-за опечаток и Copy-Paste. Хорошо диагностирует проблемы, связанные с безопасностью кода.
О том, как всё это работает на практике, можно узнать, заглянув в базу ошибок. Мы собираем в эту базу все ошибки, найденные во время проверок различных открытых проектов с помощью PVS-Studio.
Список диагностик анализатора в формате XML, предназначенный для автоматического разбора, доступен по постоянной ссылке здесь.
Анализатор PVS-Studio позволяет анализировать проекты на языках программирования C, C++, C#, Java, Go, JS и TS. Он работает на операционных системах Windows, Linux и macOS. Перед началом использования анализатора необходимо активировать лицензию. Поскольку продукт используется в разных сценариях (например, в IDE, на локальных и облачных CI/CD), далее будут перечислены все возможные способы активации. Перейдите в подходящий раздел и следуйте инструкции.
Важно. Все действия выполняются после установки анализатора. Скачать его можно на этой странице.
Лицензия анализатора состоит из имени лицензии анализатора, привязанной к лицензионному ключу, и 16-символьного лицензионного ключа в формате "ХХХХ-ХХХХ-ХХХХ-ХХХХ". Если у вас нет лицензии, её можно получить через форму запроса триальной версии.
Ниже приведён пример того, как может выглядеть лицензионная информация:
JohnSmith <--- Имя лицензии, привязанное к ключу
ASD1-DAS3-5KK3-LODR <--- Лицензионный ключВы можете ввести лицензию во время установки PVS-Studio. В процессе установки вам предложат запросить лицензию или ввести уже существующую:
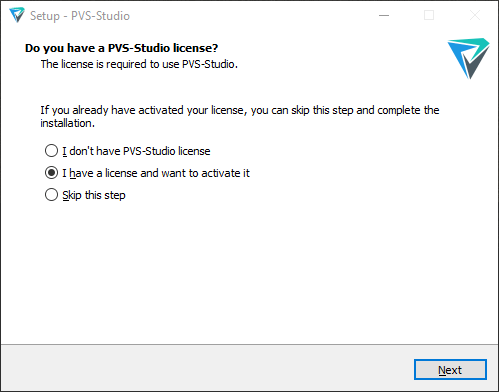
Выберите пункт I have a license and want to activate it и нажмите Next:
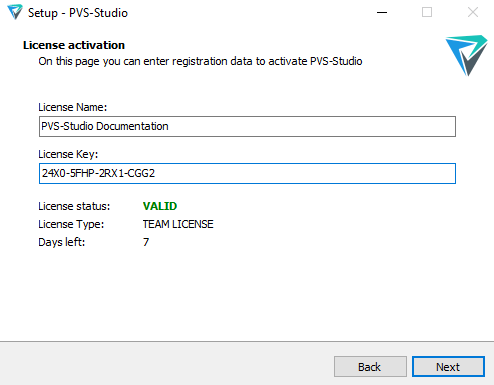
В поле License Name укажите имя пользователя анализатора, привязанное к ключу, а в License Key — лицензионный ключ. Если введённые данные валидны, отобразится сообщение с информацией о лицензии.
Перейдите в меню Visual Studio Extensions > PVS-Studio > Options, в версиях до Visual Studio 2015 PVS-Studio > Options:
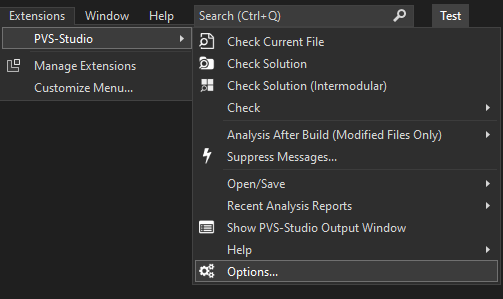
После этого справа в меню перейдите на страницу PVS-Studio > Registration:
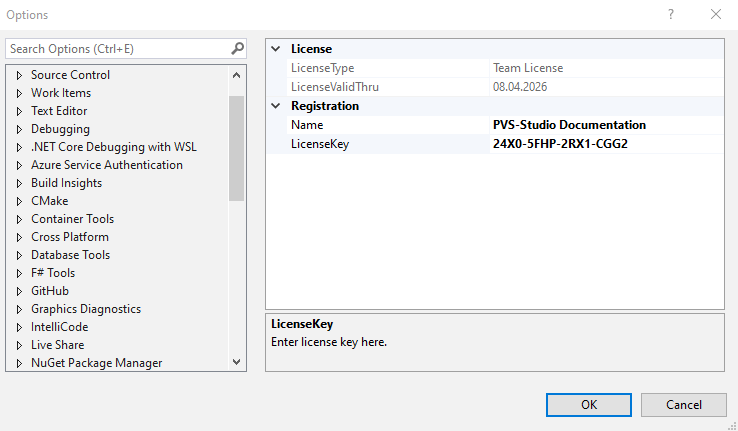
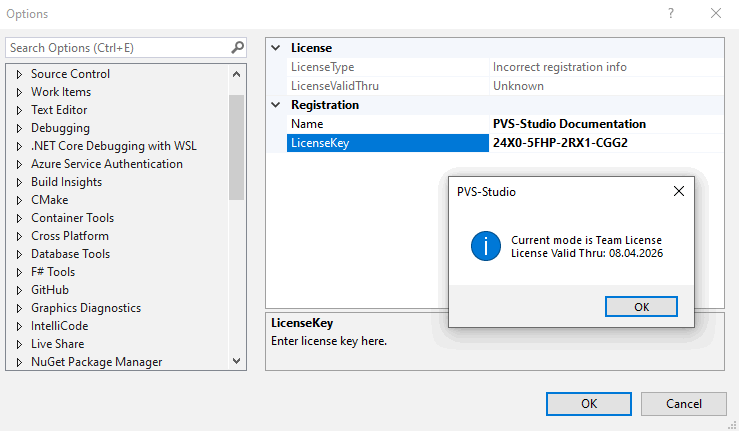
В поле Name укажите имя пользователя анализатора, привязанное к ключу, а в LicenseKey — лицензионный ключ. Если введённые данные валидны, отобразится сообщение с информацией о лицензии:
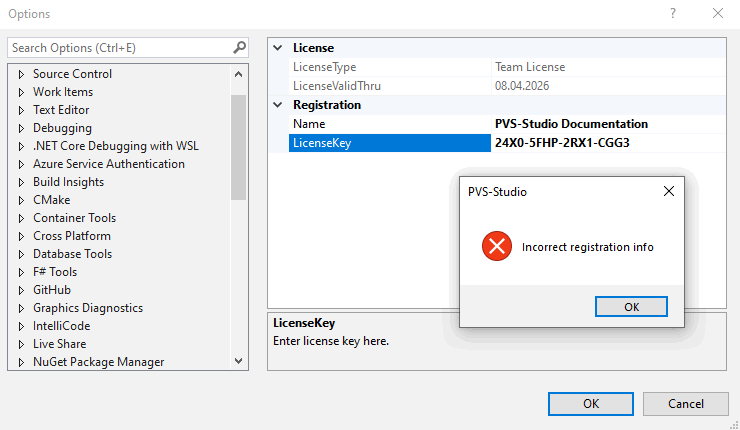
В случае если введённые данные лицензии невалидны, отобразится следующее уведомление:
Для ввода лицензии анализатора откройте любой проект, а затем окно настроек IDE:
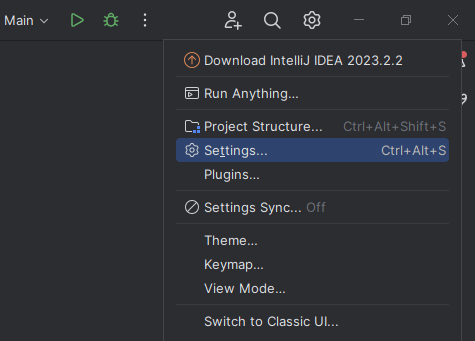
В открывшемся окне настроек плагина перейти на страницу PVS-Studio > Registration.
В поле Name укажите имя лицензии анализатора, привязанное к ключу, а в License Key — лицензионный ключ:
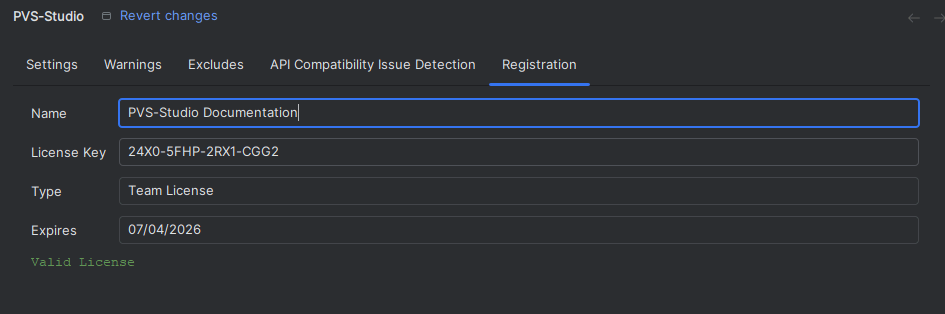
Если лицензионные данные валидны, надпись Invalid License сменится на Valid License. Для подтверждения и сохранения введённой лицензии нажмите Apply или OK.
Перейдите в меню утилиты Tools > Options > Registration, чтобы ввести лицензию:
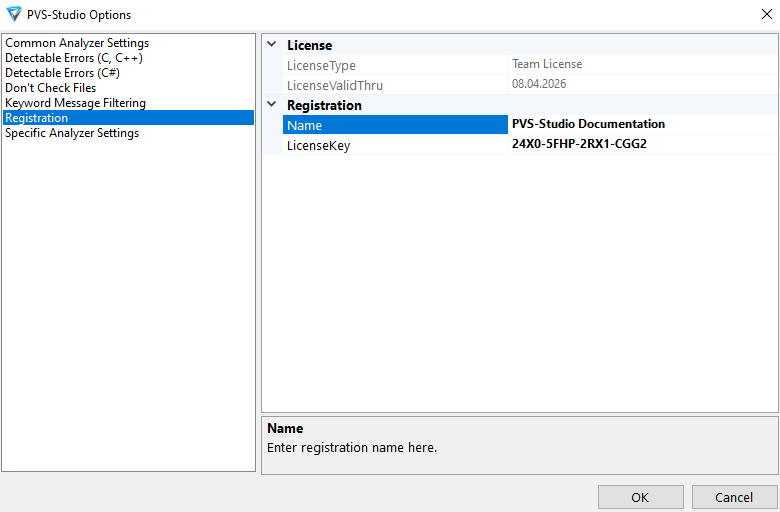
В поле Name укажите имя пользователя анализатора, привязанное к ключу, а в LicenseKey — лицензионный ключ. Если введённые данные валидны, отобразится сообщение с информацией о лицензии:
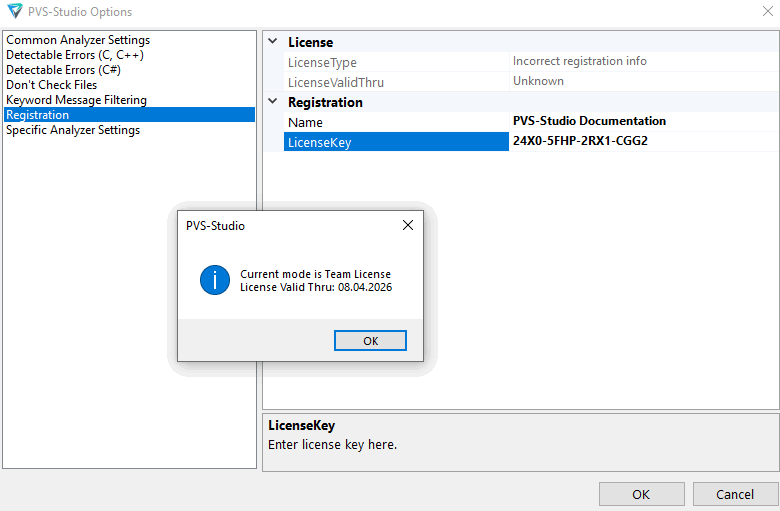
В случае если введённые данные лицензии невалидны, отобразится следующее уведомление:
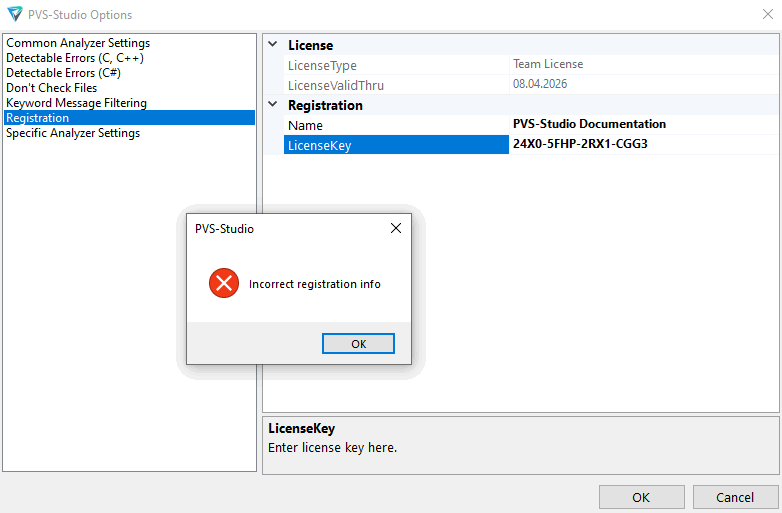
Для ввода лицензии в Visual Studio Code откройте View > Command Palette:
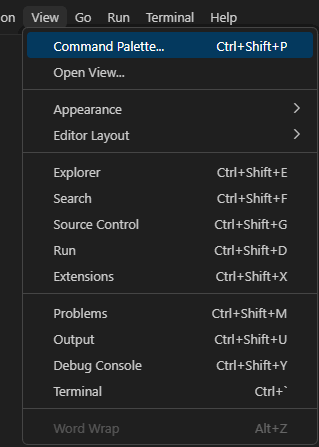
Введите в строку "PVS-Studio: Show settings" и нажмите на появившуюся команду:
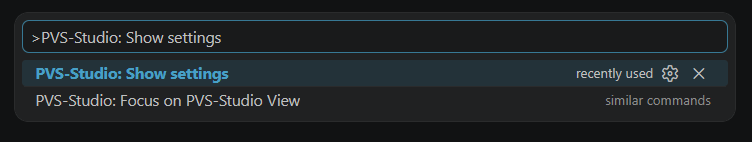
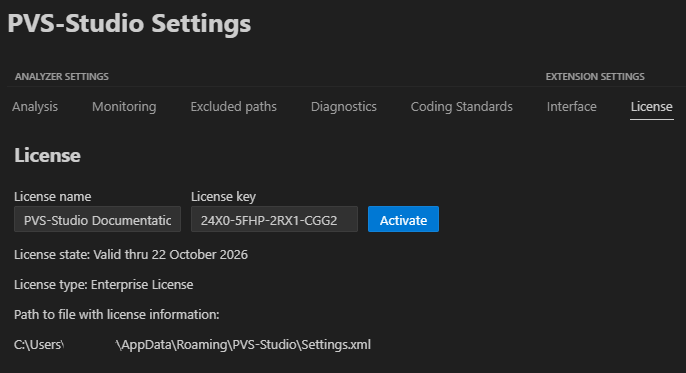
В открывшемся окне выберите вкладку License:
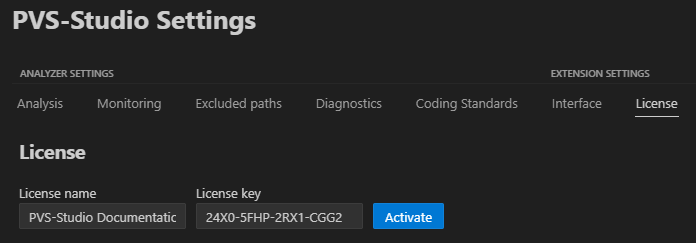
В поле License name укажите имя лицензии анализатора, привязанное к ключу, а в License key — лицензионный ключ. Если введённые данные валидны, отобразится сообщение с информацией о лицензии:
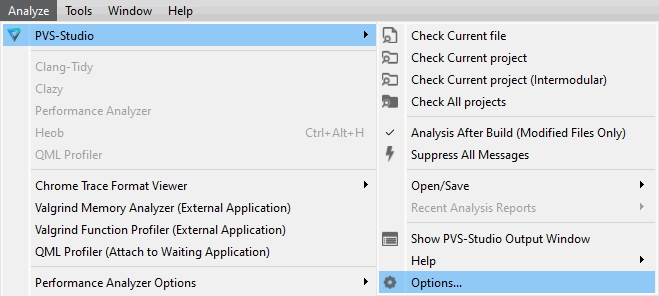
Для ввода лицензии в Qt Creator перейдите в Analyze > PVS-Studio > Options...
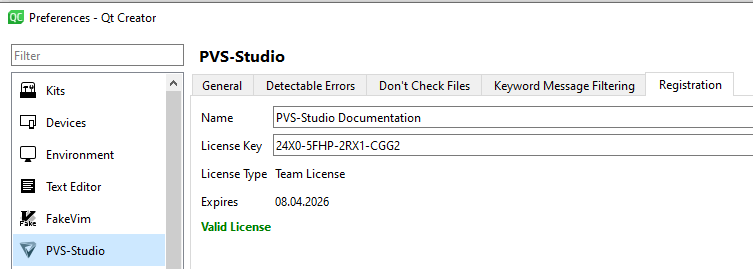
Далее выберите PVS-Studio и откройте вкладку Registration. В поле Name укажите имя лицензии анализатора, привязанное к ключу, а в License Key — лицензионный ключ. Если введённые данные валидны, отобразится сообщение с информацией о лицензии:
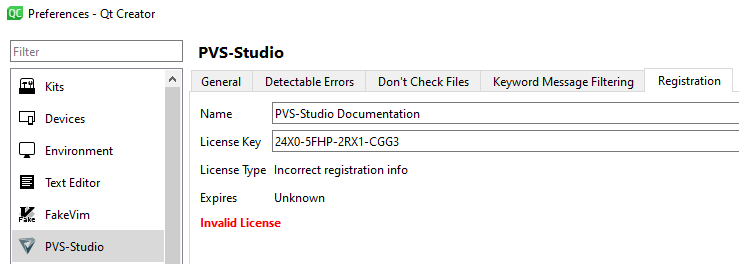
В случае если введённые данные лицензии невалидны, также отобразится уведомление об этом:
Для подтверждения и сохранения введённой лицензии нажмите кнопку Apply или OK.
На Windows, если нет возможности ввести лицензию через GUI, можно воспользоваться анализатором в специальном режиме.
Строка запуска может выглядеть следующим образом:
PVS-Studio_Cmd.exe credentials --userName %LICENSE_NAME% ^
--licenseKey %LICENSE_KEY%Вместо переменной LICENSE_NAME укажите имя лицензии анализатора, привязанное к ключу, а вместо LICENSE_KEY — лицензионный ключ.
При таком запуске анализатор запишет лицензию в файл настроек с расположением по умолчанию: %APPDATA%/PVS-Studio/Settings.xml. Если файла настроек не существует, он будет создан. Используя флаг --settings, укажите путь до файла настроек, если он находится в нестандартном расположении.
С помощью флага --licInfo можно получить информацию о текущей лицензии.
При использовании анализатора на платформах Linux/macOS, когда нет возможности ввести лицензию через GUI, используется специальная утилита pvs-studio-analyzer.
На Linux/macOS строка запуска может выглядеть следующим образом:
pvs-studio-analyzer credentials ${LICENSE_NAME} ${LICENSE_KEY}Вместо переменной LICENSE_NAME укажите имя лицензии анализатора, привязанное к ключу, а вместо LICENSE_KEY — лицензионный ключ.
При таком запуске анализатор запишет лицензию в файл настроек с расположением по умолчанию: ~/.config/PVS-Studio/PVS-Studio.lic. Если файл настроек не существует, он будет создан.
С помощью флага lic-info можно получить информацию о текущей лицензии:
pvs-studio-analyzer lic-infoПоскольку Java анализатор может быть установлен независимо от других компонентов PVS-Studio, активировать лицензию можно через плагины для сборочных систем (Maven и Gradle) и ядро Java анализатора.
При использовании Maven команда для ввода лицензии может выглядеть следующим образом:
mvn pvsstudio:pvsCredentials "-Dpvsstudio.userName=${LICENSE_NAME}" \
"-Dpvsstudio.licenseKey=${LICENSE_KEY}"При использовании Gradle активация происходит с помощью следующей команды:
./gradlew pvsCredentials "-Ppvsstudio.userName=${LICENSE_NAME}" \
"-Ppvsstudio.licenseKey=${LICENSE_KEY}"При использовании ядра Java анализатора из консоли активировать лицензию можно командой:
java -jar pvs-studio.jar --activate-license --user-name $LICENSE_NAME \
--license-key $LICENSE_KEYВместо переменной LICENSE_NAME укажите имя лицензии анализатора, привязанное к ключу, а вместо LICENSE_KEY — лицензионный ключ.
Способы запуска анализатора описаны на соответствующих страницах:
После загрузки дистрибутива PVS-Studio и запроса ключа для знакомства с инструментом, вы получаете полнофункциональную версию, которая работает одну неделю. В этой версии нет совершенно никаких ограничений – это абсолютно полноценная лицензия. При заполнении формы вы можете выбрать, какой тип лицензии хотели бы испробовать: Team License или Enterprise License.
Отличия Enterprise License от Team License представлены на этой странице.
Если вам не хватило недели на знакомство с инструментом – просто напишите нам об этом в ответном письме. И мы пришлем еще один ключ.
PVS-Studio работает на Windows (x86-64 и ARM), Linux (x86-64) и macOS (Intel и Apple Silicon). Поддерживается анализ кода для кроссплатформенных компиляторов, предназначенных для 32-битных, 64-битных, встраиваемых ARM платформ и других.
PVS-Studio требует как минимум 2 GB оперативной памяти (рекомендуется 4 GB и больше) для каждого процессорного ядра, когда анализатор работает на многоядерной системе (чем больше ядер, тем быстрее работает анализ кода).
Список поддерживаемых анализатором языков программирования и компиляторов доступен здесь.
Минимально поддерживаемая версия GCC — 4.2.
Плагин PVS-Studio может быть интегрирован в:
Для всех IDE (кроме IDEA и Android Studio) необходимо иметь в системе установленное ядро анализатора для соответствующего языка (C, C++, C# или Java).
Поддерживаются Windows 11, Windows 10, Windows 8, Windows Server 2019, Windows Server 2016 и Windows Server 2012. PVS-Studio работает как на 64-битных версиях Windows, так и на версиях для ARM.
Для работы PVS-Studio требуется .NET Framework версии 4.7.2 или выше (будет автоматически установлен при установке PVS-Studio, если подходящей версии нет в системе).
Для анализа .NET, .NET Standard и .NET Framework SDK-style проектов требуется .NET SDK 9.0. Для анализа классических .NET Framework проектов достаточно .NET Framework 4.7.2 при наличии установленных в системе Visual Studio или MSBuild версий 2017, 2019, 2022 или 2026.
Плагин PVS-Studio может быть интегрирован в Microsoft Visual Studio 2026, 2022, 2019, 2017, 2015, 2013, 2012, 2010. Для анализа C и C++ кода для встраиваемых систем соответствующие компиляторы должны быть установлены в системе, на которой запускается анализатор.
Примечание: интеграция с Visual Studio 2022 для версий 17.12 и выше поддерживается, начиная с версии PVS-Studio 7.33.
PVS-Studio работает в 64-битных дистрибутивах Linux с ядром версий 3.2.0 и выше. Для анализа C и C++ проектов для Linux, кроссплатформенных приложений или встраиваемых систем, соответствующие компиляторы должны быть установлены в системе. Для утилиты оповещения команд разработчиков blame-notifier должен быть установлен .NET Runtime 10.0.
Список протестированных дистрибутивов, на которых работа PVS-Studio гарантируется:
Анализаторы PVS-Studio были проверены на совместимость и корректную работу с операционными системами РЕД ОС 7.3 и РЕД ОС 8.
PVS-Studio работает на процессорах Intel (x86-64) и Apple Silicon (arm64) в macOS 11.1 Big Sur и выше. Для анализа C и C++ кода соответствующие компиляторы должны быть установлены в системе. Для утилиты оповещения команд разработчиков blame-notifier должен быть установлен .NET Runtime 10.0.
Для работы Java анализатора требуется JRE версий от 11 до 25. Версия используемой JRE для анализа должна быть не ниже целевой версии JDK анализируемого проекта.
Плагины для Gradle и Maven работают с JDK версий от 8 до 25. При анализе проекта на Java 8 через Gradle или Maven необходимо указать путь до Java 11 в PATH или использовать аргумент javaPath. Более подробно об этом указано в документации к Maven и Gradle плагинам.
Для работы pvs-js требуется Node.Js версии от 18 и до 24, npm и С++ анализатор PVS-Studio.
pvs-golang поддерживает анализ проектов до Go 1.26 включительно.
Установленная в системе версия Go должна быть не ниже версии Go анализируемого проекта.
На данный момент версия pvs-golang для платформы Apple Intel не поддерживается.
Инструментальное средство PVS-Studio разрабатывается с учётом требований, предъявляемых к статическим анализаторам в ГОСТ Р 71207—2024. Выявляет критические ошибки и может использоваться при разработке безопасного программного обеспечения по ГОСТ Р 56939—2024. Рассмотрим функциональные возможности, реализованные в PVS-Studio на начало 2026 года в отношении анализа исходного кода программного обеспечения, написанного на компилируемых языках программирования: C, C++, C#, Java.
ГОСТ Р 71207—2024 — РАЗРАБОТКА БЕЗОПАСНОГО ПРОГРАММНОГО ОБЕСПЕЧЕНИЯ. Статический анализ программного обеспечения. Общие требования. Разработан ФСТЭК России и ИСП РАН. Впервые введён в действие 01.04.2024.
Ссылка на ГОСТ на сайте ФГБУ "Институт стандартизации": ГОСТ Р 71207—2024.
Обзор стандарта: ГОСТ Р 71207—2024 глазами разработчика статических анализаторов кода.
Примечание. Приводимые далее в тексте ссылки на разделы и пункты (п. x.x.x) относятся к стандарту ГОСТ Р 71207—2024. Если пункты относятся к другому стандарту или указу, он будет отмечен.
Стандарт устанавливает требования к:
Входит в комплекс стандартов, направленных на предотвращение уязвимостей в программах, и применяется совместно с ГОСТ Р 56939.
Критическая ошибка в программе. Термин введён в ГОСТ Р 71207—2024 (п. 3.1.13). Это ошибка, которая может привести к нарушению безопасности обрабатываемой информации. С точки зрения безопасности это ошибки, которые должны обнаруживаться и исправляться в первую очередь.
Статические анализаторы должны выявлять следующие виды критических ошибок в коде программ на компилируемых языках (п. 6.3):
Дополнительно для C и C++ (п. 6.5):
Примечание. Набор требований ГОСТ по обнаружению критических ошибок совпадает для языков C и C++. Анализатор PVS-Studio использует общее ядро для анализа программ на этих языках, поэтому далее для сокращения текста эти языки будут рассматриваться вместе, а не по отдельности.
PVS-Studio. Инструментальное средство статического анализа кода, разрабатываемое с учётом требований, изложенных в ГОСТ Р 71207—2024. Выявляет все виды критических ошибок, перечисленных в стандарте (п. 6.3, п. 6.5), и может использоваться для предотвращения появления и устранения уязвимостей при разработке безопасного ПО (РБПО).
Поддерживает языки: C, C++, C#, Java, Go, JavaScript, TypeScript.
Запускается на большом количестве ОС, в том числе отечественных: Windows, macOS, Arch Linux, Astra Linux, CentOS, Debian GNU/Linux, Fedora, Linux Mint, openSUSE, Ubuntu, РЕД ОС и т.д.
Подтверждена техническая совместимость анализатора PVS-Studio с Astra Linux. Сертификат №31190/2025.
Анализатор содержит пять ядер:
Анализатор удовлетворяет требованиям ГОСТ Р 71207—2024 к методам анализа (раздел 7), что обеспечивает выявление всех видов критических ошибок для поддерживаемых языков. Выполняются требования, изложенные в разделе 8, такие как: выдача результатов в открытых форматах (например, SARIF), указание соответствия типа ошибки согласно системе классификации MITRE CWE и так далее.
Инструмент разрабатывается в России с 2008 года (запись в Едином Реестре российского ПО №9837) и содержит более 1000 диагностических правил. Возможно использование в полностью закрытом контуре. Является SAST-решением.
В 2025 году команда PVS-Studio приняла участие в испытаниях статических анализаторов исходных кодов компилируемых и динамических языков программирования под руководством ФСТЭК России.
В испытаниях участвовали:
Хронология испытаний:
Итоги испытаний были подведены в декабре 2025 года на открытой конференции ИСП РАН. С записью соответствующих докладов можно познакомиться здесь (06:05:10 — приблизительно начало).
Соответствующие презентации лежат здесь (в папке 2. 16-17 Стат. анализаторы).
Из-за сложности поставленных задач и большого объёма работ многое из намеченного во время испытаний не удалось реализовать и завершить. В целом все анализаторы продемонстрировали возможность выявления критических ошибок, перечисленных в стандарте. Все инструменты возможно запускать на отечественных операционных системах, анализировать большие проекты и т. д.
См. также публикацию Андрея Карпова: "Кратко об итогах испытаний статических анализаторов исходного кода в 2025 году".
Потому на момент написания данного текста нет принципиальных изменений в том, какие анализаторы можно и нужно использовать при построении процессов безопасной разработки ПО.
По-прежнему актуальна методическая рекомендация ФСТЭК № 2025-07-011. Можно выбирать разные удобные вам инструменты, обращая внимание на отмеченные в рекомендации нюансы. Также смотрите выдержку из эфира AM Live "Разработка безопасного программного обеспечения (РБПО)".
На начало 2026 года PVS-Studio поддерживает анализ кода программ, написанных на языках программирования C, C++, C#, Java.
В ГОСТ Р 71207—2024 (п. 7.4) перечислены методы, которые должен реализовывать статический анализатор. PVS-Studio реализует все эти методы.
|
Виды анализа (п. 7.4) |
C и C++ |
C# |
Java |
|---|---|---|---|
|
Внутрипроцедурный анализ потоков данных и управления |
✓ |
✓ |
✓ |
|
Межпроцедурный и межмодульный контекстно-чувствительный анализ потока данных |
✓ |
✓ |
✓ |
|
Чувствительный к путям выполнения анализ потоков данных и управления |
✓ |
✓ |
✓ |
|
Межпроцедурный и межмодульный контекстно-чувствительный анализ помеченных данных |
✓ |
✓ |
✓ |
|
Анализ программы на синтаксическом уровне |
✓ |
✓ |
✓ |
Таблица N1. Виды анализа, которые должен реализовывать статический анализатор кода согласно ГОСТ Р 71207—2024 (п. 7.4). Данные приведены для анализатора PVS-Studio на начало 2026 года
Также в стандарте (п. 7.4) перечислены вспомогательные методы анализа, которые может реализовывать инструмент для поиска дополнительных типов ошибок. PVS-Studio поддерживает следующие из них.
|
Необязательные вспомогательные виды анализа (п. 7.4) |
C и C++ |
C# |
Java |
|---|---|---|---|
|
Сигнатурный поиск |
✓ |
✓ |
✓ |
|
Анализ псевдонимов |
✓ |
✓ |
|
|
Анализ косвенных вызовов |
✓ |
||
|
Статистический анализ |
✓ |
✓ |
✓ |
|
Анализ иерархии классов |
✓ |
✓ |
✓ |
Таблица N2. Виды анализа, которые, согласно ГОСТ Р 71207—2024 (п. 7.4), следует использовать в качестве вспомогательных методов. Данные приведены для анализатора PVS-Studio на начало 2026 года
Разберём перечисленные методы более подробно и приведём примеры их использования.
Согласно ГОСТ (п 3.1.6) анализ программы на синтаксическом уровне — это статический анализ, при котором обрабатывается представление программы, полностью отражающее её синтаксическую структуру, например абстрактное синтаксическое дерево.
Хотя этот вид анализа приводится в списке последним, мы начнём именно с него, так как он является основой для всех остальных. Без разбора кода на синтаксическом уровне и построения абстрактного синтаксического дерева невозможно проведение полноценного анализа кода. Более того, обязательным также является и семантический анализ, позволяющий вывести типы данных и другую информацию, требуемую для реализации подавляющего числа диагностических правил.
В PVS-Studio все диагностические правила для всех языков работают с деревом, полученным в ходе синтаксического анализа кода. Поэтому примером использования анализа программы на синтаксическом уровне может являться любое из них.
Редчайшим исключением являются несколько диагностических правил, работающих на уровне лексем. Примером такого исключения является поиск невидимых символов, позволяющих проводить атаку Trojan Source.
Для C и C++ построение дерева осуществляется собственным парсером, написанным на языке C++ и развиваемым силами команды PVS-Studio. Наши доклады и статьи на эту тему:
Работа с C# кодом базируется на использовании .NET Compiler Platform (Roslyn). Наши доклады и статьи на эту тему:
Работа с Java кодом базируется на использовании Spoon. Наши статьи на эту тему:
Синтаксический анализ — неотъемлемая часть всех диагностических правил, реализованных в PVS-Studio для всех поддерживаемых языков. Поэтому разберём только один пример.
Ошибка была найдена с помощью PVS-Studio в проекте LLVM (язык C++) и описана в этой статье.
std::unique_ptr<OptionDefinition> m_options_definition_up;
....
Status SetOptionsFromArray(StructuredData::Dictionary &options) {
Status error;
m_num_options = options.GetSize();
m_options_definition_up.reset(new OptionDefinition[m_num_options]);
....
}Предупреждение PVS-Studio: V554 Incorrect use of unique_ptr. The memory allocated with 'new []' will be cleaned using 'delete'. CommandObjectCommands.cpp 1384
Умный указатель m_options_definition_up ориентирован на хранение одиночного элемента, но туда помещается указатель на массив. Результат — неопределённое поведение в момент разрушения объекта. Корректный вариант кода:
std::unique_ptr<OptionDefinition []> m_options_definition_up;Чтобы найти эту ошибку, необходимо в момент вызова функции reset иметь информацию, какой тип у переменной m_options_definition_up. Эта информация собирается при обходе дерева, построенного с помощью синтаксического разбора кода и механизма вывода типов переменных.
Определения:
Анализ потоков данных позволяет анализатору PVS-Studio делать предположения о значениях переменных и выражений в различных частях исходного кода. Некоторые виды предполагаемых значений:
Бывают и более сложные виды данных, сопоставляемые с какой-то переменной. Например, анализатор может знать, что указатель находится в одном из следующих состояний:
Анализ потока управления в PVS-Studio неразрывно связан с анализом потока данных. Поясним это примером на языке C++:
void foo()
{
int A = 1;
int B = 2;
if (A == 3)
{
B = 0;
}
A = 10 / B;
}В момент проверки (A == 3) анализатор благодаря анализу потока данных знает, что условие будет всегда ложным, так как переменная A равна 1. Следовательно, с точки зрения потока управления тело оператора if не выполняется, и переменной B не может быть присвоено значение 0.
Информация о потоке выполнения (что не выполняется код, где 0 записывается в переменную B) влияет на поток данных. Известно, что значение переменной B остаётся равно 2. Следовательно, деление 10 / B всегда безопасно, и анализатор не выдаёт предупреждение о потенциальном делении на ноль.
Анализ потоков данных и управления так или иначе участвует почти во всех алгоритмах выявления критических ошибок. Например, именно благодаря ему удаётся определить, каков размер массива, и происходит ли в определённой ветке кода запись за его границу.
Механизмы анализа потока данных схоже реализованы в PVS-Studio для всех языков и нет смысла их рассматривать отдельно. Дальнейшие разделы созданы с целью разделить ссылки на публикации и примеры для разных языков.
Хорошим примером использования внутрипроцедурного анализа потоков данных и управления является выявление ошибки в проекте Protocol Buffers (protobuf), которая описана в статье "31 февраля".
static const int kDaysInMonth[13] = {
0, 31, 28, 31, 30, 31, 30, 31, 31, 30, 31, 30, 31
};
bool ValidateDateTime(const DateTime& time) {
if (time.year < 1 || time.year > 9999 ||
time.month < 1 || time.month > 12 ||
time.day < 1 || time.day > 31 ||
time.hour < 0 || time.hour > 23 ||
time.minute < 0 || time.minute > 59 ||
time.second < 0 || time.second > 59) {
return false;
}
if (time.month == 2 && IsLeapYear(time.year)) {
return time.month <= kDaysInMonth[time.month] + 1;
} else {
return time.month <= kDaysInMonth[time.month];
}
}Функция ValidateDateTime принимает на вход дату и должна определить, корректна она или нет. Вначале выполняются основные проверки. Проверяется, что номер месяца лежит в диапазоне [1..12], дни находятся в диапазоне [1..31], минуты находятся в диапазоне [0..59] и так далее.
Затем идёт более сложная проверка: есть ли определённый день в определённом месяце. Чтобы проверить дни, используется вспомогательный массив kDaysInMonth. В массиве записано количество дней в различных месяцах. По номеру месяца из массива извлекается максимальное количество дней, которое и используется для проверки.
Дополнительно учитывается, что год может быть високосным, и тогда в феврале на один день больше.
Из-за опечатки дни проверяются неправильно. Обратите внимание, что с максимально возможным количеством дней в месяце сравнивается не день, а месяц.
if (time.month == 2 && IsLeapYear(time.year)) {
return time.month <= kDaysInMonth[time.month] + 1;
} else {
return time.month <= kDaysInMonth[time.month];
}В сравнениях "time.month <= ...." следует использовать day, а не month.
Номер месяца (от 1 до 12) всегда меньше количества дней в любом из месяцев.
Из-за этой ошибки корректными будут считаться такие дни, как 31 февраля или 31 ноября.
Предупреждения PVS-Studio:
Обнаружение этой ошибки возможно благодаря одновременной работе анализа потоков данных и управления.
Если значение месяца лежит вне диапазона [1..12], то функция завершает работу. Следовательно, анализ потока управления будет выполняться дальше только в том случае, если значение переменной time.month лежит в диапазоне [1..12].
Анализатор заглядывает внутрь массива и понимает, что оттуда извлекаются значения в диапазоне [28..31]. Он учитывает, что 0 из массива kDaysInMonth не извлекается, так как возможный диапазон time.month, используемый в качестве индекса, равен [1..12].
В итоге анализатор видит, что происходят следующие сравнения диапазонов:
Условия всегда истинны, о чём анализатор и выдаёт предупреждения.
Почему первый диапазон [2..2] представлен только одним числом 2? Дело в том, что учитывается уточняющее условие time.month == 2.
Наши доклады и статьи на тему анализа потока данных C++ кода:
Пример для C# будет проще, но фактически всё работает аналогичным образом. Аномалия была выявлена в проекте Unity3D.
public NetworkConnection Get(int connId)
{
if (connId < 0)
{
return m_LocalConnections[Mathf.Abs(connId) - 1];
}
if (connId < 0 || connId > m_Connections.Count)
....
}Предупреждение PVS-Studio: V3063 A part of conditional expression is always false: connId < 0. ConnectionArray.cs 59
Если первое условие выполнилось (connId < 0), то поток управления прерывается (происходит выход из функции с помощью оператора return). Следовательно, функция продолжит выполнение только в том случае, если значение переменной connId больше или равно 0.
Анализ потока данных учитывает тот факт, что connId >= 0, и на его основе диагностическое правило V6063 делает вывод, что часть условия всегда ложна.
Наши публикации на тему анализа потока данных C# кода:
При создании ядра для анализа языка Java был переиспользован механизм анализа потока данных и управления, реализованный в ядре C++ анализатора. То есть Java анализатор использует часть функциональности C++ анализатора с помощью SWIG (средство для автоматической генерации врапперов и интерфейсов для связывания программ на C и C++ с программами, написанными на других языках).
Это позволило быстрее разработать первую версию Java анализатора, однако повлекло за собой ряд сложностей и усложнение процесса дальнейшего развития. Например, достаточно неудобно отлаживать код из-за этой связки: правки C++ ядра могут неожиданно влиять на Java анализатор и так далее.
Поэтому наша команда в 2025 году начала делать параллельный механизм анализа потока данных, который забирает на себя функции C++ ядра и постепенно полностью его заменит.
Использование анализа потоков данных и управления для Java кода будет показано на примере ошибки в проекте GeoGebra.
private void updateOrdering(GeoElement geo, ObjectMovement movement) {
....
if (index == firstIndex) {
if (index != 0) {
geo.setOrdering(orderingDepthMidpoint(index));
}
else {
geo.setOrdering(drawingOrder.get(index - 1).getOrdering() - 1);
}
}
....
}Предупреждение PVS-Studio: V6025 Index 'index - 1' is out of bounds. LayerManager.java 393
Анализируя поток управления, анализатор знает, что:
geo.setOrdering(drawingOrder.get(index - 1).getOrdering() - 1);Выполняется только в том случае, если переменная index равна 0. Следовательно, фактическим аргументом, передаваемым в функцию get, будет значение -1. Результат: генерация исключения типа IndexOutOfBoundsException.
Определения:
Статические анализаторы кода могут учитывать данные, которые передаются между процедурами/функциями, чтобы выявить больше критических ошибок. Это важно при выявлении таких ошибок, как утечки памяти, разыменование нулевых указателей, выход за границы массивов и так далее. Это связано с тем, что создание некого ресурса, его использование и освобождение часто разнесены по разным функциях.
Для выявления ошибок, возникающих при взаимодействии нескольких процедур, статические анализаторы используют технологию межпроцедурного контекстно-чувствительного анализа кода.
Ситуация усложняется, если требуется анализировать взаимодействие функций, находящихся в различных единицах трансляции/программных модулях. В этом случае говорят, что выполняется межмодульный анализ.
PVS-Studio реализует межпроцедурный и межмодульный контекстно-чувствительный анализ потока данных для всех поддерживаемых языков. Однако межмодульный анализ С и C++ более сложен по сравнению с C# и Java, так как требует дополнительных действий по объединению информации, получаемой из различных единиц трансляции.
Межмодульный анализ в PVS-Studio для С и C++ выполняется в три этапа:
Наши доклады и статьи на эту тему:
В начале синтетический пример:
int get(int a, int b = 7)
{
return a + 2 - b;
}
int main()
{
int a = 5;
auto divider = get(a);
return a / divider;
}PVS-Studio выдаёт предупреждение: V609 Divide by zero. Denominator 'divider' == 0.
Это возможно благодаря тому, что анализатор подсчитал возвращаемое значение функцией get на основании переданных ей аргументов. Если поменять фактические аргументы, то предупреждение о делении на ноль исчезнет:
int main()
{
int a = 5;
auto divider = get(a, 1);
return a / divider;
}Зато выявляется другой дефект: результат деления 5/6 не имеет смысла, так как в результате целочисленного деления всегда будет получаться 0. Про это будет другое предупреждение: V1064 The 'a' operand of integer division is less than the 'divider' one. The result will always be zero.
Теперь рассмотрим пример ошибки, найденной с помощью межмодульного контекстно-чувствительного анализа инструментом PVS-Studio в коде проекта Midnight Commander (язык C).
Начнём с функции widget_destroy в файле widget-common.c:
void widget_destroy (Widget * w)
{
send_message (w, NULL, MSG_DESTROY, 0, NULL);
g_free (w);
}Функция освобождает буфер памяти, адрес которого она получает через аргумент w.
Теперь посмотрим на код в файле editcmd.c:
gboolean edit_close_cmd (WEdit * edit)
{
Widget *w = WIDGET (edit);
....
widget_destroy (w); // <= Здесь освободили память
if (....) .... else
{
edit = find_editor (DIALOG (g));
if (edit != NULL)
widget_select (w); // <= Передаём указатель дальше
}
}Обратите внимание, что в начале адрес структуры Widget передаётся в функцию widget_destroy, где происходит освобождение буфера памяти. Далее этот указатель передаётся в функцию widget_select, приведённую ниже:
void widget_select (Widget * w)
{
WGroup *g;
if (!widget_get_options (w, WOP_SELECTABLE))
return;
....
}Она просто передаёт указатель дальше в функцию widget_get_options:
static inline gboolean
widget_get_options (const Widget * w, widget_options_t options)
{
return ((w->options & options) == options);
}Здесь мы добрались до места, где возникает неопределённое поведение, связанное с использованием данных в уже освобождённом буфере памяти. Анализатор PVS-Studio сигнализирует об этом предупреждением: V774 The 'w' pointer was used after the memory was released.
.NET Compiler Platform предоставляет инфраструктуру для работы сразу со всеми файлами исходного кода, включёнными в проект. Это делает межмодульный анализ C# кода более простым в реализации, чем в случае с C++.
Рассмотрим два примера реального кода, первый из которых хорошо демонстрирует суть контекстно-чувствительного анализа, а второй — межмодульного анализа.
Первая ошибка найдена в проекте AvalonStudio. Рассмотрим вначале функцию IsBuiltInType. Обратите внимание, что если её входной аргумент cursor окажется нулевой ссылкой, то функция вернёт значение false. Другими словами, результат работы функции зависит от контекста её вызова.
private static bool IsBuiltInType(ClangType cursor)
{
var result = false;
if (cursor != null && ....)
{
return true;
}
return result;
}Теперь рассмотрим другой фрагмент кода, где вызывается рассмотренная функция:
private static StyledText InfoTextFromCursor(ClangCursor cursor)
{
....
if (cursor.ResultType != null)
{
result.Append(cursor.ResultType.Spelling + " ",
IsBuiltInType(cursor.ResultType) ? theme.Keyword
: theme.Type);
}
else if (cursor.CursorType != null)
{
switch (kind)
{
....
}
result.Append(cursor.CursorType.Spelling + " ",
IsBuiltInType(cursor.ResultType) ? theme.Keyword
: theme.Type);
}
....
}Если cursor.ResultType != null, то выполняется тело первого оператора if. Соответственно, если управление будет предано внутрь тела второго оператора if, то точно известно, что ссылка cursor.ResultType является нулевой.
Изучим место вызова рассмотренной ранее функции IsBuiltInType:
result.Append(cursor.CursorType.Spelling + " ",
IsBuiltInType(cursor.ResultType) ? theme.Keyword
: theme.Type);Анализатор знает, что cursor.ResultType — нулевая ссылка. Из этого он делает вывод, что при таком входном аргументе функция всегда возвращает false.
Это и есть межпроцедурный контекстно-чувствительный анализ.
Если условие тернарного оператора всегда ложно, то это подозрительно, о чём анализатор и сообщает, выдавая предупреждение: V3022 Expression 'IsBuiltInType(cursor.ResultType)' is always false.
Действительно, если присмотреться к коду, то можно заметить опечатку. В теле второго оператора if при вызове функции IsBuiltInType в качестве фактического аргумента следует передать переменную cursor.CursorType.
Рассмотрим второй пример кода из игры Starlight, где для выявления ошибки требуется межмодульный анализ. Здесь задействовано три файла:
protected override IEnumerable<Progress> ScanInternal ()
{
....
TriangleMeshNode.SetNavmeshHolder(
AstarPath.active.data.GetGraphIndex(this), this);
....
}Предупреждение PVS-Studio: V3106 The 1st argument 'AstarPath.active.data.GetGraphIndex(this)' is potentially used inside method to point beyond collection's bounds. NavMeshGenerator.cs 225
Анализатор сообщает, что внутри метода TriangleMeshNode.SetNavmeshHolder происходит доступ по индексу за пределами допустимого диапазона. При этом в качестве индекса выступает первый аргумент.
Взглянем на метод AstarPath.active.data.GetGraphIndex:
public int GetGraphIndex (NavGraph graph) {
if (graph == null) throw new System.ArgumentNullException("graph");
var index = -1;
if (graphs != null) {
index = System.Array.IndexOf(graphs, graph);
if (index == -1) Debug.LogError("Graph doesn't exist");
}
return index;
}Как мы видим, метод может вернуть в качестве результата -1. Теперь взглянем на метод TriangleMeshNode.SetNavmeshHolder:
public static void SetNavmeshHolder (int graphIndex, INavmeshHolder graph) {
// We need to lock to make sure that
// the resize operation is thread safe
lock (lockObject) {
if (graphIndex >= _navmeshHolders.Length) {
var gg = new INavmeshHolder[graphIndex+1];
_navmeshHolders.CopyTo(gg, 0);
_navmeshHolders = gg;
}
_navmeshHolders[graphIndex] = graph; // <=
}
}Анализатор сообщает, что проблемный доступ происходит на последней строке. Доступ по индексу происходит без предварительной проверки.
Библиотека Spoon предоставляет инфраструктуру для работы сразу со всеми файлами исходного кода, входящими в проект. Это делает межмодульный анализ Java кода схожим с анализом C# кода и более простым в реализации по сравнению с C++.
Для Java анализатора нашей командой пока собрано мало случаев реальных ошибок в открытых проектах, из которых можно подбирать примеры. Рассмотрим синтетический пример:
class Main {
static class NetworkTextTransmitter {
private final Socket socket = new Socket();
private final PrintWriter socketWriter;
public NetworkTextTransmitter(InetSocketAddress host,
InetSocketAddress source)
throws IOException {
socket.bind(host);
socket.connect(source);
socketWriter = new PrintWriter(socket.getOutputStream());
}
public void transmit(String message) {
socketWriter.println(message);
}
....
public void closeConnection() {
socketWriter.close();
}
}
public static void main(String[] args) throws IOException {
....
InetSocketAddress hostAddress =
new InetSocketAddress(Integer.parseInt(args[0]));
InetSocketAddress sourceAddress =
new InetSocketAddress(Integer.parseInt(args[1]));
NetworkTextTransmitter textTransmitter =
new NetworkTextTransmitter(hostAddress, sourceAddress);
Scanner scanner = new Scanner(System.in);
for (int i = 0; i < Integer.parseInt(args[0]); i++) {
textTransmitter.transmit(scanner.next());
}
textTransmitter.closeConnection();
}Предупреждение PVS-Studio: V6114 The 'NetworkTextTransmitter' class contains the 'socket' Closeable field, but the resources that the field is holding are not released inside the class. Main.java 10
Пример демонстрирует использование информации о состоянии класса (контекстно-чувствительный анализ) в процессе взаимодействия с ним (межпроцедурный анализ).
Программа выполняет передачу текстовых сообщений по сетевому подключению через сокет. Текстовые сообщения вводятся через консоль и передаются по подключению. Для передачи сообщений используется класс NetworkTextTransmitter, который создаёт подключение и поток передачи. По завершении передачи N сообщений метод main вызывает метод closeConnection. Внутри данного метода закрывается только поток передачи текстовых данных, однако само подключение через сокет остаётся открытым.
Согласно ГОСТ чувствительный к путям выполнения анализ (3.1.36) — это статический анализ программы, при котором могут быть определены её свойства, проявляющиеся лишь на некоторых путях выполнения программы, и условия (или часть условий), при обращении которых в истину выполнение программы пойдёт по указанному анализатором пути.
Не очень понятно, почему стандарт выделяет чувствительность к путям выполнения в отдельный вид анализа потока данных и управления. На наш взгляд, анализ потока данных (п 3.1.4) и анализ потока управления (п 3.1.5) уже подразумевают учёт путей выполнения кода. В противном случае, если не учитывать пути выполнения, эти виды анализа становятся вырожденными и почти непригодными к практическому применению.
Возможно, стандарт содержит не очень удачную формулировку или не даёт дополнительных пояснений и примеров.
Мы интерпретируем этот вид анализа следующим образом: стандарт предлагает учитывать те ситуации, когда некоторое действие может как произойти, так и не произойти. Следует выдавать предупреждение с учётом того, что выполнение программы пойдёт по пути, приводящему к ошибке.
Поясним нашу интерпретацию синтетическим примером на языке C++:
void foo(bool A)
{
int *B = new int;
if (A)
{
delete B;
}
*B = 1;
}Если условие выполнится, то анализатор должен выдать предупреждение о том, что происходит запись в уже освобождённую память.
Если условие не выполнится, то анализатор должен выдать предупреждение об утечке памяти.
Если анализатор может вычислить с помощью межпроцедурного и межмодульного контекстно-чувствительного анализа потока данных, чему равна переменная A, то он должен выдать одно из двух предупреждений.
Если вычислить значение A невозможно или известно, что оно может быть как false, так и true, то помогает анализ потоков данных и управления, чувствительный к путям выполнения. Анализатор должен выдать оба предупреждения, по возможности показав пути выполнения программы, приводящие к ним.
Анализатор PVS-Studio использует чувствительный к путям выполнения анализ потоков данных, но не выделяет его в отдельную сущность или алгоритм. Фактически все три рассмотренные виды анализа:
Реализуются в каждом языковом ядре PVS-Studio в виде единого механизма (алгоритма).
Ошибка, используемая в качестве примера, была найдена в проекте MPC-HC (С++):
void CSyncAP::RenderThread()
{
....
REFERENCE_TIME rtRefClockTimeNow;
if (m_pRefClock) {
m_pRefClock->GetTime(&rtRefClockTimeNow);
}
LONG lLastVsyncTime =
(LONG)((m_llEstVBlankTime - rtRefClockTimeNow) / 10000);
....
}Предупреждение PVS-Studio: V614 Potentially uninitialized variable 'rtRefClockTimeNow' used. syncrenderer.cpp 3604
Переменная rtRefClockTimeNow останется неинициализированной, если указатель m_pRefClock является нулевым. Соответственно, возможен путь выполнения программы, приводящий к ошибке — использованию неинициализированной переменной. Однако этого может и не произойти, поэтому анализатор сообщает о потенциальной ошибке. Таким образом, анализ здесь чувствителен к путям выполнения.
В случае, если переменная не инициализирована всегда, анализатор будет более категоричен. Код из проекта Trans-Proteomic Pipeline (язык С++):
double mscore_c::dot_hr(unsigned long *_v)
{
....
int iSeqSize;
for (int a = 0; a < iSeqSize; a++) {
....
}Здесь нет вариантов, поэтому PVS-Studio выдаёт предупреждение: V614 Uninitialized variable 'iSeqSize' used. mscore_c.cpp 552
Ошибка была обнаружена нами в проекте RunUO:
public static string ConstructFromString( .... )
{
object toSet;
bool isSerial = IsSerial( type );
if ( isSerial ) // mutate into int32
type = m_NumericTypes[4];
if ( IsEnum( type ) )
{
try
{
toSet = Enum.Parse( type, value, true ); // <= (А)
}
catch
{
return "That is not a valid enumeration member.";
}
}
else if ( IsType( type ) )
{
try
{
toSet = ScriptCompiler.FindTypeByName( value ); // <= (Б)
if ( toSet == null )
return "No type with that name was found.";
}
catch
{
return "No type with that name was found.";
}
}
....
else if ( value == null )
{
toSet = null; // <= (В)
}
....
if ( isSerial ) // mutate back
toSet = (Serial)((Int32)toSet);
constructed = toSet;
return null;
}Переменной toSet могут присваиваться как ссылки на существующие объекты (точки: А, Б), так и нулевая ссылка (точка В). Анализатор чувствителен к тому, что существуют эти различные пути выполнения, и предупреждает, что ссылка потенциально может оказаться нулевой.
Предупреждение PVS-Studio: V3148 Casting potential 'null' value of 'toSet' to a value type can lead to NullReferenceException. Properties.cs 502
Рассмотрим ошибку возможного разыменования нулевой ссылки в проекте Keycloak:
private void checkRevocationUsingOCSP(X509Certificate[] certs)
throws GeneralSecurityException {
....
if (rs == null) { // <= (А)
if (_ocspFailOpen)
logger.warnf(....); // <= (Б)
else
throw new GeneralSecurityException(....); // <= (В)
}
if (rs.getRevocationStatus() == // <= (Г)
OCSPProvider.RevocationStatus.UNKNOWN) {
....
}Если rs хранит нулевую ссылку (точка А), то нормальный поток выполнения может быть прерван генерацией исключения (точка В). Но может и не прерываться (точка Б), что приведёт к доступу по нулевой ссылке (точка Г).
Итого ссылка может быть как нулевая, так и не нулевая. Если она нулевая, то до её использования управление может как дойти, так и не дойти. Таким образом, задействован анализ потока данных и управления, чувствительный к путям выполнения.
Анализатор PVS-Studio сообщает о потенциальной ошибке: V6008 Potential null dereference of 'rs'. CertificateValidator.java 701 , CertificateValidator.java 708
В общем случае подобные предупреждения могут быть ложными, если между ссылкой rs и переменной ocspFailOpen существует сложная косвенная взаимосвязь, которую анализатор не смог выявить (см. термин анализ псевдонимов и статью про связанные переменные). Собственно, об этом говорится и в стандарте (примечание к п. 3.1.2): анализ потока управления, анализ потока данных, анализ помеченных данных, анализ псевдонимов и анализ косвенных вызовов в общем случае дают приближённые результаты.
Однако даже в этом случае ложные предупреждения могут быть полезны, так как выявляют сложный, неочевидный код, который может быть непонятен не только анализатору, но и разработчикам. Целесообразно провести его рефакторинг или, по крайне мере, написать соответствующий комментарий про косвенную связь между переменными.
Согласно ГОСТ анализ помеченных данных (3.1.3) — статический анализ, при котором анализируется течение потока данных от источников до стоков. Под источниками понимаются точки программы, в которых данные начинают иметь пометку — некоторое заданное свойство. Под стоками понимаются точки программы, в которых данные перестают иметь пометку. Распространённая (но не единственная) цель анализа помеченных данных — показать, что помеченные данные не могут попасть из источников процедуры записи (точек ввода пользователя в стоки) на диск или в сеть. Факт такого попадания означает утечку конфиденциальных данных.
Механизмы анализа помеченных данных схожи с механизмами анализа потоков данных, но имеют существенное различие. Основная задача анализа потока данных — попытаться выяснить состояние переменных в различных точках программы, чтобы в дальнейшем использовать эту информацию в диагностических правилах. Например, если известно, что значение целочисленной переменной A лежит в диапазоне от 0 до 10, то её нельзя использовать в качестве индекса для массива, содержащего только 5 элементов.
Контекстно-чувствительный анализ помеченных данных не ставит задачей определить значение переменных, а оперирует понятием недостоверности данных. Если значение целочисленной переменной A взято из ненадёжного источника и не проверено, его опасно использовать в качестве индекса массива. При этом диапазон значений A может быть полностью неизвестен. Он и не важен. Важен факт использования опасных данных.
Источники заражения. Первичным понятием в данной теме являются заражённые данные. Под этим термином подразумеваются некоторые значения, которые могут позволить злоумышленнику выполнить несанкционированные и, как правило, вредоносные операции при взаимодействии с системой. В зависимости от способа использования внешних данных приложение может быть уязвимо к тем или иным атакам. Например, если приложение использует непроверенные внешние данные при формировании запросов к БД, то оно может быть уязвимо к SQL injection.
Таким образом, внешние данные являются потенциально заражёнными. Точки, в которых приложение получает к ним доступ, называют источниками заражения. Например, источником заражения может быть операция получения значения параметра HTTP-запроса:
void ProcessRequest(HttpRequest request)
{
....
string name = request.Form["name"]; // источник
// теперь "name" содержит недостоверные/заражённые данные
....
}Передача заражения. Важным аспектом при проведении анализа помеченных данных является определение "трасс распространения" заражённых данных по приложению. В приведённом примере заражённые данные из источника передаются в переменную name. Впоследствии они могут также переходить в другие переменные или выступать в качестве аргументов функций:
void ProcessRequest(HttpRequest request)
{
string name = request.Form["name"]; // источник
// теперь "name" содержит недостоверные/заражённые данные
string sql = $"SELECT * FROM Users WHERE name='{name}'";
// недостоверные данные передаются далее как аргумент
ExecuteReaderCommand(sql);
....
}
void ExecuteReaderCommand(string sql)
{
// sql содержит недостоверные/заражённые данные
....
}Стоит отметить, что заражение может передаваться не только при присваивании и передаче аргументов. В примере выше переменная name, хранящая потенциально заражённые данные, используется для формирования строки, которая будет записана в переменную sql. В результате значение sql также будет потенциально заражённым.
Приёмники заражения (стоки). Приложение уязвимо в случае, если заражённые данные могут попасть в некоторые ключевые точки приложения. Их называют приёмниками заражения (taint sink). Каждой потенциальной уязвимости соответствуют свои приёмники. Для SQL injection, к примеру, приёмником может являться точка передачи строки запроса в объект SQL-команды:
void ProcessRequest(HttpRequest request)
{
string name = request.Form["name"]; // <= источник
// теперь "name" содержит недостоверные/заражённые данные
string sql = $"SELECT * FROM Users WHERE name='{name}'";
ExecuteReaderCommand(sql); // данные передаются далее как аргумент
....
}
void ExecuteReaderCommand(string sql)
{
using (var command = new SqlCommand(sql, _connection)) // <= sink
{
using (var reader = command.ExecuteReader()) { /*....*/ }
}
....
}Здесь внешние данные из источника (request.Form["name"]) непосредственно используются при формировании SQL-запроса, который далее передаётся в приёмник — конструктор SqlCommand. Задача анализа помеченных данных состоит в проверке наличия пути передачи заражённых данных от источника к приёмнику.
Если проверить вышеприведённый код с помощью PVS-Studio, то результатом станет следующее предупреждение: V5608 Possible SQL injection inside method. Potentially tainted data in the first argument 'sql' is used to create SQL command.
Устранение потенциальных уязвимостей. Для устранения потенциальной уязвимости внешние данные необходимо проверять или преобразовывать в некоторый безопасный вид. Конкретный способ защиты зависит от типа атаки. Например, в случае с SQL injection могут быть использованы параметризованные запросы:
String userName = Request.Form["userName"];
String query = "SELECT * FROM Users WHERE UserName = @userName";
using (var command = new SqlCommand(query, _connection))
{
var userNameParam = new SqlParameter("@userName", userName);
command.Parameters.Add(userNameParam);
using (var reader = command.ExecuteReader())
....
}Соответственно, при проведении статического анализа предупреждение на данный код выдано не будет.
Наши доклады и статьи на тему анализа помеченных данных:
Начнём с простого, но реального примера воспроизводимой уязвимости, обнаруженной в проекте FreeSWITCH:
static const char *basic_gets(int *cnt)
{
....
int c = getchar();
if (c < 0) {
if (fgets(command_buf, sizeof(command_buf) - 1, stdin)
!= command_buf) {
break;
}
command_buf[strlen(command_buf)-1] = '\0'; /* remove endline */
break;
}
....
}Предупреждение PVS-Studio: V1010 Unchecked tainted data is used in index: 'strlen(command_buf)'.
Анализатор предупреждает о подозрительном обращении по индексу к массиву command_buf. Подозрительным оно считается по той причине, что в качестве индекса используются непроверенные внешние данные. Внешние — потому что получены через функцию fgets из потока stdin, непроверенные — так как никакой проверки перед использованием выполнено не было. Выражение fgets(command_buf, ....) != command_buf не в счёт, так как таким образом проверяется только факт получения данных, но не их содержимое.
Проблема данного кода в том, что при определённых условиях произойдёт запись '\0' за пределы массива, что приведёт к возникновению неопределённого поведения. Для этого достаточно ввести строку нулевой длины. Более подробно найденный дефект и его воспроизведение описано в этой статье в главе про FreeSWITCH.
Рассмотренный реальный пример выявляется с помощью анализа помеченных данных. Однако он не очень интересен, так как всё происходит в одной функции на почти линейном участке кода.
Для демонстрации межпроцедурного анализа и контекстно-чувствительного анализа воспользуемся синтетическим примером:
int getindex() {
int index;
scanf("%d", &index);
return index;
}
void useindex(char *buf, int index) {
buf[index] = 1;
}
void foo() {
char buf[10];
int i = getindex();
useindex(buf, i);
}Предупреждение PVS-Studio: V1010 Unchecked tainted data is used in the second argument: 'i'. Check lines: 14, 20, 9.
Недостоверные чувствительные данные записываются в переменную index в процессе получения данных извне (вызов функции ввода scanf). Функция getindex возвращает эти недостоверные данные, и они попадают в функцию foo. Далее недостоверное значение передаётся в функцию useindex, где используется для обращения к массиву фиксированного размера.
Соответственно, если пользователь введёт, например, значение 33, то возникнет критическая ошибка выхода за границу массива.
Истоком здесь является функция scanf, а стоком — использование помеченных данных в качестве индекса. Приведённый код демонстрирует межпроцедурный контекстно-чувствительный анализ, так как помеченные данные передаются между функциями. Если функции будут находиться в разных файлах, то этот пример будет демонстрировать межпроцедурный контекстно-чувствительный анализ помеченных данных.
Если добавить валидацию введённых данных:
void foo() {
char buf[10];
int i = getindex();
if (i < 10)
useindex(buf, i);
}То анализатор PVS-Studio уже не будет выдавать предупреждение V1010.
Наши доклады и статьи на тему анализа помеченных данных C++ кода:
Рассмотрим анализ помеченных данных на примере XXE-уязвимости. Описание реального примера будет длинным (вы можете ознакомиться с одним из них здесь), поэтому рассмотрим синтетический вариант.
Представим приложение, которое принимает запросы в виде XML-файлов и обрабатывает товары с соответствующим идентификатором. Если идентификатор задан неверно, приложение сообщает об этом.
Формат XML-файла, с которым работает приложение:
<?xml version="1.0" encoding="utf-8" ?>
<shop>
<itemID>62</itemID>
</shop>Допустим, обработкой занимается следующий код:
static void ProcessItemWithID(String pathToXmlFile)
{
XmlReaderSettings settings = new XmlReaderSettings()
{
XmlResolver = new XmlUrlResolver(),
DtdProcessing = DtdProcessing.Parse
};
using (var fileReader = File.OpenRead(pathToXmlFile))
{
using (var reader = XmlReader.Create(fileReader, settings))
{
while (reader.Read())
{
if (reader.Name == "itemID")
{
var itemIDStr = reader.ReadElementContentAsString();
if (long.TryParse(itemIDStr, out var itemIDValue))
{
// Process item with the 'itemIDValue' value
Console.WriteLine(
$"An item with the '{itemIDValue}' ID was processed.");
}
else
{
Console.WriteLine($"{itemIDStr} is not valid 'itemID' value.");
}
}
}
}
}
}Предупреждение PVS-Studio: V5614. OWASP. Potential XXE vulnerability. Insecure XML parser is used to process potentially tainted data.
Для приведённого выше XML-файла приложение распечатает следующую строку:
An item with the '62' ID was processed.Если вместо номера в ID будет записано что-то другое (например, строка "Hello world"), приложение сообщит об ошибке:
"Hello world" is not valid 'itemID' value.Несмотря на то, что код делает то, что от него ожидается, он уязвим к XXE-атакам за счёт соблюдения всех перечисленных ранее факторов:
Ниже представлен XML-файл, через который можно скомпрометировать данный код:
<?xml version="1.0" encoding="utf-8" ?>
<!DOCTYPE foo [
<!ENTITY xxe SYSTEM "file://D:/MySecrets.txt">
]>
<shop>
<itemID>&xxe;</itemID>
</shop>В этом файле объявляется внешняя сущность xxe, которая будет обработана парсером. Вследствие этого содержимое файла D:/MySecrets.txt (например, такое: 'This is an XXE attack target.'), находящегося на машине, где запущено приложение, будет выдано пользователю:
This is an XXE attack target. is not valid 'itemID' value.Для того чтобы обезопаситься от подобной атаки, можно запретить обработку внешних сущностей (присвоить свойству XmlResolver значение null), а также запретить или игнорировать обработку DTD (записать в свойство DtdProcessing значение Prohibit или Ignore соответственно).
Анализатор также учитывает и межпроцедурные вызовы. Рассмотрим пример:
static FileStream GetXmlFileStream(String pathToXmlFile)
{
return File.OpenRead(pathToXmlFile);
}
static XmlDocument GetXmlDocument()
{
XmlDocument xmlDoc = new XmlDocument()
{
XmlResolver = new XmlUrlResolver()
};
return xmlDoc;
}
static void LoadXmlInternal(XmlDocument xmlDoc, Stream input)
{
xmlDoc.Load(input);
Console.WriteLine(xmlDoc.InnerText);
}
static void XmlDocumentTest(String pathToXmlFile)
{
using (var xmlStream = GetXmlFileStream(pathToXmlFile))
{
var xmlDoc = GetXmlDocument();
LoadXmlInternal(xmlDoc, xmlStream);
}
}В данном случае анализатор выдаст предупреждение на вызов метода LoadXmlInternal, так как отследит, что:
Наши доклады и статьи на тему анализа помеченных данных C# кода:
Рассмотрим синтетический пример (с использованием Spring Boot) межмодульного контекстно-чувствительного анализа помеченных данных, источником которых является сетевой запрос.
Первый файл — DemoController.java:
@Controller
public class DemoController {
@Autowired
private DemoService service;
@RequestMapping("demo")
public ResponseEntity<DemoObject>
demoEndpoint(@RequestParam(name="name") String name) {
return service.findByName(name)
.map(ResponseEntity::ok)
.orElse(ResponseEntity.notFound().build());
}
}Метод получает недостоверную информацию (строку). Далее эта строка передаётся без предварительной обработки/проверки в метод findByName.
Второй файл — DemoService.java:
@Service
public class DemoService {
@Autowired
DemoRepository demoRepository;
Optional<DemoObject> findByName(String name) {
return demoRepository.findByName(name);
}
}Здесь нет обработки/проверки, и метод передаёт строку далее в метод другого класса, который также имеет имя findByName.
Третий файл — DemoRepository.java:
public class DemoRepository {
@Autowired
private JdbcTemplate jdbcTemplate;
Optional<DemoObject> findByName(String name) {
var sql = "SELECT * FROM demoTable WHERE name = '" + name + "'";
if (name.equals("demoCondition")) {
sql = "SELECT * FROM demoTable WHERE name = demoName";
return Optional.ofNullable(
jdbcTemplate.queryForObject(sql, DemoObject.class));
}
return Optional.ofNullable(
jdbcTemplate.queryForObject(sql, DemoObject.class));
}
}Формируется SQL-запрос, в котором присутствует недостоверная строка. Это является уязвимостью типа SQL-инъекция.
Предупреждение PVS-Studio: V5309 Possible SQL injection. Potentially tainted data in 'sql' variable is used to create SQL command. DemoRepository.java 18, DemoController.java 15
Наши доклады и статьи на тему анализа помеченных данных Java кода:
В стандарте сказано (п. 7.4), что в состав реализуемых методов статического анализа следует включать следующие методы анализа для поиска дополнительных типов ошибок, а также в качестве вспомогательных анализов:
Наличие этих видов анализа является не обязательными для статических анализаторов, но желательными. Разберёмся, в чём состоят эти анализы, и приведём примеры использования этих технологий в PVS-Studio.
Сигнатурный анализ (п 3.1.28) — статический анализ, определяющий наличие свойства программы при помощи поиска строк в её исходном коде по некоторому образцу, в том числе заданному с помощью формального языка поиска, например, при помощи регулярных выражений.
Сигнатурный анализ используется в PVS-Studio для реализации диагностических правил для всех языков: C, C++, C#, Java.
Упоминание в определении регулярных выражений может вызвать неправильное представление о сути данной технологии. Большинство диагностических правил, выполняющих сигнатурный анализ, работают с абстрактным синтаксическим деревом и при этом учитывают дополнительную информацию, такую как типы переменных. Соответственно, это более сложный и комплексный вид анализа по сравнению с простым поиском текста по какому-то шаблону. Например, ядро PVS-Studio для анализа C и C++ кода использует регулярные выражения (причём для вспомогательных целей) только в 5 из примерно 750 правил, реализованных на момент написания этого раздела.
Пример диагностического правила для C++ кода
В среднем диагностические правила, построенные на сигнатурном поиске, достаточно просты. Однако это не значит, что выявляемые ими ошибки будут несущественными.
Например, достаточно простым выглядит правило, которое выявляет сравнение переменной с самой собой:
lowerBound[0] == lowerBound[0]Однако это не придуманный синтетический код, а реальный фрагмент из проекта LLVM (язык C++):
FailureOr<ConstantOrScalableBound>
ScalableValueBoundsConstraintSet::computeScalableBound(....)
{
....
SmallVector<AffineMap, 1> lowerBound(1), upperBound(1);
scalableCstr.cstr.getSliceBounds(pos, 1, value.getContext(), &lowerBound,
&upperBound, closedUB);
auto invalidBound = [](auto &bound) {
return !bound[0] || bound[0].getNumResults() != 1;
};
AffineMap bound = [&] {
if (boundType == BoundType::EQ && !invalidBound(lowerBound) &&
lowerBound[0] == lowerBound[0]) { // <=
return lowerBound[0];
} else if (boundType == BoundType::LB && !invalidBound(lowerBound)) {
return lowerBound[0];
....
}Предупреждение PVS-Studio: V501 There are identical sub-expressions to the left and to the right of the '==' operator: lowerBound[0] == lowerBound[0]. ScalableValueBoundsConstraintSet.cpp 110
Перед нами опечатка, от которой не застрахованы даже профессиональные разработчики компиляторов. Корректный вариант кода:
lowerBound[0] == upperBound[0]Примечание. Здесь можно познакомиться с публикациями, посвящёнными поиску ошибок в различных компиляторах с помощью PVS-Studio.
Теперь рассмотрим примеры сигнатурного анализа для C# и Java.
Проект Space Engineers (C#):
private static bool IsTriangleDangerous(int triIndex)
{
if (MyPerGameSettings.NavmeshPresumesDownwardGravity)
{
return triIndex == -1;
}
else
{
return triIndex == -1;
}
}Предупреждение PVS-Studio: V3004 The 'then' statement is equivalent to the 'else' statement. Sandbox.Game MyNavigationTriangle.cs 189
Проект jBullet (Java):
public class ConeTwistConstraint extends TypedConstraint {
....
private boolean solveTwistLimit;
private boolean solveSwingLimit;
....
public boolean getSolveTwistLimit() {
return solveTwistLimit;
}
public boolean getSolveSwingLimit() {
return solveTwistLimit;
}
}Предупреждение PVS-Studio: V6091 Suspicious getter implementation. The 'solveSwingLimit' field should probably be returned instead. ConeTwistConstraint.java(407), ConeTwistConstraint.java(74)
Анализ псевдонимов (п. 3.1.7) — статический анализ, позволяющий установить наличие в программе доступа к одной и той же переменной или функции с помощью различных ссылок (указателей).
Синтетический пример для C++ кода
На данный момент анализ псевдонимов поддерживает только некоторые конструкции и типы данных, например ссылки для простых типов. Синтетический пример со ссылками:
int foo(int &a, const int &b)
{
a = b;
return a;
}
int get_0(int b = 1)
{
int a = 15;
int &c = b;
c = 0;
return foo(a, b);
}
int test()
{
return 100 / get_0(); //+V609
}Анализатор видит присваивание переменной c значения 0, но понимает, что 0 будет присвоен и переменной b. В результате он выявляет возникновение в коде деления на ноль: V609. Divide by zero. Denominator 'get_0()' == 0.
Синтетический пример для C# кода
object GetPotentialNull() {
Random random = new();
return random.NextDouble() > 0.5 ? new object() : null;
}
void Example_1() {
object potentialNull = GetPotentialNull();
ref object alias = ref potentialNull;
if (alias != null) {
// Правило V3080 не срабатывает,
// т. к. alias и potentialNull - одно и то же значение.
_ = potentialNull.ToString();
}
}
void Example_2()
{
var obj = new object();
ref object alias = ref obj;
alias = GetPotentialNull();
// Срабатывает правило V3080, так как при
// изменении значения alias, меняется и obj.
_ = obj.ToString(); // V3080: Possible null dereference.
}Анализ псевдонимов в Java коде
В таблице N2 для языка Java поддержка анализа псевдонимов не заявлена. Пока эта технология используется ограниченно в детекторах утечек ресурсов для снижения количества ложных срабатываний. Пример:
public void negative(File f, boolean bool) throws IOException {
FileOutputStream fs = new FileOutputStream(f); // Здесь нет V6127
FileOutputStream fs2 = fs;
if (bool) {
fs.close();
} else {
fs2.close();
}
}В обоих ветках файловый поток закрывается через разные ссылки. Анализатор учитывает, что они указывают на один объект, поэтому не выдаёт предупреждение про утечку ресурсов V6127.
Анализ косвенных вызовов (3.1.2) — статический анализ, позволяющий в программе, использующей вызовы по указателю или вызовы виртуальных функций, установить множество процедур, которые могут вызываться при выполнении заданного косвенного вызова.
Синтетический пример для C++ кода
int foo(int x)
{
return x - 1;
}
int(*fptr)(int);
int bar()
{
fptr = foo;
return 1 / fptr(1);
}Если аргументом функции foo является единица, то она возвращает ноль. Анализ косвенных вызовов позволяет обнаружить, что вызов этой функции по указателю приводит к ошибке деления на ноль.
Предупреждение: V609 Divide by zero. Denominator 'fptr(1)' == 0.
Синтетический пример для C# кода
using System.Text.Json;
class DeserializationVulnerability
{
void Test(bool flag)
{
string taint = Console.ReadLine();
Func<string, Type, JsonSerializerOptions, object> deserialize;
if (flag)
deserialize = NoDeserialize;
else
deserialize = JsonSerializer.Deserialize;
if (!flag)
deserialize(taint, typeof(object), null); // <=
}
internal static object? NoDeserialize(string json,
Type returnType,
JsonSerializerOptions? options = null)
{
return new object();
}
}В данном примере объявляется делегат deserialize. В зависимости от значения параметра flag переменной deserialize присваивается либо ссылка на метод приёмник заражения (JsonSerializer.Deserialize), либо ссылка на безопасный метод (NoDeserialize).
Далее, в зависимости от значения параметра flag, вызывается делегат, в который передаются заражённые данные. Передача заражённых данных в метод JsonSerializer.Deserialize может привести к уязвимостям. Данную проблему диагностирует правило V5611 Potential insecure deserialization vulnerability. Potentially tainted data is used to create an object using deserialization.
Статистический анализ (п. 3.1.32) — статический анализ, определяющий статистику для некоторого свойства программы, например насколько часто в программе проверяется возвращаемое значение некоторой функции.
Статистический анализ используется в PVS-Studio для реализации диагностических правил для всех поддерживаемых языков (C, C++, C#, Java).
Например, для всех языков реализованы правила, выявляющие аномалию, описанную в определении из ГОСТ. Диагностические правила V1071 (C, C++), V3201 (C#) и V6121 (Java) проверяют, насколько часто в программе проверяется/используется возвращаемое значение некоторой функции.
Демонстрационные примеры для перечисленных правил рассматривать не будем, так как они достаточно длинные и не очень интересные. Рассмотрим статистический анализ на примере другого правила. Проект Linux Kernel (язык C):
static const
struct XGI330_LCDDataDesStruct2 XGI_LVDSNoScalingDesData[] = {
{0, 648, 448, 405, 96, 2}, /* 00 (320x200,320x400,
640x200,640x400) */
{0, 648, 448, 355, 96, 2}, /* 01 (320x350,640x350) */
{0, 648, 448, 405, 96, 2}, /* 02 (360x400,720x400) */
{0, 648, 448, 355, 96, 2}, /* 03 (720x350) */
{0, 648, 1, 483, 96, 2}, /* 04 (640x480x60Hz) */
{0, 840, 627, 600, 128, 4}, /* 05 (800x600x60Hz) */
{0, 1048, 805, 770, 136, 6}, /* 06 (1024x768x60Hz) */
{0, 1328, 0, 1025, 112, 3}, /* 07 (1280x1024x60Hz) */
{0, 1438, 0, 1051, 112, 3}, /* 08 (1400x1050x60Hz)*/
{0, 1664, 0, 1201, 192, 3}, /* 09 (1600x1200x60Hz) */
{0, 1328, 0, 0771, 112, 6} /* 0A (1280x768x60Hz) */
};Предупреждение PVS-Studio: V536 Be advised that the utilized constant value is represented by an octal form. Oct: 0771, Dec: 505. vb_table.h 1379
Статистическая аномалия состоит в том, что только одно число в массиве является восьмеричным (0771 в последней строке). Ноль, делающий литерал восьмеричным, лишний и вписан для выравнивания столбика чисел.
Анализ иерархии классов (п 3.1.1) — статический анализ, позволяющий выявить в программах на объектно-ориентированных языках список классов, реализованных в программе, а также отношения наследования между этими классами.
Анализ иерархии классов используется в PVS-Studio для реализации диагностических правил для всех объектно-ориентированных языков (C++, C#, Java).
Данный вид анализа, так же как синтаксический анализ, является базовым и активно используется всеми ядрами анализатора PVS-Studio. Без него невозможно большинство других видов анализа.
Поскольку анализ иерархии классов является неотъемлемой частью всех ядер PVS-Studio и работает схожим образом для всех поддерживаемых языков, то рассмотрим только один пример использования.
Проект Blender (язык C++). Для начала рассмотрим базовый класс CurvesFieldInput:
typedef struct CurvesGeometry { .... };
namespace bke
{
....
class CurvesGeometry : public ::CurvesGeometry { .... };
class CurvesFieldInput : public fn::FieldInput
{
....
virtual std::optional<AttrDomain> preferred_domain(
const CurvesGeometry &curves) const;
};
....
}Обратим внимание, что виртуальная функция preferred_domain принимает параметр типа bke::CurvesGeometry. Теперь посмотрим на класс-наследник:
namespace blender::nodes::node_geo_input_curve_handles_cc
{
class HandlePositionFieldInput final : public bke::CurvesFieldInput
{
....
std::optional<AttrDomain> preferred_domain(
const CurvesGeometry & /*curves*/) const;
};
}Предупреждение PVS-Studio: V762 It is possible a virtual function was overridden incorrectly. See first argument of function 'preferred_domain' in derived class 'HandlePositionFieldInput' and base class 'CurvesFieldInput'. node_geo_input_curve_handles.cc 95
В базовом классе виртуальная функция принимает параметр с неквалифицированным именем CurvesGeometry. Когда компилятор будет осуществлять поиск этого типа, он начнёт с области видимости класса CurvesFieldInput и будет заглядывать во все обрамляющие области видимости, пока не встретит этот тип. В итоге будет найден тип bke::CurvesGeometry.
Теперь посмотрим на производный класс. Он определён в пространстве имён, отличном от того, где располагается базовый класс. Компилятор также начнёт поиск нужного имени CurvesGeometry, не найдёт его в обрамляющих областях видимости и дойдёт до глобального. А в глобальном пространстве имён тоже есть CurvesGeometry, только не тот, что нам нужен для переопределения функции.
Чтобы выявлять такую ошибку, анализатор должен собрать информацию о типах, иерархии классов и областях видимости.
На момент обновления раздела (начало 2026 года) PVS-Studio выявляет все типы критических ошибок для языков C, C++, C#, Java. Список поддерживаемых языков в 2026 году будет расширен, но в данный момент говорить про них рано.
Для компилируемых языков PVS-Studio выявляет следующие типы критических ошибок, перечисленных в ГОСТ (п. 6.3).
|
Типы критических ошибок в компилируемых языках (п. 6.3) |
C и C++ |
C# |
Java |
|---|---|---|---|
|
Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.) |
✓ |
✓ |
✓ |
|
Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел |
✓ |
✓ |
✓ |
|
Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти) |
✓ |
✓ |
✓ |
|
Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.) |
✓ |
✓ |
✓ |
|
Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.) |
✓ |
✓ |
✓ |
Таблица N3. Выявляемые типы критических ошибок в компилируемых языках, перечисленные в ГОСТ Р 71207—2024 (п. 6.3). Данные приведены для анализатора PVS-Studio на начало 2026 года
Стандарт дополнительно перечисляет несколько типов критических ошибок, специфичных для языков C и C++ (п. 6.5). Анализатор PVS-Studio обеспечивает их обнаружение.
|
Дополнительные типы критических ошибок для C и C++ (п. 6.5) |
C и C++ |
|---|---|
|
Ошибки разыменования нулевого указателя |
✓ |
|
Ошибки деления на ноль |
✓ |
|
Ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти) |
✓ |
|
Ошибки использования форматной строки |
✓ |
|
Ошибки использования неинициализированных переменных |
✓ |
|
Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений |
✓ |
Таблица N4. Выявляемые типы критических ошибок, являющиеся дополнительными для языков C и C++ и перечисленные в ГОСТ Р 71207—2024 (п. 6.5). Данные приведены для анализатора PVS-Studio на начало 2026 года
Анализатор PVS-Studio умеет обнаруживать, например, деление на ноль не только в C и C++ коде, но и в C# и Java. Сейчас с точки зрения ГОСТ Р 71207—2024 деление на ноль в C# и Java коде не является критической ошибкой. Однако в ходе этапа "Домашнее задание" испытаний статических анализаторов кода в 2025 году обсуждалось, что хорошо расширить в стандарте список критических ошибок для некоторых языков. С высокой вероятностью это будет сделано в следующей редакции ГОСТ Р 71207.
Мы решили в PVS-Studio заранее дополнительно разметить некоторые C# и Java диагностики (детекторы) как критические. В разметке мы опирались на расширенный набор тестов, использованный для качественной оценки анализаторов на этапе "Домашнего задания". Для языков C# и Java дополнительно критическими ошибками считаются:
Более подробную информацию смотрите в статье "Фильтрация предупреждений PVS-Studio, выявляющих критические ошибки (согласно классификации ГОСТ Р 71207—2024)".
Расширенный набор ошибок для C# и Java, которые выявляются и размечаются в PVS-Studio как критические.
|
Типы ошибок, которые, скорее всего, будут включены в список критических в следующей редакции стандарта |
C# |
Java |
|---|---|---|
|
Ошибки разыменования нулевой ссылки |
✓ |
✓ |
|
Ошибки деления на ноль |
✓ |
✓ |
|
Ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти) |
✓ |
✓ |
|
Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений |
✓ |
✓ |
Таблица N5. Выявляемые типы ошибок, которые в дальнейшем также будут относиться к категории критических в новой редакции ГОСТ Р 71207. Данные приведены для анализатора PVS-Studio на начало 2026 года
Для выявления перечисленных выше типов критических ошибок в PVS-Studio реализованы следующие детекторы ошибок (диагностические правила). Приведённый список составлен в январе 2026 года. Актуальную информацию можно посмотреть здесь.
|
Типы критических ошибок, выявляемых PVS-Studio (п. 6.3) |
Детекторы (диагностические правила) |
|---|---|
|
Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.) |
C, C++: V541, V557, V575, V609, V610, V755, V1010, V1083 C#: 5608, V5609, V5610, V5611, V5614, V5615, V5616, V5618, V5619, V5620, V5621, V5622, V5623, V5624, V5626, V5627, V5628, V5631 Java: V5309, V5310, V5311, V5312, V5319, V5320, V5321, V5322, V5323, V5324, V5327, V5330, V5332, V5333, V5334, V5335, V5336, V5337, V5338 |
|
Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел |
C, C++: V569, V605, V610, V629, V642, V658, V724, V784, V1012, V1016, V1026, V1028, V1029, V1070, V1081, V1083, V1085, V1112 C#: 3134, V3200, V3204, V3217 Java: V5308, V6034, V6117, V6124, V6130, V6131 |
|
Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти) |
C, C++: V512, V518, V557, V575, V582, V594, V635, V643, V645, V752, V781, V783, V1038, V1111 C#: V3106, V3184, V3218 Java: V6025, V6079 |
|
Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.) |
C, C++: V597, V618, V631, V642, V698, V1001, V1057, V1072, V1109, V1118, V5014 C#: V3039, V5601, V5612, V5613, V5617 Java: V5305, V5307, V5313, V5314, V5315, V5316, V5317, V5318, V5325, V5326, V5328, V5329, V5331, V6109 |
|
Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.) |
C, C++: V513, V712, V720, V744, V1011, V1018, V1025, V1036, V1088, V1089 C#: V3032, V3054, V3079, V3082, V3083, V3089, V3090, V3147, V3167, V3190, V3223, V5604, V5605 Java: V5304, V6064, V6070, V6074, V6082, V6095, V6102, V6125, V6126, V6129 |
Таблица N6. Детекторы, реализованные в PVS-Studio для выявления критических ошибок в коде программ, написанных на компилируемых языках (C, C++, C#, Java) (п. 6.3)
ГОСТ Р 71207—2024 предписывает выявлять дополнительные типы ошибок в коде программ на языках C и C++. Для других языков эти типы ошибок не считаются критичными (пока).
|
Типы критических ошибок, выявляемых PVS-Studio (п. 6.5) |
Детекторы (диагностические правила) |
|---|---|
|
Ошибки разыменования нулевого указателя |
C, C++: V522, V575, V576, V595, V664, V713, V757, V769, V1004 |
|
Ошибки деления на ноль |
C, C++: V609 |
|
Ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти) |
C, C++: V515, V554, V558, V575, V585, V586, V599, V611, V613, V630, V641, V680, V689, V697, V723, V726, V748, V749, V752, V758, V772, V774, V782, V789, V1002, V1006, V1062 |
|
Ошибки использования форматной строки |
C, C++: V510, V541, V576, V618 |
|
Ошибки использования неинициализированных переменных |
C, C++: V546, V573, V575, V614, V670, V679, V788, V1007, V1050, V1077, V1086 |
|
Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений |
C, C++: V530, V599, V701, V773, V1005, V1020, V1023, V1100, V1106, V1110 |
Таблица N7. Дополнительные детекторы, реализованные в PVS-Studio для выявления критических ошибок в коде программ, написанных на C и C++ (п. 6.5)
Как было сказано в предыдущем разделе, список критических ошибок, перечисленных в стандарте, планируется расширить. PVS-Studio уже заранее учитывает это возможное расширение и позволяет обнаружить следующий набор критических ошибок для языков C# и Java.
|
Ошибки, которые PVS-Studio заранее классифицирует как критические |
Детекторы (диагностические правила) |
|---|---|
|
Ошибки разыменования нулевой ссылки |
C#: 3080, V3125, V3146, V3148, V3149, V3153, V3168, V3195 Java: V6008, V6093 |
|
Ошибки деления на ноль |
C#: V3064 Java: V6020 |
|
Ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти) |
C#: V3178 Java: V6128 |
|
Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений |
C#: V3114, V3222, V3226 Java: V6114, V6115, V6116, V6127 |
Таблица N8. Детекторы, реализованные в PVS-Studio для выявления ошибок в коде программ, написанных на C# и Java. С высокой вероятностью эти типы ошибок войдут как критические в новую редакцию стандарта ГОСТ Р 71207
Надо понимать, что список типов критических ошибок условен. Критическая ошибка, приводящая к записи за границу буфера в некотором приложении, максимум может только испортить какой-то рисунок, но не влияет на безопасность.
И наоборот, опечатка в коде, формально не попадающая ни под один тип перечисленных в ГОСТ Р 71207—2024 критических ошибок, может являться серьёзным дефектом безопасности. Из-за неё, например, неправильно происходит проверка каких-то приватных данных. Фактически эта ошибка является критической.
Рассмотрим в качестве примера баг, найденный нами в проекте RavenDB (язык C#):
public enum SecurityClearance
{
UnauthenticatedClients, //Default value
ClusterAdmin,
ClusterNode,
Operator,
ValidUser
}
public override void VerifyCanExecuteCommand(....)
{
....
var definition = JsonDeserializationServer.CertificateDefinition(read);
if (
definition.SecurityClearance != SecurityClearance.ClusterAdmin ||
definition.SecurityClearance != SecurityClearance.ClusterNode
)
return;
AssertClusterAdmin(isClusterAdmin);
}Предупреждение PVS-Studio: V3022 Expression is always true. Probably the '&&' operator should be used here. DeleteCertificateFromClusterCommand.cs 21
Проверка не имеет смысла. Переменная всегда будет не равна или одной, или другой константе. Поэтому результат проверки всегда истинный. Здесь должно быть написано:
definition.SecurityClearance != SecurityClearance.ClusterAdmin &&
definition.SecurityClearance != SecurityClearance.ClusterNodeИли:
definition.SecurityClearance == SecurityClearance.ClusterAdmin ||
definition.SecurityClearance == SecurityClearance.ClusterNodeОшибка связана с неправильной проверкой некоторого внутреннего состояния, что приводит к неверному пути выполнения программы. Это однозначно серьёзная ошибка в функции, связанной с логикой управления правами. Однако непонятно, к какому типу критической ошибки можно отнести найденную опечатку.
Мы рассмотрели пример, где сложно классифицировать опечатку как критическую ошибку, но по факту она ей является. Как же тогда интерпретировать типы критических ошибок, описанных в ГОСТ, и работать с предупреждениями анализаторов?
Одни ошибки с большей вероятностью могут привести к дефектам безопасности, чем другие. Выход за границу буфера потенциально более опасен, чем неправильное использование #pragma warning (V665).
ГОСТ Р 71207—2024 выделяет группу ошибок, которые с наибольшим шансом могут привести к возникновению уязвимости. Это и есть список критических ошибок. Эти ошибки должны выявляться в первую очередь и обязательно исправляться. Предупреждения про критические ошибки являются первоочерёдными в сравнении со всеми другими предупреждениями, так как их исправление вносят наибольший вклад в безопасность приложения.
Однако это не значит, что другие предупреждения должны быть проигнорированы. Их можно и нужно изучать, хотя не в таких жёстких временных рамках. Временные рамки поиска и исправления критических ошибок описаны в п. 5.6, п. 5.8, п. 5.9.
Анализатор PVS-Studio, помимо критических ошибок, выявляет множество других ошибок, которые также могут являться дефектами безопасности. С полным списком детекторов можно ознакомиться на этой странице.
Кратко опишем каждый из типов критических ошибок и приведём примеры их выявления с помощью PVS-Studio. Предпочтение будет отдаваться реальным случаям выявления ошибок, взятых из нашей коллекции багов в открытых проектах. Эти ошибки не обязательно являются дефектами безопасности, но зато демонстрируют работу PVS-Studio в реальных условиях. В случае, если короткого и красивого примера нет, будет составлен синтетический пример.
Описание данного вида дефектов и соответствующие примеры уже были рассмотрены в главе "Межпроцедурный и межмодульный контекстно-чувствительный анализ помеченных данных".
Данный вид дефектов может быть использован в атаках для получения неких недопустимых значений, влияющих на ход выполнения программы, отличный от предусмотренного.
Дополнительные ссылки:
Пример выявления ошибки в C или C++ коде (проект Hypertext Preprocessor, C)
PHP_CLI_API size_t sapi_cli_single_write(....)
{
....
size_t shell_wrote;
shell_wrote = cli_shell_callbacks.cli_shell_write(....);
if (shell_wrote > -1) {
return shell_wrote;
}
....
}Предупреждение PVS-Studio: V605 Consider verifying the expression: shell_wrote > - 1. An unsigned value is compared to the number -1. php_cli.c 266
Пример демонстрирует некорректное совместное использование знаковых и беззнаковых чисел. Перед сравнением числовой литерал -1 типа int будет неявно преобразован в значение SIZE_MAX типа size_t. Условие никогда не выполнится.
Пример выявления ошибки в C# коде
bool IsValidAddition(ushort x, ushort y)
{
if (x + y < x)
return false;
return true;
}Предупреждение PVS-Studio: V3204. The expression is always false due to implicit type conversion. Overflow check is incorrect.
Цель данного метода — проверить, произойдёт ли переполнение при сложении двух положительных чисел. В случае переполнения результат суммы должен оказаться меньше любого из её операндов.
Однако проверка не выполнит свою задачу, поскольку оператор '+' не имеет перегрузки для сложения чисел с типом ushort. В результате оба числа будут в начале приведены к типу int, после чего выполнится их сложение. Так как складываются значения типа int, никакого переполнения не произойдёт, и условие всегда будет давать значение false.
Пример выявления ошибки в Java коде (проект Apache Hive)
public void logSargResult(int stripeIx, boolean[] rgsToRead)
{
....
long val = 0;
for (int j = 0; j < 64; ++j) {
int ix = valOffset + j;
if (rgsToRead.length == ix) break;
if (!rgsToRead[ix]) continue;
val = val | (1 << j); // <=
}
....
}Предупреждение PVS-Studio: V6034 Shift by the value of 'j' could be inconsistent with the size of type: 'j' = [0 .. 63]. IoTrace.java 272
Ошибка заключается в невозможности корректно выставить 32 старших разряда в 64-битной переменной val.
В указанной строке индуктивная переменная (п. 3.1.10) j может принимать значение в диапазоне [0..63]. В выражении (1 << j) числовой литерал 1 имеет 32-битный тип int. Соответственно, при сдвиге единицы на 32 и более разрядов будет происходить переполнение.
Для исправления ситуации необходимо написать (1L << j).
Переполнение буфера (Buffer Overflow) — запись или чтение программой данных за пределами выделенного для этого в памяти буфера. Обычно возникает из-за неправильной работы с данными и памятью. Усугубляется отсутствием жёсткой защиты со стороны подсистемы программирования и ОС.
Так как большинство языков программирования размещают данные программы в стеке процесса, смешивая их с управляющими данными, переполнение буфера является одним из способов атаки на ПО, который позволяет загрузить и выполнить произвольный машинный код от имени программы или повлиять на логику работы программы, модифицировав данные за пределом буфера.
Дополнительные ссылки:
Пример выявления ошибки в C или C++ коде (проект ICU, C)
static char plugin_file[2048] = "";
U_CAPI void U_EXPORT2 uplug_init(UErrorCode *status)
{
....
// uprv_strncat раскрывается в strncat
uprv_strncpy(plugin_file, plugin_dir, 2047);
uprv_strncat(plugin_file, U_FILE_SEP_STRING, 2047);
uprv_strncat(plugin_file, "icuplugins", 2047);
uprv_strncat(plugin_file, U_ICU_VERSION_SHORT, 2047);
uprv_strncat(plugin_file, ".txt", 2047);
....
}Здесь анализатор PVS-Studio выдаёт несколько однотипных предупреждений: V645 The 'strncat' function call could lead to the 'plugin_file' buffer overflow. The bounds should not contain the size of the buffer, but a number of characters it can hold. icuplug.c
Многие программисты используют эту функцию вместо strcat, чтобы предотвратить выход за границу буфера, но делают это неправильно. Это как раз такой случай. Третий аргумент функции strncat задаёт не размер буфера, а максимальное количество символов, которое можно добавить. В результате этот код конкатенации строк не защищён от переполнения буфера.
Пример выявления ошибки в C# коде (проект Flax Engine)
Выход за границу массива в C# не представляет существенную опасность, так как в этом случае будет сгенерировано исключение. Так что, пожалуй, для программ на языке C# эту ошибку не стоит считать критической. Но раз формально стандарт требует выявления в компилируемых языках данного вида дефекта, то рассмотрим соответствующий пример:
public Matrix2x2(float[] values)
{
....
if (values.Length != 4)
throw new ArgumentOutOfRangeException(....);
M11 = values[0];
M12 = values[1];
M21 = values[3];
M22 = values[4];
}Предупреждение PVS-Studio: V3106 Possibly index is out of bound. The '4' index is pointing beyond 'values' bound. Matrix2x2.cs 98
Выполняя анализ потока данных и управления, анализатор знает, что если управление дошло до извлечения значений массива, то этот массив содержит 4 элемента. Соответственно, последний индекс должен быть равен 3, а не 4.
Если присмотреться, то становится очевидна опечатки при написании кода: случайно написали 3 вместо 2, а затем 4 вместо 3. Так что, на самом деле, здесь даже не одна ошибка, а сразу две.
Пример выявления ошибки в Java коде (проект ELKI)
Как и в C#, выход за границу массива в Java не представляет существенную опасность, так как в этом случае будет сгенерировано исключение.
@Override
public double[] computeMean() {
return points.size() == 1 ? points.get(1) : null;
}Предупреждение PVS-Studio: V6025 Index '1' is out of bounds. GeneratorStatic.java(104)
Простая опечатка, приводящая к выходу за границу массива. Чтобы извлечь один единственный элемент из массива, следовало написать points.get(0).
Достаточно обобщённое название критической ошибки, что, в общем-то, неизбежно. Существует огромное количество вариантов неправильного использования функций шифрования, разграничения доступа и так далее. Соответственно, решение этой задачи — в выявлении большого количества модельных вариантов ошибок (п. 3.1.19).
Пример выявления ошибки в C или C++ коде (проект Android, C)
static void FwdLockGlue_InitializeRoundKeys() {
unsigned char keyEncryptionKey[KEY_SIZE];
....
memset(keyEncryptionKey, 0, KEY_SIZE); // Zero out key data.
}Предупреждение PVS-Studio: V597 The compiler could delete the 'memset' function call, which is used to flush 'keyEncryptionKey' buffer. The memset_s() function should be used to erase the private data. FwdLockGlue.c 102
Компилятор вправе удалить вызов функции memset, так как это не изменит наблюдаемое поведение программы с точки зрения C и C++. После вызова memset буфер гарантированно не используется, следовательно, его не нужно заполнять нулями. В результате в памяти остаются приватные данные, которые потенциально могут быть куда-то переданы.
Детальнее про этот дефект безопасности:
Пример выявления ошибки в C# коде
private static string CalculateSha1(string text, Encoding enc)
{
var buffer = enc.GetBytes(text);
using var cryptoTransformSha1 = new SHA1CryptoServiceProvider();
var hash = BitConverter.ToString(cryptoTransformSha1.ComputeHash(buffer))
.Replace("-", string.Empty);
return hash.ToLower();
}Предупреждение PVS-Studio: V5613. Use of outdated cryptographic algorithm is not recommended.
Используется устаревшая криптографическая функция.
Пример выявления ошибки в Java коде
public void foo() {
Random rnd = new Random(4040);
....
}Предупреждение PVS-Studio: V6109. Potentially predictable seed is used in pseudo-random number generator.
Анализатор обнаружил подозрительный код, инициализирующий генератор псевдослучайных чисел константным значением. Числа, сгенерированные таким генератором, можно предугадать: они будут воспроизводиться снова и снова при каждом запуске программы. Потенциально это может сказаться на безопасности приложения, использующего псевдослучайные числа в задачах, связанных с криптографией (см. также "CWE-336: Same Seed in Pseudo-Random Number Generator (PRNG)").
Выявление ошибок, связанных с использованием многопоточных примитивов, — одна из самых сложных задач для статических анализаторов кода. Отслеживание взаимодействия различных частей программы, которые могут одновременно обращаться к одним и тем же ресурсам, обладает высокой вычислительной сложностью.
По причине сложности задачи выявление этого вида критических ошибок является необязательным для реализации в статических анализаторах (п. 7.3).
Как и в случае с предыдущим разделом, выявление ошибок при работе с многопоточными примитивами в основном сводится к обнаружению множества модельных вариантов ошибок (3.1.19).
Пример выявления ошибки в C или C++ коде (проект Zephyr, C)
static int nvs_startup(struct nvs_fs *fs)
{
....
k_mutex_lock(&fs->nvs_lock, K_FOREVER);
....
if (fs->ate_wra == fs->data_wra && last_ate.len) {
return -ESPIPE; // <= (A)
}
....
end:
k_mutex_unlock(&fs->nvs_lock);
return rc;
}Предупреждение PVS-Studio: V1020 The function exited without calling the 'k_mutex_unlock' function. Check lines: 620, 549. nvs.c 620
Мьютекс останется захваченным, если выход из программы произойдёт в точке (A).
Пример выявления ошибки в C# коде (проект RunUO)
private Packet m_RemovePacket;
....
private object _rpl = new object();
public Packet RemovePacket
{
get
{
if (m_RemovePacket == null)
{
lock (_rpl)
{
if (m_RemovePacket == null)
{
m_RemovePacket = new RemoveItem(this);
m_RemovePacket.SetStatic();
}
}
}
return m_RemovePacket;
}
}Предупреждение PVS-Studio: V3054 Potentially unsafe double-checked locking. Use volatile variable(s) or synchronization primitives to avoid this. Item.cs 1624
В коде паттерн блокировки с двойной проверкой реализован некорректно. При обращении к свойству RemovePacket геттер осуществляет проверку поля m_RemovePacket на равенство null. Если проверка проходит, то мы попадаем в тело оператора lock, где и происходит инициализация поля m_RemovePacket.
Сбой возникает в тот момент, когда главный поток уже инициализировал переменную m_RemovePacket посредством конструктора, но ещё не вызвал метод SetStatic. Теоретически другой поток может обратиться к свойству RemovePacket именно в этот самый неудачный момент. Проверка m_RemovePacket на равенство null уже не пройдёт, и вызывающий поток получит ссылку на неполностью готовый к использованию объект.
Пример выявления ошибки в Java коде (проект DBeaver)
public class MultiPageWizardDialog extends .... {
....
private volatile int runningOperations = 0;
....
@Override
public void run(....) {
....
try {
runningOperations++; // <=
ModalContext.run(
runnable,
true,
monitorPart,
getShell().getDisplay()
);
} finally {
runningOperations--; // <=
....
}
}
}Предупреждения PVS-Studio:
Неатомарное изменение volatile-переменной может привести к состоянию гонки. Известно, что использование модификатора volatile гарантирует, что все потоки будут видеть актуальное значение соответствующей переменной. К этому можно добавить, что модификатор volatile используется для того, чтобы указать JVM, что все операции присвоения этой переменной и все операции чтения из неё должны быть атомарными.
Можно посчитать, что пометки переменных как volatile будет достаточно, чтобы безопасно их использовать в многопоточном приложении, однако инкремент переменной — неатомарная операция, состоящая из чтения, изменения и записи данных. Подробнее суть проблемы описана здесь.
Проблема разыменования нулевых указателей вечна и сложнее, чем может показаться на первый взгляд. Любое ли разыменование нулевого указателя приводит к неопределённому поведению? Есть ли исключения и нюансы? Обсуждение этих вопросов вы можете найти здесь:
Анализатор использует для поиска разыменования нулевых указателей несколько технологий:
С первыми двумя всё понятно: анализатор пытается вычислить, может ли указатель быть нулевым в момент разыменования. Пример ошибки, найденной в проекте LLVM (язык C++).
Сначала рассмотрим функцию SetInsertPoint в файле IRBuilder.h:
void SetInsertPoint(Instruction *I)
{
BB = I->getParent();
InsertPt = I->getIterator();
assert(InsertPt != BB->end() && "Can't read debug loc from end()");
SetCurrentDebugLocation(I->getStableDebugLoc());
}Обратите внимание, что указатель I сразу разыменовывается без какой-либо проверки.
Теперь рассмотрим использование этой функции, происходящее в другом файле OMPIRBuilder.cpp (межмодульный анализ):
std::pair<Value *, Value *> OpenMPIRBuilder::emitAtomicUpdate
(InsertPointTy AllocaIP, ...., bool IsXBinopExpr)
{
....
if (UnreachableInst *ExitTI = dyn_cast<UnreachableInst>
(ExitBB->getTerminator()))
{
CurBBTI->eraseFromParent();
Builder.SetInsertPoint(ExitBB); // <= ненулевой указатель
}
else
{
Builder.SetInsertPoint(ExitTI); // <= нулевой указатель
}
return Res;
}Предупреждение PVS-Studio: V522 Dereferencing of the null pointer 'I' might take place. The null pointer is passed into 'SetInsertPoint' function. Inspect the first argument. Check lines: 'IRBuilder.h:188', 'OMPIRBuilder.cpp:5983'.
Если выполняется ветка else, то указатель ExitTI будет нулевым. Соответственно, в функцию SetInsertPoint будет передан нулевой указатель, где он и будет разыменован.
Однако в общем виде вычислить возможные значение указателей невозможно. Тогда могут помочь вспомогательные механизмы, построенные на эмпирических алгоритмах. Рассмотрим пример работы одного из таких детекторов ошибок (проект MuseScore, С++):
Ms::Segment* NotationSelectionRange::rangeStartSegment() const
{
Ms::Segment* startSegment = score()->selection().startSegment();
startSegment->measure()->firstEnabled(); // <= разыменование
if (!startSegment) { // <= проверка
return nullptr;
}
if (!startSegment->enabled()) {
startSegment = startSegment->next1MMenabled();
}
....
}Пусть анализатор не может вычислить значение startSegment, однако он замечает следующую аномалию: указатель сначала разыменовывается, а затем проверяется. Раз указатель проверяется, значит автор кода предполагает, что он может быть нулевым. Следовательно, разыменование является опасным.
Анализатор PVS-Studio выдаёт предупреждение: V595 The 'startSegment' pointer was utilized before it was verified against nullptr. Check lines: 129, 131. notationselectionrange.cpp 129 (подробнее про данный детектор — Пояснение про диагностическое правило V595).
Как было сказано в главе "Выявляемые типы критических ошибок", разыменование нулевой ссылки на данный момент не является критической ошибкой для C#/Java согласно ГОСТ Р 71207—2024, но, скорее всего, станет таковой. Анализатор PVS-Studio уже выявляет такие ошибки, что и будет продемонстрировано.
Пример выявления ошибки в C# коде (проект OpenRA)
public void DisguiseAs(Actor target)
{
....
var tooltip = target.TraitsImplementing<ITooltip>().FirstOrDefault();
AsPlayer = tooltip.Owner;
AsActor = target.Info;
AsTooltipInfo = tooltip.TooltipInfo;
....
}Если выборка пуста, то функция FirstOrDefault, в отличие от First, не выбросит исключение InvalidOperationException, а вернёт null для ссылочного типа.
Если target.TraitsImplementing<ITooltip>() вернёт пустую выборку, в tooltip будет записан null. Обращение к свойствам этого объекта, которое производится далее, приведёт к NullReferenceException.
Предупреждение PVS-Studio: V3146 Possible null dereference of 'tooltip'. The 'FirstOrDefault' can return default null value. Disguise.cs 192
Пример выявления ошибки в Java коде (проект OpenIDE)
Примечание. OpenIDE — это бесплатная среда разработки на базе IntelliJ IDEA Community Edition с открытым исходным кодом. Подкаст об OpenIDE: "Фёдор Сазонов: зачем нужна новая IDE на IntelliJ Platform?". Анализатор PVS-Studio может интегрироваться с ней как плагин. О проверке проекта мы писали в статье "Статический анализ OpenIDE".
public void decorate(....) {
....
Module module = ProjectRootManager.getInstance(project)
.getFileIndex()
.getModuleForFile(folder);
if (module == null && !module.isDisposed()) {
return;
}
....
}Разыменование нулевой ссылки возникнет из-за опечатки. Правильным вариантом будет использование в условии не оператора &&, а ||.
Предупреждение PVS-Studio: V6008 Null dereference of 'module'. BuildNodeDecorator.java 78
Известная классическая ошибка. Кстати, в силу того, что все программисты про неё знают, она встречается на практике в коде значительно реже, чем может казаться (см. доклад "Ошибки в коде: ожидания и реальность").
Проект VNL (язык C):
integer pow_ii(integer *ap, integer *bp)
{
integer pow, x, n;
....
if (x != -1)
return x == 0 ? 1/x : 0;
....
}Предупреждение PVS-Stuidio: V609 Divide by zero. Denominator 'x' == 0. pow_ii.c 28
Если x равен 0, то произойдёт деление на ноль. Видимо, это опечатка, и, скорее всего, программист планировал написать так:
return x != 0 ? 1/x : 0;Как было сказано в главе "Выявляемые типы критических ошибок", деление на ноль на данный момент не является критической ошибкой для C#/Java согласно ГОСТ Р 71207—2024, но, скорее всего, станет таковой. Анализатор PVS-Studio уже выявляет такие ошибки, что и будет продемонстрировано.
Пример выявления ошибки в C# коде (проект Stability Matrix)
private void DelayedClearProgress(TimeSpan delay)
{
Task.Delay(delay).ContinueWith(_ =>
{
TotalProgress = new ProgressReport(0, 0); // <= (A)
});
}
public ProgressReport(int current, int total, ....)
{
if (current < 0)
throw new ArgumentOutOfRangeException(nameof(current),
"Current progress cannot negative.");
if (total < 0)
throw new ArgumentOutOfRangeException(nameof(total),
"Total progress cannot be negative.");
....
Progress = (double)current / total; // <= (B)
....
}В конструктор структуры ProgressReport передаются два параметра со значениями 0 (точка A). Поэтому параметры current и total равны 0. Автор проверяет эти значения, но не проверяет их равенство с нулём, поэтому значения не попадут под условия. Затем при определении свойства Progress параметры делятся друг на друга (точка B). Такое деление на 0 приведёт к значению NaN, так как результат деления приводится к типу double.
Предупреждение PVS-Studio: V3064 Division inside method by the 2nd argument '0' which has zero value. HuggingFacePageViewModel.cs 226
Пример выявления ошибки в Java коде (проект AutoMQ)
/**
* ....
* @param buckets the number of buckets; must be at least 1
* ....
*/
public Frequencies(int buckets,
double min,
double max,
Frequency... frequencies) {
....
if (buckets < 1) {
throw new IllegalArgumentException("Must be at least 1 bucket");
}
if (buckets < frequencies.length) {
throw new IllegalArgumentException("More frequencies than buckets");
}
....
double halfBucketWidth = (max - min) / (buckets - 1) / 2.0;
....
}Комментарий утверждает, что значение переменной buckets должно быть не меньше 1. Но на самом деле минимальным корректным значением является 2. Если buckets окажется равным 1, то произойдёт деление на ноль в строке:
double halfBucketWidth = (max - min) / (buckets - 1) / 2.0;Предупреждение PVS-Studio: V6020. Divide by zero. Denominator range ['0'..'2147483646']. Frequencies.java 104
Первый пример
Проект Shareaza (язык C):
int SetSkinAsDefault()
{
TCHAR szXMLNorm[MAX_PATH];
....
else {
free(szXMLNorm);
return 0;
}
return 1;
}Предупреждение PVS-Studio: V726 An attempt to free memory containing the 'szXMLNorm' array by using the 'free' function. This is incorrect as 'szXMLNorm' was created on stack. utils.c 92
В одной из веток выполнения программы происходит попытка освобождения памяти, выделенной на стеке, с помощью функции free.
Второй пример
Проект CodeLite (язык C++):
int clSocketBase::ReadMessage(wxString& message, int timeout)
{
....
size_t message_len(0);
....
message_len = ::atoi(....);
....
std::unique_ptr<char> pBuff(new char[message_len]);
....
}Предупреждение PVS-Studio: V554 Incorrect use of unique_ptr. The memory allocated with 'new []' will be cleaned using 'delete'. clSocketBase.cpp:282
Неправильное использование умного указателя. Для освобождения памяти будет использован оператор delete, а не delete []. Это приводит к неопределённому поведению (см. "Почему в С++ массивы нужно удалять через delete[]"). Правильный вариант кода:
std::unique_ptr<char []> pBuff(new char[message_len]);Как было сказано в главе "Выявляемые типы критических ошибок", ошибки управления динамической памятью на данный момент не являются критическими для C#/Java согласно ГОСТ Р 71207—2024, но, скорее всего, станут таковыми.
Данный класс дефектов не свойственен языкам C# и Javа, и у нас на момент написания текста нет примеров подобных ошибок, обнаруженных с помощью PVS-Studio в реальных проектах. С синтетическими примерами таких ошибок можно познакомиться в документации:
Возможно, попытка выделить эту категорию ошибок для C#/Java избыточна, и это сделано не будет. Как видите, хотя детекторы по этой тематике в PVS-Studio существуют, их мало, по крайней мере на данный момент времени.
Некорректное использование форматной строки может приводить к разнообразным ошибкам, в том числе являться уязвимостью (см. публикацию "Не зная брода, не лезь в воду. Часть вторая").
Проект Open X-Ray Engine (язык C++):
void safe_verify(....)
{
....
printf("FATAL ERROR (%s): failed to verify data\n");
....
}Предупреждение PVS-Studio: V576 Incorrect format. A different number of actual arguments is expected while calling 'printf' function. Expected: 2. Present: 1. entry_point.cpp 41
Отсутствует аргумент, который должен быть распечатан в качестве строки.
Дополнительные ссылки:
Проект System Shock (язык C):
errtype uiInit(uiSlab* slab)
{
....
errtype err;
....
// err = ui_init_cursors();
....
if (err != OK) return err;
....
}Предупреждение PVS-Studio: V614 Uninitialized variable 'err' used. EVENT.C 953
В какой-то момент строчка, где происходила запись в переменную err, была закомментирована, а проверка этой переменной осталась. Получается, что в условии используется неинициализированная переменная.
Дополнительные ссылки:
Первый пример
Проект Notepad++ (язык C++):
bool ProjectPanel::openWorkSpace(const TCHAR *projectFileName)
{
TiXmlDocument *pXmlDocProject = new TiXmlDocument(....);
bool loadOkay = pXmlDocProject->LoadFile();
if (!loadOkay)
return false;
....
}Предупреждение PVS-Studio: V773 The function was exited without releasing the 'pXmlDocProject' pointer. A memory leak is possible. projectpanel.cpp 326
Утечка памяти. Если не удастся загрузить файл, то функция досрочно завершит работу, не освободив указатель pXmlDocProject.
Второй пример
Проект CMake (язык C):
RHASH_API int rhash_file(....)
{
FILE* fd;
rhash ctx;
int res;
hash_id &= RHASH_ALL_HASHES;
if (hash_id == 0) {
errno = EINVAL;
return -1;
}
if ((fd = fopen(filepath, "rb")) == NULL) return -1;
if ((ctx = rhash_init(hash_id)) == NULL) return -1;
....
}Предупреждение PVS-Studio: V773 The function was exited without closing the file referenced by the 'fd' handle. A resource leak is possible. rhash.c 450
Утечка файлового дескриптора. Если функция rhash_init вернёт NULL, то функция rhash_file досрочно завершится, вернув статус ошибки. При этом не будет закрыт файловый дескриптор, хранящийся в переменной fd.
Как было сказано в главе "Выявляемые типы критических ошибок", эти дефекты на данный момент не являются критическими ошибками для C#/Java согласно ГОСТ Р 71207—2024, но, скорее всего, станут таковыми. Анализатор PVS-Studio уже выявляет такие ошибки, что и будет продемонстрировано.
Пример выявления ошибки в C# коде (проект RocketMan)
private SceneInfo GetSceneInfo()
{
SceneInfo sceneInfo = new SceneInfo();
try
{
var reader = new StreamReader(sceneLoadDataPath);
....
while (!reader.EndOfStream)
{
sceneList.Add(reader.ReadLine());
}
sceneInfo.scenes = sceneList;
}
....
}После использования объекта типа StreamReader требуется явно освободить выделенную под сторонние (недоступные для GC) ресурсы память, вызвав метод Dispose.
Предупреждение PVS-Studio: V3114 IDisposable object 'reader' is not disposed before method returns. OVRSceneLoader.cs 212
Код можно исправить, воспользовавшись конструкцией using:
private SceneInfo GetSceneInfo()
{
SceneInfo sceneInfo = new SceneInfo();
try
{
using (var reader = new StreamReader(sceneLoadDataPath))
{
....
while (!reader.EndOfStream)
{
sceneList.Add(reader.ReadLine());
}
sceneInfo.scenes = sceneList;
}
}
....
}Пример выявления ошибки в Java коде (проект LanguageTool)
private Dictionary getDictionary(
Supplier<List<byte[]>> lines,
String dictPath,
String infoPath,
boolean isUserDict,
int userDictSize
){
....
InputStream metadata;
if (new File(infoPath).exists()) {
metadata = new FileInputStream(infoPath); // <=
} else {
metadata = getDataBroker().getFromResourceDirAsStream(infoPath);
}
Dictionary dict = Dictionary.read(fsaInStream, metadata);
if (!isUserDict) {
dicPathToDict.put(cacheKey, dict);
} else if (userDictCacheSize != null) {
getUserDictCache().put(userDictName, dict);
}
return dict;
}Предупреждение PVS-Studio: V6127 The 'metadata' Closeable object is not closed. This may lead to a resource leak. MorfologikMultiSpeller.java 320
Интерфейс Closeable сигнализирует, что этот объект может удерживать системный ресурс, который необходимо явно освободить по завершении работы. В нашем случае FileInputStream удерживает файловый дескриптор. Если ссылка на такой файловый дескриптор будет утеряна без предварительного вызова метода close, соответствующий ресурс останется удерживаемым операционной системой до тех пор, пока сборщик мусора не вызовет финализатор. Так как мы не можем гарантировать, когда это произойдёт и произойдёт ли вообще, есть вероятность утечки.
Можно предположить, что поток будет закрыт автоматически внутри метода Dictionary.read, однако документирующий комментарий к этому методу прямо указывает на обратное:
Attempts to load a dictionary from opened streams of FSA dictionary data and associated metadata. Input streams are not closed automatically.
То есть отсутствие явного вызова close приводит к утечке файлового дескриптора. В условиях длительной работы приложения или частого вызова подобного кода это может исчерпать лимит открытых файловых дескрипторов, что приведёт к критическим ошибкам ввода-вывода и потенциально к отказу в обслуживании. Рекомендуется всегда использовать конструкции, гарантирующие детерминированное освобождение ресурсов, например try-with-resources.
В предыдущих главах уже было подробно разобрано соответствие PVS-Studio требованиям, перечисленным в ГОСТ Р 71207—2024 (раздел 7):
Остановимся на оставшихся пунктах из 7-го раздела стандарта.
Согласно ГОСТ Р 71207—2024 (п. 7.4) максимальная глубина поддерживаемого межпроцедурного анализа (количество вызовов процедур, через которые может передаваться собираемая в ходе анализа информация о потоке данных программы) не должна быть заранее ограничена, но может определяться с учётом доступных для анализа вычислительных ресурсов.
В PVS-Studio нет фиксированного ограничения на глубину анализа. Остановка осуществляется на основании эмпирических алгоритмов, защищающих от зацикливания (рекурсивных вызовов), и слишком сложном/долгом анализе вызываемых процедур.
Согласно ГОСТ Р 71207—2024 (п. 7.5) при анализе должны уточняться межмодульные связи и параметры компиляторов.
PVS-Studio учитывает параметры (ключи) компиляторов, используемые при сборке ПО. Это неотъемлемая часть выполнения анализа, так как без этого, например, невозможно в C++ программе корректно выяснить, какая модель данных используется (размеры типов), раскрыть макросы, найти подключаемые библиотеки и так далее. Анализатор учитывает межмодульные связи, так как без этого невозможен межмодульный анализ.
Примечание. В ходе испытаний статических анализаторов в 2025 году выяснилось разночтение участниками такого термина, как "контролируемая сборка ПО" (п. 3.1.12). В следующей редакции стандарта этот термин должен быть уточнён, как и разъяснено, как должен функционировать перехват сборки. Это уточнение, возможно, повлияет на будущую функциональность PVS-Studio.
Согласно ГОСТ Р 71207—2024 (п. 7.6), если статический анализатор для поиска ошибок (п. 6.3.а) применяет анализ помеченных данных, должна быть предоставлена возможность конфигурации анализа: должны задаваться процедуры-источники и процедуры-стоки чувствительных данных.
PVS-Studio поддерживает анализ помеченных данных для поиска критических ошибок, описанных в п. 6.3.а:
6.3. а) ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.).
Соответственно, PVS-Studio реализует и возможность конфигурации анализа.
Аннотация процедур-источников и стоков помеченных данных осуществляется с помощью специализированных файлов в формате JSON. Подключить файл аннотаций можно следующими способами:
Способ N1 (только для С, C++ и C# анализатора). Добавить специальный комментарий в исходный код или в файл конфигурации диагностических правил (.pvsconfig):
//V_PVS_ANNOTATIONS, language:%язык_проекта%, path:%путь/до/файла.json%Вместо символа подстановки %язык_проекта% предполагается использование одного из следующих значений:
Вместо символа подстановки %путь/до/файла.json% предполагается путь до подключаемого файла аннотаций. Поддерживаются как абсолютные, так и относительные пути. Относительные пути раскрываются относительно файла, в котором указан комментарий для подключения аннотации.
Способ N2 (только для С, C++ и Java анализатора). Указать специальный флаг --annotation-file (-A) при запуске pvs-studio-analyzer, CompilerCommandsAnalyzer или pvs-studio.jar:
pvs-studio-analyzer --annotation-file=%путь/до/файла.json%Вместо символа подстановки %путь/до/файла.json% предполагается путь до подключаемого файла аннотаций. Поддерживаются как абсолютные, так и относительные пути. Относительные пути раскрываются относительно текущей рабочей директории (CWD).
Способ N3 (только для Java анализатора). Автоматическое подключение по расширению файла.
Файлами аннотаций считаются все файлы с разрешением .annotations.json, находящиеся в директории .PVS-Studio в проекте.
Если проект находится в директории project-gradle, то все следующие файлы автоматически подтянутся анализатором как файлы аннотаций:
project-gradle/.PVS-Studio/test.annotations.json
project-gradle/.PVS-Studio/user.annotations.json
project-gradle/.PVS-Studio/sql.annotations.jsonПримечание. Могут быть подключены несколько файлов с аннотациями. Для каждого файла необходимо указать отдельный флаг или комментарий.
Написание аннотаций и примеры приводятся в следующих разделах документации:
Рассмотрим соответствие PVS-Studio различным функциональным требованиям, предъявляемых в ГОСТ Р 71207—2024 (раздел 8) к инструментальным средствам статического анализа исходного кода.
Согласно ГОСТ Р 71207—2024 (п. 8.2), статический анализатор должен поддерживать анализ ПО с используемыми заимствованными компонентами целиком, при этом удовлетворяя требованиям п. 7.3–7.6, п. 8.3 и п. 8.4.
Под этим понимается следующее:
PVS-Studio удовлетворяет всем перечисленным требованиям и позволяет проводить анализ сторонних компонентов на наличие всех типов критических ошибок.
Проверка кода заимствованных компонентов не отличается от проверки кода разрабатываемого программного обеспечения. Код компонентов аналогичным образом должен быть включён в проект, если речь идёт об использовании таких сред разработки, как Visual Studio, IntelliJ IDEA, CLion и так далее. Плагины PVS-Studio используют получаемую от IDE информацию о проверяемых файлах и конфигурационных настройках. При этом необходимо убрать из настроек ряд популярных библиотек, которые PVS-Studio исключает из анализа (zlib, jpeglib и так далее), так как они фактически тоже являются заимствованными компонентами и должны проверяться.
В случае использования утилиты мониторинга компиляции заимствованные компоненты должны компилироваться вместе с исходным кодом проекта. Подробнее про утилиты мониторинга для проверки проектов независимо от сборочной системы (C и C++):
В ГОСТ Р 71207—2024 (п. 8.3) сказано:
Следует использовать такой статический анализатор (набор анализаторов), чтобы на технических средствах разработчика ПО для поиска критических ошибок обеспечивался полный анализ ПО с используемыми заимствованными компонентами за время, не превышающее двое суток.
Разумное требование. С одной стороны, оно достаточно мягкое в плане требований к скорости работы инструментов анализа. С другой стороны, это приемлемое время, за которое разработчики получат результаты анализа всего проекта, который они, согласно ГОСТ, должны выполнять в течении 10 дней после изменения кода (п. 5.6).
Фактически это означает, что рационально настроить анализ всего разрабатываемого ПО, включая заимствованные компоненты, на выходные дни. Анализ как раз гарантированно должен проходить за два дня.
Примечание. В стандарте также сказано, что статический анализ добавленных или изменённых частей ПО следует выполнять после каждого внесённого изменения (п. 5.6). Зачем тогда нужен полный анализ? Дело в межмодульном анализе проекта. Допустим, были внесены изменения в файл AA, которые косвенно повлияли на работу функций в файле BB. Это приведёт к ошибкам в файле BB, но закладываться в систему контроля версий и проверяться с помощью статического анализа будет только файл AA, в котором ошибок нет. Чтобы выявить такую распределённую ошибку, нужен межмодульный анализ, то есть полная перепроверка проекта.
Таким образом, встаёт вопрос оценки верхней границы времени, которое требуется PVS-Studio для анализа проектов различного размера.
Проведённые измерения
Наиболее ресурсоёмким является межмодульный анализ C++ кода, в котором активно используются шаблоны и современные возможности языка. Размер проекта, выбранного для измерения скорости, составляет 10 млн. строк кода.
Конфигурация: 2 процессора Intel Xeon E5 2666 v3 (каждый процессор по 10 физических ядер / 20 логических ядер), частота 3.5 ГГц, 128 ГБ памяти, SSD диск.
Время анализа (включая межмодульный): 10 часов.
Обратите внимание, что ниже проводится оценка для одного процессора с 10 физическими ядрами, а не двух.
Расчёт ожидаемого времени для проектов различного размера:
Таким образом, PVS-Studio с запасом удовлетворяет требованиям по производительности, заданным в ГОСТ Р 71207—2024 (п. 8.3).
Если складывается ситуация, что анализ с помощью PVS-Studio занимает аномально длительное время, то, скорее всего, возникла одна из следующих ситуаций:
Дополнительно см. раздел документации "Советы по повышению скорости работы PVS-Studio".
Примечание. В документации PVS-Studio одним из советов является исключение из анализа лишних библиотек. С точки зрения ГОСТ Р 71207—2024 этим советом воспользоваться, возможно, не получится, так как все заимствованные компоненты должны проверяться при РБПО.
Испытаниях статических анализаторов в 2025 году включали в себя нагрузочное тестирование на больших проектах. Инструмент PVS-Studio хорошо показал себя на всех проектах. Полную таблицу вы можете найти на 13-м слайде презентации 10_SA_ponomarev_end , выложенной здесь.
Фрагмент таблицы, относящийся только к PVS-Studio:
Результаты применения статического анализатора PVS-Studio содержат всю информацию, перечисленную в ГОСТ Р 71207—2024 (п. 8.5):
Остановимся подробнее на пункте "Тип ошибок".
Согласно стандарту тип ошибки — это категория ошибок в программе, отражающая их общность в свойствах или характеристиках (п. 3.1.35).
Анализатор PVS-Studio детектирует более 1000 ошибок разного типа. Соответственно, для каждого типа ошибки есть своё предупреждение, состоящее из идентификатора (Vxxx), сообщения и документации. Полный список типов выявляемых ошибок.
Если смотреть более обобщённо, то анализатор PVS-Studio классифицирует свои предупреждения согласно типам критических ошибок, перечисленным в ГОСТ Р 71207—2024 (п. 6.3, п. 6.5).
Если вы включили опцию "маркировать предупреждения анализатора PVS-Studio согласно ГОСТ Р 71207—2024", то в поле SAST появятся следующие идентификаторы типа критических ошибок:
Вы можете использовать фильтрацию поля SAST в плагинах для IDE или в конверторе отчётов, чтобы выбрать для изучения только список критических ошибок или только конкретный тип критических ошибок.
Дополнительные ссылки:
В ГОСТ Р 71207—2024 (п. 8.6) говорится, что:
PVS-Studio соответствует всем требованиям и обеспечивает автоматизацию принятия решения с помощью следующих средств:
Согласно стандарту (п. 8.7) статический анализатор должен обеспечивать возможность автоматизации действий, приведённых в п. 5.6, для использования в системах непрерывной интеграции.
Анализатор PVS-Studio поддерживает следующие системы непрерывной интеграции:
Согласно п. 8.8 должно быть обеспечено хранение результатов запуска статического анализатора и разметки этих результатов. Предупреждение должно быть снабжено идентификатором, с помощью которого его можно найти в результатах анализа. Допускается использовать для хранения результатов сторонние системы.
Результатом анализа проекта с помощью PVS-Studio может быть:
Эти файлы могут быть преобразованы с помощью специальных утилит в другие форматы. Их описание находится в документации в главе "Просмотр и конвертация результатов анализа (форматы SARIF, HTML и др.)".
|
Формат |
Расширение |
Инструменты |
Описание |
|---|---|---|---|
|
PVS-Studio Log (Plog) |
.plog |
Visual Studio, SonarQube, Compiler Monitoring UI |
Для Windows пользователей Visual Studio и SonarQube |
|
JSON |
.json |
Visual Studio IntelliJ IDEA Rider CLion |
Для пользователей плагинов PVS-Studio в IDE и SonarQube |
|
SARIF |
.sarif |
Visual Studio, Visual Studio Code, есть визуализация в GitHub Actions |
Универсальный формат отчёта статического анализатора |
|
TaskList |
.tasks |
Qt Creator |
Для работы с отчётом в Qt Creator |
|
TaskList Verbose |
.tasks |
Qt Creator |
Расширение формата TaskList с поддержкой отображения дополнительных позиций |
|
CSV |
.csv |
Microsoft Excel LibreOffice Calc |
Для просмотра предупреждений в табличном виде |
|
Simple Html |
.html |
Email Client Browser |
Для рассылки отчётов почтой |
|
Full Html |
Folder |
Browser |
Для просмотра предупреждений с навигацией по коду в браузере |
|
Error File |
.err |
IDEs, Vim, Emacs, etc |
Для просмотра отчётов в любом редакторе, поддерживающем формат вывода компилятора |
|
Error File Verbose |
.err |
IDEs, Vim, Emacs, etc |
Расширение формата Error File с поддержкой отображения дополнительных позиций |
|
TeamCity |
.txt |
TeamCity |
Для загрузки и просмотра предупреждений в TeamCity |
|
MISRA Compliance |
.html |
Email Client Browser |
Для проверки кода на соответствие стандартам MISRA |
|
GitLab |
.json |
GitLab |
Для просмотра предупреждений в формате GitLab Code Quality |
|
DefectDojo |
.json |
DefectDojo |
Для загрузки и просмотра предупреждений в DefectDojo |
|
Markdown |
.markdown |
VS Code, GitHub |
Для просмотра предупреждений в формате таблицы Markdown |
Таблица N9. Форматы поддерживаемых утилитой конвертации отчётов, входящих в комплект PVS-Studio
Разметка результатов осуществляется средствами плагинов PVS-Studio для различных IDE или сторонними системами, такими как SonarQube, DefectDojo, CodeChecker.
Для выполнения задачи сравнения результатов различных запусков стандарт допускает использование сторонних систем (п. 8.9). В случае PVS-Studio такими сторонними системами являются SonarQube, DefectDojo и CodeChecker. Также эти системы обеспечивают идентификацию предупреждений.
PVS-Studio Atlas
PVS-Studio Atlas — это решение для управления результатами анализа кода с возможностью разметки предупреждений. Проект имеет две редакции: Atlas Viewer и Atlas Server.
Atlas Viewer — десктопное приложение для работы с одним отчётом анализатора PVS-Studio. Основные возможности:
Atlas Server — серверное решение для работы с отчётами статических анализаторов кода в многопользовательском режиме. Основные возможности:
На начало 2026 года находится на стадии разработки. Будет доступно для тестирования в 1–2 квартале 2026 года.
Ссылка на документацию статического анализатора кода PVS-Studio.
Дополнительно документация поставляется вместе с анализатором на случай его использования в закрытом контуре.
В случае использования анализатора без доступа в интернет (в закрытом контуре) рекомендуется включить настройку UseOfflineHelp. В этом случае плагины PVS-Studio при нажатии на идентификатор ошибки будут открывать не страницы сайта, а локальные файлы с описанием диагностических правил, поставляемые в составе анализатора.
Согласно ГОСТ Р 71207—2024 (п. 8.10) статический анализатор должен содержать в документации описание всех типов ошибок, которые он находит, с указанием:
Описание диагностических правил PVS-Studio удовлетворяет всем требованиям, перечисленным в стандарте. Рассмотрим, например, описание правила V1085, предназначенного для выявления критических ошибок целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел (п. 6.3.б).
Рисунок 1. Пример документации для диагностического правила V1085
В документации присутствуют:
Также следует указывать соответствие типа ошибки в анализаторе одному или нескольким идентификаторам в системе классификации дефектов безопасности Common Weakness Enumeration (CWE) (п. 8.10). Соответствие присутствует в конце описания диагностического правила (5).
Статический анализатор должен поддерживать выдачу результатов анализа в открытом документированном формате (п. 8.11). Примером такого стандарта является формат SARIF.
PVS-Studio поддерживает выдачу результатов анализа в следующих открытых форматах:
Подробнее см. раздел документации "Просмотр и конвертация результатов анализа (форматы SARIF, HTML и др.)".
ГОСТ Р 71207—2024 (п. 8.12) не обязывает инструмент статического анализа предоставлять пользователям механизмы для доработки алгоритмов и создания новых правил, но упоминает такую возможность.
Анализатор PVS-Studio не предоставляет пользователям возможность изменять логику работы алгоритмов или добавлять новые диагностические правила. Но по запросу наша команда реализует специализированные диагностические правила, необходимые клиентам.
PVS-Studio_Cmd.exe пoддepжaнo coxpaнeниe иcпoльзyeмыx пpи aнaлизe кoнфигypaций пpoeктoв в JSON-oтчётe. Taкжe дoбaвлeнa гpyппиpoвкa cpaбaтывaний в зaвиcимocти oт иcпoльзyeмoй кoнфигypaции aнaлизa в oтчётe fullhtml пpи гeнepaции html-oтчётa c пoмoщью yтилиты PlogConverter.exe. Oб этoм и дpyгиx фopмaтax oтчётa мoжнo пpoчитaть в дoкyмeнтaции.pvs-settings.toml и в yтилитy кoмaнднoй cтpoки pvs-js дoбaвлeнa нacтpoйкa max-old-space-size, oгpaничивaющaя oбъём пaмяти, кoтopый иcпoльзyeт Node.js-cepвep aнaлизaтopa.PVS-Studio_Cmd.exe пoявилacь вoзмoжнocть paзвopaчивaть пyти кэшeй зaвиcимocтeй oтнocитeльнo фaйлa кoнфигypaции .pvsconfig. Пoдpoбнee oб этoм мoжнo пpoчитaть в дoкyмeнтaции.default-вeтки и нeбoльшиx enum, зaдaвaть кoнкpeтныe игнopиpyeмыe знaчeния и дoпycтимoe кoличecтвo игнopиpyeмыx кoнcтaнт./skipVSIXInstallErrorCode для oтключeния нeнyлeвoгo кoдa вoзвpaтa в тaкoм cлyчae.install.sh из .tar-архивов pvs-studio и pvs-studio-dotnet на Linux/macOS. Подробное описание уязвимости и руководство к исправлению описаны в конце данного раздела.x86_64-pc-linux-gnu-c++) на Linux. Также поддержана работа с компиляторами kcc ARMV7 и TI C2000-CGT в режиме мониторинга/трассировки компиляции.sourceSets).//V_USE_OLD_PARSER в файле .pvsconfig теперь игнорируется. С развитием нового парсера C++ анализатора мы рекомендуем использовать его по умолчанию для всех проверяемых проектов. Теперь новый парсер будет включен по умолчанию в проектах, использующих более старые версии Unreal Engine, даже если в исходных файлах движка присутствует флаг //V_USE_OLD_PARSER.Скрипт установки install.sh из .tar-архивов pvs-studio и pvs-studio-dotnet на Linux/macOS мог непреднамеренно сохранять владельца, группу и контекст безопасности файлов при установке компонентов PVS-Studio в системные директории.
Это могло привести к изменению владельца, группы и атрибутов безопасности системных директорий и установленных компонентов на значения, соответствующие пользователю, выполнившему установку. В системах с SELinux, работающем в режиме enforcing, это также могло привести к установке некорректных контекстов SELinux и потенциально повлиять на работу системы после перезагрузки.
Данная уязвимость существовала в версиях PVS-Studio начиная с 7.25 и заканчивая 7.43, обе включительно.
Установки с использованием других способов распространения данным недостатком не затронуты.
Мы исправили скрипт установки таким образом, чтобы при копировании файлов не сохранялись атрибуты владельца и безопасности исходных файлов. Исправленный скрипт включён в обновлённые пакеты pvs-studio и pvs-studio-dotnet, начиная с версии 8.00.
Если ранее вы устанавливали затронутый архив, необходимо проверить владельцев, группы и контексты безопасности затронутых директорий и файлов. Для восстановления корректных владельца и группы системных директорий рекомендуется использовать значения, принятые в вашей операционной системе, а не владельца и группу, указанные в архиве или установочном каталоге.
Чтобы получить список всех компонентов PVS-Studio, установленных в системе, а также поддиректорий, права на которые могли быть изменены в результате установки, можно воспользоваться скриптом, приложенным в конце данного письма. Его выполнение на системе с установленным PVS-Studio выведет пути ко всем компонентам и их поддиректориям, права на которые может потребоваться изменить. При вызове скрипта без аргументов будут выведены пути относительно стандартного префикса установки (/usr на Linux и /usr/local на macOS). Если вы использовали префикс установки, отличный от стандартного, его следует передать при вызове скрипта в качестве единственного аргумента.
Чтобы получить пути, затронутые уязвимостью, просто запустите приложенный скрипт в терминале:
./find_pvs_paths.shИзменить права на затронутые компоненты и поддиректории можно с помощью следующей команды:
./find_pvs_paths.sh | tee /dev/stderr | \
sudo xargs -r -d '\n' -t chown <user>:<group>При этом <user>:<group> следует заменить на пользователя и группу, которые являются стандартными для указанного префикса установки. На большинстве Linux-систем системные директории /usr/bin, /usr/lib и /usr/share принадлежат root:root.
В Linux с SELinux для восстановления стандартных контекстов безопасности можно использовать команду:
./find_pvs_paths.sh | tee /dev/stderr | \
sudo xargs -r -d '\n' -t restorecon -FvВажно: эту команду следует выполнять только в том случае, если эти директории действительно были затронуты установкой PVS-Studio. Если в системе используется нестандартная конфигурация SELinux, перед выполнением команды рекомендуется проконсультироваться с администратором системы.
Скрипт вывода затронутых путей при установке PVS-Studio через tar-архив:
#!/usr/bin/env bash
if [ -n "$1" ]; then
PREFIX="$1"
elif [ -z "$PREFIX" ]; then
case "$OSTYPE" in
darwin*) PREFIX=/usr/local ;;
*) PREFIX=/usr ;;
esac
fi
PREFIX=$(realpath "$PREFIX")
find "$PREFIX" \
-path '*/node_modules/*' -prune -o \
\( \
-name 'plog-converter' -o \
-name 'blame-notifier' -o \
-path '*/pvs-*/*' -o \
-name 'libpvs-*' -o \
-name 'pvs-*' \
\) \
-print 2>/dev/null |
while IFS= read -r file; do
path="$file"
while [ "$path" != "$PREFIX" ]; do
printf '%s\n' "$path"
path="$(dirname "$path")"
done
done |
sort |
uniqИсторию версий для предыдущих релизов смотрите здесь.
Новую историю версий смотрите здесь.
compile_commands.json или с помощью мониторинга компиляции. Подробнее об этом можно прочитать в документации.pvs-studio-analyzer и CompileCommandsAnalyzer.exe) изменён код возврата в случаях, когда переданный на анализ список файлов пуст или когда запуск анализа в инкрементальном режиме не обнаружил единиц трансляции для анализа.--createBinaryLogs для логирования работы механизмов Roslyn. Подробнее об этом написано в документации.final в виртуальных функциях.async-функций, также размечены async-функции классов стандартной библиотеки. Подробнее о пользовательских аннотациях для C# анализатора можно прочитать в документации.pvs-fp-cleaner, предназначенная для удаления неактуальных маркеров подавления ложноположительных срабатываний из кодовой базы. Подробнее о её работе можно прочитать в документации. Directory.Build.props, в системах, где отсутствуют экземпляры Visual Studio..pvsconfig. Теперь анализатор правильно разрешает относительные пути для опций V_EXCLUDE_PATH и V_ANALYSIS_PATHS. Подробнее о возможностях .pvsconfig можно прочитать в документации..deb и .rpm репозиториев. Может потребоваться переустановить ключи по инструкции из документации..pvsconfig. Подробнее об этом в нашей документации.%, исправлено пропускание предупреждений в функции ReadFile, а также улучшена обработка taint-статусов в ветвлениях. Это повышает точность обнаружения потенциальных уязвимостей, связанных с непроверенными данными.= delete. Возможно повторное попадание ранее подавленных срабатываний в отчёт анализатора.brace-initializer-list для встроенных контейнеров, а также проаннотированы std::min, std::max, std::unique_ptr<T[]>::reset, std::unique_ptr<T[]>::release.constexpr и alignas.PVS-Studio_Cmd.exe и pvs-studio-analyzer..pvsconfig SAST-идентификаторов для сообщений анализатора, относящихся к потенциальным угрозам безопасности (Security Related Issues). Данные SAST-идентификаторы позволяют идентифицировать срабатывания анализатора, которые классифицируются как критические ошибки в стандарте ГОСТ Р 71207-2024, описывающем использование статических анализаторов в процессе безопасной разработки программного обеспечения. Подробнее о файлах конфигурации диагностик .pvsconfig можно прочитать в документации.pvs-studio-analyzer добавлен новый флаг --apply-pvs-configs. С помощью него включается режим автоматического поиска и применения файлов конфигурации правил .pvsconfig для проверяемых исходных файлов. Сами файлы конфигурации правил ищутся в каталоге исходного файла и во всех родительских каталогах вплоть до корневой папки проекта, которая указывается с помощью нового флага --project-root. Подробнее об этом можно прочитать в нашей документации.--analysis-paths в утилите командной строки pvs-studio-analyzer получил новый режим isolate-settings. Он позволяет изолировать настройки, задаваемые с помощью файлов конфигурации правил .pvsconfig внутри заданной директории. Настройки, лежащие в родительских для этой директории папках, в этом режиме игнорируются. Подробнее об этом можно прочитать в нашей документации. Также для данного режима были добавлены настройки для файла .pvsconfig: //V_ANALYSIS_PATHS isolate-settings и //V_ISOLATE_CURRENT_DIR. Подробнее об этом можно прочитать в соответствующем разделе документации.//IGNORE_GLOBAL_PVSCONFIG и //CONFIG_PRIORITY из файлов конфигурации .pvsconfig теперь учитываются при анализе C и C++ проектов с помощью утилиты командной строки pvs-studio-analyzer. О работе этих настроек можно подробнее прочитать в нашей документации.restrict и _Atomic и спецификаторы _Atomic(T) и _Thread_local) и C23 (спецификатор thread_local).HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Windows NT\CurrentVersion\Image File Execution Options. Подробнее об этом режиме можно прочитать в нашей документации.compile_commands.json в утилите командной строки pvs-studio-analyzer теперь игнорируются все вызовы не компиляторов. Для работы с компиляторами, имеющими нестандартные имена, которые не определяются PVS-Studio по умолчанию, можно использовать флаг --compiler. Подробнее об этом можно узнать в соответствующем разделе нашей документации.PVS-Studio_Cmd.exe был добавлен новый режим работы этого способа проверки, учитывающий неисправленные предупреждения и добавляющий файлы с ними на анализ помимо изменённых. Подробнее об этом можно прочитать в документации. Также был добавлен флаг для управления кэшами зависимостей компиляции в файл конфигурации анализатора .pvsconfig. Подробнее об этом в соответствующем разделе нашей документации.--license-path в ядре Java анализатора и licensePath в плагинах PVS-Studio для Maven и Gradle. Теперь информация о лицензии записывается по указанному в параметре пути, а не по стандартному месту расположения лицензии. Подробнее можно прочитать в документации.--convert в значении toSuppress) нет срабатываний. PVS-Studio_Cmd и pvs-studio-dotnet был добавлен режим проверки модифицированных файлов, позволяющий автоматически обнаружить изменённые между запусками анализа исходные файлы. Данный режим является альтернативой инкрементальному анализу и может быть полезен при проверке Pull Request'ов. Подробнее о новом режиме можно прочитать в документации. plog-converter была добавлена возможность отображения критических ошибок согласно ГОСТ Р 71207-2024..pvsconfig. Также данный механизм можно будет использовать для проверки Unreal Engine проектов с помощью Unreal Build Tool, начиная с версии 5.5.2. Подробнее можно прочитать в документации.pvs-studio-analyzer изменено поведение флага --sourcetree-root (-r). При подмене путей в генерируемом отчёте путь до базовой директории проверяется на существование. Если часть путей не получилось подменить, то выдаётся сообщение с предупреждением, но код возврата остаётся равным 0. Если же не получилось подменить ни один путь, то помимо сообщения с предупреждением код возврата будет ненулевым.Плагин PVS-Studio для среды разработки Microsoft Visual Studio не только предоставляет удобный графический интерфейс и возможности статического анализа, но и широкий спектр дополнительных возможностей по работе с сообщениями анализатора.
Установить его вы можете как из официального репозитория плагинов, так и при помощи нашего установщика для Windows, который доступен на странице загрузки.
Чтобы установить плагин PVS-Studio для Visual Studio из Marketplace, нужно перейти в управление плагинами (Manage Extensions) с помощью команды Extensions -> Manage Extensions и ввести в поиске PVS-Studio. В результатах поиска появится нужный плагин:
После нажатия на кнопку Download начнётся автоматическая загрузка установщика PVS-Studio для Windows, который содержит не только сам плагин, но также ядро анализатора и вспомогательные инструменты.
Установщик попросит закрыть все активные процессы в доступных средах разработки и предложит на выбор плагины для всех установленных IDE:
Первое, что нужно сделать после установки – ввести лицензию. Процесс ввода лицензии в Visual Studio подробно описан в документации.
Помимо Registration есть и другие настройки – давайте рассмотрим их подробнее.
Первый раздел в списке – это Common Analyzer Settings:
По умолчанию в этой вкладке выставляются оптимальные для использования настройки. Так ThreadCount (количество потоков) равно числу ядер на используемом процессоре.
RemoveIntermediateFiles же может понадобиться, если будет обнаружена какая-либо проблема в работе анализатора и нужно будет сообщить о ней нам. При выборе false после анализа останутся артефакты (препроцессированные файлы и файлы конфигурации), которые помогут обнаружить проблему.
Этот раздел позволяет выбрать, какие именно предупреждения вы хотите получать. Можно скрыть или показать не только отдельные срабатывания, но и целые классы диагностик:
Крайне полезный раздел, который поможет улучшить качество и скорость анализа при помощи исключения лишних файлов, которые, например, не относятся напрямую к проекту:
По умолчанию уже указаны самые распространённые исключаемые директории и расширения. Если у вас будут срабатывания, например, на third party код, то стоит добавить его в PathMasks.
Подробнее про Don't Check Files можно посмотреть в соответствующем разделе документации.
При помощи Keyword Message Filtering можно указать ключевые слова, которые нужно исключить из результатов анализа:
Например, если вам встречаются сообщения об ошибках, связанные с printf, а вы считаете, что ошибок, связанных с ними, быть не может, то добавьте ключевое слово printf. Сообщения, содержащие указанное значение, сразу же будут отфильтрованы без перезапуска анализа.
По умолчанию плагин настроен для работы в самых распространённых условиях, однако если проект имеет специфичные особенности, то можно дополнительно настроить анализатор при помощи раздела Specific Analyzer Settings:
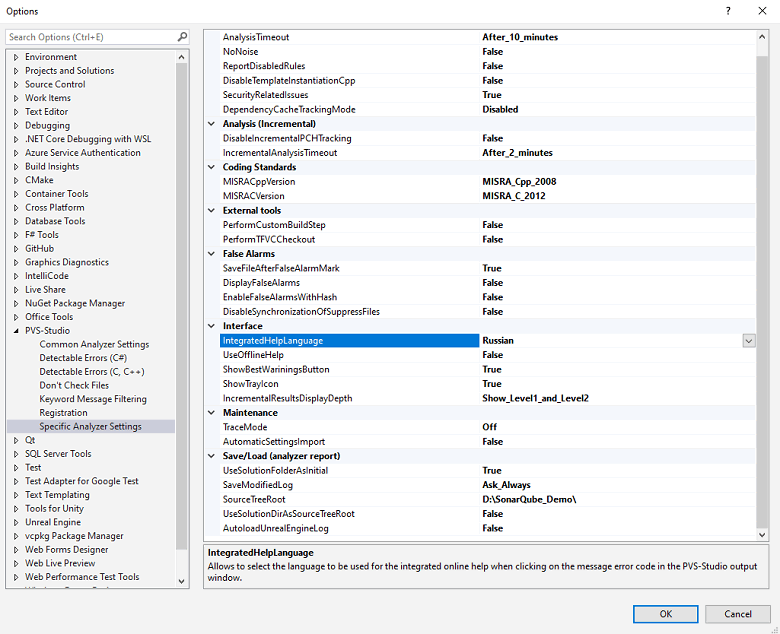
Подробное описание дополнительных настроек можно найти в специальном разделе документации.
В плагине PVS-Studio поддерживается анализ не только всего решения, но также отдельных проектов и файлов. Для запуска анализа можно выбрать интересующие файлы и проекты, и запустить на них анализ из контекстного меню:
Также всегда можно запустить анализ для текущего файла:
Дополнительно в элементе меню "Check" имеется несколько пунктов меню для более специфичных вариантов анализа:

Плагин PVS-Studio для Visual Studio поддерживает проверку проектов и исходных файлов для языков C, С++ и C#. Для языка C++ поддерживается проверка стандартных Visual C++ проектов, использующих сборочную систему MSBuild.
Для проверки специфичных проектов, таких, как, например, NMake проекты, можно воспользоваться системой отслеживания вызовов компилятора.
После анализа в IDE появится панель с результатами анализа:
Здесь можно помечать заинтересовавшие вас сообщения, подавлять ложно-позитивные срабатывания, сортировать их по разным категориям, выбирать уровни достоверности, открывать документацию к диагностикам, а также совершать многие другие манипуляции с предупреждениями.
При помощи двойного клика по строке можно легко перейти на участок кода, содержащий подозрительное место:
А при нажатии на три полоски открывается дополнительное меню панели PVS-Studio:
Подробнее про работу со списком предупреждений можно прочитать в документации.
При первом запуске анализатора на большом проекте может быть действительно много срабатываний. Разумеется, стоит выписать себе самые интересные, а вот остальные можно со спокойной душой скрыть при помощи механизма подавления предупреждений, ведь ваш код уже протестирован и работает. Так как маловероятно, что вы найдете среди них критичные для работы приложения проблемы (однако и такое может быть).
Для подавления всех предупреждений нужно выбрать пункт Suppress All Messages в дополнительной панели плагина:
После этого они будут добавлены в специальные *.suppress файлы. Так как при подавлении учитываются и соседние строки, при смещении кода сообщения не появятся вновь. Однако, если внести правку рядом с предупреждением, тогда оно будет вновь показано при последующем запуске анализа.
Подробное описание подавления предупреждений и работы с *.suppress файлами вы найдёте в разделе документации Подавление сообщений анализатора.
Также предлагаем познакомиться со статьёй "Как внедрить статический анализатор кода в legacy проект и не демотивировать команду".
Так или иначе во время работы с анализатором будут появляться ложные срабатывания (false positive). Для таких ситуаций предусмотрен специальный механизм подавления и фильтрации.
Чтобы пометить сообщение как ложное, кликните на строку с предупреждением правой кнопкой мыши и выберите Mark selected messages as False Alarms:
После этого к строке с предупреждением добавится комментарий типа //-Vxxx, где xxx – это номер диагностического правила PVS-Studio. Такой комментарий также можно добавить в код вручную. При помощи команды контекстного меню Remove False Alarm marks from selected messages можно удалить отметку ложного срабатывания с выбранных сообщений.
Если же вы не хотите добавлять комментарии в код, тогда можно воспользоваться механизмом подавления сообщений и добавить предупреждение в *.suppress файл. Чтобы это сделать, выберите другой пункт контекстного меню Add selected messages to suppression file:
Подробное описание работы механизма подавления ложных срабатываний вы найдёте в разделе документации Подавление ложно-позитивных предупреждений.
Если Вы только начали изучать инструмент статического анализа и хотели бы узнать на что он способен, то можете воспользоваться механизмом Best Warnings. Данный механизм покажет вам наиболее важные и достоверные предупреждения.
Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора нажмите на кнопку 'Best', как показано на скриншоте ниже:
После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора.
Плагин для Visual Studio добавляет окно просмотра результатов анализа PVS-Studio, которое имеет контекстное меню, появляющееся при нажатии правой кнопкой мыши в окне с результатами анализа:
Некоторым действиям из этого меню назначены горячие клавиши, что позволяет выполнять их без использования мыши.
Кнопки со стрелками, предназначенные для навигации по сообщениям анализатора, также имеют горячие клавиши:
Использование горячие клавиш полезно, потому что позволяет ускорить процесс обработки результатов анализа. Их можно назначать\переопределять в настройках: Tools -> Options -> Keyboard. Чтобы быстрее их найти, необходимо ввести 'PVSStudio' в поле поиска окна Keyboard.
На данный момент для анализа проектов, собираемых с помощью плагина Qt VS Tools, необходимо вручную проставлять пути для заголовочных файлов Qt в свойства проекта. В противном случае, анализ не пройдёт успешно, так как на данный момент у анализатора нет возможности получить информацию о заголовочных файлах от плагина Qt VS Tools.
Путь до заголовочных файлов можно получить, взяв путь до установленного Qt из Qt Version (Extensions -> Qt VS Tools -> Qt Versions) и прибавив к нему \include. Получившийся путь необходимо добавить в свойство проекта Additional Includes.
Разработка для встраиваемых систем имеет свою специфику и подходы, но контроль качества кода в этой сфере не менее важен, чем в других. PVS-Studio поддерживает анализ проектов, которые используют следующие компиляторы:
Поддерживаемыми платформами для разработки являются Windows, Linux и macOS.
После установки анализатора в Linux или macOS станет доступна утилита для анализа проектов — pvs-studio-analyzer. Подробнее о работе утилиты можно узнать тут.
В утилиту добавлено автоматическое определение поддерживаемых компиляторов, но если используется модифицированный или расширенный пакет разработки, то с помощью параметра-compiler можно перечислить имена используемых embedded-компиляторов:
-C [COMPILER_NAME...], --compiler [COMPILER_NAME...]
Filter compiler commands by compiler nameПосле установки анализатора в Windows будет доступен большой набор различных утилит, предназначенных для разных режимов работы анализатора.
Консольный режим
Анализ проекта можно автоматизировать с помощью последовательного запуска следующих команд утилиты CLMonitor:
"C:\Program Files (x86)\PVS-Studio\CLMonitor.exe" monitor
<build command for your project>
"C:\Program Files (x86)\PVS-Studio\CLMonitor.exe" analyze ... -l report.plog ...Примечание. Команда monitor запускает процесс в неблокирующем режиме.
Графический режим
В утилите Сompiler Monitoring UI необходимо перейти в режим мониторинга сборки в меню Tools > Analyze Your Files (C/C++) или щёлкнув по значку "око" на панели инструментов:
Перед запуском мониторинга сборки будет доступно следующее меню для дополнительной настройки анализа:
После запуска мониторинга следует выполнить сборку проекта в IDE или с помощью сборочных скриптов, после чего в следующем окне нажать Stop Monitoring:
Результаты анализа будут доступны в утилите Сompiler Monitoring UI после анализа файлов, участвующих в компиляции.
Примечание: Используемый по умолчанию метод отслеживания запусков компиляторов может не успеть определить все файлы исходного кода. Эта проблема особенно актуальна для Embedded проектов, поскольку они состоят из быстро компилирующихся файлов на языке C. Чтобы отследить все компилируемые файлы, читайте раздел Wrap Compilers документации утилиты мониторинга.
В отчёте анализатора могут встречаться подобные предупреждения:
V001: A code fragment from 'source.cpp' cannot be analyzed.Разработчики компиляторов для встраиваемых систем часто отходят от стандартов и добавляют в компилятор нестандартные расширения. В сфере микроконтроллеров это особенно распространено и не является чем-то необычным для разработчиков.
Но для анализатора кода это нестандартный C или C++ код, который требует дополнительной поддержки. Если на вашем коде возникают такие предупреждения, пришлите нам архив с препроцессированными *.i файлами, полученными из проблемных исходников, и мы добавим поддержку новых расширений компилятора.
Включить режим сохранения таких файлов во время анализа можно следующими способами:
Рынок пакетов разработки для встраиваемых систем очень обширен, поэтому, если вы не нашли свой компилятор в списке поддерживаемых, сообщите нам через форму обратной связи о своём желании попробовать PVS-Studio, подробно описав используемые инструменты разработки.
Для повышения качества кода или безопасности устройств в сфере разработки для встраиваемых систем часто следуют различным стандартам кодирования, например SEI CERT Coding Standard и MISRA, а также стараются избегать появления потенциальных уязвимостей, руководствуясь списком Common Weakness Enumeration (CWE). Проверка соответствия кода таким критериям присутствует и в PVS-Studio.
В этом документе собраны особенности запуска анализатора и проверки проектов для встраиваемых систем. В остальном запуск анализатора и его настройка производятся так же, как и для других типов проектов. Перед началом использования анализатора рекомендуется ознакомиться со следующими страницами документации:
В данном разделе описаны различные способы проверки кода на соответствие OWASP ASVS с помощью PVS-Studio.
Все существующие диагностические правила описаны на странице "Сообщения PVS-Studio". Если вас интересуют именно правила из группы OWASP, то вам также могут быть полезны соответствия предупреждений PVS-Studio согласно:
Как было отмечено выше, правила, связанные с OWASP, по умолчанию отключены. Далее представлены различные возможности их включения и настройки.
Если вы запускаете анализ PVS-Studio при помощи плагина для Visual Studio или какой-либо другой IDE, то активировать правила из группы OWASP можно через графический интерфейс.
Для этого необходимо перейти в настройки анализатора. К примеру, в Visual Studio 2019 нужно перейти в Extensions -> PVS-Studio -> Options:
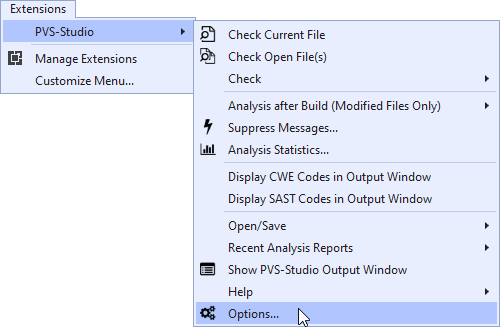
Для других IDE способы их открытия могут немного отличаться. Более подробную информацию, включая информацию о способах открытия настроек в других IDE, можно найти в разделе "Знакомство со статическим анализатором кода PVS-Studio на Windows".
В настройках необходимо перейти на вкладку "Detectable Errors" для интересующего вас языка. Здесь нужно изменить значение для группы OWASP:
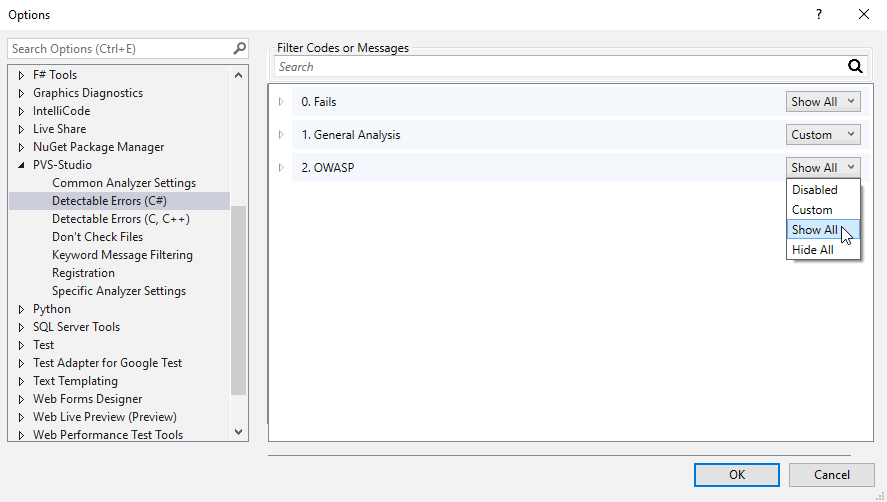
По умолчанию для группы OWASP выбрано значение 'Disabled'. Оно приводит к полному отключению соответствующих диагностик для данного языка. Чтобы включить их, нужно выбрать 'Custom', 'Show All' или 'Hide All' в зависимости от ваших целей. Подробнее об этих и других настройках можно прочитать в документации. Например, описание вкладки "Detectable Errors" представлено в разделе "Настройки: Detectable Errors".
Если было выбрано значение 'Show All', то все правила из группы будут включены и соответствующие предупреждения будут отображаться в окне вывода PVS-Studio. При этом в верхней части окна появится кнопка, отвечающая за отображение или скрытие предупреждений из соответствующей группы:
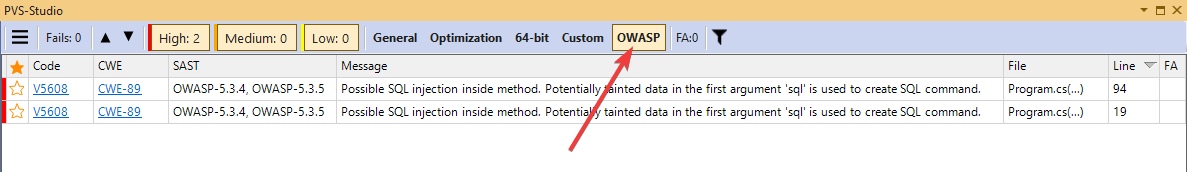
Здесь можно обратить внимание, что для предупреждений из группы OWASP указан соответствующий SAST-идентификатор. Кроме того, почти для всех предупреждений указывается подходящий им CWE. Подробно о способах настройки окна вывода предупреждений можно прочесть в разделе "Работа со списком диагностических сообщений в Visual Studio". Работа с окном в других IDE производится схожим образом.
Если анализ запускается через интерфейс командной строки, то скорее всего файл настроек будет нужно отредактировать вручную (то есть не через графический интерфейс).
В некоторых случаях настройка анализатора для разных языков отличается; также может отличаться работа под разными ОС. Ниже представлены краткие описания способов включения OWASP-правил в различных ситуациях.
Главным образом настройка C#-анализатора под любой ОС состоит в редактировании файла Settings.xml. Стоит заметить, что это тот же самый файл, который используется плагинами для Visual Studio, CLion и Rider.
По умолчанию файл лежит по пути:
Также путь к настройкам может быть передан в качестве аргумента командной строки при запуске анализа. Подробнее об этом можно прочитать в разделе "Проверка проектов Visual Studio/MSBuild/.NET из командной строки с помощью PVS-Studio".
Настройки анализатора хранятся в формате XML. Для включения правил из группы OWASP необходимо обратить внимание на следующие узлы:
Соответственно, для включения проверки соответствия кода стандарту OWASP необходимо записать в 'DisableOWASPAnalysis' и 'DisableOWASPAnalysisCs' соответствующие значения, а также убедиться, что интересующие вас правила не записаны в узле 'DisableDetectableErrors'.
Windows
Для настройки C++ анализатора на Windows также может быть использован файл Settings.xml (описание выше). Это возможно, если для анализа используется:
Для включения правил из группы OWASP необходимо установить подходящие значения для узлов 'DisableOWASPAnalysis' (аналог 'DisableOWASPAnalysisCs' для C++) и 'DisableDetectableErrors'.
Иногда может возникать необходимость в запуске C++ анализатора напрямую (через PVS-Studio.exe). Задание настроек в таком случае будет производиться с помощью файла '*.cfg'. Путь к нему должен передаваться в качестве значения параметра '--cfg':
PVS-Studio.exe --cfg "myConfig.cfg"Подробно про запуск анализа таким образом можно прочитать в разделе "Прямая интеграция анализатора в системы автоматизации сборки (C/C++)". Для включения же правил группы OWASP в конфигурационном файле необходимо проверить значение параметра 'analysis-mode'. Оно позволяет управлять включёнными группами диагностик. Оно должно быть суммой чисел, соответствующих включённым группам. К примеру, '4' соответствует анализу общего назначения, а '128' – анализу с использованием правил группы OWASP. Для того, чтобы использовать только эти 2 группы, в 'analysis-mode' нужно передать '132'. Если данный параметр не задан (или значение 0), то при анализе будут использоваться все доступные группы, в том числе и OWASP.
Кроме того, аналогичный параметр можно задавать в качестве аргумента командной строки:
PVS-Studio.exe --analysis-mode 132 ....Linux
Задание настроек под Linux производится примерно так же, как и при использовании 'PVS-Studio.exe'. Анализ производится с помощью команды 'pvs-studio-analyzer analyze'. Среди её параметров стоит отметить 'analysis-mode' и 'cfg'.
'--analysis-mode' (или '-a') устанавливает группы предупреждений, которые будут включены при анализе. Для включения правил из группы OWASP необходимо, чтобы в списке групп, разделяемых ';', присутствовало значение 'OWASP'. Например:
pvs-studio-analyzer analyze .... -a GA;MISRA;OWASP'--cfg' (или '-c') позволяет задать путь к специальному файлу конфигурации '*.cfg', который аналогичен тому, что используется для работы 'PVS-Studio.exe' (описание приведено чуть выше).
Подробную информацию можно найти в разделе "Как запустить PVS-Studio в Linux и macOS".
Работе с Java анализатором посвящён раздел "Работа с ядром Java анализатора из командной строки". В нём представлена вся информация, необходимая для запуска анализа, включения диагностик группы OWASP и т. д. Ниже записаны краткие сведения о настройках, которые нужно задать для активации OWASP.
В зависимости от того, каким именно образом вы производите анализ проектов, меняется и способ включения правил группы OWASP.
К примеру, если вы используете плагин для Maven ('pvsstudio-maven-plugin'), то в его конфигурации (в файле 'pom.xml') необходимо добавить в узел <analysisMode> значение 'OWASP', а также проверить значения в узлах <enabledWarnings> и <disabledWarnings>. Пример:
<build>
<plugins>
<plugin>
<groupId>com.pvsstudio</groupId>
<artifactId>pvsstudio-maven-plugin</artifactId>
<version>7.14.50353</version>
<configuration>
<analyzer>
<outputType>text</outputType>
<outputFile>path/to/output.txt</outputFile>
<analysisMode>GA,OWASP</analysisMode>
</analyzer>
</configuration>
</plugin>
</plugins>
</build>Если для анализа используется плагин для Gradle, необходимо открыть файл 'build.gradle' и отредактировать в блоке 'pvsstudio' значение 'analysisMode', а также проверить 'enabledWarnings' и 'disabledWarnings'. Пример:
apply plugin: com.pvsstudio.PvsStudioGradlePlugin
pvsstudio {
outputType = 'text'
outputFile = 'path/to/output.txt'
analysisMode = ["GA", "OWASP"]
}Для обоих плагинов существует и возможность конфигурирования через командную строку.
После включения правил из группы OWASP может оказаться, что срабатывания некоторых из них на вашем проекте неактуальны. Например, V5606 отвечает за проверку соответствия кода позиции 7.4.2 из OWASP ASVS:
Verify that exception handling (or a functional equivalent) is used across the codebase to account for expected and unexpected error conditions.
В соответствии с указанным требованием, правило V5606 генерирует сообщение в случае, если обнаруживает пустой блок catch или finally.
Вполне возможно, что в вашем проекте наличие пустых блоков обработки исключений является приемлемым. В этом случае сообщения V5606 вам совершенно не интересны и для удобства их стоит убрать из вывода анализатора, использовав один из описанных далее способов.
Одним из вариантов в описанной ситуации является скрытие сообщений некоторых правил с помощью общих настроек анализатора. Для этого можно либо вручную отредактировать настройки (этот момент описан выше), либо сделать это с помощью плагина для IDE:
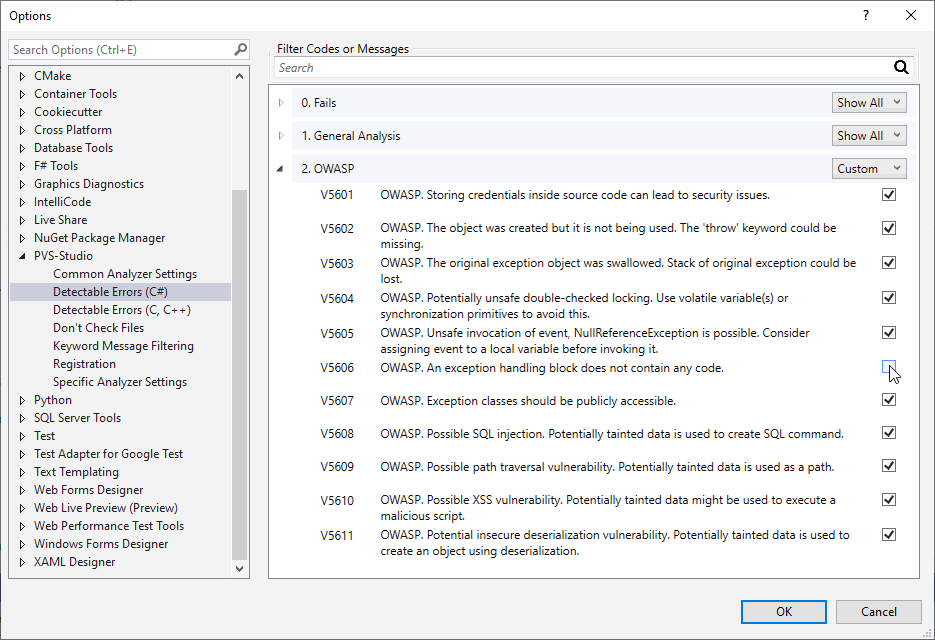
Стоит отметить, что при использовании настроек в плагине для IDE или редактировании 'Settings.xml' отдельные диагностики нельзя по-настоящему отключить (только группы целиком). Вместо этого генерируемые сообщения просто будут скрыты при просмотре лога в IDE. В некоторых случаях такое поведение может быть удобным, однако в других логичнее будет полностью отключить диагностику.
Кроме того, бывают ситуации, когда необходимо отключить срабатывания определённых уровней.
К примеру, некоторые правила, реализующие taint-анализ, считают параметры публично доступных методов источниками потенциально заражённых данных. Пояснение такого поведения можно найти в заметке "Почему важно проверять значения параметров общедоступных методов". Предупреждение, в котором источником заражения является параметр метода, выдаётся с низким уровнем.
Вполне возможно, что для вашего проекта предупреждения о необходимости валидации параметров неактуальны, однако полностью отключать правило или скрывать его предупреждения тоже не хочется. Было бы куда удобнее отключить предупреждения с конкретным уровнем.
Такую возможность, а также полное отключение диагностики, переопределение уровня и т.д. предоставляют файлы pvsconfig.
Файлы с расширением pvsconfig позволяют обеспечить дополнительную настройку анализа. На данный момент они могут быть использованы при анализе проектов на C++ и C#.
На странице "Подавление ложных предупреждений" описаны как возможности отключения диагностик с помощью pvsconfig, так и другие способы исключения нежелательных срабатываний. Прочие возможности, такие как изменение уровней предупреждений или замена подстрок в сообщениях, описаны в разделе "Дополнительная настройка диагностик".
В общем для использования функционала достаточно просто добавить файл с расширением pvsconfig в проект или решение.
Удобнее всего pvsconfig создавать через IDE, используя специальный шаблон:
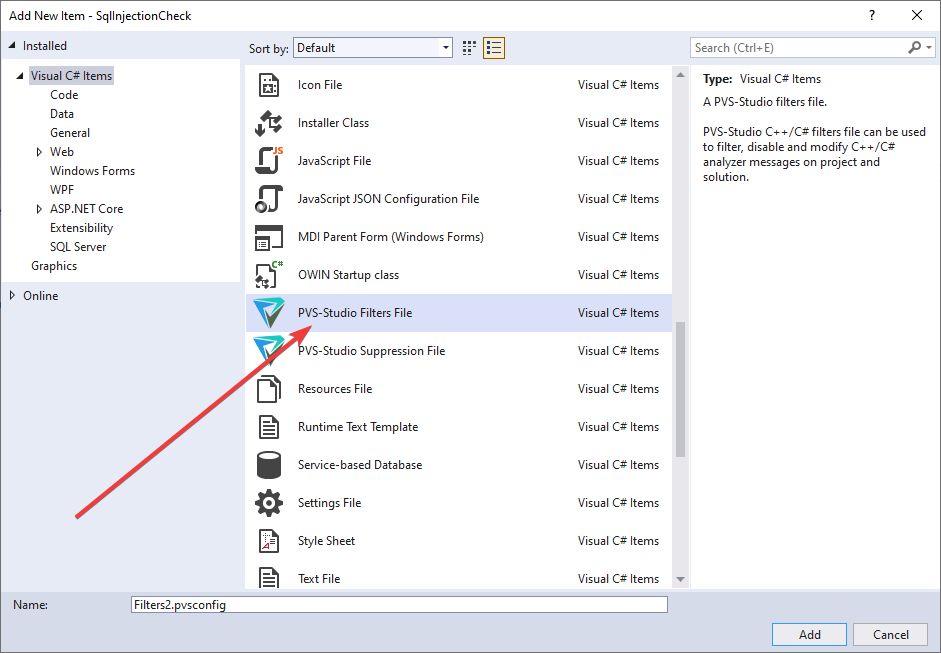
В этом случае созданный файл будет заполнен различными закомментированными примерами, что серьёзно упростит написание собственных инструкций:
# Example of PVS-Studio rules configuration file.
# Full documentation is available at
# https://pvs-studio.com/en/docs/manual/full/
# https://pvs-studio.com/en/docs/manual/0040/
#
# Filtering out messages by specifying a fragment from source code:
# //-V:textFromSourceCode:3001,3002,3003
#
# Turning off specific analyzer rules:
# //-V::3021,3022
#
# Changing in analyzer's output message:
# //+V3022:RENAME:{oldText0:newText0},{oldText1:newText1}
#
# Appends message to analyzer's message:
# //+V3023:ADD:{Message}
#
# Excluding directories from the analysis:
# //V_EXCLUDE_PATH \thirdParty\
# //V_EXCLUDE_PATH C:\TheBestProject\thirdParty
# //V_EXCLUDE_PATH *\UE4\Engine\*
#
# Redefining levels:
# //V_LEVEL_1::501,502
# //V_LEVEL_2::522,783,579
# //V_LEVEL_3::773
#
# Disabling groups of diagnostics:
# //-V::GA
# //-V::GA,OWASP
#
# Disabling messages with specified warning levels:
# //-V::3002:3
# //-V::3002,3008:3
# //-V::3002,3008:2,3
#
# Rule filters should be written without '#' character.Несложно заметить, что pvsconfig предоставляет достаточно большое количество различных способов настройки анализа – от изменения уровня до изменения самих выводимых сообщений или полного отключения диагностик. Далее представлены примеры использования некоторых возможностей pvsconfig.
Примечание. Некоторые функции могут быть доступны только для конкретных анализаторов – подробнее об этом в разделах "Подавление ложных предупреждений" и "Дополнительная настройка диагностик".
Для отключения, к примеру, правила V5606 (о пустых catch и finally), необходимо добавить в файл следующую строку:
//-V::5606Также можно и отключить выдачу диагностикой предупреждений конкретного уровня. Ранее мы рассматривали пример с taint-диагностиками, выдающими предупреждения на 3 уровне, если источником заражения является параметр. Если вам нужно, к примеру, убрать предупреждения о потенциальных SQL-инъекциях, где источником заражения будет являться параметр, то в pvsconfig нужно добавить строку
//-V::5608:3В результате предупреждения 3 уровня диагностики V5608 будут исключены из результатов анализа.
Ещё одной удобной возможностью pvsconfig является переопределение уровня выдаваемых диагностикой предупреждений. К примеру, можно переопределить уровень всех срабатываний V5609:
//V_LEVEL_2::5609Данная строка проинструктирует анализатор формировать предупреждения правила V5609 со 2 (средним) уровнем достоверности.
MISRA — это стандарт разработки программного обеспечения, созданный организацией MISRA (Motor Industry Software Reliability Association). Цель стандартов — улучшить безопасность, переносимость и надёжность программ для встраиваемых систем.
Самые отличительные черты MISRA: внимание к деталям и обеспечение безопасности. Авторы тщательно проработали международные стандарты C и C++ и выписали все возможные способы ошибиться. Стандарты MISRA C и MISRA C++ содержат список указаний для того, чтобы уменьшить вероятность ошибок, а также улучшить читаемость и сопровождаемость кода.
Указания делятся на две категории: директивы и правила.
Директива — это указание, для которого невозможно предоставить полное описание, необходимое для проведения проверки на соответствие. Для проверки требуется дополнительная информация, которая может быть представлена в проектной документации или спецификациях требований. Статические анализаторы могут помочь в проверке соответствия директивам, но разные инструменты могут давать совершенно разные интерпретации того, что является несоответствием.
Правило — это указание, для которого дано полное описание требования. Должна быть возможность проверить соответствие исходного кода правилу без необходимости использования какой-либо другой информации. Статические анализаторы способны проверять соответствие правилам с учётом ограничений.
В MISRA C 2012 правила делятся на три основных категории: Mandatory, Required и Advisory.
Mandatory — это правила, которые нельзя нарушать ни под каким предлогом. Например, в этот раздел входит правило "не используйте значение неинициализированной переменной".
Правила категории Required менее строги, они допускают возможность отклонения, но только если эти отклонения тщательно документируются и письменно обосновываются. Процесс описания формальных отклонений описан в документе MISRA Compliance 2020.
Остальные правила входят в категорию Advisory — это правила, имеющие статус рекомендательных. Но это не означает, что их можно игнорировать: их следует соблюдать в той мере, в какой это целесообразно. Соблюдать процесс описания формальных отклонений для них необязательно, однако если он не соблюдается, то должны быть приняты альтернативные меры для документирования и обоснования отклонений.
В MISRA C++ 2008 по-другому:
Помимо описания проблематики, в стандарте содержится большое количество советов о том, что нужно знать перед началом работы:
Также в конце имеются приложения, в которых содержатся: краткий список и сводная таблица правил, пример документации отклонения от правила, а также несколько чек-листов.
MISRA — это не просто набор указаний, а практически целая инфраструктура по написанию безопасного кода для встраиваемых систем.
PVS-Studio помогает искать отклонения от этого стандарта. Здесь представлена таблица соответствия диагностических правил PVS-Studio: MISRA C и MISRA C++ Coding Standards. При работе со стандартами MISRA будет полезен отчёт MISRA Compliance. Его можно сгенерировать при помощи утилит из состава PVS-Studio.
MISRA Compliance — это стандарт, который позволяет понять, соответствует ли проект стандарту MISRA C и/или MISRA C++ с учётом всех отклонений и рекатегоризаций. MISRA Compliance применим ко всем стандартам ассоциации MISRA, но рассмотрим его использование на примере стандарта MISRA C 2012.
В указаниях MISRA C 2012 говорится, что в некоторых ситуациях соблюдение требований неоправданно или даже невозможно. В случаях отклонений от правил всё должно быть задокументировано. Однако после может быть проблематично понять, соответствует ли в итоге программа данному стандарту. Здесь на помощь и приходит стандарт MISRA Compliance.
Главное — понять, соответствует ли проект MISRA C 2012 или нет. Для этого необходимо получить GCS (Guideline Compliance Summary). GCS представляет собой таблицу, где каждая запись содержит следующий набор признаков: наименование указания, его уровень и информацию о том, соответствует ли проект ему. Вот пример, как это должно выглядеть:
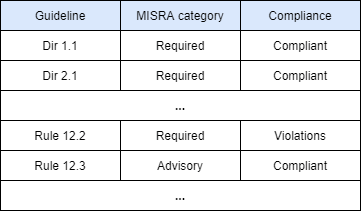
Номер указания и его категория по умолчанию берутся из стандарта. Однако MISRA Compliance позволяет изменять (рекатегоризировать) уровень указаний, хоть это и необязательно. Делается это каждым конкретным пользователем для конкретного проекта в соответствии с GRP (Guideline Re-categorization Plan). GRP — это такой допустимый набор преобразований из одного уровня в другой. Вот так это выглядит в виде таблицы:
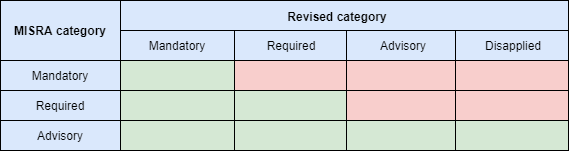
Например, есть правило 1.1, у которого уровень равен Required. Согласно таблице можно повысить уровень предупреждения до Mandatory или оставить его неизменным. Это отображено зелёными ячейками. При этом понижение уровня до Advisory или Disapplied не допускается. Это отображено красными ячейками.
На основе получившихся категорий указаний можно задать соответствия. Возможные варианты соответствий для MISRA категорий выглядят так:
Эта таблица используется для того, чтобы показать, соответствует ли проект стандарту MISRA C 2012. Если есть хотя бы одно соответствие, которое попадает в красную секцию (таблица выше), то проект не соответствует стандарту.
Чтобы было проще, опять возьмём правило 1.1 со стандартным значением категории, равной Required. В таблице видим, что допустимые значения соответствия для Required — это Compliance или Deviations (чуть подробнее о смысле этих статусов будет в пункте ниже). То есть, если проект соответствует правилу 1.1, либо соответствует, но с отклонениями, то всё хорошо и можно смотреть следующее правило. Если хотя бы одно соответствие попадает в красную зону (таблица выше), то проект не соответствуете стандарту MISRA C 2012. Если все правила имеют только допустимые значения (попадают только в зелёную зону), то проект соответствует стандарту MISRA C 2012.
Перейдём к генерации MISRA Compliance отчёта.
Чтобы сгенерировать отчёт, нужно воспользоваться утилитой PlogConverter.exe (Windows) или plog-converter (Linux, macOS). Данные утилиты также распространяются в составе дистрибутивов. На момент написания статьи PVS-Studio умеет выдавать отчёт соответствия только для стандарта MISRA C 2012.
Для генерации отчёта MISRA Compliance необходимо выполнить анализ (Windows, для Linux / macOS). Обратите внимание, что следует включить все диагностические правила, связанные с MISRA, иначе уменьшается покрытие MISRA правил. Как проверить, включены ли все правила, описано в предоставленных ссылках на документацию про анализ.
Затем нужно использовать одну из утилит конвертации отчёта. Пример запуска PlogConverter.exe:
"C:\Program Files (x86)\PVS-Studio\PlogConverter.exe" "path_to_report_file" ^
-t MisraCompliance -o "path_to_MISRA_report" --grp "path_to_grp.txt"И пример команды для plog-converter:
plog-converter "path_to_report_file" -t misra-compliance \
-o "path_to_MISRA_report" --grp "path_to_grp.txt"Сам отчёт представляет собой HTML-страницу, которая удобно подходит для печати. Вот пример отчёта, когда проект не соответствует MISRA C 2012:
Пример отчёта, когда проект соответствует MISRA C 2012:
Итак, пройдёмся по столбцам:
В нашем случае GRP представляет собой txt-файл. Пример содержания файла с допустимыми переходами:
Rule 2.1 = Mandatory
Rule 8.13 = Required
Directive 4.3 = Mandatory
Rule 2.6 = DisappliedЕсли этот файл содержит понижение категории, то утилита выдаст сообщение об ошибке и не сгенерирует отчёт. Исключением является категория Advisory, которая может понижаться до Disapplied. Вот так располагаются категории от наиболее важной к наименее важной:
Статусы соответствия проверяемого кода означают следующее:
И самое главное — это заключение о соответствии или несоответствии проекта стандарту MISRA C 2012. Код соответствует стандарту, если:
Анализатор PVS-Studio можно использовать при работе в средах разработки IntelliJ IDEA и Android Studio. Плагин PVS-Studio для этих IDE предоставляет удобный графический интерфейс для запуска анализа проектов и отдельных файлов, а также для работы с предупреждениями анализатора.
Примечание. Данный плагин также подходит для работы в средах разработки на основе IntelliJ IDEA Community Edition, например, для OpenIDE. Плагин также можно скачать из маркетплейса OpenIDE.
Плагины PVS-Studio для IntelliJ IDEA и Android Studio можно установить из официального репозитория плагинов JetBrains или из репозитория на нашем сайте. Ещё один способ установки — через установщик PVS-Studio, доступный на странице загрузки.
Для установки плагина PVS-Studio из официального репозитория JetBrains нужно открыть окно настроек с помощью команды File > Settings > Plugins, выбрать в окне вкладку Marketplace, и ввести в строке поиска PVS-Studio. В результатах поиска появится плагин PVS-Studio:
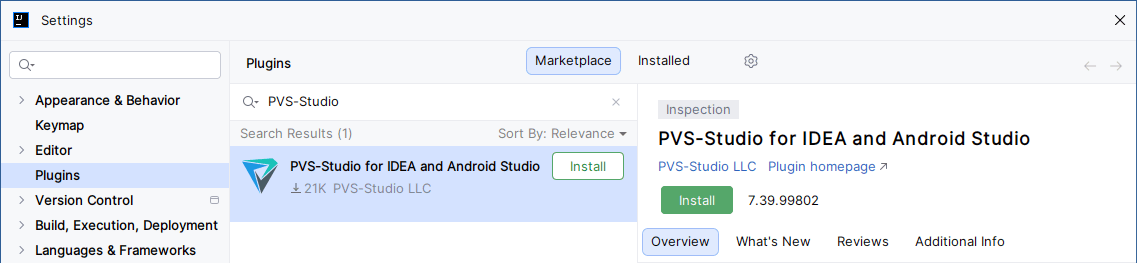
Далее нужно нажать кнопку Install напротив найденного плагина PVS-Studio. После того как установка плагина будет завершена, нужно нажать кнопку Restart IDE:
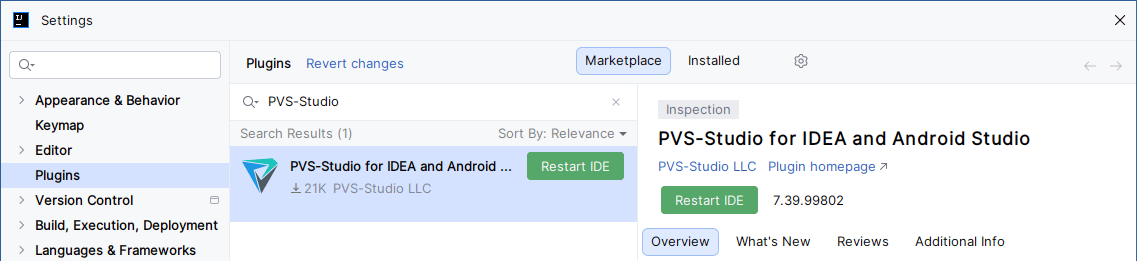
Перезапустив среду разработки, можно начать пользоваться плагином PVS-Studio для проверки кода.
Примечание. Нет необходимости загружать и устанавливать отдельно ядро Java анализатора — плагин сам загрузит и установит необходимую версию ядра при запуске анализа в IntelliJ IDEA или Android Studio.
Помимо официального репозитория JetBrains, плагин PVS-Studio также доступен из собственного репозитория PVS-Studio. Для установки плагина из репозитория PVS-Studio сначала нужно добавить репозиторий в IDE. Для этого нужно открыть окно установки плагинов с помощью команды меню File > Settings > Plugins, нажать на шестерёнку в правом верхнем углу и в выпадающем списке выбрать Manage Plugin Repositories:
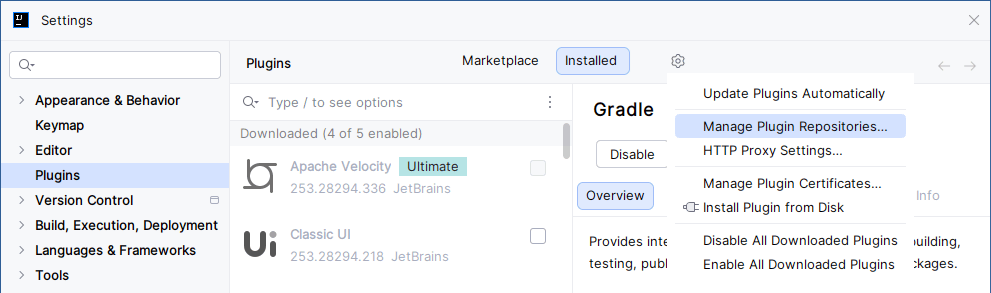
В открывшемся окне добавьте путь: https://cdn.pvs-studio.ru/java/pvsstudio-idea-plugins/updatePlugins.xml. Нажмите ОК:
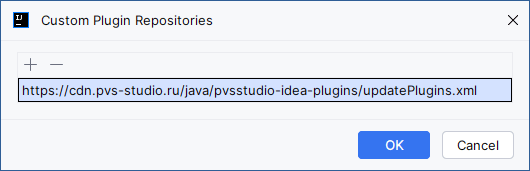
Последний шаг установки аналогичен установке плагина из официального репозитория — откройте вкладку Marketplace и введите в поиске PVS-Studio. После применения данного фильтра выберите плагин PVS-Studio for Java, нажмите Install и перезапустите среду разработки.
Для установки плагина PVS-Studio с помощью установщика на Windows, закройте все запущенные экземпляры IntelliJ IDEA, выберите пункт, соответствующий этой IDE в меню установщика, и выполните процесс установки.
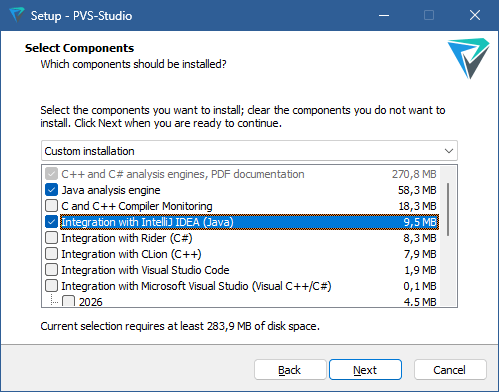
На Linux плагин PVS-Studio для IntelliJ IDEA поставляется в архиве с Java анализатором.
Примечание. О процессе установки Java анализатора PVS-Studio можно прочитать здесь.
Для того чтобы установить плагин, откройте вкладку Plugins в меню настроек плагина.
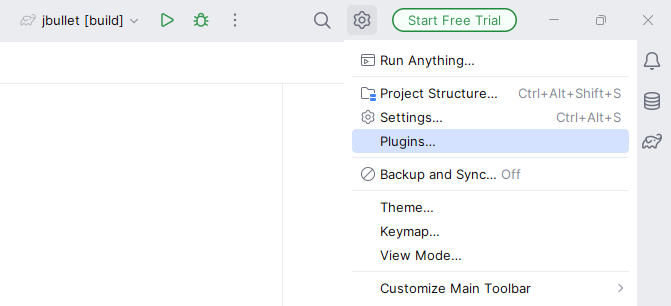
Далее откройте дополнительное меню, нажав на иконку шестерёнки, и выберите пункт Install Plugin from Disk.
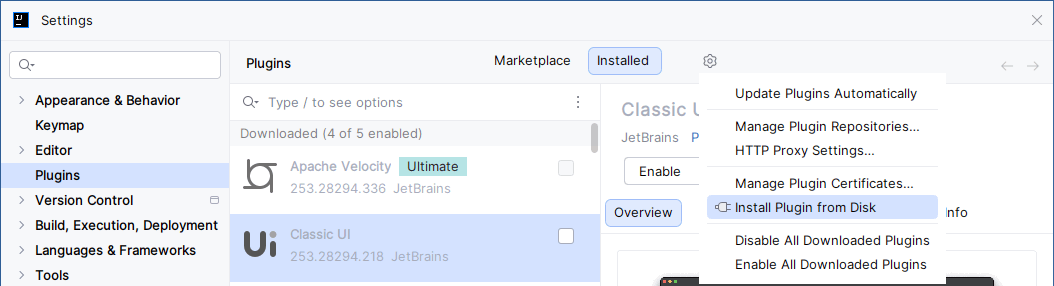
Затем укажите путь до .zip-архива с плагином, после чего плагин будет успешно установлен.
Панель настроек плагина состоит из нескольких вкладок. Рассмотрим каждую из них подробнее.
Settings — настройки ядра анализатора PVS-Studio. При наведении курсора мыши на название настройки появляется подсказка с описанием того, для чего эта настройка предназначена. Настройки из подраздела Environment используются плагином для запуска ядра Java анализатора (отдельного JVM процесса pvs-studio.jar). Стандартные значения этих настроек берутся из файла global.json. Если вы измените настройки на этой вкладке, они сохранятся в отдельный файл, переопределяющий настройки из global.json при запуске анализа. Сами изменённые настройки никак не влияют на содержимое global.json файла:
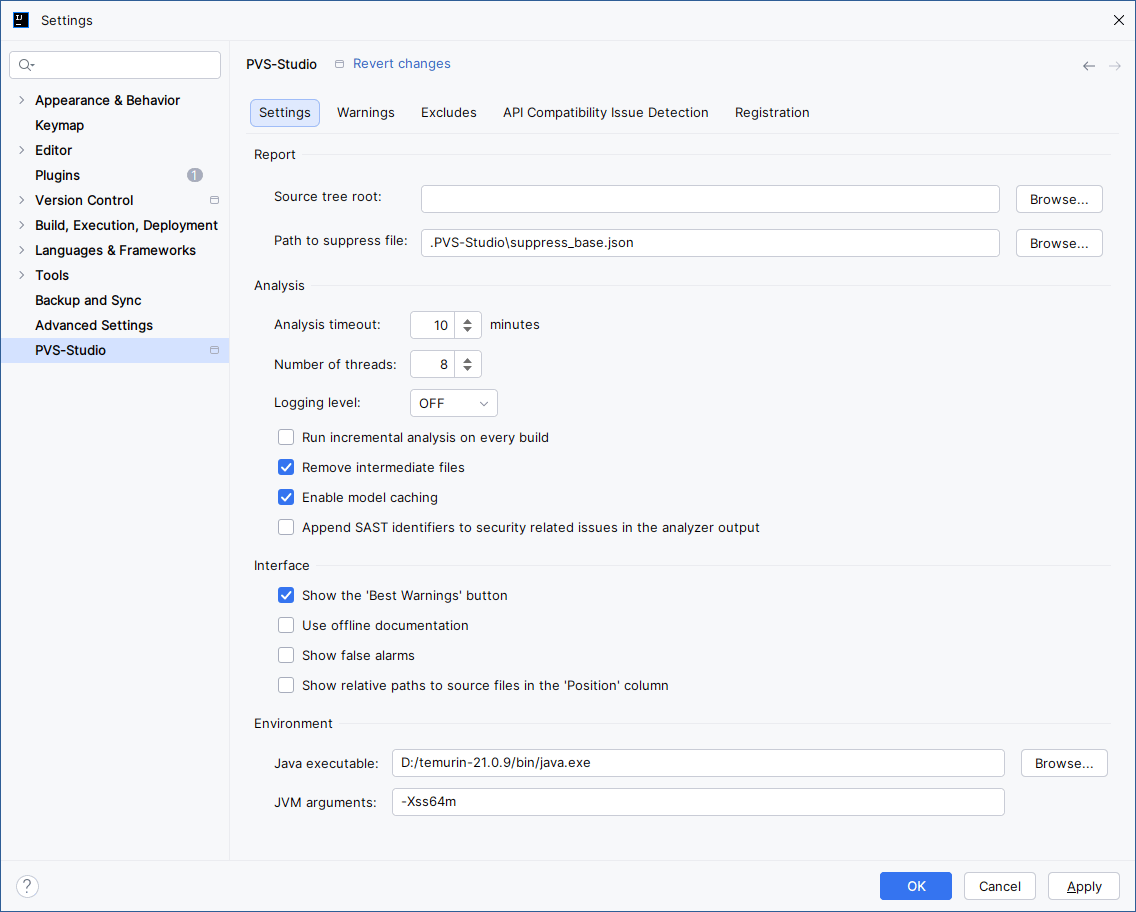
Warnings — список типов всех предупреждений, поддерживаемых анализатором. Если убрать галочку у предупреждения, то все предупреждения данного типа в таблице вывода результатов работы анализатора будут отфильтрованы, а при следующем запуске анализа соответствующее правило анализатора не будет запущено (не выдаст никаких предупреждений):
Excludes — содержит пути до файлов или директорий, которые будут исключены из анализа. Вы можете указать как абсолютный путь, так и путь относительно корневой директории проекта:
API Compatibility Issue Detection — настройки для диагностики V6078 (по умолчанию отключена). Данная диагностика позволяет узнать, изменится ли или вообще исчезнет API JDK, которое вы используете в проекте, в одной из следующих версий JDK:
Registration — отображает информацию о действующей лицензии PVS-Studio. Также на этой вкладке вы можете изменить эти данные и убедиться, что введённая лицензия действительна.
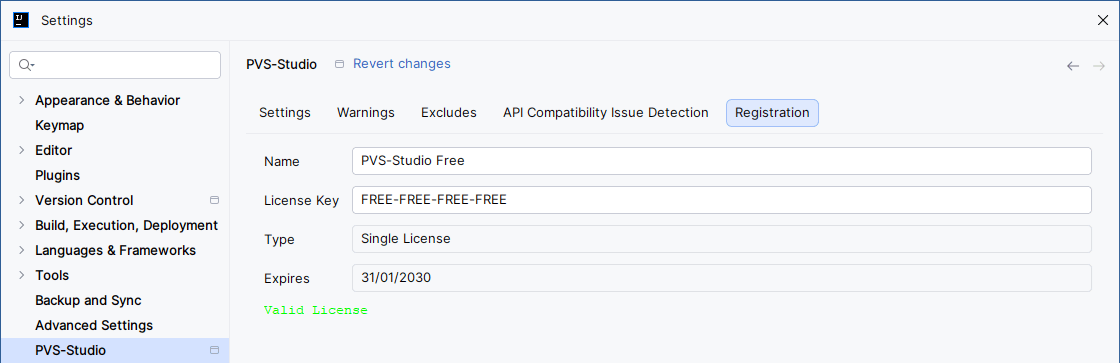
По умолчанию анализатор запускает ядро с java из переменной окружения PATH. Если вам необходимо запустить анализ с другой версией Java, её можно указать вручную. Для этого на вкладке Settings в подразделе Environment в настройках плагина необходимо в поле Java executable указать путь до java-файла из JDK. Версия этой JDK (версия языка Java) будет использована при анализе исходного кода проекта:
Перед запуском анализа вам необходимо ввести лицензию. О том, как это сделать, можно узнать в документации.
Имеется возможность анализировать:
Примечание. При анализе проекта плагин запускает ядро Java анализатора. При запуске ядра анализатора будет использована версия языка Java, соответствующая версии JDK, из которого используется файл java для запуска ядра Java анализатора (поле Java executable на вкладке Settings в настройках плагина). Если хотите изменить версию языка Java, которая будет использована при анализе, то используйте для запуска ядра Java анализатора файл java из JDK соответствующей версии.
Для анализа текущего проекта можно воспользоваться пунктом меню Tools > PVS-Studio > Check Project:
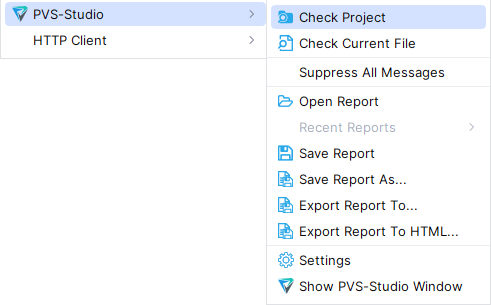
Для анализа файла, открытого на редактирование, можно использовать:
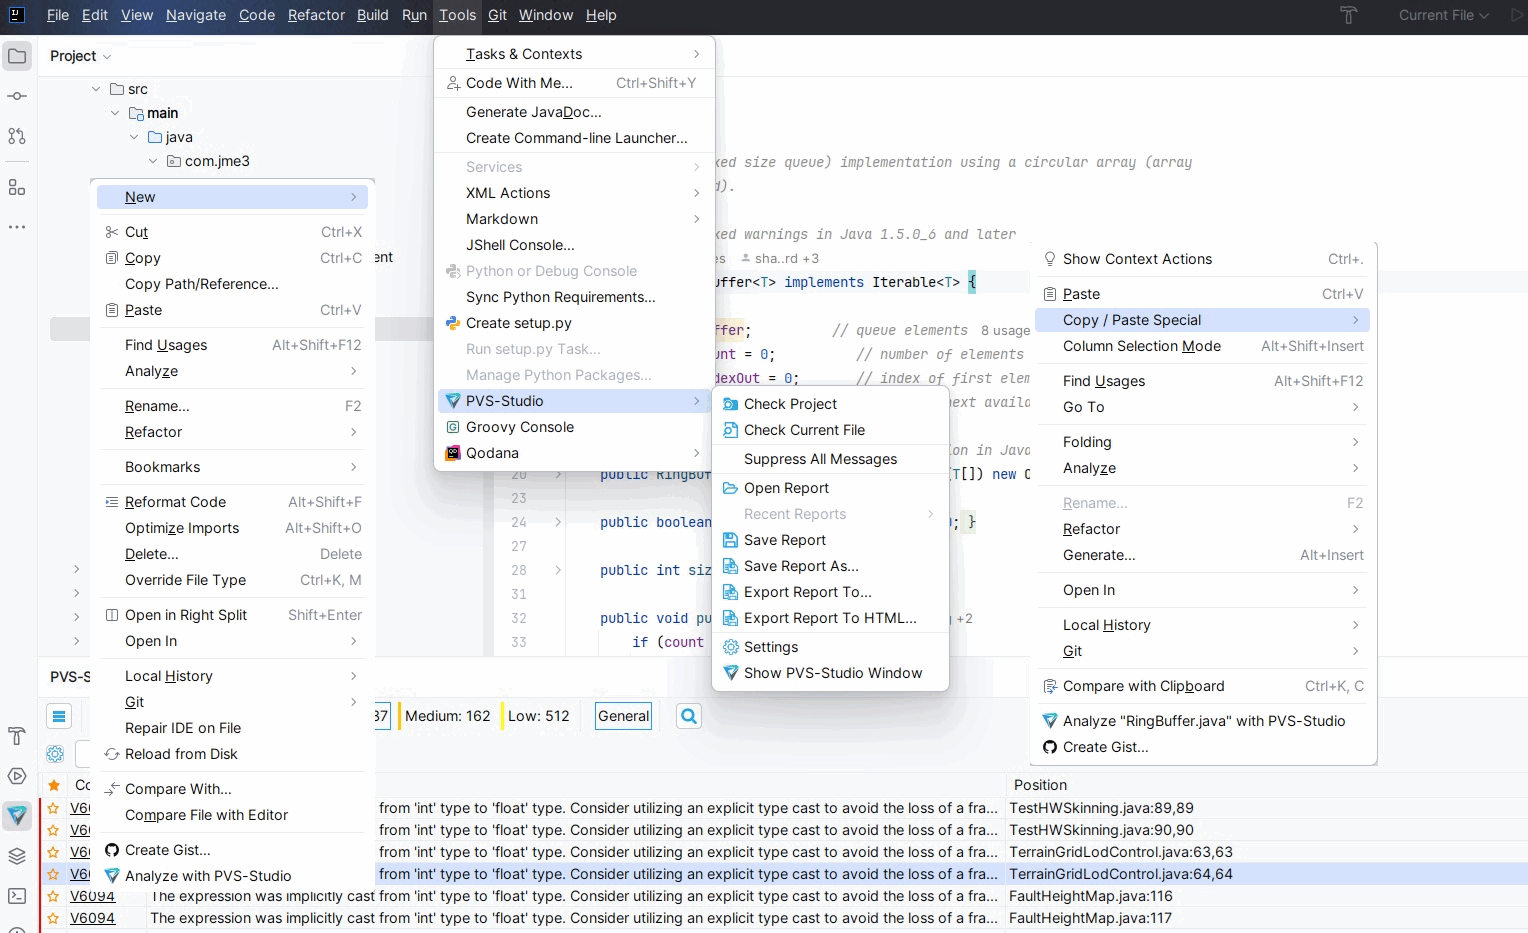
Также можно выбрать несколько элементов в окне Explorer через CTRL/SHIFT + левая кнопка мыши, после чего нажать правую кнопку мыши и выбрать Analyze with PVS-Studio:
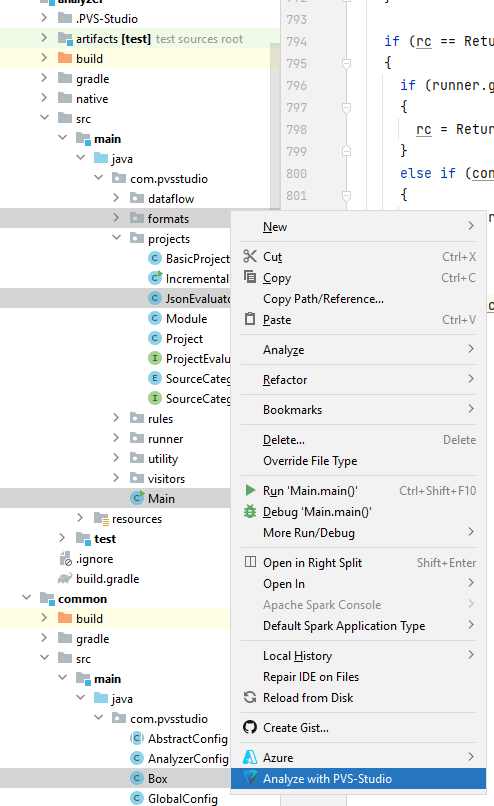
В примерах, приведённых выше, будут проанализированы:
*.java файлы (из пакета com.pvsstudio.formats); JsonEvaluator (из пакета com.pvsstudio.projects);Main (из пакета com.pvsstudio);Box из модуля common (из пакета com.pvsstudio).Во время анализа результаты работы анализатора выводятся в таблицу окна PVS-Studio:
Таблица состоит из 7 столбцов (слева направо: Favorite, Code, CWE, SAST, Message, Position, False Alarms). Имеется возможность сортировать сообщения в таблице по любому столбцу. Для изменения порядка сортировки необходимо кликнуть на заголовок столбца. Крайний левый столбец (Favorite) используется для пометки предупреждений, которая позволяет быстро найти все помеченные предупреждения, включив сортировку по столбцу Favorite:
При нажатии на строку в столбцах Code/CWE будет открыта страница в браузере с подробным описанием предупреждения или потенциальной уязвимости. В столбце SAST указывается идентификатор уязвимости кода по стандарту OWASP ASVS для предупреждения. В столбце Message содержится краткое описание предупреждения.
Столбец Position содержит список файлов, связанных с сообщением. Если вам нужно видеть путь до файла относительно папки проекта или Source Tree Root, перейдите в настройки плагина PVS-Studio и установите галочку напротив пункта Show relative paths to source files in the 'Position' column.
Крайний правый столбец False Alarms служит для отображения сообщений, помеченных как ложные срабатывания. Подробнее про работу с ложными срабатываниями будет описано в соответствующем подразделе.
Чтобы открыть файл на строке, в которой было найдено предупреждение анализатора, дважды нажмите левой кнопкой мыши на предупреждение в таблице:
Также над таблицей имеются стрелки, позволяющие переключаться между предыдущим/следующим сообщением анализатора, и открывать файл, на который это предупреждение выдано, в редакторе кода. Над таблицей имеется несколько фильтров по уровню опасности предупреждений: High, Medium, Low и Fails (ошибки анализатора):

При нажатии на лупу откроется дополнительная панель с полями ввода для столбцов Code, CWE, SAST, Message и Position. Каждое поле — это строковый фильтр для столбца, позволяющий отфильтровать сообщения из таблицы по введённому в эти поля тексту:
В левом верхнем углу, над таблицей, расположена кнопка с тремя горизонтальными полосками. При нажатии на неё откроется дополнительная панель настроек:
При нажатии на шестерёнку открывается главное окно настроек плагина, также доступное через команду меню Tools > PVS-Studio > Settings.
Если вы только начали изучать инструмент статического анализа и хотели бы узнать, на что он способен, то можете воспользоваться механизмом Best Warnings. Данный механизм покажет вам наиболее важные и достоверные предупреждения.
Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора, нажмите на кнопку 'Best':

После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора.
Иногда сообщение анализатора указывает на код, в котором нет ошибки. Это называется ложным срабатыванием (false positive).
В плагине PVS-Studio имеется возможность пометить сообщение анализатора как ложное срабатывание. Такая пометка позволяет скрывать эти сообщения анализатора при последующем анализе кода.
Для разметки ложных срабатываний необходимо выбрать одно или несколько сообщений анализатора в таблице PVS-Studio, нажать правой кнопкой мыши на любой строке в таблице и в контекстном меню выбрать пункт Mark Selected Messages As False Alarms:
После выполнения данной команды анализатор добавит к строке, на которую выдаётся предупреждение анализатора, комментарий специального вида: \\-Vxxxx, где xxxx — это номер диагностического правила PVS-Studio. Такой комментарий также можно добавить в код вручную.
Помеченные ранее ложные срабатывания можно показать в таблице окна PVS-Studio с помощью настройки Show False Alarms, доступной через команду меню Tools > PVS-Studio > Settings:
С помощью команды контекстного меню Remove False Alarm marks from selected messages можно удалить отметку ложного срабатывания с выбранных сообщений.
Подробную информацию о подавлении предупреждений, выдаваемых анализатором PVS-Studio, а также сведения о других способах подавления предупреждений анализатора можно найти в разделе документации Подавление ложных предупреждений.
Часто предупреждения, выдаваемые на legacy-код, могут мешать регулярному статическому анализу и просмотру срабатываний на новый/находящийся в разработке код.
Для решения этой проблемы в анализаторе PVS-Studio есть функция "отключения" предупреждений на старом коде. Для этого можно воспользоваться кнопкой Suppress All Messages на панели окна PVS-Studio. Механизм подавления работает с помощью специального suppress-файла: в него добавляются подавленные предупреждения анализатора после выполнения команды Suppress All Messages. При последующем запуске анализа все сообщения, добавленные в suppress-файл, не попадут в отчёт анализатора.
В IDEA подавленные предупреждения добавляются в suppress-файл suppress_base.json, который записывается в директорию .PVS-Studio, в корневой директории открытого в IDEA проекта. Чтобы вернуть все сообщения в вывод анализатора, необходимо удалить этот файл и перезапустить анализ.
Более подробное описание подавления предупреждений анализатора, и описание работы с suppress-файлами, можно прочитать в разделе документации Массовое подавление предупреждений анализатора.
Также предлагаем познакомиться со статьей: "Как внедрить статический анализатор кода в legacy проект и не демотивировать команду".
При нажатии правой кнопкой мыши, на строке с сообщением анализатора в таблице окна PVS-Studio откроется контекстное меню, содержащее дополнительные команды для выбранных сообщений анализатора.
Команда Copy Selected Messages To Clipboard копирует все выбранные в окне с результатами анализа плагина PVS-Studio предупреждения в буфер обмена.
Команда Mark Selected Messages As Important позволяет пометить звёздочкой предупреждение, чтобы в дальнейшем легко его найти при сортировке по столбцу Favorite (крайний левый столбец).
Команда Mark selected messages as False Alarms / Remove false alarm masks позволяет разметить сообщение анализатора, как ложное срабатывание, добавив в код, на который выдано предупреждение, комментарий специального вида.
Команда Add Selected Messages To Suppression File позволяет подавить предупреждения анализатора, выбранные в окне с результатами анализа плагина PVS-Studio. При следующих запусках анализа эти предупреждения не будут добавлены в окно с результатами анализа PVS-Studio.
Команда Hide All V6019 Errors позволяет скрыть все срабатывания с этим номером.
Команда Exclude from analysis позволяет добавить путь или часть пути к файлу, в котором найдено предупреждение анализатора, в список исключённых из анализа директорий. Все файлы, пути до которых попадут под данный фильтр, будут исключены из анализа.
Пункт меню Show Columns открывает список с именами столбцов, которые можно скрыть или отобразить.
Для сохранения или загрузки результатов работы анализатора можно воспользоваться командами главного меню, доступными через Tools > PVS-Studio:
Команда Open Report открывает .json-файл отчёта и загружает его содержимое в таблицу окна PVS-Studio.
Подменю Recent Reports показывает список из нескольких последних открытых файлов отчетов. При нажатии на элемент в списке будет открыт соответствующий отчет (если отчет еще существует по такому пути), и его содержимое будет загружено в таблицу окна PVS-Studio.
Команда 'Save Report' сохраняет все сообщения из таблицы (даже отфильтрованные) в .json-файл отчёта. Если текущий результат анализа ещё ни разу не сохранялся, то будет предложено задать имя и место для сохранения отчёта.
Аналогично, команда 'Save Report As' сохраняет все предупреждения из таблицы (даже отфильтрованные) в .json-файл отчёта, всегда предлагая выбрать место сохранения отчёта на диске.
Команда Export Report To... позволяет сохранить отчёт анализатора в разных форматах (.xml, .txt, .tasks, .pvslog, .log, .html, .err, .csv). Каждый формат может быть полезен в различных ситуациях и утилитах.
Команда Export Report To HTML... позволяет сохранить отчёт анализатора в выбранную папку в формате HTML. Этот формат позволяет прямо в браузере просматривать предупреждения анализатора и проводить навигацию по файлам исходного кода в браузере. В выбранной папке будет создана папка с именем fullhtml, содержащая файл отчёта анализатора (index.html).
Внимание. Вместо использования команды Export Report To HTML... более предпочтительным сценарием является использование консольных утилит PlogConverter (Windows) и plog-converter (Linux и macOS). Эти утилиты позволяют конвертировать отчёт анализатора в большее количество форматов (например, SARIF), а также предоставляют дополнительные возможности: фильтрация предупреждений из отчёта, преобразование путей в отчёте с абсолютных на относительные и наоборот, получение разницы между отчётами и др.;
Плагины PVS-Studio для IntelliJ IDEA и Android Studio добавляют окно просмотра результатов анализа PVS-Studio, которое имеет контекстное меню, появляющееся при нажатии правой кнопкой мыши в окне с результатами анализа:
Некоторым действиям из этого меню назначены горячие клавиши, что позволяет выполнять их без использования мыши.
Кнопки со стрелками, предназначенные для навигации по сообщениям анализатора, также имеют горячие клавиши:
Alt + [.Alt + ].Использование горячих клавиш полезно, потому что позволяет ускорить процесс обработки результатов анализа. Их можно назначать/переопределять в настройках: File > Settings > Keymap. Чтобы быстрее их найти, введите PVS-Studio в поле поиска окна Keymap.
В случае наличия обновления PVS-Studio сообщение об этом выведется в отчёт по завершению анализа.
Для обновления плагина нужно открыть окно настроек плагинов File > Settings > Plugins, найти в списке Installed плагин PVS-Studio for IDEA and Android Studio, нажать Update и перезапустить среду разработки.
При использовании прокси вам необходимо загрузить при помощи прокси ZIP архив для Java на странице загрузки. В этом архиве содержится ядро Java анализатора (папка с именем 8.01.110581 в директории pvs-studio-java). Ядро Java анализатора надо распаковать по стандартному пути установки ядра Java анализатора:
%APPDATA%/PVS-Studio-Java;~/.config/PVS-Studio-Java. В результате в папке по стандартному пути установки ядра Java анализатора должна находиться папка с именем версии ядра Java анализатора, скопированная из архива.
Статический анализатор кода PVS-Studio Java состоит из 2-х основных частей: ядра, выполняющего анализ, и плагинов для интеграции в сборочные системы (Maven и Gradle) и IDE (IntelliJ IDEA и Android Studio).
Функции плагинов:
Для интеграции плагина при использовании Groovy DSL необходимо добавить следующий код в скрипт сборки build.gradle:
buildscript {
repositories {
mavenCentral()
maven {
url uri('https://cdn.pvs-studio.com/java/pvsstudio-maven-repository/')
}
}
dependencies {
classpath 'com.pvsstudio:pvsstudio-gradle-plugin:latest.release'
}
}
apply plugin: com.pvsstudio.PvsStudioGradlePlugin
pvsstudio {
outputType = 'text'
outputFile = '.PVS-Studio/report.txt'
analysisMode = ['GA', 'OWASP']
}Для Kotlin DSL необходимо добавить следующий код в build.gradle.kts:
import com.pvsstudio.WarningGroup
buildscript {
repositories {
mavenCentral()
maven {
url = uri("https://cdn.pvs-studio.com/java/pvsstudio-maven-repository/")
}
}
dependencies {
classpath("com.pvsstudio:pvsstudio-gradle-plugin:latest.release")
}
}
apply<com.pvsstudio.PvsStudioGradlePlugin>()
extensions.configure<com.pvsstudio.AnalyzerConfig>("pvsstudio") {
outputType = "text"
outputFile = ".PVS-Studio/output.txt"
analysisMode = setOf(WarningGroup.GA, WarningGroup.OWASP)
}Перед первым запуском анализа вам необходимо будет ввести лицензию. Как это сделать — можно узнать в этой документации.
Для запуска анализа выполните команду:
./gradlew pvsAnalyzeОбратите внимание: при анализе проекта плагин запускает ядро Java анализатора, которое по умолчанию использует версию java из переменной окружения PATH. Задать другую версию можно при помощи настройки плагина javaPath, подробное описание которой находится ниже в разделе Конфигурация.
Для работы плагина нужно скачать его зависимости. Если вам нужно работать с плагином в системе без доступа в сеть, вы должны создать офлайн репозиторий c зависимостями плагина.
Для загрузки зависимостей и подготовки к офлайн использованию примените такую команду:
./gradlew build --refresh-dependenciesЗапускать эту команду нужно из директории с файлом build.gradle (корневой директории проекта). В этом случае все необходимые зависимости для сборки и анализа проекта будут сохранены в стандартной папке локального репозитория:
%userprofile%/.gradle/caches/modules-2/files-2.1~/.gradle/caches/modules-2/files-2.1. Вы должны иметь подключение к сети во время запуска этой команды, чтобы зависимости могли загрузиться. Для последующей работы интернет-соединение уже не нужно.
В системе должно быть установлено ядро Java той же версии, что и плагин. Узнать, как установить ядро Java анализатора, можно в отдельной документации.
Использование анализатора в таком случае не отличается от обычного. Для того чтобы Gradle не начинал скачивать зависимости, используйте флаг --offline. Команда запуска анализа в офлайн режиме:
./gradlew pvsAnalyze –-offlineНиже представлен список настроек анализатора, которые могут быть указаны в блоке pvsstudio файла build.gradle (для Groovy DSL) или build.gradle.kts (для Kotlin DSL):
additionalWarnings = ["VXXXX", ....] (Groovy) / setOf("VXXXX", ....) (Kotlin) — список диагностических правил, которые будут добавлены к анализу. Эта настройка имеет больший приоритет, чем enabledWarnings, disabledWarnings и analysisMode. Значение по умолчанию отсутствует;analysisMode = ["GA", ....] (Groovy) / setOf(WarningMode.GA, ....) (Kotlin) — список активных групп диагностических правил. Имеет меньший приоритет, чем настройки --enabled-warnings, --disabled-warnings и --additional-warnings. Значение по умолчанию: GA. Доступные группы: GA (правила общего назначения);OWASP (правила согласно OWASP Top Ten и OWASP ASVS). analyzeOnly = ["PATH", ....] (Groovy) / setOf("PATH", ....) (Kotlin) — список файлов и/или директорий, которые нужно проанализировать (абсолютные или относительный пути, которые будут раскрыты относительно каталога запуска). Файлы и/или директории, переданные в этом аргументе, объединяются в общий список с файлами и/или директориями из аргумента --analyze-only-list. При отсутствии значения для данной настройки будут проанализированы все файлы. Имеет меньший приоритет, чем exclude. Значение по умолчанию отсутствует;analyzeOnlyList = "PATH" (Groovy/Kotlin) — путь к текстовому файлу, содержащему список путей к файлам и/или каталогам для анализа (каждая запись должна быть на отдельной строке). Поддерживаются относительные (будут раскрыты относительно каталога запуска) и абсолютные пути. Файлы и/или директории, считанные из файла, указанного в этом аргументе, объединяются в общий список значений c аргументами из analyzeOnly. Эта настройка имеет меньший приоритет, чем exclude. Значение по умолчанию отсутствует;disableCache = BOOLEAN (Groovy/Kotlin) — позволяет отключить кэширование метамодели программы. При отключённом кэше модель проекта не кэшируется и строится каждый раз заново. При отключении кэширования метамодели проекта также отключается инкрементальный режим анализа проекта (настройка incremental). Значение по умолчанию: false;disabledWarnings = ["VXXXX", ....] (Groovy) / setOf("VXXX", ....) (Kotlin) — список диагностических правил, которые не будут применены во время анализа. При отсутствии данной настройки все диагностические правила считаются включёнными. Имеет больший приоритет, чем enabledWarnings и analysisMode, но меньший, чем --additionalWarnings. Значение по умолчанию отсутствует;enabledWarnings = ["VXXXX", ....] (Groovy) / setOf("VXXXX", ....) (Kotlin) — список активных диагностических правил. Во время анализа будут использованы только перечисленные в этом списке диагностические правила. Эта настройка имеет меньший приоритет, чем disabledWarnings и additionalWarnings, но больший, чем analysisMode. Значение по умолчанию отсутствует;exclude = ["PATH", ....] (Groovy) / setOf("PATH", ....) (Kotlin) — список файлов и/или директорий, которые нужно исключить из анализа. Поддерживаются относительные (будут раскрыты относительно каталога запуска) и абсолютные пути. Эта настройка имеет больший приоритет, чем analyzeOnly и analyzeOnlyList. Значение по умолчанию отсутствует. При перечислении нескольких файлов или директорий в качестве разделителя используется пробел;failOnWarnings = BOOLEAN (Groovy/Kotlin) — устанавливает ненулевой код возврата программы, если анализатор выдал хотя бы одно предупреждение. Такое поведение может быть удобным при интеграции в CI/CD. Значение по умолчанию: false;forceRebuild = BOOLEAN (Groovy/Kotlin) — позволяет принудительно перестроить целиком закэшированную метамодель программы. При использовании данного флага отключается инкрементальный режим анализа проекта (настройка incremental). Значение по умолчанию: false;incremental = BOOLEAN (Groovy/Kotlin) — позволяет запустить анализ инкрементально. В этом режиме анализируются только изменившиеся или новые файлы. Значение по умолчанию: false;javaPath = "PATH" (Groovy/Kotlin) — задаёт путь до исполняемого файла java, с которым будет запускаться ядро анализатора. Эту настройку можно задать для всей системы в файле global.json. Если не использовать javaPath, то PVS-Studio попытается использовать путь из переменной окружения PATH;jvmArguments = ["FLAG", ....] (Groovy) / setOf("FLAG", ....) (Kotlin) — дополнительные флаги JVM, с которыми будет запускаться ядро анализатора. Этот флаг позволяет настраивать JVM, которая будет запускать ядро Java анализатора. Возможно задать эту настройку для всей системы в файле global.json. Значение по умолчанию: ["-Xss64m"];licensePath = "PATH" (Groovy/Kotlin) — путь до файла с лицензией. Допустимые расширения файла: .xml, .lic. Значение по умолчанию: %APPDATA%/PVS-Studio/Settings.xml, ~/.config/PVS-Studio/PVS-Studio.lic;logging = "LEVEL" (Groovy/Kotlin) — уровень логирования при запуске анализа. При включении логирования в подпапке .PVS-Studio/logs относительно директории текущего запуска Java анализатора будут созданы файлы логов для текущего запуска. Значение по умолчанию: OFF. Допустимые варианты значений: OFF;ERROR; WARN;INFO;DEBUG; TRACE;ALL. outputFile = "PATH" (Groovy/Kotlin) — путь до файла с отчётом, куда будут записаны результаты анализа. Формат содержимого не зависит от расширения файла, указанного в данном параметре. Значение по умолчанию: $projectDir/PVS-Studio + расширение формата из настройки outputType. Для отчёта в формате fullhtml необходимо указать директорию, в которой будет создана папка с именем fullhtml, содержащая файл отчёта анализатора (index.html). Значение по умолчанию: $projectDir/fullhtml. Внимание. Вместо использования настройки outputFile более предпочтительным сценарием является использование консольных утилит PlogConverter (Windows) и plog-converter (Linux и macOS). Эти утилиты позволяют конвертировать отчёт анализатора в большее количество форматов (например, SARIF), а также предоставляют дополнительные возможности: фильтрация предупреждений из отчёта, преобразование путей в отчёте с абсолютных на относительные и наоборот, получение разницы между отчётами и др.; outputType = "TYPE" (Groovy/Kotlin) — формат, в котором будет представлен отчёт анализатора. Значение по умолчанию: json. Допустимые варианты значений:text;log;json; xml;tasklist; html;fullhtml; errorfile. securityRelatedIssues = BOOLEAN (Groovy/Kotlin) — позволяет выделить дополнительной маркировкой в поле SAST предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207—2024. Значение по умолчанию: false;sourceTreeRoot = "PATH" (Groovy/Kotlin) — корневая часть пути, которую анализатор будет использовать при генерации относительных путей в отчёте для диагностических предупреждений. Значение по умолчанию отсутствует;suppressBase = "PATH" (Groovy/Kotlin) — путь до suppress-файла, содержащего подавленные предупреждения анализатора. Они не попадут в отчёт при следующих проверках проекта. Значение по умолчанию: ./.PVS-Studio/suppress_base.json;threadsNum = NUMBER (Groovy/Kotlin) — позволяет задать число потоков, на которое будет распараллелен анализ. Можно задать эту настройку для всей системы в файле global.json. Значение по умолчанию: число доступных логических ядер;timeout = NUMBER (Groovy/Kotlin) — таймаут анализа одного файла (в минутах). Эту настройку можно задать для всей системы в файле global.json. Значение по умолчанию: 10; compatibility = BOOLEAN (Groovy/Kotlin) — активирует диагностическое правило V6078, которое обнаруживает потенциальные проблемы совместимости API между выбранными версиями Java SE. Значение по умолчанию: false;excludePackages = ["PACK", ....] (Groovy) / setOf("PACK", ....) (Kotlin) — пакеты, которые будут исключены из анализа совместимости. Используется диагностическим правилом V6078, если включена настройка compatibility;sourceJava = NUMBER (Groovy/Kotlin) — задаёт версию Java SE, на которой разработано приложение. Эта настройка используется диагностическим правилом V6078, если включена настройка compatibility. Минимальное значение: 8. Максимальное значение: 14;targetJava = NUMBER (Groovy/Kotlin) — задаёт версию Java SE, на совместимость с которой необходимо проверить API, используемое в приложении (sourceJava). Эта настройка используется диагностическим правилом V6078, если включена настройка compatibility. Минимальное значение: 8. Максимальное значение: 14;Настройки могут быть переданы через командную строку в момент запуска анализа. Формат определения:
-Ppvsstudio.<nameSingleParam>=value
-Ppvsstudio.<nameMultipleParam>=value1;value2;value3Пример:
./gradlew pvsAnalyze -Ppvsstudio.outputType=text
-Ppvsstudio.outputFile=.PVS-Studio/report.txt
-Ppvsstudio.disabledWarnings=V6001;V6002;V6003Обратите внимание, что параметры, явно переданные в командной строке, имеют наивысший приоритет.
По умолчанию анализатор запускает ядро с java из переменной окружения PATH. Если необходимо запустить анализ с другой версией, её можно указать вручную. Для этого в настройке анализатора javaPath укажите путь до java из JDK. Версия этой JDK (версия языка Java) будет использована при анализе исходного кода проекта:
....
javaPath = "C:/Program Files/Java/jdk19.0.5/bin/java"
....Благодаря использованию latest.release в качестве версии плагина в файле build.gradle или build.gradle.kts у вас всегда будет использоваться последняя версия PVS-Studio для анализа.
При использовании прокси необходимо указать логин и пароль для корректной загрузки ядра анализатора.
Это можно сделать через аргументы:
-Dhttp.proxyUser, -Dhttp.proxyPassword-Dhttps.proxyUser, -Dhttps.proxyPassword-Djava.net.socks.username, -Djava.net.socks.password-Dftp.proxyUser, -Dftp.proxyPasswordКоманда для запуска анализа через плагин для Gradle с прокси:
./gradlew pvsAnalyze "-Dhttp.proxyUser=USER" "-Dhttp.proxyPassword=PASS"Статический анализатор кода PVS-Studio Java состоит из 2-х основных частей: ядра, выполняющего анализ и плагинов для интеграции в сборочные системы (Maven и Gradle) и IDE (PVS-Studio для IntelliJ IDEA и Android Studio).
Функции плагинов:
Для интеграции плагина необходимо добавить следующий код в файл pom.xml:
<pluginRepositories>
<pluginRepository>
<id>pvsstudio-maven-repo</id>
<url>https://cdn.pvs-studio.com/java/pvsstudio-maven-repository/</url>
</pluginRepository>
</pluginRepositories>
<build>
<plugins>
<plugin>
<groupId>com.pvsstudio</groupId>
<artifactId>pvsstudio-maven-plugin</artifactId>
<version>8.01.110581</version>
<configuration>
<analyzer>
<outputType>text</outputType>
<outputFile>.PVS-Studio/report.txt</outputFile>
<analysisMode>GA,OWASP</analysisMode>
</analyzer>
</configuration>
</plugin>
</plugins>
</build>Перед запуском анализа вам необходимо будет ввести лицензию. Как это сделать — можно узнать в этой документации.
Для запуска анализа выполните команду:
mvn pvsstudio:pvsAnalyzeКроме того, анализ можно включить в цикл сборки проекта, добавив элемент <execution>:
<plugin>
<groupId>com.pvsstudio</groupId>
<artifactId>pvsstudio-maven-plugin</artifactId>
<version>8.01.110581</version>
<executions>
<execution>
<phase>compile</phase>
<goals>
<goal>pvsAnalyze</goal>
</goals>
</execution>
</executions>
</plugin>Обратите внимание: при анализе проекта плагин запускает ядро Java анализатора, которое по умолчанию использует версию java из переменной окружения PATH. Задать другую версию можно при помощи настройки плагина javaPath, подробное описание которой находится ниже в разделе Конфигурация.
Для работы плагина нужно скачать его зависимости. Если вам нужно работать с плагином в системе без доступа в сеть, вы должны создать офлайн репозиторий c зависимостями плагина. Для этого вы можете использовать maven-dependency-plugin.
Для загрузки зависимостей и подготовки к офлайн использованию примените такую команду:
mvn dependency:go-offlineЗапускать эту команду нужно из директории с файлом pom.xml (корневой директории проекта). В этом случае все необходимые зависимости для сборки и анализа проекта будут сохранены в стандартной папке локального репозитория: %userprofile%/.m2/repository на Windows или ~/.m2/repository на Linux/macOS.
Для сохранения офлайн репозитория в другую папку используйте параметр maven.repo.local. Команда в таком случае будет выглядеть так:
mvn dependency:go-offline -Dmaven.repo.local=/custom/pathВы должны иметь подключение к сети во время запуска этой команды, чтобы зависимости могли загрузиться. Для последующей работы интернет-соединение уже не нужно.
В системе должно быть установлено ядро Java той же версии, что и плагин. Узнать, как установить ядро Java анализатора, можно в отдельной документации.
Использование анализатора в таком случае не отличается от обычного. Для того чтобы Maven не начинал скачивать зависимости, используйте флаг --offline (-o). Пример команды запуска анализа в офлайн режиме с использованием пользовательского локального репозитория:
mvn -o pvsstudio:pvsAnalyze -Dmaven.repo.local=/custom/pathВ блоке <analyzer> производится настройка анализатора. Ниже представлен список настроек анализатора:
<additionalWarnings>VXXXX, ....</additionalWarnings> — список диагностических правил, которые будут добавлены к анализу. Эта настройка имеет больший приоритет, чем <enabledWarnings>, <disabledWarnings> и <analysisMode>. Значение по умолчанию отсутствует;<analysisMode>GA, ....</analysisMode> — список активных групп диагностических правил. Настройки <enabledWarnings>, <disabledWarnings> и <additionalWarnings> имеют больший приоритет, чем эта настройка. То есть, если диагностическая группа отключена (или включена), то можно включить (или отключить) отдельные диагностические правила при помощи этих настроек. Значение по умолчанию: GA. Доступные группы: GA (правила общего назначения);OWASP (правила согласно OWASP Top Ten и OWASP ASVS). <analyzeOnly>PATH, ....</analyzeOnly> — список файлов и/или директорий, которые нужно проанализировать (абсолютные или относительный пути, которые будут раскрыты относительно каталога запуска). Файлы и/или директории, переданные в этом аргументе, объединяются в общий список с файлами и/или директориями из аргумента <analyzeOnlyList>. При отсутствии значения для данной настройки будут проанализированы все файлы. Имеет меньший приоритет, чем настройка <exclude>. Значение по умолчанию отсутствует;<analyzeOnlyList>PATH</analyzeOnlyList> — путь к текстовому файлу, содержащему список путей к файлам и/или каталогам для анализа (каждая запись должна быть на отдельной строке). Поддерживаются относительные (будут раскрыты относительно каталога запуска) и абсолютные пути. Файлы и/или директории, считанные из файла, указанного в этом аргументе, объединяются в общий список со значениями из аргумента <analyzeOnly>. Этот настройка имеет меньший приоритет, чем <exclude>. Значение по умолчанию отсутствует;<disableCache>BOOLEAN</disableCache> — позволяет отключить кэширование метамодели программы. При отключенном кэше модель проекта не кэшируется и строится каждый раз заново. При отключении кэширования также отключается инкрементальный режим анализа, даже если указан параметр <incremental>. Значение по умолчанию: false;<disabledWarnings>VXXXX, ....</disabledWarnings> — список диагностических правил, которые не будут применены во время анализа. При отсутствии данной настройки все диагностические правила считаются включёнными. Имеет больший приоритет, чем настройки <enabledWarnings> и <analysisMode>, но меньший, чем <additionalWarnings>. Значение по умолчанию отсутствует;<enabledWarnings>VXXXX, ....</enabledWarnings> — список активных диагностических правил. Во время анализа будут использованы только перечисленные. Эта настройка имеет меньший приоритет, чем <disabledWarnings> и <additionalWarnings>, но больший, чем <analysisMode>. Значение по умолчанию отсутствует;<exclude>PATH, ....</exclude> — список файлов и/или директорий, которые нужно исключить из анализа (абсолютные или относительные пути, которые будут раскрыты относительно каталога запуска). Эта настройка имеет больший приоритет, чем <analyzeOnly> и <analyzeOnlyList>. Значение по умолчанию отсутствует;<failOnWarnings>BOOLEAN</failOnWarnings> — устанавливает ненулевой код возврата программы, если анализатор выдал хотя бы одно предупреждение. Такое поведение может быть удобным при интеграции в CI/CD. Значение по умолчанию: false;<forceRebuild>BOOLEAN</forceRebuild> — позволяет принудительно перестроить целиком закэшированную метамодель программы. При использовании данного флага отключается инкрементальный режим анализа проекта, даже если указан флаг <incremental>. Значение по умолчанию: false;<incremental>BOOLEAN</incremental> — позволяет запустить анализ инкрементально. В этом режиме анализируются только изменившиеся файлы. Значение по умолчанию: false;<javaPath>PATH</javaPath> — задаёт путь до исполняемого файла java, с которым будет запускаться ядро анализатора. Настройку можно задать для всей системы в файле global.json. Если не использовать <javaPath>, то PVS-Studio попытается использовать путь из переменной окружения PATH;<jvmArguments>FLAG, ....</jvmArguments> — дополнительные флаги JVM, с которыми будет запускаться ядро анализатора. Этот флаг позволяет настраивать JVM, которая будет запускать ядро Java анализатора. Возможно задать эту настройку для всей системы в файле global.json. Значение по умолчанию: ["-Xss64m"];<licensePath>PATH</licensePath> — путь до файла с лицензией. Допустимые расширения файла: .xml, .lic. Значение по умолчанию: %APPDATA%/PVS-Studio/Settings.xml (Windows) или ~/.config/PVS-Studio/PVS-Studio.lic (macOS и Linux);<logging>LEVEL</logging> — уровень логирования при запуске анализа. При включении логирования в подпапке .PVS-Studio/logs относительно директории текущего запуска Java анализатора будут созданы файлы логов для текущего запуска. При передаче некорректного значения логирование будет отключено. Значение по умолчанию: OFF. Допустимые варианты значений: OFF;ERROR; WARN;INFO;DEBUG; TRACE;ALL. <outputFile>PATH</outputFile> — путь до файла с отчётом анализатора. Формат содержимого отчёта не зависит от расширения файла, указанного в этом аргументе. Значение по умолчанию: ./PVS-Studio + расширение формата из аргумента --output-type. Для отчёта в формате .fullhtml необходимо указать директорию, в которой будет создана папка с именем fullhtml, содержащая файл отчёта анализатора (index.html). Значение по умолчанию: ./fullhtml. Примечание. Вместо использования настройки <outputFile> предпочтительнее использовать консольные утилиты PlogConverter (Windows) и plog-converter (Linux и macOS). Они позволяют конвертировать отчёт анализатора в большее количество форматов (например, SARIF), а также предоставляют дополнительные возможности: фильтрация предупреждений из отчёта, преобразование путей в отчёте с абсолютных на относительные и наоборот, получение разницы между отчётами и др.;<outputType>TYPE</outputType> — формат, в котором будет представлен отчёт анализатора. Значение по умолчанию: json. Допустимые варианты значений:text;log;json;xml;tasklist;html;fullhtml; errorfile. <securityRelatedIssues>BOOLEAN</securityRelatedIssues> — позволяет выделить дополнительной маркировкой в поле SAST предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207—2024. Значение по умолчанию: false;<sourceTreeRoot>PATH</sourceTreeRoot> — корневая часть пути, которую анализатор будет использовать при генерации относительных путей в отчёте для диагностических предупреждений. Значение по умолчанию отсутствует;<suppressBase>PATH</suppressBase> — путь до suppress-файла, содержащего подавленные предупреждения анализатора. Они не попадут в отчёт при последующих проверках проекта. Значение по умолчанию: ${basedir}/.PVS-Studio/suppress_base.json;<threadsNum>NUMBER</threadsNum> — число потоков анализа. Можно задать эту настройку для всей системы в файле global.json. Значение по умолчанию: число доступных логических ядер;<timeout>NUMBER</timeout> — таймаут анализа одного файла в минутах. Можно задать для всей системы в файле global.json. Значение по умолчанию: 10;<compatibility>BOOLEAN</compatibility> — активирует диагностическое правило V6078, которое обнаруживает потенциальные проблемы совместимости API между выбранными версиями Java SE. Значение по умолчанию: false;<excludePackages>"PACK", ....</excludePackages> — пакеты, которые будут исключены из анализа совместимости. Эта настройка используется диагностическим правилом V6078, если включена настройка <compatibility>;<sourceJava>NUMBER</sourceJava> — версия Java SE, на которой разработано анализируемое приложение. Эта настройка используется диагностическим правилом V6078, если включена настройка <compatibility>. Минимальное значение: 8. Максимальное значение: 14;<targetJava>NUMBER</targetJava> — версия Java SE, на совместимость с которой проверяется API, используемое в анализируемом приложении (<sourceJava>). Эта настройка используется диагностическим правилом V6078, если включена настройка <compatibility>. Минимальное значение: 8. Максимальное значение: 14;Формат определения:
-Dpvsstudio.<nameSingleParam>=value
-Dpvsstudio.<nameMultipleParam>=value1;value2;value3Пример:
mvn pvsstudio:pvsAnalyze -Dpvsstudio.outputType=text
-Dpvsstudio.outputFile=.PVS-Studio/report.txt
-Dpvsstudio.disabledWarnings=V6001;V6002;V6003Обратите внимание, что параметры, явно переданные в командной строке, имеют наивысший приоритет.
По умолчанию анализатор запускает ядро с Java из переменной окружения PATH. Если необходимо запустить анализ с другой версией, её можно указать вручную. Для этого в настройке анализатора <javaPath> укажите путь до Java из JDK. Версия этой JDK будет использована при анализе исходного кода проекта:
....
<javaPath>C:/Program Files/Java/jdk19.0.5/bin/java</javaPath>
....Для обновления pvsstudio-maven-plugin необходимо изменить версию плагина в файле pom.xml.
При использовании прокси необходимо указать логин и пароль для корректной загрузки ядра анализатора.
Это можно сделать через аргументы:
-Dhttp.proxyUser, -Dhttp.proxyPassword;-Dhttps.proxyUser, -Dhttps.proxyPassword;-Djava.net.socks.username, -Djava.net.socks.password;-Dftp.proxyUser, -Dftp.proxyPassword.Команда для запуска анализа через плагин для Maven с прокси:
mvn pvsstudio:pvsAnalyze "-Dhttp.proxyUser=USER" "-Dhttp.proxyPassword=PASS"PVS-Studio - статический анализатор С, С++, C#, Java, Go, JS и TS кода, предназначенный для облегчения задачи поиска и исправления различного рода ошибок. Анализатор можно использовать в Windows, Linux и macOS.
При работе с Windows анализатор интегрируется в Visual Studio в качестве плагина, предоставляя программисту удобный интерфейс для ориентации в коде и поиска проблемных мест. Также присутствует приложение C and C++ Compiler Monitoring UI (Standalone.exe), независимое от Visual Studio и позволяющее проверять файлы, компилируемые не только с помощью Visual C++, но и с использованием GCC (MinGW), Clang. Консольная утилита PVS-Studio_Cmd.exe позволит выполнять проверку MSBuild / Visual Studio проектов без запуска IDE или Compiler Monitoring UI, что позволит, например, использовать анализатор как часть процесса CI.
PVS-Studio для Linux представляет собой консольное приложение.
В данном документе описываются основы работы с PVS-Studio на операционных системах семейства Windows. Для получения информации о работе в среде Linux обратитесь к разделам документации "Установка и обновление PVS-Studio в Linux" и "Как запустить PVS-Studio в Linux и macOS".
Статический анализатор не заменяет другие инструменты поиска ошибок - он дополняет их. Внедрение такого инструмента позволяет устранять многие ошибки на этапе "зарождения", тем самым экономя время и ресурсы на их последующее устранение. Ведь чем раньше найдена ошибка, тем дешевле стоимость её исправления. Из этого следует ещё один вывод - статический анализатор необходимо использовать регулярно, именно в таком случае он проявит себя наиболее эффективно.
PVS-Studio разделяет все предупреждения по 3 уровням достоверности: High, Medium и Low. Также некоторые сообщения относятся к особой категории Fails. Рассмотрим эти уровни подробнее:
Стоит помнить, что конкретный код ошибки не обязательно привязывает её к определённому уровню достоверности, а распределение сообщений по уровням сильно зависит от контекста, в котором они были сгенерированы. При использовании плагина для Microsoft Visual Studio или в приложении C and C++ Compiler Monitoring UI окно вывода диагностических сообщений содержит кнопки уровней, позволяющие сортировать сообщения по мере необходимости.
Также имеется возможность упростить ознакомление и начальную работу с отчетом с помощью механизма отображения наиболее интересных предупреждений.
Анализатор содержит 5 видов диагностических правил:
Краткие обозначения групп диагностик (GA, OP, 64, CS, MISRA), наряду с номерами уровней достоверности предупреждений (1, 2, 3), используются для сокращенной формы записи, например, в параметрах командной строки. Пример: GA:1,2.
Выбор группы диагностических правил отображает или скрывает соответствующие сообщения.
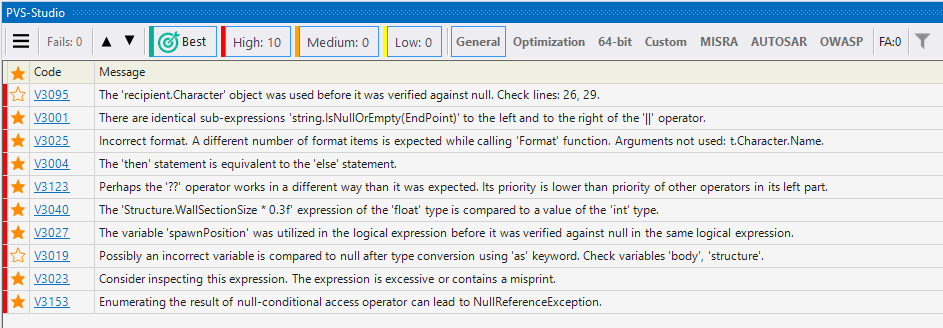
С подробным списком диагностических правил вы можете ознакомиться в соответствующем разделе документации.
Сообщения анализатора можно группировать и фильтровать по различным критериям. Для получения более подробной информации о работе со списком предупреждений анализатора обратитесь к разделу документации "Работа со списком диагностических сообщений".
При установке PVS-Studio присутствует возможность выбора того, в какие среды Microsoft Visual Studio необходимо провести интеграцию.
После выбора необходимых пунктов и установки, PVS-Studio интегрируется IDE. На скриншоте ниже можно увидеть соответствующий пункт в меню Visual Studio, а также окно вывода диагностических сообщений.
В меню настроек есть возможность настроить PVS-Studio оптимальным образом для удобства работы. Например, присутствуют следующие возможности:
Скорее всего, для первого знакомства все эти настройки вам не понадобятся, но в будущем они позволят оптимизировать работу с PVS-Studio.
Подробное описание возможностей плагина для Visual Studio можно найти в разделе документации "Работа PVS-Studio в Visual Studio".
При установке анализатора присутствует возможность интеграции плагина PVS-Studio в IDE IntelliJ IDEA, что позволит проводить анализ и работать с отчётами анализатора непосредственно из IDE.
После установки плагин будет доступен в меню 'Tools' ('Tools' > 'PVS-Studio'). Ниже представлен скриншот IntelliJ IDEA с интегрированным плагином PVS-Studio.
В меню настроек, как и в случае с плагином для Visual Studio, также присутствуют возможности отключения диагностических правил, исключение файлов / директорий из анализа и пр.
Особенности работы Java анализатора, а также альтернативные способы установки (включая установку плагинов для Maven, Gradle) описаны в разделе документации "Работа с ядром Java анализатора из командной строки".
При установке анализатора присутствует возможность интеграции плагина PVS-Studio в IDE JetBrains Rider, что позволит проводить анализ и работать с отчётами анализатора непосредственно из IDE.
После установки плагин доступен в меню 'Tools'. Анализ текущего solution / проекта можно выполнить следующим образом: 'Tools' > 'PVS-Studio' > 'Check Current Solution/Project'.
Ниже представлен скриншот IDE JetBrains Rider с интегрированным плагином PVS-Studio.
Более подробно использование плагина PVS-Studio для IDE JetBrains Rider описано в разделе документации "Работа PVS-Studio в JetBrains Rider".
PVS-Studio может использоваться независимо от интегрированной среды разработки Microsoft Visual Studio. Compiler Monitoring UI позволяет проверять проекты в процессе их сборки. В этой версии также поддерживаются переходы по коду по диагностическим сообщениям, поиск фрагментов кода, определений макросов и типов данных. Более подробно работа с этим приложением описана в разделе документации "Просмотр результатов анализа в приложении C and C++ Compiler Monitoring UI".
PVS-Studio_Cmd.exe - модуль, позволяющий выполнять анализ решений Visual Studio (.sln), а также Visual C++ и Visual C# проектов (.vcxproj, .csproj) из командной строки. Это может быть полезно, например, в случае необходимости интеграции статического анализа на сборочном сервере. PVS-Studio_Cmd.exe позволяет проводить как полный анализ целевого проекта, так и инкрементальный (анализ файлов, изменившихся с момента последний сборки). Представление кода возврата работы утилиты в виде битовой маски позволяет получить подробную информацию о результатах анализа и идентифицировать проблемы, в случае их наличия. Таким образом, используя модуль PVS-Studio_Cmd.exe, можно достаточно 'тонко' настроить сценарий статического анализа кода и внедрить его в процесс CI. Более подробно использование модуля PVS-Studio_Cmd.exe описано в разделе документации "Проверка Visual C++ (.vcxproj) и Visual C# (.csproj) проектов из командной строки с помощью PVS-Studio".
PVS-Studio обладает обширной справочной системой диагностических сообщений. Эта база доступна как при работе с инструментом PVS-Studio, так и на официальном сайте. К различным диагностическим сообщениям прилагаются примеры кода, содержащего подобные ошибки, описание проблемы, а также возможные варианты исправления.
Чтобы изучить описание той или иной диагностики, достаточно кликнуть левой кнопкой мыши по номеру диагностики в окне вывода сообщений. Эти номера оформлены как гиперссылки.
Поддержка для PVS-Studio осуществляется посредством электронной почты. Так как с клиентами общаются непосредственно разработчики анализатора, это позволяет быстро получать ответы на самые разные вопросы.
Анализатор PVS-Studio интегрируется в среды разработки Microsoft Visual Studio 2026, 2022, 2019, 2017, 2015, 2013, 2012, 2010. Системные требования к анализатору можно найти в соответствующем разделе документации.
Получив установочный пакет PVS-Studio, можно приступить к установке программы.
После подтверждения лицензионного соглашения будет предоставлен выбор вариантов интеграции PVS-Studio в поддерживаемые среды разработки: Microsoft Visual Studio. Варианты интеграции, недоступные на текущей системе, будут затемнены. В случае, если на машине установлено несколько версий одной или разных IDE, возможна интеграция анализатора во все имеющиеся версии.
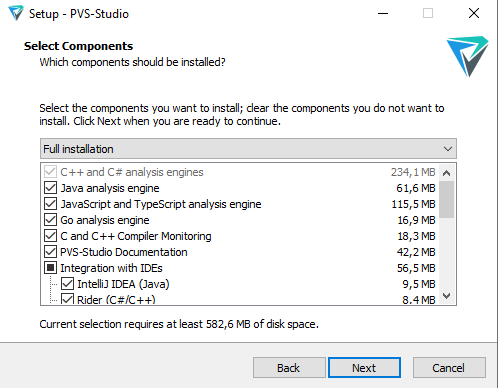
Для того чтобы удостовериться, что инструмент PVS-Studio корректно установлен, можно запустить IDE и открыть окно About (пункт меню Help). При этом анализатор PVS-Studio должен присутствовать в списке установленных компонентов.
При работе в IDE Visual Studio можно запускать различные варианты анализа - на решение, проект, файл, выбранные элементы и т.п. Например, запуск анализа решения выполняется следующим образом: "PVS-Studio -> Check -> Solution".
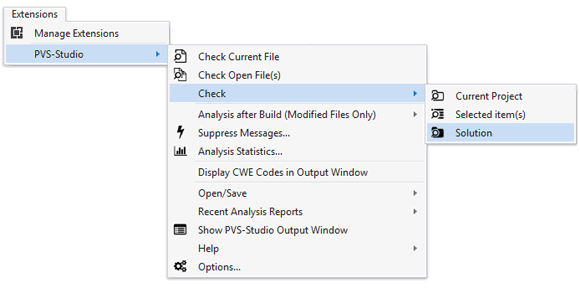
После запуска проверки на экране появится индикатор прогресса с кнопками Pause (приостановить анализ) и Stop (прервать анализ). Обнаруженные потенциально опасные конструкции во время анализа будут выводиться в окно найденных дефектов.
Термин "потенциально опасная конструкция" означает, что данную конкретную строку кода анализатор посчитал дефектом. Является ли эта строка реальным дефектом в приложении или нет - определить может только программист, основываясь на своем знании приложения. Этот принцип работы с анализаторами кода очень важно правильно понимать. Никакой инструмент не может полностью заменить программиста в работе по исправлению ошибок в программах. Только программист, основываясь на своих знаниях, может это сделать. Но инструмент может и должен помочь программисту в этом. Поэтому задача анализатора кода - это сократить количество мест в программе, которое должен просмотреть и разобрать программист.
Скорее всего, в больших реальных проектах диагностических сообщений будет не несколько десятков, а несколько сотен или даже тысяч. И просмотр всех подобных сообщений может быть непростой задачей. Для того чтобы облегчить ее, в анализаторе PVS-Studio имеются несколько механизмов, таких как фильтрация сообщений по коду ошибки, фильтрация по содержимому текста диагностического сообщения, фильтрация на основе путей к файлам и другие. Рассмотрим примеры использования систем фильтрации.
Предположим, что вы уверены, что диагностические сообщения с кодом V112 (использование магических чисел) никогда не являются реальными ошибками в вашем приложении. Тогда можно отключить показ этих диагностических сообщений с помощью настроек анализатора кода на вкладке "Detectable Errors (C++)".
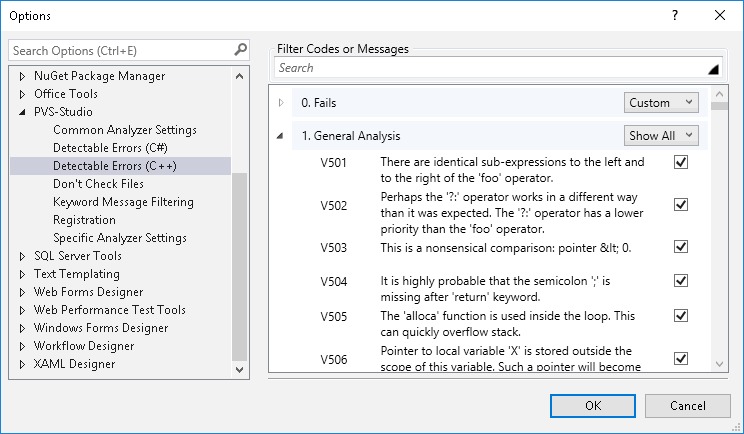
После отключения предупреждения с определённым кодом соответствующие предупреждения будут отфильтрованы в окне вывода, перезапускать анализ не требуется. Если же включить обратно показ таких сообщений, то они вновь появятся в списке предупреждений.
Теперь рассмотрим другой вариант фильтрации на основе текста диагностических сообщений. Рассмотрим пример предупреждения анализатора и кода, на который оно было выдано:
obj.specialFunc(obj);Предупреждение анализатора: V678 An object is used as an argument to its own method. Consider checking the first actual argument of the 'specialFunc' function.
Анализатор счёл подозрительным, что в качестве аргумента методу передаётся тот же объект, у которого этот метод и вызывается. Программисту, в отличии от анализатора, может быть известно о том, что такое использование данного метода вполне допустимо. Поэтому может возникнуть необходимость отфильтровать все подобные предупреждения. Сделать это можно, добавив соответствующий фильтр в настройках "Keyword Message Filtering".
После этого все диагностические сообщения, текст которых содержит указанное выражение, пропадут из списка без необходимости перезапускать анализатора кода. Вернуть их можно просто удалив выражение из фильтра.
Ещё одним механизмом сокращения количества диагностических сообщений является фильтрация по маскам имён файлов проекта и путям к ним.
Предположим, в вашем проекте используется библиотека Boost. Анализатор будет, конечно же, сообщать и о потенциальных проблемах в этой библиотеке. Скорее всего, вас эти предупреждения интересовать не будут, поэтому целесообразно отфильтровать их. Сделать это можно, просто добавив путь к папке с Boost на странице "Don't check files":
После этого диагностические сообщения, относящиеся к файлам в этой папке, не будут показаны.
Также в PVS-Studio имеется функция "Mark as False Alarm". Благодаря ей возможно пометить в исходном коде те строки, на которые анализатор выдал предупреждения, являющиеся ложными. После разметки анализатор более не будет выдавать диагностических сообщений на этот код.
Так в этом примере отключен вывод диагностического сообщения с кодом V640:
for (int i = 0; i < m; ++i)
for (int j = 0; j < n; ++j)
matrix[i][j] = Square(i) + 2*Square(j);
cout << "Matrix initialization." << endl; //-V640
....Подробно этот механизм описана в разделе "Подавление ложных предупреждений".
Есть также ряд других способов повлиять на выводимые диагностические сообщения путем настроек анализатора кода, но в рамках данного документа они не рассматриваются. Рекомендуем обратиться к документации по настройкам анализатора кода.
Когда вы просмотрите все сообщения, которые выдал анализатор кода, то вы найдете как реальные ошибки в программах, так и конструкции, не являющиеся ошибочными. Дело в том, что анализатор не может на 100% точно определить все ошибки в программах без так называемых "ложных срабатываний". Только программист, зная и понимая программу, может определить есть в конкретном месте ошибка или нет. Анализатор кода же только существенно сокращает количество мест, которые необходимо просмотреть разработчику.
Таким образом, добиваться исправления всех потенциальных проблем, на которые указывает анализатор кода, смысла, конечно же, нет.
Механизмы подавления отдельных предупреждений и массового подавления сообщений анализатора описаны в разделах документации "Подавление ложных предупреждений" и "Массовое подавление сообщений анализатора" соответственно.
В данном документе описывается использование command-line утилит для анализа MSBuild проектов (.vcxproj / .csproj) и решений Visual Studio (solutions).
Использование плагинов для IDE Visual Studio и Rider описано в соответствующих разделах документации: "Знакомство со статическим анализатором кода PVS-Studio на Windows" и "Работа PVS-Studio в JetBrains Rider".
Для анализа C# проектов может потребоваться установка дополнительных .NET SDK. Подробнее про это можно узнать в документации "Системные требования анализатора PVS-Studio".
Command-line анализатор MSBuild / .NET Core проектов имеет разные имена на разных поддерживаемых анализатором платформах:
PVS-Studio_Cmd (анализ решений, C#, C++ проектов на Windows);pvs-studio-dotnet (анализ решений, C# проектов на Linux / macOS).Описываемые ниже особенности актуальны для обеих утилит. Примеры с PVS-Studio_Cmd / pvs-studio-dotnet являются взаимозаменяемыми, если явно не указано обратное.
Примечание. Для анализа C++ проектов, не использующих сборочную систему MSBuild, на Windows следует воспользоваться системой мониторинга компиляции или прямой интеграцией анализатора в сборочную систему. Анализ C++ проектов на Linux / macOS подробно описан в этом разделе документации.
Command-line утилиты по умолчанию распаковываются в следующие директории:
C:\Program Files (x86)\PVS-Studio\;/usr/share/pvs-studio-dotnet/;/usr/local/share/pvs-studio-dotnet.Команда --help выведет все доступные аргументы анализатора:
PVS-Studio_Cmd.exe --helpПриведём пример запуска проверки решения mysolution.sln:
PVS-Studio_Cmd.exe -t "mysolution.sln" -o "mylog.plog"Рассмотрим основные аргументы анализатора:
--target (-t) (обязательный): позволяет указать объект для проверки (.sln или .csproj / .vcxproj файл). Примечание. Если вы используете WSL для анализа, убедитесь, что ваш проект находится в файловой системе Linux, иначе анализ будет на порядок медленнее. Подробнее тут;--output (-o): путь до файла, в который будут записаны результаты анализа. Если данный параметр пропущен, файл отчёта анализатора будет создан рядом с файлом, указанным через флаг --target. Поддерживается сохранение отчёта анализатора в двух форматах: .json и .plog. Тип формата определяется по указанному расширению. По умолчанию, без указания данного флага, на Windows будет создан отчёт в формате .plog, а на Linux и macOS — в формате .json;--platform (-p) и --configuration (-c): платформа и конфигурация, для которых будет запущена проверка. Если данные параметры не указаны, будет выбрана первая из доступных пар "платформа|конфигурация" (при проверке .sln файла) либо "Debug|AnyCPU" (при проверке отдельного .csproj проекта) или "Debug|Win32" (при проверке отдельного .vcxproj проекта);--sourceFiles (-f): запускает режим проверки списка файлов. Передаваемое значение — путь до текстового файла, содержащего список путей до исходных файлов для анализа (каждый должен быть на отдельной строке). Поддерживаются относительные и абсолютные пути. В данном режиме при анализе C и C++ файлов генерируется файл кэша зависимостей единиц компиляции от заголовочных файлов, который используется для уменьшения времени анализа при повторных запусках. Расположением кэша зависимостей можно управлять с помощью флага --dependencyRoot (-D). Нельзя использовать вместе с флагом --regenerateDependencyCacheWithoutAnalysis (-W). Важно: при использовании этого аргумента с аргументами --selectProjects (-S) и/или --excludeProjects (-E) вначале будет применена фильтрация проектов, а после среди файлов оставшихся проектов будет произведён поиск и анализ файлов из --sourceFiles (-f);--analyzeModifiedFiles (-F): запускает анализ только модифицированных файлов. Информация о модификации файлов определяется путём сравнения хэша, вычисленного на основе содержимого исходных файлов. Вычисленные хэши хранятся в кэше зависимостей. Кэш конфигурируется с помощью флагов --dependencyRoot (-D) и --dependencyCacheSourcesRoot (-R). Нельзя использовать вместе с флагами --regenerateDependencyCache (-G), --regenerateDependencyCacheWithoutAnalysis (-W) и --sourceFiles (-f). Важно: при использовании этого аргумента с аргументами --selectProjects (-S) и/или --excludeProjects (-E) вначале будет применена фильтрация проектов, а после среди файлов оставшихся проектов будет произведён поиск и анализ измененных файлов; --regenerateDependencyCache (-G): генерирует или обновляет для всех исходных файлов проектов кэш зависимостей компиляции, который используются вместе с флагом --sourceFiles (-f) и запускает анализ всех исходных файлов проектов. Отфильтровать проекты возможно при помощи флагов --selectProjects (-S) и --excludeProjects (-E). При передаче вместе с этим флагом флага --sourceFiles (-f), будет произведена полная перегенерация кэшей зависимостей для всех исходных файлов проектов, а анализ будет запущен только для списка файлов, переданных в --sourceFiles (-f). Нельзя использовать вместе с флагом --analyzeMoifiedFiles (-F);--regenerateDependencyCacheWithoutAnalysis (-W): генерирует или обновляет для всех исходных файлов проектов кэш зависимостей компиляции, который используется вместе с флагом --sourceFiles (-f), без запуска анализа. Отфильтровать проекты возможно при помощи флагов --selectProjects (-S) и --excludeProjects (-E). Нельзя использовать вместе с флагами --sourceFiles (-f) и --analyzeMoifiedFiles (-F);--appendHashToCache (-H): Включает добавление хэша исходных файлов в файл кэша зависимостей при генерации или модификации его с помощью флагов --regenerateDependencyCache (-G), --regenerateDependencyCacheWithoutAnalysis (-W) и --sourceFiles (-f).--dependencyRoot (-D): опциональный путь к директории для размещения кэшей зависимости исходных файлов. Работает в дополнение к флагам --sourceFiles (-f), --regenerateDependencyCache (-G) и --analyzeMoifiedFiles (-F);--dependencyCacheSourcesRoot (-R): опциональный путь, который используется для создания относительных путей в кэшах зависимостей исходных файлов, генерируемом при использовании флагов --sourceFiles (-f), --regenerateDependencyCache (-G) и --analyzeMoifiedFiles (-F);--resolveRelativePathsToCfgFile (-L): включает разрешение относительных путей в настройках файла .pvsconfig уровня решения относительно директории, где расположен файл .pvsconfig. Важно: этот флаг влияет только на настройки, связанные с кэшами зависимостей исходных файлов;--settings (-s): путь до файла настроек PVS-Studio. Если параметр опущен, будет использован файл настроек Settings.xml, находящийся в директории %AppData%\PVS-Studio\ на Windows или ~/.config/PVS-Studio/ на Linux/macOS. Эти же файлы настроек используются плагинами (Visual Studio, Rider), что даёт возможность их редактирования с помощью интерфейса PVS-Studio плагина в данных IDE. Примечание: для работы анализатора на Windows файл настроек должен содержать регистрационную информацию. Различные способы ввода лицензии описаны здесь. В зависимости от используемого файла настроек, применяются следующие правила:--licFile (-l): путь до файла лицензии PVS-Studio. Данный флаг доступен только в pvs-studio-dotnet. Если параметр опущен, будет использован файл лицензии PVS-Studio.lic, находящийся в директории ~/.config/PVS-Studio/ .--progress (-r): включение режима подробного логирования в stdout прогресса проверки (по умолчанию выключено);--suppressAll (-a): добавить неподавленные сообщения в suppress файлы соответствующих проектов (по умолчанию выключено). При наличии данного флага все сообщения будут добавлены в базу подавленных сообщений после сохранения результата проверки. Флаг поддерживает два режима работы. SuppressOnly добавляет сообщения из переданного отчёта о работе анализатора в suppress файлы без запуска анализа;AnalyzeAndSuppress запускает анализ, сохраняет отчёт о работе анализатора, и только затем подавляет найденные в нём сообщения. Этот режим позволит вам при регулярных запусках получать отчёт анализатора, в котором содержатся только новые сообщения на изменённый / написанный код, т.е. новые сообщения попадают в новый лог и сразу же подавляются — при последующей проверке они уже не будут выданы. Тем не менее, если вам всё же потребуется посмотреть старые сообщения (без перепроверки), рядом с отчётом о работе анализатора, содержащим новые сообщения, будет сохранён файл с полным отчётом о проверке (только для .plog отчётов анализатора). Подробнее про режим подавления сообщений можно прочитать в этом разделе документации.--sourceTreeRoot (-e): корневая часть пути, которую PVS-Studio будет использовать при генерации относительных путей в диагностических сообщениях. Задание этого параметра переопределяет значение SourceTreeRoot в настройках PVS-Studio;--incremental (-i): режим инкрементального анализа. Для получения подробной информации об инкрементальном анализе в PVS-Studio обратитесь к разделу "Режим инкрементального анализа PVS-Studio". Примечание: этот режим доступен только для Enterprise-лицензии PVS-Studio. Доступны следующие режимы работы инкрементального анализа:Scan — позволяет проанализировать все зависимости для определения того, на каких файлах должен быть выполнен инкрементальный анализ. Непосредственно анализ выполнен не будет. Будут учтены изменения, произведенные с момента последней сборки, предыдущая история изменений будет удалена.AppendScan — позволяет проанализировать все зависимости для определения того, на каких файлах должен быть выполнен инкрементальный анализ. Непосредственно анализ выполнен не будет. Будут учтены изменения, произведенные с момента последней сборки, а также все предыдущие изменения.Analyze — позволяет выполнить инкрементальный анализ. Этот шаг должен выполняться после выполнения шагов Scan или AppendScan, и может выполняться как до, так и после сборки решения или проекта. Статический анализ будет выполнен только для файлов из списка, полученного в результате выполнения команд Scan или AppendScan.ScanAndAnalyze — позволяет проанализировать все зависимости для определения того, на каких файлах должен быть выполнен инкрементальный анализ, и сразу же выполнить инкрементальный анализ измененных файлов с исходным кодом. Будут учтены изменения, произведенные с момента последней сборки.--msBuildProperties (-m): позволяет задать или переопределить свойства уровня проекта. Для задания или переопределения нескольких свойств уровня проекта, используйте символ |, например: --msBuildProperties "WarningLevel=2|OutDir=bin\OUT32\"--excludeDefines (-x): список символов, которые будут исключены из текущего набора при анализе проекта. При необходимости перечисления нескольких символов в качестве разделителя используется ;. Пример: --excludeDefines "DEF1;DEF2". Данная опция учитывается только при анализе C# проектов.--appendDefines (-d): список символов, которые будут добавлены к текущему набору при анализе проекта. При необходимости перечисления нескольких символов в качестве разделителя используется ';'. Пример: --appendDefines "DEF1;DEF2". Данная опция учитывается только при анализе C# проектов.--selectProjects (-S): список проектов анализируемого решения (.sln), которые будут проанализированы. Остальные проекты будут исключены из анализа. Поддерживается перечисление проектов через имя проектного файла (c расширением или без него), по абсолютному или относительному пути. При необходимости перечисления нескольких проектов в качестве разделителя используется ;. Пример: --selectProjects Project1;"Project 2.vcxproj";".\Project3\Project3.csproj".--excludeProjects (-E): список проектов анализируемого решения (.sln), которые будут исключены из анализа. Поддерживается перечисление проектов через имя проектного файла (c расширением или без него), по абсолютному или относительному пути. При необходимости перечисления нескольких проектов в качестве разделителя используется ;. Пример: --excludeProjects Project1;"Project 2.vcxproj";".\Project3\Project3.csproj".--rulesConfig (-C): путь к файлу конфигурации диагностик .pvsconfig. Может быть использован совместно с файлами конфигурации из проектов / решения и файлами конфигурации из каталогов:%AppData%\PVS-Studio\;~/.config/PVS-Studio/.--useSuppressFile (-u): путь до suppress файлов. Через этот параметр можно указать несколько suppress файлов. В качестве разделителя используется символ ;. Например: -u "path\to\test.suppress;path\to\test.suppress.json". Подробнее про режим подавления сообщений можно прочитать в этом разделе документации.--disableLicenseExpirationCheck (-h): cбрасывает код возврата и отключает предупреждение об истечении срока действия лицензии, когда срок действия лицензии подходит к концу.--intermodular (-I): включает межмодульный режим анализа C и С++ проектов. Анализатор выполняет более глубокий анализ кода, но тратит на это больше времени. Анализатор C# по умолчанию обеспечивает межмодульный анализ.--redirectOutputToLog: перенаправляет сообщения об ошибках из StdErr / StdOut в отчёт анализатора.--saveFilteredOutMessagses: сохраняет отчёты с подавленными или помеченными как False Alarm сообщениями. У флага есть следующие опции:OnlyFalseAlarms — сохранение дополнительного отчёта, содержащего сообщения, помеченные как False Alarm;OnlySuppressed — сохранение дополнительного отчёта, содержащего подавленные сообщения;SuppressedAndFalseAlarms — сохранение дополнительного отчёта, содержащего подавленные и помеченные как False Alarm сообщения;All — сохранение всех вышеперечисленных дополнительных отчётов.--misraCVersion: задает стандарт MISRA C. Поддерживаемые стандарты MISRA C: 2012, 2023.--misraCppVersion: задает стандарт MISRA C++. Поддерживаемые стандарты MISRA C++: 2008, 2023.--securityRelatedIssues: выделяет дополнительной маркировкой в поле SAST в результатах анализа предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207-2024.--threads (-j): позволяет одновременное использование N потоков анализатора PVS-Studio. Использование флага со значением 0 автоматически установит количество потоков. По умолчанию устанавливается значение, равное минимальному числу из количества ядер процессора или количества оперативной памяти, поделённой на два.--createBinaryLogs: генерирует бинарные логи при разборе анализатором MSBuild проектов. Эти логи можно использовать для диагностирования проблем, возникающих во время анализа.--logCompilerErrors: логирует ошибки компиляции, возникшие в ходе анализа. Ошибки компиляции могут повлиять на корректность результатов анализа. О наличии ошибок компиляции свидетельствуют предупреждения V051 и V053 (в этих документация описаны возможные причины появления ошибок компиляции).--analyzeProjectReferences: включает в анализ проекты, указанные в ProjectReference проекта, являющегося целью анализа (включая транзитивные ProjectReference). Примечание: флаг может быть использован только для C# (.csproj) проектов, являющихся целью анализа.У консольной утилиты также имеются дополнительные режимы работы:
сredentials — предназначен для активации лицензии;suppression — предназначен для специфичных действий с файлами подавления (создание пустых suppress файлов, подавление/расподавление отдельных предупреждений, получение статистики по suppress файлам).В режиме suppression имеются дополнительные флаги, которых нет в основном режиме (или у них отличается название):
--mode (-m): в этом флаге указывается подрежим работы с suppress файлами:CreateEmptySuppressFiles создаёт пустые suppress файлы рядом с проектными файлами (.csproj / .vcxproj) по заданному паттерну имени файла (флаг --suppressFilePattern). Если флаг паттерна не передан, то создаются пустые suppress файлы с именем проекта. Этот режим учитывает флаг пометки suppress файлов primary меткой (--markAsPrimary). Primary suppress файлы используются для подавления нескольких предупреждений, выбранных в окне вывода результатов для Visual Studio;Suppress позволяет подавить отдельные предупреждения из файла отчёта анализатора (--analyzerReport). Подавляемые предупреждения из отчёта анализатора отбираются при помощи фильтров: групп (--groups), кодов диагностик (--errorCodes), путей (--files). Этот режим учитывает флаг --markAsPrimary;UnSuppress режим расподавляет предупреждения из переданного отчёта анализатора. UnSuppress аналогичен Suppress режиму по используемым флагам, кроме флага --markAsPrimary, который не используется в данном режиме;FilterFromSuppress фильтрует сообщения в существующем файле отчёта (.plog, .json или raw output C++ ядра) без запуска анализа при помощи suppress файлов, расположенных рядом с файлами проектов/решения. Ещё один вариант: передать путь до suppress файлов в параметре --useSuppressFile (-u). Файл с результатами фильтрации сохраняется рядом с переданным файлом отчёта. Имя этого файла имеет постфикс _filtered. В флаге --analyzerReport (-R) указывается путь до файла отчёта анализатора;CountSuppressedMessages подсчитывает количество подавленных сообщений во всех suppress файлах. Данный режим также может подсчитать количество актуальных сообщений в suppress файлах. Если передать полный файл отчёта (через флаг --analyzerReport), то можно узнать, сколько сообщений в базе подавления ещё актуальны. Вы можете узнать статистику по каждому suppress файлу, если запустите данный режим с флагом -r;UpdateSuppressFiles выполняет обновление suppress файлов, удаляя из них сообщения, которые не содержатся в переданном файле отчёта (флаг --analyzerReport). Примечание: для работы этого режима требуется полный отчёт, содержащий подавленные сообщения. Полный отчёт создаётся каждый раз при запуске анализа, если есть подавленные сообщения. Файл полного отчёта имеет имя *_WithSuppressedMessages.* и располагается рядом с основным отчётом. Если вы запустите данный режим c файлом отчёта, не содержащим подавленные сообщения, все suppress файлы будут очищены.--analyzerReport (-R): путь до отчёта анализатора, предупреждения из которого должны быть использованы при обработке. Аналогичен флагу -o из основного режима;--msBuildProperties (-b): пары ключ-значение, аналогичен флагу --msBuildProperties (-m) из основного режима работы PVS-Studio-Cmd.exe;--markAsPrimary (-M): помечает suppress файлы как primary suppress файлы;--suppressFilePattern (-P): паттерн имени для создания/использования suppress файлов;--logModifiedFiles (-l): в файл, переданный в этом флаге, записываются пути до всех модифицированных проектных и suppress файлов. Можно использовать и абсолютные, и относительные пути до файла. Файл будет создан или перезаписан, если был модифицирован хотя бы один проектный или suppress файл. Эта же информация выводится в консоль, если указан флаг --progress (-r);--groups (-g): фильтр предупреждений из отчёта анализатора (-R) по группам диагностик с уровнями достоверности. Пример: GA:1,2,3|OWASP|64:2;--errorCodes (-E): фильтр предупреждений из отчёта анализатора (-R) по кодам диагностик анализатора. Пример: V501,V1001,V3001;--files (-f): фильтр предупреждений из отчёта анализатора (-R) по путям. Пример: --files absolute/path/directory*3,8,11|relative/path/file*1|fileName.Command-line версия анализатора PVS-Studio поддерживает все настройки по фильтрации/отключению сообщений, доступные в плагинах для Visual Studio и Rider. Вы можете как задать их вручную в .xml файле, переданном с помощью аргумента --settings, так и использовать настройки, заданные через UI плагина, не передавая данного аргумента. Обратите внимание, что IDE плагин PVS-Studio использует отдельный набор настроек для каждого пользователя в системе.
Актуально только для PVS-Studio_Cmd. Если вы установили несколько экземпляров PVS-Studio различных версий для текущего пользователя системы, то все экземпляры программы будут использовать установочную директорию, указанную при последней установке. Во избежание конфликтов в работе анализатора в настройках, передаваемых с аргументом --settings (-s), необходимо указать путь до установочной директории (значение элемента <InstallDir>).
PVS-Studio_Cmd позволяет провести выборочную проверку отдельных файлов (например, только файлов, в которых были внесены изменения), заданных в списке, передаваемом с помощью флага --sourceFiles (-f). Это позволяет значительно уменьшить время, необходимое для анализа, а также получить отчёт анализатора только для определённых изменений в исходном коде.
Список файлов представляет собой простой текстовый файл, в котором построчно указаны пути к проверяемым файлам. Относительные пути к файлам будут раскрыты относительно текущей рабочей директории. Можно указывать как исходные компилируемые файлы (.c / .cpp для C++ и .cs для C#), так и заголовочные файлы (.h / .hpp для C++).
Для получения списка изменившихся файлов для флага --sourceFiles (-f) можно использовать системы контроля версий (SVN, Git и тд.). Это позволит предоставлять анализатору актуальную информацию об изменениях в коде.
При использовании данного режима для анализа C и C++ файлов генерируется кэш зависимостей компиляции, который будет использован при последующих запусках анализа. По умолчанию кэши зависимостей сохраняются в специальной поддиректории .pvs-studio, рядом с проектными файлами (.vcxproj). При необходимости можно изменить место их хранения при помощи флага --dependencyRoot (-D). Также возможно использовать флаг --dependencyCacheSourcesRoot (-R), который позволяет создавать файлы кэшей зависимостей с относительными путями, что позволяет использовать один и тот же файл кэша зависимостей на разных системах.
Более подробную информацию о кэшах зависимостей вы можете найти в одноименном разделе документации для C++ проектов.
Для того, чтобы определить набор анализируемых файлов, пути и названия которых соответствуют определенному шаблону, флагу --sourceFiles (-f) должен быть передан специально сформированный .xml файл. В нем могут содержаться списки абсолютных и относительных путей и/или масок до проверяемых файлов.
<SourceFilesFilters>
<SourceFiles>
<Path>C:\Projects\Project1\source1.cpp</Path>
<Path>\Project2\*</Path>
<Path>source_*.cpp</Path>
</SourceFiles>
<SourcesRoot>C:\Projects\</SourcesRoot>
</SourceFilesFilters>Кэш зависимостей не генерируется при использовании такого формата списка анализируемых файлов и на анализ будут поставлены только те файлы исходного кода, которые были перечислены в файле. Заголовочные файлы будут проигнорированы. Для их проверки воспользуйтесь списком файлов в текстовом формате.
Включение данного режима позволяет анализатору учитывать информацию не только из анализируемого файла, но и из связанных с ним файлов. Это позволяет производить более глубокий и качественный анализ. Однако на сбор необходимой информации требуется дополнительное время, что отразится на времени анализа вашего проекта.
Данный режим актуален для C и C++ проектов. C# проекты обеспечивают межмодульный анализ по умолчанию.
Для запуска межмодульного анализа необходимо передать флаг --intermodular в консольную утилиту.
Утилиты PVS-Studio_Cmd / pvs-studio-dotnet имеют несколько ненулевых кодов возврата, которые не означают проблемы в работе самой утилиты, т.е. даже если утилита вернула не 0, это ещё не означает, что она "упала". Код возврата представляет собой битовую маску, маскирующую все возможные состояния, возникшие во время работы утилиты. Например, утилита вернёт ненулевой код возврата в случае, если анализатор нашёл в проверяемом коде потенциальные ошибки. Это позволяет обрабатывать такую ситуацию отдельно, например, на сборочном сервере, когда политика использования анализатора не подразумевает наличия срабатываний в коде, заложенном в систему контроля версий.
Рассмотрим далее все возможные коды состояния утилиты, из которых формируется битовая маска кода возврата.
0: анализ успешно завершён, ошибок в проверяемом коде не найдено;1: ошибка (падение) анализатора при проверке одного из файлов;2: общая (неспецифичная) ошибка при работе анализатора. Обычно это сигнализирует о наличии ошибки в коде самого анализатора и сопровождается выведением stack trace этой ошибки в stderr. Если вам встретилась такая ошибка, пожалуйста пришлите этот stack trace нам в форму обратной связи. Это поможет улучшить работу анализатора;4: какие-то из переданных аргументов командной строки некорректны. Возможные причины возникновения: неправильный или пустой путь до файла, неправильный выходной формат отчёта анализатора;8: не найден заданный проект, solution или файл настроек анализатора. Возможные причины возникновения: неправильный или пустой путь до файла, проект внутри solution был переименован или удалён;16: заданная конфигурация и/или платформа не найдены в файле решения. Возможная причина возникновения: в проекте не настроена, переименована, удалена конфигурация (платформа);32: решение или проект не поддерживаются или содержат ошибки. Возможные причины возникновения: повреждена структура файла решения или проекта, запуск проверки проекта Unreal Engine не через интеграцию Unreal Build Tool, некорректное значение макроса VCTargetsPath в проектах MSBuild, анализатор не смог получить встроенные .NET типы (V053);64: некорректное расширение проверяемого решения или проекта;128: некорректная или просроченная лицензия на анализатор. Возникает при использовании функционала Enterprise версии c Team лицензией или окончании срока действия лицензии;256: в проверяемом коде найдены потенциальные ошибки. Возникает при наличии хотя бы одного сообщения не из группы Fails;512: произошла ошибка при выполнении подавления сообщений (режим suppression или использование флага --suppressAll). Возникает при загрузке некорректного файла отчёта или suppress-файла;1024: показывает, что лицензия на анализатор истечёт в течение месяца;Приведём пример скрипта Windows batch для расшифровки кода возврата утилиты PVS-Studio_Cmd:
@echo off
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe"
-t "YourSolution.sln" -o "YourSolution.plog"
set /A FilesFail = "(%errorlevel% & 1) / 1"
set /A GeneralExeption = "(%errorlevel% & 2) / 2"
set /A IncorrectArguments = "(%errorlevel% & 4) / 4"
set /A FileNotFound = "(%errorlevel% & 8) / 8"
set /A IncorrectCfg = "(%errorlevel% & 16) / 16"
set /A InvalidSolution = "(%errorlevel% & 32) / 32"
set /A IncorrectExtension = "(%errorlevel% & 64) / 64"
set /A IncorrectLicense = "(%errorlevel% & 128) / 128"
set /A AnalysisDiff = "(%errorlevel% & 256) / 256"
set /A SuppressFail = "(%errorlevel% & 512) / 512"
set /A LicenseRenewal = "(%errorlevel% & 1024) / 1024"
if %FilesFail% == 1 echo FilesFail
if %GeneralExeption% == 1 echo GeneralExeption
if %IncorrectArguments% == 1 echo IncorrectArguments
if %FileNotFound% == 1 echo FileNotFound
if %IncorrectCfg% == 1 echo IncorrectConfiguration
if %InvalidSolution% == 1 echo IncorrectCfg
if %IncorrectExtension% == 1 echo IncorrectExtension
if %IncorrectLicense% == 1 echo IncorrectLicense
if %AnalysisDiff% == 1 echo AnalysisDiff
if %SuppressFail% == 1 echo SuppressFail
if %LicenseRenewal% == 1 echo LicenseRenewalПримечание. Так как максимальное значение кода возврата под Unix ограничено 255, коды возврата утилит PVS-Studio_Cmd (где может возвращаться значение больше 255) и pvs-studio-dotnet отличаются.
Рассмотрим далее все возможные коды состояния утилиты, из которых формируется битовая маска кода возврата.
0: анализ успешно завершён, ошибок в проверяемом коде не найдено;1: некорректная или просроченная лицензия на анализатор. Возникает при использовании функционала Enterprise версии c Team лицензией или окончании срока действия лицензии;2: общая ошибка при работе анализатора. Эта ошибка включает пропущенные аргументы командной строки, некорректный solution или проект, заданный для анализа, ошибки внутри анализатора и т.п. Если ошибка сопровождается stack trace, пожалуйста пришлите этот stack trace нам в форму обратной связи. Это поможет улучшить работу анализатора;4: показывает, что лицензия на анализатор истечёт в течение месяца;8: в проверяемом коде найдены потенциальные ошибки. Возникает при наличии хотя бы одного сообщения не из группы Fails;Примечание. Данный раздел актуален для Windows. Анализ C++ проектов на Linux / macOS описан в соответствующем разделе документации.
Если ваш C/C++ проект не использует стандартные сборочные системы Visual Studio (VCBuild/MSBuild) или даже использует собственную сборочную систему / make-файлы через NMake проекты Visual Studio, то вы не сможете проверить такой проект с помощью PVS-Studio_Cmd.
В таком случае вы можете воспользоваться системой отслеживания компиляторов, которая позволяет анализировать проекты, независимо от их сборочной системы, "перехватывая" запуск процессов компиляции. Система отслеживания компиляции может использоваться как из командной строки, так и через пользовательский интерфейс приложения C and C++ Compiler Monitoring UI.
Также вы можете напрямую встроить запуск command-line ядра анализатора непосредственно в вашу сборочную систему.
Примечание. Потребуется прописать вызов ядра анализатора PVS-Studio.exe для каждого компилируемого файла, по аналогии с тем, как вызывается C++ компилятор.
При запуске анализа кода из командной строки по умолчанию используются те же настройки, что и при запуске анализа из IDE (Visual Studio / Rider). Также можно указать, какой файл настроек использовать, с помощью аргумента --settings, как было описано выше.
Что касается, к примеру, системы фильтров (Keyword Message Filtering и Detectable Errors), то она НЕ применяется при анализе из командной строки. В том смысле, что в файле отчёта независимо от заданных параметров будут все сообщения об ошибках. Но при загрузке файла с результатами в IDE фильтры уже будут применены. Это происходит из-за того, что фильтры применяются динамически к результатам (и при запуске из IDE также). Это очень удобно, поскольку, получив список сообщений, вы можете захотеть отключить некоторые из них (например, V201). Достаточно отключить их в настройках и соответствующие сообщения пропадут из списка БЕЗ перезапуска анализа.
Формат отчёта анализатора не предназначен для прямого отображения или чтения человеком. Однако, если необходимо каким-либо образом отфильтровать результаты анализа и преобразовать их в "читаемый" вид, можно воспользоваться утилитой PlogConverter, распространяемой вместе с PVS-Studio.
Для работы с отчётами разных форматов требуется использование разных утилит:
.plog;.json.Исходный код обеих утилит открыт и доступен для загрузки: PlogConverter для Windows и plog-converter для Linux/macOS. Это позволяет достаточно просто добавлять поддержку новых форматов на основе существующих алгоритмов.
Более подробно данные утилиты описываются в соответствующих разделах документации для PlogConverter (Windows) и plog-converter (Linux/macOS).
С помощью файла global.json для проектов SDK-стиля (см. как определить стиль проекта) указывается, с какой версией SDK должен работать .NET CLI (например, при сборке проекта). Анализатор работает аналогичным образом при анализе отдельного проекта (.csproj). Если для него есть файл global.json, то анализатор будет учитывать, с помощью какой версии .NET SDK собирается этот проект.
В некоторых случаях применение global.json при сборке и при анализе различается: если для решения (.sln) есть global.json, который применяется при сборке решения, он может не всегда примениться при анализе этого решения. Это связано с тем, что при анализе решения поиск global.json осуществляется не относительно анализируемого решения, а относительно каждого из проектов, которые включены в это решение. В таком случае анализатор не всегда может получить встроенные .NET-типы, что приведёт к появлению предупреждения V053. Проекты, для которых есть V053, не будут проанализированы.
Чтобы global.json применялся при анализе каждого из проектов решения, он должен располагаться в одной из родительских директорий для всех проектов (.csproj) этого решения.
Для проектов не SDK-стиля global.json не учитывается при сборке и анализе.
В данном документе описывается система мониторинга компиляции для Windows. Мониторинг проектов под Linux описан здесь (подраздел "Любой проект (только для Linux)").
Система мониторинга компиляции (PVS-Studio Compiler Monitoring, CLMonitoring) предназначена для "бесшовной" интеграции статического анализа PVS-Studio в любую сборочную систему на ОС семейства Windows. Эта сборочная система должна использовать для компиляции файлов один из препроцессоров, поддерживаемых command-line анализатором PVS-Studio.exe (Visual C++, GCC, Clang, Keil MDK ARM Compiler 5/6, IAR C/C++ Compiler for ARM).
Анализатору PVS-Studio.exe для корректного анализа исходных C/C++ файлов требуется промежуточный .i (intermediate) файл — результат работы препроцессора, содержащий все включённые в исходный файл заголовки и раскрытые макросы. Это требование обуславливает невозможность "просто проверить" исходные файлы на диске. Ведь помимо содержимого самих файлов статическому анализатору требуется также информация, необходимая для генерации такого .i файла. Заметим, что PVS-Studio не содержит в себе препроцессора и при своей работе полагается на внешний.
Рассматриваемая система, как следует из её названия, основана на "отслеживании" запусков компилятора во время сборки проекта. Она позволяет собрать всю необходимую информацию для запуска анализа (т.е. для генерации препроцессированных .i файлов) на исходниках, сборка которых была отслежена. Это, в свою очередь, позволяет проанализировать проект, просто запустив его пересборку, без необходимости от пользователя как-либо модифицировать свои сборочные сценарии.
Система представлена сервером, отслеживающим компиляцию (command-line утилита CLMonitor.exe), и приложением C and C++ Compiler Monitoring UI (Standalone.exe), осуществляющим непосредственный запуск статического анализа. При необходимости использования из командной строки CLMonitor.exe может также быть использован и в качестве клиента.
В режиме работы по умолчанию система не производит анализа иерархии запущенных процессов, а отслеживает запуск всех процессов в системе. Это значит, что, если будет запущена параллельная сборка нескольких проектов, система также отследит запуски компиляторов у обоих проектов.
CLMonitor.exe также умеет отслеживать только такие запуски процессов компилятора, которые были порождены от указанного (по PID) родительского процесса. Такой режим работы предусмотрен для случая, когда в системе была запущена параллельная сборка нескольких проектов, но вам нужно отследить запуски процессов компилятора только для определённого собираемого проекта или solution'а. Режим отслеживания дочерних процессов будет описан ниже.
Сервер мониторинга (CLMonitor.exe) отслеживает запуск процессов, соответствующих целевому компилятору (например, cl.exe в случае Visual C++ или g++.exe в случае GCC) и собирает информацию об окружении этих процессов. Сервер мониторинга отслеживает запуски процессов только для того пользователя, из-под которого он сам запущен. Эта информация необходима для последующего запуска статического анализа и включает:
После завершения сборки проекта серверу мониторинга (CLMonitor.exe) необходимо послать сигнал о прекращении отслеживания. Это можно сделать как с помощью того же CLMonitor.exe, запустив его в режиме клиента, так и через интерфейс Compiler Monitoring UI.
По завершении мониторинга сервер, используя собранную о процессах информацию, запускает генерацию промежуточных (intermediate) файлов для исходных файлов, которые были скомпилированы во время работы мониторинга. Затем уже выполняется запуск непосредственно статического анализатора (PVS-Studio.exe), выдавая на выход стандартный отчёт о работе PVS-Studio, с которым можно работать как из Compiler Monitoring UI, так и из любого IDE плагина PVS-Studio.
Примечание: далее будет описано использование CLMonitor.exe для интеграции анализа в автоматизированную систему сборки. Если вы хотите просто проверить свой проект, то воспользуйтесь приложением Compiler Monitoring UI.
CLMonitor.exe представляет собой сервер мониторинга, который осуществляет непосредственно само отслеживание запусков компиляторов. Его необходимо запустить непосредственно перед началом сборки вашего проекта. В режиме отслеживания сервер будет перехватывать запуски всех поддерживаемых компиляторов.
Перечислим далее поддерживаемые компиляторы:
Примечание. При работе с Cygwin из-за специфики этого инструмента невозможно перехватить вызовы компиляторов. В таком случае в качестве альтернативы рекомендуем использовать MinGW.
Но, если вы хотите интегрировать анализ непосредственно в вашу сборочную систему (или систему непрерывной интеграции и т.п.), вы не можете "просто" запустить сервер мониторинга. Ведь данный процесс на время своей работы блокирует остальную сборку. Поэтому вам нужно запустить CLMonitor.exe с аргументом monitor:
CLMonitor.exe monitorВ этом режиме CLMonitor запустит сам себя в режиме отслеживания и завершит свою работу, а ваша сборочная система сможет продолжить выполнять свои оставшиеся задачи. При этом второй (запущенный из первого) процесс CLMonitor будет оставаться запущенным и производить отслеживание сборки.
Т.к. в таком режиме работы ни одна консоль не подключена к процессу CLMonitor, то помимо стандартных потоков ввода\вывода (stdin\stdout) сервер мониторинга также выводит свои сообщения в журнал событий Windows (Event Logs -> Windows Logs -> Application).
Также можно отслеживать только те запуски компиляторов, которые были порождены от определённого указанного по PID процесса. Для этого необходимо запустить CLMonitor.exe в режиме отслеживания с аргументами trace и --parentProcessID ('-p' сокращённый вариант). Аргумент --parentProcessID в качестве параметра должен принимать PID процесса, который, как предполагается, будет выступать родительским для запускаемых процессов компилятора. Строка запуска СLMonitor.exe в таком режиме может выглядеть следующим образом:
CLMonitor.exe trace –-parentProcessID 10256Если вы выполняете сборку из консоли и хотите, чтобы CLMonitor.exe отследил только сборку, запускаемую из этой же консоли, то вы можете запустить CLMonitor.exe с аргументом --attach (-a):
CLMonitor.exe monitor –-attachВ таком режиме работы программа отследит только те запуски компиляторов, которые были дочерними по отношению к процессу консоли, из-под которой была запущена сборка.
Стоит учитывать, что при сборке проектов, использующих сборочную систему MSBuild, оставшиеся с момента выполнения предыдущих сборок процессы MSBuild.exe не всегда завершаются. В этом случае CLMonitor.exe, запускаемый в режиме отслеживания дочерних процессов, не сможет отследить запуски компиляторов, которые были порождены от оставшихся в системе работающих процессов MSBuild.exe. Ведь данные процессы MSBuild.exe, скорее всего, не входят в иерархию процесса, указанного с помощью аргумента --parentProcessID. В связи с этим, перед запуском CLMonitor.exe в режиме отслеживания дочерних процессов рекомендуется завершать процессы MSBuild.exe, оставшиеся в системе с момента выполнения предыдущей сборки.
Примечание: для корректной работы сервера отслеживания он должен быть запущен с правами, эквивалентными правам, с которыми запускаются и сами процессы компиляторов.
Для корректной записи сообщений в системные журналы событий процесс CLMonitor.exe необходимо запустить от имени администратора хотя бы один раз. Если процесс ни разу не стартовал с правами администратора, сообщения об ошибках не будут попадать с системный журнал.
Обратите внимание, что в системные логи сервер записывает только сообщения об ошибках в своей работе (обработанных исключениях), а не диагностические сообщения от анализатора!
После завершения сборки запустите CLMonitor.exe в режиме клиента для генерации препроцессированных файлов и непосредственного запуска статического анализа:
CLMonitor.exe analyze -l "d:\ptest.plog"В качестве параметра '-l' передаётся полный путь до файла, в который будут записаны непосредственные результаты работы статического анализатора.
После запуска в режиме клиента CLMonitor.exe подключится к запущенному ранее серверу и получит от него информацию обо всех отловленных процессах компиляторов, после чего сервер завершит свою работу. Клиент же начнёт запуск препроцессоров и анализаторов PVS-Studio.exe для всех отслеженных исходных файлов.
В результате работы CLMonitor.exe будет получен файл-отчёта (D:\ptest.plog), который можно открыть в любом IDE плагине PVS-Studio или в Compiler Monitoring UI (PVS-Studio|Open/Save|Open Analysis Report).
Вы можете использовать в CLMonitor подавление сообщений анализатора с помощью аргумента '-u':
CLMonitor.exe analyze -l "d:\ptest.plog" -u "d:\ptest.suppress" -sВ параметре '-u' передаётся путь до suppress файла, полученного с помощью диалога Message Suppression в Compiler Monitoring UI (Tools|Message Suppression...). Параметр '-s' является необязательным и позволяет дописывать в переданный через '-u' suppress файл все новые сообщения текущей проверки.
Также возможно запустить CLMonitor.exe в режиме клиента для генерации препроцессированных файлов и непосредственного запуска анализатора в режиме межмодульного анализа:
CLMonitor.exe analyze -l "d:\ptest.plog" --intermodularФлаг --intermodular включает режим межмодульного анализа. В этом режиме анализатор выполняет более глубокий анализ кода, но тратит на это больше времени.
Для задания дополнительных параметров отображения и фильтрации сообщений вы можете передать путь до файла конфигурации диагностик (.pvsconfig) с помощью аргумента '-c':
CLMonitor.exe analyze -l "d:\ptest.plog" -c "d:\filter.pvsconfig"При необходимости завершить мониторинг без запуска анализа следует воспользоваться командой abortTrace:
CLMonitor.exe abortTraceCLMonitor.exe позволяет сохранять отловленную информацию о компиляции в отдельном дамп-файле. Это позволит в дальнейшем перезапустить анализ без необходимости повторно собирать проект и мониторить эту сборку. Для сохранения дампа мониторинга компиляции нужно сначала запустить мониторинг в обычном режиме командами trace или monitor, как было описано выше. После того как сборка завершена, можно завершить мониторинг и сохранить файл дампа. Для этого нужно запустить CLMonitor.exe с командой saveDump:
CLMonitor.exe saveDump -d d:\monitoring.zipТакже можно завершить мониторинг, сохранить файл дампа и запустить анализ отловленных файлов. Это можно сделать, дополнительно указав команде CLMonitor.exe analyze путь до места сохранения дампа:
CLMonitor.exe analyze -l "d:\ptest.plog" -d d:\monitoring.zipЗапустить анализ из уже готового dump файла можно без предварительного запуска мониторинга:
CLMonitor.exe analyzeFromDump -l "d:\ptest.plog"
-d d:\monitoring.zipФайл дампа представляет собой обычный zip архив, содержащий список отловленных у процессов параметров (параметры запуска, текущая директория, переменные окружения и т.п.) в формате XML. Команда analyzeFromDump поддерживает запуск как из заархивированного в zip дампа, так и из неупакованного XML файла. Если вы используете разархивированный xml файл, убедитесь, что у него расширение xml.
Анализ из дампа также поддерживает возможность запуска анализа в межмодульном режиме. Для этого, как и в режиме анализа, необходимо передать флаг --intermodular:
CLMonitor.exe analyzeFromDump -l "d:\ptest.plog"
-d d:\monitoring.zip --intermodularДля "ручной" проверки отдельных проектов через CLMonitor с удобным просмотром и фильтрацией результатов в IDE можно воспользоваться расширением для Visual Studio Code.
После установки расширения окно PVS-Studio появится в качестве одной из вкладок на нижней панели Visual Studio Code. В случае если окно было скрыто, вы можете снова отобразить его с помощью команды PVS-Studio: Show window в палитре команд (Ctrl + Shift + P).
После установки расширения PVS-Studio в палитре команд (Ctrl + Shift + P) станет доступна команда для запуска мониторинга компиляции С и C++ компиляторов — PVS-Studio: Run compiler monitoring for C and C++. При запуске этой команды откроется (если было скрыто) окно PVS-Studio с таблицей, в которой отображаются предупреждения анализатора, фильтры предупреждений в верхней левой части над таблицей и кнопками в правой верхней части для:
Для того, чтобы проанализировать весь проект, необходимо запустить его полную пересборку, при этом будут отслежены, а после проанализированы вызовы компилятора для всех исходных файлов в проекте. При пересборке части проекта будет произведён анализ только тех файлов, которые были пересобраны.
Если пересобраны только изменённые файлы (сборочные системы могут запускать компиляцию только для новых или изменённых файлов, кэшируя результат для остальных), то при запуске анализа из мониторинга будут проанализированы только эти файлы — это инкрементальный анализ.
После отслеживания первого запуска компилятора слева от уже существующих кнопок (красная кнопка — отмена мониторинга без запуска анализа) отобразится кнопка для запуска анализа из мониторинга (зелёная кнопка со стрелкой), а слева от неё в сообщении будет указано количество отслеженных на данный момент запусков компиляторов.

По окончании пересборки проекта для запуска анализа нужно нажать на кнопку запуска анализа из мониторинга (зелёная со стрелкой) или в палитре команд (Ctrl + Shift + P) выполнить соответствующую команду PVS-Studio: Stop monitoring and start analysis.
Если вы первый раз запускаете мониторинг на проекте, то получите уведомление о создании файла в [workspace folder]/.PVS-Studio/CLMonitorAnalyzerConfig.jsonc, в котором можно задать некоторые настройки анализа, аналогичные параметрам консольной версии CLMonitor в режимах analyze и analyzeFromDump, а именно:
[workspace folder]/.PVS-Studio/lastMonitoring.zip..pvsconfig или директории, из которой будут использованы файлы .pvsconfig;
Далее пользователю будет предложено в палитре команд выбрать тип анализа:
После выбора будет запущен анализ из отслеженных запусков C и C++ компиляторов. По мере анализа в таблицу предупреждений расширения будут добавляться предупреждения анализатора.
Важно: если пересборка проекта выполняется с правами администратора, VS Code также должен быть запущен с этими правами, чтобы возможно было отследить запуски компиляторов, выполняемых от имени администратора.
Если файлы исходного кода, а также конфигурация сборки в проекте не меняются, то вы можете сохранить дамп мониторинга компиляции и запускать анализ сразу из дампа. Для этого в файле [workspace folder]/.PVS-Studio/CLMonitorAnalyzerConfig.jsonc в поле compilationDump укажите путь, по которому перед запуском анализа из мониторинга будет сохранён дамп мониторинга компиляции. Анализ из дампа компиляции запускается командой PVS-Studio: Start analysis from compiler monitoring dump file в палитре команд (Ctrl + Shift + P).
Важно: при добавлении, изменении или удалении файлов исходного кода, а также при изменении конфигурации сборки проекта необходимо перегенерировать дамп мониторинга компиляции, чтобы анализ охватил все файлы проекта после внесённых изменений.
Если при мониторинге пропускаются запуски компиляторов C и C++, откройте настройки расширения PVS-Studio с помощью команды PVS-Studio: Show settings. Во вкладке Monitoring (C and С++) в поле Wrap compilers введите имена файлов компиляторов, которые необходимо отслеживать, разделив их запятой.
После этого вам необходимо перезапустить VS Code с правами администратора и запустить мониторинг. Режим Wrap compilers обеспечивает стабильное отслеживание всех запусков компиляторов, указанных в одноимённой настройке, при мониторинге в VS Code. Более подробную информацию о данном режиме вы можете найти в соответствующем разделе документации.
Для "ручной" проверки отдельных проектов через CLMonitor можно воспользоваться интерфейсом приложения Compiler Monitoring UI, который можно запустить из меню Start.
Для запуска отслеживания откройте диалог через Tools -> Analyze Your Files... (рисунок 1):
Рисунок 1 — Диалог запуска мониторинга сборки
Нажмите "Start Monitoring". После этого будет запущен CLMonitor.exe, а основное окно среды будет свёрнуто.
Выполните сборку, а по её завершении нажмите на кнопку "Stop Monitoring" в окне в правом нижнем углу экрана (рисунок 2):
Рисунок 2 — Диалог управления мониторингом
Если серверу мониторинга удалось отследить запуски компиляторов, будет запущен статический анализ исходных файлов. По окончании вы получите обычный отчёт о работе PVS-Studio (рисунок 3):
Рисунок 3 — Результаты работы сервера мониторинга и статического анализатора
Результаты работы могут быть сохранены в виде XML файла (файла с расширением plog) с помощью команды меню File -> Save PVS-Studio Log As...
Удобная навигация по сообщениям анализатора и навигации по коду среды доступна в среде разработки Visual Studio с помощью плагина PVS-Studio. Если проверяемый проект можно открывать в Visual Studio, но при этом "обычная" проверка (PVS-Studio|Check|Solution) не работает (например, это актуально для makefile проектов), можно использовать преимущества работы из IDE, загрузив полученные результаты анализа (plog файл) в PVS-Studio с помощью команды (PVS-Studio|Open/Save|Open Analysis Report...). Данное действие можно также автоматизировать с помощью средств автоматизации Visual Studio, привязав его, а также саму проверку, например, к сборке проекта. Приведём в качестве примера интеграцию анализа с помощью системы отслеживания вызовов компилятора PVS-Studio в makefile проект. Такой тип проектов, например, используется системой сборки Unreal Engine проектов на Windows.
В качестве команды запуска сборки впишем файл run.bat:
Рисунок 4 — настройка сборки makefile проекта.
Содержимое файла run.bat:
set slnPath=%1
set plogPath="%~2test.plog"
"%ProgramFiles(X86)%\PVS-Studio\CLMonitor.exe" monitor
waitfor aaa /t 10 2> NUL
nmake
"%ProgramFiles(X86)%\PVS-Studio\CLMonitor.exe" analyze -l %plogPath%
cscript LoadPlog.vbs %slnPath% %plogPath%В качестве параметров в run.bat мы передаём пути до solution'а и проекта. Мы запускаем отслеживание запусков компиляторов с помощью CLMonitor.exe. Команда waitfor нужна для создания задержки между запуском отслеживания компиляторов и запуском сборки. Без неё мониторинг может "не успеть" отловить первые запуски компиляторов. Далее мы запускаем сборку проекта через nmake. По завершении сборки мы запускаем анализ и, когда анализ завершится (результат анализа будет записан рядом с проектным файлом), мы загружаем результаты анализа в Visual Studio с помощью другого скрипта — LoadPlog.vbs. Вот его содержимое:
Set objArgs = Wscript.Arguments
Dim objSln
Set objSln = GetObject(objArgs(0))
Call objSln.DTE.ExecuteCommand("PVSStudio.OpenAnalysisReport",
objArgs(1))Здесь мы используем команду автоматизации Visual Studio DTE.ExecuteCommand для обращения из командной строки напрямую к запущенному экземпляру Visual Studio, в котором открыт наш проект. Фактически, выполнение данной команды эквивалентно клику по PVS-Studio|Open/Save|Open Analysis Report...
Для нахождения запущенного экземпляра Visual Studio мы использовали метод GetObject. Обратите внимание, что это метод идентифицирует запущенную Visual Studio по открытому в ней solution'у. При его использовании не следует держать открытыми несколько IDE с одинаковыми загруженными solution'ами. Он может "промахнуться", и результаты анализа откроются не в той IDE, в которой вы запускали сборку\анализ.
Использование Incredibuild позволяет снизить время анализа проекта в разы при распределении нагрузки по нескольким машинам. Однако утилита CLMonitor.exe не может отслеживать удалённые вызовы компилятора и поддерживает трассировку только для локальных сборок. Поэтому результат анализа мониторинга компилятора, запущенного Incredibuild-ом, может оказаться некорректным.
Вы можете запустить анализ через мониторинг компилятора с использованием распределённых сборок. Для этого необходимо получить дамп мониторинга локального компилятора при помощи CLMonitor.exe (получение дампа описано в предыдущих разделах) и запустить анализ дампа в распределённом режиме при помощи Incredibuild. Более подробная информация о настройке Incredibuild для данного режима имеется в соответствующем разделе документации: "Ускорение анализа C/C++ кода с помощью систем распределённой сборки (Incredibuild)".
При сборке проекта в среде IAR Embedded Workbench текущая рабочая директория процесса компилятора(iccarm.exe) в некоторых случаях может быть установлена средой в C:\Windows\System32. Такое поведение может вызывать проблемы, так как CLMonitoring сохраняет промежуточные файлы в текущей рабочей директории процесса компилятора.
Чтобы избежать записи промежуточных файлов в C:\Windows\System32, а также ошибок, связанных с недостаточными правами для записи в C:\Windows\System32, необходимо открывать рабочее пространство(workspace) двойным щелчком мыши на файле с расширением eww из проводника Windows. В этом случае промежуточные файлы будут сохранены в директории рабочего пространства.
В случае необходимости инкрементального анализа при использовании системы мониторинга компиляции, достаточно "отслеживать" инкрементальную сборку, т.е. компиляцию тех файлов, которые были изменены с момента последней сборки. Этот сценарий использования позволит анализировать только изменённый/новый код.
Такой сценарий использования естественен для системы мониторинга компиляции. Соответственно, режим анализа (полный или анализ только модифицированных файлов) зависит только от того, какая сборка отслеживается: полная или инкрементальная.
Включение данного режима позволяет анализатору учитывать информацию не только из анализируемого файла, но и из связанных с ним файлов. Это позволяет производить более глубокий и качественный анализ. Однако на сбор необходимой информации требуется дополнительное время, что отразится на времени анализа вашего проекта.
Для запуска межмодульного анализа (режим 'analyze') или межмодульного анализа из дампа (режим 'analyzeFromDump') необходимо передать флаг --intermodular.
Режимы 'analyze' и 'analyzeFromDump' позволяют провести выборочную проверку группы файлов. С помощью флага '--sourceFiles' (-f) задается путь к текстовому файлу, в котором построчно указываются пути к проверяемым файлам. Относительные пути к файлам будут раскрыты в соответствии с текущей рабочей директорией. Можно указывать как исходные компилируемые файлы (.c, .cpp и т.д.), так и заголовочные файлы (.h/.hpp).
В режиме проверки списка файлов генерируется кэш зависимостей компиляции, который будет использован при последующих запусках анализа. По умолчанию кэш зависимостей сохраняются в специальной поддиректории '.pvs-studio' рабочей директории под названием 'CLMonitor.deps.json'. При необходимости можно указать другое место сохранения/загрузки при помощи флага '--dependencyRoot' (-D).
По умолчанию, в кэше зависимостей сохраняются абсолютные пути к файлам исходного кода. Для того чтобы сделать переносимый кэш, можно указать произвольную корневую папку проекта (относительно которой будут сохраняться и загружаться пути) при помощи флага '--dependencyCacheSourcesRoot' (-R).
Используемый по умолчанию метод отслеживания запусков компиляторов может не успеть определить все файлы исходного кода. Эта проблема особенно актуальна для Embedded проектов, поскольку они состоят из быстро компилирующихся файлов на языке C. Для того чтобы гарантировать перехват всех процессов компиляции, утилита мониторинга может использовать более агрессивный подход — через механизм Image File Execution Options (IFEO) в реестре Windows. Этот механизм позволяет запустить специальный обработчик перед непосредственным запуском каждого процесса компиляции. Затем обработчик передаст серверу мониторинга необходимую информацию и продолжит запуск компилятора. Работа этого режима прозрачна для сборочной системы и требует доступ к редактированию пути реестра "HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Windows NT\CurrentVersion\Image File Execution Options" (запуск утилиты от имени администратора или выдача утилите прав на запись в реестр).
Чтобы включить этот метод отслеживания в консольном варианте мониторинга нужно передать утилите CLMonitor.exe в режимах 'monitor' или 'trace' флаг '--wrapCompilers (-W)' со списком компиляторов. Список компиляторов разделяется запятой, например:
CLMonitor.exe trace --wrapCompilers gcc.exe,g++.exeОбратите внимание, что нужно указывать имена исполняемых файлов компилятора с расширением .exe и без путей.
Для того чтобы включить данный режим перехвата при использовании графического интерфейса, заполните поле Wrap Compilers в окне запуска мониторинга.
Несмотря на преимущества использования механизма IFEO, необходимо соблюдать некоторые меры предосторожности.
Для того чтобы подключить обработчик перед запуском процессов, монитор модифицирует путь реестра "HKEY_LOCAL_MACHINE\SOFTWARE\Microsoft\Windows NT\CurrentVersion\Image File Execution Options". В нём создаётся новый ключ с именем исполняемого файла процесса, с полем "Debugger". В этом поле указывается команда запуска обработчика, который будет запущен вместо процесса с указанным именем исполняемого файла. Ошибка в этом поле может сделать невозможным запуск некоторых процессов. PVS-Studio не позволяет использовать этот режим с произвольным набором исполняемых файлов, а только с теми, которые опознаются как известные компиляторы. После успешного завершения процесса мониторинга записи реестра будут возвращены в исходное состояние. Если процесс мониторинга будет завершен нештатно (в случае принудительного завершения, ошибки или выключения компьютера), реестр автоматически восстановлен не будет. Однако при модификации реестра утилита мониторинга создаст файл восстановления в "%AppData%\PVS-Studio\wrapperBackup.reg", при использовании которого модифицированные ключи реестра будут возвращены в исходное состояние. Если при очередном запуске монитора файл восстановления существует, он будет применен автоматически. Перед автоматическим восстановлением файл восстановления проходит проверку. Если этот файл содержит подозрительные записи, он не будет использован и будет переименован в "wrapperBackup-rejected.reg". В этом случае отклонённый файл восстановления должен быть проверен ответственным лицом. Возможно, это свидетельствует о неправильной настройке или наличии вредоносного ПО на компьютере.
Несмотря на удобство используемой в данном режиме работы "бесшовной" интеграции анализа в автоматизированный сборочный процесс (через CLMonitor.exe), тем не менее, необходимо помнить и о естественных ограничениях, присущих данному режиму. А именно, о невозможности на 100% гарантировать перехват всех запусков компилятора при сборке. Это в свою очередь, может быть вызвано как влиянием внешнего окружения (например, антивирусами), так и особенностями аппаратно-программного окружения (например, компилятор может отработать слишком быстро при использовании SSD диска, а при этом производительности CPU может оказаться недостаточно для того, чтобы "успеть" отловить такой запуск).
Поэтому мы рекомендуем, по возможности, выполнить полноценную интеграцию статического анализатора PVS-Studio.exe в вашу сборочную систему (если вы используете сборочную систему, отличную от MSBuild), либо же воспользоваться IDE плагином PVS-Studio.
Этот раздел документации описывает устаревший метод запуска анализа, который может быть удалён в будущих версиях.
Мы рекомендуем всем использовать PVS-Studio из сред разработки Microsoft Visual Studio, куда инструмент прекрасно интегрируется. Однако, бывают ситуации, когда необходим запуск из командной строки, например, для кроссплатформенных проектов, использующих сборочную систему, основанную на makefile'ах.
В случае, если у вас есть файлы проектов (.vcproj/.vcxproj) и решения (.sln), и запуск из командной строки нужен, к примеру, для ежедневных проверок, то рекомендуем ознакомиться со статьей "Проверка Visual C++ (.vcxproj) и Visual C# (.csproj) проектов из командной строки с помощью PVS-Studio".
Также, независимо от сборочной системы, вы можете воспользоваться системой отслеживания вызовов компилятора.
Итак, как работает С++ анализатор кода (PVS-Studio или любой другой)?
Когда пользователь анализатора дает команду проверить какой-либо файл (например, file.cpp), то анализатор сначала выполняет препроцессирование этого файла. В результате раскрываются все макросы, подставляются #include-файлы. Препроцессированный i-файл уже может разбирать анализатор кода. Обратите внимание, что анализатор не может разбирать файл, который не был препроцессирован. Поскольку тогда он не будет иметь информации об используемых типах, функциях, классах. Работа любого анализатора кода состоит как минимум из двух этапов: препроцессирование и собственно анализ.
Возможна ситуация, в которой программы не имеют связанных с ними проектных файлов, например, в случае мультиплатформенного ПО или старых проектов, собираемых с помощью пакетных утилит командной строки. Зачастую в таких случаях для управления сборочным процессом используют различные Make системы, например, Microsoft NMake, GNU Make и т.п.
Для проверки подобных проектов потребуется встроить в сборочный процесс прямой вызов анализатора (по умолчанию, файл расположен в %programfiles%\PVS-Studio\x64\PVS-Studio.exe) и передать ему все необходимые для препроцессирования аргументы. Фактически анализатор необходимо вызывать для тех же файлов, для которых вызывается компилятор (cl.exe в случае Visual C++).
Анализатор PVS-Studio должен быть вызван в пакетном режиме для каждого C/C++ файла проекта либо для целой группы файлов (файлы с расширением c/cpp/cxx и т.п., анализатор не нужно вызывать для заголовочных h файлов) с аргументами следующего вида:
PVS-Studio.exe --cl-params %ClArgs% --source-file %cppFile%
--lic-file %licPath% --cfg %cfgPath% --output-file %ExtFilePath%%ClArgs% — все аргументы, передаваемые используемому компилятору при обычной компиляции, в том числе и путь до файла (или файлов) с исходным кодом.
%cppFile% — путь до анализируемого C/C++ файла или пути до группы C/C++ файлов (имена файлов, разделённые пробелами)
Параметры %ClArgs% и %cppFile% должны быть переданы анализатору PVS-Studio аналогично тому, как они передаются компилятору Visual C++ , т.е. полный путь до файла должен быть передан дважды, в каждом параметре.
%licPath% — путь до файла с лицензией PVS-Studio.
%cfgPath% — путь до конфигурационного файла PVS-Studio.cfg. Этот файл общий для всех C/C++ файлов, который может быть создан вручную (пример будет показан ниже).
%ExtFilePath% — необязательный параметр, путь до внешнего файла, в который будут сохранены результаты работы анализатора. Если данный параметр не указан, анализатор будет выдавать сообщения о найденных ошибках в stdout. Полученные здесь результаты анализа можно открыть в окне PVS-Studio среды Visual Studio с помощью команды PVS-Studio/Open Analysis Report (выбрав в качестве типа файла Unparsed output). Обратите внимание на то, что, начиная с версии PVS-Studio 4.52, анализатор при запуске из командной строки поддерживает работу с одним выходным файлом (--output-file) из нескольких процессов PVS-Studio.exe. Это сделано для того, чтобы, как и в обычных makefile, при компиляции можно было запускать несколько процессов анализатора. При этом выходной файл не будет перезаписан и потерян, так как используется механизм блокировок файла.
Приведём пример вызова анализатора в независимом режиме для отдельного файла с препроцессором Visual C++ (cl.exe):
PVS-Studio.exe --cl-params "C:\Test\test.cpp" /D"WIN32" /I"C:\Test\"
--source-file "C:\Test\test.cpp" --cfg "C:\Test\PVS-Studio.cfg"
--output-file "C:\Test\test.log" --lic-file ...Конфигурационный файл PVS-Studio.cfg (параметр --cfg) должен содержать следующие строки:
exclude-path = C:\Program Files (x86)\Microsoft Visual Studio 10.0
vcinstalldir = C:\Program Files (x86)\Microsoft Visual Studio 10.0\VC\
platform = Win32
preprocessor = visualcpp
language = C++
skip-cl-exe = noРассмотрим эти параметры:
Вы можете фильтровать диагностические сообщения анализатора с помощью опций analyzer-errors и analysis-mode (заданных или в cfg-файле, или в командной строке). Это необязательные параметры:
Также существует возможность подать на вход анализатору готовый препроцессированный файл (i-файл), пропустив этап препроцессирования и сразу приступив к анализу. Для этого необходимо использовать параметр skip-cl-exe, указав значение yes. В этом режиме не требуется использование параметра cl-params. Вместо этого необходимо указать путь к i-файлу (--i-file) и задать тип препроцессора, использованного для создания этого i-файла. Указание пути к файлу исходного кода (--source-file) также необходимо. Несмотря на то, что i-файл уже содержит достаточную информацию для анализа, иногда может потребоваться сравнение i-файла с файлом исходного кода, например, когда анализатору требуется посмотреть на нераскрытый макрос. Таким образом, вызов анализатора в независимом режиме с заданным i-файлом для препроцессора Visual C++ (cl.exe) мог бы иметь вид:
PVS-Studio.exe --source-file "C:\Test\test.cpp"
--cfg "C:\Test\PVS-Studio.cfg" --output-file "C:\Test\test.log"Конфигурационный файл PVS-Studio.cfg (параметр --cfg) должен содержать следующие строки:
exclude-path = C:\Program Files (x86)\Microsoft Visual Studio 10.0
vcinstalldir = C:\Program Files (x86)\Microsoft Visual Studio 10.0\VC\
platform = Win32
preprocessor = visualcpp
language = C++
skip-cl-exe = yes
i-file = C:\Test\test.iПолный список параметров командной строки можно получить с помощью запуска:
PVS-Studio.exe –helpСледует отметить, что при явном вызове PVS-Studio.exe, лицензионная информация, сохранённая в файле 'Settings.xml', не учитывается. При запуске следует явно указывать путь до файла с лицензией. Это текстовый файл в кодировке UTF-8, состоящий из двух строк – имени и ключа.
Путь до файла с лицензией можно указать как в конфигурационном файле PVS-Studio, так и передать как аргумент командной строки. Соответствующий параметр: lic-file.
Например, чтобы указать путь до файла с лицензией в .cfg файле, следует добавить следующую строку:
lic-file = D:\Test\license.licВозьмём для примера Makefile проект, в котором сборка осуществляется компилятором Visual C++, и она описана в makefile проекта следующим правилом:
$(CC) $(CFLAGS) $<
Здесь $(CC) вызывает cl.exe, которому передаются параметры компиляции $(CFLAGS), и наконец с помощью макроса $< осуществляется подстановка всех С\С++ файлов, от которых зависит текущая цель сборки. Таким образом, для всех файлов с исходным кодом будет вызван компилятор cl.exe с необходимыми параметрами.
Модифицируем данный сценарий таким образом, чтобы перед вызовом компилятора для каждого файла осуществлялась проверка статическим анализатором PVS-Studio:
$(PVS) --source-file $< --cl-params $(CFLAGS) $<
--cfg "C:\CPP\PVS-Studio.cfg"
$(CC) $(CFLAGS) $<Здесь $(PVS) - путь до исполняемого файла анализатора (%programfiles%\PVS-Studio\x64\PVS-Studio.exe). Обратите внимание, что после вызова анализатора на следующей строке вызывается компилятор Visual C++ с теми же параметрами, что и изначально. Это делается для того, чтобы были построены правильные цели (targets) и сборка не остановился из-за отсутствия .obj-файлов.
Инструмент PVS-Studio разрабатывался для работы в рамках сред Visual Studio. И его работа из командной строки - это дополнение к основному режиму работы. Тем не менее, все его диагностические возможности доступны.
Полученные в данном режиме ошибки могут быть также перенаправлены в файл с помощью аргумента командной строки --output-file. Данный файл будет содержать необработанный и неотфильтрованный вывод анализатора.
Такой файл можно открыть в IDE окне PVS-Studio или приложении C and C++ Compiler Monitoring UI (Standalone.exe) командой Open Analysis Report (выбрав в качестве типа файла 'Unparsed output') и в дальнейшем его можно будет сохранить в стандартном формате отчета PVS-Studio log file (plog), что позволит избежать дублирования сообщений, а также использовать все стандартные механизмы фильтрации сообщений.
Также 'сырой' отчёт можно преобразовать в один из поддерживаемых форматов (xml, html, csv и т.п.) с помощью консольной утилиты PlogConverter.
Пользователи, знакомые с режимом инкрементального анализа в PVS-Studio, при работе из IDE естественно не хотят от него отказываться и в версии для командной строки. К счастью, любая система сборки автоматически позволяет получить инкрементальный анализ "из коробки". Ведь говоря "make" мы компилируем только изменившиеся файлы. Соответственно и PVS-Studio.exe будет вызван только для изменившихся файлов. Так что инкрементальный анализ в версии для командной строки есть автоматически.
Несмотря на то, что полученный в независимом режиме неотфильтрованный текстовый файл с диагностическими сообщениями анализатора возможно открыть в окне PVS-Studio среды разработки (что в свою очередь позволит использовать навигацию по файлам и механизмы фильтрации), в самой среде Visual Studio будет работать фактически только текстовый редактор, а дополнительная функциональность системы IntelliSense (автодополнение, переход к местам декларации типов и телам функций, и т.п.) будет недоступна. А это, в свою очередь, создаёт очень большие неудобства при работе с результатами анализа, особенно для крупных проектов, вынуждая каждый раз вручную искать объявления классов и функций и значительно увеличивая время работы над каждым диагностическим сообщением.
Решить рассматриваемую проблему можно, создав пустой проект Visual C++ (например, Makefile проект) в одной директории с проверяемыми анализатором исходными C++ файлами (vcproj/vcxproj файл при этом должен находиться в папке, являющейся корневой для всех проверяемых исходных файлов). После этого можно включить режим Show All Files проекта (кнопка Show All Files в окне Solution Explorer), что позволит увидеть в древовидной структуре окна Solution Explorer все файлы, располагающиеся в нижележащих директориях файловой системы. Затем через контекстную команду Include in Project можно добавить в проект все необходимые cpp, с и h файлы (возможно, что для некоторых файлов также придётся прописать пути до include директорий, если в них, например, присутствуют включения из сторонних библиотек). Стоит помнить, что при включении в проект лишь части от всех проверяемых файлов, IntelliSense может не распознать часть из упоминаемых в них типов, если эти типы определяются как раз в отсутствующих файлах.
Рисунок 1 — добавление файлов в проект
Созданный таким образом проектный файл Visual C++ не может быть использован для сборки или анализа исходного кода с помощью PVS-Studio, но всё же позволит значительно упростить работу с результатами анализа, и может быть сохранён для дальнейшего использования на следующих итерациях работы анализатора в независимом режиме.
Как известно, компилятор cl.exe может обрабатывать файлы как по одному, так и группой. В первом случае вызов компилятора происходит в несколько запусков:
cl.exe ... file1.cpp
cl.exe ... file2.cpp
cl.exe ... file2.cppВо втором случае - за один запуск:
cl.exe ... file1.cpp file2.cpp file3.cppИ тот, и другой режим работы поддерживается в консольной версии PVS-Sudio.exe, примеры приведены выше.
Пользователю может оказаться полезно понимать логику работы программы в первом и втором случае. При раздельном запуске PVS-Studio.exe для каждого файла сначала вызывает препроцессор, а затем выполняется анализ. При обработке нескольких файлов за раз PVS-Studio.exe сначала выполняет препроцессирование всех файлов, а затем для каждого файла еще раз запускается PVS-Studio.exe для анализа уже препроцессированных файлов.
Для сборки проектов для Unreal Engine под Windows используется специализированная сборочная система Unreal Build System. Данная система интегрируется поверх сборочной системы, используемой средой Visual Studio / JetBrains Rider (MSBuild), с помощью автогенерируемых makefile-проектов MSBuild. Это специальный тип Visual C++ (.vcxproj) проектов, в которых для непосредственного выполнения сборки выполняется команда, вызывающая стороннюю утилиту, например, (но далеко не обязательно) Make. Использование makefile проектов позволяет работать с кодом Unreal Engine из среды Visual Studio / JetBrains Rider, используя такие преимущества, как автодополнение, подсветка синтаксиса, навигация по символам и т.п.
В связи с тем, что makefile-проекты MSBuild сами по себе не содержат полной информации, необходимой для компиляции, а, следовательно, и препроцессирования исходных C/C++ файлов, PVS-Studio не поддерживает проверку таких проектов с помощью Visual Studio плагина или консольной утилиты PVS-Studio_Cmd.exe. Поэтому, для проверки таких проектов с помощью PVS-Studio можно пойти двумя путями — отслеживание вызовов компилятора (Compiler Monitoring) и прямая интеграция C/C++ анализатора PVS-Studio.exe в сборочную утилиту UnrealBuildTool. Рассмотрим эти варианты подробнее.
Для сборки на Windows Unreal Build System использует компилятор Visual C++ - cl.exe. Этот компилятор поддерживается системой отслеживания компиляторов PVS-Studio на Windows. Эту систему можно использовать как из приложения C and C++ Compiler Monitoring UI, так и с помощью консольной утилиты CLMonitor.exe.
Запуск мониторинга компиляций можно осуществлять вручную из приложения Compiler Monitoring UI, или назначить на событие начала\окончания сборки в Visual Studio. Результатом работы системы мониторинга является XML файл отчёта .plog, который можно открыть в Visual Studio плагине PVS-Studio, или преобразовать к одному из стандартных форматов (txt, html, csv) с помощью специальной утилиты PlogConverter.
Подробное описание системы отслеживания вызовов компилятора доступно в данном разделе документации. Мы рекомендуем использовать данный способ запуска анализа для знакомства с анализатором, как наиболее простой в настройке.
Для того чтобы проанализировать проект, необходимо предварительно провести трассировку его полной сборки. Сборка проекта под Linux выполняется при помощи скрипта AutomationTool.
pvs-studio-analyzer trace -- \
<UnrealEngine source location>/UnrealEngine/Engine/
Build/BatchFiles/RunUAT.sh \
BuildCookRun -project="<Project path>/<Project name>.uproject" \
-build -Clean -targetplatform=Linux ....
pvs-studio-analyzer analyze ....Подробная документация к утилите pvs-studio-analyzer находится на странице "Кроссплатформенная проверка C и C++ проектов в PVS-Studio".
Инструкции для работы с полученным после анализа отчётом находятся на странице "Просмотр и конвертация результатов анализа".
В Unreal Engine версии от 5.0.0, 5.0.1 и 5.0.2 имеется баг, из-за которого Unreal Engine Build Tool не находит ядро анализатора по пути по умолчанию: "%ProgramFiles(x86)%\PVS-Studio\x64\PVS-Studio.exe":
На данный момент существует временное решение данной проблемы — необходимо скопировать файл PVS-Studio.exe расположенный в папке "%ProgramFiles(x86)%\PVS-Studio\x64 в папку ...\UE_5.0\Engine\Restricted\NoRedist\Extras\ThirdPartyNotUE\PVS-Studio".
Важно. Этот баг исправлен в релизной версии Unreal Engine 5.0.3.
В данном разделе рассматривается проверка Unreal Engine проектов на операционной системе Windows.
UnrealBuildTool является драйвером анализа. Он запускает анализ отдельных файлов, сохраняет отдельные отчёты, после чего на финальной стадии собирает отдельные отчёты в финальный отчёт анализатора PVS-Studio.
Для того, чтобы анализатор мог проверить файл, UnrealBuildTool предварительно препроцессирует его для того, чтобы передать анализатору .i файл. В некоторых случаях, UnrealBuildTool может не справиться с данным шагом, и тогда анализатор, в свою очередь, не сможет проверить файл и создать выходной отчёт для этого файла. После этого, UnrealBuildTool не сможет использовать этот отчёт для сборки единого отчёта PVS-Studio.
При этом, в консольном выводе UnrealBuildTool можно будет увидеть информацию о поднятом исключении следующего вида:
Unhandled exception: System.IO.FileNotFoundException:
Could not find file <FILE>.i.pvslog'.В случае получения подобной ошибки проверьте флаги компилятора, используемые при компиляции и при анализе — они должны быть идентичны. Если вы уверены, что флаги идентичны, но компиляций проходит, а анализ — нет, то обязательно напишите нам в поддержку.
В случае с Unreal Build System, разработчики из Epic Games предоставляют возможность использовать PVS-Studio с помощью интеграции со сборочной утилитой UnrealBuildTool, начиная с версии Unreal Engine 4.17.
Перед началом анализа вам будет необходимо ввести лицензию на анализатор. Для этого нужно ввести ваши данные в IDE:
Обратите внимание, что до версии Unreal Engine 4.20, UBT не умел подхватывать лицензию из общего файла настроек PVS-Studio. В случае, если UBT не видит лицензию, введённую через интерфейс, вам необходимо создать отдельный файл лицензии с именем PVS-Studio.lic вручную и подложить его в директорию %USERPROFILE%\AppData\Roaming\PVS-Studio.
Примечание. При интеграции PVS-Studio со сборочной утилитой UnrealBuildTool сборки проекта не происходит. Это связано с тем, что UnrealBuildTool заменяет процесс сборки на процесс анализа.
UnrealBuildTool позволяет запускать анализ PVS-Studio, добавив данный флаг в строку запуска:
-StaticAnalyzer=PVSStudioНапример, полная строка запуска UnrealBuildTool может выглядеть так:
UnrealBuildTool.exe UE4Client Win32 Debug -WaitMutex -FromMsBuild
-StaticAnalyzer=PVSStudio -DEPLOYДля включения анализа при запуске из IDE, откройте свойства проекта для выбранной конфигурации:
и добавьте флаг -StaticAnalyzer=PVSStudio в опции сборки и пересборки (Build Command Line / Rebuild All Command Line).
Примечание 1. Обратите внимание, что при таком сценарии использования сборка проекта выполняться не будет. Вместо этого будет выполнено препроцессирование всех (команда Rebuild) или изменившихся (команда Build) файлов проекта, а после запущен его анализ.
Примечание 2. Интеграция PVS-Studio с UnrealBuildTool поддерживает не все настройки анализатора, доступные из Visual Studio (PVS-Studio > Options...). В данный момент поддерживается выбор групп диагностик для анализа, добавление директорий-исключений через PVS-Studio > Options... > Don't Check Files и фильтрация загруженных результатов анализа через Detectable Errors.
Примечание 3. При открытии файла проекта .uproject напрямую (не .sln файла) данный способ не поддерживается. Используйте способы, описанные ниже.
Примечание 4. При использовании Unreal Engine версии 5.3 может возникнуть падение анализа из-за невозможности найти generated.h файлы самого Unreal Engine. Проблема связана с тем, как UE 5.3 запускает анализ. При запуске анализа с помощью флага, Unreal Build Tool создаёт в папке для промежуточных файлов ещё одну папку UnrealEditorSA. Эта папка определяется как та, в которой нужно искать заголовочные файлы. Проектные файлы попадают в эту папку, а самого UE - нет. При этом, заголовочные файлы движка могут использоваться в проекте. Данная проблема была исправлена в Unreal Engine 5.4. Для решения проблемы, продолжая использовать в Unreal Engine 5.3, используйте интеграция через .target-файл.
Вы можете интегрировать PVS-Studio в процесс сборки, модифицировав .target-файл. Такой сценарий будет удобен при частой перегенерации проектных файлов.
Для интеграции вам необходимо добавить параметр StaticAnalyzer со значением PVSStudio:
public MyProjectTarget(TargetInfo Target) : base(Target)
{
...
WindowsPlatform.StaticAnalyzer = WindowsStaticAnalyzer.PVSStudio;
...
}public MyProjectTarget(TargetInfo Target) : base(Target)
{
...
StaticAnalyzer = StaticAnalyzer.PVSStudio;
...
}Теперь UnrealBuildTool будет автоматически запускать анализ вашего проекта.
Вы можете интегрировать PVS-Studio в процесс сборки, модифицировав BuildConfiguration.xml файл.
Данный файл может быть найден по следующим путям:
Engine/Saved/UnrealBuildTool/BuildConfiguration.xmlUser Folder/AppData/Roaming/Unreal Engine/UnrealBuildTool/BuildConfiguration.xmlMy Documents/Unreal Engine/UnrealBuildTool/BuildConfiguration.xml.Ниже приводим минимальный рабочий пример такого файла:
<?xml version="1.0" encoding="utf-8" ?>
<Configuration xmlns="https://www.unrealengine.com/BuildConfiguration">
<BuildConfiguration>
<StaticAnalyzer>
PVSStudio
</StaticAnalyzer>
</BuildConfiguration>
</Configuration>Примечание 1. Пример выше будет отличаться в версии Unreal Engine ниже 5.1. Приводим ссылку на документацию и минимальный пример для этих версий:
<?xml version="1.0" encoding="utf-8" ?>
<Configuration xmlns="https://www.unrealengine.com/BuildConfiguration">
<WindowsPlatform>
<StaticAnalyzer>
PVSStudio
</StaticAnalyzer>
</WindowsPlatform>
</Configuration>Анализ всего проекта может занять много времени. Инкрементный анализ помогает ускорить анализ, проверяя только те файлы, которые были изменены с момента последней сборки. Инкрементальный анализ запускается только если ранее была произведена полная сборка проекта. Чтобы запустить инкрементный анализ, вам необходимо выполнить сборку Unreal Engine проекта (Build).
Например, если в проекте имеются файлы A.cpp, B.cpp и C.cpp, то в таком случае при первой "сборке" (анализе) проекта в Unreal Engine до версии 4.25 будут проанализированы все файлы. При следующей "сборке" (анализе) проекта, если не было изменено ни одного файла, то ни один файл и не будет проанализирован. Однако, если файлы A.cpp и B.cpp изменить, то проанализированы будут только эти два файла.
Важно. В версии UE 4.25 или новее вместо анализа измененных файлов, при "сборке" (анализе) проекта будут проанализированы все файлы из тех Unreal Engine модулей, в которые включены измененные файлы. Например, если имеется собранный ранее проект с двумя модулями "A_Module" и "B_Module", и в модуль "A_Module" включены файлы A1.cpp и A2.cpp, а в модуль "B_Module"файлы B1.cpp и B2.cpp, то при изменении файла B2.cpp и "сборке" (анализе) проекта будут проанализированы файлы B1.cpp и B2.cpp из модуля "B_Module". Это изменение ухудшило инкрементальный анализ тем, что теперь анализируются все файлы из модуля, если в нём был изменён хотя бы один файл. Однако, даже такой инкрементальный анализ позволяет ускорить время анализа проекта, если проект поделен на модули.
Если вам требуется настроить одновременную сборку проекта и его анализ в рамках одной конфигурации Visual Studio, для этого можно создать вспомогательные скрипты (в нашем примере назовём их, соответственно, BuildAndAnalyze и RebuildAndAnalyze) на основе стандартных скриптов Build и Rebuild. Основное изменение в скрипте RebuildAndAnalyze — вызов для сборки нового скрипта BuildAndAnalyze.bat, а не Build.bat.
В скрипт BuildAndAnalyze необходимо добавить удаление кэша действий и запуск UnrealBuildTool с флагом анализа после проведения успешной сборки.
В кэш сохраняются действия, выполняемые UBT в ходе работы (сборки, анализ и т.п.).
Восстановление кэша из бэкапа после анализа необходимо для того, чтобы вновь получить сохранённые действия сборки. Если UBT не обнаружит сохранённых действий сборки — она будет выполнена заново.
Удаление/восстановление кэша необходимо для того, чтобы не сохранять действия анализа, но при этом и не потерять действия по сборке проекта. Не сохранять действия анализа в кэш необходимо, потому что, если анализ будет проведен обновленной версией анализатора, в которой добавлены новые диагностические правила, то не модифицированные файлы проверены не будут. Удаление/восстановление кэша позволяет избежать подобной ситуации. Благодаря этому даже неизменные файлы будут проверены новыми диагностиками, В результате, эти диагностики могут обнаружить потенциальные ошибки или уязвимости, которые ранее не были обнаружены.
Примечание 1. Изменения, описанные ниже, основываются на стандартном скрипте Build и стандартной строке запуска скрипта. В случае, если используется модифицированный скрипт или нестандартный порядок аргументов, может потребоваться внесение дополнительных изменений.
Первоначально необходимо определить ряд переменных, которые будут необходимы для удаления/восстановления файла кэша действий.
Примечание 2. Файлы кэша действий в разных версиях движка Unreal Engine могут отличаться как расширением, так и расположением. Примите это во внимание при формировании скриптов.
SET PROJECT_NAME=%1%
SET PLATFORM=%2%
SET CONFIGURATION=%3%
SET UPROJECT_FILE=%~5
for %%i in ("%UPROJECT_FILE%") do SET "PROJECT_PATH=%%~dpi"
SET PREFIX=%PROJECT_PATH%Intermediate\Build\%PLATFORM%
SET ACTIONHISTORY_PATH=....
SET ACTIONHISTORY_BAC_PATH= "%ACTIONHISTORY_PATH:"=%.bac"Для разных версий движка во фрагменте скрипта, приведённом выше, необходимо задать соответствующее значение ACTIONHISTORY_PATH.
SET ACTIONHISTORY_PATH="%PREFIX%\%PROJECT_NAME%\ActionHistory.bin"SET ACTIONHISTORY_PATH="%PREFIX%\%PLATFORM%\%PROJECT_NAME%\ActionHistory.dat"SET ACTIONHISTORY_PATH="%PREFIX%\%PROJECT_NAME%\ActionHistory.dat"REM Если у вас есть конфигурации сборки для Client/Server,
REM то вам необходимо учесть их при определении переменной UE_FOLDER.
echo %PROJECT_NAME% | findstr /c:"Editor">nul ^
&& (SET UE_FOLDER=UE4Editor) || (SET UE_FOLDER=UE4)
SET ACTIONHISTORY_PATH="%PREFIX%\%UE_FOLDER%\%CONFIGURATION%\ActionHistory.bin"REM Если у вас есть конфигурации сборки для Client/Server,
REM то вам необходимо учесть их при определении переменной UE_FOLDER.
echo %PROJECT_NAME% | findstr /c:"Editor">nul ^
&& (SET UE_FOLDER=UnrealEditor) || (SET UE_FOLDER=UnrealGame)
SET ACTIONHISTORY_PATH="%PREFIX%\%UE_FOLDER%\%CONFIGURATION%\ActionHistory.bin"После вызова UnrealBuildTool для сборки (и команды popd) необходимо добавить следующий код:
SET "UBT_ERR_LEVEL=!ERRORLEVEL!"
SET "NEED_TO_PERFORM_ANALYSIS="
IF "!UBT_ERR_LEVEL!"=="0" (
SET "NEED_TO_PERFORM_ANALYSIS=TRUE"
)
IF "!UBT_ERR_LEVEL!"=="2" (
SET "NEED_TO_PERFORM_ANALYSIS=TRUE"
)
IF DEFINED NEED_TO_PERFORM_ANALYSIS (
pushd "%~dp0\..\..\Source"
ECHO Running static analysis
IF EXIST %ACTIONHISTORY_PATH% (
ECHO Backup %ACTIONHISTORY_PATH%
COPY %ACTIONHISTORY_PATH% %ACTIONHISTORY_BAC_PATH%
ECHO Removing %ACTIONHISTORY_PATH%
DEL %ACTIONHISTORY_PATH%
)
..\..\Engine\Binaries\DotNET\UnrealBuildTool.exe
%* -StaticAnalyzer=PVSStudio -DEPLOY
popd
IF EXIST %ACTIONHISTORY_BAC_PATH% (
ECHO Recovering %ACTIONHISTORY_PATH%
COPY %ACTIONHISTORY_BAC_PATH% %ACTIONHISTORY_PATH%
ECHO Removing %ACTIONHISTORY_BAC_PATH%
DEL %ACTIONHISTORY_BAC_PATH%
)
)Наиболее важными операциями из приведённого выше кода являются удаление и восстановление кэша, а также запуск UnrealBuildTool с флагом -StaticAnalyzer=PVSStudio для проведения анализа.
При необходимости можно использовать модифицированный скрипт при работе из IDE. Для этого необходимо указать его в качестве используемого в свойствах проекта:
Примечание. Обратите внимание, что при использовании модифицированных скриптов флаг -StaticAnalyzer=PVSStudio в аргументах запуска скрипта указывать не нужно, так как он уже выставляется в скрипте при запуске UnrealBuildTool для анализа.
Проверка самого Unreal Engine не отличается от проверки другого UE проекта.
В обоих случаях будут проанализированы все файлы, переданные на сборку. Если при сборке проекта должны собираться модули самого Unreal Engine, то они тоже будут проверены.
Для анализа отдельного решения Unreal Engine добавьте код, представленный в пункте интеграции через .target-файл в UnrealEditor.Target.cs (располагается в директории UnrealEngine/Engine/Source):
После этого запустите сборку с таргетом Editor (например, Development Editor).
Вы также можете воспользоваться вторым способом запуска анализа: откройте свойства проекта UE*, выберите в пункте NMake поле Build Command Line и добавьте в команду флаг
-StaticAnalyzer=PVSStudioПосле этого запустите сборку Unreal Engine.
Начиная с версии Unreal Engine 5.8, автоматически задействуются глобальные конфигурационные файлы .pvsconfig из папки %appdata%\PVS-Studio. Для подключения пользовательских конфигурационных файлов добавьте в target-файл параметр StaticAnalyzerPVSConfigs, в котором перечислены необходимые вам файлы конфигурации.
public MyProjectTarget(TargetInfo Target) : base(Target)
{
....
StaticAnalyzerPVSConfigs = [
".pvsconfig",
@"D:\UnrealEngine\UEGame\mysettings.pvsconfig"
];
....
}Если до конфигурационного файла указан относительный путь, то он будет вычислен относительно папки проекта, определяемой свойством Target.ProjectFile.
Для подключения пользовательских конфигурационных файлов через параметр командной строки Unreal Build Tool используйте параметр -StaticAnalyzerPVSConfigs, перечисляя через ; нужные вам файлы .pvsconfig:
-StaticAnalyzerPVSConfigs=.pvsconfig;D:\UnrealEngine\UEGame\mysettings.pvsconfigВключение различных групп диагностик анализатора доступно начиная с версии Unreal Engine 4.25.
Для выбора нужных групп диагностик необходимо модифицировать .target-файлы проекта.
Например, включить диагностики микро-оптимизаций можно следующим образом:
public MyUEProjectTarget( TargetInfo Target) : base(Target)
{
....
WindowsPlatform.PVS.ModeFlags =
UnrealBuildTool.PVSAnalysisModeFlags.Optimizations;
}Допустимые значения для включения соответствующих групп диагностик:
Для включения нескольких групп диагностик используйте оператор |:
WindowsPlatform.PVS.ModeFlags =
UnrealBuildTool.PVSAnalysisModeFlags.GeneralAnalysis
| UnrealBuildTool.PVSAnalysisModeFlags.Optimizations;C версии Unreal Engine 5.1 стали доступны ещё несколько настроек, которые можно задать в .target-файлах:
AnalysisTimeoutFlag;EnableNoNoise;EnableReportDisabledRules.WindowsPlatform.PVS.AnalysisTimeoutFlag — задаёт таймаут для анализа одного файла. Этому свойству возможно присвоить одно из значений перечисления AnalysisTimeoutFlags:
After_10_minutes (10 минут на файл);After_30_minutes (30 минут на файл);After_60_minutes (60 минут на файл);No_timeout (нет ограничения по времени на анализ одного файла).WindowsPlatform.PVS.EnableNoNoise — отключает выдачу всех предупреждений 3-его уровня (Low).
WindowsPlatform.PVS.EnableReportDisabledRules — включает отображение исключений из правил анализатора, которые могут быть указаны в комментариях и файлах .pvsconfig. Сообщения о том, откуда взята информация об исключении правил анализатора, выводятся в результаты анализа в виде предупреждений с кодом V012.
Если в .target-файле включено использование настроек из Settings.xml файла:
public MyUEProjectTarget( TargetInfo Target) : base(Target)
{
....
WindowsPlatform.PVS.UseApplicationSettings = true;
}то можно задать настройки через интерфейсы плагинов для Visual Studio или Rider.
Настройки по включению и отключению групп диагностик в Visual Studio находятся в Extensions > PVS-Studio > Options... > Detectable Errors (C, C++):
В Rider настройки по включению и отключению групп диагностик находятся в Tools > PVS-Studio > Settings... > Warnings:
С версии Unreal Engine 5.1 также доступны некоторые дополнительные настройки через интерфейс плагинов для Visual Studio и Rider.
В Visual Studio в Extensions > PVS-Studio > Options... > Specific Analyzer Settings > Analysis:
В Rider в Tools > PVS-Studio > Settings... > Analysis > Analysis Timeout:
По умолчанию, UnrealBuildTool объединяет единицы трансляции в файлы большого размера для оптимизации сборки. Такое поведение помогает оптимизировать время сборки, однако может помешать при анализе кода. Т.к. на анализ идут файлы большого размера, то возможна ситуация нехватки памяти.
Мы настоятельно рекомендуем отключать Unity Build, чтобы избежать проблемы нехватки памяти при анализе.
Unity Build можно отключить в *.Traget.cs файле, указав bUseUnityBuild = false;
Чтобы данная настройка влияла только на процесс анализа, не замедляя сборку, вы можете добавить в *.Target.cs файл следующий код:
Для Unreal Engine версии 5.0 и ниже:
public UE4ClientTarget(TargetInfo Target) : base(Target)
{
...
if (WindowsPlatform.StaticAnalyzer == WindowsStaticAnalyzer.PVSStudio)
{
bUseUnityBuild = false;
}
...
}Для Unreal Engine версии 5.1 и выше:
public UE5ClientTarget(TargetInfo Target) : base(Target)
{
...
if (StaticAnalyzer == StaticAnalyzer.PVSStudio)
{
bUseUnityBuild = false;
}
...
}Для запуска анализа вам достаточно указать флаг -StaticAnalyzer=PVSStudio в команде сборки NMake. UnrealBuildTool будет выключать Unity Build, если для параметра StaticAnalyzer указано значение PVSStudio.
В Unreal Engine, начиная с версии 5.4, доступна настройка, позволяющая запускать анализатор только на файлах проекта (пропуская модуль ядра Unreal Engine). Использование этой настройки позволяет значительно ускорить процесс анализа.
Включить настройку можно добавлением в строку запуска UnrealBuildTool флага:
-StaticAnalyzerProjectOnlyВ .target.cs-файле эта настройка включается так:
bStaticAnalyzerProjectOnly = true;Для отключения анализа автогенерируемых файлов воспользуйтесь инструкцией по исключению файлов из анализа при помощи PathMasks. Добавьте маску *.gen.cpp в настройку плагина PathMasks.
Примечание: начиная с Unreal Engine 5.4, анализ автогенерируемых файлов отключён по умолчанию. Для возвращения этой функциональности вы можете использовать флаг ‑StaticAnalyzerIncludeGenerated.
В Unreal Engine 5.4 добавили настройку, которая задаёт уровень предупреждений, выдаваемых UnrealBuildTool при анализе. Она не влияет на работу PVS-Studio, однако может приводить к замедлению при получении отчёта. По умолчанию настройка включена (значение = 1).
Выключение (значение = 0) помогает избежать вышеуказанной проблемы. Для этого нужно добавить в строку запуска UnrealBuildTool флаг:
-StaticAnalyzerPVSPrintLevel=0В target.cs файле настройка задаётся так:
StaticAnalyzerPVSPrintLevel = 0;Для автоматического запуска анализа, например, в CI/CD системах или скриптах, достаточно вызвать команду сборки проекта.
Для получения команды сборки откройте свойства проекта, выберите пункт NMake. В поле Build Command Line будет содержаться искомая команда.
Если вы интегрируете PVS-Studio через .target.cs файл или BuildConfiguration.xml файл, то просто используйте полученную команду сборки. Если используете интеграцию через флаг UnrealBuildTool, то добавьте его в команду сборки.
Команда сборки может выглядеть так:
"Path_to_UE\Engine\Build\BatchFiles\Build.bat" ProjectGame Win64 DebugGame ^
-Project="Path_to_projet\ProjcetGame.uproject" ^
-WaitMutex -FromMsBuild -StaticAnalyzer=PVSStudioПри запуске анализа в Rider непосредственно из .uproject файла есть несколько вариантов запуска анализа.
О первых двух вариантах написано в пунктах выше: Интеграция PVS-Studio через файл target файл и Интеграция PVS-Studio через Build Configuration файл.
Третий вариант заключается в генерации .sln файла и открытии проекта через него. В таком случае появится возможность добавить -StaticAnalyzer=PVSStudio флаг в команду сборки NMake.
Примечание. Открытие Unreal Engine проектов непосредственно через .uproject файл доступно в версиях Rider 2022.3 и выше. В остальных версиях возможно открыть проект только с помощью .sln файла.
Путь до файла с результатами анализа будет выведен в Output (Build) окно IDE (или stdout, если вы запускали UnrealBuildTool вручную из командной строки). Данный файл с результатами анализа имеет "нераспарсенный" вид — его можно открыть в IDE:
unparsed output в Visual Studio;А также результаты анализа можно преобразовать с помощью утилиты PlogConverter, как это было описано в разделе выше для XML лога.
Особенности работы со списком диагностических предупреждений более подробно описаны в статье "Работа со списком диагностических сообщений", а работа с отчётом анализатора — в статье "Работа с XML отчётом (.plog файл)".
Более удобным вариантом использования является автоматическая загрузка лога анализа в окно вывода PVS-Studio при работе в IDE. Для такого сценария необходимо включить соответствующую опцию:
В настройках плагинов PVS-Studio для Visual Studio и PVS-Studio for Rider и утилиты C and C++ Compiler Monitoring UI (Standalone.exe) имеется возможность указать маски директорий. Если в полном пути до файла имеется фрагмент, совпадающий с одной из масок в PathMasks, то этот файл исключается из анализа.
Важно. Для Unreal Engine проектов актуальны только маски директорий (PathMasks), но не маски имен файлов (FileNameMasks).
В плагине для Visual Studio данные настройки находятся в Extensions > PVS-Studio > Options... > Don't Check Files:
В Rider маски для исключения директорий из анализа находятся в Tools > PVS-Studio > Settings > Excludes:
Аналогичные настройки имеются и в C and C++ Compiler Monitoring UI (Standalone.exe) в Tools > Options... > Don't Check Files:
Среди этих масок по умолчанию имеется специальная маска для исключения исходного кода Unreal Engine: \Epic Games\UE_. Эта маска добавлена по умолчанию, чтобы результаты анализа не засорялись лишними предупреждениями, информация о которых вряд ли окажется полезной большинству разработчиков.
Примечание. Если Unreal Engine установлен не по пути по умолчанию, то в отчёт анализатора будут попадать предупреждения, выдающиеся на исходный код Unreal Engine. Если они вам мешают, то добавьте в PathMasks директорию, в которую установлен Unreal Engine.
Более подробная информация об исключении файлов из анализа описана в разделе "Настройки: Don't Check Files".
Многочисленные срабатывания анализатора на старом legacy-коде часто мешают регулярному использованию статического анализа. Такой код обычно уже хорошо оттестирован и стабильно работает, поэтому править в нём все срабатывания может быть нецелесообразно. Тем более, если размер кодовой базы достаточно велик, такая правка может занять огромное количество сил и времени. Если же срабатывания анализатора на существующий код не трогать, то они будут мешать работать со срабатываниями на свежий код.
Чтобы решить данную проблему и начать сразу регулярно использовать статический анализ, PVS-Studio предлагает возможность "отключить" сообщения на старом коде. Для этого в плагинах PVS-Studio для Visual Studio и JetBrains Rider имеются элементы интерфейса, которые позволяют подавлять предупреждения анализатора в этих IDE.
Имеется единственное отличие для пользователя в механизме подавления предупреждений для Unreal Engine проектов в этих IDE. Заключается оно в том, что для UE проектов пользователю необходимо добавить вручную один suppress файл к solution, а для не-UE проектов suppress файлы также могут добавляться автоматически к каждому проекту.
Если вы попытаетесь подавить предупреждения в Visual Studio или Rider для UE проекта, когда solution suppress файл не существует, то вы получите предупреждение.
В Visual Studio:
В Rider:
В этих сообщениях содержится описание действий для добавления suppress файла уровня solution.
Более подробную информацию о подавлении предупреждений в этих IDE вы найдете в соответствующих разделах документации:
Более подробная информация о механизме подавления предупреждений находится в разделе документации "Подавление сообщений анализатора (отключение выдачи предупреждений на существующий код)".
Если вы запускаете сборку Unreal Engine проекта через командную сроку (с помощью UnrealBuildTool.exe через пакетные файлы Build.bat или Rebuild.bat), вам может быть удобно использовать подавления предупреждений анализатора через консольную утилиту PVS-Studio_Cmd.exe. Для этого в ней имеются режимы SuppressOnly и FilterFromSuppress.
Режим SuppressOnly позволяет сохранить полученные ранее предупреждения анализатора в suppress файл. Пример команды создания suppress-файла:
PVS-Studio_Cmd.exe -t path/to/solution/file ^
-a SuppressOnly ^
-o path/to/report.pvslog ^
-u path/to/suppress_file.suppressВ результате выполнения данной команды все предупреждения анализатора из отчёта path/to/report.pvslog будут добавлены в path/to/suppress_file.suppress. Если suppress файла из аргумента -u не существует, то он будет создан.
Режим FilterFromSuppress позволяет использовать suppress файл для фильтрации сообщений из отчёта. Пример команды фильтрации отчёта анализатора при помощи suppress-файла:
PVS-Studio_Cmd.exe -t path/to/solution/file ^
-a FilterFromSuppress ^
-o path/to/report.pvslog ^
-u path/to/suppress_file.suppressВ результате выполнения этой команды рядом с отчётом path/to/report.pvslog будет создан файл path/to/report_filtered.plog. В него будут записаны все предупреждения анализатора, которые отсутствуют в path/to/suppress_file.suppress.
Чтобы иметь в отчете предупреждения анализатора только для нового или измененного кода, изначально необходимо получить suppress-файл, который будет служить начальной "точкой отсчёта". Для получения suppress файла необходимо выполнить следующие действия:
.pvslog отчёт (по умолчанию он располагается в папке ProjectDir/Saved/PVS-Studio);Отчёт анализатора в формате .plog, полученный после фильтрации в режиме FilterFromSuppress, возможно открыть в Visual Studio с установленным плагином для PVS-Studio или в утилите C and C++ Compiler Monitoring UI. Также возможно конвертировать .plog отчет в другие форматы при помощи утилиты PlogConverter.exe в Windows.
Начиная с релиза Unreal Engine 5.5, появилась возможность подавления предупреждений с помощью файла .Build.cs. Для этого необходимо прописать в файле следующую строку:
StaticAnalyzerPVSDisabledErrors.Add("V###");где "V###" — номер диагностического правила, которое необходимо отключить.
Если необходимо отключить несколько предупреждений, их номера можно перечислить через пробел:
StaticAnalyzerPVSDisabledErrors.Add("V### V###");Важно отметить, что файл .Build.cs генерируется для каждой директории проекта, и диагностические правила, прописанные в этом файле, отключаются только для той директории, в которой он находится.
SN-DBS — это система распределённой сборки приложений, разрабатываемая компанией SN Systems. До версии UE 5.5 интеграция PVS-Studio не работала вместе с интеграцией SN-DBS. При попытке запуска параллельного анализа проекта анализ проходил только на части файлов, анализируемых на мастер-ноде SN-DBS. Логи сборки при этом содержали сообщение "fatal error C1510: Cannot load language resource clui.dll."
Способы решения:
Engine/Source/Programs/UnrealBuildTool/Platform/Windows/PVSToolChain.cs в случае, если вы собирали UBT из исходных файлов.Данная проблема была исправлена в релизе UE 5.5.
В игровом движке Unreal Engine версии 5.5 появился новый инструмент Horde — платформа, позволяющая использовать циклы CPU на других машинах, чтобы распределить нагрузку.
Horde включает Unreal Build Accelerator — инструмент, реализующий виртуализацию для сторонних программ (например, компиляторов C++ или анализатора PVS-Studio), давая им возможность работать на удалённой машине и взаимодействовать с инициирующей системой по мере необходимости.
Чтобы установить сервер Horde, нужно:
Для установки сервера Horde на Windows запустите соответствующий установщик. Скачать его можно по ссылке.
Также можно развернуть сервер Horde с помощью Docker. Для этого сгенерируйте Personal Access Token на GitHub, далее авторизуйтесь с помощью него в GitHub Container Registry. Сделать это можно с помощью команды:
docker login ghcr.ioЕсли авторизация прошла успешно, то следующая команда сработает, и образ Horde скачается:
docker pull ghcr.io/epicgames/horde-server:latestДля запуска сервера Horde потребуются внешние экземпляры Redis и MongoDB, которые должны быть настроены через файл конфигурации или переменные окружения.
Однако есть возможность развернуть сервер Horde сразу со всеми необходимыми компонентами с помощью Docker Compose. Для этого возьмите из исходного кода Unreal Engine файл docker-compose.yaml и выполните в его директории команду:
docker-compose upВ этом файле можно предварительно настроить порты, на которых будет развёрнут сервер Horde. По первому порту располагается интерфейс для управления сервером, а по второму — API для подключения агентов:
....
horde-server:
image: ghcr.io/epicgames/horde-server:latest
restart: always
environment:
Horde__HttpPort: 13340
Horde__Http2Port: 13342
Horde__RedisConnectionConfig: redis:30002
Horde__DatabaseConnectionString:
mongodb://horde:dbPass123@mongodb:27017/Horde?authSource=admin
ports:
- 13340:13340 # HTTP/1
- 13342:13342 # HTTP/2
volumes:
- ./data:/app/Data
....Для того чтобы добавить агентов к серверу Horde, необходимо, чтобы на компьютерах, которые будут выступать в качестве агентов, был установлен Horde Agent. Ссылку для его установки можно найти прямо на сервере Horde по URL { HordeHost }/tools:
При установке Horde Agent с помощью .msi укажите URL сервера, к которому он будет подключён:
После окончания установки включите опцию Enroll agent with the Horde Server, чтобы агент отобразился в списке доступных для подключения на сервере Horde. Этот список располагается по URL /agents/registration. После того как Horde Agent будет установлен на удалённой машине, на этой странице появится информация об этом агенте:
Теперь, чтобы подключить агента, выберите его в списке и нажмите кнопку Enroll Agents. После этого он появится среди доступных на сервере агентов по адресу (по URL: /agents):
Для того чтобы сборка проекта запускалась на нескольких компьютерах, измените файл BuildConfiguration.xml (о том, где он находится, написано в документации Unreal Engine) и добавьте несколько свойств, отвечающих за использование Horde и UBA:
<?xml version="1.0" encoding="utf-8" ?>
<Configuration xmlns="https://www.unrealengine.com/BuildConfiguration">
<BuildConfiguration>
<bAllowUBAExecutor>true</bAllowUBAExecutor>
</BuildConfiguration>
<Horde>
<Server>http://horde-server-url:13340</Server>
<WindowsPool>Win-UE5</WindowsPool>
</Horde>
<UnrealBuildAccelerator>
<bForceBuildAllRemote>false</bForceBuildAllRemote>
<bLaunchVisualizer>true</bLaunchVisualizer>
</UnrealBuildAccelerator>
</Configuration>bAllowUBAExecutor в значении true указывает, что в процессе сборки будет использоваться UBA. Группа Horde содержит настройки используемого сервера Horde. В группе UnrealBuildAccelerator находятся настройки UBA:
bForceBuildAllRemote в значении false указывает, что сборка должна проходить не только на удалённых компьютерах, но и на сервере;bLaunchVisualizer в значении true запускает визуализатор при сборке.Переходим к проекту: сначала сгенерируйте из .uproject файлы проекта для Visual Studio, чтобы открыть его в IDE.
В конструкторе класса в .target-файле добавьте следующее поле для включения PVS-Studio:
StaticAnalyzer = StaticAnalyzer.PVSStudio;Примечание. При сборке проекта с помощью Horde и UBA может возникнуть проблема, когда файлы Unreal Engine по пути его установки недоступны для использования сборочной системой. В этом случае, проверьте, что у указанного файла не установлен атрибут Readonly, и все пользователи имеют к нему полный доступ.
Во время сборки на экране появится визуализатор, показывающий, какие процессы происходят на каждом из Horde-агентов:
Связка UnrealBuildTool и PVS-Studio работает следующим образом:
.i);.pvslog;.pvslog в один, который обычно лежит в $PROJECT\Saved\PVS-Studio\*.pvslog;На любом из вышеперечисленных этапов может возникнуть ошибка — например, если анализатор не смог проверить один из исходных файлов. Поэтому, если анализ завершился неудачно, то для выяснения и исправления причин сразу же пишите нам, и мы постараемся исправить проблему как можно быстрее.
Пожалуйста, прикрепите к письму дополнительные файлы, которые помогут нам понять причину ошибки и воспроизвести её:
.pvslog файлы. Пути до .pvslog могут отличаться на разных версиях Unreal Engine, но в основе формирования, как правило, лежат {PLATFORM} и {CONFIGURATION}. Например, в UE 4.26 их можно найти в {PROJECT}\Intermediate\Build\{PLATFORM}\UE4|UE4Editor\{CONFIGURATION}\{PROJECT}\PVS\.Unity проекты, написанные на C#, можно проверить с помощью PVS-Studio из консоли или IDE. Проверяемый Unity проект должен успешно собираться, чтобы результаты проверки были максимально корректными и полными.
Загрузить анализатор можно на этой странице.
Перед началом работы с PVS-Studio нужно ввести данные лицензии. Здесь написано, как это сделать.
Перед началом работы с кодом Unity проекта необходимо установить в настройках Unity предпочитаемый редактор скриптов. Это можно сделать с помощью параметра "External Script Editor" на вкладке "External Tools" в окне "Preferences". Чтобы открыть это окно, используйте опцию меню "Edit" -> "Preferences" в редакторе Unity:
После этого открыть Unity проект в IDE можно, используя опцию "Assets" -> "Open C# Project" в редакторе Unity:
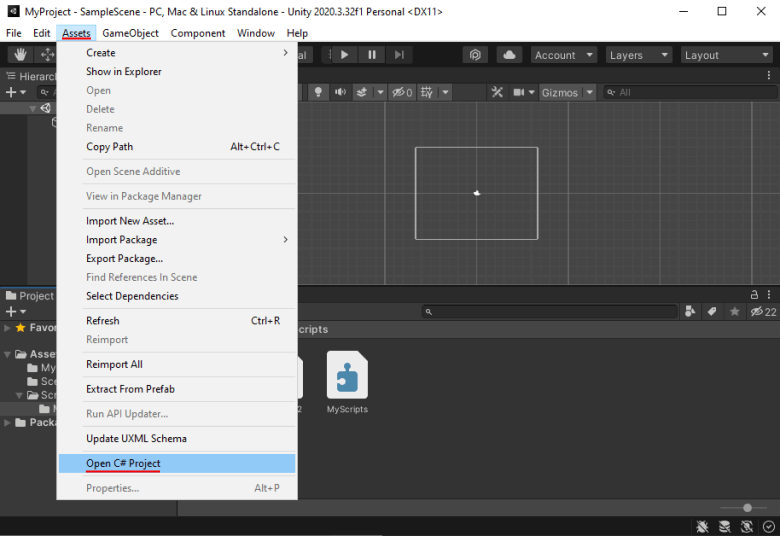
Также вы можете открыть сгенерированный Unity .sln файл из IDE. Если .sln файл отсутствует, то необходимо произвести вышеописанные действия в редакторе Unity. Тогда .sln будет сгенерирован.
Проанализировать Unity проект можно из Visual Studio. Руководство по использованию плагина доступно по ссылке.
Анализ может быть выполнен для следующих элементов:
Запустить анализ можно из подменю плагина PVS-Studio в меню "Extensions" на верхней панели меню:
Также запуск анализа доступен из окна "Solution Explorer" через контекстное меню по нажатию на элементе решения.
Отчёт об анализе доступен в окне "PVS-Studio":
Проанализировать Unity проект можно из JetBrains Rider. Возможности этого плагина и его применение аналогичны таковым для плагина Visual Studio. Подробная инструкция по использованию плагина для JetBrains Rider доступна по ссылке.
Запустить анализ можно через главное меню:
PVS-Studio можно запускать из командной строки. Это удобно, если вы хотите интегрировать анализ проекта в вашу инфраструктуру CI/CD.
Руководство по использованию CLI версии PVS-Studio доступно по ссылке.
Вы можете проверить всё решение (sln), отдельные проекты (csproj) или некоторый набор файлов исходного кода. В последнем случае путь к .sln/.csproj файлу также обязателен.
Для анализа C# проектов на Windows используется "PVS-Studio_Cmd.exe", на Unix-like системах "pvs-studio-dotnet".
Пример запуска PVS-Studio через CLI на Windows:
PVS-Studio_Cmd.exe -t D:\UnityProjects\MyProject\MyProject.slnПример запуска PVS-Studio через CLI на Unix-like системах:
pvs-studio-dotnet -t ./MyUnityProject.slnПо умолчанию анализатор генерирует отчёты в формате:
Отчёты можно открывать с помощью IDE плагинов PVS-Studio.
Примечание: отчёты в формате plog не поддерживается в Rider. Кроме того, под Linux и macOS не поддерживается конвертация таких отчётов.
Ниже представлено меню плагина под Visual Studio:
Отчёты можно сконвертировать в более удобный для восприятия человеком формат.
Для конвертации используется CLI утилита PlogConverter. На Windows используется "PlogConverter.exe", на Unix-like системах "plog-converter". Руководство к утилите доступно здесь.
Пример конвертации отчёта в формат HTML на Windows (вводится в одну строку):
PlogConverter.exe D:\UnityProjects\MyProject\MyProject.plog
-t FullHtml
-o D:\UnityProjects\MyProject\Пример конвертации отчёта в формат HTML на Unix-like системах:
plog-converter –t fullhtml ./ ./MyProject.plogЭти команды конвертируют отчёт в формат HTML, который удобен для просмотра в браузере и для рассылки по почте. Пример отчёта в формате FullHTML:
Если в Unity в настройках генерации C# проектов выбрана опция "Player projects", то происходит создание solution файла с дубликатами названий проектов. При анализе проекта с помощью PVS-Studio это может приводить к ошибке следующего вида: The solution file has two projects named "UnityEngine.UI". Для проведения анализа эту опцию требуется отключить.
После этого может понадобиться заново сгенерировать проектные файлы. Для этого есть кнопка ниже – "Regenerate project files".
После того как дубликаты из sln-файла пропадут, анализ должен работать нормально. Подробнее эта проблема с повторяющимися именами проектов описана здесь.
Во время анализа мы рекомендуем не совершать действий, которые могут привести к изменению sln/csproj файлов или файлов исходного кода. Например, это такие действия, как изменение или создание Assembly Definitions и Assembly Definition References, добавление новых скриптов.
В этой документации будет рассмотрен быстрый запуск анализа Java проекта через плагины для сборочных систем Gradle и Maven.
Также PVS-Studio Java предоставляет интеграцию с IDE IntelliJ IDEA через специальный плагин и интеграцию с Visual Studio Code через специальное расширение. Подробнее можно прочитать в документации:
Для интеграции плагина в проект, использующий Groovy DSL, добавьте следующий код в скрипт сборки build.gradle:
buildscript {
repositories {
mavenCentral()
maven {
url uri('https://cdn.pvs-studio.ru/java/pvsstudio-maven-repository/')
}
}
dependencies {
classpath 'com.pvsstudio:pvsstudio-gradle-plugin:latest.release'
}
}
apply plugin: com.pvsstudio.PvsStudioGradlePlugin
pvsstudio {
outputType = 'json'
outputFile = '.PVS-Studio/report.json'
analysisMode = ['GA', 'OWASP']
}Для Kotlin DSL добавьте следующий код в build.gradle.kts:
import com.pvsstudio.WarningGroup
buildscript {
repositories {
mavenCentral()
maven {
url =
uri("https://cdn.pvs-studio.ru/java/pvsstudio-maven-repository/")
}
}
dependencies {
classpath("com.pvsstudio:pvsstudio-gradle-plugin:latest.release")
}
}
apply<com.pvsstudio.PvsStudioGradlePlugin>()
extensions.configure<com.pvsstudio.AnalyzerConfig>("pvsstudio") {
outputType = "json"
outputFile = ".PVS-Studio/report.json"
analysisMode = setOf(WarningGroup.GA, WarningGroup.OWASP)
}Перед запуском анализа необходимо ввести лицензию. Её активация происходит с помощью следующей команды:
./gradlew pvsCredentials "-Ppvsstudio.userName=${LICENSE_NAME}" \
"-Ppvsstudio.licenseKey=${LICENSE_KEY}"Вместо переменной LICENSE_NAME укажите имя лицензии анализатора, привязанное к ключу, а вместо LICENSE_KEY — лицензионный ключ.
Можно запускать анализ. Для этого выполните следующую команду:
./gradlew pvsAnalyzeОбратите внимание: при анализе проекта плагин запускает ядро Java анализатора, которое по умолчанию использует версию Java из переменной окружения PATH. Задать другую версию можно с помощью настройки плагина javaPath. Подробное описание находится в документации.
Для интеграции плагина в проект добавьте следующий код в файл pom.xml:
<pluginRepositories>
<pluginRepository>
<id>pvsstudio-maven-repo</id>
<url>https://cdn.pvs-studio.ru/java/pvsstudio-maven-repository/</url>
</pluginRepository>
</pluginRepositories>
<build>
<plugins>
<plugin>
<groupId>com.pvsstudio</groupId>
<artifactId>pvsstudio-maven-plugin</artifactId>
<version>8.01.110581</version>
<configuration>
<analyzer>
<outputType>json</outputType>
<outputFile>.PVS-Studio/report.json</outputFile>
<analysisMode>GA, OWASP</analysisMode>
</analyzer>
</configuration>
</plugin>
</plugins>
</build>Перед запуском анализа необходимо ввести лицензию. Её активация происходит с помощью следующей команды:
mvn pvsstudio:pvsCredentials "-Dpvsstudio.userName=${LICENSE_NAME}" \
"-Dpvsstudio.licenseKey=${LICENSE_KEY}"Вместо переменной LICENSE_NAME укажите имя лицензии анализатора, привязанное к ключу, а вместо LICENSE_KEY — лицензионный ключ.
Можно запускать анализ. Для этого выполните следующую команду:
mvn pvsstudio:pvsAnalyzeОбратите внимание: при анализе проекта плагин запускает ядро Java анализатора, которое по умолчанию использует версию Java из переменной окружения PATH. Задать другую версию можно с помощью настройки плагина javaPath. Подробное описание находится в документации.
Существует сценарий, при котором можно запускать анализ Maven-проектов без модификации файла pom.xml. В этом случае старт анализа осуществляется через запуск специальной команды в директории проекта:
Для PowerShell:
$repo = "https://files.pvs-studio.com/java/pvsstudio-maven-repository/"
mvn -f ./pom.xml `
"-Dmaven.repo.remote= $repo" `
"-Dmaven.test.skip=true" `
"-Dpvsstudio.outputType=json" `
"-Dpvsstudio.outputFile=.PVS-Studio/report.json" `
"-Dpvsstudio.analysisMode=GA,OWASP" `
com.pvsstudio:pvsstudio-maven-plugin:8.01.110581:pvsAnalyzeДля Bash:
repo=https://files.pvs-studio.com/java/pvsstudio-maven-repository/
mvn -f ./pom.xml \
-Dmaven.repo.remote= "$repo" \
-Dmaven.test.skip=true \
-Dpvsstudio.outputType=json \
-Dpvsstudio.outputFile=.PVS-Studio/report.json \
-Dpvsstudio.analysisMode=GA,OWASP \
com.pvsstudio:pvsstudio-maven-plugin:8.01.110581:pvsAnalyzeДля cmd:
set REPO=https://files.pvs-studio.com/java/pvsstudio-maven-repository/
mvn -f ./pom.xml ^
"-Dmaven.repo.remote=%REPO%" ^
"-Dmaven.test.skip=true" ^
"-Dpvsstudio.outputType=json" ^
"-Dpvsstudio.outputFile=.PVS-Studio/report.json" ^
"-Dpvsstudio.analysisMode=GA,OWASP" ^
com.pvsstudio:pvsstudio-maven-plugin:8.01.110581:pvsAnalyzeПосле завершения анализа в директории .PVS-Studio в корне проекта будет создан файл report.json — отчёт со срабатываниями анализатора PVS-Studio Java.
Ознакомиться с результатами отчёта можно через:
Отчёт анализатора PVS-Studio может быть представлен в различных форматах. Для его конвертации из одного поддерживаемого формата в другой воспользуйтесь утилитой PlogConverter. Она входит в состав дистрибутива PVS-Studio. Один из поддерживаемых форматов вывода — FullHTML, который позволяет изучать отчёт анализатора в браузере с возможностью сортировать предупреждения и просматривать исходный код, на который анализатор выдал предупреждение.
По умолчанию утилита располагается в корневой директории анализатора. Чтобы сконвертировать отчёт, выполните в директории с json-отчётом следующую команду:
Для PowerShell:
& "C:\Program Files (x86)\PVS-Studio\PlogConverter.exe" `
-t FullHtml `
-a "GA:1,2,3;OWASP:1,2,3" `
-o . `
report.jsonДля Bash:
plog-converter \
-t FullHtml \
-a GA:1,23;OWASP:1,2,3 \
-o . \
report.jsonДля cmd:
"C:\Program Files (x86)\PVS-Studio\PlogConverter.exe" ^
-t FullHtml ^
-a GA:1,2,3;OWASP:1,2,3 ^
-o . ^
report.jsonВ результате утилита создаст директорию fullhtml, где будет лежать набор файлов, представляющих собой веб-страницу с отчётом анализатора. Для его просмотра откройте файл index.html в вашем браузере.
Более подробно про работу с PVS-Studio Java через сборочные системы Gradle и Maven можно узнать в соответствующих разделах документации:
Сценарий, при котором Java анализатор запускается напрямую через обращение к ядру, является продвинутым и не рекомендуется в качестве основного. Для удобной интеграции и использования Java анализатора PVS-Studio рекомендуем воспользоваться:
На Windows ядро Java анализатора возможно установить через инсталлятор PVS-Studio для Windows. Скачать его можно на странице загрузки.
Кроме этого, на всех операционных системах возможно скачать ZIP архив для Java на странице загрузки. В этом архиве содержится ядро Java анализатора (папка с именем 8.01.110581 в директории pvs-studio-java). Ядро анализатора надо распаковать в необходимое вам место или по стандартному пусти установки ядра Java анализатора:
%APPDATA%/PVS-Studio-Java;~/.config/PVS-Studio-Java. Для получения информации про все доступные аргументы анализатора, необходимо выполнить команду --help:
java -jar pvs-studio.jar --helpАргументы анализатора:
--additional-warnings — список диагностических правил, которые будут добавлены к анализу. Имеет больший приоритет, чем настройки --enabled-warnings, --disabled-warnings и --analysis-mode. Значение по умолчанию отсутствует. При перечислении нескольких правил в качестве разделителя используется пробел. Пример: --additional-warnings V6001 V6002 V6003;--analysis-mode — список активных групп диагностических правил. Приоритет меньше, чем у настроек --enabled-warnings, --disabled-warnings и --additional-warnings. Значение по умолчанию: GA. При перечислении нескольких групп в качестве разделителя используется пробел. Пример: --analysis-mode GA OWASP. Доступные группы: GA (правила общего назначения);OWASP (правила, соответствующие OWASP Top Ten и OWASP ASVS). --analyze-only-list — путь к текстовому файлу, который содержит список путей к файлам и/или директориям для анализа (каждая запись должна быть на отдельной строке). Поддерживаются относительные (будут раскрыты относительно каталога запуска) и абсолютные пути. Файлы и/или директории, считанные из файла, указанного в этом аргументе, объединяются в общий список со значениями из аргумента --analyze-only. Эта настройка имеет меньший приоритет, чем настройка --exclude. При передаче пустого списка файлов анализатор завершает работу с кодом возврата 55, отчёт анализатора при этом не создастся. Значение по умолчанию отсутствует;--analyze-only — список файлов и/или директорий, которые нужно проанализировать (абсолютные или относительный пути, которые будут раскрыты относительно каталога запуска). Файлы и/или директории, переданные в этом аргументе, объединяются в общий список с файлами и/или директориями из аргумента --analyze-only-list. При отсутствии значения для данной настройки будут проанализированы все файлы. Эта настройка имеет меньший приоритет, чем --exclude. Значение по умолчанию отсутствует. При перечислении нескольких файлов или директорий в качестве разделителя используется пробел. Пример: --analyze-only "path/to/file1" "path/to/file2" "path/to/dir";--cfg (-c) — конфигурационный файл для запуска ядра анализатора. В этом файле должны быть сохранены значения аргументов командной строки ядра Java анализатора в JSON-формате. Более подробная информация об этом файле находится в документации. Значение по умолчанию отсутствует;--convert — запуск в режиме конвертации. Режимы: toFullhtml — преобразует отчёт с предупреждениями в формат .fullhtml; toSuppress — преобразует отчёт с предупреждениями в формат файла подавления (suppress-файл);--disable-cache — отключает кэширование метамодели программы. При отключённом кэше модель проекта не кэшируется и строится каждый раз заново. Отключается и инкрементальный режим анализа проекта, даже если указан флаг --incremental. Значение по умолчанию: false;--disabled-warnings — список диагностических правил, которые не будут включены во время анализа. При отсутствии данной настройки все диагностики считаются включёнными. Эта настройка имеет больший приоритет, чем --enabled-warnings и --analysis-mode, но меньший, чем --additional-warnings. Значение по умолчанию отсутствует;--dst-convert — путь до файла или каталога, куда будет записан результат преобразования (файл для toSuppress, директория для toFullhtml);--enabled-warnings — список активных диагностических правил. Во время анализа будут использованы только те диагностические правила, которые перечислены в этом списке. Эта настройка имеет меньший приоритет, чем --disabled-warnings и --additional-warnings, но больший, чем --analysis-mode. Значение по умолчанию отсутствует. При перечислении нескольких правил в качестве разделителя используется пробел. Пример: --enabled-warnings V6001 V6002 V6003;--exclude — список файлов и/или директорий, которые нужно исключить из анализа (относительные пути, которые будут раскрыты относительно каталога запуска, или абсолютные пути). Эта настройка имеет больший приоритет, чем --analyze-only и --analyze-only-list. Значение по умолчанию отсутствует. При перечислении нескольких файлов или директорий в качестве разделителя используется пробел. Пример: --exclude "path/to/file1" "path/to/file2" "path/to/dir";--ext-file — путь до файла с classpath. Значение по умолчанию отсутствует. В качестве разделителя classpath используется : в *nix-системах и ; — в Windows-системах. Пример: --ext-file "path/to/project_classpath_file";--ext (-e) — определение classpath. Значение по умолчанию отсутствует. При перечислении нескольких сущностей classpath в качестве разделителя используется пробел. Пример: --ext "path/to/file.jar" "path/to/dirJars";--fail-on-warnings — устанавливает ненулевой код возврата программы, если анализатор выдал хотя бы одно предупреждение на проекте. Данное поведение может быть удобным при интеграции в CI/CD. Значение по умолчанию: false;--force-rebuild — позволяет принудительно перестроить целиком закэшированную метамодель программы. При использовании данного флага отключается инкрементальный режим анализа проекта, даже если указан флаг --incremental. Значение по умолчанию: false;--help (-h) — вывод в консоль справочной информации об аргументах ядра Java анализатора;--incremental (-i) — запускает инкрементальный режим анализа PVS-Studio. Анализируются только изменившиеся файлы. Значение по умолчанию: false;--java-path — задаёт путь до исполняемого файла java, с которым будет запускаться ядро анализатора. Эту настройку можно задать для всей системы в файле global.json. Если не использовать java-path, то PVS-Studio попытается использовать путь из переменной окружения PATH;--logging — уровень логирования при запуске анализа. При включении в поддиректории .PVS-Studio/logs относительно директории текущего запуска Java анализатора будут созданы файлы логов для текущего запуска. При передаче некорректного значения логирование будет отключено. Значение по умолчанию: OFF. Варианты допустимых значений: OFF;ERROR; WARN;INFO;DEBUG; TRACE;ALL. --output-file (-o) — путь до файла с отчётом анализатора. Формат содержимого отчёта не зависит от расширения файла, указанного в этом аргументе. Значение по умолчанию: ./PVS-Studio + расширение формата из аргумента --output-type. Для отчёта в формате .fullhtml необходимо указать директорию, в которой будет создана папка с именем fullhtml, содержащая файл отчёта анализатора (index.html). Значение по умолчанию: ./fullhtml. Примечание. Вместо использования аргумента --output-file более предпочтительным сценарием является использование консольных утилит PlogConverter (Windows) и plog-converter (Linux и macOS). Эти утилиты позволяют конвертировать отчёт анализатора в большее количество форматов (например, SARIF), а также предоставляют дополнительные возможности: фильтрация предупреждений из отчёта, преобразование путей в отчёте с абсолютных на относительные и наоборот, получение разницы между отчётами и др.;--output-type (-O) — формат, в котором будет представлен отчёт анализатора. Значение по умолчанию: json. Допустимые варианты значений:text;log;json;xml;tasklist;html;fullhtml; errorfile. --security-related-issues — позволяет выделить дополнительной маркировкой в поле SAST предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207—2024. Значение по умолчанию: false;--sourcetree-root — корневая часть пути, которую анализатор будет использовать при генерации относительных путей в отчёте для диагностических предупреждений. Значение по умолчанию отсутствует; Пример: --sourcetree-root /path/to/project/directory;--src-convert — путь до отчёта анализатора с предупреждениями (*.json);--src (-s) — набор файлов или директорий анализируемого проекта. Значение по умолчанию отсутствует. При перечислении нескольких файлов или директорий в качестве разделителя используется пробел. Пример: --src "path/to/file1" "path/to/file2" "path/to/dir";--suppress-base — путь до suppress-файла, содержащего подавленные предупреждения анализатора. Предупреждения из этого файла не попадут в отчёт при следующих проверках проекта. Значение по умолчанию: ./.PVS-Studio/suppress_base.json;--threads (-j) — число потоков анализа. Также возможно задать эту настройку для всей системы в файле global.json. Значение по умолчанию: число доступных логических ядер;--timeout — таймаут анализа одного файла (в минутах). Эту настройку можно задать для всей системы в файле global.json. Значение по умолчанию: 10; --activate-license — позволяет сохранить в файл информацию о лицензии, указанной через аргументы --user-name и --license-key. Значение по умолчанию: false;--license-key — лицензионный ключ;--license-path — путь до файла с лицензией. Допустимые расширения файла: .xml, .lic. Значение по умолчанию: %APPDATA%/PVS-Studio/Settings.xml (Windows) или ~/.config/PVS-Studio/PVS-Studio.lic (macOS и Linux);--user-name — имя лицензии анализатора, привязанное к лицензионному ключу;--compatibility — активирует диагностическое правило V6078, которое обнаруживает потенциальные проблемы совместимости API между выбранными версиями Java SE. Значение по умолчанию: false;--exclude-packages — пакеты, которые будут исключены из анализа совместимости. Эта настройка используется диагностическим правилом V6078, если включена настройка --compatibility. Пример: --exclude-packages "package1" "package2" "package3";--source-java — версия Java SE, на которой разработано проверяемое приложение. Эта настройка используется диагностическим правилом V6078, если включена настройка --compatibility. Минимальное значение: 8. Максимальное значение: 14;--target-java — версия Java SE, на совместимость с которой проверяется API, используемое в приложении (--source-java). Эта настройка используется диагностикой анализатора V6078, если включена настройка --compatibility. Минимальное значение: 8. Максимальное значение: 14.Перед запуском анализа вам необходимо будет ввести лицензию. Как это сделать — можно узнать в этой документации.
Примеры быстрого запуска ядра Java анализатора:
java -jar pvs-studio.jar -s A.java B.java C.java -e Lib1.jar Lib2.jar -j4
-o report.txt -O text --user-name licenseName –-license-key licenseKey
java -jar pvs-studio.jar -s src/main/java --ext-file classpath.txt -j4
-o report.txt -O text --license-path PVS-Studio.licОбратите внимание:
java из переменной окружения PATH. Задать другую версию можно при помощи аргумента java-path, подробное описание которого находится выше в разделе Аргументы ядра Java анализатора.По умолчанию анализатор запускает ядро через Java, путь к которой указан в PATH. Если необходимо запустить анализ с какой-то другой версией, ее можно указать вручную. Для этого запустите ядро Java анализатора, используя полный путь до исполняемого Java файла из JDK. Версия Java из этой JDK будет использована при анализе исходного кода проекта:
/path/to/jdk_folder/bin/java -jar pvs-studio.jar ^
-s A.java B.java C.java -e Lib1.jar Lib2.jar -j4 ^
-o report.txt -O text --user-name licenseName –-license-key licenseKeyДля упрощения команды запуска анализа можно вынести аргументы командной строки в специальный JSON-файл. В дальнейшем этот файл можно передать в ядро анализатора через флаг --cfg.
Синтаксис файла выглядит следующим образом:
{
"single-value-parameter": "value",
"multiple-values-parameter": ["value1", "value2", "value3"]
}Каждый параметр в файле конфигурации представляет собой полное имя флага командной строки со значением, которое будет передано в этом флаге.
Пример файла конфигурации:
{
"src": ["A.java", "B.java", "C.java"],
"threads": 4,
"output-file": "report.txt",
"output-type": "text",
"user-name": "licenseName",
"license-key": "licenseKey"
....
}В таком случае запуск анализатора сведётся к следующей строке:
java -jar pvs-studio.jar –-cfg cfg.jsonПримечание. Параметры, переданные через командную строку, имеют более высокий приоритет, чем параметры, заданные в файле конфигурации.
Часть настроек ядро Java анализатора берёт из файла global.json. Этот файл расположен в папке по стандартному пути установки ядра Java анализатора:
%APPDATA%/PVS-Studio-Java/global.json;~/.config/PVS-Studio-Java/global.json. Вот список этих настроек:
java — Значение по умолчанию: java;jvm-arguments — Значение по умолчанию: ["-Xss64m"];threads — Значение по умолчанию: число доступных процессоров. Это значение возможно переопределить через аргумент --threads командной строки ядра Java анализатора;timeout — Значение по умолчанию: 10. Это значение возможно переопределить через аргумент --timeout командной строки ядра Java анализатора;verbose — Значение по умолчанию: true.Эти значения по умолчанию используются для всех ядер Java анализатора в системе, а также плагинами PVS-Studio для Java. При необходимости значения этих параметров можно изменить. Например, чтобы все плагины PVS-Studio для Java использовали одно и то же количество потоков для анализа.
Информацию о том, какие из этих настроек возможно переопределить в плагинах PVS-Studio для Java, вы найдёте в соответствующих разделах документации:
0 — анализ успешно завершён. Ошибки могут быть как найдены, так и не найдены;50 — произошла ошибка при анализе;51 — переданы невалидные аргументы при запуске анализа;52 — при анализе используется невалидная или просроченная лицензия;53 — анализ успешно завершен, и анализатор нашёл потенциальные ошибки в коде проекта. Этот код возврата будет возвращен только при использовании флага ядра Java анализатора --fail-on-warnings;54 — при анализе попытались использовать Enterprise возможности ядра Java анализатора, но при этом использовали не Enterprise лицензию;55 — все файлы были исключены из анализа.Каждый раз при запуске анализа проверяется наличие новой версии анализатора PVS-Studio. Если вышла новая версия анализатора, то в файле с результатами анализа будет содержаться сообщение: "A newer version of PVS-Studio is available (8.01.110581)". Это сообщение содержит последнюю версию ядра Java анализатора.
Кроме этого, получить последнюю версию PVS-Studio можно из файла по ссылке.
Для обновления ядра Java анализатора скачайте ZIP-архив на странице загрузки. В этом архиве содержится ядро Java анализатора (папка с именем 8.01.110581 в директории pvs-studio-java). Ядро Java анализатора надо распаковать в необходимое место или в стандартную директорию:
%APPDATA%/PVS-Studio-Java;~/.config/PVS-Studio-Java.Весь этот процесс можно автоматизировать при помощи различных скриптов, что позволит всегда использовать последнюю версию ядра Java анализатора.
В этой документации представлена работа с анализатором PVS-Studio для JavaScript и TypeScript c использованием командной строки.
Помимо CLI, PVS-Studio предоставляет интеграцию с WebStorm, PhpStorm и Visual Studio Code. Подробнее описано в соответствующих документациях:
Установка анализатора описана в отдельной документации.
Перед началом использования анализатора необходимо активировать лицензию. Ввод лицензии описан в отдельной документации.
Утилита имеет два режима работы:
analyze — утилита выполняет анализ переданного проекта;suppress — утилита выполняет генерацию файла подавления.Для получения информации обо всех доступных аргументах и флагах необходимо выполнить команды:
pvs-js --helppvs-js analyze --helppvs-js suppress --helpДля запуска анализа проекта нужно воспользоваться командой analyze и передать путь до директории с JavaScript или TypeScript проектом:
pvs-js analyze /path/to/projectПо итогам выполнения анализа утилита сохранит отчёт в текущей рабочей директории с именем PVS-Studio.json и вернёт код возврата.
Режим analyze имеет один аргумент — директория с проектом.
Ниже представлены флаги режима analyze.
Определяет поведение анализатора на указанных путях. Принимает строку следующего формата:
(mode=<path>|<glob>)(,mode=<path>|<glob>)*где mode — поведение анализатора на указанном пути <path> или glob-паттерне <glob>. Допустимые режимы:
analyze — анализатор проведёт анализ файлов, соответствующих указанному пути или glob-паттерну;skip-analysis — анализатор уберёт из анализа файлы, соответствующие указанному пути или glob-паттерну.Анализатор всегда изначально предполагает, что все исходные файлы должны быть проверены (analyze=*), даже при явной передаче флага. Флаг может быть задан несколько раз, анализатор последовательно применит все указанные фильтры.
Например, нужно исключить из анализа директории 3rd-party и unittests, но включить в анализ поддиректорию 3rd-party/lib1:
pvs-jvs analyze /path/to/project \
--analysis-paths "skip-analysis=*/3rd-party/*" \
--analysis-paths "skip-analysis=*/unittests/*" \
--analysis-paths "analyze=*/3rd-party/lib1/*"Активирует проверку списка файлов. Позволяет решить задачу автоматической проверки коммитов и Pull/Merge Requests на стороне CI/CD.
В качестве аргумента принимает файл со списком путей или glob-паттернов, которые необходимо проанализировать. Каждый путь или glob-паттерн должен быть записан отдельной строкой, например:
# content of the file
src/source1.ts
src/source2.tsЕсли файл содержит относительные пути, то они будут раскрыты в абсолютные через текущую рабочую директорию.
Пример:
pvs-js analyze /path/to/project \
--source-files fromCommit.txtПуть до результирующего отчёта анализатора. Расширение файла, переданного в качестве аргумента, не влияет на формат содержимого отчёта.
Если необходимо выдать результат в stdout, то нужно передать символ - как аргумент флага.
Если флаг не передан, то по умолчанию отчёт запишется в текущей рабочей директории с именем PVS-Studio.json.
Пример:
pvs-js analyze /path/to/project \
--output report.jsonПозволяет задать конфигурацию анализа через файл в формате TOML. Более подробно об этом способе настройки анализатора написано в отдельной документации.
По умолчанию утилита ищет файл pvs-settings.toml в директории, указанной для анализа.
Пример:
cd /path/to/project
pvs-js analyze . \
--analysis-config project-settings.tomlЗадаёт количество потоков для анализа. Представляет собой целое, неотрицательное число.
Если в качестве аргумента передано значение 0, то анализ будет распараллелен на все доступные логические ядра.
Если флаг не указан, то по умолчанию утилита распараллеливает работу на оптимальное количество потоков для анализа.
Пример:
pvs-js analyze /path/to/project \
--threads 8Определяет время, через которое будет остановлен анализ единичного файла (таймаут).
Представляет собой строку формата XXhYYmZZs.
Если флаг не указан, то по умолчанию утилита останавливает анализ единичного файла через 10 минут.
Пример установки таймаута на 30 минут:
pvs-js analyze /path/to/project \
--file-analysis-timeout 30mПозволяет генерировать переносимые между машинами отчёты. Представляет собой путь до директории, который будет заменяться в позициях предупреждений на специальный маркер |?|.
Пример:
pvs-js analyze /path/to/project \
--source-tree-root /path/to/projectПозволяет управлять состоянием диагностических правил — включены (on) или выключены (off).
Принимает строку следующего формата:
(RULE|RANGE|GROUP)=(on|off)(,(RULE|RANGE|GROUP)=(on|off))*где:
RULE — диагностическое правило, которое записывается в формате Vxxxx. Списки диагностических правил доступны здесь: [1] и [2].RANGE — закрытый диапазон диагностических правил, который записывается в формате Vxxxx-Vyyyy. Число xxxx должно быть меньше yyyy.GROUP — группа диагностических правил. Доступные группы:ALL — все диагностические правила.GA — диагностические правила общего назначения.OWASP — диагностические правила для обнаружения отклонений от OWASP ASVS.Анализатор всегда изначально предполагает, что включена только группа диагностических правил общего назначения (GA=on), даже при явной передаче флага. Флаг может быть задан несколько раз: анализатор последовательно применит все указанные фильтры.
Пример отключения всех правил и включение только правил V7001–V7031:
pvs-js analyze /path/to/project \
--rules ALL=off \
--rules V7001-V7031=onВключает добавление SEC-меток в поле SAST предупреждений анализатора. SEC-метки отображают группы срабатываний анализатора согласно классификации критических ошибок из ГОСТ Р 71207-2024.
Пример:
pvs-js analyze /path/to/project \
--security-related-issuesПри указании флага утилита возвращает код 1, если отчёт содержит предупреждения после успешного завершения анализа.
Пример:
pvs-js analyze /path/to/project \
–-indicate-warningsПозволяет не выдавать в результатах анализа предупреждения низкого уровня достоверности.
Пример:
pvs-js analyze /path/to/project \
–-no-noiseЗадаёт пути до файлов подавления предупреждений анализатора.
Если флаг не указан, то по умолчанию утилита неявно ищет файл с названием suppress_file.suppress.json в директории анализа.
Флаг может быть задан несколько раз: анализатор читает все указанные файлы подавления.
Пример:
pvs-js analyze /path/to/project \
--suppress-files /path/to/project/js.suppress.json \
--suppress-files /path/to/project/ts.suppress.jsonПозволяет отключить проверку об истечении срока лицензии. Если до окончания лицензии остаётся менее 30 дней, без указания флага утилита возвращает код 21 и записывает сообщение.
Пример:
pvs-js analyze /path/to/project \
--disable-license-expiration-checkПозволяет игнорировать ненулевой код возврата при следующих некритичных ошибках:
Пример:
pvs-js analyze /path/to/project \
--ignore-analysis-failuresПозволяет задать произвольный путь до файла, содержащего информацию о лицензии. На Windows лицензия должна содержаться в Settings.xml файле, на Linux/macOS — в файле PVS-Studio.lic.
Если флаг не указан, то по умолчанию утилита ищет лицензию, которая была введена стандартным способом на Windows или Linux/macOS.
Пример:
pvs-js analyze /path/to/project \
--license-file /path/to/project/PVS-Studio.licУказывает максимальный размер области кучи для долгоживущих объектов, доступной для TypeScript Server. Подробнее об этом флаге можно прочитать здесь.
Представляет собой целое число — количество мегабайт. Значение по умолчанию: 8192.
Пример:
pvs-js analyze –max-old-space-size=4096Режим suppress производит подавление предупреждений на основе переданных отчётов анализа. Предупреждения, которые генерирует анализатор и которые соответствуют подавленным, не попадут в отчёт при следующих проверках проекта. Более подробно об этом механизме написано в отдельной документации.
Режим принимает пути до отчётов анализа. Если необходимо прочитать отчёт из stdin, то нужно передать символ - как аргумент флага.
Подавленные предупреждения по умолчанию записываются в текущую рабочую директорию в файл с именем suppress_file.suppress.json. Расположение файла может быть изменено соответствующим флагом, который будет описан ниже. Если файл ранее существовал, то утилита дополнит его новыми предупреждениями.
Пример:
pvs-js suppress /path/to/project/module1.report.json
/path/to/project/module2.report.jsonНиже представлены флаги режима suppress
Путь до результирующего файла подавления.
При попытке передачи пути до директории в качестве аргумента будет выдана ошибка.
Если файл ранее существовал и является файлом подавления, то утилита дополнит его новыми предупреждениями.
Если необходимо выдать результат в stdout, то нужно передать символ - как аргумент флага.
Пример:
pvs-js suppress /path/to/project/report.json \
--output /path/to/project/project.suppress.json0 — анализ успешно завершён.1 — анализ успешно завершён и результирующий отчёт содержит предупреждения. Этот код будет возвращен только при использовании флага --indicate-warnings.2 — обнаружена некорректная конфигурация анализатора, заданная через интерфейс командной строки или файлы конфигурации.3 — при работе утилиты возникла непредвиденная ошибка. Обычно это сигнализирует о наличии ошибки в коде самой утилиты и сопровождается выведением дополнительной информации в stderr. Если вам встретилась такая ошибка, пожалуйста, отправьте эту информацию нам через форму обратной связи.4 — все файлы были исключены из анализа.5 — имеются файлы, которые не удалось проанализировать (например, произошла ошибка парсинга).6 — имеются файлы, анализ которых был прерван по таймауту.20 — истёк срок действия лицензии.21 — срок действия лицензии истечёт через месяц.22 — лицензия отсутствует или невалидна.0 — предупреждения из всех переданных отчетов были успешно подавлены.1 — часть предупреждений из переданных отчетов не была подавлена из-за некритичной ошибки.2 — были указаны некорректные входные данные.3 — при работе утилиты возникла непредвиденная ошибка. Обычно это сигнализирует о наличии ошибки в коде самой утилиты и сопровождается выведением дополнительной информации в stderr. Если вам встретилась такая ошибка, пожалуйста, отправьте эту информацию нам через форму обратной связи.В этой документации представлена работа с анализатором PVS-Studio для Go c использованием командной строки.
Помимо CLI, PVS-Studio предоставляет интеграцию с GoLand и Visual Studio Code. Подробнее описано в соответствующих документациях:
Установка анализатора описана в отдельной документации.
Перед началом использования анализатора необходимо активировать лицензию. Ввод лицензии описан в отдельной документации.
Утилита имеет два режима работы:
analyze — утилита выполняет анализ переданного проекта;suppress — утилита выполняет генерацию файла подавления.Для получения информации обо всех доступных аргументах и флагах, необходимо выполнить команды:
pvs-golang --helppvs-golang analyze --helppvs-golang suppress --helpДля запуска анализа проекта нужно воспользоваться командой analyze и передать путь до директории с Go проектом:
pvs-golang analyze /path/to/projectПо итогам выполнения анализа утилита сохранит отчёт в текущей рабочей директории с именем PVS-Studio.json и вернёт код возврата.
Режим analyze имеет один аргумент — директория с проектом.
Ниже представлены флаги режима analyze.
Определяет поведение анализатора на указанных путях. Принимает строку следующего формата:
(mode=<path>|<glob>)(,mode=<path>|<glob>)*где mode — поведение анализатора на указанном пути <path> или glob-паттерне <glob>. Допустимые режимы:
analyze — анализатор проведёт анализ файлов, соответствующих указанному пути или glob-паттерну;skip-analysis — анализатор уберёт из анализа файлы, соответствующие указанному пути или glob-паттерну.Анализатор всегда изначально предполагает, что все исходные файлы должны быть проверены (analyze=*), даже при явной передаче флага. Флаг может быть задан несколько раз, анализатор последовательно применит все указанные фильтры.
Например, нужно исключить из анализа директории 3rd-party и unittests, но включить в анализ поддиректорию 3rd-party/lib1:
pvs-golang analyze /path/to/project \
--analysis-paths "skip-analysis=*/3rd-party/*" \
--analysis-paths "skip-analysis=*/unittests/*" \
--analysis-paths "analyze=*/3rd-party/lib1/*"Активирует проверку списка файлов. Позволяет решить задачу автоматической проверки коммитов и Pull/Merge Requests на стороне CI/CD.
В качестве аргумента принимает файл со списком путей или glob-паттернов, которые необходимо проанализировать. Каждый путь или glob-паттерн должен быть записан отдельной строкой, например:
# content of the file
src/source1.go
src/source2.goЕсли файл содержит относительные пути, то они будут раскрыты в абсолютные через текущую рабочую директорию.
Пример:
pvs-golang analyze /path/to/project \
--source-files fromCommit.txtПуть до результирующего отчёта анализатора. Расширение файла, переданного в качестве аргумента, не влияет на формат содержимого отчёта.
Если необходимо выдать результат в stdout, то нужно передать символ - как аргумент флага.
Если флаг не передан, то по умолчанию отчёт запишется в текущей рабочей директории с именем PVS-Studio.json.
Пример:
pvs-golang analyze /path/to/project \
--output report.jsonПозволяет задать конфигурацию анализа через файл в формате TOML. Более подробно об этом способе настройки анализатора написано в отдельной документации.
По умолчанию, утилита ищет файл pvs-settings.toml в директории, указанной для анализа.
Пример:
cd /path/to/project
pvs-golang analyze . \
--analysis-config project-settings.tomlЗадаёт количество потоков для анализа. Представляет собой целое, неотрицательное число.
Если в качестве аргумента передано значение 0, то анализ будет распараллелен на все доступные логические ядра.
Если флаг не указан, то по умолчанию утилита распараллеливает работу на оптимальное количество потоков для анализа.
Пример:
pvs-golang analyze /path/to/project \
--threads 8Определяет время, через которое будет остановлен анализ единичного файла (таймаут).
Представляет собой строку формата XXhYYmZZs.
Если флаг не указан, то по умолчанию утилита останавливает анализ единичного файла через 10 минут.
Пример установки таймаута на 30 минут:
pvs-golang analyze /path/to/project \
--file-analysis-timeout 30mПозволяет генерировать переносимые между машинами отчёты. Представляет собой путь до директории, который будет заменяться в позициях предупреждений на специальный маркер |?|.
Пример:
pvs-golang analyze /path/to/project \
--source-tree-root /path/to/projectПозволяет управлять состоянием диагностических правил — включены (on) или выключены (off).
Принимает строку следующего формата:
(RULE|RANGE|GROUP)=(on|off)(,(RULE|RANGE|GROUP)=(on|off))*где:
RULE — диагностическое правило, которое записывается в формате Vxxxx. Списки диагностических правил доступны здесь: [1] и [2].RANGE — закрытый диапазон диагностических правил, который записывается в формате Vxxxx-Vyyyy. Число xxxx должно быть меньше yyyy.GROUP — группа диагностических правил. Доступные группы:ALL — все диагностические правила.GA — диагностические правила общего назначения.OWASP — диагностические правила для обнаружения отклонений от OWASP ASVS.Анализатор всегда изначально предполагает, что включена только группа диагностических правил общего назначения (GA=on), даже при явной передаче флага. Флаг может быть задан несколько раз: анализатор последовательно применит все указанные фильтры.
Пример отключения всех правил и включение только правил V8001–V8031:
pvs-golang analyze /path/to/project \
--rules ALL=off \
--rules V8001-V8031=onВключает добавление SEC-меток в поле SAST предупреждений анализатора. SEC-метки отображают группы срабатываний анализатора согласно классификации критических ошибок из ГОСТ Р 71207-2024.
Пример:
pvs-golang analyze /path/to/project \
--security-related-issuesПри указании флага, утилита возвращает код 1, если отчёт содержит предупреждения после успешного завершения анализа.
Пример:
pvs-golang analyze /path/to/project \
–-indicate-warningsПозволяет не выдавать в результатах анализа предупреждения низкого уровня достоверности.
Пример:
pvs-golang analyze /path/to/project \
–-no-noiseЗадаёт пути до файлов подавления предупреждений анализатора.
Если флаг не указан, то по умолчанию утилита неявно ищет файл с названием suppress_file.suppress.json в директории анализа.
Флаг может быть задан несколько раз: анализатор читает все указанные файлы подавления.
Пример:
pvs-golang analyze /path/to/project \
--suppress-files /path/to/project/file1.suppress.json \
--suppress-files /path/to/project/file2.suppress.jsonПозволяет отключить проверку об истечении срока лицензии. Если до окончания лицензии остаётся менее 30 дней, без указания флага утилита возвращает код 21 и записывает сообщение.
Пример:
pvs-golang analyze /path/to/project \
--disable-license-expiration-checkПозволяет игнорировать ненулевой код возврата при следующих некритичных ошибках:
Пример:
pvs-golang analyze /path/to/project \
--ignore-analysis-failuresПозволяет задать произвольный путь до файла, содержащего информацию о лицензии. На Windows лицензия должна содержаться в Settings.xml файле, на Linux/macOS — в файле PVS-Studio.lic.
Если флаг не указан, то по умолчанию утилита ищет лицензию, которая была введена стандартным способом на Windows или Linux/macOS.
Пример:
pvs-golang analyze /path/to/project \
--license-file /path/to/project/PVS-Studio.licРежим suppress производит подавление предупреждений на основе переданных отчётов анализа. Предупреждения, которые генерирует анализатор и которые соответствуют подавленным, не попадут в отчёт при следующих проверках проекта. Более подробно об этом механизме написано в отдельной документации.
Режим принимает пути до отчётов анализа. Подавленные предупреждения по умолчанию записываются в текущую рабочую директорию в файл с именем suppress_file.suppress.json. Расположение файла может быть изменено соответствующим флагом, который будет описан ниже. Если файл ранее существовал, то утилита дополнит его новыми предупреждениями.
Пример:
pvs-golang suppress /path/to/project/module1.report.json
/path/to/project/module2.report.jsonНиже представлены флаги режима suppress.
Путь до результирующего файла подавления.
При попытке передачи пути до директории в качестве аргумента будет выдана ошибка.
Если файл ранее существовал и является файлом подавления, то утилита дополнит его новыми предупреждениями.
Если необходимо выдать результат в stdout, то нужно передать символ - как аргумент флага.
Пример:
pvs-golang suppress /path/to/project/report.json \
--output /path/to/project/project.suppress.json0 — анализ успешно завершён.1 — анализ успешно завершён и результирующий отчёт содержит предупреждения. Этот код будет возвращен только при использовании флага --indicate-warnings.2 — обнаружена некорректная конфигурация анализатора, заданная через интерфейс командной строки или файлы конфигурации.3 — при работе утилиты возникла непредвиденная ошибка. Обычно это сигнализирует о наличии ошибки в коде самой утилиты и сопровождается выведением дополнительной информации в stderr. Если вам встретилась такая ошибка, пожалуйста, отправьте эту информацию нам через форму обратной связи.4 — все файлы были исключены из анализа.5 — имеются файлы, которые не удалось проанализировать (например, произошла ошибка парсинга).6 — имеются файлы, анализ которых был прерван по таймауту.20 — истёк срок действия лицензии.21 — срок действия лицензии истечёт через месяц.22 — лицензия отсутствует или невалидна.0 — предупреждения из всех переданных отчетов были успешно подавлены.1 — часть предупреждений из переданных отчетов не была подавлена из-за некритичной ошибки.2 — были указаны некорректные входные данные.3 — при работе утилиты возникла непредвиденная ошибка. Обычно это сигнализирует о наличии ошибки в коде самой утилиты и сопровождается выведением дополнительной информации в stderr. Если вам встретилась такая ошибка, пожалуйста, отправьте эту информацию нам через форму обратной связи.Статический анализатор PVS-Studio для С и C++ представляет собой консольное приложение pvs-studio и набор вспомогательных утилит. Также доступны интеграции с VS Code, Qt Creator и CLion в виде плагинов, предоставляющие удобный интерфейс для анализа проектов. Чтобы программа работала, необходимо настроить окружение для сборки вашего проекта.
Новый запуск анализатора выполняется для каждого файла. Результаты анализа нескольких исходных файлов могут быть добавлены в один отчёт или отображены в stdout.
Существуют три основных режима работы анализатора:
Примеры команд для установки анализатора из пакетов и репозиториев приведены на этих страницах:
Для ознакомления с PVS-Studio можно запросить лицензию через форму обратной связи. Подробнее о том, как ввести полученную лицензию на Linux и macOS, можно прочитать здесь.
Перед запуском анализа выполните один из следующих шагов для получения модели сборки проекта.
Важно. Перед началом анализа проект должен компилироваться успешно. Если вы используете WSL для анализа, убедитесь, что ваш проект находится в файловой системе Linux, иначе анализ будет гораздо медленнее. Подробнее тут.
Для анализа проектов можно заранее сгенерировать файл compile_commands.json.
Этот файл может быть сгенерирован из следующих широко используемых сборочных систем:
На этой странице вы можете найти руководство по тому, как запускать анализ при помощи compile_commands.json файлов.
Примечание. Подход упрощает анализ, т.к. запуски компилятора не нуждаются в полной трассировке.
Если сгенерировать файл compile_commands.json невозможно, воспользуйтесь режимом трассировки компиляции. Для его работы необходима установить утилиту strace. С её помощью анализатор собирает необходимую информацию о компиляции проекта во время его сборки.
Примечание. Перед запуском режима необходимо очистить проект. Это поможет анализатору получить всей информации о скомпилированных файлах.
Собрать проект и отследить процесс его компиляции можно с помощью команды:
pvs-studio-analyzer trace -- makeВместо команды make можно использовать любую команду запуска сборки проекта со всеми необходимыми параметрами.
Например:
pvs-studio-analyzer trace -- make debugВ результате трассировки по умолчанию будет сформирован файл strace_out. Подробнее о режиме трассировки можно узнать в документации.
В некоторых Docker образах, например, Astra Linux, ptrace по умолчанию отключен, что может препятствовать работе утилиты pvs-studio-analyzer в режиме трассировки.
Ниже описаны способы включения ptrace в контейнере. Обратите внимание, что полная совместимость PVS-Studio в таком режиме не гарантируется. Если у вас возникнут трудности, обязательно обращайтесь к нам в поддержку.
Первый метод - запуск контейнера с параметром --pid=host
Этот метод подразумевает использование пространства процессов хоста:
--pid=host: docker run -it --pid=host <image_name> /bin/bash. Замените <image_name> на имя вашего образа.Обратите внимание, что контейнер будет делить пространство PID с хостом, что влияет на изоляцию и безопасность системы.
Второй метод - копирование файла ptrace_scope
Этот метод позволяет "заменить" файл ptrace_scope в образе на версию с включенной трассировкой:
/proc/sys/kernel/yama/ptrace_scope в директорию с Dockerfile. В нём должно содержаться значение 0;COPY ptrace_scope /proc/sys/kernel/yama/ptrace_scope;docker build -t <new_image_name>.О том, как запустить PVS-Studio в Docker контейнере, можно прочитать в нашей документации.
После получения файла трассировки компиляции strace_out или JSON Compilation Database compile_commands.json можно запустить анализ следующими командами:
pvs-studio-analyzer analyze -o /path/to/PVS-Studio.log \
-e /path/to/exclude-path \
-j<N>
plog-converter -a GA:1,2 \
-t json \
-o /path/to/Analysis_Report.json \
/path/to/PVS-Studio.logРежим analyze предполагает наличие файлов strace_out или compile_commands.json в текущем рабочем каталоге. Можно явно указать расположение одного из этих файлов при помощи флага --file (-f).
Предупреждения анализатора будут сохранены в указанный Analysis_Report.json файл. Разные способы просмотра и фильтрации полученного отчёта приведены в разделе "Просмотр и фильтрация отчёта анализатора".
В этом сценарии компиляторы могут иметь специальные имена, и анализатор не сможет их распознать. Для проверки такого проекта необходимо явно указать имена компиляторов без путей:
pvs-studio-analyzer analyze ... --compiler COMPILER_NAME \
--compiler gcc --compiler g++ --compiler COMPILER_NAME
plog-converter ...Обычно кросс-компиляторы распространяются вместе со своими реализациями стандартной библиотеки, которые находятся не по стандартным путям. Анализатор старается обнаружить их автоматически, однако, если этого не произошло и в отчёте содержатся предупреждения на эти файлы, исключите такие директории из анализа с помощью флага -e:
pvs-studio-analyzer ... -e /path/to/exclude-path ...Если pvs-studio-analyzer неправильно определяет тип кросс-компилятора и, как следствие, неправильно запускает препроцессор, попробуйте явно указать его через этот флаг:
pvs-studio-analyzer analyze ... --compiler CustomCompiler=gccТеперь pvs-studio-analyzer запустит CustomCompiler с флагами препроцессирования gcc. Подробнее об этом можно прочитать в документации.
Важно. При интеграции анализатора в сборочную систему проблем с кросс-компиляторами не возникает.
Вы можете передавать response-файлы в pvs-studio-analyzer. Response-файл — это файл, содержащий аргументы командной строки.
Response-файл можно передать через параметр командной строки, который начинается с символа @. После следует путь до response-файла, например, @/path/to/file.rsp. Аргументы в response-файле разделены пробелами, табуляцией или переносами строк. Если вы хотите передать аргумент, который содержит пробельный символ, то экранируйте этот символ с помощью обратного слэша \ или оберните весь аргумент в одинарные '' или двойные "" кавычки. Однако кавычки внутри кавычек экранировать нельзя. Разницы между одинарными и двойными кавычками нет. Обратите внимание, что аргументы передаются без изменений: подстановок значений переменных среды и раскрытия glob не происходит. Рекурсивные response-файлы также поддерживаются.
Для утилиты pvs-studio-analyzer доступен режим инкрементального анализа, т.е. анализ только изменённых файлов. Для этого запустите утилиту с параметром --incremental:
pvs-studio-analyzer analyze ... --incremental ...Этот режим работает независимо от инкрементальной сборки проекта, т.е. если ваш проект полностью скомпилирован, то первый запуск инкрементального анализа всё равно будет анализировать все файлы. При следующем запуске будут анализироваться только изменённые.
Для отслеживания изменённых файлов, анализатор сохраняет служебную информацию в каталоге с именем .PVS-Studio в директории запуска. Поэтому для использования этого режима необходимо всегда запускать анализатор в одной и той же директории.
Утилита pvs-studio-analyzer поддерживает режим анализа списка файлов, при помощи которого можно настроить анализатор для проверки коммитов и pull requests. Для анализа запустите утилиту с параметром --source-files или -S и укажите путь к файлу со списком исходных файлов для анализа:
pvs-studio-analyzer analyze ... -S source_file_list ...Более подробно изучить анализ списков файлов можно в документации.
Тестовые проекты доступны в официальном репозитории PVS-Studio на GitHub:
На рисунке 1 представлен пример просмотра предупреждений анализатора в CLion (подробнее здесь):
Рисунок 1 — Просмотр предупреждений PVS-Studio в CLion
На рисунке 2 представлен пример просмотра предупреждений анализатора в Qt Creator:
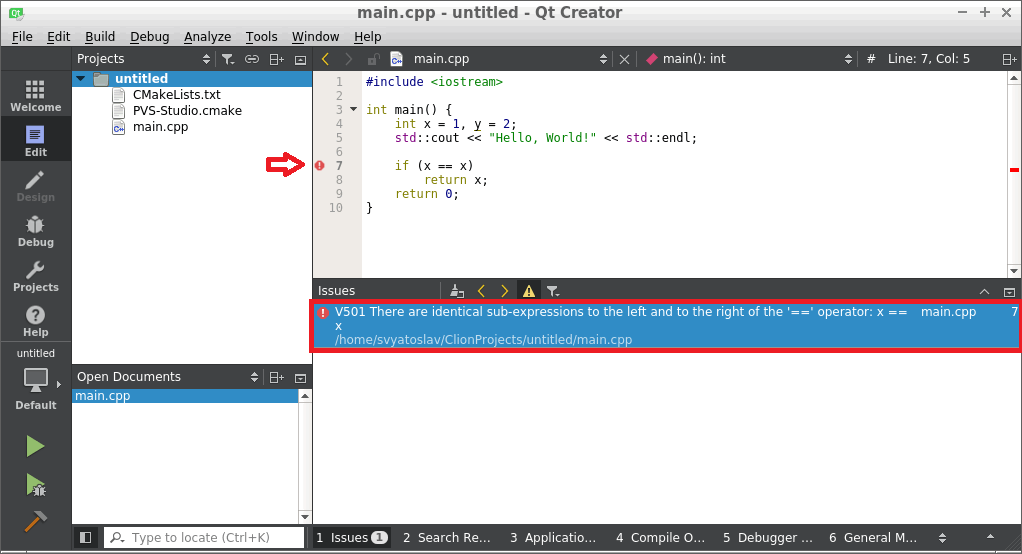
Рисунок 2 — Просмотр предупреждений PVS-Studio в Qt Creator
Вы можете ознакомиться с инструкция по проверке CMake проектов в среде Qt Creator в документации. "Интеграция с Qt Creator без использования плагина PVS-Studio".
Для Qt Creator существует расширение PVS-Studio, подробнее о нём можно прочитать в документации.
Анализатор проверяет не исходные файлы, а препроцессированные файлы. Такой способ позволяет проводить более глубокий и качественный анализ исходного кода.
В связи с этим действуют ограничения на передаваемые параметры компиляции. К ним относятся параметры, мешающие запуску компилятора в режиме препроцессора или искажающие его вывод. Например, ряд флагов оптимизации и отладки — такие как -O2, -O3, -g3, -ggdb3 и другие — могут нарушить вывод препроцессора. При обнаружении недопустимых параметров анализатор выдаст соответствующее предупреждение.
Необязательно изменять настройки проверяемого проекта, но для правильного запуска анализатора некоторые параметры необходимо исключить.
При интеграции анализатора в сборочную систему передайте ему конфигурационный файл с настройками (*.cfg). Имя файла может быть произвольным, и его необходимо передать с флагом --cfg.
В конфигурационном файле можно установить следующие настройки:
exclude-path (опциональный) — задаёт директорию, файлы из которой не нужно проверять. Обычно это каталоги системных файлов или подключаемых библиотек. Параметр exclude-path можно указывать несколько раз;analysis-paths (опциональный) — определяет поведение анализа на указанных путях. Доступны следующие режимы:skip-analysis задаёт директорию, файлы из которой не нужно проверять. Обычно это каталоги системных файлов или подключаемых библиотек;skip-settings игнорирует настройки, расположенные в исходных файлах и файлах .pvsconfig по указанному пути;skip игнорирует настройки, расположенные в исходных файлах и файлах; .pvsconfig по указанному пути. Также будут отфильтрованы предупреждения, сгенерированные для файлов исходного кода по указанному пути или маске.platform (обязательный) — задаёт используемую платформу. Возможные варианты: linux32 или linux64;preprocessor (обязательный) — задаёт используемый препроцессор. Возможные варианты: gcc, clang, keil;language (обязательный) — задаёт язык проверяемого файла, который анализатор ожидает увидеть в файле, предоставленном через --source-file. Возможные значения: C, C++. Поскольку поддерживаемые языковые диалекты содержат специфические ключевые слова, неправильное указание этого параметра может привести к ошибкам разбора кода V001;lic-file (опциональный) — содержит абсолютный путь к файлу с лицензией;analysis-mode (опциональный) — задаёт тип выдаваемых предупреждений. Рекомендуется использовать значение 4 (General Analysis), подходящее большинству пользователей;output-file (опциональный) — задаёт полный путь к файлу, в который будет записываться отчёт работы анализатора. При отсутствии этого параметра в конфигурационном файле все сообщения о найденных ошибках будут выводиться в консоль;sourcetree-root (опциональный) — задаёт корневую часть пути, которую анализатор автоматически поменяет на специальный маркер. По умолчанию при генерации предупреждений PVS-Studio выдаёт полные и абсолютные пути до файлов, в которых анализатор нашёл ошибки. Например, абсолютный путь до файла /home/project/main.cpp — заменяет относительный путь |?|/main.cpp, если /home/project был указан в качестве корня;source-file (обязательный) — содержит абсолютный путь до проверяемого исходного файла;i-file (обязательный) — содержит абсолютный путь до препроцессированного файла;no-noise (опциональный) — отключает вывод предупреждений низкого уровня достоверности (уровень 3). При работе на больших проектах анализатор может выдать большое число предупреждений. Используйте эту настройку, если вы не планируете исправить все сообщения сразу и хотите сконцентрироваться на исправлении наиболее важных срабатываний.Необязательно создавать новый конфигурационный файл для проверки каждого файла. В него достаточно сохранить постоянные настройки, например, lic-file и т.п.
Любой из перечисленных способов интеграции анализатора в сборочную систему можно автоматизировать в системе Continuous Integration, например, в Jenkins, TeamCity и других инструментах, настроив автоматический запуск анализа и уведомление о найденных ошибках.
Также возможна интеграция с платформой непрерывного анализа SonarQube с помощью плагина PVS-Studio. Более подробная информация о нём доступна на этой странице.
Результаты анализа PVS-Studio можно загружать в DevSecOps-платформы DefectDojo, SonarQube, CodeChecker, AppSec.Hub, Hexway и Securitm, преобразовав в специальный формат. Подробнее об интеграции отчётов можно прочесть в документации.
Для конвертации отчёта анализатора в различные форматы (*.xml, *.tasks и т.п.) можно воспользоваться утилитой с открытым исходным кодом Plog Converter. Подробнее об утилите можно прочесть в документации.
Для просмотра отчёта анализатора можно воспользоваться плагином Qt Creator. Подробнее о плагине для Qt Creator можно прочитать в документации.
Пример команды, которая подойдёт большинству пользователей для открытия отчёта в Qt Creator:
plog-converter -a GA:1,2 -t tasklist \
-o /path/to/project.tasks \
/path/to/project.logНа рисунке 3 представлен пример просмотра .tasks файла в Qt Creator:
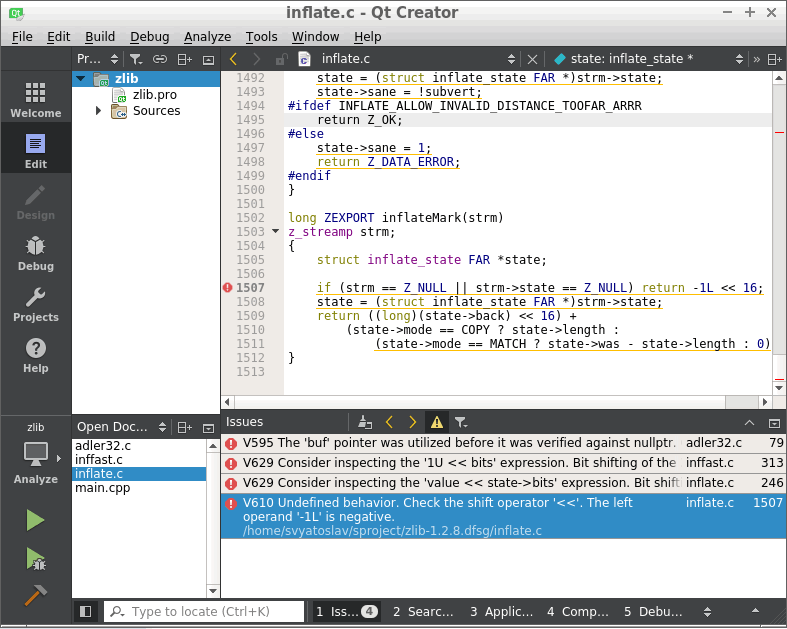
Рисунок 3 — Просмотр .tasks файла в Qt Creator
Конвертер отчётов анализатора позволяет генерировать HTML-отчёт двух видов:
1. FullHtml — полноценный отчёт для просмотра результатов анализа. Он поддерживает поиск и сортировку предупреждений по типу, файлу, уровню, коду и сообщению предупреждения. Особенностью этого отчёта является возможность навигации к месту ошибки в файле с исходным кодом. Сами файлы с исходным кодом, содержащие предупреждения анализатора, копируются в HTML и становятся частью отчёта. Примеры отчёта приведены на рисунках 4–5.
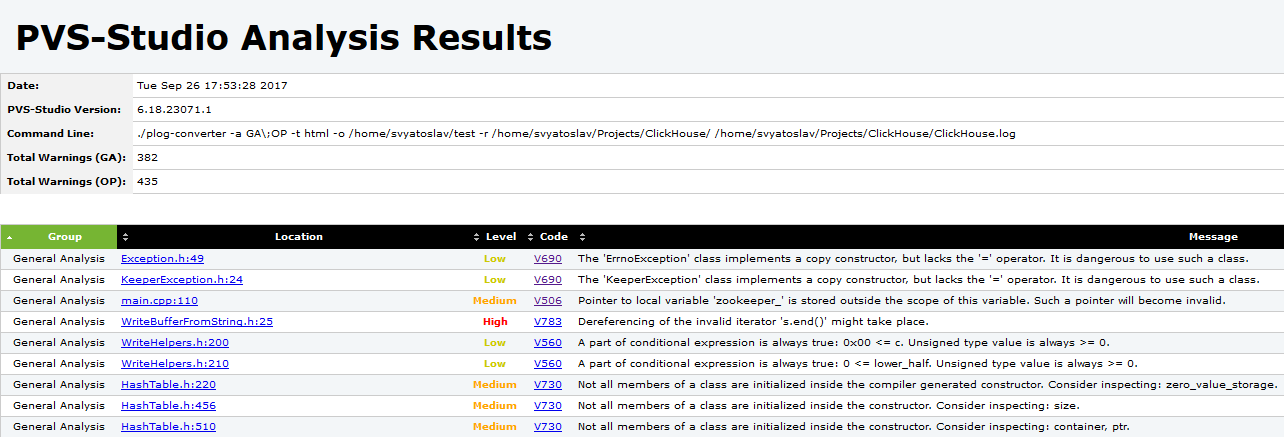
Рисунок 4 — Пример главной страницы HTML-отчёта
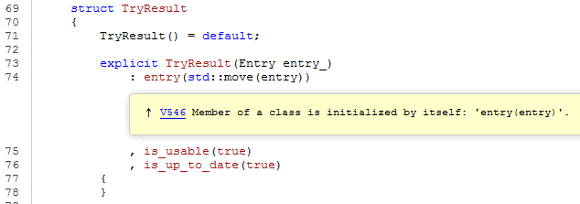
Рисунок 5 — Просмотр предупреждения в коде
Пример команды для получения отчёта:
plog-converter -a GA:1,2 -t fullhtml \
-o /path/to/report_dir \
/path/to/project.logТакой отчёт удобно рассылать в архиве или предоставлять к нему доступ по локальной сети с помощью любого веб-сервера, например, Lighttpd.
2. Html — упрощённый вариант предыдущего отчёта, состоящий из одного файла в формате .html. Содержит краткую информацию о найденных предупреждениях и подходит для уведомления о результатах по электронной почте. Пример отчёта приведен на рисунке 6.
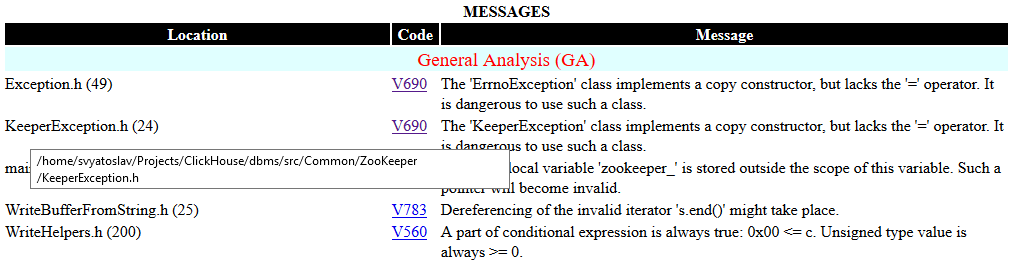
Рисунок 6 — Пример простой HTML-страницы
Пример команды для получения отчёта:
plog-converter -a GA:1,2 -t html \
-o /path/to/project.html \
/path/to/project.logПример команд для открытия отчёта в редакторе gVim:
plog-converter -a GA:1,2 \
-t errorfile \
-o /path/to/project.err \
/path/to/project.log
gvim /path/to/project.err
:set makeprg=cat\ %
:silent make
:cwНа рисунке 7 представлен пример просмотра файла .err в gVim:
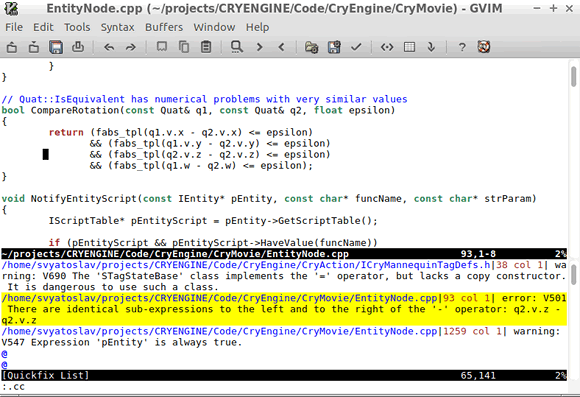
Рисунок 7 — Просмотр .err файла в gVim
Пример команд для открытия отчёта в редакторе Emacs:
plog-converter -a GA:1,2 \
-t errorfile \
-o /path/to/project.err \
/path/to/project.log
emacs
M-x compile
cat /path/to/project.err 2>&1На рисунке 8 представлен пример просмотра .err файла в Emacs:
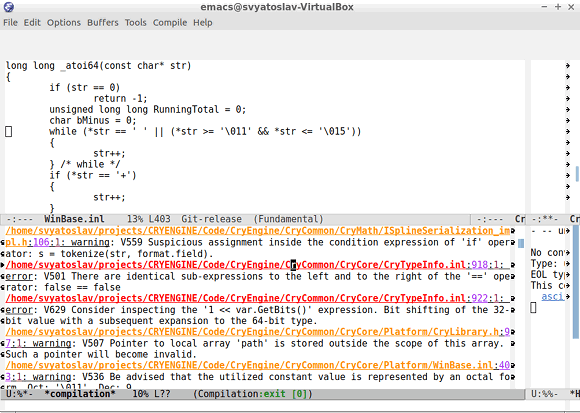
Рисунок 8 — Просмотр .err файла в Emacs
Пример команд для конвертации отчёта в CSV формат:
plog-converter -a GA:1,2 \
-t csv \
-o /path/to/project.csv \
/path/to/project.logПосле открытия файла project.csv в LibreOffice Calc добавьте автофильтр Menu Bar > Data > AutoFilter. На рисунке 9 представлен пример файла .csv в LibreOffice Calc:
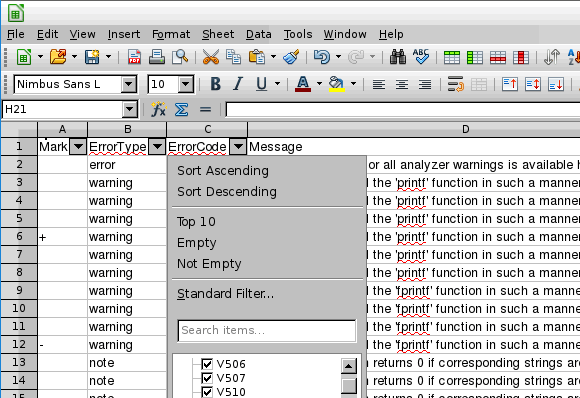
Рисунок 9 — Просмотр .csv файла в LibreOffice Calc
Утилита blame-notifier предназначена для автоматизации оповещения разработчиков, заложивших в репозиторий код, на который PVS-Studio выдал предупреждения. Принцип её работы заключается в следующем:
blame-notifier с указанием дополнительных параметров;Также возможна рассылка полного отчёта, содержащего все предупреждения, сгруппированные по авторам.
Способы установки и использования утилиты описаны в соответствующем разделе документации: "Оповещение команд разработчиков (утилита blame-notifier)".
Массовое подавление предупреждений позволяет легко внедрить анализатор в любой проект и сразу начать находить новые ошибки. Механизм позволяет отложить исправление предупреждений, чтобы не мешать текущей работе.
Есть несколько способов использования этого механизма в зависимости от варианта интеграции анализатора. Подробнее о том, как использовать механизм подавления в pvs-studio-analyzer можно узнать в документации.
Прямая интеграция анализатора может выглядеть следующим образом:
.cpp.o:
$(CXX) $(CFLAGS) $(DFLAGS) $(INCLUDES) $< -o $@
$(CXX) $(CFLAGS) $< $(DFLAGS) $(INCLUDES) -E -o $@.PVS-Studio.i
pvs-studio --cfg $(PVS_CFG) --source-file $< --i-file $@.PVS-Studio.i
--output-file $@.PVS-Studio.logВ этом режиме анализатор не может одновременно проверять исходные файлы и фильтровать их. Поэтому для фильтрации и подавления предупреждений потребуются дополнительные команды.
Для подавления всех предупреждений анализатора выполните команду:
pvs-studio-analyzer suppress /path/to/report.logДля фильтрации нового лога воспользуйтесь следующими командами:
pvs-studio-analyzer filter-suppressed /path/to/report.log
plog-converter ...Файл с подавленными предупреждениями имеет имя по умолчанию suppress_file.suppress.json, однако при необходимости можно задать произвольное имя.
1. Утилита strace выдаёт сообщение вида:
strace: invalid option -- 'y'Обновите программу strace до минимально поддерживаемой версии 4.7. Поскольку анализ проекта без интеграции в сборочную систему представляет собой сложную задачу, данная опция помогает анализатору извлечь важную информацию о компиляции.
2. Утилита strace выдаёт сообщение вида:
strace: umovestr: short read (512 < 2049) @0x7ffe...: Bad addressТакие ошибки возникают в системных процессах и на сборку/анализ проекта не влияют.
3. Утилита pvs-studio-analyzer выдаёт сообщение вида:
No compilation units foundАнализатору не удалось обнаружить файлы для анализа. Возможно, вы используете кросс-компиляторы для сборки проекта. Подробнее об этом можете прочитать в этом разделе.
Другой возможный сценарий заключается в том, что режим трассировки запускается на собранном проекте. Это может привести к тому, что файл strace_out будет пустой. Тогда необходимо очистить проект перед его сборкой и запустить режим трассировки снова.
4. Отчёт анализатора состоит из подобных строк:
r-vUVbw<6y|D3 h22y|D3xJGy|D3pzp(=a'(ah9f(ah9fJ}*wJ}*}x(->'2h_u(ahАнализатор сохраняет отчёт в промежуточном формате. Для просмотра отчёта его необходимо преобразовать в легкочитаемый формат с помощью утилиты plog-converter, которая устанавливается вместе с анализатором.
5. Анализатор выдаёт ошибку:
Incorrect parameter syntax:
The ... parameter does not support multiple instances.При вызове анализатора какой-то из параметров задали несколько раз.
Такое может возникнуть, если часть параметров анализатора определили в конфигурационном файле, а другая часть — передана через командную строку, что может привести к случайному повторному определению какого-либо параметра.
При использовании утилиты pvs-studio-analyzer почти все параметры определяются автоматически, поэтому она может работать без конфигурационного файла. Дублирование таких параметров тоже может приводить к такой ошибке.
6. Анализатор выдаёт предупреждение:
V001 A code fragment from 'path/to/file' cannot be analyzed.Если анализатору не удаётся обработать какой-нибудь фрагмент кода, он пропускает его и выводит предупреждение V001. Обычно это не влияет на анализ других частей кода, но если проблемный фрагмент находится в заголовочном файле, количество таких предупреждений может значительно возрасти. Для исправления проблемы пришлите нам препроцессированный (*.PVS-Studio.i) и конфигурационный (*.PVS-Studio.cfg) файлы для проблемного файла с исходным кодом через форму обратной связи.
Для удобного просмотра результатов анализа можно использовать расширение (плагин) PVS‑Studio для Qt Creator. Подробнее про его установку и использование описано в документации "Использование расширения PVS‑Studio для Qt Creator".
Проанализировать такие проекты можно через встроенный механизм генерации файла compile_commands.json.
Анализатор PVS-Studio может быть использован для анализа CMake проектов в среде Qt Creator.
Важно. Перед использованием CMake-модуля необходимо ввести лицензию PVS-Studio при помощи специальных команд для Windows и Linux/macOS.
Затем добавьте к вашему проекту CMake-модуль PVS-Studio. После чего добавьте код для создания цели анализа в файл CMakeLists.txt вашего проекта:
include(PVS-Studio.cmake)
pvs_studio_add_target(TARGET ${PROJECT_NAME}.analyze ALL
OUTPUT
FORMAT errorfile
ANALYZE ${PROJECT_NAME}
MODE GA:1,2
LOG ${PROJECT_NAME}.log
ARGS -e C:/Qt/
HIDE_HELP)По умолчанию, при открытии CMakeLists.txt проекта, Qt Creator скрывает дополнительные цели сборки. Чтобы их отобразить, отключите опцию 'Hide Generated Files' в фильтрах обозревателя проекта:
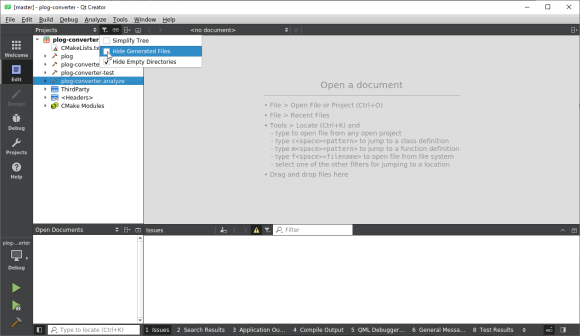
Для сборки и запуска анализа нажмите Build "ИмяПроекта.analyze" из контекстного меню цели анализа:
После завершения анализа найденные анализатором ошибки будут добавлены в панель 'Issues':
Если для сборки проектов под Windows вы используете набор инструментов MSVC, Qt Creator поменяет механизм разбора предупреждений на совместимый с выводом компиляторов Visual Studio. Этот формат вывода не совместим с форматами вывода PVS-Studio, в результате сообщения анализатора не появятся в панели 'Issues'. Чтобы настроить поддержку формата errorfile нужно выполнить следующие шаги:
2. В открывшемся окне нажмите на кнопку 'Add...'. В строках 'Error message capture pattern' вставьте следующие регулярные выражения:
Во вкладке Error
(.*):(\d+): error: (.*)Во вкладке Warning
(.*):(\d+): warning: (.*)Либо, если нужно отображение предупреждений низкого уровня
(.*):(\d+): (?:warning|note): (.*)
3. После настройки регулярный выражений нажмите 'Ok'. Выберите новый парсер и перезапустите анализ.
В результате предупреждения анализатора появятся в панели 'Issues'.
Плагин PVS-Studio для Qt Creator предоставляет удобный графический интерфейс для запуска анализа проектов и отдельных файлов, а также для работы с предупреждениями анализатора. Далее будут описаны установка, настройка и основные сценарии использования.
Для начала необходимо получить нужную версию расширения. Её можно найти в директории установки PVS-Studio.
Из-за ограничений интегрированной среды разработки Qt Creator, в ней могут быть запущены только те версии плагина, что были сделаны специально для неё. Список поддерживаемых версий IDE указан в таблице ниже:
|
Версия IDE Qt Creator |
Статус поддержки плагинов PVS-Studio |
|---|---|
|
8.0.x |
Поддержка окончена. Последняя доступная версия — 7.31 |
|
9.0.x |
Поддержка окончена. Последняя доступная версия — 7.34 |
|
10.0.x |
Поддержка окончена. Последняя доступная версия — 7.35 |
|
11.0.x |
Поддержка окончена. Последняя доступная версия — 7.37 |
|
12.0.x |
Поддержка окончена. Последняя доступная версия — 7.39 |
|
13.0.x |
Поддержка окончена. Последняя доступная версия — 7.41 |
|
14.0.x |
Поддержка окончена. Последняя доступная версия — 7.43 |
|
15.0.x |
Поддерживается |
|
16.0.x |
Поддерживается |
|
17.0.x |
Поддерживается |
|
18.0.x |
Поддерживается |
|
19.0.x |
Поддерживается |
|
20.0.x |
Поддерживается |
Символ 'х' в названии файла плагина означает, что на его месте может быть любая цифра. То есть поддержка версии 9.0.х означает, что работоспособность плагина проверена на версиях 9.0.0, 9.0.1 и 9.0.2.
Целевая версия Qt Creator и платформа указаны в названии архива плагина. Например, 'pvs-studio-qtcreator-11.0.x-7.25.73595.503.windows.zip' или 'libpvs-studio-qtcreator-11.0.x-7.25.73595.503.linux.tar.gz'.
В таблице ниже указаны совместимые специализированные версии Qt Creator, для которых есть собственные версии плагина PVS-Studio. Они несовместимы с официальными версиями Qt Creator, на основе которых они были созданы, но функционально они эквивалентны.
|
Версия IDE Qt Creator |
Статус поддержки плагинов PVS-Studio |
|---|---|
|
6.0.x (редакция КПДА) |
Поддерживается |
Файл архива плагина для Qt Creator в редакции КПДА (Комплект разработчика ЗОСРВ "Нейтрино") можно определить по суффиксу qt5-neutrino в его названии, например, 'libpvs-studio-qtcreator-6.0.x-qt5-neutrino-7.38.96564.1478.windows.zip'.
Примечание. В Qt Creator версии 15.0.0 возникает проблема при установке плагинов для конкретного пользователя с помощью мастера установки. Путь, по которому устанавливаются плагины, не совпадает с путём, по которому эти плагины ищутся. Данная проблема исправлена с версии 15.0.1.
Чтобы установить расширение PVS-Studio откройте Qt Creator и выберите в строке меню пункт 'Help' -> 'About Plugins':
Нажмите кнопку 'Install Plugin...':
В появившемся мастере установки укажите местоположение архива плагина (с расширением '.zip' или '.tar.gz' в зависимости от платформы).
Замечание: не нужно распаковывать архив с плагином перед установкой. Мастер установки плагинов QtCreator заявляет, что поддерживает установку плагинов напрямую, но на практике этот способ часто приводит к сбоям. Поэтому мы советуем устанавливать плагины, не извлекая из архивов.
Далее мастер установки спросит место для установки плагина. Выберите подходящий вам вариант, нажмите далее и подтвердите установку.
Замечание: для установки в "Qt Creator installation" могут потребоваться права администратора. В противном случае будет выдана ошибка об отсутствии прав для записи файла.
По окончанию установки плагина не будет выдано никакого окна подтверждения. Сразу после закрытия мастера установки плагинов нужно нажать кнопку "ОК". В таком случае появится сообщение о том, что новые плагины будут доступны только после перезапуска QtCreator. Соглашаемся, и IDE перезапустится автоматически.
В случае невозможности установки плагина с помощью мастера установки, можно воспользоваться ручной установкой. Для этого необходимо скопировать файл плагина (файл с расширением '.dll' или '.so' в зависимости от вашей платформы) в директорию с плагинами для Qt Creator. По умолчанию, Qt Creator ищет плагины в следующих директориях:
Windows:
%директория_установки_Qt%\Tools\QtCreator\lib\qtcreator\plugins
%APPDATA%\Local\QtProject\qtcreator\plugins\%версия_qt_creator%Linux:
/opt/Qt/Tools/QtCreator/lib/qtcreator/pluginsДанный способ можно использовать при невозможности установить плагин в стандартные директории. При запуске Qt Creator можно указать дополнительные директории для поиска плагинов с помощью флага '-pluginpath'.
Например, запуск IDE можно произвести с помощью следующей команды:
Для обновления плагина достаточно удалить файлы прошлых версий плагина и установить новую версию удобным для вас способом. Найти место расположения плагина можно, выбрав пункт 'Details' в списке установленных плагинов.
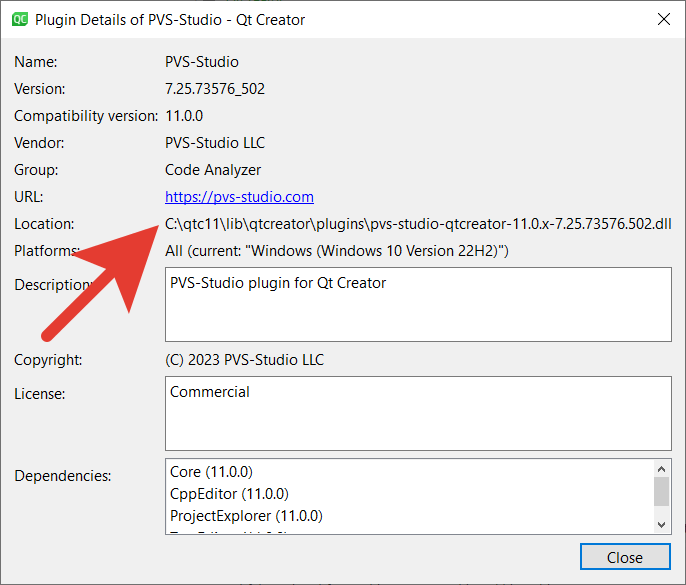
В случае, если при запуске Qt Creator появляется сообщение, что плагин PVS-Studio не может быть загружен, т.к. не найдены подходящие зависимости (например, как рисунке ниже), то необходимо проверить используемую версию плагина и Qt Creator. Используемую версию Qt Creator можно узнать в меню 'Help' -> 'About Qt Creator', а версия используемого плагина указана в названии его файла.
Так как Qt Creator не обладает системой обновления плагинов, то после очередного обновления плагина может появиться следующее окно.
Данное сообщение означает, что плагин обнаружил одновременное использование нескольких версий и автоматически выключил все версии, кроме самой последней. Крайне желательно удалить старые версии. Для вашего удобства в сообщении также перечислены все обнаруженные версии плагина и пути, где они расположены. Текущий активный плагин отмечен записью [Active].
Плагин PVS-Studio для IDE Qt Creator интегрируется в главное меню среды разработки и панель вывода.
В главном меню появляется дополнительный пункт в разделе 'Analyze', содержащий следующие пункты:
Check – подменю, позволяющее запустить анализ;
Analysis after Build – быстрый доступ к настройке для активации инкрементального анализа;
Open/Save – подменю, позволяющее загружать и сохранять отчёты;
Recent Reports – хранит список последних открытых отчётов для их быстрой загрузки. Клик по пункту меню инициирует загрузку выбранного файла;
Help – подменю, содержащее в себе ссылки на документацию и наиболее важные разделы сайта анализатора;
Options – открывает настройки IDE Qt Creator в разделе PVS-Studio.
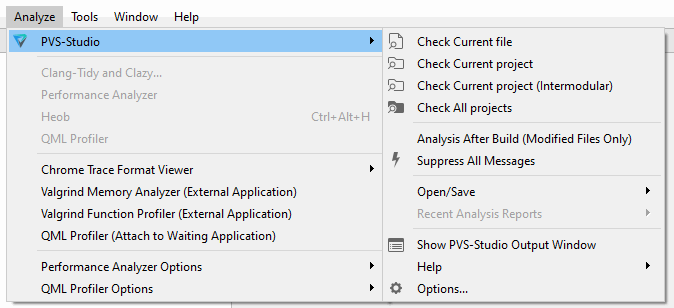
В области вывода появляется дополнительная панель с именем 'PVS-Studio'.
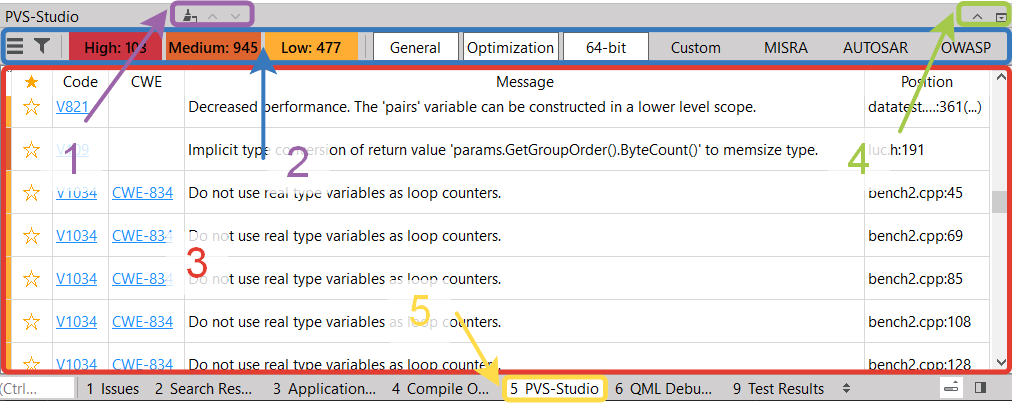
Панель вывода PVS-Studio состоит из следующих элементов:
1 – панель управления отчётом. Первая кнопка позволяет очистить текущую таблицу, предупреждений, а две другие (со стрелочками) позволяют перемещаться между позициями в таблице. Обратите внимание, что навигация будет производиться именно между позициями (т.е. будут открываться указанные в предупреждениях файлы), а не просто строками таблицы.
2 – панель быстрых фильтров. Содержит кнопки показа дополнительного меню, показа расширенных фильтров, а также переключатели отображаемых уровней и категорий предупреждений. При клике по кнопке дополнительного меню появляется всплывающее меню со следующими пунктами:
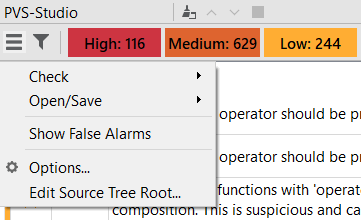
3 – основная область просмотра. Целиком состоит из таблицы предупреждений. Подробно этот элемент будет рассмотрен позже.
4 – элементы управления панелью. Первая кнопка позволяет развернуть область просмотра по высоте, а вторая – скрыть панель.
5 – кнопка для показа панели PVS-Studio.
Интеграция в настройки состоит из добавления нового раздела "PVS-Studio" в список уже существующих разделов.
Раздел настроек PVS-Studio разделён на 5 разделов (по вкладке на каждый). Более подробно о назначении каждого раздела и настроек, входящих в них, описано в разделе "Конфигурация плагина".
Плагин поддерживает анализ проектов, их частей, а также отдельных файлов. На данный момент поддерживаются следующие типы проектов:
Запуск анализа можно произвести несколькими способами:
При запуске любым из перечисленных способов в области уведомлений появится окно с прогрессом анализа, а в таблице, по мере поступления, начнут появляться предупреждения анализатора. Остановить уже запущенный процесс анализа можно с помощью специальной кнопки в заголовке панели вывода или с помощью "крестика", который находится в конце прогресс-бара уведомления (виден только при наведении курсора на прогресс-бар).
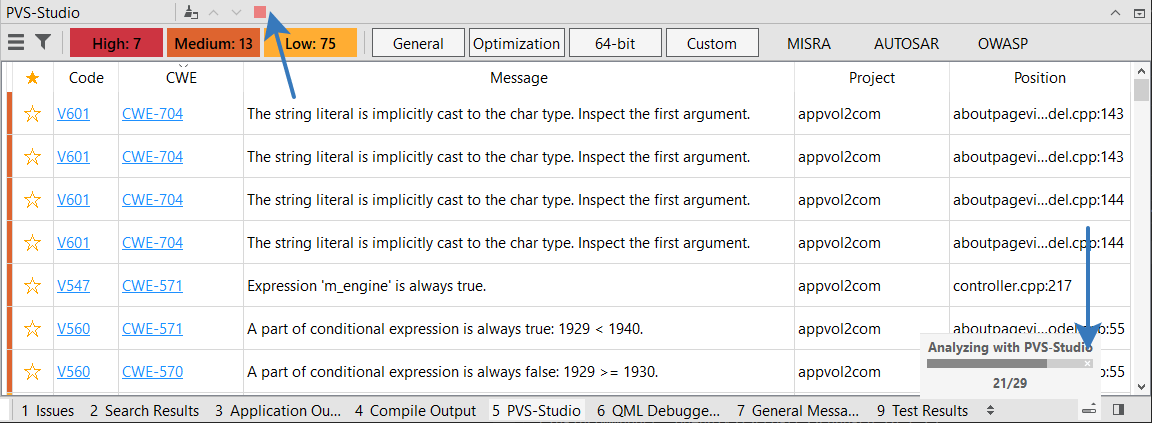
При запуске анализа также проверяется содержимое папки '.PVS-Studio' в директории исходного кода проекта. Если в ней будут найдены пользовательские файлы конфигурации (с расширением *.pvsconfig) или suppress-файлы (с суффиксом *.suppress.json), то они будут переданы анализатору для дальнейшей обработки.
Внимание: на данный момент плагин PVS-Studio для Qt Creator поддерживает работу только с одним suppress-файлом. Если при запуске будет найдено несколько файлов, то в отчёте появится соответствующая запись. В ней также будет указано, какой файл используется при анализе.
В случае каких-либо проблем с запуском будет выведено всплывающее окно с подробным описанием проблемы.
В плагине реализована поддержка инкрементального анализа. В этом режиме после каждой успешной сборки проекта будет автоматически запускаться его анализ. Однако проанализированы будут только те файлы, что изменились с момента прошлого запуска анализатора. Подробнее о режиме инкрементального анализа можно узнать в отдельной документации.
Активировать инкрементальный анализ можно в настройках плагина (General->Incremental analysis) или с помощью пункта меню 'Analysis after Build' в подменю PVS-Studio главного окна.
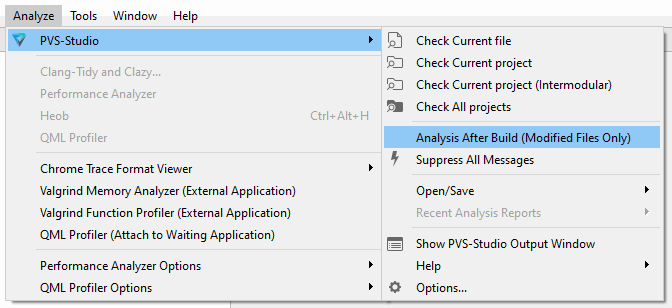
Также в плагине доступен режим межмодульного анализа. Под межмодульным анализом в PVS-Studio понимается расширение возможностей межпроцедурного анализа на функции, объявленные в единицах трансляции, отличных от той, к которой относится текущий проверяемый файл. Более подробную информацию о том, что такое межмодульный анализ и чем он может быть полезен, можно найти в документации.
Для запуска межмодульного анализа необходимо выбрать пункт 'Analyze with PVS-Studio (Intermodular)' в контекстном меню проекта верхнего уровня. Межмодульный анализ отдельных частей проекта невозможен.
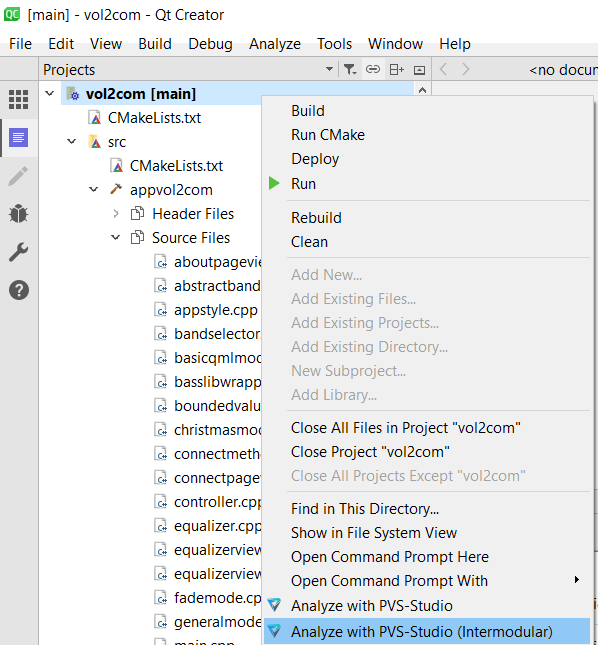
Обратите внимание: расширение PVS-Studio для Qt Creator поддерживает только отчёты в формате JSON. Для отображения отчёта в другом формате вам потребуется выполнить его преобразование в JSON-формат.
Для преобразования можно воспользоваться утилитами командной строки PlogConverter.exe для Windows и plog-converter для Linux / macOS. Эти утилиты позволяют не только конвертировать отчёт PVS-Studio в разные форматы, но и дополнительно обрабатывать его. Например, проводить фильтрацию предупреждений. Подробнее о них можно прочитать здесь.
Пример команды конвертации отчёта PVS-Studio в JSON-формат при помощи PlogConverter.exe (Windows):
PlogConverter.exe path\to\report.plog -t json ^
-n PVS-StudioПример команды конвертации отчёта PVS-Studio в JSON-формат при помощи plog-converter (Linux и macOS):
plog-converter path/to/report/file.json -t json \
-o PVS-Studio.jsonВ случае если у вас уже есть готовый отчёт анализатора, и вы хотите посмотреть его в Qt Creator, то откройте панель PVS-Studio, нажмите на кнопку меню и выберите пункт 'Open/Save -> Open Report...':
Также отчёт может быть открыт с помощью пункта меню 'Analyze -> PVS-Studio -> Open/Save -> Open Report...':
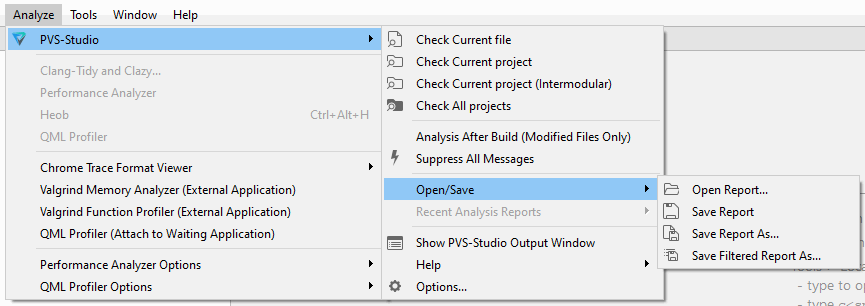
После выбора и загрузки отчёта появится область просмотра предупреждений, а сами предупреждения отобразятся в таблице:
Окно вывода результатов PVS-Studio в первую очередь предназначено для упрощения навигации по коду проекта и переходу к участкам кода, содержащим потенциальные ошибки. Двойной клик по предупреждению в таблице автоматически откроет позицию (файл и строку), на которую оно выдано.
Клик левой кнопкой мыши по заголовку таблицы сортирует содержимое по выбранному столбцу.
Клик правой кнопкой мыши по заголовку таблицы открывает всплывающее меню, с помощью которого можно скрыть/отобразить дополнительные столбцы, а также активировать отображение полных путей до файлов в столбце позиций.
В таблице предупреждений поддерживается множественный выбор. Для его активации можно использовать протяжку с зажатой левой кнопкой мыши, а также привычные сочетания клавиш:
Примечание: практически все элементы в плагине имеют всплывающие подсказки. Для их активации достаточно задержать курсор мыши над элементом на пару секунд.
Level – неименованный первый столбец, отображает соответствие между уровнем предупреждения и цветом (в порядке убывания важности/достоверности): красный – 1 уровень, оранжевый – 2 уровень, жёлтый – 3 уровень.
Star – показывает, отмечено ли срабатывание как избранное. Клик по ячейке в этом столбце устанавливает/снимает отметку "избранное" с соответствующего предупреждения. Полезно для выделения интересных предупреждений, например, тех, к которым имеет смысл вернуться позже.
ID – показывает порядковый номер предупреждения в отчёте. Полезно при необходимости отсортировать отчёт в порядке получения предупреждений от анализатора.
Code – указывает к какой диагностике относится те или иные предупреждения. Клик по значению в данном столбце открывает документацию по соответствующей диагностике.
CWE – отображает соответствие предупреждения согласно классификации CWE. Клик по значениям в данном столбце открывает документацию с описанием соответствующего недостатка безопасности.
SAST – отображает соответствие предупреждения согласно различным стандартам защищённости или безопасности, например, SEI CERT, MISRA, AUTOSAR, и т.д.
Message – текст предупреждения, выданного анализатором.
Project – содержит название проекта, анализ которого привёл к выдаче предупреждения.
Position – показывает позицию (имя файла и строка через двоеточие), к которой относится срабатывание. В случае необходимости отобразить полный путь до файла – необходимо кликнуть правой кнопкой мыши по заголовку таблицы и выбрать пункт 'Show full path to file'. Если предупреждение анализатора содержит сразу несколько позиций, то в его конце появляется метка (...). В таком случае при клике в столбце позиции появится список со всеми дополнительными позициями.
FA – показывает, установлена ли для предупреждения отметка ложного срабатывания.
Примечание: некоторые столбцы могут быть скрыты по умолчанию. Для их отображения /скрытия необходимо кликнуть правой кнопкой мыши по заголовку таблицы и в появившемся меню выбрать пункт 'Show Columns', а в нем столбец, который вас интересует.
При клике на каком-либо предупреждении правой кнопкой мыши появляется всплывающее меню с перечнем доступных дополнительных действий:
Меню 'Mark As' – содержит команды для быстрой установки/снятия отметок с выбранных предупреждений. На данный момент доступны отметки предупреждений как избранные и ложные. Обратите внимание, что содержимое этого меню меняется в зависимости от состояния выбранных на данный момент предупреждений.
'Suppress selected messages' – позволяет подавить текущие выбранные предупреждения в файл подавления. Подробнее о подавлении предупреждений написано в пункте "Подавление предупреждений".
Меню 'Copy to clipboard' – позволяет скопировать информацию о выбранных предупреждениях. Содержит несколько подпунктов:
'Hide all %N errors' – позволяет скрыть из отчёта все предупреждения, относящиеся к данной диагностике. При клике появляется всплывающее меню для подтверждения операции. В случае положительного выбора сообщения будут отфильтрованы мгновенно.
'Don't check files from' – подменю, содержащее части пути до файла позиции. Используется, если вам необходимо скрыть из отчёта все срабатывания, полученные на файлы из выбранной директории. При выборе какого-либо значения появится всплывающее окно для подтверждения фильтрации и описанием как её отключить в будущем:
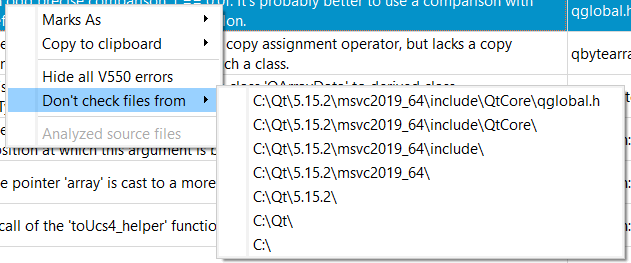
Меню 'Analyzed source files' – содержит список файлов, анализ которых привёл к появлению данного предупреждения. Полезно при выдаче срабатывания на заголовочных файлах.
Механизмы фильтрации окна вывода PVS-Studio позволяют быстро найти и отобразить как отдельные диагностические сообщения, так и целые их группы.
Все перечисленные ниже механизмы фильтрации предупреждений (быстрые и расширенные фильтры) можно совмещать между собой одновременно, а также с сортировкой. Например, можно отфильтровать сообщения по уровню и группам отображаемых предупреждений, исключить все сообщения кроме тех, что содержат определённый текст и дополнительно отсортировать по позициям.
Панель инструментов содержит ряд переключателей, позволяющих включить либо отключить отображение предупреждений из соответствующих им групп. При изменении состава активных категорий также будут пересчитаны счётчики.
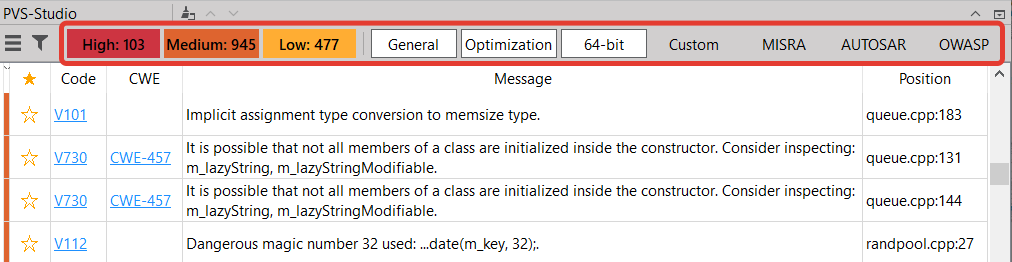
Примечание: переключатель группы 'Fails' отображается только при наличии ошибок от анализатора (их 'Code' начинается с V0..) в отчёте.
Детальное описание уровней достоверности предупреждений и групп диагностических правил приведено в разделе документации "Знакомство со статическим анализатором кода PVS-Studio".
Расширенные фильтры отображаются при нажатии кнопки 'Quick Filters'. Состояние панели дополнительных фильтров (показана/скрыта) не влияет на активные фильтры. Т.е. их можно скрыть и при этом фильтры не будут сброшены.
При её активации появляется дополнительная панель, которая содержит поля ввода для фильтрации всех столбцов таблицы, а также кнопка для быстрой очистки всех фильтров (Clear All).
После ввода текста в поля ввода необходимо нажать 'Enter' для активации фильтра. Обратите внимание, что некоторые поля поддерживают множественную фильтрацию (например, Code), о чём сообщается во всплывающей подсказке при наведении курсора мыши на поле ввода.
При первом запуске анализатора на большом проекте может быть действительно много срабатываний. Разумеется, стоит выписать себе самые интересные, а вот остальные можно скрыть при помощи механизма подавления предупреждений.
Для подавления всех предупреждений нужно выбрать пункт 'Suppress All Messages' в меню плагина:
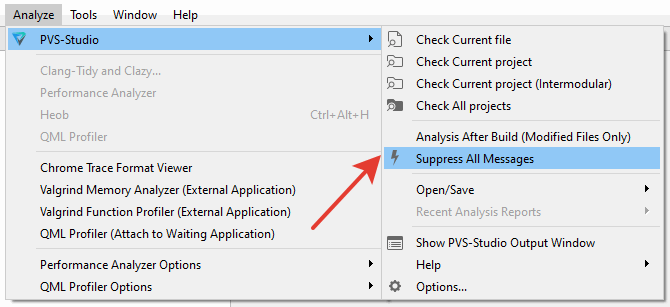
При его активации появится дополнительное окно с вопросом, какие именно предупреждения вы хотите подавить:
При выборе нужного пункта предупреждения будут подавлены в существующий файл подавления предупреждений. Если файл подавления предупреждений не будет найден, то будет создан в следующей директории: '%корневой_каталог_исходного_код_проекта%/.PVS-Studio'.
Если предложенный выше вариант вам не подходит, то можно воспользоваться точечным подавлением предупреждений. Для этого необходимо выбрать нужные строки в таблице, открыть контекстное меню и выбрать 'Add message to suppression file'.
В настройки плагина PVS-Studio для IDE Qt Creator можно попасть с помощью выбора раздела PVS-Studio в общем списке настроек или с помощью пунктов меню 'Options...' плагина.
Настройки плагина хранятся в файле 'qtcsettings.json', который расположен:
Все настройки плагина разделены на 5 вкладок:
Содержит основные настройки анализатора и плагина.
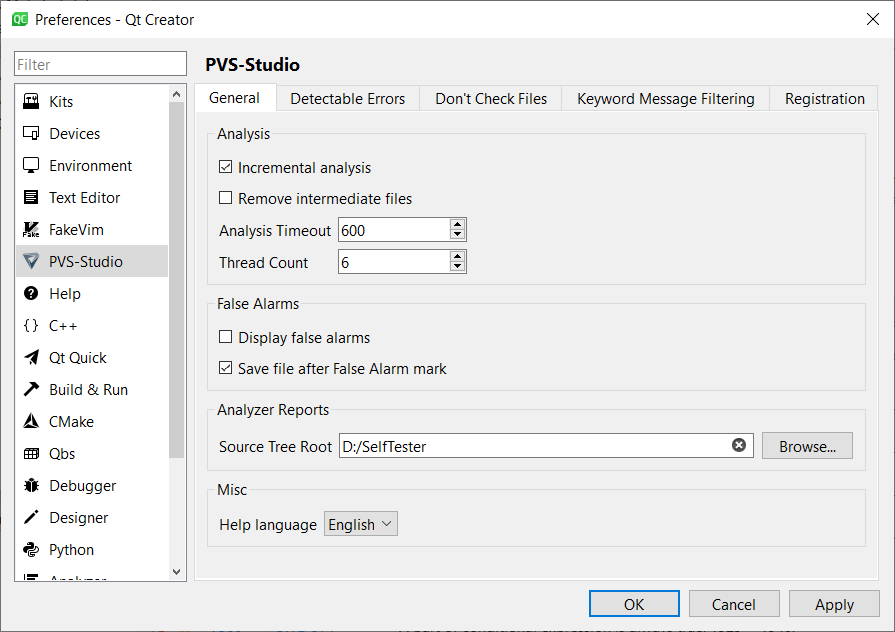
Incremental analysis – включает режим инкрементального запуска анализатора.
Remove intermediate files – автоматическое удаление временных файлов, создаваемых анализатором в процессе работы.
Analysis Timeout – позволяет задать временя (в секундах), после которого проверка текущего файла будет пропущена.
Thread Count – количество потоков, используемых при анализе. Указание большего значения может ускорить анализ, но также может привести к аварийному завершению работы анализатора в связи с нехваткой памяти. Оптимальное значение равно количеству физических ядер используемого процессора.
Display false alarms – включает/отключает отображение ложных срабатываний в отчёте. При активации появляется дополнительный столбец в таблице визуализации отчёта.
Save file after False Alarm mark – если активно, то сохраняет изменённый файл после вставки комментария ложного срабатывания.
Source Tree Root – содержит путь, который должен использоваться при открытии позиций, использующих относительные пути. Например, если в предупреждении записан относительный путь '\test\mylist.cpp', а настройка Source Tree Root содержит путь 'C:\dev\mylib', то при попытке перехода на позицию из предупреждения будет открыт файл 'C:\dev\mylib\test\mylist.cpp'.
Детальное описание использования относительных путей в файлах отчётов PVS-Studio смотрите здесь.
Help Language – указывает, на какой язык предпочтительно открывать документацию анализатора. Используется при переходе в документацию на сайте анализатора.
Данная вкладка содержит список и описание всех предупреждений анализатора, а также позволяет включать/выключать как отдельные диагностики, так и целые категории.
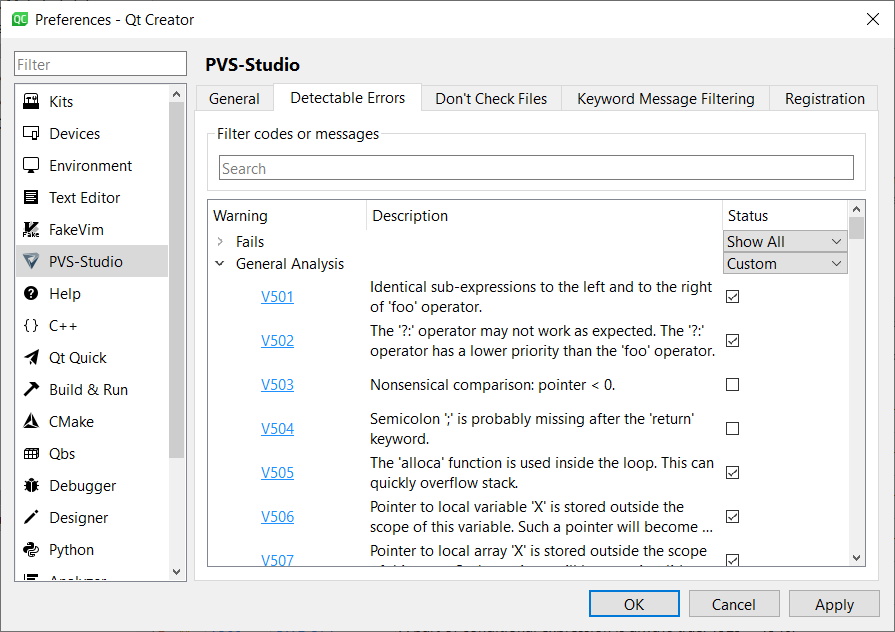
В верхней части окна доступен полнотекстовый поиск по описанию диагностики и её номеру. При клике на код диагностики открывается её документация. При наведении на текст появляется всплывающее сообщение с полным текстом. При нажатии 'OK' или 'Apply' происходит обновление таблицы предупреждений для соответствия текущим фильтрам.
Все диагностики сгруппированы в категории. Для них можно выставить следующие состояния:
Полный список диагностик всегда доступен в разделе "Сообщения PVS-Studio".
Содержит списки для фильтрации предупреждений по маскам имён файлов или путей. Если имя или путь будет удовлетворять хотя бы одной маске – он будет скрыт из отчёта.
Поддерживаются следующие символы подстановки:
* – любое количество любых символов
? – один любой символ
Для добавления записи необходимо нажать кнопку 'Add' и ввести текст в появившееся поле. Для удаления необходимо выбрать запись и нажать кнопку 'Remove'. Записи с пустыми полями будут удалены автоматически. Редактировать уже существующие записи можно при помощи двойного клика по ней или выбора и нажатия кнопки 'Edit'.
При нажатии кнопок 'OK' или 'Apply' происходит обновление таблицы предупреждений для соответствия текущим фильтрам.
Вкладка содержит редактор ключевых слов, предупреждения с которыми будут скрыты в отчётах. Ключевые слова из этого списка проверяются только по данным в столбце 'Message'.
Функция может быть полезна при необходимости скрыть предупреждения от определённой функции или класса, достаточно указать их здесь.
Вкладка содержит форму для ввода данных лицензии, которая будет использоваться при запуске анализатора. Процесс ввода лицензии в Qt Creator подробно описан в документации.
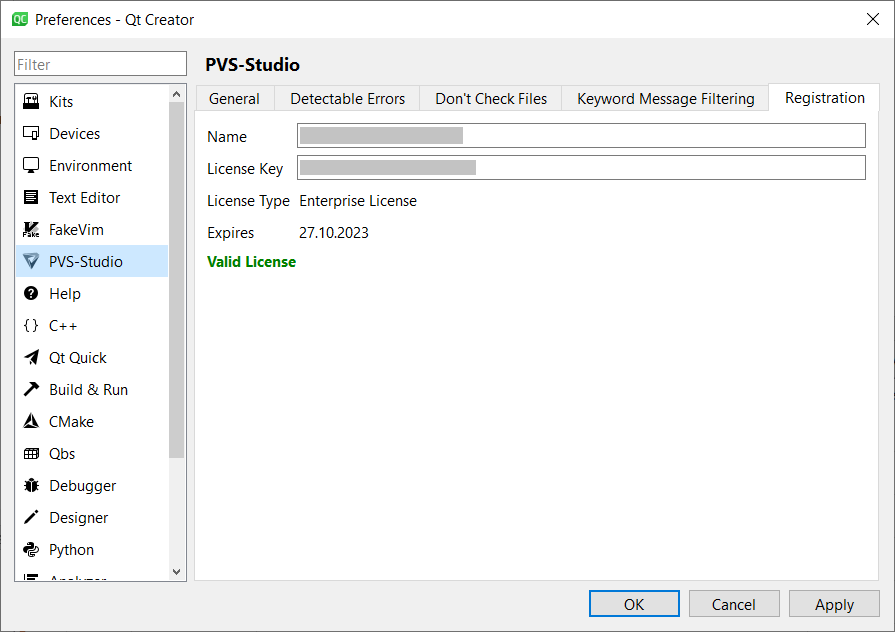
Использование горячих клавиш позволяет ускорить процесс обработки полученных результатов анализа. Их можно назначать/переопределять в настройках 'Options -> Environment -> Keyboard'. Чтобы быстрее их найти, необходимо ввести 'PVS-Studio' в поле поиска окна 'Keyboard Shortcuts'.
Одним из способов представления структуры C++ проекта является формат JSON Compilation Database. Это файл, в котором записаны параметры компиляции, необходимые для создания объектных файлов из исходного кода проекта. Обычно он имеет имя compile_commands.json. База данных компиляции в JSON-формате состоит из массива "командных объектов", где каждый объект определяет один из способов компиляции единицы трансляции в проекте.
Файл compile_commands.json может использоваться для компиляции проекта или для анализа сторонними утилитами. C и C++ анализатор PVS-Studio тоже умеет работать с этим форматом.
Анализ проекта на Linux и macOS выполняется с помощью утилиты pvs-studio-analyzer. Анализ на Windows – c помощью утилиты CompilerCommandsAnalyzer.exe, которая обычно размещена в папке C:\Program Files (x86)\PVS-Studio. Дополнительную информацию о CompilerCommandsAnalyzer и pvs-studio-analyzer можно узнать тут.
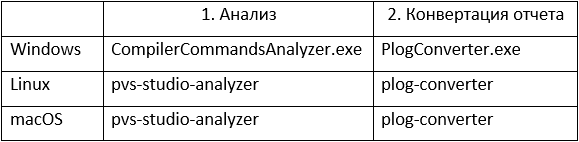
Важно: Проект должен успешно компилироваться и быть собран перед запуском анализа.
Для запуска анализа и получения отчета необходимо выполнить две команды.
Пример команд для Linux и macOS:
pvs-studio-analyzer analyze -f path_to_compile_commands.json \
-o pvs.log -e excludepath -j<N>
plog-converter -a GA:1,2 -t tasklist -o project.tasks pvs.logПример команд для Windows:
CompilerCommandsAnalyzer.exe analyze
-f path_to_compile_commands.json ^
-o pvs.log -e exclude-path -j<N>
PlogConverter.exe -a GA:1,2 -t Plog -o path_to_output_directory ^
-n analysis_report pvs.logЕсли анализ выполняется из директории с файлом compile_commands.json, флаг -f можно опустить.
Чтобы исключить из анализа директории с third-party библиотеками и/или тестами, можно использовать флаг -e. Если путей несколько, необходимо писать флаг -e для каждого пути:
-e third-party -e testsАнализ может быть распараллелен на несколько потоков с помощью флага -j.
Более подробные инструкции по утилитам на Linux/macOS и Windows доступны здесь и здесь.
Если проект по умолчанию не содержит compile_commands.json, то можно воспользоваться одним из способов генерации такого файла.
Для генерации compile_commands.json необходимо добавить один флаг к вызову CMake:
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On .Создание compile_commands.json происходит только в том случае, если генератор поддерживает JSON-формат. Такими генераторами являются, например, Makefile и Ninja:
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -G Ninja .
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -G "NMake Makefiles" .Для использования генератора Ninja под Windows часто требуется выполнять команды из командной строки разработчика от Visual Studio (например, x64 Native Tools Command Prompt for VS, и т.п.).
Если сборка проекта осуществляется напрямую с помощью Ninja и в папке проекта есть файл build.ninja, то можно воспользоваться следующей командой для генерации compile_commands.json:
ninja -t compdb > compile_commands.jsonДля генерации compile_commands.json в проекте, использующем Qt Build System, необходимо выполнить следующую команду:
qbs generate --generator clangdbКогда сборка проекта происходит с использованием GNU make, и получить compile_commands.json не получается, то следует попробовать инструмент Text Toolkit. Сгенерировать базу данных компиляции можно либо через Web-интерфейс (только для Linux и macOS), либо запустив скрипт на Python. Для генерации online нужно:
make -nwi > output.txt;output.txt в окно на сайте Text Toolkit;compile_commands.json.Для генерации compile_commands.json с помощью Python, нужно клонировать репозиторий с GitHub и выполнить следующую команду:
ninja -nv | python path_to_texttoolkit_dir\cdg.pyУтилита Bear (версии 2.4 или выше) собирает параметры компиляции, перехватывая вызовы компилятора во время сборки проекта. Для генерации compile_commands.json используется следующая команда
bear -- <build_command>В качестве build_command может быть любая команда для сборки: например, make all или ./build.sh.
Утилита intercept-build в scan-build аналогична утилите Bear. Команда для генерации compile_commands.json:
intercept-build <build_command>Compile Database Generator (compiledb) – это утилита для генерации базы данных компиляции для Makefile-based сборочных систем. Пример генерации compile_commands.json:
compiledb -n makeФлаг -n означает, что сборка не произойдет (dry run).
С помощью утилиты xcpretty можно сгенерировать compile_commands.json. Для этого необходимо выполнить следующую команду:
xcodebuild [flags] | xcpretty -r json-compilation-databaseДля генерации compile_commands.json в проекте, использующем qmake, можно воспользоваться IDE Qt Creator версии 4.8 и выше. Для этого необходимо открыть в ней нужный проект и выбрать в строке меню пункт Сборка > Создать базу данных компиляции для %название_проекта% (Build > Generate Compilation Database for %название_проекта%):
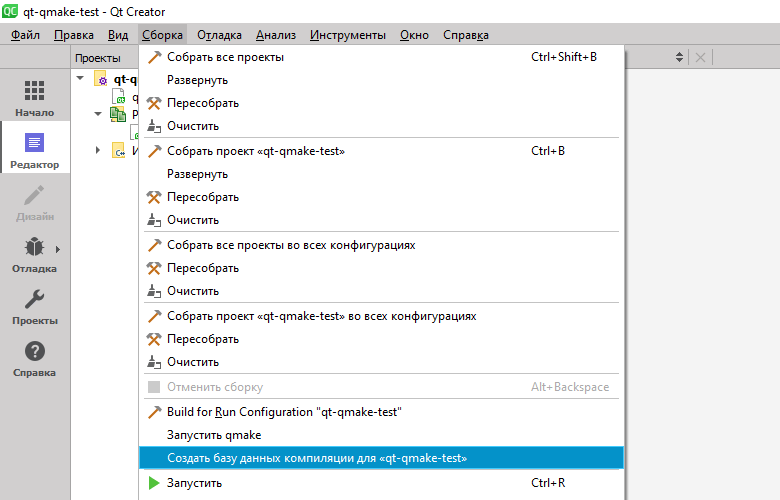
Сгенерированный файл compile_commands.json появится в директории сборки проекта.
Примечание: данный способ получения compile_commands.json не предусматривает автоматизации и рекомендуется к использованию только в целях тестирования.
Для генерации compile_commands.json в проекте, использующем систему сборки SCons, необходимо в файл SConstruct (аналог Makefile файла для утилиты Make) в директории проекта добавить следующие строчки:
env = Environment(COMPILATIONDB_USE_ABSPATH=True)
env.Tool('compilation_db')
env.CompilationDatabase()
env.Program('programm_for_build.c')После этого для создания файла compile_commands.json необходимо запустить в директории проекта (где расположен файл SConstruct) команду:
scons -QБолее подробное описание создания compile_commands.json в SCons находится в соответствующем разделе документации SCons.
Для генерации compile_commands.json в проекте, использующем систему сборки Bazel, используйте утилиту bazel-compile-commands-extractor (это утилита, которая не требует полной сборки проекта, и основана на Action Graph Query (aquery)). Инструкция по её настройке расположена здесь.
Есть несколько других вариантов создания файла compile_commands.json для Bazel проекта кроме bazel-compile-commands-extractor:
compile_commands.json для проекта.Помимо режима работы с compile_commands.json, работать с PVS-Studio в CMake можно с помощью официальной интеграции или специального CMake-модуля. Он позволяет вам интегрировать анализатор в проект на основе CMake более глубоким образом. Например, вы можете указать конкретные цели для анализа, чтобы не проверять весь проект полностью, а лишь те части, которые вам нужны.
Примечание. Минимальная версия CMake для использования CMake-модуля – 3.15 (апрель 2019).
Убедитесь, что вы ввели лицензионный ключ, иначе анализ не заработает. О том, как это сделать, подробно написано здесь.
Начиная с версии 4.3.0, CMake предлагает сценарий использования анализатора без compile_commands.json. Срабатывания анализатора PVS-Studio будут появляться в процессе компиляции проекта.
Чтобы включить анализ через официальную интеграцию, добавьте следующее правило в CMakeLists.txt:
set(CMAKE_<LANG>_PVS_STUDIO <EXECUTABLE> analyze -a "GA\;OP")LANG может принимать значения C или CXX;EXECUTABLE — путь до исполняемого файла pvs-studio-analyzer на GNU/Linux или CompilerCommandsAnalyzer.exe на Windows. CMake извлечёт его расположение из PATH, если до него указан не абсолютный путь.Указанные после EXECUTABLE параметры будут переданы исполняемому файлу C++ анализатора pvs-studio-analyzer/CompilerCommandsAnalyzer.exe.
Использование этой интеграции накладывает ограничения на формат вывода результатов анализа — вам будет недоступна конвертация отчёта через plog-converter, так как анализ этим способом осуществляется индивидуально для каждого файла и без сохранения результирующего отчёта PVS-Studio.
Поскольку срабатывания анализатора PVS-Studio являются частью журнала сборки, вы можете воспользоваться CTest для передачи отчёта в систему отслеживания результатов CDash.
Если вы по какой-то причине не можете запускать анализ при каждой сборке, то оберните настройку в условие:
if(ENABLE_PVS_STUDIO_CHECKS)
set(CMAKE_<LANG>_PVS_STUDIO <EXECUTABLE> analyze -a "GA\;OP")
endif()Кроссплатформенные проекты могут задействовать автоматический выбор названия исполняемого файла анализатора PVS-Studio для C и C++ проектов:
find_program(PVS_STUDIO_COMMAND NAMES
pvs-studio-analyzer CompilerCommandsAnalyzer)
set(CMAKE_CXX_PVS_STUDIO ${PVS_STUDIO_COMMAND} analyze -a "GA\;OP")Можно не редактировать CMakeLists.txt для проведения анализа, а сгенерировать папку сборки с добавлением параметра -DCMAKE_<LANG>_PVS_STUDIO со значением командной строки запуска анализатора PVS-Studio. Обратите внимание, что в этом случае разделение параметров осуществляется через символ ;, поэтому для указания нескольких групп диагностических правил в параметре -a потребуется экранирование:
cmake -B build -DCMAKE_C_PVS_STUDIO="<EXECUTABLE>;analyze;-a;GA\;OP"Альтернативный способ добавить анализ с помощью PVS-Studio в проект — это использовать CMake-модуль. Для его автоматической загрузки используйте FetchContent:
include(FetchContent)
FetchContent_Declare(
PVS_CMakeModule
GIT_REPOSITORY "https://github.com/viva64/pvs-studio-cmake-module.git"
GIT_TAG "master"
)
FetchContent_MakeAvailable(PVS_CMakeModule)
include("${pvs_cmakemodule_SOURCE_DIR}/PVS-Studio.cmake")Этот код самостоятельно загрузит Git-репозиторий с модулем в генерируемую папку кэша и позволит интегрировать анализатор в ваш проект. Обратите внимание, что master — это самая свежая версия. Если у вас возникнут проблемы с ней, то попробуйте взять последний релизный тег текущей версии анализатора.
Вы также можете загрузить файл с модулем PVS-Studio.cmake самостоятельно, если вы не хотите иметь лишних зависимостей от FetchContent.
Пожалуйста, не забывайте обновлять модуль с выходом новой версии анализатора во избежание проблем в его работе. В параметре GIT_TAG также можно указать master-ветку, чтобы всегда использовать последнюю версию модуля.
Для запуска анализатора CMake-модуль добавляет отдельную цель для сборки. При запуске сборки этой цели на самом деле будет запущен анализ с параметрами, которые были указаны при добавлении этой цели. Чтобы добавить цель для анализа, нужно использовать команду pvs_studio_add_target. Например:
cmake_minimum_required(VERSION 3.5)
project(pvs-studio-cmake-example CXX)
add_executable(example main.cpp)
# Optional:
# include(FetchContent)
# FetchContent_Declare(....)
# FetchContent_MakeAvailable(....)
include(PVS-Studio.cmake)
pvs_studio_add_target(TARGET example.analyze ALL
OUTPUT FORMAT json
ANALYZE example
MODE GA:1,2
LOG target.err
ARGS -e /path/to/exclude-path)Этот небольшой CMake-файл содержит одну цель для сборки исполняемого файла и одну цель для запуска анализа. Разберем параметры команды pvs_studio_add_target:
ALL — анализ будет запускаться автоматически при сборке цели all, т. е. будет работать при каждой сборке проекта;TARGET — название создаваемой цели для анализа. Чтобы запустить анализ, достаточно собрать эту цель;ANALYZE — цели, которые нужно проанализировать. Должны быть уникальны при параллельной сборке нескольких целей CMake-модулем. Чтобы также проанализировать зависимости этих целей, стоит добавить флаг RECURSIVE;RECURSIVE — рекурсивно анализировать зависимости целей;COMPILE_COMMANDS — использовать compile_commands.json вместо указания целей в опции ANALYZE. Работает за счет CMAKE_EXPORT_COMPILE_COMMANDS, доступно только при использовании Makefile или Ninja генераторов.OUTPUT — печатать вывод анализатора в лог сборки;LOG — файл отчета. Если его не указывать, будет использоваться файл PVS-Studio.log в директории с CMake кэшем;FORMAT — формат отчета. В данном случае json — формат ошибок с поддержкой многофайловой навигации. Список доступных форматов можно найти здесь (раздел "Утилита Plog Converter"). Можно использовать несколько форматов (пример: FORMAT "gitlab,tasklist-verbose");MODE — включение групп диагностик и их уровней.PLATFORM — название платформы, доступные опции: win32, x64/win64, linux32, linux64, macos, arm (IAR Embedded Workbench), pic8 (MPLAB XC8), tms (Texas Instruments C6000);PREPROCESSOR — формат препроцессированного файла (clang/visualcpp/gcc);LICENSE — путь до .lic файла;CONFIG — путь до .cfg файла;CFG_TEXT — содержимое .cfg файла;SUPPRESS_BASE — путь до suppress-файла в формате .suppress.json;KEEP_COMBINED_PLOG — не удалять совмещенный файл .pvs.raw для последующей обработки утилитой plog-converter.DEPENDS — дополнительные зависимости для цели;SOURCES — список исходных файлов для анализа;BIN — путь до pvs-studio-analyzer (macOS/Linux) или CompilerCommandsAnalyzer.exe (Windows);CONVERTER — путь до plog-converter (macOS/Linux) или HtmlGenerator.exe (Windows);C_FLAGS — дополнительные флаги для C компилятора;CXX_FLAGS — дополнительные флаги для C++ компилятора;ARGS — дополнительные аргументы для pvs-studio-analyzer/CompilerCommandsAnalyzer.exe;CONVERTER_ARGS — дополнительные аргументы для plog-converter/HtmlGenerator.exe.Для исключения файлов из анализа можно воспользоваться опцией ARGS, передав пути через флаг -e (--exclude-path), как указано в примере выше. Вы можете задать абсолютные, относительные пути или маску поиска (glob). Учтите, что относительные пути будут раскрыты относительно каталога сборки. Такой подход позволяет, например, исключить из анализа сторонние библиотеки.
Для запуска анализа надо собрать цель, которая была добавлена в pvs_studio_add_target. Например, так выглядит запуск анализа для примера выше:
cmake --build <path-to-cache-dir> --target example.analyzeПеред запуском будут собраны все цели, указанные для анализа в параметре ANALYZE.
Здесь вы можете найти примеры интеграции PVS-Studio в CMake.
Docker — программное обеспечение для автоматизации развёртывания и управления приложениями в средах с поддержкой контейнеризации. Позволяет "упаковать" приложение со всем его окружением и зависимостями в контейнер, который может быть перенесён на любую систему, где установлен Docker.
Ниже будут рассмотрены:
Для сборки готового образа с последней версией анализатора PVS-Studio можно использовать Dockerfile.
Для debian-based систем:
FROM gcc:7
# INSTALL DEPENDENCIES
RUN apt update -yq \
&& apt install -yq --no-install-recommends wget \
&& apt clean -yq
# INSTALL PVS-Studio
RUN wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt | apt-key add - \
&& wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list \
&& apt update -yq \
&& apt install -yq pvs-studio strace \
&& pvs-studio --version \
&& apt clean -yqДля zypper-based систем:
FROM opensuse:42.3
# INSTALL DEPENDENCIES
RUN zypper update -y \
&& zypper install -y --no-recommends wget \
&& zypper clean --all
# INSTALL PVS-Studio
RUN wget -q -O /tmp/viva64.key https://files.pvs-studio.com/etc/pubkey.txt \
&& rpm --import /tmp/viva64.key \
&& zypper ar -f https://files.pvs-studio.com/rpm viva64 \
&& zypper update -y \
&& zypper install -y --no-recommends pvs-studio strace \
&& pvs-studio --version \
&& zypper clean -allДля yum-based систем:
FROM centos:7
# INSTALL DEPENDENCIES
RUN yum update -y -q \
&& yum install -y -q wget \
&& yum clean all -y -q
# INSTALL PVS-Studio
RUN wget -q -O /etc/yum.repos.d/viva64.repo \
https://files.pvs-studio.com/etc/viva64.repo \
&& yum install -y -q pvs-studio strace \
&& pvs-studio --version \
&& yum clean all -y -qПримечание. PVS-Studio для Linux также может быть скачан по следующим постоянным ссылкам:
Команда для сборки образа:
docker build -t viva64/pvs-studio:8.01 -f DockerfileПримечание. Базовый образ и зависимости необходимо изменить для целевого проекта.
Запустить анализ, например, CMake-проекта можно с помощью следующей команды:
docker run --rm -v "~/Project":"/mnt/Project" \
-w "/mnt/Project" viva64/pvs-studio:8.01 \
sh -c 'mkdir build && cd build &&
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On .. && make -j8 &&
pvs-studio-analyzer analyze ... -o report.log -j8 ...'При этом конвертер отчётов анализатора (plog-converter) рекомендуется запускать вне контейнера, чтобы отчёты содержали корректные пути до исходных файлов. Единственный тип отчёта, который имеет смысл сгенерировать в контейнере, это fullhtml, (HTML отчёт с сортировкой предупреждений и навигацией по коду). Для получения других типов отчёта требуется дополнительная настройка анализатора.
При проверке не CMake-проектов в контейнере в режиме трассировки вызовов компилятора может возникнуть такая ошибка:
strace: ptrace(PTRACE_TRACEME, ...): Operation not permitted
Error: Command strace returned 1 code.Для исправления ошибки необходимо запустить докер с дополнительными правами:
docker run ... --security-opt seccomp:unconfined ...или так:
docker run ... --cap-add SYS_PTRACE ...Указание лицензии анализатора
Т.к. время жизни контейнера ограничено, файл лицензии анализатора необходимо закоммитить в образ, либо указывать анализатору через смонтированный каталог:
pvs-studio-analyzer analyze ... -l /path/to/PVS-Studio.lic ...Восстановление путей к исходникам в отчёте
Чтобы получить отчёт анализатора с корректными путями до файлов с исходным кодом, анализатору предварительно необходимо указать директорию проекта:
pvs-studio-analyzer analyze ... -r /path/to/project/in/container ...После чего запустить конвертер отчёта вне контейнера.
На Linux или macOS:
plog-converter ... -r /path/to/project/on/host ...на Windows:
PlogConverter.exe ... -r /path/to/project/on/hostТакже в Windows можно открыть отчёт без конвертации в утилите Compiler Monitoring UI.
Исключение директорий из анализа
Исключить из анализа директории со сторонними библиотеками, тестами и директорию компилятора можно с помощью параметра -e:
pvs-studio-analyzer analyze ... -e /path/to/tests ... -e /path/to/contrib ...Настройка кросс-компилятора
Если контейнер содержит кросс-компилятор или компилятор без алиасов (например, g++-7), то имя компилятора надо указать дополнительно:
pvs-studio-analyzer analyze ... -C g++-7 -C compilerName ...Вариант установки из архива
FROM openkbs/ubuntu-bionic-jdk-mvn-py3
ARG PVS_CORE="8.01.110581"
RUN wget "https://files.pvs-studio.com/java/pvsstudio-cores/${PVS_CORE}.zip"\
-O ${PVS_CORE}.zip \
&& mkdir -p ~/.config/PVS-Studio-Java \
&& unzip ${PVS_CORE}.zip -d ~/.config/PVS-Studio-Java \
&& rm -rf ${PVS_CORE}.zipКоманда для сборки образа:
docker build -t viva64/pvs-studio:8.01 -f DockerfileВариант коммита слоя с анализатором
Анализатор выкачивается автоматически при первом анализе проекта. Можно предварительно задать имя контейнера и выполнить анализ проекта:
docker run --name analyzer
-v "D:\Project":"/mnt/Project"
openkbs/ubuntu-bionic-jdk-mvn-py3
sh -c "cd /mnt/Project && mvn package
&& mvn pvsstudio:pvsAnalyze -Dpvsstudio.licensePath=/path/to/PVS-Studio.lic"после чего выполнить коммит в новый образ:
docker commit analyzer viva64/pvs-studio:8.01Примечание. Базовый образ и зависимости необходимо изменить для целевого проекта. Установку и запуск анализатора следует выполнять от имени одного и того же пользователя.
Регулярно запускать анализ проекта следует аналогичным образом, добавив параметр --rm:
docker run --rm -v "D:\Project":"/mnt/Project"
openkbs/ubuntu-bionic-jdk-mvn-py3
sh -c "cd /mnt/Project
&& mvn package
&& mvn pvsstudio:pvsAnalyze -Dpvsstudio.licensePath=/path/to/PVS-Studio.lic"Настройку анализатора при интегрировании в сборочную систему Maven или Gradle можно производить согласно инструкциям из документации:
Для сборки готового образа с последней версией анализатора PVS-Studio можно использовать следующий Dockerfile:
# escape=`
FROM mcr.microsoft.com/dotnet/framework/runtime:4.8
SHELL ["cmd", "/S", "/C"]
# INSTALL chocolatey
RUN `
@"%SystemRoot%\System32\WindowsPowerShell\v1.0\powershell.exe" -NoProfile`
-InputFormat None -ExecutionPolicy Bypass `
-Command " [System.Net.ServicePointManager]::SecurityProtocol = 3072; `
iex ((New-Object System.Net.WebClient).DownloadString `
('https://chocolatey.org/install.ps1'))" `
&& `
SET "PATH=%PATH%;%ALLUSERSPROFILE%\chocolatey\bin"
# INSTALL Visual Studio Build Tools components (minimal)
RUN `
choco install -y visualstudio2019buildtools `
--package-parameters "--quiet --wait --norestart --nocache `
--add Microsoft.VisualStudio.Workload.VCTools;includeRecommended `
--add Microsoft.VisualStudio.Workload.ManagedDesktopBuildTools`
;includeRecommended"
# INSTALL PVS-Studio
RUN `
choco install -y pvs-studioВыполнив в директории Dockerfile следующую команду, можно получить готовый образ:
docker build -t viva64/pvs-studio:8.01 .Полученный Docker образ будет иметь минимальные зависимости, чтобы проанализировать С++/С# "Hello Word" проекты. Если ваш проект требует дополнительные компоненты Visual Studio Build Tools, то нужно их установить, скорректировав скрипт. С перечнем доступных компонентов можно ознакомиться здесь.
В данном образе устанавливаются последние из доступных версий Build Tools для Visual Studio 2019 и PVS-Studio при помощи Chocolatey. Чтобы установить конкретную версию Build Tools 2019, нужно явно указать ее при установке. Например,
choco install visualstudio2019buildtools --version=16.10.0.0 ...О доступных версиях можно узнать здесь.
Если вам нужно установить Build Tools для Visual Studio 2017, то инструкция для установки идентична.
Если установка через Chocolatey по каким-либо соображениям не подходит, то можно всё установить самостоятельно, подготовив все необходимые инсталляторы. Рядом с Dockerfile вам необходимо будет создать директорию с инсталляторами нужных версий (PVS-Studio, VS Build Tools и т.д.). Dockerfile:
# escape=`
FROM mcr.microsoft.com/dotnet/framework/runtime:4.8
SHELL ["cmd", "/S", "/C"]
ADD .\installers C:\Installers
# INSTALL Visual Studio Build Tools components (minimal)
RUN `
C:\Installers\vs_BuildTools.exe --quiet --wait --norestart --nocache `
--add Microsoft.VisualStudio.Workload.VCTools;includeRecommended `
--add Microsoft.VisualStudio.Workload.ManagedDesktopBuildTools`
;includeRecommended `
|| IF "%ERRORLEVEL%"=="3010" EXIT 0
# INSTALL PVS-Studio
RUN `
C:\Installers\PVS-Studio_setup.exe `
/verysilent /suppressmsgboxes /norestart /nocloseapplications
# Cleanup
RUN `
RMDIR /S /Q C:\InstallersПримечание. Если ваш проект потребует дополнительной настройки окружения и зависимостей, то необходимо будет самостоятельно модифицировать Dockerfile соответствующим образом.
Чтобы запустить анализ, при запуске контейнера нужно смонтировать все необходимые внешние зависимости: директорию с проектом, файл с настройками анализатора (Settings.xml) и т.д.
Команда запуска анализа может выглядеть следующим образом:
docker run --rm -v "path\to\files":"C:\mnt" -w "C:\mnt" \
viva64/pvs-studio:8.01 \
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe" \
--target ".\Project\Project.sln" --output ".\Report.plog" \
--settings ".\Settings.xml" --sourceTreeRoot "C:\mnt"После чего у вас появится отчет "path\to\files\Report.plog", который вы можете открыть в Visual Studio плагине или в утилите Compiler Monitoring UI.
Примечание. Опция 'sourceTreeRoot' - корневая часть пути, которую PVS-Studio будет использовать при генерации относительных путей в диагностических сообщениях. Это позволит избежать недействительных путей в отчете.
Настраивать анализатор можно через:
Чтобы ядро анализатора работало, необходимо иметь лишь Java 11+. Если вы используете сборочную систему (Maven, Gradle), то вам также необходимо иметь настроенное для неё окружение.
Чтобы получить Docker образ с Maven и последней версией ядра анализатора PVS-Studio, можно воспользоваться одним из следующих вариантов.
Вариант установки из архива
# escape=`
FROM csanchez/maven:3.8.3-azulzulu-11-windowsservercore-ltsc2019
SHELL ["cmd", "/S", "/C"]
ARG PVS_CORE="8.01.110581"
RUN `
powershell -Command `
Invoke-WebRequest `
"https://files.pvs-studio.com/java/pvsstudio-cores/%PVS_CORE%.zip" `
-OutFile .\pvs-studio.zip`
&& `
powershell -Command `
Expand-Archive `
-LiteralPath '.\pvs-studio.zip' `
-DestinationPath \"%APPDATA%\PVS-Studio-Java\" `
&& `
DEL /f .\pvs-studio.zipВыполнив в директории Dockerfile следующую команду, можно получить готовый образ:
docker build -t viva64/pvs-studio:8.01 .Вариант коммита слоя с анализатором
Анализатор выкачивается автоматически при первом анализе проекта. Можно предварительно задать имя контейнера и выполнить анализ проекта:
docker run --name analyzer ^
-v "path\to\project":"C:/mnt/Project" ^
-w C:\mnt\Project ^
csanchez/maven:3.8.3-azulzulu-11-windowsservercore-ltsc2019 ^
mvn package pvsstudio:pvsAnalyzeПосле чего выполнить коммит в новый образ:
docker commit analyzer viva64/pvs-studio:8.01Примечание. В случае с Gradle иметь предустановленную сборочную систему необязательно, так как gradlew сделает все за вас. Поэтому за основу Dockerfile достаточно взять образ только с Java 11+.
Регулярно запускать анализ проекта следует аналогичным образом:
docker run --name analyzer ^
--rm ^
-v "path\to\project":"C:/mnt/Project"^
-w C:\mnt\Project^
viva64/pvs-studio:8.01 ^
mvn package pvsstudio:pvsAnalyze '-Dpvsstudio.licensePath=./PVS-Studio.lic'Отличие запуска в том, что указывается опция '--rm', чтобы после запуска контейнер не оставался в памяти. А также нужно указать путь до лицензии. В данном примере лицензия была помещена в корень проекта.
Стоит учесть, что при каждом запуске анализа Maven будет скачивать все необходимые зависимости в свой локальный репозиторий. Чтобы этого избежать, при запуске можно смонтировать локальный репозиторий Maven хостовой машины. Например:
docker run ... -v "%M2_REPO%":"C:\Users\ContainerUser\.m2" ...Настройку анализатора при интегрировании в сборочную систему Maven или Gradle можно производить согласно инструкциям из документации:
Для автоматизации процедуры анализа в CI (Continuous Integration) необходимо запускать анализатор как консольное приложение.
В Jenkins Вы можете создать один из следующих шагов сборки:
и вписать команду анализа (и команду конвертации отчёта в нужный формат).
Примеры команд запуска анализатора и интеграции в сборочные системы приведены на следующих страницах документации:
Warnings NG Plugin поддерживает отчёты анализатора PVS-Studio, начиная с версии плагина 6.0.0. Этот плагин предназначен для визуализации результатов работы различных анализаторов.
Установить плагин можно из стандартного репозитория Jenkins в меню Manage Jenkins > Manage Plugins > Available > Warnings Next Generation Plugin:
Для публикации результатов анализа в настройках проекта необходимо добавить послесборочный шаг (секция Post-build Actions) Record compiler warnings and static analysis results. Далее необходимо раскрыть список Tool и выбрать PVS-Studio. В поле Report File Pattern можно указать маску или путь к отчёту анализатора. Поддерживаются отчёты с расширением .plog и .xml.
В поле Report Encoding указывается кодировка, в которой будет считан файл отчета. Если поле пустое, то будет использована кодировка операционной системы, в которой запущен Jenkins. Поля Custom ID и Custom Name переопределяют отображаемые в интерфейсе идентификатор и имя выбранной утилиты соответственно.
Для публикации результатов анализа через pipeline скрипты добавьте следующее:
recordIssues enabledForFailure: true,sourceCodeEncoding:'UTF-8',
tool: PVSStudio(pattern: 'report.plog')где report.plog отчет анализатора.
Сгенерировать отчёт в нужном формате можно следующими способами.
Windows: C, C++, C#
Отчёты с расширением .plog являются стандартными для Windows.
Linux/macOS: C, C++
plog-converter ... --renderTypes xml ...Windows/Linux/macOS: Java
В настройках плагинов для Maven и Gradle в поле outputType указать значение xml.
После сборки проекта слева в списке появится новый элемент меню PVS-Studio Warnings. По нажатию на него открывается страница, где представлена визуализация данных отчета, созданного анализатором PVS-Studio:
Также при нажатии на значение в столбце File в браузере будет открыт файл с исходным кодом на строчке, где была найдена ошибка.
Примечание. Просмотр предупреждений из загруженного отчёта анализатора в файлах исходного кода в Jenkins (ссылки в столбце File) работает, только если в момент запуска шага Record compiler warnings and static analysis results (секция Post-build Actions) в рабочей директории Jenkins задачи расположены файлы проекта, пути до которых указываются в отчёте анализатора (*.plog файл). Файлы исходного кода, на которые были выданы предупреждения анализатора, кэшируются для каждой сборки Jenkins задачи. Поэтому после прохождения шага Record compiler warnings and static analysis results (секция Post-build Actions) можно очищать рабочую директорию Jenkins задачи без потери возможности просмотра предупреждений в файлах исходного кода в Jenkins. Если открытие файла не работает, значит отчёт был сформирован вне рабочей директории Jenkins задачи или кэшированные файлы исходного кода из в директории сборки Jenkins задачи, участвовавшие в составлении отчёта, перемещены или удалены.

В других CI настройка запуска анализатора и работа с отчётом выполняются аналогичным образом.
Для автоматизации процесса анализа в TeamCity необходимо запускать анализатор как консольное приложение.
В TeamCity необходимо создать Build Step со следующими параметрами:
В скрипте напишите команду анализа и опционально команду конвертации отчёта в нужный формат.
Примеры команд для запуска анализатора, обработки результатов анализа и интеграции в сборочные системы приведены на следующих страницах документации:
В TeamCity можно прикреплять отчёты анализатора в формате HTML к сборкам, указав их в артефактах.
Сгенерировать HTML-отчёт с навигацией по коду можно следующими способами:
Windows: C, C++, C#
PlogConverter.exe ... --renderTypes FullHtml ...Linux/macOS: C, C++
plog-converter ... --renderTypes fullhtml ...Windows/Linux/macOS: Java
В настройках плагинов для Maven и Gradle в поле 'outputType' указать значение 'fullhtml'.
В меню 'Edit Configuration Settings -> General Settings -> Artifact paths' укажите каталог с HTML-отчётом.
После успешного выполнения сборки отчёт анализатора формате fullhtml будет доступен в артефактах. Чтобы открыть его, нужно кликнуть на файл 'index.html' на вкладке 'Artifacts'. Также можно сделать так, чтобы отчёт анализатора отображался на специальной вкладке отчёта о сеансе сборки. Для этого необходимо перейти в настройки проекта, открыть 'Report Tabs' и добавить новую вкладку отчёта сборки ('Create new build report tab').
В окне добавления вкладки в поле 'Start page' необходимо указать путь к файлу 'index.html' относительно корневой папки артефактов. Например, если содержимое вкладки 'Artifacts' выглядит примерно так:
то в поле 'Start Page' нужно записать путь 'fullhtml/index.html'. После добавления вкладки результаты анализа можно будет просматривать на ней:
При переходе к предупреждениям анализатора будет открываться дополнительная вкладка браузера:
Утилита "plog-converter" поддерживает стандартные отчёты для TeamCity - TeamCity Inspections Type. После генерации отчёта его необходимо вывести в stdout на любом шаге сборки.
Сгенерировать такой отчёт и вывести его в stdout можно следующими способами:
Windows: C, C++, C#
PlogConverter.exe ... –-renderTypes=TeamCity -o TCLogsDir ...
Type TCLogsDir\MyProject.plog_TeamCity.txtLinux/macOS: C, C++
plog-converter ... -t teamcity -o report_tc.txt ...
cat report_tc.txtWindows/Linux/macOS: Java
Поддержка скоро появится.
После успешного выполнения сборки отчёт анализатора появится на новой вкладке в информации об этой сборке:
Навигацию по коду можно осуществить при помощи нажатия на номер строки слева от диагностического правила. Переход осуществится при условии наличия абсолютного пути к исходному файлу, открытого проекта в IDE (Visual Studio, IntelliJ IDEA) и установленного плагина TeamCity.
SolidLab SDP — это платформа, которая поддерживает процессы безопасной разработки на всех этапах жизненного цикла программного обеспечения.
В подсистеме статического анализа платформы есть возможность использования PVS-Studio для выполнения сканирования в составе CI/CD-конвейеров, централизованного сканирования репозиториев без интеграции в процессы сборки и доставки, а также запуска анализа по расписанию или событию.
У SolidLab SDP есть подсистемы динамического и композиционного анализа, что позволяет использовать PVS-Studio вместе с другими инструментами безопасной разработки.
Примечание. Настройка лицензии производится администратором однократно и не требует дополнительных действий от разработчиков или других пользователей.
Лицензия для использования PVS-Studio хранится в системе управления секретами SolidLab SDP и передаётся инструменту автоматически во время запуска анализа.
Для загрузки и обновления лицензии воспользуйтесь SDP API. Для этого выполните следующий запрос:
curl -X 'PUT' \
'https://$URL/api/v3/user/secret?user=$user' \
-H 'accept: application/json' \
-H 'Content-Type: application/json' \
-H 'Authorization: Bearer $SDP_API_TOKEN' \
-d '{
"secret_name": "pvs_studio_licence",
"secret_value": "$PVS_STUDIO_LICENCE"
}'Для запуска анализа отправьте запрос в SDP API. В нём укажите шаблон сканирования, источник исходного кода и параметры выполнения анализа:
curl -s -X POST \
"https://$URL/api/v3/scan/start" \
-H "Authorization: Bearer $SDP_API_TOKEN" -d '
{
"template": "sast-subsystem",
"template_version": "X.X.X",
"user": "$CLIENT",
"project": "$PROJECT",
"scan_plan": {
"scanners_configs": {
"pvs": "--errorCodes V501,V1001,V3001 -e /path/to/tests"
},
"code_mode": {
"source_type": "git",
"git": {
"repo_url": "$REPO_URL",
"repo_type": "public", // "private"
"repo_branch": "$REPO_BRANCH"
},
"results_correlation": {
"enable": "true"
},
"code_snippet": {
"enable": "true"
}
}
}
}'Источник исходного кода может быть представлен Git-репозиторием или архивом, передаваемым в S3-совместимое хранилище через SDP-API.
В поле scanners_configs можете указать параметры, с которыми будет запущен анализатор PVS-Studio:
pvs для анализатора кроссплатформенных C и C++ проектов;pvsdotnet для анализатора MSBuild проектов;pvsjava для анализатора Java-проектов.После запуска сканирования в ответ возвращается параметр Workflow ID, который можно использовать для отслеживания статуса процесса:
curl -s -X "GET" \
-H "Authorization: Bearer $SDP_API_TOKEN" \
-H 'Content-Type: application/json' \
https://$URL/api/v3/scan/status/{$WORKFLOW_ID}После завершения сканирования результаты будут автоматически выгружены в систему управления находками, а также во внешние системы, для которых настроены интеграции.
Результаты проверки Quality Gate в CI/CD процессе можно получить с помощью следующего запроса:
сurl -s -X "GET" \
-H "Authorization: Bearer $SDP_API_TOKEN" \
https://$URL/api/v3/scan/${workflow_id}/results/${PROJECT}/secgateВыгрузить SARIF-отчёт с результатами анализа можно с помощью запроса:
сurl -s -X "GET" \
-H "Authorization: Bearer $SDP_API_TOKEN" \
https://$URL/api/v3/scan_info/${workflow_id}/results/${PROJECT}/correlatedSolidLab SDP также поддерживает передачу результатов анализа во внешние инструменты:
Подробнее об этом написано в документации SolidLab SDP.
Travis CI – сервис для сборки и тестирования программного обеспечения, использующего GitHub в качестве хранилища. Travis CI не требует изменения программного кода для использования сервиса, все настройки происходят в файле '.travis.yml', расположенном в корне репозитория.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
Для начала создайте переменные, которые используются для формирования файла лицензии анализатора и отсылки его отчетов. Перейдите на страницу настроек - кнопка "Settings" справа от нужного репозитория.
Откроется окно настроек.
Краткое описание настроек:
В секции "Environment Variables" создайте переменные 'PVS_LICENSE_NAME' и 'PVS_LICENSE_KEY', содержащие, соответственно, имя лицензии анализатора, привязанное к ключу, и лицензионный ключ для статического анализатора.
Тут же добавьте переменные 'MAIL_USER' и 'MAIL_PASSWORD', содержащие имя пользователя и пароль от почтового ящика, который нужно использовать для отправки отчетов.
При запуске задачи Travis CI берет инструкции из файла '.travis.yml', лежащего в корне репозитория.
Используя Travis CI, можно запускать статический анализ как в виртуальной машине, так и используя для этого предварительно настроенный контейнер. Результаты этих подходов ничем не отличаются друг от друга, но использование предварительно настроенного контейнера может пригодиться, например, если у нас уже есть контейнер с каким-то специфическим окружением, внутри которого собирается и тестируется программный продукт, и нет желания восстанавливать это окружение в Travis CI.
В качестве примера для сборки и тестирования используется виртуальная машина на базе Ubuntu Trusty, ее описание можно посмотреть по ссылке.
Первым делом указывается язык, на котором написан проект (в данном случае это С) и перечисляются компиляторы, которые используются для сборки:
language: c
compiler:
- gcc
- clangПримечание: при указании более одного компилятора, задачи будут запускаться параллельно для каждого из них. Подробнее можно прочитать в документации.
Перед началом сборки нам необходимо добавить репозиторий анализатора, установить зависимости и дополнительные пакеты:
before_install:
- sudo add-apt-repository ppa:ubuntu-lxc/daily -y
- wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt |sudo apt-key add -
- sudo wget -O /etc/apt/sources.list.d/viva64.list
https://files.pvs-studio.com/etc/viva64.list
- sudo apt-get update -qq
- sudo apt-get install -qq coccinelle parallel
libapparmor-dev libcap-dev libseccomp-dev
python3-dev python3-setuptools docbook2x
libgnutls-dev libselinux1-dev linux-libc-dev pvs-studio
libio-socket-ssl-perl libnet-ssleay-perl sendemail
ca-certificatesПеред сборкой проекта необходимо подготовить окружение:
script:
- ./coccinelle/run-coccinelle.sh -i
- git diff --exit-code
- export CFLAGS="-Wall -Werror"
- export LDFLAGS="-pthread -lpthread"
- ./autogen.sh
- rm -Rf build
- mkdir build
- cd build
- ../configure --enable-tests --with-distro=unknownДалее нам необходимо создать файл с лицензией и запустить анализ проекта.
Первой командой создаем файл с лицензией для анализатора. Данные для переменных '$PVS_LICENSE_NAME' и '$PVS_LICENSE_KEY' берутся из настроек проекта.
- pvs-studio-analyzer credentials
$PVS_LICENSE_NAME $PVS_LICENSE_KEY -o PVS-Studio.licСледующей командой запускаем трассировку сборки проекта:
- pvs-studio-analyzer trace -- make -j4После запускаем статический анализ.
Примечание: при использовании триальной лицензии необходимо указывать параметр '--disableLicenseExpirationCheck'.
- pvs-studio-analyzer analyze -j2 -l PVS-Studio.lic
-o PVS-Studio-${CC}.log
–-disableLicenseExpirationCheckПоследней командой файл с результатами работы анализатора конвертируется в html-отчет.
- plog-converter -t html PVS-Studio-${CC}.log
-o PVS-Studio-${CC}.htmlТак как TravisCI не позволяет изменять формат почтовых уведомлений, то для отсылки отчетов на последнем шаге воспользуемся пакетом 'sendemail':
- sendemail -t mail@domain.com
-u "PVS-Studio $CC report, commit:$TRAVIS_COMMIT"
-m "PVS-Studio $CC report, commit:$TRAVIS_COMMIT"
-s smtp.gmail.com:587
-xu $MAIL_USER
-xp $MAIL_PASSWORD
-o tls=yes
-f $MAIL_USER
-a PVS-Studio-${CC}.log PVS-Studio-${CC}.htmlПолный текст конфигурационного файла для запуска анализатора в виртуальной машине:
language: c
compiler:
- gcc
- clang
before_install:
- sudo add-apt-repository ppa:ubuntu-lxc/daily -y
- wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt |sudo apt-key add -
- sudo wget -O /etc/apt/sources.list.d/viva64.list
https://files.pvs-studio.com/etc/viva64.list
- sudo apt-get update -qq
- sudo apt-get install -qq coccinelle parallel
libapparmor-dev libcap-dev libseccomp-dev
python3-dev python3-setuptools docbook2x
libgnutls-dev libselinux1-dev linux-libc-dev pvs-studio
libio-socket-ssl-perl libnet-ssleay-perl sendemail
ca-certificates
script:
- ./coccinelle/run-coccinelle.sh -i
- git diff --exit-code
- export CFLAGS="-Wall -Werror"
- export LDFLAGS="-pthread -lpthread"
- ./autogen.sh
- rm -Rf build
- mkdir build
- cd build
- ../configure --enable-tests --with-distro=unknown
- pvs-studio-analyzer credentials
$PVS_LICENSE_NAME $PVS_LICENSE_KEY -o PVS-Studio.lic
- pvs-studio-analyzer trace -- make -j4
- pvs-studio-analyzer analyze -j2 -l PVS-Studio.lic
-o PVS-Studio-${CC}.log
--disableLicenseExpirationCheck
- plog-converter -t html PVS-Studio-${CC}.log -o PVS-Studio-${CC}.html
- sendemail -t mail@domain.com
-u "PVS-Studio $CC report, commit:$TRAVIS_COMMIT"
-m "PVS-Studio $CC report, commit:$TRAVIS_COMMIT"
-s smtp.gmail.com:587
-xu $MAIL_USER
-xp $MAIL_PASSWORD
-o tls=yes
-f $MAIL_USER
-a PVS-Studio-${CC}.log PVS-Studio-${CC}.htmlДля запуска статического анализатора в контейнере, предварительно создайте его, используя следующий 'Dockerfile':
FROM docker.io/ubuntu:trusty
ENV CFLAGS="-Wall -Werror"
ENV LDFLAGS="-pthread -lpthread"
RUN apt-get update && apt-get install -y software-properties-common wget \
&& wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt |
sudo apt-key add - \
&& wget -O /etc/apt/sources.list.d/viva64.list
https://files.pvs-studio.com/etc/viva64.list \
&& apt-get update \
&& apt-get install -yqq coccinelle parallel
libapparmor-dev libcap-dev libseccomp-dev
python3-dev python3-setuptools docbook2x
libgnutls-dev libselinux1-dev linux-libc-dev
pvs-studio git libtool autotools-dev automake
pkg-config clang make libio-socket-ssl-perl
libnet-ssleay-perl sendemail ca-certificates \
&& rm -rf /var/lib/apt/lists/*Конфигурационный файл для запуска контейнера может выглядеть так:
before_install:
- docker pull docker.io/oandreev/lxc
env:
- CC=gcc
- CC=clang
script:
- docker run
--rm
--cap-add SYS_PTRACE
-v $(pwd):/pvs
-w /pvs
docker.io/oandreev/lxc
/bin/bash -c " ./coccinelle/run-coccinelle.sh -i
&& git diff --exit-code
&& ./autogen.sh
&& mkdir build && cd build
&& ../configure CC=$CC
&& pvs-studio-analyzer credentials
$PVS_LICENSE_NAME $PVS_LICENSE_KEY -o PVS-Studio.lic
&& pvs-studio-analyzer trace -- make -j4
&& pvs-studio-analyzer analyze -j2
-l PVS-Studio.lic
-o PVS-Studio-$CC.log
--disableLicenseExpirationCheck
&& plog-converter -t html
-o PVS-Studio-$CC.html
PVS-Studio-$CC.log
&& sendemail -t mail@domain.com
-u 'PVS-Studio $CC report, commit:$TRAVIS_COMMIT'
-m 'PVS-Studio $CC report, commit:$TRAVIS_COMMIT'
-s smtp.gmail.com:587
-xu $MAIL_USER -xp $MAIL_PASSWORD
-o tls=yes -f $MAIL_USER
-a PVS-Studio-${CC}.log PVS-Studio-${CC}.html"Примечание: при запуске контейнера необходимо указывать параметр '--cap-add SYS_PTRACE' либо '--security-opt seccomp:unconfined', так как для трассировки компиляции используется системный вызов 'ptrace'.
После загрузки конфигурационного файла '.travis.yml' в корень репозитория, Travis CI получит уведомление о наличии изменений в проекте и автоматически запустит сборку.
Подробную информацию о ходе сборки и проверке анализатором можно увидеть в консоли.
После окончания тестов на почту будет отправлено 2 письма: одно с результатами статического анализа при сборке проекта с использованием 'gcc', а второе с использованием 'clang'.
CircleCI – облачный CI-сервис для автоматизации сборки, тестирования и публикации программного обеспечения. Поддерживает сборку проектов как в контейнерах, так и в виртуальных машинах с ОС Windows, Linux и macOS.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
При запуске сборки проекта CircleCI читает конфигурацию задачи из файла в репозитории по пути '.circleci/config.yml'.
Перед добавлением файла с конфигурацией необходимо добавить в проект переменные, содержащие лицензионные данные для анализатора. Для этого в левой панели навигации необходимо нажать 'Settings', потом в группе 'ORGANIZATION' выбрать пункт 'Projects' и нажать на шестерёнку справа от нужного проекта.
В открытом окне с настройками в разделе 'Environment Variables' создайте переменные 'PVS_LICENSE_NAME' и 'PVS_LICENSE_KEY', содержащие имя лицензии анализатора, привязанное к ключу, и лицензионный ключ для PVS-Studio.
Теперь создадим '.circleci/config.yml'.
Вначале необходимо указать образ виртуальной машины, на которой будет происходить сборка и анализ. Полный список образов доступен по ссылке.
version: 2.1
jobs:
build:
machine:
image: ubuntu-2204:currentДалее надо загрузить исходники проекта. А также, через менеджер пакетов, необходимо добавить репозитории и установить инструменты и зависимости проекта:
steps:
# Downloading sources from the Github repository
- checkout
# Setting up the environment
- run: sudo apt-get install -y cmake
- run: sudo apt-get update
- run: sudo apt-get install -y build-essentialДалее добавляется репозиторий PVS-Studio и устанавливается анализатор:
- run: wget -q -O - https://cdn.pvs-studio.com/etc/pubkey.txt
| sudo apt-key add –
- run: sudo wget -O /etc/apt/sources.list.d/viva64.list
https://cdn.pvs-studio.com/etc/viva64.list
- run: sudo apt-get -y update && sudo apt-get -y install pvs-studioЗарегистрировать лицензию анализатора можно следующей командой:
- run: pvs-studio-analyzer credentials -o PVS.lic ${PVS_LICENSE_NAME}
${PVS_LICENSE_KEY}Одним из возможных вариантов анализа (C++) является создание файла compile_commands.json при сборке проекта:
- run: mkdir build && cd build && cmake ..
-DCMAKE_EXPORT_COMPILE_COMMANDS=OnПосле получения файла compile_commands.json анализ производится следующей командой:
- run: pvs-studio-analyzer analyze -j2 -l PVS.lic -o PVS-Studio.log
-f ./build/compile_commands.json
--disableLicenseExpirationCheckПолученный файл с "сырыми" результатами работы анализатора необходимо сконвертировать в html-отчет:
- run: plog-converter -t html -o PVS-Studio.html PVS-Studio.logПосле завершения тестов отчеты анализатора сохраняются как артефакт:
- run: mkdir PVS_Result && cp PVS-Studio.* ./PVS_Result/
- store_artifacts:
path: ./PVS_ResultПолный текст '.circleci/config.yml':
version: 2.1
jobs:
build:
machine:
image: ubuntu-2204:current
steps:
# Downloading sources from the Github repository
- checkout
# Setting up the environment
- run: sudo apt-get install -y cmake
- run: sudo apt-get update
- run: sudo apt-get install -y build-essential
# Installation of PVS-Studio
- run: wget -q -O - https://cdn.pvs-studio.com/etc/pubkey.txt
| sudo apt-key add -
- run: sudo wget -O /etc/apt/sources.list.d/viva64.list
https://cdn.pvs-studio.com/etc/viva64.list
- run: sudo apt-get -y update && sudo apt-get -y install pvs-studio
# PVS-Studio license activation
- run: pvs-studio-analyzer credentials -o PVS.lic ${PVS_LICENSE_NAME}
${PVS_LICENSE_KEY}
# Building the project
- run: mkdir build && cd build && cmake ..
-DCMAKE_EXPORT_COMPILE_COMMANDS=On
# Running analysis. The compile_commands.json file obtained
# when building the project is used
- run: pvs-studio-analyzer analyze -j2 -l PVS.lic -o PVS-Studio.log
-f ./build/compile_commands.json
--disableLicenseExpirationCheck
# Converting the analyzer report to HTML format
- run: plog-converter -t html -o PVS-Studio.html PVS-Studio.log
# Creating a directory with analysis artifacts
# and copying analyzer reports (PVS-Studio.log and PVS-Studio.html)
# into it
- run: mkdir PVS_Result && cp PVS-Studio.* ./PVS_Result/
# Saving workflow artifacts
- store_artifacts:
path: ./PVS_ResultПосле загрузки сценария в репозиторий, CircleCI автоматически начнет сборку проекта.
По окончании работы сценария, файлы с результатами работы анализатора можно скачать через вкладку 'Artifacts'.
GitLab — это онлайн-сервис для управления репозиториями. Его можно использовать прямо в браузере на официальном сайте, зарегистрировав аккаунт, или установить и развернуть на собственном сервере.
Обратите внимание: вы можете посмотреть пример интеграции, приведённый в документации, на нашем демо-стенде в Gitlab.
В данной документации рассматривается пример интеграции PVS-Studio для анализа C# проекта на Linux. Команды запуска PVS-Studio для анализа C, C++ или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Как запустить PVS-Studio на Linux и macOS" и "Работа с ядром Java анализатора из командной строки".
При запуске задачи GitLab CI берёт инструкции из файла .gitlab-ci.yml. Его можно добавить либо кликнув на кнопку Set up CI/CD, либо создав в локальном репозитории и загрузив на сайт.
CI/CD пайплайны в Gitlab могут выполняться как на предоставленных машинах, так и в Docker-контейнерах. При этом Gitlab позволяет хранить образы контейнеров в регистре образов, находящемуся непосредственно в проекте. Мы воспользуемся этой возможностью для демонстрации работы с PVS-Studio.
Для начала создадим Dockerfile, в котором опишем процесс установки зависимостей для сборки и анализа проекта. В нашем случае демонстрация проводится на примере .NET проекта:
FROM ubuntu:24.04
RUN apt update && apt install gpg wget software-properties-common -y
RUN add-apt-repository ppa:dotnet/backports && apt install dotnet-sdk-9.0 -y
RUN wget -qO- https://files.pvs-studio.com/etc/pubkey.txt | \
gpg --dearmor -o /etc/apt/trusted.gpg.d/viva64.gpg \
&& wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list \
&& apt update && apt install pvs-studio pvs-studio-dotnet -yПосле подготовки Dockerfile необходимо собрать образ с корректным тегом и загрузить его в Registry проекта. Тэг должен включать url Gitlab, неймспейс и название проекта.
docker build -t registry.gitlab.com/namespace/name .
docker push registry.gitlab.com/namespace/nameПримечание: если использование контейнера не выглядит удобным, то установку анализатора можно произвести и в самом пайплайне.
Как говорилось выше, пайплайн будет исполнятся в ранее созданном Docker-контейнере. Отразим данный факт в тексте файла .gitlab-ci.yml. Помимо этого, укажем, что данный пайплан выполняется при Merge Request, коммитах в основную ветку и коммите тэгов. Также, опишем стадии пайплайна.
image: registry.gitlab.com/namespace/name
workflow:
rules:
- if: $CI_PIPELINE_SOURCE == 'merge_request_event'
- if: $CI_COMMIT_TAG
- if: $CI_COMMIT_BRANCH == $CI_DEFAULT_BRANCH
stages:
- build
- analyzeНаш демонстрационный проект собирается очень просто:
build:
stage: build
script:
- 'dotnet build'
После того, как мы убедились, что проект собирается, мы можем запустить его анализ с помощью анализатора PVS-Studio. Инструменты анализа уже установлены в контейнере, поэтому нам остаётся только ввести лицензию (которая заранее внесена в соответствующие переменные проекта), запустить анализ и провести необходимые трансформации отчёта.
analyze:
stage: analyze
needs: [build]
dependencies: []
script:
- 'pvs-studio-analyzer \
credentials $PVS_STUDIO_LICENSE_NAME $PVS_STUDIO_LICENSE_KEY'
- 'pvs-studio-dotnet -t dotnetcore.csproj -o pvs.json || :'
- 'plog-converter -t gitlab -a all -o pvs_codequality.json pvs.json'
- 'plog-converter -t html -a all -o pvs_report.html pvs.json'
- 'plog-converter -t totals -a all -o pvs_metrics.txt pvs.json'
artifacts:
expose_as: 'PVS-Studio report'
paths: ['pvs_report.html', 'pvs_metrics.txt']
reports:
codequality: pvs_codequality.jsonПеременные определяются в настройках по пути Settings > CI/CD > Variables.
Для ввода лицензии необходимо вызвать утилиту pvs-studio-analyzer с флагом credentials, в который передаются имя лицензии анализатора, привязанное к ключу, и ключ лицензии соответственно. Данные ключи можно хранить, например, в переменных проекта, как показано в нашем примере.
Обратите внимание, как анализатор (в нашем случае утилита pvs-studio-dotnet) создаёт файл pvs.json. Это отчёт анализатора. Далее он преобразовывается в другие форматы с помощью утилиты plog-converter — конвертатора отчётов PVS-Studio. Результирующие отчёты сохраняются в артефактах задачи для последующей демонстрации в Merge Request, для реализации Quality Gate, а также загружаются в Code Quality.
Следующий этап — использование результатов анализа PVS-Studio в качестве Quality Gate. Quality Gate — это механизм, который предназначен для контроля качества проекта через оценку различных метрик. В нашем случае метрикой выступает количество различных предупреждений, содержащихся в отчётах анализатора PVS-Studio.
quality_gate:
stage: analyze
needs: [analyze]
dependencies: [analyze]
script:
- read PVS_HIGH_LEVEL_COUNT PVS_MID_LEVEL_COUNT \
< <(grep "Total L1:" pvs_metrics.txt | \
sed -E 's/.*L1:([0-9]+) \+ L2:([0-9]+).*/\1 \2/')
- '[ "$PVS_HIGH_LEVEL_COUNT" -gt "$PVS_MAX_HIGH_LEVEL_COUNT" ] && \
{ echo "ERROR: Higl Level warnings number ($PVS_HIGH_LEVEL_COUNT)\
exceed maximum allowed ($PVS_MAX_HIGH_LEVEL_COUNT)"; exit 1; } || :'
- '[ "$PVS_MID_LEVEL_COUNT" -gt "$PVS_MAX_MID_LEVEL_COUNT" ] && \
{ echo "ERROR: Mid Level warnings number ($PVS_MID_LEVEL_COUNT) \
exceed maximum allowed ($PVS_MAX_MID_LEVEL_COUNT)"; exit 1; } || :'Мы используем файл pvs_metrics.txt, полученный на предыдущем этапе из изначального отчёта PVS-Studio. В нём содержится информация о количестве различных ошибок, найденных в проверяемом проекте. В этом примере мы получаем количество ошибок с уровнями High и Medium, после чего сравниваем их с заранее определёнными пороговыми значениями, которые хранятся в переменных проекта. Для реализации Quality Gate также рекомендуется использовать специализированные инструменты непрерывного мониторинга качества кода, например SonarQube.
Ранее мы уже рассмотрели процесс загрузки отчёта в Code Quality. Для этого использовалась утулита plog-converter:
plog-converter -t gitlab -a all -o pvs_codequality.json pvs.jsonПолучаемый из данной утилиты отчёт загружается в Code Quality как артефакт:
artifacts:
reports:
codequality: pvs_codequality.jsonРезультаты Code Quality можно посмотреть, например, из окна Merge Request:
В нём будут показываться новые и исправленные предупреждения анализатора.
Список всех предупреждений можно посмотреть в отчёте в html-формате, также полученном с помощью утилиты plog-converter:
plog-converter -t html -a all -o pvs_report.html pvs.jsonЭтот отчёт далее сохраняется как артефакт и прикрепляется ссылкой к Merge Request через expose_as:
artifacts:
expose_as: 'PVS-Studio report'
paths: ['pvs_report.html', 'pvs_metrics.txt']Gitlab позволяет получить дельту изменённых файлов. Для этого можно использовать следующий код:
get_file_changes:
stage: analyze
script:
- |
if [ "$CI_PIPELINE_SOURCE" = "merge_request_event" ]; then
BASE=$CI_MERGE_REQUEST_TARGET_BRANCH_SHA
else
BASE=$CI_COMMIT_BEFORE_SHA
if [ "$BASE" = "0000000000000000000000000000000000000000" ]; then
BASE=$(git rev-parse HEAD~1)
fi
fi
- |
'git diff-tree --no-commit-id --name-only -r $BASE -r $CI_COMMIT_SHA
-- "*.cs" > changed_files.txt'
artifacts:
paths:
- changed_files.txtВажно отметить, что в зависимости от типа события, запустившего пайплайн, способ получения дельты файлов будет отличаться.
Полученные файлы можно использовать на последующих этапах, так как анализатор PVS-Studio поддерживает анализ списка файлов. В случае с проектами на C#, вызова анализатора будет выглядеть следующим образом:
if [ -s changed_files.txt ]; then
pvs-studio-dotnet -t dotnetcore.csproj -f changed_files.txt -o pvs.json || :
else
echo "{ \"version\": 3, \"warnings\": [] }" > pvs.json
fiПодробнее о режиме проверки списка файлов можно прочитать в нашей документации.
SourceCraft — платформа, с помощью которой можно разрабатывать исходный код, управлять версиями, тестировать, собирать, развёртывать и сопровождать программные продукты. Сервис представляет собой систему управления репозиториями кода для Git с отслеживанием ошибок и пайплайном CI/CD.
В документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Подробности в соответствующих разделах документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
Сначала необходимо включить сканирование кода. Для этого нужно перейти в раздел Настройки репозитория > Безопасность. Подробнее про настройку SourceCraft написано в документации.
После необходимо добавить новый Workflow. Для этого добавьте YAML-скрипт в директорию .sourcecraft/.workflows репозитория. После этого каждый коммит и каждый новый pull request в ветку по умолчанию будут автоматически проверяться.
Рассмотрим следующий пример скрипта ci.yaml, который позволяет полностью проверить проект с помощью PVS-Studio:
on:
pull_request:
- workflows: [ pvs-studio-pipeline ]
filter:
source_branches: [ "**" ]
target_branches: [ "main", "develop" ]
push:
- workflows: [ pvs-studio-pipeline ]
filter:
branches: [ "main", "develop" ]
workflows:
pvs-studio-pipeline:
tasks:
- name: pvs-studio-cpp-analysis
cubes:
- name: run-pvs-studio-analysis
image:
name: sourcecraft/pvs-studio-cpp
script:
- |
cd $SOURCECRAFT_WORKSPACE
# Ввод лицензии PVS-Studio
pvs-studio-analyzer credentials $PVS_STUDIO_CREDENTIALS
# Сборка проекта
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -B build .
cmake --build build -j
# Запуск анализа PVS-Studio
pvs-studio-analyzer analyze -f build/compile_commands.json -j
# Конвертация отчет в формат SARIF
plog-converter -t sarif \
-o $SOURCECRAFT_WORKSPACE/result.sarif \
-r $SOURCECRAFT_WORKSPACE \
-R toRelative \
PVS-Studio.log
env:
PVS_STUDIO_CREDENTIALS: ${{ secrets.PVS_STUDIO_CREDENTIALS }}
# Загрузка результатов работы анализатора
- name: upload-sarif-to-sourcecraft
image:
name: sourcecraft/scan-result-uploader:0.6.0
script:
- export APPSEC_CUSTOM_ENGINE_NAME="PVS-Studio"
- export APPSEC_CUSTOM_ENGINE_TYPE="SAST"
- /app/bin/scan-result-uploaderПоле workflows описывает, какие процессы будут запущены.
Поле target_branches хранит целевые ветки.
Поле pull_request означает, что анализ будет запускаться при открытии/обновлении pull request.
Поле push означает, что анализ запустится при прямом коммите в ветки. Также можно настроить, чтобы анализ осуществлялся по расписанию с помощью поля schedule.
Поле name задаёт название шага.
Далее идёт последовательность шагов script, которые выполняют некоторые действия или последовательность команд оболочки.
После установки нужно ввести лицензию PVS-Studio. Для её активации используется шифрованная переменная PVS_STUDIO_CREDENTIALS, которая содержит имя и ключ лицензии.
Чтобы создать секрет, перейдите во вкладку Настройки репозитория > Секреты и нажмите кнопку Новый секрет.
Шаг pvs-studio-cpp-analysis запускает анализатор PVS-Studio и сохраняет отчёт в формате SARIF в $SOURCECRAFT_WORKSPACE/result.sarif.
pvs-studio-analyzer analyze -f build/compile_commands.json -j
plog-converter -t sarif -o $SOURCECRAFT_WORKSPACE/result.sarif PVS-Studio.log
-r $SOURCECRAFT_WORKSPACE -R toRelativeБолее подробно о параметрах запуска pvs-studio-analyzer описано в документации, а о параметрах plog-converter в этой документации.
Шаг upload-sarif-to-sourcecraft загружает результаты работы анализатора на платформу. Результат анализа можно посмотреть на вкладке Безопасность > Анализ кода.
Для ручного запуска пайплайна нужно написать скрипт в файл ci.yaml или использовать скрипт, описанный выше. После этого перейти в раздел Автоматизации > CI/CD и нажать кнопку Новый запуск. После этого произойдёт запуск пайплайна.
В разделе Анализ кода можно отфильтровать срабатывания по статусу:
Важности:
И типу сканера. Для этого нужно выбрать необходимые параметры в строке фильтра.

При нажатии на конкретное предупреждение анализатора откроется подробное описание проблемы с выделением соответствующего фрагмента кода, где была обнаружена потенциальная ошибка или уязвимость.
Также здесь можно перейти к исправлению ошибки, нажав на кнопку Редактировать, и написать комментарий по работе со срабатыванием.
В случае, если срабатывание оказалось ложным, можно отметить его. Для этого нужно нажать на кнопку Решить и отметить срабатывание ложным.
После подтверждения появится запись об изменении статуса срабатывания.
GitHub Actions — это платформа, позволяющая решать CI/CD задачи, связанные с кодом в репозиториях GitHub. При помощи скриптованных Workflows она автоматизирует реакции на события, происходящие в репозитории. Это позволяет автоматически проверять собираемость проекта и проводить тестирование сразу, как только в репозиторий добавляют новый код. Средой выполнения рабочих нагрузок могут выступать как облачные виртуальные машины, так и локальные агенты с предоставленной вами конфигурацией.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
Для того чтобы создать новый Workflow, нужно добавить YAML скрипт в директорию '.github/workflows' репозитория.
Рассмотрим следующий пример скрипта 'build-analyze.yml', который позволяет полностью проверить проект в PVS-Studio:
name: PVS-Studio build analysis
on: workflow_dispatch
jobs:
build-analyze:
runs-on: ubuntu-latest
steps:
- name: Check out repository code
uses: actions/checkout@v4
- name: Install tools
run: |
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt \
| sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
sudo apt update
sudo apt install pvs-studio
pvs-studio-analyzer credentials ${{ secrets.PVS_STUDIO_CREDENTIALS }}
- name: Build
run: |
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -B build .
cmake --build build -j
- name: Analyze
run: |
pvs-studio-analyzer analyze -f build/compile_commands.json -j
- name: Convert report
run: |
plog-converter -t sarif -o pvs-report.sarif PVS-Studio.log
- name: Publish report
uses: github/codeql-action/upload-sarif@v3
with:
sarif_file: pvs-report.sarif
category: PVS-StudioПоле 'name' в начале задаёт имя текущего Workflow, которое будет отображаться в интерфейсе GitHub.
Поле 'on' определяет, при каком событии Workflow должен запуститься. Значение 'workflow_dispatch' указывает, что задача запускается вручную. Чтобы её запустить, нужно нажать кнопку 'Run workflow' у соответствующего Workflow.
Поле 'runs-on' указывает, на какой системе должна выполняться задача. GitHub Actions предоставляет облачные серверы на системах Windows, Linux, macOS. В данном случае используется Ubuntu.
Далее идёт последовательность шагов 'steps', которые выполняют некоторые действия или последовательность команд оболочки.
Шаг 'Check out repository code' скачивает текущую версию кода репозитория.
Шаг 'Install tools' устанавливает и активирует PVS-Studio регистрационными данными в систему. Для активации PVS-Studio используется шифрованная переменная 'secrets.PVS_STUDIO_CREDENTIALS', которая содержит имя и ключ лицензии.
Чтобы создать секрет, перейдите во вкладку 'Settings > Secrets > Actions' и нажмите кнопку 'New repository secret'.
Создайте новую переменную с именем и ключом лицензии. GitHub сохранит её в зашифрованном виде, после чего её нельзя будет посмотреть. Даже в выводе консоли текст переменной будет видоизменен.
Шаг 'Build' выполняет сборку проекта, в данном случае при помощи CMake. Также в нем генерируется файл 'compile_commands.json', который используется анализатором для определения целей анализа.
Шаг 'Analyze' запускает анализ проекта и сохраняет результат в виде внутреннего представления в файл по умолчанию 'PVS-Studio.log'.
Более подробно о параметрах запуска pvs-studio-analyzer смотрите в документации.
Шаг 'Convert report' преобразует отчёт анализатора в требуемое представление, в данном случае – SARIF. Утилита plog-converter позволяет преобразовывать, объединять отчёты с разных запусков анализа и фильтровать сообщения в них.
Наконец, шаг 'Publish report' публикует итоговый отчёт, после чего его можно просмотреть во вкладке 'Security'.
Для того чтобы анализировать изменения файлов сразу после того, как они были отправлены в репозиторий, создайте новый скрипт 'analyze-changes.yml'.
name: PVS-Studio analyze changes
on:
push:
paths:
- '**.h'
- '**.c'
- '**.cpp'
jobs:
analyze-changes:
runs-on: ubuntu-latest
steps:
- name: Check out repository code
....
- name: Get list of changed source files
run: |
echo "$(git diff --name-only \
${{ github.event.before }}..${{ github.event.after }})" \
> source-files.txt
cat source-files.txt
- name: Install tools
....
- name: Build
run: |
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -B build .
cmake --build build -j
- name: Analyze
run: |
pvs-studio-analyzer analyze -f build/compile_commands.json \
-S source-files.txt -j
- name: Convert report
....
- name: Publish report
....В нём используется событие запуска 'push', которое стартует, когда в репозитории происходят изменения. При этом в нём заданы фильтры путей 'paths', чтобы анализ запускался только при изменении файлов с исходным кодом.
Шаг 'Get list of changed source files' для шага 'Analyze' получает список изменившихся файлов, которые необходимо проанализировать.
Сборка проекта при этом происходит на случай, если в нём есть генерируемые файлы, содержимое которых появляется только в процессе сборки.
Используя средства GitHub Actions, возможно реализовать самые разные сценарии, в том числе при изменениях не только в главной ветке, но и в других ветках или Pull Request'ах.
Чтобы GitHub начал анализировать SARIF-файлы, сначала необходимо настроить репозиторий. Открываем свой репозиторий и нажимаем на раздел Security.

Находим пункт Code scanning alerts и нажимаем на кнопку Set up code scanning.
Далее нажимаем на пункт Set up this workflow.
Теперь нужно изменить скрипт анализа. Чтобы участки кода, на которые выдано срабатывание, корректно отображались в разделе Security, перед публикацией SARIF-отчёта нужно преобразовать его пути в относительные при помощи утилиты plog-converter. Для этого нужно использовать флаг --pathTransformationMode (или -R) и --srcRoot (или -r). Подробнее о параметрах утилиты plog-converter можно прочитать здесь. Пример конвертации отчёта:
- plog-converter report.log -t json -n relative -R toRelative -r $PWD
- plog-converter relative.json -t sarif -n PVSSarif -r file://Полные скрипты анализа будет выглядеть так:
name: PVS-Studio build analysis
on: workflow_dispatch
jobs:
build-analyze:
runs-on: ubuntu-latest
steps:
- name: Check out repository code
uses: actions/checkout@v4
- name: Install tools
run: |
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt \
| sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
sudo apt update
sudo apt install pvs-studio
pvs-studio-analyzer credentials ${{ secrets.PVS_STUDIO_CREDENTIALS }}
- name: Build
run: |
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On -B build .
cmake --build build -j
- name: Analyze
run: |
pvs-studio-analyzer analyze -f build/compile_commands.json -j
- name: Convert report
run: |
plog-converter PVS-Studio.log -t json -n relative
-R toRelative -r $PWD
plog-converter relative.json -t sarif -n pvs-report -r file://
- name: Publish report
uses: github/codeql-action/upload-sarif@v3
with:
sarif_file: pvs-report.sarif
category: PVS-StudioПосле исполнения задачи можно будет посмотреть срабатывания статического анализатора в разделе Security.
Кликнув на срабатывание анализатора, можно посмотреть участок кода, на котором есть потенциальная ошибка.
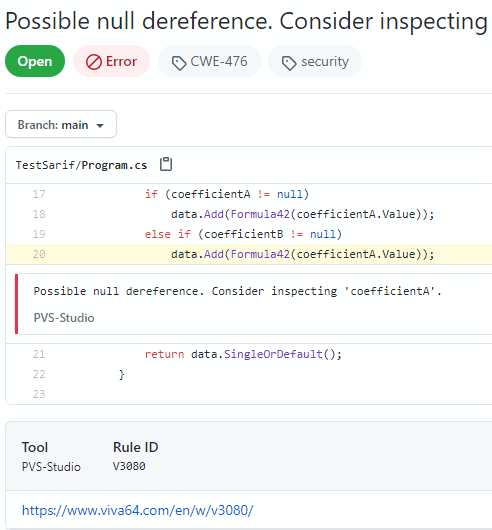
GitFlic — сервис для хранения исходного кода и работы с ним. Основан на системе контроля версий Git.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
При запуске задачи CI/CD используется инструкция из файла 'gitflic-ci.yaml'. Его можно добавить, кликнув на ссылку 'создайте новый', либо создав в локальном репозитории и загрузив на сайт. Воспользуемся первым вариантом. Перейдя по ссылке, нажмём кнопку 'Использовать':
После этого откроется базовый шаблон, который мы отредактируем для интеграции статического анализатора PVS-Studio. Составим пример скрипта работы на примере С++ проекта:
Сперва нужно установить зависимости и утилиты для сборки проекта:
- apt install cmake
- apt-get install gcc
- apt-get install doxygenТеперь установим анализатор PVS-Studio.
- wget -O - https://files.pvs-studio.com/etc/pubkey.txt
| apt-key add -
- wget -O /etc/apt/sources.list.d/viva64.list
https://files.pvs-studio.com/etc/viva64.list
- apt-get update && apt-get -y install pvs-studio
- pvs-studio-analyzer credentials $PVS_LICENSE_NAME $PVS_LICENSE_KEYЗдесь PVS_LICENSE_NAME и PVS_LICENSE_KEY — переменные для имени лицензии анализатора, привязанного к ключу, и лицензионного ключа PVS-Studio, значения которых задаются в настройках репозитория. Чтобы установить их, перейдём в Настройки -> Настройки CI/CD -> Переменные для задачи.
Сборка проекта осуществляется с cmake:
- cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On .Далее запускается анализатор:
- pvs-studio-analyzer analyze -o report.logЧтобы отобразить результаты анализа во вкладке Безопасность, их необходимо сконвертировать в формат .sarif при помощи утилиты plog-converter. Также необходимо перевести пути к файлам в относительные, чтобы файлы корректно отображались в разделе ошибок. Для этого нужно использовать флаг --pathTransformationMode (или -R) и --srcRoot (или -r). Подробнее о параметрах утилиты plog-converter можно прочитать здесь.
- plog-converter report.log -t json -n relative -a \
"GA:1,2,3;OP:1,2,3,;OWASP:1,2,3" -R toRelative -r $PWD
- plog-converter relative.json -t sarif -a \
"GA:1,2,3;OP:1,2,3,;OWASP:1,2,3" -n PVSSarif -r file://Отчёт можно выгрузить при помощи артефактов, он сразу отобразится в разделе Безопасность.
artifacts:
reports:
sast:
paths:
- 'PVSSarif.sarif'Полное содержание файла gitflic-ci.yaml:
analyze-job:
stage: build
scripts:
- apt install cmake
- apt-get install gcc
- apt-get install doxygen
- wget -O - https://files.pvs-studio.com/etc/pubkey.txt | apt-key add -
- wget -O /etc/apt/sources.list.d/viva64.list
https://files.pvs-studio.com/etc/viva64.list
- apt-get update && apt-get -y install pvs-studio
- pvs-studio-analyzer credentials ${PVS_LICENSE_NAME} ${PVS_LICENSE_KEY}
- cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On .
- pvs-studio-analyzer analyze -o report.log
- plog-converter report.log -t json -n relative -R toRelative -r $PWD
- plog-converter relative.json -t sarif -n PVSSarif -r file://
artifacts:
reports:
sast:
paths:
- 'PVSSarif.sarif'После этого в разделе Безопасность откроется отчёт об ошибках.
В данном разделе можно выбрать необходимое срабатывание и подробнее изучить его.
При нажатии на кнопки Подробнее можно увидеть полную информацию о срабатывании.
TRON.ASOC — платформа для автоматизации безопасной разработки. Помогает обнаруживать, анализировать и устранять уязвимости на этапах разработки и эксплуатации.
Рассмотрим пример интеграции отчёта анализатора PVS-Studio в TRON.ASOC.
Для начала нужно добавить проект в разделе Проекты, заполнив обязательные поля.
После этого необходимо выбрать инструмент безопасности. Для этого переходим в раздел Интеграции > Инструменты безопасности и нажимаем кнопку Добавить инструмент безопасности. В поле Инструмент выбираем PVS-Studio.
Далее перейдём в раздел Источники сканирования. Здесь нужно выбрать источник проекта. Важно: в поле Источник нужно выбрать CLI Tool Custom Source.
Для отслеживания метрик анализа можно добавить контроль качества. Для этого необходимо перейти в раздел Контроль качества. Можно выбрать метрику и настроить количество срабатываний для её оценки.
Перейдём к загрузке отчёта проекта. Для этого необходимо сконвертировать отчёт в формат .sarif при помощи утилиты plog-converter.
plog-converter report.json -t sarifПодробнее про утилиту plog-converter описано в документации.
После конвертации отчёта необходимо на платформе перейти в раздел Проекты и выбрать нужный проект. После этого выбрать раздел Обзор > Слои проекта.
Далее добавляем слой проекта. Название и Тип слоя выбираем в зависимости от проекта. В поле Контроль качества выбираем ранее созданное правило.
Созданное правило будет выглядеть так:
Чтобы запустить сканирование, добавим проверку безопасности. В открывшейся форме указываем созданный инструмент и источник сканирования.
Теперь можно нажать кнопку Начать новое сканирование. Для загрузки отчёта рассмотрим два варианта.
Нужно нажать на три точки рядом с проверкой безопасности и в появившемся меню выбрать пункт Импортировать результаты.
После этого выбираем файл отчёта с расширением .sarif. После загрузки отчёт появится в разделе Результаты сканирования. Для просмотра всех срабатываний перейдём в раздел Проблемы безопасности. Выбрав любое срабатывание, можно просмотреть более подробную информацию о нём.
Вернёмся в раздел Слои проекта. Выберем в меню Редактировать проверку безопасности. Здесь рассмотрим подробнее пункт Конечная точка API проверки безопасности. Для загрузки отчёта с помощью API нужно использовать эту команду:
curl --location 'http://you_host'
--header 'x-api-token: '
--header 'content-type: application/json'
--data @"path_to_sarif"Она приведена в примере для подключения конечной точки API. Также ниже указана ссылка для создания API-токена.
При создании токена нужно указать его название и срок действия.
После того как получен токен, можно перейти к загрузке отчёта. Для этого нужно вернуться в раздел Слои проекта и нажать на кнопку Начать новое сканирование. И в командной строке прописать полученную команду. После загрузки отчёт появится в разделе Результаты сканирования. Чтобы просмотреть все срабатывания, откроем раздел Проблемы безопасности. Выберем любое срабатывание, чтобы получить более подробную информацию о нём.
Результаты анализа содержат поля Статус и Ответственный. В поле Статус можно выбрать, к какому состоянию принадлежит срабатывание, например установить In progress.
В поле ответственный можно выбрать, кому назначить работу над этим срабатыванием. Подробнее про возможности обработки результатов анализа можно узнать в документации платформы TRON.ASOC.
Для начала создаем инструмент уведомления. Необходимо перейти в раздел Интеграции > Инструменты уведомлений. Для добавления нового инструмента нужно заполнить данные на форме. А также можно проверить подключение, нажав на соответствующую кнопку.
После добавления инструмента оповещения перейдем в раздел Правила реагирования для продолжения настройки. Для добавления правила нужно нажать на кнопку Добавить правило реагирования.
Далее необходимо заполнить параметры правила. Подробнее с параметрами правил можно ознакомиться в документации.
После настройки вернемся в раздел Проблемы безопасности. Появилась возможность оповестить пользователя о назначенном срабатывании. Для этого его необходимо выбрать в поле Ответственный.
Azure DevOps – облачная платформа, предоставляющая возможность разработки, выполнения приложений и хранения данных на удаленных серверах. В состав платформы входят инструменты Azure Pipeline, Azure Board, Azure Artifacts и другие, позволяющие ускорить процесс создания программного обеспечения и повысить его качество.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C# кода. Команды запуска PVS-Studio для анализа C, C++ или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Кроссплатформенная проверка C и C++ проектов в PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
Рассмотрим пример для интеграции анализа в сборку проекта.
Перейдите в раздел 'Pipelines -> Builds' и создайте новый Build pipeline.
Укажите источник проекта. Например, GitHub.
Авторизуйте приложение Azure Pipelines и укажите репозиторий с проектом.
В окне выбора шаблона укажите 'Starter pipeline'.
Запустить статический анализ кода проекта можно, используя Microsoft-hosted либо self-hosted агенты.
Microsoft-hosted агенты представляют собой обычные виртуальные машины, которые запускаются при запуске Pipeline и удаляются после завершения задачи. Использование таких агентов позволяет не тратить время на их поддержку и обновление.
Заменим сценарий сборки по умолчанию следующим образом:
# Настройка триггеров запуска. Запуск для изменений только в master-ветке
trigger:
- master
# Так как установка произвольного ПО в виртуальные машины
# запрещена, воспользуемся Docker-контейнером,
# запущенном в виртуальной машине с Windows Server 1803
pool:
vmImage: 'win1803'
container: microsoft/dotnet-framework:4.7.2-sdk-windowsservercore-1803
steps:
# Загрузка дистрибутива анализатора
- task: PowerShell@2
inputs:
targetType: 'inline'
script: 'Invoke-WebRequest
-Uri https://files.pvs-studio.com/PVS-Studio_setup.exe
-OutFile PVS-Studio_setup.exe'
- task: CmdLine@2
inputs:
workingDirectory: $(System.DefaultWorkingDirectory)
script: |
# Восстанавливаем проект и скачиваем зависимости
nuget restore .\ShareX.sln
# Создаем директорию, куда будут сохранены файлы с отчетами анализатора
md .\PVSTestResults
# Устанавка анализатора
PVS-Studio_setup.exe /VERYSILENT /SUPPRESSMSGBOXES
/NORESTART /COMPONENTS=Core
# Регистрация лицензионной информации
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe"
credentials
-u $(PVS_LICENSE_NAME)
-n $(PVS_LICENSE_KEY)
# Запуск анализа PVS-Studio
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe"
-t .\ShareX.sln
-o .\PVSTestResults\ShareX.plog
# Преобразование отчета в html формат.
"C:\Program Files (x86)\PVS-Studio\PlogConverter.exe"
-t html
-o .\PVSTestResults\
.\PVSTestResults\ShareX.plog
# Публикация отчетов анализатора
- task: PublishBuildArtifacts@1
inputs:
pathToPublish: PVSTestResults
artifactName: PVSTestResultsДалее нужно добавить переменные, которые используются для создания файла лицензии. Для этого откройте окно редактирования Pipeline, и в правом верхнем углу нажмем кнопку 'Variables'.
Добавьте переменные – 'PVS_LICENSE_NAME' и 'PVS_LICENSE_KEY', содержащие имя лицензии анализатора, привязанное к ключу, и лицензионный ключ соответственно. При создании переменной 'PVS_LICENSE_KEY' не забудьте отметить пункт 'Keep this value secret' для шифрования значения переменной, а также подавления вывода значения переменной в лог выполнения задачи.
Для проверки запустите Pipeline кнопкой 'Run'.
Второй вариант запуска анализа – использовать self-hosted агент. Self-hosted агенты - это агенты, настраиваемые и управляемые самостоятельно. Такие агенты дают больше возможностей для установки программного обеспечения, которое необходимо для сборки и тестирования программного продукта.
Перед использованием таких агентов их необходимо настроить согласно инструкции, а также установить и настроить статический анализатор.
Для запуска задачи на self-hosted агенте заменим предлагаемую конфигурацию по умолчанию на следующую:
# Настройка триггеров запуска. Анализ для master-ветки
trigger:
- master
# Задача запускается на self-hosted агенте из пула 'MyPool'
pool: 'MyPool'
steps:
- task: CmdLine@2
inputs:
workingDirectory: $(System.DefaultWorkingDirectory)
script: |
# Восстанавливаем проект и скачиваем зависимости
nuget restore .\ShareX.sln
# Создаем директорию, куда будут сохранены файлы с отчетами анализатора
md .\PVSTestResults
# Запуск анализа PVS-Studio.
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe"
-t .\ShareX.sln
-o .\PVSTestResults\ShareX.plog
# Преобразование отчета в html формат.
"C:\Program Files (x86)\PVS-Studio\PlogConverter.exe"
-t html
-o .\PVSTestResults\
.\PVSTestResults\ShareX.plog
# Публикация отчетов анализатора
- task: PublishBuildArtifacts@1
inputs:
pathToPublish: PVSTestResults
artifactName: PVSTestResultsПосле выполнения задачи, архив с отчетами анализатора можно скачать во вкладке 'Summary', либо можно воспользоваться расширением Send Mail, позволяющим настроить отправку электронной почты.
Если вы хотите, чтобы при наличии предупреждений анализатора сборочный шаг завершился и выдал сообщение об ошибке, вы можете использовать утилиту PlogConverter. С помощью PlogConverter можно задать порог, при котором будет происходить остановка работы. Далее приведен пример кода по добавлению в конец конфигурации шага остановки:
- task : PowerShell@2
inputs:
targetType: 'inline'
script: |
& "C:\Program Files (x86)\PVS-Studio\PlogConverter.exe" -t json -a GA:1
-o .\PVSTestResults\ .\PVSTestResults\TestTask.plog
--indicateWarnings --noHelpMessages
IF ($LASTEXITCODE -eq 0) {exit 0} ELSE {Write-Host
"##vso[task.logissue type=error]Analysis log contains High level warnings.";
Write-Host "##vso[task.complete result=Failed;]"; exit 0 }Что бы изменить тип предупреждений, на которые будет реагировать задача, воспользуйтесь флагом --analyzer (-a) утилиты PlogConverter.
Для просмотра отчета анализатора на странице результатов выполнения можно воспользоваться расширением SARIF SAST Scans Tab.
Чтобы конвертировать отчет в формат SARIF и воспользоваться расширением, добавьте следующие шаги:
- task: CmdLine@2
inputs:
workingDirectory: $(System.DefaultWorkingDirectory)
script: "C:\Program Files (x86)\PVS-Studio\PlogConverter.exe" -t sarif
-o .\PVSTestResults\ .\PVSTestResults\TestTask.plog
- task: PublishBuildArtifacts@1
inputs:
PathtoPublish: .\PVSTestResults\TestTask.plog.sarif
ArtifactName: CodeAnalysisLogsПосле выполнения задачи на странице с результатами во вкладке Scans будет добавлен отчет анализатора.
AppVeyor — web-сервис непрерывной интеграции. Он предназначен для сборки и тестирования ПО, расположенного на GitHub и ряде других сервисов хранения исходного кода.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
Необходимо задать переменные окружения, с помощью которых сформируется файл лицензии. Для этого необходимо перейти в интересующий проект, открыть вкладку 'Settings', в появившейся боковой панели перейти на вкладку 'Environment'. Далее нужно добавить две переменные —'PVS_LICENSE_NAME' и 'PVS_LICENSE_KEY':
Они будут содержать лицензионный ключ и имя пользователя анализатора, привязанное к ключу, соответственно. Эти переменные необходимы для проверки лицензии анализатора.
Чтобы запустить анализ, необходимо добавить скрипт. Для этого на панели настроек нужно перейти на вкладку 'Tests', в появившемся окне нажать 'Script':
В появившуюся форму нужно добавить код:
sudo apt-get update && sudo apt-get -y install jq
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt \
| sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
sudo apt-get update && sudo apt-get -y install pvs-studio
pvs-studio-analyzer credentials $PVS_LICENSE_NAME $PVS_LICENSE_KEY
PWD=$(pwd -L)
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck
plog-converter -t errorfile PVS-Studio.log --cerr -wПримечание. Присваивание значения команды 'pwd' переменной '$PWD' необходимо для корректной работы анализатора, поскольку AppVeyor модифицирует переменную для своих служебных целей в другое значение.
Результат анализа проекта будет сохранён в файл 'PVS-Studio.errorfile'.
Документация по использующимся утилитам:
Для анализа pull requests необходимо произвести дополнительные настройки.
На вкладке 'General' нужно включить сохранение кэша для сборки Pull Requests (checkbox находится внизу страницы):
Далее необходимо прейти на вкладку 'Environment', где нужно указать папку для кэширования (поле для добавления находится внизу страницы):
Без данной настройки проект будет анализироваться целиком.
Чтобы запустить анализ, необходимо добавить скрипт. Для этого на панели настроек нужно перейти на вкладку 'Tests', в появившемся окне нажать 'Script':
В появившуюся форму нужно добавить код:
sudo apt-get update && sudo apt-get -y install jq
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt \
| sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
sudo apt-get update && sudo apt-get -y install pvs-studio
pvs-studio-analyzer credentials $PVS_LICENSE_NAME $PVS_LICENSE_KEY
PWD=$(pwd -L)
if [ "$APPVEYOR_PULL_REQUEST_NUMBER" != '' ]; then
PULL_REQUEST_ID="pulls/$APPVEYOR_PULL_REQUEST_NUMBER"
MERGE_BASE=`wget -qO - \
https://api.github.com/repos/${APPVEYOR_REPO_NAME}/${PULL_REQUEST_ID} \
| jq -r ".base.ref"`
git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck \
--dump-files --dump-log pvs-dump.log \
-S .pvs-pr.list
else
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck
fi
plog-converter -t errorfile PVS-Studio.log --cerr -wПримечание. Присваивание значения команды 'pwd' переменной '$PWD' необходимо для корректной работы анализатора, поскольку AppVeyor модифицирует переменную для своих служебных целей в другое значение.
Если анализируется pull request, то будет получена разница между ветками. После этого запустится анализ для изменённых файлов. В противном случае проект будет проанализирован полностью.
Результат анализа проекта будет сохранён в файл 'PVS-Studio.errorfile'.
Документация по использующимся утилитам:
С документацией по анализу pull/merge requests можно ознакомиться здесь.
Buddy — платформа, позволяющая автоматизировать сборку, тестирование и публикацию программного обеспечения. Поддерживает сервисы хостинга: GitHub, Bitbucket, GitLab.
В данной документации рассматривается пример по интеграции PVS-Studio для анализа C и C++ кода. Команды запуска PVS-Studio для анализа C# или Java кода будут отличаться. Смотрите соответствующие разделы документации: "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio" и "Работа с ядром Java анализатора из командной строки".
В первую очередь необходимо создать pipeline, в котором будет запускаться анализ. Для этого нужно перейти в настройки проекта, после чего нажать 'New pipeline':
В появившемся окне необходимо указать конфигурацию, название pipeline'а и условие для его запуска. После внесения данных нужно нажать 'Add pipeline':
Для анализа pull requests в качестве триггера необходимо выбрать 'On events'. Событие для срабатывания — 'Git create branch, tag or PR'. Далее необходимо прейти в настройки триггера, где на вкладке 'Wildcard' нужно добавить 'all pull requests':
После создания pipeline'а нужно указать компилятор, который будет использоваться для сборки проекта. Разберём на примере GCC, написав его название в поиск:
В списке найденных компиляторов выберите нужный.
После выбора компилятора необходимо задать переменные окружения, с помощью которых будет сформирован файл лицензии. Для этого нужно нажать на 'Variables' и добавить переменные 'PVS_LICENSE_NAME' и 'PVS_LICENSE_KEY', которые будут содержать имя лицензии анализатора, связанной с ключом, и лицензионный ключ соответственно:
Необходимо перейти на вкладку 'Docker' и нажать 'Package & Tools':
В появившуюся форму нужно ввести команды установки анализатора:
apt-get update && apt-get -y install wget gnupg jq
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt | apt-key add -
wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
apt-get update && apt-get -y install pvs-studioДля анализа всего проекта необходимо перейти на вкладку 'Run':
В появившуюся форму нужно ввести команды запуска анализатора:
pvs-studio-analyzer credentials $PVS_LICENSE_NAME $PVS_LICENSE_KEY
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck
plog-converter -t errorfile PVS-Studio.log --cerr -wПосле внесения данных необходимо нажать 'Add this action'.
При выполнении данного pipeline'а сформируется отчёт с результатом анализа. Он будет сохранён в файл 'PVS-Studio.errorfile'.
Документация по использующимся утилитам:
Для анализа pull requests необходимо перейти на вкладку 'Run'.
В появившуюся форму нужно ввести команды анализа pull/merge requests:
pvs-studio-analyzer credentials $PVS_LICENSE_NAME $PVS_LICENSE_KEY
if [ "$BUDDY_EXECUTION_PULL_REQUEST_NO" != '' ]; then
PULL_REQUEST_ID="pulls/$BUDDY_EXECUTION_PULL_REQUEST_NO"
MERGE_BASE=`wget -qO - \
https://api.github.com/repos/${BUDDY_REPO_SLUG}/${PULL_REQUEST_ID} \
| jq -r ".base.ref"`
git fetch origin
git diff --name-only HEAD origin/$MERGE_BASE > .pvs-pr.list
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck \
-S .pvs-pr.list
else
pvs-studio-analyzer analyze -j8 \
-o PVS-Studio.log \
--disableLicenseExpirationCheck
fi
plog-converter -t errorfile PVS-Studio.log --cerr -wПосле внесения данных необходимо нажать 'Add this action'.
При выполнении данного pipeline'а сформируется отчёт с результатом проверки изменённых файлов. Он будет сохранён в 'PVS-Studio.errorfile'.
Документация по использующимся утилитам:
С документацией по анализу pull/merge requests можно ознакомиться здесь.
Утилита blame-notifier предназначена для автоматизации процесса оповещения разработчиков, заложивших в репозиторий код, на который анализатор PVS-Studio выдал предупреждения. Отчет анализатора подается на вход blame-notifier с указанием дополнительных параметров; утилита находит файлы, в которых были обнаружены предупреждения и формирует HTML-отчет на каждого "виновного" разработчика. Также возможен вариант рассылки полного отчета: внутри него будут содержаться все предупреждения, относящиеся к каждому "виновному" разработчику.
Утилита blame-notifier доступна только при наличии Enterprise лицензии. Вы можете запросить пробную Enterprise лицензию здесь.
Примечание. Название утилиты различается под разными платформами. Под Windows она имеет название BlameNotifier.exe, под Linux и macOS - blame-notifier. Если речь не идёт про утилиту под конкретную ОС, во избежание дублирования в данном документе используется название blame-notifier.
Для работы утилиты blame-notifier под Linux и macOS требуется .NET Runtime 8.0.
Утилиту BlameNotifier можно найти в установочной директории PVS-Studio (по умолчанию это путь "C:\Program Files (x86)\PVS-Studio\").
Для debian-based систем:
wget -q -O - https://files.pvs-studio.com/etc/pubkey.txt | \
sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://files.pvs-studio.com/etc/viva64.list
sudo apt-get update
sudo apt-get install blame-notifierДля yum-based систем:
wget -O /etc/yum.repos.d/viva64.repo \
https://files.pvs-studio.com/etc/viva64.repo
yum update
yum install blame-notifierДля zypper-based систем:
wget -q -O /tmp/viva64.key https://files.pvs-studio.com/etc/pubkey.txt
sudo rpm --import /tmp/viva64.key
sudo zypper ar -f https://files.pvs-studio.com/rpm viva64
sudo zypper update
sudo zypper install blame-notifierПрямые ссылки для загрузки.
Установка:
brew install viva64/pvs-studio/blame-notifierОбновление:
brew upgrade blame-notifierПрямые ссылки для загрузки.
Флаг "--help" выводит основную информацию об утилите:
blame-notifier --helpПример использования утилиты blame-notifier (одной строкой):
blame-notifier path/to/PVS-Studio.log
--VCS Git
--recipientsList recipients.txt
--server ... --sender ... --login ... --password ...Ниже приводится краткое описание параметров утилиты:
При использовании утилиты должен быть указан как минимум один из флагов, через который задаётся список получателей отчётов: '--recipientsList' или '--vcsBasedRecipientsList'. При необходимости эти флаги могут использоваться совместно.
Формат файла со списком получателей отчётов:
# Получатели полного отчёта
username_1 *email_1
...
username_N *email_N
# Получатели собственных ошибок
username_1 email_1
...
username_N email_NЗакомментировать строку можно символом "#". Для получателей полных отчетов необходимо добавить символ "*" в начале или в конце email адреса. Полный отчет будет включать все предупреждения, отсортированные по разработчикам.
Маски фильтрации имеют следующим вид: MessageType:MessageLevels.
MessageType может принимать одно из следующих значений: GA, OP, 64, CS, MISRA, Fail.
MessageLevels может принимать значение от 1 до 3.
Возможна комбинация разных масок через ";" (без пробелов), например:
--analyzer=GA:1,2;64:1В таком случае будут обработаны предупреждения общего назначения (GA) уровней 1 и 2 и 64-битные предупреждения (64) уровня 1.
В данной статье рассматривается встраивание PVS-Studio в процесс непрерывной интеграции в среде Windows. Встраивание в процесс CI в среде Linux описано в статье "Как запустить PVS-Studio в Linux".
Прежде чем перейти к основной теме данной статьи, стоит отметить, что использование PVS-Studio исключительно на сборочном сервере эффективно, но не оптимально. Лучшим вариантом будет построение двухуровневой системы проверки исходного кода - локально на машинах разработчиков и на сборочном сервере.
Этот принцип происходит из того факта, что чем раньше обнаружена ошибка, тем меньше стоимость и сложность её исправления. Поэтому необходимо стремиться к как можно более раннему обнаружению и исправлению ошибок, для чего и необходимо использование PVS-Studio на машинах разработчиков. Рекомендуется использование режима инкрементального анализа, позволяющего автоматически запускать проверку только изменённого кода после сборки проекта.
Тем не менее использование PVS-Studio на машинах разработчиков не исключает возможности попадания ошибок в систему контроля версий. Для отслеживания таких ситуаций и нужно иметь второй уровень защиты - регулярный запуск статического анализатора на сборочном сервере. Даже в случае попадания ошибки в систему контроля версий, её удастся своевременно выявить и исправить. Встраивание анализа в процесс ночных сборок позволит на следующий день получать информацию обо всех ошибках, допущенных в течение прошлого дня, и оперативно поправить проблемный код.
Примечание. Не рекомендуется конфигурировать статический анализ кода на сервере таким образом, чтобы он запускался на каждый коммит, так как анализ может занимать продолжительное время. Если необходим именно такой сценарий использования и при этом сборочной системой проекта является MSBuild, можно воспользоваться режимом инкрементального анализа command line модуля 'PVS-Studio_Cmd.exe'. За дополнительной информацией обратитесь к разделу "Инкрементальный анализ в command line модуле 'PVS-Studio_Cmd.exe'" текущего документа. Также для анализа файлов при инкрементальной сборке (вне зависимости от сборочной системы) можно использовать утилиту 'CLMonitor.exe' (только для анализа C, C++ кода). Более подробно использование утилиты 'CLMonitor.exe' описано в разделе "Система мониторинга компиляции" текущего документа.
Подготовка к встраиванию PVS-Studio в процесс непрерывной интеграции - важный этап, позволяющий сэкономить время в дальнейшем и использовать статический анализатор более эффективно. В этом разделе будут рассмотрены те особенности настройки PVS-Studio, которые упростят последующую работу.
Для установки PVS-Studio требуются права администратора. Автоматическая установка осуществляется следующей командой, выполненной в командной строке (одной строкой):
PVS-Studio_setup.exe /verysilent /suppressmsgboxes
/norestart /nocloseapplicationsВыполнение этой команды приведёт к установке всех доступных компонентов PVS-Studio. Обратите внимание, что PVS-Studio может потребоваться перезагрузка компьютера в случае, например, если обновляемые файлы были заблокированы. Если установщик запустить без флага 'NORESTART', перезагрузка может произойти без предварительных уведомлений или диалогов.
В состав дистрибутива входит утилита 'PVS-Studio-Updater.exe', позволяющая проверять наличие обновлений анализатора, а в случае их наличия, загрузить и установить их на локальной машине. Для запуска утилиты в 'silent' режиме следует использовать те же параметры, что и для установки дистрибутива:
PVS-Studio-Updater.exe /verysilent /suppressmsgboxesФайл настроек генерируется автоматически при запуске Visual Studio с установленным плагином PVS-Studio или приложением C and C++ Compiler Monitoring UI (Standalone.exe), и в дальнейшем он может быть отредактирован или скопирован на другие машины. Информация о лицензии также хранится в файле настроек. Расположение файла по умолчанию:
%AppData%\PVS-Studio\Settings.xmlДля более детальной информации по автоматическому развёртыванию PVS-Studio обратитесь к статье "Автоматическое развёртывание PVS-Studio".
Перед использованием анализатора необходимо выполнить его предварительную настройку, что поможет оптимизировать работу со списком предупреждений, а также (возможно) повысить скорость проведения анализа.
Примечание. Описанные ниже опции можно изменить, напрямую отредактировав файл настроек, или воспользовавшись интерфейсом страницы настроек в плагине к Visual Studio или в приложении C and C++ Compiler Monitoring UI.
Часто бывает полезно исключить из анализа определённые файлы или даже целые директории. Это позволит не анализировать код сторонних библиотек, сократив общее время анализа, и оставив в выводе только те предупреждения, которые актуальны именно для вашего проекта. По умолчанию в настройках анализатора уже присутствуют исключения для некоторых файлов или путей, например, для библиотеки boost. Более подробно исключение файлов из анализа описано в статье "Настройки: Don't Check Files".
На этапе внедрения также следует отключить те диагностические правила PVS-Studio, которые неактуальны для проверяемого проекта. Существует возможность отключения как отдельных диагностических правил, так и целых групп. Если вы изначально знаете диагностики, неактуальные для вашего проекта (например, 64-битные ошибки), есть смысл отключить их сразу. Это также может ускорить работу анализатора. Если список таких диагностических правил неизвестен, то при необходимости их можно будет отключить позже. Более подробно отключение диагностических правил описано в статье "Настройки: Detectable Errors".
В случае внедрения статического анализа в существующий проект, когда объём кодовой базы уже существенен, проверка исходного кода может выявить большое количество ошибок в существующем коде. Команда разработчиков, занимающихся данным проектом, может не иметь ресурсов, необходимых для исправления всех этих предупреждений. В таком случае возникает необходимость убрать все предупреждения, обнаруженные в старом коде, чтобы с текущего момента видеть только те предупреждения анализатора, которые были выданы на вновь написанный/модифицированный код.
Достичь желаемого результата можно с использованием механизма массового подавления сообщений анализатора. Более подробно про это написано в статье: "Массовое подавление сообщений анализатора".
Примечание 1. Если необходимо скрыть только отдельные предупреждения анализатора, следует воспользоваться механизмом подавления ложных срабатываний, описанном в статье "Подавление ложных предупреждений".
Примечание 2. Используя SonarQube, можно изменять отображение предупреждений, найденных за определённый период времени. Таким образом, можно настроить отображение только тех предупреждений, которые были найдены после внедрения анализатора (т.е. отключить отображение предупреждений на старый код).
PVS-Studio достаточно просто встраивается в процесс непрерывной интеграции, а также предоставляет средства для удобной обработки результатов работы анализатора.
Интеграция PVS-Studio с платформой SonarQube доступна только при наличии Enterprise лицензии. Вы можете запросить пробную Enterprise лицензию здесь.
Ниже будут описаны принципы анализа проектов, основанных на различных сборочных системах, а также утилиты для работы с результатами анализа.
В данном разделе будет описан наиболее эффективный вариант анализа MSBuild / Visual Studio проектов, то есть файлов решений Visual Studio (.sln), проектов Visual C++ (.vcxproj) и Visual C# (.csproj).
Анализ из командной строки проектов, перечисленных выше, производится за счёт использования модуля 'PVS-Studio_Cmd.exe', находящегося в установочной директории PVS-Studio. Расположение установочной директории по умолчанию - 'C:\Program Files (x86)\PVS-Studio\'.
Передавая модулю 'PVS-Studio_Cmd.exe' различные аргументы, можно регулировать параметры анализа. Увидеть список всех доступных аргументов можно, выполнив команду:
PVS-Studio_Cmd.exe --helpАнализатор имеет один обязательный аргумент - '--target', с помощью которого задаётся объект для проверки (.sln, .vcxproj или .csproj файл). Остальные аргументы являются опциональными и подробно описываются в статье "Проверка Visual C++ (.vcxproj) и Visual C# (.csproj) проектов из командной строки с помощью PVS-Studio".
Рассмотрим пример запуска анализа на .sln файле (одной строкой):
PVS-Studio_Cmd.exe --target "targetsolution.sln" --platform "Any CPU"
--output "results.plog" --configuration "Release"Исполнение этой команды запустит анализ .sln файла 'targetsolution.sln' для платформы 'Any CPU' и конфигурации 'Release'. Выходной файл ('results.plog') будет создан в директории проверяемого проекта. При анализе будут использоваться стандартные настройки анализатора, так как явно не указано обратное.
Модуль 'PVS-Studio_Cmd.exe' имеет ряд ненулевых кодов возврата, посредством которых информирует о результирующем состоянии анализа. Код возврата представляет собой битовую маску, маскирующую все возможные состояния, возникшие во время работы утилиты. То есть ненулевой код не является свидетельством того, что утилита закончила свою работу некорректно. Подробное описание кодов возврата приведено в упомянутой выше статье "Проверка Visual C++ (.vcxproj) и Visual C# (.csproj) проектов из командной строки с помощью PVS-Studio".
Примечание. Если перед анализом нужно выполнить команды из CustomBuild task (например, для генерации файлов с кодом), можно указать PVS-Studio специальную директиву. В таком случае анализатор сначала выполнит необходимые команды и только затем запустит анализ. Подробности описаны в разделе "Выполнение команд из CustomBuild task перед анализом".
При регулярном запуске анализатора может возникнуть необходимость в получении отчёта анализатора, содержащего предупреждения, выданные только на вновь написанный / модифицированный код. При ночном анализе на сборочном сервере это позволит видеть только те предупреждения, которые были допущены в течение предыдущего дня.
В случае необходимости получения такого результата при запуске модуля 'PVS-Studio_Cmd.exe' необходимо указывать аргумент командной строки '--suppressAll'. При наличии этого флага все сообщения будут добавлены в базу подавленных сообщений (.suppress файлы соответствующих проектов) после сохранения результатов проверки. Следовательно, при следующей проверке эти сообщения выданы не будут. Если всё же потребуется посмотреть старые сообщения, рядом с .plog файлом, содержащим новые сообщения, будет сохранён полный лог проверки.
Механизм массового подавления предупреждений анализатора более подробно описан в статье "Массовое подавление сообщений анализатора".
Примечание. При использовании платформы SonarQube можно наблюдать только за новыми предупреждениями, не используя механизмы подавления. Для этого необходимо настроить отображение результатов анализа таким образом, чтобы видеть изменения только за последний день.
Режим инкрементального анализа в PVS-Studio позволяет проверять только файлы, изменённые/затронутые с момента последней сборки проекта. Этот режим доступен как при работе с использованием плагина для Visual Studio, так и при проверке проектов с использованием command line модуля PVS-Studio. Использование режима инкрементального анализа позволит получить предупреждения только на модифицированный код, а также сократить время анализа, так как те части проекта, которые не изменялись, проанализированы не будут.
Данный режим актуален, если система непрерывной интеграции настроена на автоматическую инкрементальную сборку после обнаружения изменений в системе контроля версий, то есть, если сборка и анализ проекта на сервере происходит неоднократно в течение дня.
Использование инкрементального анализа в модуле 'PVS-Studio_Cmd.exe' регулируется с помощью флага '--incremental'. Доступны следующие режимы работы:
Для получения подробной информации об инкрементальном анализе в PVS-Studio обратитесь к статье "Режим инкрементального анализа PVS-Studio".
Примечание. При использовании режима инкрементального анализа следует учитывать некоторые особенности. Если PVS-Studio использует препроцессор Visual C++ ('cl.exe'), возможно возникновение ситуации с блокировкой файлов. Это связано с тем, что при попытке записи файла, он может быть заблокирован компилятором 'cl.exe', выполняющим препроцессирование. При использовании препроцессора Clang данная ситуация возникает значительно реже. Это следует учитывать при решении конфигурирования сервера в пользу инкрементального анализа вместо полноценного анализа по ночам.
Если стоит задача анализа CMake проектов, рекомендуется генерировать из них решения для среды Visual Studio и в дальнейшем работать с ними. Это позволит полноценно использовать модуль 'PVS-Studio_Cmd.exe' и все связанные с этим фактом преимущества.
В случае, если проект не использует сборочную систему MSBuild, его не получится проанализировать с использованием command line модуля 'PVS-Studio_Cmd.exe'. Тем не менее, в состав дистрибутива входят утилиты, с помощью которых можно проверить даже проекты со специфичными сборочными системами.
Система мониторинга компиляции (PVS-Studio Compiler Monitoring, CLMonitoring) предназначена для 'бесшовной' интеграции статического анализа PVS-Studio в любую сборочную систему на ОС семейства Windows, использующую для компиляции файлов один из препроцессоров, поддерживаемых command line анализатором 'PVS-Studio.exe'.
Принцип работы сервера мониторинга (CLMonitor.exe) основан на отслеживании запуска процессов, соответствующих целевому компилятору, и сборе информации об окружении этих процессов. Сервер мониторинга отслеживает запуски процессов только для того пользователя, из-под которого он сам запущен.
Поддерживаемые компиляторы:
При интеграции сервера мониторинга в сборочный процесс первоначально необходимо запустить модуль 'CLMonitor.exe' с аргументом 'monitor':
CLMonitor.exe monitorЭто позволит серверу мониторинга запустить самого себя в режиме отслеживания и завершить работу, а сборочной системе - продолжить выполнять оставшиеся задачи. При этом второй (запущенный из первого) процесс CLMonitor будет оставаться запущенным и производить отслеживание сборки.
После завершения сборки необходимо запустить модуль 'CLMonitor.exe' в режиме клиента для генерации препроцессированных файлов и непосредственного запуска статического анализа:
CLMonitor.exe analyze -l "c:\ptest.plog" -u "c:\ptest.suppress" -sРассмотрим эту команду более подробно:
Более подробно использование системы мониторинга компиляции описано в статье "Система мониторинга компиляции в PVS-Studio".
Примечание. Системе мониторинга компиляции присущ ряд недостатков, связанный с естественными ограничениями такого подхода, а именно - невозможность гарантировать на 100% перехват всех запусков компилятора при сборке (например, при сильной загрузке системы). Также следует помнить о том, что если параллельно выполняются несколько сборок, система может отследить запуски компиляторов сторонней сборки.
Примечание. Прямая интеграция анализатора возможна только для проверки С/С++ кода.
Прямая интеграция анализатора может быть необходима в случаях отсутствия возможности использования command line модуля 'PVS-Studio_Cmd.exe' (проект собирается не с помощью сборочной системы MSBuild) и системы мониторинга компиляции (см. примечание соответствующего раздела).
В таком случае может потребоваться встроить в сборочный процесс прямой вызов анализатора ('PVS-Studio.exe') и передать ему все необходимые для препроцессирования аргументы. То есть анализатор необходимо вызвать для тех же файлов, для которых вызывается компилятор.
Подробное описание прямой интеграции анализатора в системы автоматизированной сборки приведено в статье "Прямая интеграция анализатора в системы автоматизации сборки (C/C++)".
Результатом работы анализатора является .plog файл, имеющий формат XML. Этот файл не предназначен для ручной обработки, например, для чтения программистом. Тем не менее, в состав дистрибутива входят специальные утилиты, цель которых - сделать работу с .plog файлом максимально удобной.
Отчёт анализатора можно отфильтровать ещё перед запуском анализа с помощью настройки No Noise. При работе на большой кодовой базе, анализатор неизбежно генерирует большое количество предупреждений. При этом, часто нет возможности поправить все предупреждения сразу. Для того, чтобы иметь возможность сконцентрироваться на правке наиболее важных предупреждений, можно сделать анализ менее "шумным" с помощью данной настройки. Она позволяет полностью отключить генерацию предупреждений низкого уровня достоверности (Low Certainty, 3-ий уровень предупреждений). После перезапуска анализа, сообщения этого уровня полностью пропадут из вывода анализатора.
Когда обстоятельства позволят и более существенные предупреждения анализатора будут исправлены, можно выключить режим No Noise - при следующем анализе все пропавшие ранее предупреждения станут вновь доступны.
Для включения этой настройки используйте окно Specific Analyzer Settings.
Для преобразования результатов работы анализатора в один из форматов для непосредственной работы предназначена утилита 'PlogConverter.exe', входящая в состав дистрибутива. 'PlogConverter.exe' позволяет выполнять преобразование .plog файлов в следующие форматы:
Пример запуска утилиты 'PlogConverter.exe' (одной строкой):
PlogConverter.exe test1.plog -o "C:\Results" -r "C:\Test"
-a GA:1 -t HtmlДанная команда преобразует файл 'test1.plog' в формат .html с отображением диагностических правил первого уровня категории GA (диагностики общего назначения). Результат будет записан в директорию 'C:\Results'. Оригинальный .plog файл изменён не будет.
Получить подробную справка по всем параметрам утилиты 'PlogConverter' можно с помощью команды:
PlogConverter.exe --helpПримечание. Утилита 'PlogConverter' поставляется вместе с исходными файлами (C#), которые доступны в архиве 'PlogConverter_src.zip'. Для создания собственного формата вывода результатов анализа можно переиспользовать алгоритм разбора структуры .plog файла.
Более подробно утилита 'PlogConverter' описана в статье "Работа с результатами анализа (.plog файл)".
Результаты статического анализа могут быть импортированы платформой непрерывного анализа и измерения качества кода SonarQube. Для импорта результатов анализа предназначен плагин 'sonar-pvs-studio-plugin', входящий в состав дистрибутива. Использование плагина позволяет добавлять сообщения, найденные анализатором PVS-Studio, в базу сообщений сервера SonarQube. Это, в свою очередь, даёт возможность видеть статистику появления / исправления ошибок, осуществлять навигацию по предупреждениям анализатора, просматривать документацию к диагностическим правилам и многое другое.
Все сообщения PVS-Studio, добавленные в SonarQube, имеют тип Bug. В интерфейсе SonarQube сохранено разделение сообщений по группам диагностик аналогично тому, как это сделано в анализаторе.
Более подробная информация об интеграции результатов анализа в SonarQube приведена в статье "Интеграция результатов анализа PVS-Studio в SonarQube".
Эффективным способом оповещения разработчиков о результатах анализа является их рассылка с использованием специализированных утилит, например, SendEmail. При использовании платформы контроля качества кода SonarQube, выполнять рассылку писем можно её средствами.
Ещё одним вариантом оповещения разработчиков является использование утилиты 'BlameNotifier', поставляемой в составе дистрибутива PVS-Studio. Она позволяет формировать вариативные отчёты. Например, разработчики, заложившие код с ошибками в систему контроля версий, получат индивидуальный отчёт. Лидеры команд, руководитель разработки и т.д. могут получить полный лог отчёта, включающий в себя информацию обо всех найденных ошибках и разработчиках, которые эти ошибки допустили.
Следующая команда выведет основную информацию об утилите:
BlameNotifier.exe --helpБолее подробно утилита 'BlameNotifier' рассматривается в статье "Работа с результатами анализа (.plog файл)" в разделе "Оповещение разработчиков".
Если у вас остались вопросы, пожалуйста, воспользуйтесь формой обратной связи.
Режим серверного инкрементального анализа из командной строки доступен только для Enterprise лицензии PVS-Studio. Вы можете запросить пробную Enterprise лицензию здесь. Инкрементальный анализ из IDE при работе на машине разработчика доступен для всех типов лицензий PVS-Studio.
Полный анализ можно регулярно запускать отдельно, например, раз в сутки во время ночных сборок. Однако наибольшего эффекта от использования анализатора можно добиться только за счёт более раннего обнаружения и исправления выявленных им дефектов. То есть самым оптимальным вариантом использования статического анализатора является проверка нового кода сразу после его написания. Такой сценарий работы, несомненно, осложняется необходимостью постоянно вручную запускать проверку для всех модифицированных файлов и каждый раз ждать завершения анализа. Это несовместимо с интенсивной разработкой и отладкой нового кода. Да и просто неудобно. Однако PVS-Studio предлагает решение этой проблемы.
Стоит помнить, что после первой полной проверки проекта желательно просмотреть все диагностические сообщения для нужных файлов и исправить найденные в коде ошибки. А остальные сообщения либо разметить как ложные срабатывания, либо отключить отображение неактуальных для проекта кодов сообщений или групп диагностик, либо подавить оставшиеся срабатывания, и, возможно, вернуться к их правке позже. Такой подход позволит иметь список сообщений, не забитый бессмысленными и ненужными предупреждениями.
Включить режим послесборочного инкрементального анализа можно в меню Extensions > PVS-Studio > Analysis after Build (Modified Files Only):
Данный пункт активирован в PVS-Studio по умолчанию.
После активации режима инкрементального анализа PVS-Studio станет автоматически в фоновом режиме производить анализ всех затронутых модификациями файлов сразу после окончания сборки проекта. После окончания инкрементальной сборки, когда запустится анализ, в области уведомлений Windows появится анимированная иконка PVS-Studio:
Контекстное меню области уведомлений позволяет на время приостановить (команда Pause) или отменить (команда Abort) текущую проверку.
Анализатор ориентируется на сборочную систему для определения изменившихся файлов, которые необходимо проверить. Полная пересборка проекта приведёт к анализу всех его файлов - используйте инкрементальную сборку для проверки только изменившихся файлов. В случае, если анализатор во время инкрементального анализа обнаружит ошибки в коде, в названии открытой в Visual Studio вкладки окна PVS-Studio отразится число найденных ошибок, и будет показано Windows уведомление:
Клик по иконке в области уведомлений (либо по самому уведомлению) откроет окно PVS-Studio Output.
При работе из Visual Studio можно задать ограничение на время работы инкрементального анализа или уровень выводимых предупреждений. Данные настройки можно регулировать в меню PVS-Studio > Options > Special Analyzer Settings > IncrementalAnalysisTimeout и PVS-Studio > Options > Specific Analyzer Settings > IncrementalResultsDisplayDepth.
Режим инкрементального анализа для решений Visual Studio доступен также в модуле командной строки (PVS-Studio_Cmd.exe). Этот режим позволяет ускорить статический анализ на сервере непрерывной интеграции. В нём реализованы подходы, аналогичные подходам MSBuild для инкрементальной сборки.
Настроить инкрементальный анализ на сервере можно с помощью нескольких команд:
PVS-Studio_Cmd.exe ... --incremental Scan ...
MSBuild.exe ... -t:Build ...
PVS-Studio_Cmd.exe ... --incremental Analyze ...Все режимы работы инкрементального анализа выглядят так:
В случае необходимости инкрементального анализа при использовании системы мониторинга компиляции, достаточно "отслеживать" инкрементальную сборку, т.е. компиляцию тех файлов, которые были изменены с момента последней сборки. Этот сценарий использования позволит анализировать только изменённый/новый код.
Такой сценарий использования естественен для системы мониторинга компиляции, т.к. она основана на "отслеживании" запусков компилятора во время сборки проекта, что позволяет получить всю необходимую информацию для запуска анализа на исходных файлах, компиляция которых была отслежена. Следовательно, режимы анализа зависят от того, какая сборка отслеживается: полная или инкрементальная.
Более подробно система мониторинга компиляции описана в статье "Система мониторинга компиляции в PVS-Studio".
Для проверки CMake-проекта можно использовать файл JSON Compilation Database. Для получения необходимого анализатору файла compile_commands.json необходимо добавить один флаг к вызову CMake:
cmake -DCMAKE_EXPORT_COMPILE_COMMANDS=On <src-tree-root>Для инкрементального анализа такого проекта необходимо добавить флаг --incremental к команде анализа:
pvs-studio-analyzer analyze ... --incremental ...В каталоге .PVS-Studio будут сохраняться зависимости между файлами и время модификаций, т.к. в этом режиме анализатор работает независимо от сборочной системы. Этот каталог необходимо сохранять для работы этого режима анализа.
Если используемый CMake генератор не поддерживает создание файла compile_commands.json, или генерация такого файла неудобна, можно воспользоваться прямой интеграцией PVS-Studio с CMake - использование модуля прямой интеграции позволит выполнять инкрементальный анализ одновременно с инкрементальной сборкой.
В скрипты сборочной системы Make и подобных можно прописать вызов анализатора рядом с компилятором:
$(CXX) $(CFLAGS) $< ...
pvs-studio --source-file $< ...В таком случае инкрементальный анализ и инкрементальная сборка будут работать совместно, получая информацию об изменённых файлах от сборочной системы.
Примеры интеграции PVS-Studio в Makefile собраны в репозитории на GitHub: pvs-studio-makefile-examples.
Проверить любой проект без интеграции анализатора в сборочную систему можно с помощью следующих команд:
pvs-studio-analyzer trace – make
pvs-studio-analyzer analyze ...Вместо команды make может быть любая команда запуска сборки проекта со всеми необходимыми параметрами.
В этом режиме анализатор отслеживает и производит логирование дочерних процессов сборочной системы и ищет среди них процессы компиляции. Если собирать проект в режиме инкрементальной сборки, то и проверяться будут только изменённые файлы.
Режим инкрементального анализа C# проектов под Linux и macOS аналогичен описанному выше в разделе "Command line analyzer for MSBuild projects (PVS-Studio_Cmd.exe)" с поправками на то, что:
Включить режим послесборочного инкрементального анализа можно в плагине для IntelliJ IDEA в меню Analyze > PVS-Studio > Settings > PVS-Studio > Misc > Run incremental analysis on every build:
После активации режима инкрементального анализа PVS-Studio станет автоматически в фоновом режиме производить анализ изменённых файлов сразу после окончания сборки проекта. Если PVS-Studio выдаст предупреждения, то они будут выведены в окне PVS-Studio:
В maven плагине инкрементальный режим включается флажком incremental:
<plugin>
<groupId>com.pvsstudio</groupId>
<artifactId>pvsstudio-maven-plugin</artifactId>
....
<configuration>
<analyzer>
....
<incremental>true</incremental>
....
</analyzer>
</configuration>
</plugin>После активации режима инкрементального анализа команда pvsstudio:pvsAnalyze будет запускать анализ только на измененных файлах относительно последнего запуска.
В gradle плагине инкрементальный режим включается аналогичным флажком incremental:
apply plugin: com.pvsstudio.PvsStudioGradlePlugin
pvsstudio {
....
incremental = true
....
}После активации режима инкрементального анализа команда pvsAnalyze будет запускать анализ только на измененных файлах относительно последнего запуска.
Проверка запросов на слияние и модифицированных файлов доступна только при наличии Enterprise лицензии. Вы можете запросить пробную Enterprise лицензию здесь.
С помощью режима анализа коммитов и слияния веток можно проанализировать только те файлы, которые были изменены относительно текущего состояния ветки (в которую производится коммит или запрос на слияние). Это сократит время анализа и упростит просмотр его результатов: отчёт анализатора будет содержать предупреждения, выданные из-за ошибок в изменённых файлах.
Этот документ описывает общие принципы анализа запросов на слияние. Примеры для конкретных CI можно найти в следующих разделах документации:
Для анализа файлов, изменённых при слиянии веток, эти файлы необходимо выделить из всех остальных файлов проекта. Для этого после прохождения слияния нужно получить разницу между HEAD веткой, из которой производится запрос на слияние, и той, куда будут вноситься изменения.
Рассмотрим дерево коммитов:
В данном случае была создана ветка quickFix. После работы в ней открывается запрос на слияние. Для получения разницы между текущим состоянием ветки master и последним коммитом в ветке quickFix можно использовать следующую команду (на момент её выполнения нужно находиться в ветке quickFix):
git diff --name-only HEAD master > .pvs-pr.listТак мы получим список изменённых файлов относительно последних коммитов в ветках master и quickFix. Названия изменённых файлов будут сохранены в .pvs-pr.list.
Примечание. В примере получения файлов для анализа используется система контроля версий git. Однако подойдёт любая система контроля версий, позволяющая получить список изменённых файлов.
Для проверки отправленного запроса на слияние нужно проанализировать полученный список файлов.
В данном разделе приведены примеры команд для получения списка модифицированных файлов.
Для Git:
Для получения списка изменённых файлов перед коммитом, выполните команду:
git diff --cached --name-only > .pvs-pr.listДля получения списка изменённых файлов между двумя коммитами, выполните команду:
git diff --name-only CommitA CommitB > .pvs-pr.listДля SVN:
На Windows можно выполнить следующую команду в PowerShell:
Write-Host (svn status | Select-String -Pattern `^[AM]\W*(.*)`
| %{$_.Matches.Groups[1].value}) -Separator "`b`n" > .pvs-pr.litsНа Linux:
svn status -q | grep -oP "^[M|A]\W*\K(.*)" > .pvs-pr.listДля Mercurial:
hg log --template "{files % `{file}\n`}\n" > .pvs-pr.listДля Perforce:
p4 diff -f -sa > .pvs-pr.listБольшинство систем контроля версий поддерживают возможность отслеживания событий в репозитории с помощью специальных хуков. Как правило, хуки представляют из себя обычные файлы скриптов, которые запускает VCS. Они могут быть использованы как на стороне клиента (локальная машина разработчика), так и на стороне сервера системы контроля версии (если у вас развёрнут собственный сервер VCS (Version Control System)). Использование хуков на сервере VCS позволяет настроить глобальную политику для всех разработчиков компании.
Сценарии использования хуков индивидуальны для каждой системы контроля версий. Подробнее об этом лучше узнать в документации по вашей системе контроля версий.
Вы можете попробовать интегрировать PVS-Studio непосредственно на сервер VCS, следуя этому плану:
ssh) отправить изменения на удалённую машину, применить там patch-файл и запустить анализ в режиме проверки списка файлов или проверки модифицированных файлов. -w указывает, что утилита должна завершать свою работу с кодом возврата 2, если в отфильтрованном отчёте есть срабатывания. Стоит учесть, что, как правило, операция выполнения хуков является блокирующей. Это означает, что пока хук не пройдет, операция коммита или отправки изменений не завершится. Следовательно, использование хуков может замедлить отправку изменений в репозиторий.
Обратите внимание, что такой сценарий довольно труден в реализации, и мы настоятельно рекомендуем использовать хуки VCS только для создания триггеров CI систем.
Анализ проверки списка файлов в PVS-Studio_Cmd и pvs-studio-dotnet включается с помощью флага --sourceFiles (-f).
Для включения этого режима в Java анализаторе используется утилита pvs-studio.jar с флагом --analyze-only-list.
Для проверки списка файлов анализатору необходимо через флаг -f передать текстовый файл, который содержит абсолютные или относительные пути к файлам для анализа (относительные пути будут раскрыты относительно рабочей директории). Каждый из путей должен быть записан на новой строке. Текст, который не является путём к файлу с исходным кодом, игнорируется (может быть полезно для комментирования).
Пример содержимого файла с путями:
D:\MyProj\Tests.cs
D:\MyProj\Common.cpp
D:\MyProj\Form.hДля C, C++ и C# анализаторов есть альтернатива данному режиму: режим проверки модифицированных файлов.
Далее будут рассмотрены варианты запуска анализа для разных языков и ОС.
Для проверки C# файлов используется утилита PVS-Studio_Cmd для Windows и pvs-studio-dotnet для Linux и macOS.
Путь к файлу, который содержит список файлов для анализа, передаётся с помощью аргумента -f (подробную информацию об аргументах можно найти в документации). О формате этого файла написано выше в разделе Режим проверки списка файлов.
Для получения информации о наличии предупреждений анализатора можно проверить код возврата. Коды возврата описаны в документации.
Пример команды запуска анализа:
PVS-Studio_Cmd.exe -t MyProject.sln ^
-f .pvs-pr.list ^
-o Analysis_Report.jsonБудут проанализированы файлы из .pvs-pr.list, которые содержатся в решении MyProject.sln. Результаты анализа будут сохранены в файл Analysis_Report.json.
Пример команды запуска анализа:
pvs-studio-dotnet -t MyProject.sln \
-f .pvs-pr.list \
-o Analysis_Report.jsonБудут проанализированы файлы из .pvs-pr.list, которые содержатся в решении MyProject.sln. Результаты анализа будут сохранены в файл Analysis_Report.json.
Для проверки C и C++ файлов можно использовать утилиты:
Способ проверки для каждой утилиты описан далее.
При первом запуске анализа генерируется файл кэша зависимостей всех исходных файлов проекта от заголовочных. При последующих запусках он будет обновляться анализатором автоматически. Существует возможность создания/обновления этого файла без запуска анализа. Данный процесс будет описан для каждой из утилит в соответствующем разделе.
В данном разделе более подробно расписывается механизм работы файлов кэшей зависимостей компиляции в консольных утилитах PVS-Studio_Cmd.exe и pvs-studio-analyzer/CompilerCommandsAnalyzer.exe.
В этих утилитах имеются специальные флаги:
--sourceFiles (-f);--source-files (-S).--dependencyRoot (-D);--dependency-root.--regenerateDependencyCache (-G);--regenerate-depend-info.--regenerateDependencyCacheWithoutAnalysis (-W);--regenerate-depend-info-without-analysis.--dependencyCacheSourcesRoot (-R);--dependency-cache-sources-root.При первом запуске анализа с использованием флага анализа списка файлов анализатор препроцессирует все C и C++ файлы из проектов, переданных на анализ. Эта информация о зависимостях сохраняется в отдельный файл кэша зависимостей для каждого проекта.
При последующих запусках анализатора с флагом анализа списка файлов информация в кэше зависимости добавляется/обновляется для:
После этапа обновления информации о зависимостях производится анализ всех файлов, указанных в списке файлов для анализа, а также файлов, зависящих от них (используется информация о зависимостях, полученная на предыдущем этапе).
Перед каждым запуском анализа кэш зависимостей компиляции будет обновлён для всех файлов, переданных на анализ, и файлов, в зависимостях которых есть файлы, переданные в списке файлов для анализа. При наличии изменений в зависимостях файлов по отношению к закэшированным зависимостям эти изменения будут учтены уже в текущем запуске анализа, а кэш обновлён для последующих запусков.
Для поддержания кэша зависимостей в актуальном состоянии требуется запускать анализ с флагом для анализа списка файлов для каждого изменения исходных файлов, либо одновременно для всех изменившихся файлов из нескольких коммитов.
Пропуск анализа изменений исходных файлов, либо отдельные запуски анализа изменённых файлов в порядке, отличающемся от порядка их модификации, может привести к последующему пропуску анализа из-за изменений в структуре зависимостей проекта. Так, например, если в .cpp файл была добавлена зависимость от .h файла, то этот .cpp файл должен попасть в список файлов на проверку для обновления его кэша зависимостей. Иначе при попадании вновь добавленного .h файла в список файлов на анализ анализатор не сможет найти единицу трансляции, для которой необходимо выполнить препроцессирование.
Если вы не можете обеспечить гарантированную передачу всех изменяющихся файлов проекта в режиме анализа списка файлов, мы рекомендуем использовать режим анализа списка файлов совместно с режимом перегенерации кэшей зависимостей с запуском анализа. В таком случае время работы анализатора несколько возрастёт (для перегенерации кэша необходимо произвести препроцессирование всех единиц трансляции проектов), однако оно всё равно будет значительно меньше, чем время полного анализа (т.к. будет производиться только препроцессирование всех исходных файлов проектов, без анализа). При этом актуальность кэша будет гарантирована на каждом запуске анализа независимо от возможного пропуска изменившихся файлов или от порядка, в котором файлы передавались на анализ.
Примечание. Сценарий анализа файлов проекта, который использует сборочную систему MSBuild, описан в разделе PVS-Studio_Cmd (Windows, Visual Studio\MSBuild).
В зависимости от ОС, на которой выполняется анализ, утилита будет иметь разные названия:
CompilerCommandsAnalyzer.exe;pvs-studio-analyzer. В примерах данной документации используется название pvs-studio-analyzer. Способ анализа файлов для CompilerCommandsAnalyzer.exe аналогичен описанным здесь.
Для использования pvs-studio-analyzer нужно сгенерировать либо файл compile_commands.json, либо файл с результатами трассировки компиляции (актуально только для Linux). Они необходимы для того, чтобы анализатор имел информацию о компиляции конкретных файлов.
Получение compile_commands.json
Со способами получения файла compile_commands.json можно ознакомится в документации.
Получение файла трассировки (только для Linux)
Со способами получения файла трассировки можно ознакомиться в документации. По умолчанию результат трассировки записывается в файл strace_out.
Существует два варианта анализа с использованием файла трассировки. Можно либо производить полную трассировку сборки всего проекта при каждом запуске, либо кэшировать результат трассировки и использовать его.
Минус первого способа в том, что полная трассировка противоречит идее быстрой проверки коммитов или запросов на слияние.
Второй способ плох тем, что результат анализа может оказаться неполным, если после трассировки поменяется структура зависимостей исходных файлов (например, в один из исходных файлов будет добавлен новый #include).
Из-за этого мы не рекомендуем использовать режим проверки списка файлов с логом трассировки для проверки коммитов или запросов на слияние. В случае, если вы можете делать инкрементальную сборку при проверке коммита, рассмотрите возможность использовать режим инкрементального анализа.
Пример команд для анализа файлов и обновления зависимостей
Рассмотрим пример использования pvs-studio-analyzer. Путь к файлу, который содержит список файлов для анализа, передаётся с помощью аргумента -S (подробную информацию об аргументах утилиты можно найти в документации). О формате этого файла написано выше в разделе Режим проверки списка файлов.
Примечание. Если информация о компиляции была получена с использованием режима трассировки компиляции, с помощью флага -f передаётся файл трассировки (по умолчанию его название — strace_out).
Пример команды для анализа файлов:
pvs-studio-analyzer analyze -S .pvs-pr.list \
-f compile_commands.json \
-o Analysis_Report.jsonПри выполнении данной команды сгенерируется отчёт с результатом проверки файлов, содержащихся в .pvs-pr.list. Результаты анализа будут сохранены в файл Analysis_Report.json.
Для генерации или обновления файла зависимостей без запуска анализа используется флаг --regenerate-depend-info-without-analysis. Вместе с этим флагом нельзя использовать флаг -S. Команда для обновления будет выглядеть следующим образом:
pvs-studio-analyzer analyze -f compile_commands.json \
–-regenerate-depend-info-without-analysisДля принудительного обновления кэша зависимостей с последующим запуском анализа используется флаг --regenerate-depend-info. Его также можно использовать вместе с флагом -S. В этом случае для всех файлов из проекта обновится кэш зависимостей. Однако анализироваться при этом будут:
-S указан путь до файла, в котором построчно перечислены пути до файлов исходного кода, которые надо проанализировать);Команда для обновления кэша зависимостей для всего проекта и анализа переданных файлов будет выглядеть следующим образом:
pvs-studio-analyzer analyze -S .pvs-pr.list \
-f compile_commands.json \
-o Analysis_Report.json \
–-regenerate-depend-infoПо умолчанию файл с кэшем зависимостей генерируется в папку .PVS-Studio, которая создаётся в рабочей директории. Сам кэш содержится в файле depend_info.json. Папку с расположением этого файла возможно изменить через флаг --dependency-root.
Получение информации о наличии/отсутствии предупреждений в отчёте анализатора
Есть срабатывания в отчёте анализатора или нет, можно понять по коду возврата консольных утилит:
PlogConverter.exe;plog-converter.С документацией по данным утилитам можно ознакомиться здесь.
Пример использования PlogConverter.exe:
PlogConverter.exe Analysis_Report.json ^
-t html ^
-n PVS-Studio ^
--indicateWarningsПример использования plog-converter:
plog-converter Analysis_Report.json \
-t html \
-n PVS-Studio \
--indicate-warningsВ качестве первого аргумента командной строки передается путь до файла с результатами анализа. С помощью аргумента -t указывается формат, в котором необходимо сохранить отчёт. При помощи аргумента -n задаётся имя файла с преобразованным отчётом. Флаги --indicateWarnings для PlogConverter.exe и --indicate-warnings для plog-converter позволяют установить код возврата 2, если в отчёте есть предупреждения анализатора.
Путь к файлу, который содержит список файлов для анализа, передаётся с помощью аргумента -f (подробную информацию об аргументах можно найти в документации). О формате этого файла написано в разделе "Режим проверки списка файлов".
Пример команды запуска анализа:
CLMonitor.exe analyze -l "Analysis_Report.json" ^
-f ".pvs-pr.list"При выполнении данной команды будет сгенерирован отчёт с результатом проверки файлов, содержащихся в .pvs-pr.list. Результаты анализа будут сохранены в файл Analysis_Report.json.
По коду возврата консольной утилиты PlogConverter.exe можно понять, есть срабатывания в отчёте анализатора или нет. Если предупреждения анализатора отсутствуют, код возврата — 0. При наличии предупреждений код возврата — 2. С документацией по данным утилитам можно ознакомиться здесь.
Пример использования PlogConverter.exe:
PlogConverter.exe Analysis_Report.json \
-t html \
-n PVS-Studio \
--indicate-warningsВ качестве первого аргумента командной строки передается путь до файла с результатами анализа. С помощью аргумента -t указывается формат, в котором необходимо сохранить отчёт. При помощи аргумента -n задаётся имя файла с преобразованным отчётом. Флаг --indicateWarnings для PlogConverter.exe позволяет задать код возврата 2, если в отчёте есть предупреждения анализатора.
Если нужные файлы с кодом включены в проект Visual Studio, который использует сборочную систему MSBuild, то анализ производится с помощью утилиты PVS-Studio_Cmd.
Путь к файлу, который содержит список файлов для анализа, передаётся с помощью аргумента -f (подробную информацию об аргументах утилит можно найти в документации). О формате этого файла написано выше в разделе Режим проверки списка файлов.
Для получения информации о наличии предупреждений анализатора можно проверить код возврата. Коды возврата описаны в документации.
Пример команды запуска анализа:
PVS-Studio_Cmd.exe -t MyProject.sln ^
-f .pvs-pr.list ^
-o Analysis_Report.jsonБудут проанализированы файлы из .pvs-pr.list, которые содержатся в решении MyProject.sln. Результаты анализа будут сохранены в файл Analysis_Report.json.
Для обновления зависимостей без запуска анализа используется флаг -W. Вместе с ним нельзя использовать флаг -f:
PVS-Studio_Cmd.exe -t MyProject.sln ^
-WДля принудительного обновления кэша зависимостей с последующим запуском анализа используется флаг -G. Его также можно использовать вместе с флагом -f. В этом случае для всех файлов исходного кода из проектов, переданных для анализа, будут обновлены кэши зависимостей. Однако, анализироваться при этом будут:
-f указан путь до файла, в котором построчно перечислены пути до файлов исходного кода, которые надо проанализировать);Команда для обновления кэшей зависимостей для всех проектов и анализа переданных файлов будет выглядеть следующим образом:
PVS-Studio_Cmd.exe -t MyProject.sln ^
-f .pvs-pr.list ^
-GПо умолчанию файл с кэшем зависимостей генерируется на уровне проекта и сохраняется в папку .pvs-studio. Файл, содержащий кэш, имеет название вида projectName.vcxproj.deps.json (часть имени файла, в данном случае projectName.vcxproj, соответствует имени проекта). Соответственно, если проанализировать файлы, относящиеся к одному решению, но к разным проектам, то в директории каждого из проектов будет создана папка .pvs-studio с файлом зависимостей.
Существует возможность изменить директорию сохранения кэша. Для этого используется параметр -D. В качестве его значения передаётся путь до директории, в которую необходимо сохранить кэш.
Для задания относительных путей в кэшах зависимостей используется флаг -R. В качестве аргумента ему необходимо передать путь, относительно которого будут раскрыты пути в файлах кэшей зависимостей.
Получение информации о наличии/отсутствии предупреждений в отчёте анализатора
По коду возврата консольной утилиты PVS-Studio_Cmd.exe можно понять, есть срабатывания в отчёте анализатора или нет. Код возврата 256 означает, что в отчёте есть предупреждения анализатора.
Также возможно использование консольных утилит PlogConverter.exe (Windows) или plog-converter (Linux/macOS) с флагом --indicateWarnings. При использовании этих флагов, если в отчёте анализатора имелись предупреждения, код возврата будет равен 2.
Пример использования PlogConverter.exe:
PlogConverter.exe Analysis_Report.json ^
-t html ^
-n PVS-Studio ^
--indicateWarningsПример использования plog-converter:
plog-converter Analysis_Report.json \
-t html \
-n PVS-Studio \
--indicate-warningsДля проверки Java файлов используется утилита pvs-studio.jar. Подробную информацию о самой утилите и её аргументах можно найти в документации.
Путь к файлу, который содержит список файлов для анализа, передаётся с помощью флага --analyze-only-list. О формате этого файла написано выше в разделе Режим проверки списка файлов.
Для анализа списка файлов также необходимо передать путь до проекта, содержащего их. Делается это при помощи аргумента -s. С помощью аргумента -e определяется classpath. Если требуется использовать несколько сущностей classpath, то они разделяются пробелом.
Пример команды запуска анализа:
java -jar pvs-studio.jar -s projectDir ^
--analyze-only-list .pvs-pr.list ^
-e Lib1.jar Lib2.jar ^
-j4 ^
-o report.json ^
-O json ^
--user-name license_name ^
--license-key license_keyВ результате будут проанализированы файлы, записанные в .pvs-pr.list. Результаты анализа сохранятся в файл report.json.
Для получения информации о наличии срабатываний можно воспользоваться флагом --fail-on-warnings. При его использовании анализатор вернёт код 53, если в результате анализа будут выданы предупреждения.
В качестве альтернативы режиму проверки списка файлов существует режим проверки модифицированных файлов. С помощью режима анализа модифицированных файлов можно проанализировать только те файлы, которые были изменены относительно сохраненного состояния директории проекта. Информацию о модификации файлов анализатор получает и сохраняет в кэш зависимостей компиляции. Кэш зависимостей представляет собой список файлов исходного кода проекта и их зависимостей. В режиме модифицированных файлов для каждого исходного файла, представленного в кэше, вычисляется хэш этого файла. При последующем запуске хэш в кэше зависимостей сравнивается с фактическим значением хэша файла. Если хэши различаются, файл будет проанализирован.
В текущий момент анализ модифицированных файлов доступен на Windows для MSBuild С, С++ и С# проектов с помощь утилиты PVS-Studio_Cmd и плагина для Visual Studio, а также на Linux/macOS для С# проектов с помощью утилиты pvs-studio-dotnet.
Анализ модифицированных файлов в PVS-Studio_Cmd и pvs-studio-dotnet включается с помощью флага --analyzeModifiedFiles (-F).
Пример команды запуска анализа модифицированных файлов:
PVS-Studio_Cmd.exe -t MyProject.sln -F ^
-D path\to\depCacheDir ^
-R depCacheRoot ^
-o analysis_report.jsonВ результате работы этой команды проанализируются изменённые и добавленные в проекты файлы, которые содержатся в решении MyProject.sln. Для получения информации об изменениях будут использованы файлы кэшей зависимостей, расположенные по пути, указанном во флаге -D. Пути в файлах кэшей будут записаны относительно пути, указанного в флаге -R. Результаты анализа будут сохранены в файл analysis_report.json.
Вы можете использовать флаг //V_SOLUTION_DIR_AS_DEPENDENCY_CACHE_SOURCE_TREE_ROOT в файле *.pvsconfig для использования пути каталога решения (папка, где расположен файл *.sln), в качестве корневой части пути, которая будет использована для построения относительных путей файлов в кэше зависимостей компиляции.
Также для управления построением относительных путей файлов в кэше зависимостей компиляции можно использовать флаг //V_DEPENDENCY_CACHE_SOURCE_ROOT. С помощью него можно указать директорию, которая будет использоваться в качестве корневой части пути для построения относительных путей.
С помощью флага //V_DEPENDENCY_CACHE_ROOT можно указать директорию, в которой будут сохраняться файлы кэша зависимостей компиляции. Без указания этой настройки кэш зависимостей записывается в папку .pvs-studio в директории проектного файла.
Если файл кэша зависимостей компиляции отсутствует, то он будет сгенерирован, и при этом запустится анализ всех исходных файлов из проекта. Для того, чтобы не запускался анализ всех файлов из проекта при первом запуске анализа, можно запустить анализатор в режиме генерации файлов кэшей зависимостей без непосредственного запуска анализа (флаг -W) с вычислением хэшей для файлов исходного кода (флаг -H). Для этого воспользуйтесь следующей командой:
PVS-Studio_Cmd.exe -t MyProject.sln -W -H ^
-D path\to\depCacheDir ^
-R depCacheRootВ этом случае будут сгенерированы файлы кэшей зависимостей, но не будет запущен анализ. Следующий запуск анализа модифицированных файлов (флаг -F) будет анализировать уже только добавленные или изменившиеся файлы исходного кода из проектов.
Для проверки коммита или запроса на слияние воспользуйтесь следующим алгоритмом:
Если вам нужно проверять не только измененные файлы, но и оставлять в отчёте предупреждения, которые не были обработаны после анализа, то вы можете воспользоваться флагом //V_DEPENDENCY_CACHE_TRACKING_MODE в режиме ModifiedAndWarningsContainingFiles. С этим флагом в режиме анализа модифицированных файлов будут проанализированы файлы, которые изменились с предыдущего запуска анализа, и файлы, в которых остались предупреждения анализатора. Для анализа только модифицированных файлов выставьте значение флага ModifiedFilesOnly.
Если вы хотите проверить только модифицированные файлы в плагине для Visual Studio, то нужно записать в .pvsconfig флаг //V_DEPENDENCY_CACHE_TRACKING_MODE или включить настройку DependencyCacheTrackingMode в одном из режимов отслеживания кэша. После этого в плагине появится пункт меню Extension > PVS-Studio > Check > Modified Files и пункт Analyze Modified Files with PVS-Studio в контекстном меню решений и проектов, при запуске которых начнется анализ модифицированных файлов.
Если включена настройка //V_DEPENDENCY_CACHE_TRACKING_MODE, то при любом запуске анализа будет происходить обновление кэша зависимостей компиляции для актуализации информации о модифицированных файлах и наличии файлов с предупреждениями.
DefectDojo – это DevSecOps платформа, инструмент для отслеживания ошибок и уязвимостей. Он предоставляет функции для работы с отчётами, включая возможность объединения результатов, запоминания ложных срабатываний и удаления дубликатов срабатываний, умеет сохранять метрики и строить графики их изменения. Используя его, можно удобно работать с результатами анализа PVS-Studio и управлять процессом устранения ошибок.
DefectDojo имеет несколько вариантов разворачивания. Здесь описано, как его можно установить и настроить. На этой странице находится общая документация по эксплуатации.
Для работы с отчётом PVS-Studio в DefectDojo нужно преобразовать его в специальный формат.
Для преобразования можно воспользоваться утилитами командной строки PlogConverter.exe для Windows и plog-converter для Linux/macOS. Эти утилиты позволяют не только конвертировать отчёт PVS-Studio в разные форматы, но и дополнительно обрабатывать его. Например, проводить фильтрацию сообщений.
Пример команды конвертации отчёта PVS-Studio для DefectDojo при помощи PlogConverter.exe (Windows):
PlogConverter.exe path\to\report.plog ^
-t DefectDojo ^
-o output\dir ^
-n converted_report_nameПример команды конвертации отчёта PVS-Studio для DefectDojo при помощи plog-converter (Linux/macOS):
plog-converter path/to/report.json \
-t defectdojo \
-o path/to/report.defectdojo.json \
-n converted_report_nameПосле того как вы преобразовали отчёт, его необходимо загрузить в DefectDojo. Для этого нужно добавить в DefectDojo новый engagement, в котором будут находиться результаты анализа. Для добавления engagement нужно выбрать пункт 'Add New Interactive Engagement'.
Далее нужно загрузить получившийся отчёт в созданный engagement. Для этого можно использовать API DefectDojo или вручную загрузить отчёт.
Для ручной загрузки отчёта откройте engagement, нажмите на кнопку меню в таблице 'Tests' и выберите пункт 'Import Scan Result'.
В открывшемся окне в поле 'Scan type' укажите 'Generic Findings Imports', в поле 'Choose report file' укажите отчёт, который нужно загрузить.
Для автоматизации загрузки отчёта используйте API DefectDojo. Пример команды загрузки отчёта:
curl -X POST
-H Authorization:"Token 44ac826dc4f3b6add1161dab11b49402618efaba"
-F scan_type="Generic Findings Import"
-F file=@"path/to/report.json"
-F engagement=1
-H Content-Type:multipart/form-data
-H accept:application/json defctdojohost/api/v2/import-scan/Токен для авторизации можно найти в меню пользователя DefectDojo, выбрав пункт 'API v2 Key'.
В параметре 'engagement' указывается идентификатор того engagement, в который нужно загрузить отчёт. Идентификатор можно узнать из URL выбранного engagement.
В параметре 'file' нужно указать путь до отчёта.
После загрузки отчёта, его можно посмотреть в DefectDojo. Выберите engagement, в который загрузили отчёт, и откройте нужный результат анализа. Последний загруженный отчёт будет первым в списке.
В результате откроется страница, которая будет содержать список предупреждений анализатора.
DefectDojo поддерживает фильтрацию и сортировку предупреждений по разным параметрам. Например, можно оставить только некоторые диагностики или предупреждения с определённым идентификатором CWE.
При нажатии кнопки 'Column visibility' открывается меню со списком для скрытия/отображения столбцов.
Поле 'Name' содержит номер диагностического правила. Нажмите на это поле для просмотра более подробной информации о предупреждении.
На открывшейся странице содержится следующая информация:
DefectDojo позволяет отмечать предупреждения как False Positive.
Для того чтобы разметка ложных сообщений сохранялась при загрузке нового отчёта, требуется дополнительная настройка DefectDojo.
Откройте настройки DefectDojo ('Configuration -> System Settings' или 'http://defectdojohost/system_settings') и включите опцию 'False positive history'.
Затем добавьте следующую запись в файл 'local_settings.py':
HASHCODE_FIELDS_PER_SCANNER=
{"PVS-Studio Scan (Generic Findings Import)":["unique_id_from_tool"]}Файл должен быть расположен в директории 'dojo/settings/'. Если вы запускаете DefectDojo через 'docker-compose.yml', то файл ('local_settings.py') нужно расположить в папке 'docker/extra_settings/'. В этом случае 'local_settings.py' копируется в папку 'dojo/settings/' при старте docker контейнера.
Эти настройки обеспечивают то, что предупреждения, отмеченные как False Positive, при загрузке нового отчёта не потеряют этот статус. Статус не изменится, даже если строка кода, на которую было выдано срабатывание, сдвинулась.
Дополнительно можно включить настройку 'Deduplicate findings'. В этом случае, когда в отчёте встретится уже загруженное предупреждение, оно будет иметь дополнительный статус 'Duplicate'.
Для того чтобы отметить предупреждение как ложное, нужно выделить его, нажать на кнопку 'Bulk Edit', выделить пункты 'Status' и 'False Positive'.
Quality Gate — это индикатор соответствия кода проекта заданным пороговым значениям метрик. В DefectDojo нет функционала для настройки Quality Gate через Веб-интерфейс. Однако с помощью API можно получить необходимую информацию для реализации механизма Quality Gate.
Пример скрипта для использования Quality Gate в DefectDojo можно найти здесь.
Для работы скрипта нужно выставить две переменные окружения:
Пример команды запуска скрипта:
python ./qualitygate.py --engagement 6 --critical 0 --high 10 ^
--medium 50 --low 250'engagement' – номер engagement, в который загружается отчёт.
'critical', 'high', 'medium', 'low' – пороговые значения количества предупреждений PVS-Studio различных уровней достоверности.
Скрипт получает последний отчёт из предоставленного engagement и определяет количество сообщений по уровням достоверности. После этого происходит проверка, что количество предупреждений меньше переданных.
Например, из приведённого выше примера следует, что скрипт вернёт код 1, если в отчёте будет хотя бы одно Critical предупреждение или больше 10 High, 50 Medium, 250 Low предупреждений.
Вы можете указать свою логику Quality Gate, изменив функцию quality_gate().
Есть несколько вариантов отправки оповещений в DefectDojo. Рассмотрим только отправку оповещений на примере почты.
Настройка рассылки результатов анализа происходит в два этапа: настройки почты отправителя и настройки оповещений в интерфейсе DefectDojo.
Для настройки отправителя в файл docker-compose.yml нужно добавить строки, в которых будут указаны данные для подключения к почте, с которой будут отправляться сообщения.
uwsgi:
....
DD_EMAIL_URL: "smtp+tls://email%40domain.com:YourPassword@YourSMTPServer:port"
celeryworker:
....
DD_EMAIL_URL: "smtp+tls://email%40domain.com:YourPassword@YourSMTPServer:port"Теперь перейдем к настройке оповещений в интерфейсе DefectDojo. Сначала нужно выбрать почту как способ отправки отчетов. Для этого у пользователя с правами SuperUser нужно перейти в Configuration > System Settings. В поле Email from указать почту, с которой будут отправляться сообщения. А также выбрать пункт Enable mail notifications, чтобы можно было выбрать оповещения для отправки на почту.
Далее нужно настроить пользователя. В поле Email address нужно указать почту, на которую будут приходить оповещения.
Затем нужно перейти в Configuration > Notifications. Здесь можно выбрать необходимые оповещения. Чтобы они приходили на почту, нужно выбрать соответствующую колонку.
Также оповещения можно настроить для конкретного проекта. Для этого нужно перейти в Products, выбрать проект и в разделе Notifications выбрать все нужные оповещения.
После этого оповещения будут приходить на почту с адреса, указанного в настройках в файле docker-compose.yml.
Интеграция PVS-Studio с платформой SonarQube доступна только при наличии Enterprise лицензии. Вы можете запросить пробную Enterprise лицензию здесь.
SonarQube — это открытая платформа для обеспечения непрерывного контроля качества исходного кода, поддерживающая большое количество языков программирования и позволяющая получать отчеты по таким метрикам, как дублирование кода, соответствие стандартам кодирования, покрытие тестами, сложность кода, потенциальные ошибки и т.д. SonarQube удобно визуализирует результаты анализа и позволяет отслеживать динамику развития проекта во времени.
Демонстрация возможностей платформы SonarQube доступна здесь.
Для импорта результатов анализа в SonarQube PVS-Studio предоставляет плагин. Использование плагина позволяет добавлять сообщения, найденные анализатором PVS-Studio, в базу сообщений сервера SonarQube. С помощью Web интерфейса SonarQube можно фильтровать сообщения, осуществлять навигацию по коду для анализа ошибок, назначать задачи на исполнителей и контролировать их выполнение, анализировать динамику количества ошибок и оценивать уровень качества кода проекта.
Важно: Начиная с версии 9.5, версия SonarQube Plugin API стала отличаться от фактической версии SonarQube. Эта версия API используется для того, чтобы узнать, совместим ли плагин PVS-Studio с SonarQube. Маппинг версий SonarQube в версии SonarQube Plugin API можно посмотреть в разделе Compatibility на GitHub. Также узнать версию SonarQube Plugin API можно из файла по пути sonarqube-VERSION/lib/sonar-application-VERSION.jar/sonar-api-version.txt, где sonarqube-VERSION — это папка установки SonarQube.
Дополнительно при загрузке отчёта анализатора PVS-Studio в SonarQube в лог выводится сообщение c текущей версией SonarQube Plugin API, например:
INFO Edition: COMMUNITY, SonarQube Plugin API Version: 10.1.0.809Пользователям PVS-Studio доступны следующие плагины для SonarQube:
sonar-pvs-studio-plugin.jar — плагин для импорта результатов PVS-Studio в проект на сервере SonarQube. В зависимости от версии SonarQube, необходимо использовать определённый файл плагина:sonar-pvs-studio-plugin-old-versions-before-10.2 .jar;sonar-pvs-studio-plugin.jar. После версии 10.7 изменилась схема управления версиями изданий SonarQube. Новый шаблон версии SonarQube Community: YY.M.0.BUILDNumber. Пример: SonarQube Community Build 25.1.0.102122. Новый шаблон версии SonarQube Developer/Enterprise/Data Center: YYYY.RELEASENumber.PATCHNumber.BUILDNumber. Пример: SonarQube Developer 2025.1.0.102418).sonar-pvs-studio-lang-plugin.jar — плагин, позволяющий создавать профиль (quality profile) с языком C/C++/C#. Он предоставляется для совместимости перехода плагинов PVS-Studio со старых версий SonarQube с сохранением ранее полученных метрик/статистики. В будущих релизах его поддержка может прекратиться. Если вы создаёте новый проект, используйте профиль с одним из стандартных языков (C++, C#, Java, Go, JavaScript/TypeScript).После установки сервера SonarQube скопируйте плагин (sonar-pvs-studio-plugin.jar) в следующую директорию:
SONARQUBE_HOME/extensions/pluginsВ зависимости от языка, для которого вы загружаете результаты анализа, установите также соответствующие плагины из списка (часть из них может быть установлена по умолчанию, в зависимости от используемой вами редакции SonarQube):
SonarQubeFolder/lib/extensions архива SonarQube.SonarQubeFolder/lib/extensions архива SonarQube.После этого перезапустите сервер SonarQube.
Примечание: Если вы сразу начали использовать обновленную версию плагина SonarCXX (2.0.+) для своего проекта, использующего языки C/C++, то для вас нижеизложенная информация неактуальна.
В SonarCXX 2.0.+ разработчиками были внесены многочисленные изменения с учетом опыта предыдущих версий. Одно из кардинальных изменений – переименование языкового ключа с C++ на CXX. Это изменение привело к тому, что PVS-Studio плагин теперь по умолчанию формирует разные несвязанные между собой репозитории для этих языков. Поэтому, если вы загрузите отчет PVS-Studio после обновления SonarCXX плагина без предварительной настройки, то все существующие ранее Issues от PVS-Studio, будут считаться удаленными, а все Issues из отчета будут считаться новыми.
Если вам необходимо обновить SonarCXX с сохранением истории Issues от PVS-Studio (например, сохранить статус Won't Fix или False Positive со всеми комментариями), то вам необходимо следовать данной инструкции:
<language>c++</language> на <language>cxx</language>;SonarQubeFolder/conf/sonar.properties добавьте строчку sonar.pvs-studio.enableCompatibilitySonarCXXRepositories=true;SonarQubeFolder/extentions/plugins/ на новую версию плагина (>= 2.0.0);SonarQubeFolder/bin/windows-x86-64/StartSonar.bat);После этого вы сможете загружать отчеты PVS-Studio для проектов с использованием Quality Profile для языка CXX.
Важно: Если вы ранее загружали отчеты PVS-Studio с использованием плагина SonarCXX версии 2.0.+ без добавления строки из инструкции в файл SonarQubeFolder/conf/sonar.properties, то все Issues, которые были ранее загружены, изменят свой статус на Removed и будут удалены со временем (по умолчанию 30 дней).
Самый простой и быстрый способ развёртывания сервера SonarQube — это использование образа SonarQube из Dockerhub.
Для загрузки отчётов анализатора PVS-Studio в SonarQube необходимо установить последнюю версию плагина PVS-Studio для SonarQube (которую можно скачать на этой странице), а также один из плагинов для C/C++, если в анализируемых вами проектах используются эти языки.
Ниже приведён пример Docker-файла, который позволит создать образ с SonarQube Community Edition и всеми необходимыми плагинами:
# Для использования SonarQube Enterprise Edition замените "lts-community"
# на "lts" в теге базового docker образа.
FROM sonarqube:lts-community
USER root
# Установка утилиты curl
RUN apk add curl || (apt-get update && apt-get install -y curl)
# Используйте последнюю версию плагина.
# Найти её можно по на странице:
# https://pvs-studio.com/en/pvs-studio/download-all/
ARG PVS_VER=7.27.75620.2023
# Установка плагина PVS-Studio для SonarQube.
RUN curl -Lo \
/opt/sonarqube/extensions/plugins/sonar-pvs-studio-plugin-$PVS_VER.jar \
https://cdn.pvs-studio.com/sonar-pvs-studio-plugin-$PVS_VER.jar
# Если вам необходима другая версия плагина CXX, измените её здесь.
ARG C_VER=cxx-2.1.1
ARG C_JAR=sonar-cxx-plugin-2.1.1.488.jar
# Установка плагина SonarCXX (нужен для работы с C/C++ проектами).
RUN curl -Lo \
/opt/sonarqube/extensions/plugins/$C_JAR \
https://github.com/SonarOpenCommunity/sonar-cxx/releases/download/$C_VER/$C_JAR
# Смена пользователя, который будет использоваться в контейнере
USER sonarqubeПосле создания файла необходимо собрать Docker-образ при помощи команды:
docker build -f dockerfile -t sonarqube-pvs-studio ./Для запуска контейнера SonarQube из ранее собранного образа, используйте команду:
docker run -p 9000:9000 sonarqube-pvs-studioВажно: чтобы не потерять данные из SonarQube при удалении контейнера, монтируйте каталоги по путям, определённым в инструкции к контейнеру SonarQube в DockerHub. Вот пример команды запуска контейнера с монтированными каталогами:
docker run -v /path/to/data:/opt/sonarqube/data
-v /path/to/logs:/opt/sonarqube/logs
-v /path/to/extentions:/opt/sonarqube/extensions
-p 9000:9000 sonarqube-pvs-studioЧтобы увидеть в браузере SonarQube запущенный в Docker-контейнере, перейдите по ссылке http://localhost:9000/.
Для входа введите стандартные значения login-а и пароля администратора SonarQube:
Login: admin
Password: adminПосле входа установите новый пароль для аккаунта администратора.
Примечание: Ниже приведена настройка Quality Profile с предустановленными плагинами PVS-Studio и Sonar C++ Community(v2.0.4). Примите во внимание то, что, если Вы используете Sonar C++ Community плагин версии ниже 2.0+, то вместо языка CXX, будут С++(Community) / С(Community).
Quality Profile - это коллекция диагностик, которые выполняются во время анализа. Вы можете включать диагностики PVS-Studio в существующие профили, либо создать новый. Профиль привязывается к конкретному языку программирования, но вы можете создавать несколько профилей с разными наборами правил. Все действия доступны пользователям из группы sonar-administrators.
Создать новый профиль можно в меню Quality Profiles > Create:
Для включения диагностик анализатора в активный профиль, выберите интересующий вас репозиторий в меню Rules > Repository:
Далее добавьте все диагностические правила в свой профиль, нажав на кнопку Bulk Change, или выберите конкретные правила вручную.
Окно активации диагностик выглядит следующим образом:
Вы также можете фильтровать правила по тегам, прежде чем выбрать их для профиля:
После создания/настройки соответствующего профиля, назначьте один из них профилем по умолчанию:
Профиль по умолчанию запускается на файлах для указанного языка программирования. Профили не обязательно делить по используемым утилитам. Вы можете создать единый профиль для вашего проекта, добавив туда диагностические правила из разных утилит.
Так как в SonarQube каждое расширение анализируемого файла должно быть однозначно присвоено одному языку программирования, Sonar C++ Community плагин версии 2.0+ во избежание конфликтов с другими языковыми плагинами по умолчанию не определяет расширения файлов. Для этого Вам нужно самостоятельно их определить:
При выходе новой версии PVS-Studio могут добавиться новые диагностики, поэтому нужно обновить версию плагина на сервере SonarQube и добавить новые диагностики в Quality Profile, который использует диагностики PVS-Studio. Настройка автоматического обновления описана ниже, в отдельном разделе.
Для импорта результатов анализа в SonarQube используется утилита SonarQube Scanner. Для работы ей требуется конфигурационный файл с именем sonar-project.properties, размещённый в корневом каталоге проекта. Конфигурационный файл содержит настройки для анализа заданного проекта, при этом часть или все настройки можно перенести в параметры запуска утилиты SonarQube Scanner.
Перед первым запуском анализа вам необходимо ввести лицензию. Как это сделать — можно узнать в этой документации.
Далее будут рассмотрены типовые режимы запуска сканера для импорта результатов анализа PVS-Studio в SonarQube на разных платформах. SonarQube Scanner будет автоматически подхватывать конфигурационный файл с именем sonar-project.properties в текущей директории запуска.
Для C# проектов возможно использовать два варианта SonarScanner-а:
sonar-project.properties);sonar-project.properties). Разница между ними заключается в том, что SonarQube Scanner for .NET является более специализированным. Он отображает больше статистики, которую предоставляет SonarQube для C# проекта, чем SonarQube Scanner. Например, для отчёта, загруженного SonarQube Scanner, на вкладке со списком проектов (превью проектов) в SonarQube не отображается краткая статистика по проекту, в отличии от проекта, загруженного при помощи SonarQube Scanner for .NET:
MSBuild-проекты проверяются с помощью утилиты PVS-Studio_Cmd.exe.
Вариант 1
Одним запуском PVS-Studio_Cmd вы можете получить отчёт анализатора и конфигурационный файл sonar-project.properties:
PVS-Studio_Cmd.exe ... -o Project.plog --sonarqubedata ...Команда запуска сканера будет выглядеть следующим образом:
sonar-scanner.bat ^
-Dsonar.projectKey=ProjectKey ^
-Dsonar.projectName=ProjectName ^
-Dsonar.projectVersion=1.0 ^
-Dsonar.pvs-studio.reportPath=Project.plog ^
-Dsonar.login=admin ^
-Dsonar.password=NEW_ADMIN_PASSWORDВариант 2
При использовании SonarQube Scanner for .NET для C# проектов необходимо использовать специальный набор команд, а также не нужно генерировать файл sonar-project.properties (аргумент --sonarqubedata из PVS-Studio_Cmd.exe) при запуске анализа:
SonarScanner.MSBuild.exe begin ... /d:sonar.pvs-studio.reportPath=Project.plog
MSBuild.exe Project.sln /t:Rebuild ...
PVS-Studio_Cmd.exe -t Project.sln ... -o Project.plog
SonarScanner.MSBuild.exe enddotnet <path to SonarScanner.MSBuild.dll>
begin /d:sonar.pvs-studio.reportPath=Project.plog
dotnet build Project.sln /t:Rebuild ...
PVS-Studio_Cmd.exe -t Project.sln ... -o Project.plog
dotnet <path to SonarScanner.MSBuild.dll> endДобавьте следующие строки в проверяемый анализатором PVS-Studio Java проект (в зависимости от типа проверяемого проекта):
Maven
<outputType>json</outputType>
<outputFile>output.json</outputFile>
<sonarQubeData>sonar-project.properties</sonarQubeData>Gradle
outputType = 'json'
outputFile = 'output.json'
sonarQubeData='sonar-project.properties'Ядро Java анализатора
Windows:
java -jar pvs-studio.jar ^
-s ./ ^
--ext-file /path/to/file/with/classpath/entries ^
-o output.json ^
--output-type json ^
--sonarqubedata sonar-project.propertiesLinux/macOS:
java -jar pvs-studio.jar \
-s ./ \
--ext-file /path/to/file/with/classpath/entries \
-o output.json \
--output-type json \
--sonarqubedata sonar-project.propertiesПосле завершения работы Java анализатора конфигурационный файл SonarQube также будет создан автоматически.
Команда запуска сканера будет выглядеть следующим образом:
Windows:
sonar-scanner.bat ^
-Dsonar.projectKey=ProjectKey ^
-Dsonar.projectName=ProjectName ^
-Dsonar.projectVersion=1.0 ^
-Dsonar.pvs-studio.reportPath=output.json ^
-Dsonar.login=admin ^
-Dsonar.password=NEW_ADMIN_PASSWORDLinux/macOS:
sonar-scanner \
-Dsonar.projectKey=ProjectKey \
-Dsonar.projectName=ProjectName \
-Dsonar.projectVersion=1.0 \
-Dsonar.pvs-studio.reportPath=output.json \
-Dsonar.login=admin \
-Dsonar.password=NEW_ADMIN_PASSWORDВ случае Go проекта, конфигурационный файл sonar-project.properties необходимо создать самостоятельно с таким содержимым:
sonar.projectBaseDir=path/to/project/dir
sonar.sources=path/to/project/dir
sonar.inclusions=**/*.goВ свойствах должен быть указан путь до локальной директорию проекта.
Получить отчет анализатора можно с помощью следующей команды:
pvs-golang analyze path/to/project/dir .... -o report.jsonКоманда запуска сканера будет выглядеть следующим образом:
Windows:
sonar-scanner.bat ^
-Dsonar.projectKey=ProjectKey ^
-Dsonar.projectName=ProjectName ^
-Dsonar.projectVersion=1.0 ^
-Dsonar.pvs-studio.reportPath=report.json ^
-Dsonar.login=admin ^
-Dsonar.password=NEW_ADMIN_PASSWORDLinux/macOS:
sonar-scanner \
-Dsonar.projectKey=ProjectKey \
-Dsonar.projectName=ProjectName \
-Dsonar.projectVersion=1.0 \
-Dsonar.pvs-studio.reportPath=report.json \
-Dsonar.login=admin \
-Dsonar.password=NEW_ADMIN_PASSWORDВ случае JavaScript или TypeScript проекта, конфигурационный файл sonar-project.properties необходимо создать самостоятельно с таким содержимым:
sonar.projectBaseDir=path/to/project/dir
sonar.sources=path/to/project/dir
sonar.inclusions=**/*.js,**/*.tsВ свойствах должен быть указан путь до локальной директорию проекта.
Получить отчет анализатора можно с помощью следующей команды:
pvs-js analyze path/to/project/dir .... -o report.jsonКоманда запуска сканера будет выглядеть следующим образом:
Windows:
sonar-scanner.bat ^
-Dsonar.projectKey=ProjectKey ^
-Dsonar.projectName=ProjectName ^
-Dsonar.projectVersion=1.0 ^
-Dsonar.pvs-studio.reportPath=report.json ^
-Dsonar.login=admin ^
-Dsonar.password=NEW_ADMIN_PASSWORDLinux/macOS:
sonar-scanner \
-Dsonar.projectKey=ProjectKey \
-Dsonar.projectName=ProjectName \
-Dsonar.projectVersion=1.0 \
-Dsonar.pvs-studio.reportPath=report.json \
-Dsonar.login=admin \
-Dsonar.password=NEW_ADMIN_PASSWORDВ случае С/C++ проекта, конфигурационный файл необходимо создать самостоятельно. Например, он может быть с таким содержимым:
sonar.projectKey=my:project
sonar.projectName=My project
sonar.projectVersion=1.0
sonar.pvs-studio.reportPath=report.json
sonar.sources=path/to/directory/with/project/sourcesВариант 1
В случае C# проекта получить отчет анализатора вместе с конфигурационным файлом можно с помощью следующей команды:
pvs-studio-dotnet .... -o report.json –sonarqubedataЗапуск sonar-scanner осуществляется следующим образом:
sonar-scanner\
-Dsonar.projectKey=ProjectKey \
-Dsonar.projectName=ProjectName \
-Dsonar.projectVersion=1.0 \
-Dsonar.pvs-studio.reportPath=report.json \
-Dsonar.login=admin \
-Dsonar.password=NEW_ADMIN_PASSWORDВариант 2
При использовании SonarQube Scanner for .NET для C# проектов необходимо использовать специальный набор команд, а также не нужно генерировать файл sonar-project.properties (аргумент --sonarqubedata из pvs-studio-dotnet) при запуске анализа:
dotnet <path to SonarScanner.MSBuild.dll>
begin /d:sonar.pvs-studio.reportPath=report.json
dotnet build Project.sln /t:Rebuild ...
pvs-studio-dotnet .... -o report.json
dotnet <path to SonarScanner.MSBuild.dll> endC SonarQube 2025.1 свойство -Dsonar.password было удалено, поэтому вместо него нужно использовать токен -Dsonar.token.
Команда в таком случае будет выглядеть так:
-Dsonar.projectKey=ProjectKey ^
-Dsonar.projectName=ProjectName ^
-Dsonar.projectVersion=1.0 ^
-Dsonar.pvs-studio.reportPath=Project.plog ^
-Dsonar.token=TOKENДля более глубокой настройки анализа своего проекта, вы можете самостоятельно составить конфигурационный файл из следующих настроек (или отредактировать создаваемый по умолчанию файл при проверке MSBuild и Java проектов):
sonar.pvs-studio.reportPath — путь к отчёту анализатора в формате .plog (для MSBuild проектов) или .json;sonar.pvs-studio.licensePath — путь к лицензии анализатора PVS-Studio (если проверяется MSBuild проект, вы можете передать эту настройку с помощью параметра sonar.pvs-studio.settingsPath). Путь до файла по умолчанию -- ~/.config/PVS-Studio/PVS-Studio.lic на Linux и macOS;sonar.pvs-studio.sourceTreeRoot — путь к директории проекта на текущем компьютере, если отчёт анализатора был получен на другом компьютере, Docker-контейнере и т.п. Задание данного пути позволяет передавать в sonar.pvs-studio.reportPath отчёт, сгенерированный с относительными путями (если проверяется MSBuild проект, вы можете передать эту настройку с помощью параметра sonar.pvs-studio.settingsPath);sonar.pvs-studio.settingsPath — путь к Settings.xml для MSBuild проектов, проверяемых на Windows. В этом файле уже содержится информация о licencePath и sourceTreeRoot, поэтому эти параметры можно не указывать отдельно. Путь по умолчанию -- %AppData%\PVS-Studio\Settings.xml. Файл используется только на Windows;sonar.pvs-studio.cwe — включает добавление CWE ID к предупреждениям анализатора. По умолчанию эта опция выключена. Используйте значение active для включения;sonar.pvs-studio.misra — включает добавление идентификатора MISRA к предупреждениям анализатора. По умолчанию эта опция выключена. Используйте значение active для включения;sonar.pvs-studio.language — включает языковой плагин C/C++/C#. По умолчанию эта опция выключена. Используйте значение active для включения. Используйте данную настройку, если вы используете профиль с языком C/C++/C#, добавляемым отдельным плагином PVS-Studio. Данный плагин предоставляется для совместимости перехода со старых версий SonarQube плагинов PVS-Studio с сохранением ранее полученных метрик\статистики, в будущих релизах его поддержка может быть прекращена.Описание остальных стандартных параметров конфигурации сканера доступно в общей документации SonarQube.
При использовании плагина PVS-Studio вместе с плагином SonarCFamily необходимо дополнительно использовать SonarSource Build Wrapper или Compilation Database (с версии SonarQube 9.1) при загрузке отчёта PVS-Studio. Подробная инструкция об их использовании находится на сайте SonarQube.
При загрузке отчёта необходимо будет указать свойство sonar.cfamily.build-wrapper-output или sonar.cfamily.compile-commands как аргумент при запуске sonar-scanner (например: -Dsonar.cfamily.build-wrapper-output=директория_с_результатами_работы_Build_Wrapper) или добавить его в файл sonar-project.properties.
Когда директории подпроектов расположены на разных уровнях, загрузить в SonarQube результаты анализа нескольких подпроектов в один проект со стандартными настройками становится невозможным. Это связано с тем, что для такой структуры подпроектов требуется дополнительная настройка индексатора в утилите SonarScanner.
Правильно настроить такой проект можно с помощью модулей, где каждый модуль настраивается для одного подпроекта:
sonar.projectKey=org.mycompany.myproject
sonar.projectName=My Project
sonar.projectVersion=1.0
sonar.sources=src
sonar.modules=module1,module2
module1.sonar.projectName=Module 1
module1.sonar.projectBaseDir=modules/mod1
module2.sonar.projectName=Module 2
module2.sonar.projectBaseDir=modules/mod2Для указания пути к файлу с результатами анализа PVS-Studio есть 2 пути.
Первый способ
Указать разные отчёты для модулей:
....
sonar.modules=module1,module2
module1.sonar.projectName=Module 1
module1.sonar.projectBaseDir=modules/mod1
module1.sonar.pvs-studio.reportPath=/path/to/report1.plog
module2.sonar.projectName=Module 2
module2.sonar.projectBaseDir=modules/mod2
module2.sonar.pvs-studio.reportPath=/path/to/report2.plogВторой способ
Указать один отчёт на уровне проекта:
sonar.projectKey=org.mycompany.myproject
sonar.projectName=My Project
sonar.projectVersion=1.0
sonar.sources=src
sonar.pvs-studio.reportPath=/path/to/report.plog
sonar.modules=module1,module2
....В этом случае каждый модуль загрузит из отчёта только те предупреждения, которые относятся к нему. К сожалению, на файлы из других модулей будет выдан WARN об отсутствии файлов в вывод утилиты SonarScanner, но все результаты анализа будет загружены корректно.
В отчётах анализатора PVS-Studio каждое предупреждение имеет такую характеристику, как уровень достоверности:
В SonarQube у Issues есть похожая характеристика — Severity. Количество уровней Severity у Issue в SonarQube отличается (их 5, а в PVS-Studio их 4). Кроме этого, сервер SonarQube в определённый момент стал поддерживать два режима, в которых отличается отображение Severity уровней на вкладке Issues:
Соответствие уровня достоверности предупреждения PVS-Studio уровню Severity у Issue в SonarQube представлена в таблице:
|
PVS-Studio Warning |
Standard Experience Mode |
Multi-Quality Rule Mode |
|---|---|---|
|
Fails (0) |
Info |
Info |
|
High (1) |
Critical |
High |
|
Medium (2) |
Major |
Medium |
|
Low (3) |
Minor |
Low |
|
- |
Blocker |
Blocker |
Со всеми возможности анализатора по поиску потенциальных уязвимостей в коде вы можете ознакомиться на странице PVS-Studio SAST (Static Application Security Testing).
Информация о безопасности проверяемого кода, предоставляемая анализатором PVS-Studio, дополнительно помечается в отображаемых SonarQube результатах анализа.
В меню Issues > Tag или Rules > Tag доступны следующие теги для группировки предупреждений PVS-Studio по разным стандартам безопасности:
Также вы можете выбрать конкретный CWE ID, если такой доступен (если сообщение анализатора соответствует нескольким идентификаторам CWE, оно будет отмечено одним общим тегом cwe - используйте префиксы в тексте предупреждений для фильтрации таких идентификаторов):
В SonarQube 7.8 и 8.4, на страницах Issues и Rules доступен новый фильтр по категориям безопасности. При помощи этого фильтра SonarQube позволяет классифицировать правила в соответствии стандартам безопасности, таким как:
Правила и проблемы от PVS-Studio, которые сопоставлены с CWE ID, также можно группировать в этом меню (Security Category > CWE):
Примечание. Начиная с версии SonarQube 8.5, во вкладку Security Category могут попасть только Issues/Rules, связанные с безопасностью, а именно те Issues/Rules, у которых тип Vulnerability или Security Hotspot.
Все правила PVS-Studio по умолчанию имеют тип Bug. Если вам необходимо изменить тип правила с Bug на 'Vulnerability при наличии CWE ID или если правило относится к рейтингу OWASP Top 10, то для этого необходимо в конфигурационном файле сервера $SONARQUBE_HOME\conf \sonar.properties добавить следующую строчку:
sonar.pvs-studio.treatPVSWarningsAsVulnerabilities=activeЧтобы изменения вступили в силу нужно перезапустить сервер SonarQube. После того как вы это сделали, правила с CWE ID или относящиеся к рейтингу OWASP Top 10 будут иметь тип Vulnerability, а новые сгенерированные проблемы уже будут учитывать это изменение.
Примечание. Если у вас до этого были старые проблемы, то это изменение их не коснется. Для этого вам необходимо вручную изменить тип у этих проблем.
В конфигурационном файле sonar-project.properties доступны следующие опции:
sonar.pvs-studio.cwe=active
sonar.pvs-studio.misra=activeОни включают режим добавления идентификаторов CWE и MISRA к предупреждениям анализатора. Выглядит это следующим образом:
Возможность фильтровать предупреждения по соответствующим тегам доступна всегда и не зависит от указанных опций.
На вкладке Projects > Your Project > Measures доступны различные метрики кода, вычисляемые после каждого запуска анализа. Всю собираемую информацию можно выводить в полезные графики. В секции Security вы можете следить за количеством предупреждений, выдаваемых на проект с пометкой CWE и MISRA:
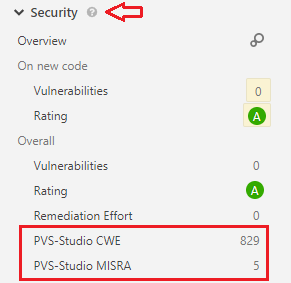
Остальные, общие метрики сообщений анализатора PVS-Studio, доступны в отдельной секции PVS-Studio.
Большинство действий, доступных для пользователей SonarQube, являются стандартными для этой платформы. Например, просмотр и сортировка результатов анализа, изменение статуса предупреждения и т.п. Поэтому в этом разделе будут описаны только дополнительные возможности, появляющиеся с установкой плагина PVS-Studio.
Предупреждения PVS-Studio делятся на несколько групп, из которых не все могут быть интересны для конкретного проекта. Поэтому вы можете фильтровать диагностики по следующим тегам при создании профиля или просмотре результатов анализа:
|
Группа диагностик в PVS-Studio |
Тег в SonarQube |
|---|---|
|
Диагностики общего назначения |
pvs-studio#ga |
|
Диагностики микро-оптимизаций |
pvs-studio#op |
|
Диагностики 64-битных ошибок |
pvs-studio#64 |
|
Стандарт MISRA |
pvs-studio#misra |
|
Диагностики, реализованные по запросам пользователей |
pvs-studio#cs |
|
Проблемы при работе анализатора кода |
pvs-studio#fails |
И стандартные теги, которые используются для предупреждений PVS-Studio:
|
Стандарты контроля качества кода |
Тег в SonarQube |
|---|---|
|
Стандарт CWE |
cwe |
|
Стандарт CERT |
cert |
|
Стандарт MISRA |
misra |
|
Стандарт ГОСТ |
sec, sec-* |
Стандартные теги SonarQube, в отличии от группы тегов pvs-studio#, могут включать, в зависимости от используемого quality-профиля, сообщения и от других инструментов, помимо PVS-Studio.
На вкладке Projects > Your Project > Measures доступны различные метрики кода, вычисляемые после каждого запуска анализа. С плагином добавляется секция PVS-Studio, где вы можете найти полезную информацию для проекта и строить графики:
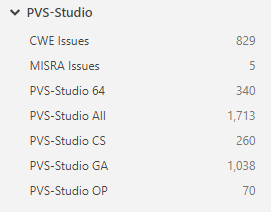
При работе на большой кодовой базе, анализатор неизбежно генерирует большое количество предупреждений. При этом часто нет возможности поправить все предупреждения сразу. Для того, чтобы иметь возможность сконцентрироваться на правке наиболее важных предупреждений и не "засорять" статистику, можно провести предварительную настройку анализатора и фильтрацию лога до запуска SonarQube Scanner. Это можно сделать несколькими способами.
1. Анализ можно сделать менее "шумным" с помощью настройки No Noise. Она позволяет полностью отключить генерацию предупреждений низкого уровня достоверности (Low Certainty, третий уровень предупреждений). После перезапуска анализа, сообщения этого уровня полностью пропадут из вывода анализатора. Для включения этой настройки в анализаторе, воспользуйтесь окном настроек Specific Analyzer Settings в Windows и общей документацией для Linux и macOS.
2. Анализ можно ускорить, исключив из проверки внешние библиотеки, код тестов и т.д. Для добавления файлов и каталогов в исключения, воспользуйтесь окном настроек Don't Check Files в Windows и общей документацией для Linux и macOS.
3. Если вам нужен дополнительный контроль над тем, какие сообщения анализатора будут попадать в отображаемые результаты, например, по уровню достоверности или кодам ошибок, воспользуйтесь утилитой для фильтрации и преобразования результатов (Plog Converter) на соответствующей платформе.
4. Если вам необходимо изменить важность предупреждения, это делается в настройках самого анализатора, а не в SonarQube. Сообщения PVS-Studio имеют следующие уровни достоверности: High, Medium, Low и Fails. В SonarQube им соответствуют уровни Critical, Major, Minor и Info. Изменение уровней описано на странице "Дополнительная настройка диагностик"
Автоматизировать процесс обновления позволяет SonarQube Web Api. Предположим, на вашем билд-сервере настроена система автоматического обновления PVS-Studio (как это описано в статье Развертывание PVS-Studio в больших командах). Для того, чтобы обновить плагины PVS-Studio и добавить новые диагностики в Quality Profile без использования веб-интерфейса, выполните следующие шаги (пример для Windows, на других ОС данная процедура выполняется аналогично):
sonar-pvs-studio-plugin.jar из директории установки PVS-Studio в директорию $SONARQUBE_HOME\extensions\plugins.Допустим, сервер SonarQube установлен в директории C:\Sonarqube\ и запущен как сервис. PVS-Studio установлена в директории C:\Program Files (x86)\PVS-Studio\. Тогда скрипт для автоматического обновления дистрибутива PVS-Studio и плагина sonar-pvs-studio-plugin будет иметь вид:
set PVS-Studio_Dir="C:\Program Files (x86)\PVS-Studio"
set SQDir="C:\Sonarqube\extensions\plugins\"
rem Update PVS-Studio
cd /d "C:\temp\"
xcopy %PVS-Studio_Dir%\PVS-Studio-Updater.exe . /Y
call PVS-Studio-Updater.exe /VERYSILENT /SUPPRESSMSGBOXES
del PVS-Studio-Updater.exe
rem Stop the SonarQube server
sc stop SonarQube
rem Wait until the server is stopped
ping -n 60 127.0.0.1 >nul
xcopy %PVS-Studio_Dir%\sonar-pvs-studio-plugin.jar %SQDir% /Y
sc start SonarQube
rem Wait until the server is started
ping -n 60 127.0.0.1 >nulapi/qualityprofiles/search, например (одной строкой):curl http://localhost:9000/api/qualityprofiles/search
-v -u admin:adminОтвет сервера имеет следующий формат:
{
"profiles": [
{
"key":"c++-sonar-way-90129",
"name":"Sonar way",
"language":"c++",
"languageName":"c++",
"isInherited":false,
"isDefault":true,
"activeRuleCount":674,
"rulesUpdatedAt":"2016-07-28T12:50:55+0000"
},
{
"key":"c-c++-c-pvs-studio-60287",
"name":"PVS-Studio",
"language":"c/c++/c#",
"languageName":"c/c++/c#",
"isInherited":false,
"isDefault":true,
"activeRuleCount":347,
"rulesUpdatedAt":"2016-08-05T09:02:21+0000"
}
]
}Допустим, нам нужно добавить новые диагностики в профиль PVS-Studio для языка c/c++/c#. Его ключом является значение c-c++-c-pvs-studio-60287.
api/qualityprofiles/activate_rules и укажите параметры profile_key (обязательный параметр) и tags. Обязательный параметр profile_key определяет ключ профиля в SonarQube, в котором будут активированы диагностики. В рассматриваемом примере этот параметр имеет значение c-c++-c-pvs-studio-60287.Обратите внимание на то, что ключ профиля может содержать специальные символы, и при отправке его в POST-запросе нужно произвести экранирование URL символов. Так, ключ профиля c-c++-c-pvs-studio-60287 должен быть преобразован в c-c%2B%2B-c-pvs-studio-60287
В параметре tags передайте теги диагностик, которые нужно активировать в профиле. Чтобы активировать все диагностики PVS-Studio, укажите тег pvs-studio.
В результате, запрос на добавление всех диагностик в профиль PVS-Studio будет иметь вид (одной строкой):
curl --request POST -v -u admin:admin -data
"profile_key=c-c%2B%2B-c-pvs-studio-60287&tags=pvs-studio"
http://localhost:9000/api/qualityprofiles/activate_rulesНастройка рассылки результата анализа происходит в несколько этапов. Сначала нужно настроить почту, с которой будут приходить оповещения. После этого каждый пользователь может выбрать необходимые оповещения.
Для настройки почты, находясь в роли Администратора, нужно перейти в раздел Administration > Configuration > General.
После этого необходимо заполнить параметры:
SMTP host(email.smtp_host.secured) — SMTP-сервер для отправки оповещений;SMTP port(email.smtp_port.secured) -— номер порта для отправления писем;SMTP username(email.smtp_username.secured) — имя пользователя для авторизации;SMTP password(email.smtp_password.secured) — пароль пользователя для авторизации;From address(email.from) — email адрес отправителя писем;From name(email.fromName) — наименование отправителя писем;Email prefix(email.prefix) — префикс исходящего письма.Примечание. В качестве Server base URL (sonar.core.serverBaseURL) нужно указать тот IP-адрес, на котором находится SonarQube. Это нужно, чтобы гиперссылки в письме ссылались на правильный сервер (по умолчанию они всегда будут отправлять на localhost).
Данные параметры можно задать в файле настроек сервера SonarQube, расположенном по пути sonarqube\conf\sonar.properties.
Чтобы проверить подключение к почте, можно отправить тестовое письмо в разделе Test Configuration.
После настройки отправителя каждый пользователь может выбрать нужные оповещения. Для этого нужно перейти в раздел My Account > Notifications. Есть различные типы оповещений, которые может выбрать пользователь. Отдельно можно выбрать оповещения для каждого проекта.
sonar-project.properties определены модули, и у вас есть отдельный отчёт анализатора для каждого модуля, то необходимо объединить отчёты в один с помощью утилиты PlogConverter и указать отчёт один раз в sonar.pvs-studio.reportPath.sonar.projectBaseDir, не будут проиндексированы, и сообщения, найденные в этих файлах, будут проигнорированы.CodeChecker — это интерфейс для работы со статическими анализаторами для Linux и macOS. С помощью данного инструмента можно удобно просматривать результаты анализа PVS-Studio и управлять ими.
Для того, чтобы запустить CodeChecker нужно создать виртуальное окружение Python (версии >= 3.8) и установить инструмент с помощью пакетного менеджера pip:
python3 -m venv .venv
source ./.venv/bin/activate
pip3 install codecheckerПримечание. Интеграция результатов анализа PVS-Studio доступна с версии CodeChecker 6.25.0.
Для корректного отображения severity у диагностических правил PVS-Studio необходимо скачать файл CodeChecker.json и положить его в этом виртуальном окружении Python, по пути .venv/share/codechecker/config/labels/analyzers с названием pvs-studio.json.
Теперь для запуска веб-сервера CodeChecker потребуется выполнить следующую команду:
CodeChecker serverПо умолчанию веб-сервер CodeChecker доступен по адресу http://localhost:8001.
О других способах установки и развёртывания CodeChecker можно прочитать в специальном разделе документации самого инструмента.
Для работы с отчётом PVS-Studio в CodeChecker его нужно привести в нужный формат. Помочь нам с этим может встроенный инструмент CodeChecker — report-converter.
Важно, что report-converter может преобразовать только JSON-отчёт PVS-Studio. Для преобразования отчёта PVS-Studio другого формата в JSON или фильтрации предупреждений необходимо использовать утилиты PlogConverter.exe для Windows и plog-converter для Linux/macOS:
Пример команды конвертации отчёта PVS-Studio при помощи plog-converter (Linux/macOS):
plog-converter -t json -a 'GA:1,2;OWASP:1'
-o /home/user/Logs/PVS-Studio.json PVS-Studio.logПример команды конвертации отчёта PVS-Studio при помощи PlogConverter.exe (Windows):
PlogConverter.exe -t Json -a 'GA:1,2;OWASP:1' -o /home/user/Logs
-n PVS-Studio PVS-Studio.plogДля преобразования отчёта PVS-Studio в формат CodeChecker необходимо выполнить следующую команду:
report-converter -t pvs-studio -o ./pvs_studio_reports ./PVS-Studio.jsonФлаг -t указывает формат входного отчёта, -o – директорию, в которую будут сохранены преобразованные предупреждения. Подробнее об остальных функциях report-converter можно прочитать в его документации.
Чтобы сохранить преобразованный отчёт на веб-сервере для дальнейшей работы с ним, необходимо выполнить следующую команду:
CodeChecker store ./codechecker_pvs_studio_reports -n defaultПосле флага -n необходимо передать название запуска CodeChecker.
После выполнения описанных выше действий в списке запусков для проекта появится запуск с указанным названием.
Нажав на его название, можно увидеть список предупреждений для этого проекта:
На данной странице можно фильтровать и сортировать предупреждения по определённым параметрам, например по уровню достоверности или названию диагностического правила.
Нажав на локацию конкретного срабатывания, можно увидеть место в коде, где это срабатывание произошло:
На этой же странице можно поменять Review status открытого срабатывания. Эта функция может быть полезна при разметке предупреждений анализатора после проведения анализа. Каждому срабатыванию можно поставить один из следующих статусов:
При пометке срабатывания как False Positive оно будет исключено из отображения отчёта, в том числе при всех следующих запусках.
Срабатывания, которых не было при предыдущих запусках помечаются в списке специальным значком, а также есть возможность просматривать разницу между конкретными запусками:
После нажатия кнопки Diff отобразится список только различающихся срабатываний:
Компания PVS-Studio и платформа AppSec.Hub заключили технологическое партнёрство для обеспечения интеграции статического анализатора кода PVS-Studio в экосистему DevSecOps. PVS-Studio — это инструмент для обнаружения потенциальных ошибок и уязвимостей в исходном коде на языках C, C++, C#, Java, Go, JS и TS. AppSec.Hub — это платформа для автоматизации процессов Application Security, которая позволяет объединять различные инструменты анализа, тестирования и мониторинга безопасности приложений.
На данный момент прямая интеграция PVS-Studio через пользовательский интерфейс (UI) AppSec.Hub отсутствует. Однако в AppSec.Hub можно загрузить результаты анализа PVS-Studio в виде отчёта и после этого работать с конкретными ошибками так же, как это позволяют и другие инструменты. Загрузка возможна двумя способами: через пользовательский интерфейс и командную строку с использованием CLI-инструментов.
Оба доступных варианта подразумевают работу с результатами анализатора (его отчётом) в формате, поддерживаемом AppSec.Hub. Для получения отчёта PVS-Studio в таком формате необходимо сделать следующие шаги.
PlogConverterна Windows и plog-converter на Linux и macOS, входящую в состав PVS-Studio, чтобы преобразовать отчёт анализатора в формат SARIF (Static Analysis Results Interchange Format). О том, как это сделать, можно прочитать в нашей документации.Клонируйте репозиторий AppSec.Hub с конвертерами:
git clone https://github.com/Swordfish-Security/hub-tool-converters.gitПерейдите в директорию конвертера:
cd hub-tool-convertersВыполните команду для конвертации:
python main.py -s pvs-Studio -t CODEBASE --format sarif \
-f <PATH_TO_REPORT_IN_SARIF> -o <OUTPUT_REPORT_FILE> \
-n <CODEBASE_NAME> -u <REPOSITORY_URL>Данный способ подразумевает ручную загрузку отчёта через UI AppSec.Hub. Сделать это можно следующим образом:
1. Откройте веб-интерфейс AppSec.Hub.
2. Перейдите в раздел Applications -> <Application Name> -> Issues.
3. Нажмите кнопку Actions в правом верхнем углу и выберите пункт Import from report.
4. Выберите файл отчёта анализатора PVS-Studio в формате AppSec.Hub, полученный в результате осуществления предварительных шагов.
5. Подтвердите импорт.
Подробнее об этом способе можно прочитать в официальной документации AppSec.Hub.
Такой способ подразумевает использование утилиты hub-cli, входящей в поставку AppSec.Hub, для автоматической загрузки отчёта. Сделать это можно следующим образом:
1. Убедитесь, что у вас установлена утилита hub-cli. Она должна идти в комплекте поставки AppSec.Hub.
2. Выполните команду для импорта отчёта:
python -m src.import_report --url <URL_TO_YOUR_APPSECHUB> --token <TOKEN> \
--appcode <APP_CODE> --application-name <APP_NAME> \
--report-file <OUTPUT_REPORT_FILE>Больше об этой программе можно узнать в официальной документации AppSec.Hub.
После загрузки отчёта во вкладке Issues появится список предупреждений, выданных анализаторов PVS-Studio.
На странице можно фильтровать и сортировать предупреждения по определённым параметрам, например, по уровню достоверности или названию диагностического правила. Подробнее о работе с дефектами безопасности можно прочитать в официальной документации AppSec.Hub.
Если у вас возникнут вопросы или сложности с интеграцией, обратитесь в техническую поддержку PVS-Studio или AppSec.Hub.
Компания PVS-Studio и платформа Hexway заключили технологическое партнёрство для обеспечения интеграции статического анализатора кода PVS-Studio в экосистему DevSecOps. PVS-Studio — это инструмент для обнаружения потенциальных ошибок и уязвимостей в исходном коде на языках C, C++, C#, Java, Go, JS и TS. Hexway VamPy — это решение, агрегирующее данные о безопасности из разных источников для работы с уязвимостями.
В Hexway можно загрузить результаты анализа PVS-Studio в виде отчёта и работать с конкретными ошибками так же, как это позволяют другие инструменты. Загрузка возможна двумя способами: через пользовательский интерфейс или командную строку с использованием CLI-инструментов.
Интеграция происходит с помощью преобразования отчёта PVS-Studio в формат SARIF. Для этого:
PlogConverter на Windows и plog-converter на Linux и macOS, входящую в состав PVS-Studio, чтобы преобразовать отчёт анализатора в формат SARIF (Static Analysis Results Interchange Format). О том, как это сделать, можно прочитать в нашей документации. Например, на Linux это можно сделать следующим образом: plog-converter -t sarif -o pvs-studio.sarif pvs-studio.jsonДля импорта отчёта через UI необходимо сделать следующее:
1. Перейдите на вкладку Repositories и выберете нужный репозиторий;
2. Нажмите на клавишу Scan внизу экрана;
3. Заполните поля и выберете файл для загрузки, затем нажмите клавишу Submit;
Импорт отчёта происходит с помощью утилиты vampy-cli, которая доступна на сайте Hexway. Полная команда загрузки отчёта выглядит следующим образом:
vampy-cli upload \
--scanner SARIF \
--file <PATH_TO_PVS_STUDIO_REPORT>
--repository <REPOSITORY>
--vampy-url <VAPMPY_URL>
--api-token <TOKEN>Больше об этом способе можно узнать в официальной документации Hexway.
Импорт отчёта происходит с помощью утилиты curl или иной утилиты, позволяющей посылать POST запросы на указанный адрес. Полная команда загрузки отчёта выглядит следующим образом:
curl -X POST "<YOUR_ADDRESS>/api/ext/v1/scan_uploads/" \
-H "accept: */*" \
-H "Content-Type: multipart/form-data" \
-H "Authentication: <TOKEN>"\
-F "repository=<REPO_NAME>" \
-F "repositoryBranch=<REPO_BRANCH>" \
-F "scannerResultFile=@<PATH_TO_PVS_STUDIO_REPORT>" \
-F "scannerType=SARIF"Больше об этом способе можно узнать в официальной документации Hexway.
После загрузки отчёта во вкладке Issues появится список предупреждений, выданных анализатором PVS-Studio.
На странице можно фильтровать и сортировать предупреждения по определённым параметрам, например, по уровню достоверности или названию диагностического правила. Подробнее о работе с дефектами безопасности можно прочитать в официальной документации Hexway.
Для разметки каждого предупреждения выберете нужное вам и нажмите на указанную кнопку.
Таким образом можно размечать сообщения, например, как исправленные, ложные, принятые и так далее.
Если у вас возникнут вопросы или сложности с интеграцией, обратитесь в техническую поддержку PVS-Studio или Hexway.
Облачный сервис и программное обеспечение SGRC Securitm позволяют построить управление информационной безопасностью на базе риск-ориентированного подхода и единой информационной модели компании.
Отчёт анализатора PVS-Studio можно загрузить в Securitm для дальнейшего использования.
Примечание. О работе непосредственно Securitm можно прочитать в документации этого инструмента.
Чтобы загрузить отчёт анализатора PVS-Studio в Securitm, его предварительно необходимо преобразовать в формат Sarif. Поможет с этим инструмент PlogConverter.
Пример команды на Windows:
PlogConverter.exe -t sarif -o ./ PVS-Studio.plogПример команды на Linux/macOS:
plog-converter -t sarif -o ./ PVS-Studio.jsonВ приведённых выше примерах команд флаг -t указывает на формат выходного отчёта, -o — на директорию, куда будет сохранён преобразованный отчёт. Последним параметром указывается путь до отчёта PVS-Studio, который нужно преобразовать.
Примечание. О том, какие ещё есть опции при конвертации отчёта, можно прочитать в специальном разделе документации.
Для того, чтобы импортировать результаты анализа PVS-Studio из полученного ранее отчёта, нужно в интерфейсе Securitm перейти во вкладку Технические уязвимости и нажать на кнопку Импорт в правой верхней части страницы:
После этого откроется окно, в котором можно выбрать файл отчёта PVS-Studio, а после нажать на кнопку Импорт. При удачном импорте результатов в нижней части окна появится соответствующее уведомление, а также статистика:
После импорта срабатывания анализатора PVS-Studio появятся в списке уязвимостей во вкладке Технические уязвимости:
В серверной версии Securitm также есть возможность интеграции результатов анализа с помощью встроенного API. Подробнее об этом можно прочитать в этом разделе документации Securitm.
Если нажать на любое из срабатываний анализатора в списке, можно подробнее узнать о нём. Например, на вкладке срабатывания можно найти ссылку на документацию, классификацию срабатывания по Common Weakness Enumeration (CWE) или сообщение анализатора:
Также каждое из срабатываний можно отправить в список принятых технических уязвимостей, а можно сразу открыть задачу на её исправление с помощью соответствующей кнопки Создать задачу:
В появившемся окне можно задать дополнительную информацию для задачи, а также выбрать ответственного за исправление уязвимости.
Список задач по устранению технических уязвимостей можно найти на той же странице, что и список срабатываний анализатора:
Securitm поддерживает рассылку результатов с помощью Telegram, а также интеграцию в Microsoft Teams. Этому посвящён раздел в документации инструмента.
Также есть возможность интеграции Securitm со многими другими инструментами, например Jira или Yandex Tracker. Об этом можно прочитать в этом разделе документации инструмента.
CyberCodeReview — это ASOC-платформа для анализа защищённости кода и приложений.
Примечание. Подробнее о возможностях платформы CyberCodeReview можно прочитать в документации.
Этот инструмент позволяет просматривать результаты анализа с помощью PVS-Studio. Для этого предусмотрена возможность загрузки кроссплатформенного JSON-отчёта PVS-Studio.
Примечание. О доступных форматах отчёта PVS-Studio и конвертации можно прочитать по ссылке.
На странице продукта внутри платформы необходимо нажать на кнопку Импорт, перетащить или выбрать файл JSON-отчёта PVS-Studio, в поле Сканер выбрать PVS-Studio, а также установить другие необходимые настройки. После этого нужно нажать на кнопку Импорт.
После этого, если в отчёте были срабатывания анализатора, они появятся в Security Center для данного продукта.
Примечание. Подробнее о загрузке отчёта с помощью UI можно прочитать в соответствующем разделе документации инструмента.
Помимо загрузки отчёта вручную через интерфейс CyberCodeReview, можно воспользоваться API данной платформы и загрузить отчёт через него. Для этого необходимо выполнить следующую команду:
curl -X POST localhost/api/v1/scan/import/ \
-H "Authorization: Token <authorization_token>" \
-H "Content-Type: multipart/form-data" \
-F "file=@<report_file_path>" \
-F "product_name=<product_name>" \
-F "product_type=<product_type>" \
-F "scanner_name=PVS-Studio" \
-F "branch=<branch_name>" \
-F "repository=<repository SSH URL>" \
-F "docker_image=<registry address>" \
-F "domain=<domain>" \
-F "host=<host>"В этой команде:
-X POST определяет используемый метод HTTP (в данном случае — POST);-H "Authorization: Token <authorization_token>" определяет токен авторизации, полученный из Security Center;-H "Content-Type: multipart/form-data" определяет тип содержимого запроса;-F "file=@<report_file_path>" определяет путь к файлу отчёта, создаваемого сканером;-F "product_name=<product_name>" определяет название сканируемого продукта;-F "product_type=<product_type>" определяет тип сканируемого продукта;-F "scanner_name=PVS-Studio" определяет имя сканера, используемого для создания отчёта (в данном случае выбран анализатор PVS-Studio);-F "branch=<branch_name>" (необязательно) указывает имя ветки в репозитории исходного кода (если применимо). Этот параметр особенно полезен, когда вы хотите связать результаты сканирования с определённой веткой в вашем репозитории. Если параметр не указан, сканирование будет связано с веткой по умолчанию.Также при использовании Auditor есть дополнительные параметры:
-F "repository=<repository SSH URL>". Если ваш продукт — это код в репозитории, введите адрес репозитория в определённом формате;-F "docker_image=<registry address>". Если ваш продукт — образ, введите адрес реестра, в котором находится продукт;-F "domain=<domain>". Если ваш продукт — веб-ресурс, введите его доменное имя;.-F "host=<host>". Если ваш продукт находится в Интернете, введите его IP-адрес.Примечание. Подробнее о загрузке отчёта с помощью API можно прочитать в соответствующем разделе документации инструмента.
После загрузки отчёта все срабатывания анализатора PVS-Studio появятся в списке необработанных уязвимостей. Уровни достоверности срабатываний PVS-Studio будут совпадать с уровнями критичности в веб-интерфейсе CyberCodeReview.
Открыв конкретное срабатывание, можно увидеть, на какой файл оно было выдано, какой идентификатор имеет по CWE, а также его сообщение.
Далее по срабатыванию анализатора можно создать задачу в Jira, подтвердив её и назначив ответственного исполнителя.
Примечание. Подробнее об интеграции CyberCodeReview в Jira можно прочитать в документации инструмента.
Jira – система управления задачами и проектами. Исправлять предупреждения от статического анализатора кода может быть удобно в рамках оформленной задачи.
Оформлять новую задачу на каждое предупреждение не рекомендуется по следующим причинам:
Тем не менее, исправление некоторых предупреждений или ошибок требует фиксации и контроля в системе управления задачами.
У пользователей, которые используют PVS-Studio, SonarQube и Jira одновременно, есть возможность в полуавтоматическом режиме создавать задачи из предупреждений анализатора. Делается это с помощью встроенного в Jira приложения SonarQube Connector for Jira. Добавить его к своему проекту можно в меню Jira Software > Apps > Find new apps > SonarQube Connector for Jira.
Для создания задачи из предупреждения PVS-Studio надо проделать несколько шагов:
Создание задач из выбранных предупреждений выглядит так:
Важно: для загрузки предупреждений анализатора в SonarQube требуется Enterprise лицензия PVS-Studio. Вы можете запросить пробную Enterprise лицензию здесь.
В данной статье рассматривается работа в среде Windows. Работа в среде Linux описана в статье "Как запустить PVS-Studio в Linux".
Для установки PVS-Studio требуются права администратора.
Автоматическая установка выполняется указанием дополнительных параметров командной строки:
PVS-Studio_setup.exe /verysilent /suppressmsgboxes
/norestart /nocloseapplicationsPVS-Studio может потребоваться перезагрузка компьютера в случае, например, если обновляемые файлы были заблокированы. Для установки без перезагрузки необходимо использовать флаг 'NORESTART'. Обратите внимание, что без этого флага при запуске установщика PVS-Studio в silent режиме перезагрузка может произойти без предварительных уведомлений или диалогов.
По умолчанию будут установлены все доступные компоненты PVS-Studio. В случае, если это не желательно, возможно указание компонентов для установки с помощью флага 'COMPONENTS' (далее перечислены все доступные компоненты):
PVS-Studio_setup.exe /verysilent /suppressmsgboxes
/nocloseapplications /norestart /components=Core,
Standalone,MSVS,MSVS\2010,MSVS\2012,MSVS\2013,MSVS\2015,MSVS\2017,
MSVS\2019,MSVS\2022,MSVS\2026,IDEA,JavaCore,Rider,CLion,VSCode,
DOTNET,Golang,JavaScript,WebStorm,PhpStorm,GoLandВы можете использовать нотацию /components="Core,*MSVS" для установки плагинов для всех Visual Studio одновременно.
Краткое описание компонентов:
Начиная с PVS-Studio 8.0 доступны следующие компоненты:
Во время установки PVS-Studio все экземпляры Visual Studio / IntelliJ IDEA / Rider должны быть выключены, однако для предотвращения потерь несохраненных документов установочный пакет не выгружает Visual Studio / IntelliJ IDEA / Rider самостоятельно.
Инсталлятор завершит работу с кодом завершения 100 в случае, если не сможет установить модуль расширения (*.vsix) для какой-либо из выбранных версий Visual Studio. Чтобы в этом случае инсталлятор завершался с кодом 0, передайте в командной строке флаг '/skipVSIXInstallErrorCode'. Сама установка при этом не меняется, а информация об ошибке по-прежнему записывается в журнал.
Получить дополнительную информацию о флагах можно с помощью 'HELP':
PVS-Studio_setup.exe /helpУтилита PVS-Studio-Updater.exe позволяет проверить наличие обновлений анализатора, а в случае их наличия, скачать и установить их на локальной машине. Для запуска утилиты обновления в "тихом" режиме можно использовать те же параметры, что и для дистрибутива:
PVS-Studio-Updater.exe /VERYSILENT /SUPPRESSMSGBOXESВ случае отсутствия обновлений на сервере, утилита завершит работу с кодом 0. Т.к. PVS-Studio-Updater.exe производит локальную установку PVS-Studio, во время его работы в системе также не должен быть запущен процесс devenv.exe.
Если в вашей системе используется прокси с авторизацией, утилита PVS-Studio-Updater.exe предложит вам ввести учетные данные для авторизации. Если учетные данные были введены корректно, PVS-Studio-Updater.exe сохранит их в Windows Credential Manager, и в дальнейшем будет использовать эти учетные данные для авторизации на прокси. Если вы хотите использовать утилиту с прокси без авторизации, вы можете сделать это с помощью флага proxy (/proxy=ip:port).
Начиная с версии 7.24 PVS-Studio для Windows поддерживает возможность изменения источника обновлений. Это может быть полезно, если вы не хотите, чтобы разработчики обновляли PVS-Studio сразу после выхода релиза.
Например, вы можете создать группу пользователей, которые получат обновления первыми и группу пользователей, которые должны получить обновление после того, как первая группа протестирует продукт.
Для первой группы никаких изменений в настройках не требуется, они будут получать обновления из релизного канала PVS-Studio.
Для второй группы необходимо развернуть альтернативный канал обновления. Для этого достаточно на своем сервере разместить файл version.xml и дистрибутив для установки PVS-Studio. После этого нужно изменить источник обновления на машинах разработчиков второй группы.
Информация об источнике обновления хранится в системном реестре: 'HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\ProgramVerificationSystems\PVS-Studio' в ключе 'UpdateUrl'. По умолчанию, там прописан стандартный адрес до файла version.xml, который содержит информацию об обновлении. Вы можете указать адрес до альтернативного файла version.xml, расположенного на вашем сервере. Например: https://myserver.com/version.xml
Файл version.xml имеет следующую структуру:
<ApplicationUpdate>
<!--Версия обновления PVS-Studio-->
<Version>7.23</Version>
<!--Ссылка для скачивания-->
<FileURL>https://myserver.com/PVS-Studio_setup.exe</FileURL>
<CompatibilityVersion>1</CompatibilityVersion>
</ApplicationUpdate>Теперь PVS-Studio будет проверять обновления через файл version.xml, который лежит на сервере myserver.com и при наличии обновления, скачает его с этого сервера.
Ещё один возможный вариант установки заключается в использовании менеджера пакетов Chocolatey. При использовании этого варианта установке в системе уже должен быть установлен сам пакетный менеджер.
Команда установки последней доступной версии пакета PVS-Studio:
choco install pvs-studioКоманда установки конкретной версии пакета PVS-Studio:
choco install pvs-studio --version=7.05.35617.2075При установке пакета также можно задать список устанавливаемых компонентов по аналогии с перечисленными в разделе "Автоматическое развёртывание" данного документа. Для указания компонентов используется флаг '--package-parameters'. Компоненты эквивалентны описанным выше и отличаются только синтаксисом некоторых параметров:
По умолчанию устанавливается только компонент 'Core'. При перечислении компонентов установки 'Core' указывать не нужно.
Пример команды, которая установит анализатор с компонентами 'Core' и 'Standalone':
choco install pvs-studio --package-parameters="'/Standalone'"Способы ввода лицензии при использовании различного окружения описаны в разделе документации "Как ввести лицензию PVS-Studio, и что делать дальше".
При развертывании на большое количество машин можно установить лицензию без ручного ввода ключа. Для этого необходимо скопировать файл настроек в папку, находящуюся в профиле пользователя.
Если несколько пользователей используют один и тот же компьютер, лицензия должна быть скопирована для каждого.
Расположение файла настроек по умолчанию:
%USERPROFILE%\AppData\Roaming\PVS-Studio\Settings.xmlЭтот файл можно редактировать любым текстовым редактором - это простой xml-файл. Следует отметить, что некоторые настройки могут отсутствовать в этом файле. В этом случае будут применены настройки по умолчанию.
Работа анализатора PVS-Studio зависит от окружения, поэтому невозможно его использование в полностью portable режиме, без предварительной настройки. Однако, если на нескольких машинах настроено одинаковое окружение, необходимое для корректной работы анализатора, то можно скопировать файлы анализатора с одного компьютера на другой. Это позволит использовать PVS-Studio на разных компьютерах без непосредственной установки на каждый из них.
Также, вы можете заложить файлы анализатора в систему контроля версий. Это облегчает развертывание и обновление PVS-Studio на большом количестве машин.
Шаг 1. Скачайте установщик PVS-Studio (.exe) с сайта и запустите его.
Шаг 2. После окончания установки введите лицензию как указано в документации.
Шаг 3. Скопируйте папку 'C:\Program Files (x86)\PVS-Studio' и файл настроек 'Settings.xml' на другой компьютер. Расположение файла настроек по умолчанию:
%USERPROFILE%\AppData\Roaming\PVS-Studio\Settings.xmlВ результате станет возможно запускать 'PVS-Studio_Cmd.exe' из папки, которая была скопирована на компьютер пользователя. При запуске анализа в аргументе '-s' необходимо указать путь до файла настроек:
PVS-Studio_Cmd.exe .... -s <pathToSettingsXml> ....Шаг 1. Скачайте установщик PVS-Studio (.exe) с сайта и запустите его;
Шаг 2. Cоздайте файл 'PVS-Studio.lic' с данными о лицензии рядом с ядром Java анализатора по пути 'C:\Program Files (x86)\PVS-Studio-Java'. В файле лицензии на отдельных строках должны быть указаны имя лицензии и лицензионный ключ, например:
LicenseName
ХХХХ-ХХХХ-ХХХХ-ХХХХПосле этого вы сможете перенести папку 'C:\Program Files (x86)\PVS-Studio-Java' на другой компьютер, где установлена Java версии 8 и выше. Это позволит использовать Java анализатор из скопированной папки, указав в аргументе '--license-path' путь до файла лицензии, созданный ранее:
java -jar pvs-studio.jar .... --license-path PVS-Studio.lic ....Для ускорения прохождения анализа можно использовать системы распределённой сборки, например, Incredibuild. Анализ C/C++ кода в PVS-Studio можно разделить на 2 этапа: препроцессирование и собственно анализ. Каждый из этих этапов может быть выполнен удалённо системой распределённой сборки. Для анализа каждого проверяемого C/C++ компилируемого файла, PVS-Studio запускает сначала внешний препроцессор, а затем непосредственно C++ анализатор. Каждый такой процесс может быть выполнен удалённо.
В зависимости от типа проверяемого проекта, анализ PVS-Studio запускается либо через утилиту PVS-Studio_Cmd.exe (для MSBuild проектов), либо с помощью утилиты для отслеживания вызовов компилятора CLMonitor.exe \ Standalone.exe (для любой сборочной системы). Далее, одна из этих утилит будет запускать для каждого проверяемого файла сначала препроцессор (cl.exe, clang.exe для Visual C++ проектов, для остальных – тот же процесс, что использовался при компиляции), а затем C++ анализатор PVS-Studio.exe.
Задание для настройки 'ThreadCount' значения, большего '16' (или большего, чем количество ядер процессора, если у процессора более 16 ядер), доступно только при наличии Enterprise лицензии PVS-Studio. Вы можете запросить пробную Enterprise лицензию здесь.
Данные процессы запускаются параллельно, в зависимости от настройки PVS-Studio|Options...|Common AnalyzerSettings|ThreadCount. Увеличивая количество параллельно проверяемых файлов с помощью этой настройки, и разнеся выполнение этих процессов дополнительно на удалённые машины, можно существенно (в несколько раз) сократить полное время анализа.
Приведём пример ускорения анализа PVS-Studio c использованием распределённой системы Incredibuild. Для этого нам потребуется консольная утилита управления IBConsole. Мы будем использовать интерфейс для автоматического перехвата (Automatic Interception Interface), который позволяет удалённо выполнять любой процесс, перехваченный этой системой. Запуск утилиты IBConsole для распределённого анализа с помощью PVS-Studio будет иметь следующий вид:
ibconsole /command=analyze.bat /profile=profile.xmlФайл analyze.bat должен содержать строку запуска анализатора, PVS-Studio_Cmd.exe или CLMonitor.exe, со всеми необходимыми им параметрами (более подробно можно посмотреть в соответствующем разделе документации). Файл profile.xml содержит конфигурацию для интерфейса автоматического перехвата. Вот пример такой конфигурации для анализа MSBuild проекта с помощью PVS-Studio_Cmd.exe:
<?xml version="1.0" encoding="UTF-8" standalone="no" ?>
<Profile FormatVersion="1">
<Tools>
<Tool Filename="PVS-Studio_Cmd" AllowIntercept="true" />
<Tool Filename="cl" AllowRemote="true" />
<Tool Filename="clang" AllowRemote="true" />
<Tool Filename="PVS-Studio" AllowRemote="true" />
</Tools>
</Profile>Посмотрим, что означает каждая запись в этом файле. Мы видим, что для PVS-Studio_Cmd задан атрибут AllowIntercept со значением 'true'. Это означает, что процесс с таким именем не будет сам запускаться распределённо, но система автоматического перехвата будет следить за порождаемыми этим процессом дочерними процессами.
Для процессов препроцессора cl и clang и C/C++ анализатора PVS-Studio задан атрибут AllowRemote. Это означает, что процессы с такими именами, будучи отловленными у процессов с AllowIntercept, будут потенциально выполнены на других (удалённых) агентах Incredibuild.
Перед запуском IBConsole необходимо задать настройку PVS-Studio|Options...|Common AnalyzerSettings|ThreadCount в соответствии с суммарным количеством ядер, доступных на всех Incredibuild агентах. Если этого не сделать, эффекта от использования Incredibuild не будет!
Примечание: во время анализа Visual C++ проектов, PVS-Studio использует clang.exe, поставляемый в дистрибутиве PVS-Studio, для препроцессирования C/C++ файлов перед анализом, вместо препроцессора cl.exe. Это сделано для ускорения препроцессирования, т.к. clang работает быстрее, чем cl. Некоторые старые версии Incredibuild выполняют распределённый запуск препроцессора clang.exe не совсем корректно, что приводит к ошибкам препероцессирования. Поэтому, clang не стоит прописывать в файле конфигурации IBConsole, если ваша версия Incredibuild работает с clang некорректно.
Используемый тип препроцессора во время анализа задаётся настройкой PVS-Studio|Options...|Common AnalyzerSettings|Preprocessor. Если выбрать для этой настройки значение 'VisualCpp', PVS-Studio будет использовать для препроцессирования только cl.exe, который будет выполняться распределённо, но медленне чем clang, который распределённо выполняться не может. Данную настройку стоит выбрать в зависимости от типа проекта и количества доступных для анализа агентов – при большом количестве агентов выбор VisualCpp будет оправдан. При небольшом количестве агентов, локальное препроцессирование с помощью clang может оказаться быстрее.
Имеется возможность использования системы отслеживания вызовов компиляторов (утилиты CLMonitor.exe и Compiler Monitoring UI) при распределенном анализе проекта с помощью Incredibuild. Подобная связка позволит намного быстрее провести анализ проекта, однако, имеет свои особенности. Системы отслеживания вызовов компиляторов не могут отслеживать удаленные вызовы компилятора, и CLMonitor.exe поддерживает трассировку только для локальных сборок.
Анализ мониторинга компилятора, запущенного Incredibuild-ом, может оказаться некорректным, потому что системы отслеживания вызовов компиляторов не отловят вызовы компилятора на других машинах. Тем не менее, имеется возможность распараллелить при помощи Incredibuild анализ дампа, полученного при помощи систем отслеживания вызовов компиляторов. Для этого необходимо получить дамп запуска компилятора.
В случае использования CLMonitor.exe порядок действий для получения дампа мониторинга компилятора такой:
CLMonitor.exe monitor;CLMonitor.exe saveDump -d c:\monitoring.zipВ случае использования Compiler Monitoring UI дамп возможно получить выполнив следующие действия после запуска Compiler Monitoring UI:
Аналогично предыдущему примеру для распределенного анализа дампа используем ibconsole:
ibconsole /command=analyze.bat /profile=profile.xmlОднако теперь в файле analyze.bat вместо вызова PVS-Studio_Cmd.exe необходимо вызвать CLMonitor.exe в режиме анализа дампа файла:
CLMonitor.exe analyzeFromDump -l "с:\ptest.plog" -d "c:\monitoring.zip"В случае с Compiler Monitoring UI вместо PVS-Studio_Cmd.exe необходимо вызвать Standalone.exe:
Standalone.exeВ файле настроек же необходимо заменить PVS-Studio_Cmd на CLMonitor / Standalone и cl, при необходимости, заменить на тот тип препроцессора, который используется при сборке (gcc, clang). Например:
<?xml version="1.0" encoding="UTF-8" standalone="no" ?>
<Profile FormatVersion="1">
<Tools>
<Tool Filename="CLMonitor" AllowIntercept="true" />
<Tool Filename="gcc" AllowRemote="true" />
<Tool Filename="PVS-Studio" AllowRemote="true" />
</Tools>
</Profile>Также не забываем задать настройку PVS-Studio|Options...|Common AnalyzerSettings|ThreadCount в соответствии с суммарным количеством ядер, доступных на всех Incredibuild агентах. Если этого не сделать, эффекта от использования Incredibuild не будет!
При задании настройки ThreadCount следует помнить, что машина-координатор анализа (т.е. та, на которой будет работать PVS-Studio_Cmd/CLMonitor/Standalone) будет заниматься обработкой результатов, приходящих ото всех процессов PVS-Studio.exe. Данная задача сейчас не может быть распределена – поэтому, особенно когда ThreadCount задаётся очень большим (более 50 процессов одновременно), стоит подумать о том, чтобы "разгрузить" машину-координатор от непосредственно задач анализа (т.е. выполнения процессов анализатора и препроцессора). Это можно сделать с помощью флага IBConsole '/AvoidLocal' или в настройках локального агента Incredibuild на машине координаторе.
При использовании Compiler Monitoring UI для запуска анализа файла дампа мониторинга компиляции необходимо выбрать пункт меню Tools -> Analyze Your Files... и указать путь до файла дампа, прежде чем запустить анализ дампа:
Итогом распределенного анализа дампа будет файл с:\ptest.plog при использовании CLMonitor.exe или предупреждения анализатора в таблице в интерфейсе Compiler Monitoring UI:
Сообщения из таблицы возможно сохранить в файлы в различных форматах используя пункты меню:
При подобном варианте анализа процессы PVS-Studio.exe будут распределены Incredibuild-ом по всем используемым машинам, а CLMonitor.exe распараллелен не будет.
Больше всего пользы подобный вид анализа принесет на большом проекте, в котором редко изменяется структура проекта (добавление, удаление, переименование файлов и т.п.), но часто изменяется их содержимое.
PVS-Studio распространяется в виде Deb/Rpm пакетов или архива. Воспользовавшись установкой из репозитория, вы сможете получать обновления о выходе новой версии программы.
В дистрибутиве содержатся следующие файлы:
Установить анализатор можно следующими способами:
До Debian 11 и Ubuntu 22.04:
wget -q -O - https://cdn.pvs-studio.ru/etc/pubkey.txt | \
sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://cdn.pvs-studio.ru/etc/viva64.list
sudo apt-get update
sudo apt-get install pvs-studioПосле Debian 11 и Ubuntu 22.04:
wget -qO- https://cdn.pvs-studio.ru/etc/pubkey.txt | \
sudo gpg --dearmor -o /etc/apt/trusted.gpg.d/viva64.gpg
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://cdn.pvs-studio.ru/etc/viva64.list
sudo apt-get update
sudo apt-get install pvs-studiowget -O /etc/yum.repos.d/viva64.repo \
https://cdn.pvs-studio.ru/etc/viva64.repo
yum update
yum install pvs-studiowget -q -O /tmp/viva64.key \
https://cdn.pvs-studio.ru/etc/pubkey.txt
sudo rpm --import /tmp/viva64.key
sudo zypper ar -f https://cdn.pvs-studio.ru/rpm viva64
sudo sed -i \
's|enabled=1|enabled=1\ngpgkey=https://cdn.pvs-studio.ru/etc/pubkey.txt|' \
/etc/zypp/repos.d/viva64.repo
sudo zypper refresh
sudo zypper install pvs-studioЗагрузка ключа для режима ЗПС.
sudo curl -fsSL -o /etc/digsig/keys/pvs-studio_astra_pub.key \
https://cdn.pvs-studio.ru/etc/pvs-studio_astra_pub.key
sudo update-initramfs -u -k all
sudo rebootПодключение репозитория и установка.
curl -fsSL "https://cdn.pvs-studio.ru/etc/pubkey.txt" \
| sudo gpg --dearmor --yes -o /etc/apt/trusted.gpg.d/viva64.gpg
sudo curl -fsSL -o /etc/apt/sources.list.d/viva64.astra.list \
https://cdn.pvs-studio.ru/etc/viva64.astra.list
sudo apt-get update
sudo apt-get install pvs-studioВы можете скачать PVS-Studio для Linux здесь.
Также вам необходимо установить утилиту strace версии 4.11 или выше для функционирования режима трассировки компиляции.
sudo gdebi pvs-studio-VERSION.debили
sudo dpkg -i pvs-studio-VERSION.deb
sudo apt-get -f installsudo dnf install pvs-studio-VERSION.rpmили
sudo zypper install pvs-studio-VERSION.rpmили
sudo yum install pvs-studio-VERSION.rpmили
sudo rpm -i pvs-studio-VERSION.rpmtar -xzf pvs-studio-VERSION.tgz
sudo ./install.shПосле успешной установки анализатора на ваш компьютер, для проверки проекта следуйте инструкциям на этой странице: "Как запустить PVS-Studio в Linux".
PVS-Studio распространяется в виде графического инсталлятора, архива или через Homebrew репозиторий. Воспользовавшись установкой из репозитория, вы сможете получать обновления анализатора автоматически.
В дистрибутиве содержатся следующие файлы:
Установить анализатор можно следующими способами:
Установка:
brew install viva64/pvs-studio/pvs-studioОбновление:
brew upgrade pvs-studioЗапуститите .pkg файл и следуйте инструкциям инсталлятора:
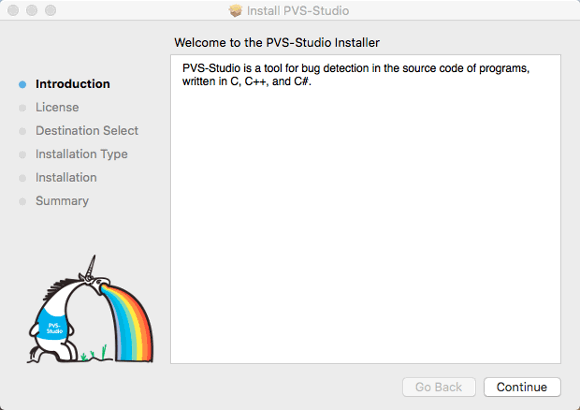
Распакуйте архив и поместите исполняемые файлы в каталог, доступный в PATH.
tar -xzf pvs-studio-VERSION.tgzПосле успешной установки анализатора на ваш компьютер, для проверки проекта следуйте инструкциям на этой странице: "Как запустить PVS-Studio в Linux и macOS".
Анализатор PVS-Studiо позволяет легко посмотреть наиболее интересные предупреждения, чтобы ускорить и упростить ознакомление и начальную работу с отчетом. Это предупреждения наших самых интересных и опасных диагностических правил, которые с наибольшей вероятностью являются реальными ошибками.
Данный механизм предназначен прежде всего для знакомства с возможностями анализатора.
Режим отображения интересных предупреждений не является заменой работы с полным отчётом анализатора, т.к. в полном отчёте могут содержаться не менее опасные потенциальные ошибки, на которые также нужно обратить внимание.
В основе механизма отбора интересных предупреждений лежит оценка срабатываний анализатора на основе ряда критериев, которые мы называем весами. Для каждой диагностики задан изначальный вес, который отражает вероятность обнаружить с её помощью качественную (интересную) ошибку. Веса были проставлены в соответствие с нашим многолетним опытом работы со статическим анализатором и статистикой анализа разнообразных проектов. Далее эти веса корректируются с учетом:
В итоге на выходе получается список пар "предупреждение-вес". Из этого списка будет выбрано не более десяти самых "тяжелых" предупреждений.
Для Microsoft Visual Studio доступен плагин PVS-Studio, удобно интегрированный в IDE. Он позволяет запускать анализ всего solution'а, конкретных проектов или отдельных файлов, а также поддерживает инкрементальный анализ.
Механизм отображения интересных предупреждений находится в специальном окне просмотра результатов анализа в Visual Studio:
Данное окно появляется автоматически, например, при выполнении анализа проекта. Если же его необходимо отобразить вручную, то это делается из настроек расширения PVS-Studio:
Само окно позволяет выполнять навигацию по найденным предупреждениям и переходить к коду для его исправления. Также оно предоставляет широкие возможности фильтрации и сортировки результатов. Дополнительно присутствует возможность быстрого перехода к документации выбранной диагностики.
Чтобы отобразить лучшие срабатывания, необходимо нажать на кнопку 'Best'.
В результате в окне окажутся только лучшие предупреждения. При повторном нажатии в окне будут отображаться все найденные ошибки.
Начиная с версии PVS-Studio 7.22 механизм Best Warning поддерживается в плагинах Rider, IntelliJ IDEA и СLion. Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора, нажмите на кнопку 'Best', как показано на скриншоте ниже:
После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора. При повторном нажатии в окне будут отображаться все найденные ошибки.
Если вы новый пользователь, то также рекомендуем ознакомиться с:
Механизм подавления предупреждений анализатора, также называемый созданием baseline-уровня сообщений, подходит для следующих сценариев:
В этих ситуациях предупреждения анализатора можно подавить специальным образом, чтобы они больше не попадали в новые отчёты. Использование этого режима не требует модификации файлов с исходным кодом проекта.
Анализатор поддерживает анализ исходного кода для языков программирования C, C++, C#, Java, Go, JS и TS. Анализ может быть выполнен на операционных системах Windows, Linux и macOS. В связи с этим, способы подавления предупреждений могут отличаться в зависимости от используемой платформы и типа проектов, поэтому перейдите в раздел, который Вам подходит, и следуйте приведённой там инструкции.
Механизм подавления сообщений основан на использовании специальных файлов, которые добавляются рядом с проектом (или в любом заданном месте). Такие файлы подавления содержат сообщения, размеченные для данного проекта как "ненужные". Заметим, что модификация исходного файла, содержащего размеченные сообщения, и, в частности, сдвиг строк, не приведёт к повторному появлению подавленных сообщений. Однако, правка строки, содержащей сообщение анализатора, может привести к его повторному появлению, т.к. такое сообщение уже считается "новым".
Предупреждение считается подавленным, если в suppress-файле имеется запись, элементы которой эквивалентны соответствующим полям предупреждения из отчёта анализатора (всего их 6):
При записи в файл подавления сообщение предупреждения нормализуется, а именно:
При вычислении хэш-кодов обрабатывается не вся строка, а только символы до первого комментария ложного срабатывания (строчный комментарий, попадающий под один из паттернов: //-VXXXX, //-VXXX, //-vXXXX или //-vXXX, где X – это символ числа от 0 до 9). При этом символы табуляции и пробелов игнорируются.
Изменения исходного кода, которые отменяют подавление предупреждений:
Изменения исходного кода, которые не отменяют подавление предупреждений:
Для Microsoft Visual Studio доступен плагин PVS-Studio, удобно интегрированный в IDE. Он позволяет запускать анализ всего solution'а, конкретных проектов или отдельных файлов, а также поддерживает инкрементальный анализ.
В меню PVS-Studio доступен пункт Suppress Messages, открывающий окно для работы с подавленными предупреждениями анализатора.
В открывшемся окне доступно несколько действий:
Для просмотра результатов анализа в Visual Studio существует специальное окно.
Специальное окно позволяет выполнять навигацию по найденным предупреждениям и переходить к коду для его исправления. Окно PVS-Studio предоставляет широкие возможности фильтрации и сортировки результатов. Также присутствует возможность быстрого перехода к документации выбранной диагностики.
Дополнительные возможности работы с каждым сообщением доступны в контекстном меню по нажатию на правый клик мыши на сообщении.
Для добавления нескольких выбранных предупреждений во все suppress файлы, связанные с предупреждениями, имеется пункт меню "Add selected messages to all suppression files". Кроме этого пункта меню имеется пункт "Add selected messages to primary suppression files". Он позволяет подавить несколько выбранных предупреждений только в primary suppress файлы, связанные с выбранными предупреждениями.
Primary – это метка для suppress файлов, позволяющая приоритизировать использование файлов с такой меткой при подавлении предупреждений. По умолчанию при использовании обычных suppress файлов выбранные предупреждения будут подавлены во все suppress файлы проекта или решения. Если вы хотите подавлять новые предупреждения анализатора только в какой-то конкретный suppress файл, но при этом у вас имеются другие suppress файлы с подавленными ранее предупреждениями, которые вы не хотите модифицировать, то пометьте ваш suppress файл для новых срабатываний как primary.
Использование primary метки позволяет разделить предупреждения, подавленные при внедрении PVS-Studio в проект, от предупреждений, которые были подавлены в ходе дальнейшего регулярного использования анализатора. В таком случае подавленные первоначально предупреждения обычно требуют обработки в будущем (так как их обычно не изучают внимательно), а предупреждения, полученные в результате регулярного использования анализатора, уже по определению просмотрены пользователем.
Primary suppress файлы в выпадающих списках обозначаются дополнительным текстом в скобках:
Добавление Primary suppress файла в проект или решение происходит аналогично добавлению обычного suppress файла через пункт меню "New item..." в контекстном меню проекта/решения:
Также имеется возможность пометить все suppress файлы как primary при подавлении всех предупреждений ("Suppress All") или только отфильтрованных предупреждений ("Suppress Filtered"). Для этого необходимо выбрать чекбокс в окне сообщения, которое выдаётся при подавлении:
Для расподавления нескольких выделенных предупреждений имеется пункт меню "Remove selected messages from all suppression files". Этот пункт отображается в контекстном меню окна вывода результатов, если выбрано более одного предупреждения и хотя бы одно из них подавлено:
При выборе одного предупреждения в контекстном меню доступны пункты не только для подавления/расподавления, но и для перемещения. При перемещении предупреждение удаляется из всех suppress файлов и добавляется в выбранные suppress файлы:
Также при выборе одного предупреждения в окне вывода результатов при наведении мыши на пункты меню, связанные с suppress файлами, появляются выпадающие списки suppress файлов:
В этих выпадающих списках возможно выбрать один suppress файл, все suppress файлы или все primary suppress файлы из списка. Выбранные suppress файлы будут использованы при выполнении команды подавления/расподавления, перемещения.
Пролистывать список suppress файлов возможно при помощи элементов интерфейса сверху и снизу списка со стрелками, либо при помощи клавиш стрелок "Вверх" и "Вниз". Выбрать элемент из списка можно при помощи клавиши "Enter" или левой кнопки мыши.
Из подменю окна вывода результатов плагина возможно включить отображения подавленных предупреждений:
Также включить отображение подавленных предупреждений возможно в окне работы с suppress файлами "Extensions -> PVS-Studio -> Suppress Messages...":
Кроме этого, в подменю таблицы при отображении подавленных предупреждений появляется список с отображаемыми suppress файлами. Убирая или выставляя галочку в чекбоксах из этого списка, возможно включать или отключать отображение подавленных предупреждений из определённых suppress файлов:
Изменения отображения подавленных предупреждений в окне вывода результатов происходят только после закрытия списка отображаемых suppress файлов.
Пролистывать список отображаемых suppress файлов возможно при помощи элементов интерфейсаI сверху и снизу списка со стрелками, либо при помощи клавиш стрелок "Вверх" и "Вниз". Выбирать элемент из списка при помощи клавиши "Enter" или левой кнопки мыши.
Вы можете добавить suppress файл в проект как некомпилируемый\текстовый файл с помощью команд меню 'Add New Item...' или 'Add Existing Item...'. Такое добавление позволяет держать suppress файлы и файлы проектов в разных директориях. Поддерживается добавление нескольких suppress файлов в проект.
Вы можете добавить suppress файл в решение (solution). Сделать это можно с помощью команд меню 'Add New Item...' или 'Add Existing Item...'. Как и для проектов, для решений поддерживается добавление нескольких suppress файлов.
Suppress файл уровня solution позволяет подавлять сообщения во всех проектах соответствующего solution. Если у проектов есть отдельные suppress файлы, анализатор будет учитывать как предупреждения, подавленные в suppress файле solution, так и в suppress файле проекта.
Механизм подавления сообщений можно также использовать напрямую из командной строки. Утилита командной строки PVS-Studio_Cmd.exe автоматически подхватывает существующие suppress файлы при проверке. Также её можно использовать для подавления ранее сгенерированных сообщений анализатора, сохранённых в plog файле. Для подавления сообщений из существующего plog файла необходимо запустить PVS-Studio_Cmd.exe с флагом '--suppressAll'. Например (в одну строку):
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe"
-t "Solution.sln" -o "results.plog" --suppressAll SuppressOnlyИсполнение команды сгенерирует suppress файлы для всех проектов, содержащихся в Solution.sln, на которые были сгенерированы сообщения в results.plog.
Флаг '--suppressAll' поддерживает два режима работы:
Также через аргумент -u возможно указать путь до suppress файла. Этот suppress файл будет создан, если он ещё не существовал. В этот suppress файл будут добавлены все предупреждения анализатора.
В PVS-Studio-Cmd.exe имеется режим работы suppression. Он предназначен для:
В этом режиме, аналогично основному режиму работы PVS-Studio-Cmd.exe через флаг -u возможно передать пути до suppress файлов. Эти suppress файлы будут использованы наравне с suppress файлами проектов и решения.
В режиме "suppression" в PVS-Studio_Cmd.exe через флаг -m указывается режим работы:
В режимах CreateEmptySuppressFiles, Suppress и UnSuppress будут использоваться только suppress файлы, чьи имена совпали с паттерном имени suppress файлов (флаг -P). В этом паттерне имеется переменная %projName%, вместо которой подставляется имя проекта.
Пометка suppress файлов как primary (флаг -M) происходит только в режимах CreateEmptySuppressFiles и Suppress.
В режимах Suppress и UnSuppress возможно указать фильтры для предупреждений из отчёта анализатора через флаги фильтров:
Пример команды запуска PVS-Studio_Cmd.exe в режиме suppression:
"C:\Program Files (x86)\PVS-Studio\PVS-Studio_Cmd.exe" suppression
-t "Solution.sln" -R "results.plog" --mode Suppress
-g GA:1,2,3|OWASP:2|64 -E V501,V1001,V3001
-f filename*11,54|absolute/path/filename*1|relative/path/to/directory
-P Prefix_%projName%_Postifx -MPVS-Studio на Windows можно использовать не только для проверки MSBuild \ Visual Studio проектов. С помощью системы отслеживания вызовов компилятора, вы можете запустить статический анализ любых типов проектов, использующих один из поддерживаемых в PVS-Studio C++ компиляторов.
При запуске анализа, после мониторинга сборки, с помощью команды
clmonitor.exe analyze --useSuppressFile %PathToSuppressFile%можно с помощью дополнительного флага --useSuppressFile (-u) передать анализатору путь до suppress файла, который будет использован при проверке.
Помимо консольного инструмента CLMonitor.exe, использовать мониторинг компиляции можно также и с помощью графической утилиты C and C++ Compiler Monitoring UI. Эта утилита предоставляет возможности для проверки кода, независимо от используемого компилятора или сборочной системы, а затем позволяет работать с результатами анализа, предоставляя пользовательский интерфейс, схожий с Visual Studio плагином PVS-Studio.
Тем не менее, если у вас есть проект, который можно открыть в Visual Studio, мы рекомендуем вам, для просмотра результатов анализа использовать Visual Studio плагин PVS-Studio, т.к. возможности встроенного в Compiler Monitoring UI редактора кода значительно уступают редактору кода Visual Studio. Для этого вы можете сохранить отчёт анализатора и переоткрыть его в Visual Studio.
Меню для запуска анализа и подавления предупреждений выглядит следующим образом.
При выборе пункта меню для запуска анализа появится окно "Compiler Monitoring (C and C++)".
Для фильтрации предупреждений анализатора, перед анализом необходимо указать файл с подавленными ранее предупреждениями. Создать и пополнять такой файл можно через меню "Message Suppression...", которое является таким же, как было представлено в разделе про Visual Studio на рисунке 2. После завершения анализа в окне PVS-Studio будут отображены только новые ошибки. Без указания файла анализатор выдаст все результаты.
В Linux/macOS команды подавления и фильтрации сообщений анализатора выполняются только в консоли, при необходимости этот процесс может быть автоматизирован на сервере, выполняющем автоматический запуск анализа. Есть несколько способов использования этого механизма, в зависимости от варианта интеграции анализатора.
Для подавления всех предупреждений анализатора (первый раз и в последующих случаях) необходимо выполнять команду:
pvs-studio-analyzer suppress /path/to/report.logЕсли вы хотите подавить предупреждение для какого-либо конкретного файла, воспользуйтесь флагом --file(-f):
pvs-studio-analyzer suppress -f test.c /path/to/report.logПомимо самого файла, вы можете явно указать номер строки для подавления:
pvs-studio-analyzer suppress -f test.c:22 /path/to/report.logПри такой записи будут подавлены все предупреждения, которые находятся на строке 22 файла 'test.c'.
Этот флаг можно указывать несколько раз, тем самым подавив предупреждения сразу в нескольких файлах.
Помимо явного указания файла, есть механизм подавления конкретных диагностик:
pvs-studio-analyzer suppress -v512 /path/to/report.logФлаг --warning(-v) так же можно указывать несколько раз:
pvs-studio-analyzer suppress -v1040 -v512 /path/to/report.logУказанные выше флаги --file и --warning можно комбинировать для более точечного подавления предупреждений:
pvs-studio-analyzer suppress -f test.c:22 -v512 /path/to/report.logТак, указанная выше команда подавит все предупреждения диагностики V512 на 22 строке файла 'test.c'.
Анализ проекта можно запускать как прежде. При этом подавленные предупреждения будут фильтроваться:
pvs-studio-analyzer analyze ... -o /path/to/report.log
plog-converter ...При таком запуске подавленные предупреждения будут сохраняться в текущем каталоге, в файле с именем suppress_file.suppress.json, который надо хранить с проектом. Новые подавленные предупреждения будут дописываться в этот файл. Если необходимо указать другое имя или расположение файла, то команды выше можно дополнить, указав путь до файла с подавленными предупреждениями.
Прямая интеграция анализатора может выглядеть следующим образом:
.cpp.o:
$(CXX) $(CFLAGS) $(DFLAGS) $(INCLUDES) $< -o $@
pvs-studio --cfg $(CFG_PATH) --source-file $< --language C++
--cl-params $(CFLAGS) $(DFLAGS) $(INCLUDES) $<В этом режиме интеграции происходит вызов C++ ядра анализатора напрямую, поэтому анализатор не может одновременно проверять исходные файлы и фильтровать их. Поэтому для фильтрации и подавления предупреждений потребуется вызывать дополнительные команды.
Для подавления всех предупреждений анализатора необходимо выполнить команду:
pvs-studio-analyzer suppress /path/to/report.logДля фильтрации нового лога по ранее сгенерированному файлу подавления, необходимо воспользоваться следующими командами:
pvs-studio-analyzer filter-suppressed /path/to/report.log
plog-converter ...Файл с подавленными предупреждениями также имеет имя по умолчанию suppress_file.suppress.json, для которого при необходимости можно задать произвольное имя.
Для просмотра результатов анализа в IntelliJ IDEA существует специальное окно.
Специальное окно позволяет выполнять навигацию по найденным предупреждениям и переходить к коду для его исправления. Окно PVS-Studio предоставляет широкие возможности фильтрации и сортировки результатов. Также присутствует возможность быстрого перехода к документации выбранной диагностики.
Дополнительные возможности работы с каждым сообщением доступны в контекстном меню по нажатию на правый клик мыши на сообщении. Здесь доступна команда для подавления выделенного предупреждения.
В плагине PVS-Studio для IntelliJ IDEA есть механизм, который позволяет подавить сразу все сообщения одним нажатием кнопки:
По умолчанию файл подавления расположен по пути {projectPath}/.PVS-Studio/suppress_base.json, но в настройках плагина есть возможность изменить этот путь:
Какой бы способ подавления Вы не использовали, при следующем анализе подавленные Вами сообщения не попадут в отчет.
Для подавления предупреждений анализатора необходимо выполнять команду:
./gradlew pvsSuppress "-Ppvsstudio.report=/path/to/report.json"
"-Ppvsstudio.output=/path/to/suppress_base.json"Для подавления предупреждений анализатора необходимо выполнять команду:
mvn pvsstudio:pvsSuppress "-Dpvsstudio.report=/path/to/report.json"
"-Dpvsstudio.output=/path/to/suppress_base.json"Для подавления предупреждений анализатора необходимо выполнять команду:
java -jar pvs-studio.jar --convert toSuppress
--src-convert "/path/to/report.json"
--dst-convert "/path/to/suppress_base.json"Использование baseline-инга для Unreal Engine проектов описано в отдельном разделе про использование PVS-Studio для Unreal Engine проектов.
В плагинах PVS-Studio for CLion и PVS-Studio for Rider на данный момент имеется возможность подавления всех сообщений анализатора. Чтобы подавить сообщения анализатора на старом коде, можно воспользоваться кнопкой 'Suppress All Messages' на панели окна PVS-Studio:
В Rider также имеется возможность подавить все сообщения из главного меню 'Tools -> PVS-Studio -> Suppress All Messages':
Механизм подавления работает с помощью специальных *.suppress файлов, в которые добавляются подавленные сообщения анализатора после выполнения команды 'Suppress All Messages'. При последующем запуске анализа все сообщения, добавленные в *.suppress файлы, не попадут в отчёт анализатора. Система подавления через *.suppress файлы достаточно гибкая и способна "отслеживать" подавленные сообщения даже при модификации и сдвигах участков кода, в которых выдаётся подавленное сообщение.
При работе с Rider файлы *.suppress создаются на уровне проекта, рядом с каждым проектным файлом, но их также можно добавить в любой проект или solution (например, чтобы использовать один общий *.suppress файл для нескольких проектов или всего solution'а). Чтобы вернуть подавленные сообщения анализатора, необходимо удалить *.suppress файлы для соответствующих проектов и перезапустить анализ.
В CLion подавленные сообщения добавляются в файл suppress_file.suppress.json, который записывается в директорию .PVS-Studio, которая находится в корневой директории CLion проекта. Чтобы вернуть все сообщения анализатора, необходимо удалить этот файл и перезапустить анализ.
С версии PVS-Studio 7.27 внутреннее содержимое файлов подавления сортируется. Это требуется для корректного использования в системе контроля версий и избежания проблем слияния файлов.
Сообщения сортируются в таком порядке: имя исходного файла, код диагностики, хэш строки, описание диагностики.
SonarQube (бывший Sonar) — платформа с открытым исходным кодом для непрерывного анализа (англ. continuous inspection) и измерения качества кода.Пользователям этой системы доступен плагин для PVS-Studio. SonarQube сводит результаты анализа к единой информационной панели, ведя историю прогонов и позволяя тем самым увидеть общую тенденцию изменения качества программного обеспечения в ходе разработки. Дополнительным преимуществом является возможность объединять результаты разных анализаторов.
Так, получив результаты анализа одного или нескольких анализаторов, необходимо перейти к списку предупреждений и кликнуть на кнопку "Bulk Change", после чего откроется следующее меню.
В этом окне можно разметить все предупреждения анализатора как "won't fix" и в дальнейшем работать только с новыми ошибками.
PVS-Studio можно быстро интегрировать в новый проект, настроить его автоматическую ежедневную проверку в CI и одновременно постепенно разбираться с подавленными предупреждениями в IDE.
Выглядеть это будет примерно так:
Настроить статический анализ на сборочном сервере и компьютерах разработчиков. В дальнейшем исправлять новые предупреждения анализатора и не давать им накапливаться. Также стоит запланировать поиск и исправление ошибок среди подавленных предупреждений.
Дополнительный контроль за качеством кода поможет обеспечить рассылка результатов по почте. Рассылать предупреждения только для тех разработчиков, которые внесли ошибочный код, возможно с помощью утилиты BlameNotifier, которая входит в Windows дистрибутив PVS-Studio.
Некоторым может быть удобно загружать результаты в Jenkins или TeamCity с помощью плагина PVS-Studio, и рассылать ссылку на эту страницу.
На странице приведены все возможные способы подавления предупреждений анализатора на данный момент. Описание этого механизма основывается на документации к анализатору PVS-Studio, но детали по этой теме были рассмотрены подробнее. Общие сведения могут быть не очень информативны для новых пользователей, поэтому следует ознакомиться с документацией по ссылкам ниже.
При работе с большим количеством сообщений (а при первичной проверке крупных проектов, когда ещё не настроены фильтры и не размечены ложные срабатывания, число сообщений может достигать десятков тысяч), разумно воспользоваться средствами навигации поиска, и фильтрации встроенными в окно вывода результатов PVS-Studio.
Если Вы только начали изучать инструмент статического анализа и хотели бы узнать на что он способен, то можете воспользоваться механизмом Best Warnings. Данный механизм покажет вам наиболее важные и достоверные предупреждения.
Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора, нажмите на кнопку 'Best', как показано на скриншоте ниже:
После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора.
Окно вывода результатов PVS-Studio в первую очередь предназначено для упрощения навигации по коду анализируемого проекта и переходу к участкам кода, содержащим потенциальные ошибки. Двойной щелчок мыши по любому из сообщений в списке автоматически откроет в редакторе кода файл, на который данное сообщение указывает, переведёт курсор на интересующую строку и выделит её. Кнопки быстрой навигации (рисунок 1) позволяют легко просматривать обнаруженные потенциально опасные места в исходном коде без необходимости постоянно переключаться между окнами среды разработки.

Рисунок 1 — Кнопки быстрого перехода
Для представления результатов анализа окно PVS-Studio использует виртуальную таблицу, позволяющую быстро отображать и осуществлять сортировку сгенерированных сообщений даже для очень крупных проектов (виртуальная таблица позволяет работать со списками из сотен тысяч строк без заметного ущерба для производительности). Крайний левый столбец таблицы предназначен для пометки интересных сообщений, например, тех, к которым имеет смысл вернуться повторно. Данный столбец также поддерживает сортировку, поэтому найти все сообщения, размеченные подобным образом, не составит труда. Пункт контекстного меню "Show Columns" позволяет настроить отображаемые в таблице столбцы (рисунок 2):
Рисунок 2 — Настройка отображения таблицы вывода результатов
Таблица поддерживает множественное выделение с помощью стандартных комбинаций Ctrl и Shift, при этом выделение строк сохраняется и после пересортировки по любой другой колонке. Пункт меню "Copy selected messages to clipboard" (либо сочетание Ctrl+C) позволяет скопировать в буфер обмена содержимое всех выделенных в таблице строк.
Механизмы фильтрации окна вывода PVS-Studio позволяют быстро найти и отобразить как отдельные диагностические сообщения, так целые их группы. Панель инструментов окна содержит ряд переключателей, позволяющих включить либо отключить отображение сообщений из соответствующих им групп сообщений (рисунок 3).
Рисунок 3 — Группы фильтрации сообщений
Все переключатели можно разбить на 3 группы: фильтры по уровню диагностической достоверности сообщений, фильтры по принадлежности сообщения к определённому типу диагностических правил, фильтр размеченных в коде ложных срабатываний. Отключение этих фильтров мгновенно отключает отображение соответствующих им сообщений в списке.
Детальное описание уровней достоверности предупреждений и наборов диагностических правил приведено в разделе документации "Знакомство со статическим анализатором кода PVS-Studio".
Механизм быстрой фильтрации (quick filters) позволяет отфильтровать отчёт анализатора по заданным ключевым словам. Открыть панель быстрой фильтрации можно с помощью кнопки Quick Filters панели инструментов окна (рисунок 4).
Рисунок 4 — Панель быстрой фильтрации
Быстрая фильтрация позволяет отобразить сообщения в соответствии с фильтрами по 3-м ключевым словам: по коду сообщения, по тексту сообщения и по файлу, содержащему данное сообщение. Например, отобразить все сообщения, содержащие слово 'odd' из файла 'command.cpp'. Изменения в списке сообщений становятся видны сразу после выхода из поля ввода ключевого слова (при потере фокуса). Кнопка Reset Filters очищает заданные в данный момент ключевые слова.
Все перечисленные механизмы фильтрации сообщений можно совмещать между собой, фильтруя, например, уровень отображаемых сообщений и файл, к которому сообщения должны относиться, исключая сообщения, помеченные как ложные срабатывания.
При необходимости перехода на какое-либо конкретное сообщение в таблице можно воспользоваться диалогом быстрого перехода к строке, который вызывается через пункт контекстного меню "Navigate to ID..."(рисунок 5):
Рисунок 5 - Вызов диалога быстрого перехода
Рисунок 6 - Диалог быстрого перехода к сообщению
Каждое сообщение в списке вывода PVS-Studio имеет уникальный идентификатор — порядковый номер добавления этого сообщения в таблицу, который отображён в колонке ID. Диалог быстрого перехода позволяет выделить и автоматически сфокусировать сообщение с заданным идентификатором ID, независимо от текущей сортировки таблицы и выделенных строк. Обратите внимание, что ID идентификаторы отображённых в таблице сообщений не всегда идут последовательно, т.к. часть сообщений может быть скрыта с помощью механизмов фильтрации. Переход к таким сообщениям невозможен.
Зачастую в разработке крупных проектов принимают участие распределённые группы разработчиков, а поэтому очень часто один человек не имеет возможности оценить каждое из сообщений статического анализатора на предмет ложно-позитивного срабатывания и, тем более, внести исправления в соответствующий участок исходного кода. В такой ситуации имеет смысл делегировать рассмотрение подобного сообщения разработчику, непосредственно отвечающему за данный участок.
PVS-Studio позволяет автоматически сгенерировать и внести в код комментарий TODO специального вида, содержащий всю необходимую информацию для оценки и анализа отмеченного им фрагмента программы. Такой комментарий будет сразу отображён в окне задач Visual Studio (окно Task List, для версии Visual Studio 2010 необходимо включить разбор комментариев в настройках Tools->Options->Text Editor->C++->Formatting->Enumerate Comment Tasks->true) при условии, что в настройках Tools->Options->Environment->Task List->Tokens задана соответствующая TODO лексема (присутствует в настройках по умолчанию). Комментарий может быть добавлен с помощью команды контекстного меню 'Add TODO comments for selected messages' (рисунок 7)
Рисунок 7 - Вставка TODO комментария
TODO комментарий будет вставлен в строку, сгенерировавшую сообщение анализатора, и будет содержать код ошибки, текст сообщения анализатора и ссылку на online документацию для данного типа ошибок. Благодаря окну заданий (Task List) данный комментарий может быть легко найден любым имеющим доступ к исходному коду разработчиком, а сам текст комментария позволит выявить и исправить потенциальную ошибку даже в случае отсутствия у программиста установленной версии PVS-Studio или полного отчёта о работе анализатора (рисунок 8).
Рисунок 8 - Окно заданий Visual Studio
В Visual Studio открыть окно Task List можно через меню View->Other Windows->Task List. Комментарии TODO отображаются в разделе Comments окна.
В данном разделе описаны механизмы подавления ложноположительных предупреждений, выдаваемых анализатором. С помощью описанных здесь механизмов можно управлять как отдельными сообщениями, выдаваемыми на определённые строки кода, так и подавлять множественные срабатывания, возникающие, например, из-за использования C/C++ макросов. Описан способ, как с помощью комментариев указать анализатору выключить то или иное сообщение анализатора или изменить выдаваемый текст сообщения.
Механизмы, описанные в данном разделе, применимы как для C/C++, так и для C# анализаторов PVS-Studio, если явно не указано обратное.
Любой анализатор кода всегда выдает помимо полезных сообщений об ошибках еще множество так называемых "ложных срабатываний". Это ситуации, когда программисту совершенно очевидно, что в коде нет ошибки, а анализатору это не очевидно. Такие ложные срабатывания называют False Alarm. Рассмотрим пример кода:
obj.specialFunc(obj);Анализатор считает подозрительным, что у объекта вызывается метод, в качестве аргумента в который передаётся тот же самый объект, поэтому он выдаст на данный код предупреждение V678. Программист же может знать, что использование метода 'specialFunc' таким образом вполне допустимо, поэтому предупреждение анализатора в данном случае является ложным срабатыванием. О том, что предупреждение V678, выданное на этот код, является ложным, можно сообщить анализатору.
Это можно сделать либо вручную, либо с помощью команды контекстного меню. По умолчанию, ложные срабатывания не отображаются в итоговом отчете или плагине. Для включения отображения размеченных подобным образом сообщений можно воспользоваться настройкой 'PVS-Studio -> Options... -> Specific Analyzer Settings -> DisplayFalseAlarms'.
Не рекомендуется использовать разметку сообщений как ложных предупреждений без предварительного просмотра соответствующего кода, так как это противоречит идеологии статического анализа. Только программист может определить, является ли сообщение об ошибке ложным.
Обычно в компиляторах для подавления отдельных сообщений об ошибках используют '#pragma'-директивы. Приведём пример кода:
unsigned arraySize = n * sizeof(float);Компилятор выдает сообщение:
warning C4267: 'initializing' : conversion from 'size_t' to 'unsigned int', possible loss of data x64Sample.cpp 151
Это сообщение можно подавить с помощью следующей конструкции:
#pragma warning (disable:4267)Точнее, чтобы подавить конкретно это сообщение, лучше оформить код так:
#pragma warning(push)
#pragma warning (disable:4267)
unsigned arraySize = n * sizeof(float);
#pragma warning(pop)Анализатор PVS-Studio в качестве разметки использует комментарии специального вида. Для той же строчки кода подавление сообщения PVS-Studio будет выглядеть так:
unsigned arraySize = n * sizeof(INT_PTR); //-V103Теперь анализатор пометит предупреждение V103 на эту строку как ложное. Такой подход был выбран для повышения наглядности конечного кода. Дело в том, что PVS-Studio может сообщать о проблемах в середине многострочных выражений, как, например, здесь:
size_t n = 100;
for (unsigned i = 0;
i < n; // <= анализатор сообщит о проблеме здесь
i++)
{
// ...
}Чтобы подавить это сообщение при использовании комментария, достаточно написать:
size_t n = 100;
for (unsigned i = 0;
i < n; //-V104
i++)
{
// ...
}Если же в это выражение пришлось бы добавлять '#pragma'-директиву, то код выглядел бы значительно менее наглядно.
Хранение разметки в исходном коде позволяет вносить в него модификации без опасения потерять информацию о строках с ошибками.
Иногда необходимо подавить более одного срабатывания на одной строке. В этом случае следует указать отдельный комментарий для каждого из них. Вот пара примеров:
1) подавление срабатываний разных диагностик:
struct Small { int *pointer; };
struct Big { int *array[20]; };
int Add(const Small &a, Big b) //-V835 //-V813
{
return *a.pointer + *b.array[10];
}2) подавление срабатываний одной диагностики:
struct Small { int *pointer; };
int Add(const Small &a, const Small &b) //-V835 //-V835
{
return *a.pointer + *b.pointer;
}Можно также использовать отдельную базу, в которой хранить информацию примерно так: код ошибки, имя файла, номер строки. Данный подход отдельно реализован в PVS-Studio и называется "Mass Suppression".
Для работы с ложными срабатываниями пользователю предоставляется две команды, доступные из контекстного меню PVS-Studio (рисунок 1).
Рисунок 1 - Команды для работы с механизмом подавления ложных предупреждений
Рассмотрим команды, относящиеся к подавлению ложных предупреждений:
1. Mark selected messages as False Alarms. Вы можете выбрать одно или несколько предупреждений в списке (рисунок 2) и воспользоваться этой командой для разметки соответствующего кода, как безопасного.
Рисунок 2 - Выбор предупреждений перед выполнением команды "Mark selected messages as False Alarms"
2. Remove False Alarm marks from selected messages. Убирает комментарий, помечающий код как безопасный. Функция, например, может быть полезна, если вы поспешили и ошибочно отметили код как безопасный. Как и в предыдущем случае, вы должны выбрать сообщения из списка, которые планируете обработать.
В макросах (#define) анализатор также, разумеется, может находить потенциальные проблемы и выдавать на них диагностические сообщения. Но при этом анализатор будет выдавать сообщения в тех местах, где макрос используется, то есть где фактически происходит подстановка тела макроса в код. Пример:
#define TEST_MACRO \
int a = 0; \
size_t b = 0; \
b = a;
void func1()
{
TEST_MACRO // V1001 here
}
void func2()
{
TEST_MACRO // V1001 here
}Чтобы подавить это сообщение, можно использовать команду "Mark as False Alarm". Тогда код с расставленными командами подавления будет выглядеть так:
#define TEST_MACRO \
int a = 0; \
size_t b = 0; \
b = a;
void func1()
{
TEST_MACRO //-V1001
}
void func2()
{
TEST_MACRO //-V1001
}Однако если макрос используется очень активно, то везде размечать его как False Alarm не очень удобно. Есть возможность в коде сделать вручную специальную пометку, чтобы анализатор автоматически размечал диагностики в этом макросе как False Alarm. С этой пометкой код будет выглядеть так:
//-V:TEST_MACRO:1001
#define TEST_MACRO \
int a = 0; \
size_t b = 0; \
b = a;
void func1()
{
TEST_MACRO
}
void func2()
{
TEST_MACRO
}При проверке такого кода сообщения о проблемах в макросе уже сразу будут помечены как False Alarm. Причём можно указывать несколько диагностик сразу, через запятую:
//-V:TEST_MACRO:1001, 105, 201Обратите внимание, что если макрос содержит вложенные макросы, то для автоматической пометки нужно указывать всё равно имя макроса самого верхнего уровня:
#define NO_ERROR 0
#define VB_NODATA ((long)(77))
size_t stat;
#define CHECK_ERROR_STAT \
if( stat != NO_ERROR && stat != VB_NODATA ) \
return stat;
size_t testFunc()
{
{
CHECK_ERROR_STAT // #1
}
{
CHECK_ERROR_STAT // #2
}
return VB_NODATA; // #3
}В указанном примере диагностика V126 появляется в трех местах. Чтобы автоматически помечать ее как False Alarm в местах #1 и #2 нужно добавить такой код:
//-V:CHECK_ERROR_STAT:126А чтобы и в #3 это сработало, необходимо указать еще:
//-V:VB_NODATA:126К сожалению, просто указать "сразу помечать V126 в макросе VB_NODATA" и не указывать про макрос CHECK_ERROR_STAT нельзя из-за технических особенностей механизма препроцессирования.
Всё написанное в этом разделе про макросы справедливо также и для любого фрагмента кода. То есть если, например, вы хотите подавить все срабатывания диагностики V103 на вызов функции 'MyFunction', необходимо добавить такую строку:
//-V:MyFunction:103Этот пункт относится только к анализатору языков C и C++.
Иногда нужно отключить некоторое правило не глобально, а для определенной части кода. Например, нужно отключить диагностику для определенного файла или части файла, при этом остальные диагностики должны продолжать работать. Подавленное предупреждение должно продолжать выдаваться при анализе остального кода.
Анализатор предоставляет механизм подавления с использованием специальных директив 'pragma'. Этот способ аналогичен тому, который используется в компиляторе для управления предупреждениями.
Анализатор использует следующие директивы:
Так же, как и в случае с '#pragma warning', поддерживается вложенность.
Пример:
void func(int* p1, int* p2, int* p3)
{
if (!p1 || !p2 || !p3)
return;
#pragma pvs(push)
#pragma pvs(disable: 547)
if (p1) // V547 off
do_something();
#pragma pvs(push)
#pragma pvs(enable: 547)
if (p2) // V547 Expression 'p2' is always true.
do_something_else();
#pragma pvs(pop)
if (p3) // V547 off
do_other();
#pragma pvs(pop)
}Примечание: хотя компиляторы игнорируют неизвестные директивы 'pragma', в зависимости от настроек, они могут выдавать предупреждения о таких директивах. В этом случае предупреждение можно отключить, передав специальный параметр в командную строку компилятора:
Отображением и фильтрацией сообщений можно управлять с помощью комментариев специального вида. Такие комментарии можно писать в специальных файлах конфигурации (.pvsconfig) для всех анализаторов, либо непосредственно в коде проекта (только для C/C++ анализатора).
Файлы конфигурации диагностик анализатора представляют собой простые текстовые файлы, добавляемые в Visual Studio проект либо solution. Для добавления файла конфигурации, выделите интересующий вас проект или solution в окне Solution Explorer среды Visual Studio и выберите пункт контекстного меню 'Add New Item...'. В появившемся окне выберите тип файла 'PVS-Studio Filters File' (рисунок 3):
Рисунок 3 - Добавление в solution файла конфигурации диагностик анализатора.
Из-за особенностей некоторых версий среды Visual Studio, тип файлов 'PVS-Studio Filters File' может отсутствовать на некоторых версиях и редакциях Visual Studio в окне добавления нового файла для solution и\или проекта. В таком случае, можно добавить в проект обычный текстовый файл, задав ему расширение 'pvsconfig'. В свойствах этого файла (после добавления), должно быть указано, что файл не участвует в сборке.
Файл конфигурации, добавленный в проект, действует на все файлы данного проекта. Файл конфигурации, добавленный в solution, действует на все файлы всех проектов, добавленных в данный solution.
Также можно разместить файл конфигурации .pvsconfig в текущей папке пользовательских данных (%AppData%\PVS-Studio\) - такой файл будет подхвачен автоматически при запуске проверки, без необходимости как-либо модифицировать проектные файлы.
Примечание. '.pvsconfig' файлов в '%AppData%\PVS-Studio\' может быть несколько, и все они будут автоматически подхвачены анализатором. Стоит также учитывать, что конфигурация из '%AppData%\PVS-Studio\' будет глобальна для анализатора и будет безусловно использоваться при каждом запуске.
При использовании инструмента командной строки PVS-Studio_Cmd указать путь к файлу конфигурации .pvsconfig можно через параметр --rulesConfig (-C), например:
PVS-Studio_Cmd.exe -t D:\project\project.sln
-C D:\project\rules.pvsconfigФайлы конфигурации диагностик .pvsconfig имеют простой синтаксис. Любая строка, начинающаяся с символа '#' считается комментарием и игнорируется. Фильтры записываются в формате однострочных C++/C# комментариев, т.е. должны начинаться с символов '//'.
Для C/C++ кода, фильтры также могут быть записаны в виде комментариев непосредственно в исходном коде. Обратите внимание, что такой формат записи не поддерживается в C# проектах!
Далее рассмотрим различные варианты фильтров, допустимых в файлах конфигурации диагностик.
Предположим, есть следующая структура:
struct MYRGBA
{
unsigned data;
};И ряд функций, которые её используют:
void f1(const struct MYRGBA aaa)
{
}
long int f2(int b, const struct MYRGBA aaa)
{
return int();
}
long int f3(float b, const struct MYRGBA aaa, char c)
{
return int();
}На все эти функции анализатор выдаст три сообщения V801: Decreased performance. It is better to redefine the N function argument as a reference. Сообщение в подобном коде будет ложным, так как компилятор сам оптимизирует код, и проблемы не будет.
Можно, конечно, каждое сообщение пометить как False Alarm с помощью функции Mark As False Alarm. Однако, есть способ лучше. Достаточно добавить в код строку:
//-V:MYRGBA:801Для C/C++ проектов, мы рекомендуем добавлять такую строку в .h-файл рядом с объявлением структуры, но если это невозможно (например, структура в системном .h-файле), то можно прописать это в stdafx.h.
И тогда, после перепроверки, все три сообщения V801 будут автоматически помечены как False Alarm.
Обратите внимание: при использовании комментариев вида //-V:MY_STRING:Vxxx PVS-Studio будет подавлять все сообщения Vxxx, выданные на строки, в которых содержится подстрока MY_STRING.
Описанный механизм может применяться для подавления предупреждений не только для отдельных слов. Иногда, это очень удобно.
Рассмотрим несколько примеров:
//-V:<<:128Подавит предупреждения V128 в строках, где имеется оператор <<.
buf << my_vector.size();Если вы хотите подавлять предупреждение V128 только при записи данных в объект с именем 'log', то можно написать так:
//-V:log<<:128
buf << my_vector.size(); // Есть предупреждение
log << my_vector.size(); // Нет предупрежденияПримечание. Обратите внимание, что строка для поиска не должна содержать пробелов.
Правильно: //-V:log<<:128
Неправильно: //-V:log <<:128При поиске подстроки пробелы игнорируются. Но не беспокойтесь, следующая ситуация обработается корректно:
//-V:ABC:501
AB C = x == x; // Есть предупреждение
AB y = ABC == ABC; // Нет предупрежденияСуществует возможность с помощью комментария полностью выключить предупреждение. В этом случае после двух двоеточий указывается номер отключаемой диагностики. Синтаксис:
//-V::(number)Если требуется проигнорировать предупреждение V122, то можно указать в начале файла:
//-V::122Для отключения нескольких диагностик можно перечислить их номера через запятую. Синтаксис:
//-V::(number1),(number2),...,(numberN)Если требуется, например, игнорировать предупреждения V502, V507 и V525, то в начале файла можно указать:
//-V::502,507,525При необходимости можно отключать предупреждения определённых диагностик на указанных уровнях. Синтаксис:
//-V::(number1),(number2),...,(numberN):1,2,3Например, если требуется игнорировать предупреждения V3161 и V3165 на уровнях 'Medium' и 'Low', можно указать:
//-V::3161,3165:2,3Анализатор также поддерживает возможность фильтрации предупреждений по номеру диагностики и подстроке. Синтаксис:
//-V::(number1),(number2),...,(numberN)::{substring}Например, можно исключить из отчёта все предупреждения V3022 и V3063, содержащие подстроку "always true":
//-V::3022,3063::{always true}Этот функционал можно комбинировать с фильтрацией по уровню:
//-V::(number1),(number2),...,(numberN):1,2,3:{substring}Например, можно исключить все срабатывания V5625, имеющие 2 уровень и содержащие подстроку "Google.Protobuf 3.6.1":
//-V::5625:2:{Google.Protobuf 3.6.1}Существует также возможность отключить группу диагностик. Синтаксис:
//-V::GA
//-V::X64
//-V::OP
//-V::CS
//-V::MISRAДля отключения сразу нескольких групп диагностик их можно перечислить через запятую. Синтаксис:
//-V::X64,CS,...Для отключения всех диагностик C++ или C# анализатора следует использовать следующую форму:
//-V::C++
//-V::C#Поскольку анализатор не будет выдавать указанные предупреждения, то это может значительно уменьшить размер лога проверки, если какая-то диагностика даёт слишком много ложных срабатываний.
В случае необходимости можно задать исключение из анализа файлов / директорий, которые попадают под заданные маски. Это может быть удобно, например, для исключения из анализа кода сторонних библиотек или автоматически сгенерированных файлов.
Несколько примеров масок:
//V_EXCLUDE_PATH C:\TheBestProject\thirdParty
//V_EXCLUDE_PATH *\UE4\Engine\*
//V_EXCLUDE_PATH *.autogen.csСинтаксис масок идентичен синтаксису для опций 'FileNameMasks' и 'PathMasks', описанному в документе "Настройки: Don't Check Files".
Перед запуском анализа 'PVS-Studio_Cmd' формирует конфигурацию диагностических правил из:
Если у вас большое количество проектов, для которых конфигурация формируется разными способами, то в некоторых случаях конфигурация из глобальных файлов может приводить к путанице в результирующей конфигурации. Это связано с тем, что конфигурация из глобальных файлов применяется всегда над каким бы проектом вы ни работали. Другими словами, настройки, которые характерны только для проекта X, будут также применены к другим проектам.
Поэтому, если вам необходимо проигнорировать конфигурацию из глобальных файлов, нужно добавить специальный флаг в соответствующий '.pvsconfig' файл:
//IGNORE_GLOBAL_PVSCONFIGПравила действия флага следующие:
Использование этого флага позволит гибко выключать глобальные настройки для определенных случаев.
Возможны ситуации, в которых определённый тип диагностик не актуален для анализируемого проекта, или какая-либо из диагностик анализатора выдаёт предупреждения на код, в корректности которого вы уверены. В таком случае можно воспользоваться системой группового подавления сообщений, основанной на фильтрации полученных результатов анализа. Список доступных режимов фильтрации можно открыть через общее меню PVS-Studio -> Options.
Следует отметить, что применение фильтров для группового подавления ложных срабатываний не требует перезапуска анализа, результаты фильтрации будут сразу отображены в окне вывода PVS-Studio.
Во-первых, можно отключить диагностику тех или иных ошибок по их коду. Это делается с помощью вкладки "Настройки: Detectable Errors". На вкладке обнаруживаемых ошибок можно указать номера ошибок, которые не надо показывать в отчете по анализу. Иногда бывает целесообразно убрать в отчете ошибки с определенными кодами. Например, если вы уверены, что ошибки, связанные с явным приведением типа (коды V201, V202, V203), вас не интересуют, то вы можете скрыть их показ. Также отображение ошибок определённого типа можно отключить с использованием команды контекстного меню "Hide all Vxxx errors". Соответственно, в случае, если необходимо включить отображение обратно, настроить это можно на упоминавшейся выше вкладке "Detectable Errors".
Во-вторых, можно отключить анализ некоторых частей проекта (некоторых папок или файлов проекта). Раздел "Настройки: Don't Check Files". На этой вкладке можно ввести информацию о библиотеках, включения (через директиву #include) из файлов которых анализировать не надо. Это может потребоваться для уменьшения количества лишних диагностических сообщений. Например, в проекте используется библиотека Boost. И хотя на какой-то код из этой библиотеки анализатор выдает диагностические сообщения, вы считаете, что эта библиотека является достаточно надежной и написана хорошо. Поэтому, возможно, не имеет смысла получать диагностические сообщения по поводу кода в этой библиотеке. В этом случае можно отключить анализ файлов из этой библиотеки, указав путь к ней на странице настроек. Кроме того, возможно ввести файловые маски для исключения некоторых файлов из анализа. Анализатор не будет проверять файлы, удовлетворяющие условиям маски. Например, подобным образом можно исключить из анализа автогенерируемые файлы.
Маски путей для файлов, сообщения из которых попали в текущий сгенерированный отчёт, можно автоматически добавить в список Don't Check Files с помощью команды контекстного меню "Don't check files and hide all messages from..." для выделенного в окне PVS-Studio Output сообщения (рисунок 4).
Рисунок 4 - Добавление масок путей через контекстное меню
Данная команда позволит добавить в фильтры исключений как отдельный выбранный файл, так и маску по целой директории, в которой данный файл находится.
В-третьих, можно подавлять отдельные сообщения по тексту. На вкладке "Настройки: Keyword Message Filtering" можно настроить фильтрацию ошибок по содержащемуся в них тексту, а не по коду. При необходимости можно скрыть из отчета сообщения о диагностированных ошибках, содержащих определенные слова или фразы. Например, если в отчете есть ошибки, в которых указаны названия функций printf и scanf, а вы считаете, что ошибок, связанных с ними, быть не может, то просто добавьте эти два слова с помощью редактора подавляемых сообщений.
Иногда, особенно на стадии внедрения статического анализа в крупных проектах, может возникнуть необходимость 'подавить' все предупреждения анализатора на имеющуюся кодовую базу, т.к. разработчики могут не иметь необходимых ресурсов для исправления найденных анализатором ошибок в старом коде. В таком случае может быть полезно 'скрыть' все предупреждения, выданные на имеющийся код, чтобы отслеживать только вновь появляющиеся ошибки. Этого можно достичь за счёт использования механизма "массового подавления сообщений анализатора". Использование соответствующего механизма в среде Windows описано в документе "Массовое подавление сообщений анализатора", в среде Linux – в соответствующем разделе документа "Как запустить PVS-Studio в Linux".
В редких случаях автоматически расставленные разметки могут быть поставлены не в том месте, где должны быть. И тогда анализатор вновь выдаст эти же сообщения об ошибках, так как маркер не будет найден. Это проблема препроцессора, связанная с многострочными #pragma-директивами определенного типа, из-за которых также сбивается нумерация строк. Решением проблемы является пометка сообщений, на которых заметен сбой, вручную. PVS-Studio всегда сообщает о подобных ошибках сообщением "V002. Some diagnostic messages may contain incorrect line number".
Как и с любой другой процедурой, включающей в себя массовую обработку файлов, при использовании разметки сообщений как ложных стоит помнить о потенциально возможных конфликтах доступа. Так как во время разметки файлов один из файлов может быть открыт во внешнем редакторе и там модифицирован, результат совместной работы с файлом предсказать невозможно. Поэтому мы рекомендуем либо иметь копию исходного кода, либо пользоваться системами контроля версий.
Результатом анализа проекта с помощью PVS-Studio может быть:
Полученные файлы можно просматривать в плагине PVS-Studio для IDE или в приложении C and C++ Compiler Monitoring UI.
Эти форматы отчёта неудобны для прямого просмотра в текстовом редакторе или рассылки по электронной почте. Поэтому в состав дистрибутива PVS-Studio входит специальная утилита, позволяющая преобразовывать результаты анализа в другие форматы.
Название утилиты преобразования отчётов зависит от платформы:
PlogConverter.exe;plog-converter.Приведём далее список форматов, поддерживаемых утилитой конвертации отчётов.
|
Формат |
Расширение |
Инструменты |
Описание |
|---|---|---|---|
|
PVS-Studio Log (Plog) |
|
Visual Studio SonarQube Compiler Monitoring UI |
Для Windows пользователей Visual Studio и SonarQube |
|
JSON |
|
Visual Studio IntelliJ IDEA Rider CLion |
Для пользователей плагинов PVS-Studio в IDE и SonarQube |
|
SARIF |
|
Visual Studio Visual Studio Code Визуализатор GitHub Actions |
Универсальный формат отчёта статического анализатора |
|
TaskList |
|
Qt Creator |
Для работы с отчётом в Qt Creator |
|
TaskList Verbose |
|
Qt Creator |
Расширение формата TaskList с поддержкой отображения дополнительных позиций |
|
CSV |
|
Microsoft Excel LibreOffice Calc |
Для просмотра предупреждений в табличном виде |
|
Simple HTML |
|
Почтовый клиент Браузер |
Для рассылки отчётов почтой |
|
Full HTML |
Папка |
Браузер |
Для просмотра предупреждений с навигацией по коду в браузере |
|
Error File |
|
IDE Vim Emacs |
Для просмотра отчётов в любом редакторе, поддерживающем формат вывода компилятора |
|
Error File Verbose |
|
IDE Vim Emacs |
Расширение формата Error File с поддержкой отображения дополнительных позиций |
|
TeamCity |
|
TeamCity |
Для загрузки и просмотра предупреждений в TeamCity |
|
MISRA Compliance |
|
Почтовый клиент Браузер |
Для проверки кода на соответствие стандартам MISRA |
|
GitLab |
|
GitLab |
Для просмотра предупреждений в формате GitLab Code Quality |
|
DefectDojo |
|
DefectDojo |
Для загрузки и просмотра предупреждений в DefectDojo |
|
Markdown |
|
Visual Studio Code GitHub |
Для просмотра предупреждений в формате таблицы Markdown |
Для преобразования отчёта PVS-Studio в один из перечисленных форматов можно воспользоваться утилитой PlogConverter, поставляемой в дистрибутиве PVS-Studio для Windows. Утилиту PlogConverter можно найти в установочной директории PVS-Studio (по умолчанию это путь C:\Program Files (x86)\PVS-Studio). Кроме этого, исходный код утилиты доступен на GitHub.
Флаг --help выведет основную информацию об утилите:
PlogConverter.exe –-helpДля запуска утилиты в командной строке терминала выполнить:
PlogConverter.exe [options] <path to PVS-Studio log>Параметры утилиты:
--renderTypes (или -t): указывает форматы, в которые будет преобразован отчёт. Возможна комбинация разных форматов: для этого их нужно перечислить через запятую. Если конкретный формат не указан, то отчёт конвертируется во все форматы.JSON: рекомендуемый для использования формат отчёта. Поддерживается всеми плагинами PVS-Studio для IDE и утилитами. Этот формат рекомендуется, если нужно объединить несколько отчётов в один или сконвертировать Plog-отчёт в JSON-формат.Plog: формат отчёта для просмотра на Windows. Вместо него рекомендуется использовать более универсальный формат JSON. Формат Plog можно выбрать, если нужно объединить несколько отчётов в один или сконвертировать SON-отчёт в Plog-формат.Html: формат отчёта в виде HTML-файла. Такой отчёт удобно использовать для автоматических рассылок на e-mail.FullHtml: формат отчёта в виде HTML-файла. При выборе этого формата PlogConverter конвертирует сообщения анализатора и исходные файлы в HTML-файлы. Это позволяет просматривать отчёт анализатора в браузере с сортировкой по сообщениям и навигацией по коду. Результатом конвертации будет директория с именем fullhtml, которая будет находиться по пути, указанному через флаг -o. При этом если указан параметр -n, то директория будет иметь заданное название и постфикс .fullhtml;Txt: формат отчёта с 'plain text' представлением сообщений анализатора.Csv: формат отчёта с разделителями. Такой отчёт удобно читать в Microsoft Excel.Totals: формат отчёта, содержащий суммарную информацию о количестве предупреждений разных типов (GA, OP, 64, CS, MISRA, ...) и разных уровней достоверности. Детальное описание уровней достоверности предупреждений и наборов диагностических правил приведено в разделе документации "Знакомство со статическим анализатором кода PVS-Studio".Tasklist: формат отчёта для просмотра в Qt Creator.TeamCity: формат отчёта, предназначенный для загрузки и просмотра в TeamCity CI.Sarif: открытый формат для обмена данными между инструментами статического анализа. Более подробно о SARIF можно прочитать здесь.MisraCompliance: формат отчёта о проверке кода на соответствие стандарту MISRA.GitLab: формат отчёта совместимый с GitLab Code Quality.DefectDojo: формат отчёта, предназначенный для загрузки и просмотра в DefectDojo.Markdown: формат отчета в виде таблицы Markdown.--analyzer (или -a): производит фильтрацию предупреждений по маске. Маска фильтрации имеет вид: MessageType:MessageLevels. MessageType может принимать один из следующих типов: GA, OP, 64, CS, MISRA, FAIL, OWASP, AUTOSAR. MessageLevels может принимать значения от 1 до 3.--excludedCodes (или -d): задает список предупреждений (через ,), которые нужно исключить из результирующего отчёта. Например: -d V595,V730.--includePaths (или -i): позволяет включить в отчет предупреждения, выданные только в определенных файлах. Через этот параметр вы можете передать список путей (абсолютных или относительных) или wildcard-масок. В качестве разделителя используется символ ;. Обратите внимание, что фильтрация путей возможно только для отчетов, не содержащих SourceTreeRoot-маркер.--excludePaths (или -e): позволяет исключить все предупреждения, выданные в определенных файлах. Через этот параметр вы можете передать список путей (абсолютных или относительных) или wildcard-масок. В качестве разделителя используется символ ;. Обратите внимание, что исключение путей возможно только для отчетов, не содержащих SourceTreeRoot-маркер.--settings (или -s): задаёт путь к файлу настроек PVS-Studio. Он содержит различные настройки для анализатора. PlogConverter прочитает из переданного файла параметр DisableDetectableErrors и исключит предупреждения указанных диагностик из отчёта.--srcRoot (или -r): задаёт замену SourceTreeRoot маркера. Если при проверке путь до корневого каталога проекта был заменен на SourceTreeRoot маркер |?|, то этот параметр становится обязательным, иначе файлы проекта не будут найдены. Для преобразования путей из абсолютных в пути с SourceTreeRoot маркером, необходимо добавить флаг -R toRelative.--outputDir (или -o): задаёт директорию, куда будут сохранены сконвертированные отчёты. Если параметр не задан, то файлы записываются в директорию запуска.--outputNameTemplate (или -n): задаёт шаблонное имя файла без расширения. Все сконвертированные отчёты будут иметь одно и то же имя, но разные расширения.--errorCodeMapping (или -m): позволяет включить отображение CWE ID и/или SAST ID для найденных предупреждений: -m cwe,misra,autosar,owasp,sec. Если указано значение cwe, то для предупреждений в отчёте будет указано CWE ID. Если указано misra, autosar, owasp, sec, то будет включено отображение SAST ID.--indicateWarnings (или -w): устанавливает возвращаемый код утилиты PlogConverter, равный 2, если после фильтрации лога остались предупреждения.--pathTransformationMode (или -R): устанавливает режим преобразования путей при конвертации отчёта. Опция требует --srcRoot. Опция работает только для тех форматов, которые поддерживают относительные пути: JSON, Plog. Допустимые значения:toAbsolute – пути преобразуются в абсолютные;toRelative – пути преобразуются в относительные.--misraDeviations: правила MISRA, для которых не будут учитываться нарушения. Правила отделяются друг от друга символом ;. Если все найденные анализатором нарушения MISRA указаны в опции --misraDeviations, то в итоговом отчёте проект будет считаться удовлетворяющим стандарту MISRA.--grp: путь до текстового файла Guideline Re-categorization Plan. Эту опцию следует использовать только при генерации отчёта MISRA Compliance. Это файл, в котором указаны изменения категорий для правил MISRA. Подробнее о том, что такое категория правила MISRA, можно прочитать здесь.--noHelpMessages: исключить из предупреждений анализатора ссылки на документацию диагностических правил.--keepFalseAlarms (или -f): сохранить в отчете предупреждения, отмеченные как ложные.--countWarnings (или -с): позволяет отобразить количества сообщений, соответствующее аргументам данной команды. Формат команды -c {Группы или Коды диагностик}:{Уровни };{Другие аргументы }... Пример команд: -c GA:1,2;OP:1 | -c V003 | -c V502,V504:1 | -c ALL. --generateDiffWith (или -D): генерирует отчёт с различиями между отчётом указанном в данной опции и входным отчётом.--filterSecurityRelatedIssues: оставляет в результирующем отчёте только сообщения, имеющие маркировку по ГОСТ Р 71207-2024.--filterCWE: оставляет в результирующем отчёте только сообщения, у которых есть любой (параметр ALL) или конкретные CWE ID (искомые идентификаторы перечисляются через ,).--filterSAST: оставляет в результирующем отчёте только сообщения, у которых есть любой (параметр ALL) или совпадающие по подстроке SAST ID (шаблоны поиска перечисляются через ,). Для идентификаторов с пробелами рекомендуется использовать кавычки, например, --filterSAST="MISRA C++".--csvSeparator: задаёт разделитель столбцов для CSV файлов.Утилита PlogConverter имеет несколько ненулевых кодов возврата, которые не означают проблемы в работе самой утилиты. Если утилита вернула не '0', это ещё не значит, что она отработала с ошибкой.
Описание кодов возврата PlogConverter:
0 — конвертация отчёта прошла успешно;1 — при генерации одного из выходных файлов возникла ошибка;2 — выходной отчёт содержит неотфильтрованные или неподавленные предупреждения. Чтобы этот режим работал, утилите нужно передать флаг --indicateWarnings (-w);3 — общая (неспецифичная) ошибка при работе утилиты, перехваченное исключение при работе. Обычно это сигнализирует о наличии ошибки в коде самого PlogConverter;4 — утилите были переданы неверные аргументы командной строки или один из файлов, переданный как аргумент, не был найден.5 — ошибка при попытке заменить абсолютные пути на относительные в формате отчёта, который это не поддерживает.PlogConverter.exe -t Json,Csv -a GA:1,2;OWASP:1 -o D:\Logs -r
D:\projects\projectName -m CWE,OWASP -n PVS-Log PVS-Studio.logВ данном примере происходит следующее:
PVS-Studio.log конвертируется в форматы JSON и CSV;|?| в путях до файлов с ошибками будет заменён на D:\projects\projectName;D:\Logs и называться PVS-Log.json и PVS-Log.csv.Для преобразования отчёта PVS-Studio в один из перечисленных форматов можно воспользоваться утилитой plog-converter, поставляемой вместе с пакетами и архивами PVS-Studio С/C++ для Linux и macOS. После установки пакета или из архива PVS-Studio C/C++ вы сможете использовать утилиту plog-converter для конвертации отчётов анализатора в различные форматы (.xml, .tasks и т.п.). Кроме этого, исходный код утилиты доступен на GitHub.
Флаг --help выведет основную информацию об утилите:
plog-converter --helpДля запуска утилиты в командной строке терминала выполнить:
plog-converter [options] <path to PVS-Studio log>Все опции могут быть указаны в произвольном порядке.
Доступные опции:
--renderTypes (или -t): задает возможные варианты конвертации отчёта. Это обязательный аргумент запуска утилиты. Возможна комбинация разных форматов перечислением через повторение --renderTypes (-t) перед каждым форматом или через запятую в качестве аргумента флага:json: рекомендуемый для использования формат отчёта. Поддерживается всеми плагинами PVS-Studio для IDE и утилитами. Этот формат рекомендуется, если нужно объединить несколько отчётов в один или сконвертировать Plog-отчёт в JSON-формат;html: формат отчёта в виде HTML-файла. Такой отчёт удобно использовать для автоматических рассылок на e-mail;fullhtml: формат отчёта в виде HTML-файла. При выборе этого формата plog-converter конвертирует сообщения анализатора и исходные файлы в HTML-файлы. Это позволяет просматривать отчёт анализатора в браузере с сортировкой по сообщениям и навигацией по коду. При передаче этого значения нужно обязательно передать аргумент --output (-o). Результатом конвертации будет директория по пути, указанному через флаг -o. При этом если указан параметр -n, либо указано два или более форматов отчета, то результирующая директория будет иметь постфикс .fullhtml;errorfile: формат вывода GCC и Clang;errorfile-verbose: расширенный формат вывода errorfile с поддержкой отображения дополнительных позиций (при их наличии);csv: формат отчёта с разделителями. Такой отчёт удобно читать в Microsoft Excel;tasklist: формат отчёта для просмотра в Qt Creator;tasklist-verbose: расширенный формат вывода tasklist с поддержкой отображения дополнительных позиций (при их наличии);teamcity: формат отчёта, предназначенный для загрузки и просмотра в TeamCity CI;sarif: открытый формат для обмена данными между инструментами статического анализа. Более подробно можно прочитать здесь;totals: формат отчёта, содержащий суммарную информацию о количестве предупреждений разных типов (GA, OP, 64, CS, MISRA, ...) и разных уровней достоверности. Детальное описание уровней достоверности предупреждений и наборов диагностических правил приведено в разделе документации "Знакомство со статическим анализатором кода PVS-Studio";misra-compliance: формат отчёта о проверке кода на соответствие стандарту MISRA. При передаче этого значения нужно обязательно передать аргумент --output (-o);gitlab: формат отчёта совместимый с GitLab Code Quality;defectdojo: формат отчёта, предназначенный для загрузки и просмотра в DefectDojo.--analyzer (или -a): производит фильтрацию предупреждений согласно маске. Маска фильтрации имеет следующий вид: MessageType:MessageLevels. MessageType может принимать один из следующих типов: GA, OP, 64, CS, MISRA, FAIL, OWASP. MessageLevels может принимать значения от 1 до 3. Возможна комбинация разных масок через ; (без пробелов). По умолчанию в созданном отчёте останутся только предупреждения General Analysis 1 и 2 уровня. Значение по умолчанию: GA:1,2--output (или -o): путь к файлу или директории, куда будет осуществляться вывод. Если флаг не указан, то вывод будет осуществляться в стандартный поток вывода. При этом:--stdout: позволяет дублировать текст отчета в стандартный поток вывода, если указан флаг --output.--settings (или -s): путь к файлу конфигурации. Файл аналогичен файлу конфигурации анализатора PVS-Studio.cfg. Из этого файла используется информация об исключённых директориях (exclude-path).--srcRoot (или -r): задает замену SourceTreeRoot маркера. Если при проверке путь до корневого каталога проекта был заменён на SourceTreeRoot маркер |?|, то этот параметр становится обязательным (иначе файлы проекта не будут найдены).--excludedCodes (или -d): список исключённых диагностик, разделённых запятыми: -d V595,V730.--errorCodeMapping (или -m): включить отображение CWE ID и/или SAST ID для найденных предупреждений: -m cwe -m misra -m autosar -m owasp. Если указано значение cwe, то для предупреждений в отчёте будет указано CWE ID. Если указано misra, autosar или owasp, то для правил соответствующего стандарта будет включено отображение SAST ID.--includePaths (или -I): включить в отчёт только предупреждения, выданные в указанных файлах. Через этот параметр вы можете передать путь (абсолютный или относительный) или шаблон glob. Если путей несколько, то передайте каждый их них через этот параметр. Обратите внимание, что фильтрация путей возможно только для отчетов, не содержащих SourceTreeRoot-маркер.--excludePaths (или -E): позволяет исключить все предупреждения, выданные в определенных файлах. Через этот параметр вы можете передать путь (абсолютный или относительный) или шаблон glob. Если путей несколько, то передайте каждый их них через этот параметр. Обратите внимание, что исключение путей возможно только для отчетов, не содержащих SourceTreeRoot-маркер.--cerr (или -e): использовать stderr вместо stdout.--grp: путь к текстовому файлу Guideline Re-categorization Plan. Используется только при генерации отчёта в формате MISRA Compliance. Это файл, в котором указаны изменения категорий для правил MISRA. Подробнее о том, что такое категория правила MISRA, можно прочитать здесь.--indicateWarnings (или -w): устанавливает возвращаемый код утилиты plog-converter, равный 2, если после фильтрации лога в отфильтрованном выходном файле (файлах) остались предупреждения.--pathTransformationMode (или -R): устанавливает режим преобразования путей при конвертации отчёта. Опция требует --srcRoot. Опция работает только для тех форматов, которые поддерживают относительные пути: json. Допустимые значения:toAbsolute – пути преобразуются в абсолютные;toRelative – пути преобразуются в относительные.--misraDeviations: позволяет указать нарушения MISRA. Нужно перечислить через ; правила MISRA, для которых не будут учитываться нарушения. Если все найденные анализатором нарушения MISRA указаны в опции --misraDeviations, то в итоговом отчёте проект будет считаться удовлетворяющим стандарту MISRA.--noHelpMessages: исключить из предупреждений анализатора ссылки на документацию диагностических правил.--name (или -n): шаблонное имя для результирующих отчетов. Используется для генерации двух и более форматов отчета – во время работы к шаблонному имени будет добавлено соответствующее расширение. По умолчанию при генерации нескольких отчетов используется имя входного отчета без расширения. При этом если входных отчетов несколько, то имя будет MergedReport.--keepFalseAlarms: сохранить в отчете предупреждения, отмеченные как ложные.--filterSecurityRelatedIssues: оставляет в результирующем отчёте только сообщения, имеющие маркировку по ГОСТ Р 71207-2024.--filterCWE: оставляет в результирующем отчёте только сообщения, у которых есть любой (параметр ALL) или конкретные CWE ID (искомые идентификаторы перечисляются через ,).--filterSAST: оставляет в результирующем отчёте только сообщения, у которых есть любой (параметр ALL) или совпадающие по подстроке SAST ID (шаблоны поиска перечисляются через ,). Для идентификаторов с пробелами рекомендуется использовать кавычки, например, --filterSAST="MISRA C++".Описание кодов возврата plog-converter:
0 — конвертация отчёта прошла успешно;1 — общая (неспецифичная) ошибка при работе утилиты, перехваченное исключение при работе. Обычно это сигнализирует о наличии ошибки в коде 'plog-converter'а;2 — выходной отчёт содержит неотфильтрованные или неподавленные предупреждения. Чтобы этот режим работал, утилите нужно передать флаг --indicate-warnings (-w).5 — ошибка при попытке заменить абсолютные пути на относительные в формате отчёта, который это не поддерживает.plog-converter -t json -t csv -a 'GA:1,2;OWASP:1' -o /home/user/Logs
-r /home/user/projects/projectName -m cwe -m owasp -n PVS-Log PVS-Studio.logВ данном примере происходит следующее:
PVS-Studio.log конвертируется в форматы JSON и CSV;|?| будет заменён на /home/user/projects/projectName;/home/user/Logs и называться PVS-Log.json и PVS-Log.csv.В составе дистрибутива PVS-Studio поставляется утилита BlameNotifier. Она позволяет оповещать разработчиков, заложивших в репозиторий код, на который анализатор выдал предупреждения. Также возможна настройка оповещения обо всех обнаруженных предупреждениях определённого круга лиц. Это может быть полезно менеджерам и руководителям команд.
Более подробно данная утилита описана в соответствующем разделе документации: "Оповещение команд разработчиков (утилита blame-notifier)".
По умолчанию, при генерации диагностических сообщений, PVS-Studio выдаёт абсолютные, полные пути до файлов, в которых анализатор нашёл ошибки. Поэтому при сохранении отчёта именно эти полные пути и попадут в результирующий файл (XML plog файл). В дальнейшем это может вызывать неудобства, например, при необходимости работы с таким файлом отчёта на машине, отличной от той, на которой отчёт был сгенерирован. Ведь пути до файлов с исходным кодом на двух машинах могут и различаться. А это приведёт к невозможности открывать файлы и использовать встроенный механизм навигации по коду в таком лог-файле.
Хотя решить данную проблему можно и ручной правкой путей в XML отчёте, гораздо удобнее сразу получать от анализатора сообщения с путями, записанными относительно какой-нибудь фиксированной директории (например, корневой директории дерева исходников проекта). Такой порядок работы позволяет получить файл отчёта с корректными путями и на любой другой машине путём простой замены "корня", относительно которого раскрываются все пути в файле отчёта PVS-Studio. PVS-Studio может автоматически производить такую генерацию относительных путей и подмену их "корня" с помощью настройки 'SourceTreeRoot' на странице "PVS-Studio -> Options -> Specific Analyzer Settings".
Приведём пример использования данного режима работы. По умолчанию поле настроек 'SourceTreeRoot' пусто, а анализатор всегда генерирует полные пути в выдаваемых диагностических сообщениях. Предположим, что проверяемый проект расположен в директории "C:\MyProjects\Project1". В нашем примере в качестве "корня" дерева исходников проекта можно взять путь "C:\MyProjects\", запишем этот путь в поле 'SourceTreeRoot' и запустим анализ.
По завершению анализа PVS-Studio автоматически заменит заданную нами корневую директорию исходников на специальный маркер, т.е. в сообщении на файл "C:\MyProjects\Project1\main.cpp", путь до данного файла будет передан, как "|?|Project1\main.cpp." Сообщения же на файлы, лежащие вне заданной корневой директории, затронуты не будут. Т.е. сообщение на файл из директории "C:\MyCommonLib\lib1.cpp" будет содержать абсолютный, полный путь до данного файла.
В дальнейшем, при работе с таким фалом отчёта через IDE плагин PVS-Studio, маркер |?| будет автоматически заменяться на значение настройки 'SourceTreeRoot', например, при использовании False Alarm разметки или навигации по сообщениям. Если же будет необходимо работать с данным файлом отчёта на другой машине, достаточно лишь указать в настройках IDE плагина новый путь до корня дерева исходников, например, "C:\Users\User\Projects\", и плагин будет автоматически осуществлять корректное раскрытие полных путей.
Данный режим можно также использовать и в Independent режиме анализатора, при прямой его интеграции в сборочную систему (make, msbuild и т.п.). Это позволяет распределить процесс полного анализа исходников и дальнейшую работу с результатами анализа, что может быть особенно полезно на крупном проекте. Например, проект может быть полностью проверен один раз на сборочном сервере, а с результатами проверки уже может работать сразу несколько разработчиков на своих локальных машинах.
Вы также можете использовать настройку 'UseSolutionDirAsSourceTreeRoot', представленную на той же странице. Данная настройка включает или выключает режим использования пути до папки, содержащей файл решения *.sln, в качестве параметра 'SourceTreeRoot'. При включении этого режима (True) в поле 'SourceTreeRoot' будет отображено значение '<Using solution path>'. При этом фактическое значение параметра 'SourceTreeRoot', сохраненное в файле настроек, не меняется. При выключении настройки 'UseSolutionDirAsSourceTreeRoot' (False) это значение (если ранее оно было задано) будет вновь отображено в поле 'SourceTreeRoot'. Таким образом, настройка 'UseSolutionDirAsSourceTreeRoot' просто меняет механизм генерации пути до файла, позволяя использовать в качестве параметра 'SourceTreeRoot' либо указанное пользователем значение, либо путь до папки, содержащей файл решения.
С версии PVS-Studio 7.27 вы можете указать параметр '//V_SOLUTION_DIR_AS_SOURCE_TREE_ROOT' в файле конфигурации диагностик (.pvsconfig). Данный параметр копирует поведение настройки 'UseSolutionDirAsSourceTreeRoot'. Приоритет этого параметра выше, чем настройки из Settings.xml.
PVS-Studio можно использовать независимо от интегрированной среды разработки Visual Studio. Ядро анализатора представляет собой command-line утилиту, позволяющую проверять C/C++ файлы, компилируемые с помощью Visual C++, GCC или Clang. Поэтому мы разработали отдельное приложение, которое представляет оболочку для command-line утилиты и помогает работать с полученным логом сообщений.
PVS-Studio предоставляет удобное расширение среды Visual Studio, позволяющее "в один клик" проверять vcproj/vcxproj-проекты этой IDE. Однако существуют и другие сборочные системы, которые желательно поддержать. Хотя ядро PVS-Studio не зависит от конкретного формата, используемого той или иной сборочной системой (как например MSBuild, GNU Make, NMake, CMake, ninja и т.п.), для интеграции статического анализа PVS-Studio в систему сборки, отличную от поддерживаемых средой Visual Studio проектов VCBuild/MSBuild, от пользователя потребуется самостоятельно выполнить ряд действий. Перечислим их:
Для решения этих проблем можно воспользоваться инструментом C and C++ Compiler Monitoring UI (Standalone.exe).
Рисунок 1 - Compiler Monitoring UI
Compiler Monitoring UI предоставляет возможности для "бесшовной" проверки кода, независимо от используемых компилятора или сборочной системы, а затем позволяет работать с результатами анализа, предоставляя пользовательский интерфейс, схожий с Visual Studio плагином PVS-Studio. Также Compiler Monitoring UI позволяет работать и с отчётом анализатора, полученным с помощью прямой его интеграции в сборочную систему, при отсутствии у пользователя среды Visual Studio. Рассмотрим далее эти возможности.
Compiler Monitoring UI предоставляет пользовательский интерфейс для системы отслеживания компиляции. Сама система отслеживания (консольная утилита CLMonitor.exe) может использоваться и независимо от Compiler Monitoring UI, например, для интеграции статического анализа в систему автоматизированной сборки. Подробнее об использовании системы отслеживания компилятора можно почитать в этом разделе документации.
Для запуска отслеживания откройте диалог через Tools -> Analyze Your Files... (рисунок 2):
Рисунок 2 - Диалог запуска мониторинга сборки
Нажмите "Start Monitoring". После этого будет запущен CLMonitor.exe, а основное окно среды будет свёрнуто.
Выполните сборку, а по её завершении нажмите на кнопку "Stop Monitoring" в окне в правом нижнем углу экрана (рисунок 3):
Рисунок 3 - Диалог управления мониторингом
Если серверу мониторинга удалось отследить запуски компиляторов, будет запущен статический анализ исходных файлов. По окончании вы получите обычный отчёт о работе PVS-Studio (рисунок 4):
Рисунок 4 - Результаты работы сервера мониторинга и статического анализатора
Результаты работы могут быть сохранены в виде XML файла (файла с расширением plog) для дальнейшего использования с помощью команды меню File -> Save PVS-Studio Log As...
Способ проведения инкрементального анализа аналогичен тому, как проводится анализ всего проекта. Ключевое отличие состоит в необходимости выполнения не полной, а инкрементальной сборки. В таком случае будут отслежены запуски компиляторов для модифицированных файлов, что позволит проверить только их. В остальном процесс анализа полностью идентичен тому, что описан выше, в разделе "Анализ исходных файлов с помощью отслеживания запуска компиляторов".
После того, как был получен отчёт с предупреждениями анализатора, можно сразу начать просматривать сообщения и править код. Также в Compiler Monitoring UI можно загрузить и отчёт, полученный ранее. Для этого нужно воспользоваться пунктом меню 'File|Open PVS-Studio Log...'.
Различные механизмы подавления и фильтрации сообщений идентичны плагину Visual Studio и доступны в окне настроек 'Tools|Options...' (рисунок 5).
Рисунок 5 - Настройки анализа и механизмы фильтрации сообщений
С помощью окна Analyzer Output можно осуществлять навигацию по предупреждениям анализатора, размечать сообщения как ложные срабатывания и добавлять фильтры для сообщений. Интерфейс для работы с предупреждениями анализатора в Compiler Monitoring UI идентичен интерфейсу окна вывода в плагине для Visual Studio. С подробным описанием окна вывода сообщений можно ознакомиться в данном разделе документации.
Если Вы только начали изучать инструмент статического анализа и хотели бы узнать на что он способен, то можете воспользоваться механизмом Best Warnings. Данный механизм покажет вам наиболее важные и достоверные предупреждения.
Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора, нажмите на кнопку 'Best', как показано на скриншоте ниже:
После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора.
Хотя встроенный редактор Compiler Monitoring UI не имеет такой же мощной и удобной системы навигации и автодополнения, как Microsoft IntelliSense в среде Visual Studio или им подобным, Compiler Monitoring UI предоставляет несколько механизмов поиска, которые могут упростить работу с результатами анализа.
Помимо обычного поиска в открытом файле (Ctrl + F), Compiler Monitoring UI имеет также диалог Code Search для текстового поиска в открытых файлах и директориях файловой системы. Этот диалог доступен через пункт меню 'Edit|Find & Replace|Search in Source Files...' (Рисунок 6):
Рисунок 6 - Диалог поиска Compiler Monitoring UI
Диалог поддерживает поиск в текущем файле, всех открытых файлах, либо в произвольной директории файловой системы. Поиск можно в любой момент остановить, нажав Cancel в появившемся модальном окне. Результаты, при появлении первого совпадения, сразу начнут отображаться в дочернем окне Code Search Results (рисунок 7):
Рисунок 7 - Результаты текстового поиска в исходных файлах проекта
Конечно, при необходимости найти места объявления и\или использования какого-либо идентификатора или макроса, обычный текстовый поиск может оказаться чересчур громоздким или долгим. В этом случае вы можете воспользоваться механизмом поиска по зависимостям и навигации по #include макросам.
Поиск по зависимостям в файлах позволяет искать символ\макрос именно в тех файлах, которые непосредственно участвовали при компиляции, а точнее, при последующем препроцессировании файлов, при их проверке анализатором. Для запуска поиска по зависимостям, откройте контекстное меню на символе, использование которого вы хотите посмотреть (рисунок 8):
Рисунок 8 - Поиск символа по зависимостям
Результаты поиска, по аналогии с текстовым поиском, начнут выдаваться в отдельном дочернем окне Find Symbol Results. Поиск можно в любой момент остановить, нажав на Cancel в status bar'е главного окна Compiler Monitoring UI рядом с индикатором прогресса.
Навигация по #include макросам позволяет открывать в редакторе кода Compiler Monitoring UI файл, добавленный в текущий файл через такой макрос. Для открытия include'а также нужно воспользоваться контекстным меню редактора (рисунок 9):
Рисунок 9 - Навигация по include'ам
Стоит помнить, что информация о зависимостях доступна не для любого исходного файла, открытого в Compiler Monitoring UI. В ситуации, когда база зависимостей недоступна для Compiler Monitoring UI, описанные выше пункты контекстного меню доступны также не будут.
База зависимостей создаётся только тогда, когда анализ запущен непосредственно из самого Compiler Monitoring UI. При открытии произвольного C/C++ исходника такой информации у Compiler Monitoring UI не будет. Заметим, что при сохранении результата работы анализатора в виде plog файла, в случае если этот результат был получен в самом приложении Compiler Monitoring UI, рядом с plog файлом будет создан также соответствующий ему специальный dpn файл, содержащий зависимости проверенных файлов. Наличие dpn файла рядом с plog файлом отчёта сделает возможным поиск по зависимостям, если такой plog файл будет открыт в Compiler Monitoring UI.
Файл конфигурации служит для отображения и фильтрации сообщений анализатора. Также в нём можно задать дополнительные настройки анализа. Использование данных файлов возможно только для проектов, написанных на C, C++ или C#.
Файлы конфигурации поддерживаются плагинами для следующих IDE:
Утилиты, поддерживающие файлы конфигурации:
PVS-Studio_Cmd.exe;CLMonitor.exe (только в режиме analyze или analyzeFromDump); Standalone.exe); CompileCommandsAnalyzer.exe (в режиме analyze).Для использования файла конфигурации в Visual Studio необходимо добавить его на уровне проекта или решения. Для этого выделите интересующий проект или решение в окне Solution Explorer среды Visual Studio. Выберите пункт контекстного меню Add New Item... . В появившемся окне выберите тип файла PVS-Studio Filters File.
Если шаблона нет, то вы можете просто добавить в проект или решение обычный текстовый файл с расширением .pvsconfig.
Для каждого проекта/решения можно добавить несколько файлов конфигурации.
Конфигурационные файлы, добавленные на уровне проекта, применяются ко всем файлам в проекте.
Добавление строки //DISABLE_ANALYSIS_AFTER_BUILD в файл .pvsconfig уровня решения скроет меню Analysis After Build (Modified Files Only) и отключит инкрементальный анализ для соответствующего решения. Изменения вступят в силу при повторном открытии решения.
Специального шаблона для добавления файла конфигурации для CLion нет.
Добавить файл конфигурации для CLion можно только на уровне проекта. Чтобы использовать его в CLion, добавьте в папку .PVS-Studio новый файл с расширением .pvsconfig через контекстное меню New > File.
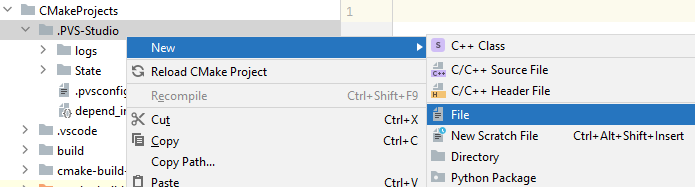
Специального шаблона для добавления файла конфигурации для Rider нет.
Добавить файл конфигурации для Rider можно только на уровне проекта. Чтобы использовать файл конфигурации диагностик в Rider, добавьте в проект новый файл с расширением .pvsconfig через Solution Explorer.
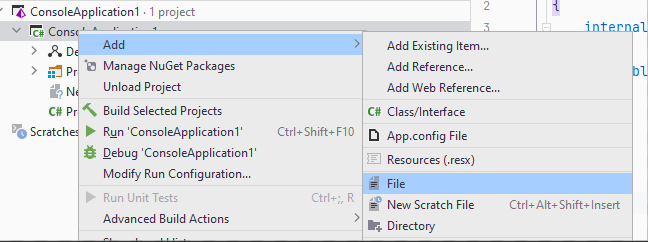
При анализе через PVS-Studio_Cmd.exe или pvs-studio-dotnet автоматически используются файлы конфигурации из анализируемого проекта или решения. Также можно передать путь к дополнительному файлу .pvsconfig с помощью параметра --rulesConfig (-C):
PVS-Studio_Cmd.exe -t ProjName.sln -C \path\to\.pvsconfig
pvs-studio-dotnet -t ProjName.sln -C /path/to/.pvsconfigВ этом случае при анализе учитываются настройки и из файлов в проекте/решении, и из файла, переданного в качестве аргумента.
Путь к файлу конфигурации необходимо передать в качестве аргумента командной строки (параметр -c):
CLMonitor.exe analyzeFromDump -d /path/to/compileDump.gz -c /path/to/.pvsconfigЕсли вы используете утилиту CompilerCommandsAnalyzer.exe, то можете передать путь до .pvsconfig файла через параметр -R:
CompilerCommandsAnalyzer.exe analyze ... -R /path/to/.pvsconfigВ Standalone.exe вы можете указать путь к файлу при запуске мониторинга.
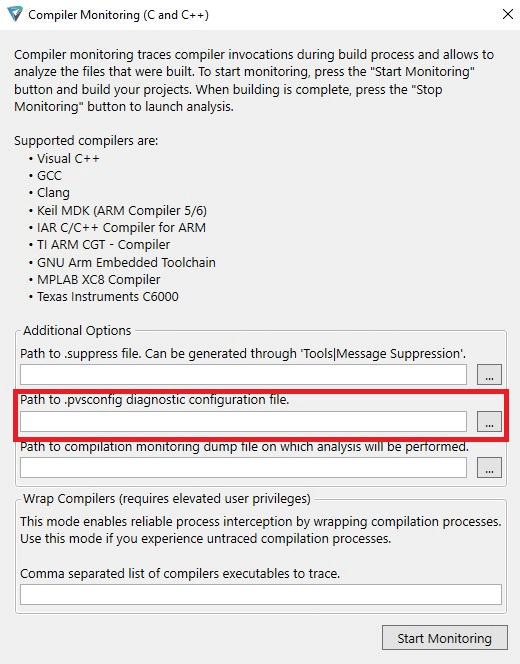
Глобальный файл конфигурации диагностик используется при проверке всех проектов. Таких файлов конфигурации .pvsconfig может быть несколько, и все они будут использованы инструментами PVS-Studio.
Для добавления глобального файла конфигурации создайте файл с расширением .pvsconfig в папке:
%APPDATA%\PVS-Studio;~/.config/PVS-Studio.Задание настроек в файлах конфигурации производится при помощи специальных директив, начинающихся с символов //. Каждая директива пишется с новой строки.
Пример:
//-V::122
//-V::123Также существует возможность добавлять комментарии. Для этого необходимо написать символ # в начало строки.
Пример:
# I am a commentДля полного отключения определённой диагностики используется запись:
//-V::numbernumber — номер диагностики, которую нужно выключить (например, 3022).
Пример использования:
//-V::3022В данном случае будут игнорироваться срабатывания диагностики V3022.
Для отключения нескольких диагностик перечислите номера через запятую:
//-V::number1,number2,...,numberNПример:
//-V::3022,3080При использовании этой директивы будут полностью отключены диагностики V3022 и V3080.
Для отключения диагностик некоторой категории используются следующие директивы:
//-V::GA
//-V::X64
//-V::OP
//-V::CS
//-V::MISRA
//-V::OWASPПояснение для каждой из категорий:
Можно комбинировать фильтры категорий, перечисляя их через запятую.
Пример комбинации:
//-V::GA,MISRAДля отключения всех диагностик C++ или C# анализатора используются директивы:
//-V::C++
//-V::C#Если требуется исключить срабатывания определённого уровня, используйте запись вида:
//-V::number1,number2,...,numberN:levelnumber1, number2 и т.д. — номера диагностик, срабатывания которых нужно исключить (например, 3022).level — уровень предупреждения (1, 2 или 3).Цифре 1 соответствуют срабатывания уровня High, цифре 2 — Medium, цифре 3 — Low.
Можно исключать предупреждения сразу нескольких уровней. Для этого нужно написать уровни через запятую.
Пример:
//-V::3022,5623:1,3Эта запись позволит исключить срабатывания диагностик V3022 и V5623 уровня High и Low.
Анализатор поддерживает возможность исключения предупреждений по номеру диагностики и подстроке, содержащейся в сообщении.
Запись для подавления:
//-V::number::{substring}number — номер диагностики, сообщение которой нужно подавить (например, 3080);substring — подстрока, содержащаяся в сообщении анализатора.При использовании такого шаблона будут игнорироваться срабатывания диагностик с номером number, сообщения которых содержат подстроку substring.
Пример подавления по подстроке:
//-V::3022::{always true}В данном случае будут отключены срабатывания V3022, в сообщении которых есть подстрока always true.
Также можно добавить фильтрацию по уровню и подстроке. Такая запись будет иметь вид:
//-V::number1,number2,...,numberN:level:{substring}number1, number2 и т.д. — номера диагностик, срабатывания которых нужно исключить (например, 3022);level — уровень предупреждения (1, 2 или 3);substring — подстрока, содержащаяся в сообщении анализатора.Цифре 1 соответствуют срабатывания уровня High, цифре 2 — Medium, цифре 3 — Low.
Можно исключать предупреждения диагностик сразу нескольких уровней. Для этого нужно написать уровни через запятую.
Пример:
//-V::3022,5623:1,3:{always true}Будут исключены срабатывания уровня High и Low диагностик V3022, V5623, в сообщении которых есть подстрока always true.
Для исключения предупреждений некоторых категорий по уровням используется запись вида:
//-V::category1,category2,...,categoryN:levelcategory1, category2 и т. д. — имена категорий, срабатывания которых нужно исключить (например, GA). Перечень категорий и их описание можно найти в разделе Отключение диагностик из определённых категорий этой документации;level — уровень предупреждения (1, 2 или 3).Можно комбинировать фильтры категорий и уровней, перечисляя их через запятую.
Пример комбинации:
//-V::GA,MISRA:1,3Будут исключены срабатывания уровня High и Low диагностик, которые относятся к категориям GA и MISRA.
Примечание: Данная настройка доступна только для C, С++ и C# проектов.
Для включения определённой диагностики используется запись:
//+V::numbernumber — номер диагностики, которую нужно включить (например, 3022).
Пример использования:
//+V::3022В данном случае будут включены срабатывания диагностики V3022.
Для включения нескольких диагностик перечислите номера через запятую:
//+V::number1,number2,...,numberNПример:
//+V::3022,3080При использовании этой директивы будут полностью включены диагностики V3022 и V3080.
Примечание: Данная настройка доступна только для C, С++ и C# проектов.
Для включения диагностик некоторой категории используются следующие директивы:
//+V::GA
//+V::X64
//+V::OP
//+V::CS
//+V::MISRA
//+V::OWASPМожно комбинировать фильтры категорий, перечисляя их через запятую.
Пример комбинации:
//+V::GA,MISRAДобавление False Alarm метки для предупреждений на строки с некоторым фрагментом производится с помощью следующей директивы:
//-V:substring:numbersubstring — подстрока, содержащаяся в строке, на которую указывает анализатор;number — номер диагностики, сообщение которой нужно подавить (например, 3080).Примечание 1. Искомая подстрока (substring) не должна содержать пробелов.
Примечание 2. Сообщения, отфильтрованные данным способом, не будут удалены из отчёта. Они будут отмечены как False Alarm (FA).
Пример использования:
public string GetNull()
{
return null;
}
public void Foo()
{
string nullStr = GetNull();
Console.WriteLine(nullStr.Length);
}На данный код анализатор выдаст предупреждение: "V3080 Possible null dereference. Consider inspecting 'nullStr'."
Для добавления FA-метки для срабатываний на такой код используйте в .pvsconfig следующую запись:
//-V:Console:3080Такая директива добавит отметку False Alarm на все предупреждения V3080, указывающие на строку кода, в которой есть Console.
Аналогичным образом можно добавлять отметку False Alarm на срабатывания сразу нескольких диагностик. Для этого перечислите их номера через запятую:
//-V:substring:number1,number2,...,numberПример:
//-V:str:3080,3022,3175Сообщения диагностик V3080, V3082, V3175 будут помечены как False Alarm, если в строке, на которую указывает анализатор, есть подстрока str.
С PVS-Studio версии 7.28 появилась возможность ставить дополнительный хэш-код к метке False Alarm. При изменении строки с этим хэш-кодом предупреждения, выданные на эту строку, не будут отмечены как ложные срабатывания, так как хэш-код изменённой строки отличается от хэш кода метки.
Эта настройка помогает распознавать ситуации, когда строка с меткой False Alarm изменяется.
Для включения этой функции добавьте в файл конфигурации следующий флаг:
//V_ENABLE_FALSE_ALARMS_WITH_HASHВ коде метка False Alarm c хэш-кодом выглядит следующим образом:
//-V817 //-VH"3652460326"С версии PVS-Studio 7.30 появилась возможность для подавления только тех сообщений, к False Alarm метке которых поставлен дополнительный хэш-код:
//V_HASH_ONLY ENABLE
//V_HASH_ONLY ENABLE_VERBOSEВ случае применения данной настройки те строчки, которые имеют метку False Alarm, но не имеют хэш-кода, не будут подавлены.
Настройка ENABLE приведёт к попаданию одного на весь проект сообщения V018 в отчёт. В случае применения настройки ENABLE_VERBOSE такое предупреждение будет выдаваться на каждую строчку кода, в которой присутствует метка False Alarm без хэш-кода.
Выключение настройки выполняется следующим образом:
//V_HASH_ONLY DISABLEДанная ситуация может возникнуть в случае, если применение данной настройки необходимо только на определённой части кода.
Для исключения из анализа файла или группы файлов используйте шаблон:
//V_EXCLUDE_PATH fileMaskfileMask — маска файла.
Пример использования некоторых масок:
//V_EXCLUDE_PATH C:\TheBestProject\thirdParty
//V_EXCLUDE_PATH *\UE4\Engine\*
//V_EXCLUDE_PATH *.autogen.csНачиная с версии 7.34 PVS-Studio можно использовать шаблон //V_ANALYSIS_PATHS с режимом skip-analysis.
Например:
//V_ANALYSIS_PATHS skip-analysis=C:\TheBestProject\thirdParty
//V_ANALYSIS_PATHS skip-analysis=*\UE4\Engine\*
//V_ANALYSIS_PATHS skip-analysis=*.autogen.csС синтаксисом формирования масок можно ознакомится в документации.
Примечание: Эта настройка доступна только в файлах конфигурации (.pvsconfig), которые расположены на уровне решения. В других случаях она будет проигнорирована.
Начиная с версии 7.32, утилита PVS-Studio_Cmd.exe и плагин для Visual Studio поддерживают исключение из анализа проектов по шаблону:
//V_EXCLUDE_PROJECT projMaskprojMask — маска файла проекта.
Пример использования некоторых масок:
//V_EXCLUDE_PROJECT C:\TheBestProject\thirdParty\3rdparty.vcxproj
//V_EXCLUDE_PROJECT *\TOCSharp.csproj
//V_EXCLUDE_PROJECT *\elsewhere\*.*projСинтаксис формирования масок совпадает с синтаксисом, используемым для исключения файлов из анализа. Исключить из проверки можно только .vcxproj и .csproj проекты.
Также вы можете исключить проект из анализа, указав аналогичный путь для флага //V_EXCLUDE_PATH.
Эта опция влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Примечание: Данная настройка доступна только для C и С++ проектов.
Начиная с версии 7.34 PVS-Studio поддерживает возможность игнорировать настройки, которые находятся в исходных файлах и файлах конфигурации диагностик .pvsconfig.
Для этого можно использовать флаг //V_ANALYSIS_PATHS с режимом skip-settings.
Например:
//V_ANALYSIS_PATHS skip-settings=*\path\to\folder\*
//V_ANALYSIS_PATHS skip-settings=*\path\*\custom_pvsconfig
//V_ANALYSIS_PATHS skip-settings=*custom_settings.hЕсли необходимо исключить файлы из анализа и одновременно игнорировать настройки для этих файлов, можно использовать флаг //V_ANALYSIS_PATHS с режимом skip.
Например:
//V_ANALYSIS_PATHS skip=*\path\to\source_or_pvsconfigС синтаксисом формирования масок можно ознакомится в документации.
Примечание: данная настройка доступная только при использовании утилиты pvs-studio-analyzer.
Начиная с версии 7.36, утилита pvs-studio-analyzer поддерживает режим, при котором в каждом каталоге (и его родительских каталогах) для каждой единицы трансляции выполняется поиск файлов конфигурации правил (.pvsconfig). Каждый найденный файл *.pvsconfig будет применён для всех единиц трансляции в каталоге и его подкаталогах. Для включения этого режима следует воспользоваться флагом командной строки --apply-pvs-configs. Подробнее об этом можно узнать в документации по утилите pvs-studio-analyzer.
Вы можете изолировать настройки в каталоге от настроек из родительских директорий. Это полезно, если вам необходимо отделить настройки в подпроектах или third-party библиотеках. В таком случае никакие файлы конфигурации правил из родительских каталогов не будут применены для указных директорий и их подкаталогов.
Для изоляции настроек с помощью файла конфигурации правил есть два способа:
V_ANALYSIS_PATHS с режимом isolate-settings. Данную опцию можно указать в любом файле конфигураций правил. Поддерживаются абсолютные и относительные пути. Относительные пути раскрываются через путь до файла конфигураций правил, например://V_ANALYSIS_PATHS isolate-settings=path/to/isolate;isolate-settings=ThirdParty//V_ISOLATE_CURRENT_DIR. Включает изоляцию каталога, в котором расположен файл конфигурации с данным флагом.Перед запуском анализа PVS-Studio_Cmd формирует конфигурацию диагностических правил из:
%APPDATA%\PVS-Studio для Windows и в папке ~/.config/PVS-Studio для Linux и macOS);--rulesConfig (-C);Может возникнуть ситуация, когда глобальная конфигурация не должна применяться при анализе каких-либо проектов или решений. Для её отключения добавьте в соответствующий файл конфигурации следующий флаг:
//IGNORE_GLOBAL_PVSCONFIGНачиная с версии 7.36, этот флаг поддерживается и в pvs-studio-analyzer.
При запуске анализа через интерфейс плагинов (Visual Studio, Rider и CLion) или в C and C++ Compiler Monitoring UI (Standalone.exe) имеется возможность указания timeout-а по истечению которого анализ файла будет прерван. При превышении timeout-а анализа в результаты анализа будет добавлено предупреждение V006 с информацией о том, на каком файле был превышен timeout.
Настройки timeout-а анализа файлов можно указать и в .pvsconfig. Например, этой строчкой указывается timeout в 10 минут (600 секунд):
//V_ANALYSIS_TIMEOUT 600Если в .pvsconfig указана строка с timeout-ом равным 0, то файлы будут анализироваться без ограничения по времени.
Благодаря настройке timeout-ов через .pvsconfig файлы разных уровней, можно ограничить время анализа файлов в определенных проектах, solution-ах или во всей системе.:
--rulesConfig (-c) в PVS-Studio_Cmd.exe (переопределяет timeout анализа файлов для текущего анализа solution/проекта);%AppData% в Windows, ~/.config в Linux, macOS); .sln);.csproj, .vcxproj).Предупреждения анализатора имеют три уровня достоверности: High, Medium, Low. В зависимости от используемых в коде конструкций анализатор оценивает достоверность предупреждений и присваивает им соответствующий уровень в отчёте.
В некоторых проектах поиск определённых типов ошибок может быть очень важен, независимо от степени достоверности предупреждения. Бывает и обратная ситуация, когда сообщения малополезны, но совсем их отключать не хочется. В таких случаях для диагностик можно вручную задать уровень High/Medium/Low. Для этого следует использовать следующие директивы:
//V_LEVEL_1 изменяет уровень срабатываний на High;//V_LEVEL_2 изменяет уровень срабатываний на Medium;//V_LEVEL_3 изменяет уровень срабатываний на Low.Для изменения уровня используйте директиву следующего вида:
//V_LEVEL_1::numbernumber — номер диагностики.
Например, чтобы изменить уровень предупреждений для диагностики V3176 на третий, используйте запись:
//V_LEVEL_3::3176Для изменения подстроки в сообщении анализатора используйте следующий синтаксис:
//+Vnnn:RENAME:{originalString:replacementString}, ...Vnnn — название диагностики, сообщение которой необходимо модифицировать (например, V624);originalString — исходная подстрока;replacementString — строка на которую нужно заменить.Разберём работу директивы на примере. Диагностика V624, встречая в коде число 3.1415, предлагает заменить его на M_PI из библиотеки <math.h>. Но в проекте используется специальная математическая библиотека, и нужно использовать математические константы именно из неё. Для корректной работы следует добавить директиву в файл конфигурации.
Эта директива будет иметь следующий вид:
//+V624:RENAME:{M_PI:OUR_PI},{<math.h>:"math/MMath.h"}Теперь анализатор сообщит, что нужно использовать константу OUR_PI из заголовочного файла math/MMath.h.
Существует возможность добавить строку к сообщению.
Директива, позволяющая сделать это, имеет следующий вид:
//+Vnnn:ADD:{message}Vnnn — название диагностики, сообщение которой необходимо модифицировать (например, V2003);message — строка для добавления;Разберём пример. Для этого рассмотрим сообщение диагностики V2003: "Explicit conversion from 'float/double' type to signed integer type.".
Чтобы добавить дополнительную информацию в это сообщение, нужно использовать директиву следующего вида:
//+V2003:ADD:{ Consider using boost::numeric_cast instead.}Теперь анализатор будет выдавать модифицированное сообщение: "Explicit conversion from 'float/double' type to signed integer type. Consider using boost::numeric_cast instead.".
При запуске анализа через интерфейс плагина Visual Studio или в C and C++ Compiler Monitoring UI (Standalone.exe) имеется возможность отключить синхронизацию suppress файлов с помощью настройки Specific Analyzer Settings/DisableSynchronizationOfSuppressFiles.
Отключить синхронизацию также можно через .pvsconfig файл уровня решения. Для этого необходимо добавить в соответствующий конфигурационный файл следующий флаг:
//DISABLE_SUPPRESS_FILE_SYNCДля включения синхронизации через .pvsconfig независимо от значения настройки DisableSynchronizationOfSuppressFiles необходимо использовать флаг:
//ENFORCE_SUPPRESS_FILE_SYNCЭта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Начиная с версии 7.24 утилита PVS-Studio_Cmd.exe и плагин для Visual Studio поддерживают возможность указать версию ядра PVS-Studio для анализа C++ проектов, если на компьютере установлено несколько версий PVS-Studio.
Начиная с версии 7.36 утилита PVS-Studio_Cmd.exe и плагин для Visual Studio поддерживают возможность указать версию ядра PVS-Studio для анализа C# проектов, если на компьютере установлено несколько версий PVS-Studio.
Для того, чтобы PVS-Studio_Cmd.exe запускал анализ на нужной версии ядра PVS-Studio необходимо в файл .pvsconfig уровня решения добавить флаг //PVS_VERSION::Major.Minor, где
Major — мажорное число версии, а Minor — минорное число.
Например:
//PVS_VERSION::7.26PVS-Studio_Cmd.exe вычисляет путь до ядра используя информацию из системного реестра, которую пишет инсталлятор при установке PVS-Studio.
Для C++ проектов минимальная поддерживаемая версия значения настройки PVS_VERSION — это 7.26 (минимальное значение для C++ проектов было добавлено в версии 7.36). Это означает, что при использовании этой настройки при анализе C++ проектов можно запустить версию ядра PVS-Studio 7.26 или выше.
Для C# проектов минимальная поддерживаемая версия значения настройки PVS_VERSION — это 7.15. Это означает, что при использовании этой настройки при анализе C# проектов можно запустить только версию ядра PVS-Studio 7.15 или выше.
В случае установки новой версии PVS-Studio в уже существующую директорию, содержащую другую версию PVS-Studio, номер версии в реестре для этой директории будет обновлён.
Последняя установка PVS-Studio, считается установкой по умолчанию. А значит, если последней была установлена версия PVS-Studio 7.23, то такой же версии будут все плагины и PVS-Studio_Cmd.exe. Следовательно, вы не сможете воспользоваться механизмом выбора версий ядра PVS-Studio. Поэтому, если вы хотите использовать старые версии PVS-Studio (7.23 и ниже), то вам нужно в начале установить их и только потом поставить последнюю версию PVS-Studio 7.24 или выше.
Для всех версий ниже 7.24 необходимо в реестре прописать соотношение версии и пути до каталога установки этой версии, чтобы PVS-Studio_Cmd.exe смог найти путь до ядра PVS-Studio. Информация записывается в раздел Computer\HKEY_LOCAL_MACHINE\SOFTWARE\WOW6432Node\ProgramVerificationSystems\PVS-Studio\Versions.
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Начина с версии 7.25 утилита PVS-Studio_Cmd.exe и плагин для Visual Studio поддерживают возможность явно задать приоритет файлов конфигурации одного уровня. Для этого необходимо использовать флаг //CONFIG_PRIORITY::number, где number — номер приоритета.
Начиная с версии 7.36, этот флаг поддерживается в утилите pvs-studio-analyzer.
Например:
//CONFIG_PRIORITY::1Чем меньше номер, тем приоритетней файл конфигурации. Файлы, в которых нет данного флага, имеют минимальный приоритет. Файлы имеющий одинаковый приоритет применяются в алфавитном порядке. Например, среди файлов Filter1.pvsconfig, Filter2.pvsconfig, Filter3.pvsconfig настройки из Filter3.pvsconfig будут приоритетными.
Флаг //CONFIG_PRIORITY влияет только на файлы конфигурации одного уровня. В порядке возрастания приоритета файлы настроек применяются так:
--rulesConfig (-c) утилите PVS-Studio_Cmd. Эта опция влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Чтобы PVS-Studio перед анализом выполнил команды из CustomBuild task, в файл .pvsconfig нужно добавить следующую директиву:
//EXECUTE_CUSTOM_BUILD_COMMANDSЭта директива применима только для .pvsconfig файлов, передаваемых через командную строку, а также расположенных на глобальном уровне или уровне решения.
Рассмотрим случай, в котором директива может пригодиться.
Некоторые Visual C++ проекты при сборке могут генерировать исходный код с помощью команд, записанных в CustomBuild task. Запуск анализа без генерации этих файлов может привести к ошибкам. Если нужно только сгенерировать файлы, то выполнять полную сборку смысла нет (это может быть долго).
В таком случае будет полезно указать PVS-Studio соответствующую директиву, чтобы анализатор сначала выполнил команды генерации файлов, а затем провёл анализ.
Иногда анализатор может выдавать сообщение об ошибке парсинга на полностью компилирующийся проект. Эти ошибки могут быть не критичны для качества анализа. В таком случае их можно подавить.
Ошибка парсинга имеет код:
Подавление V051 (C# анализатор)
C# анализатор выдаёт V051 при наличии хотя бы одной ошибки компиляции. Увидеть все ошибки можно запустив command line версию анализатора с флагом --logCompilerErrors. Синтаксис для подавления этих ошибок выглядит следующим образом:
//V_EXCLUDE_PARSING_ERROR:V051:{"ProjectName": "MyProject", "ErrorCode": "CS0012", "Message": "Some message"}
В данном случае для проекта (.csproj) MyProject будет подавлена ошибка компиляции с кодом CS0012 и сообщением Some message.
Также не обязательно комбинировать информацию для подавления:
//V_EXCLUDE_PARSING_ERROR:V051:{"ProjectName": "MyProject"} — подавить все ошибки на проекте MyProject//V_EXCLUDE_PARSING_ERROR:V051:{"ErrorCode": "CS0012"} — подавить все ошибки с кодом CS0012 для всех проектов//V_EXCLUDE_PARSING_ERROR:V051:{"Message": "Some message"} — подавить все ошибки с сообщением "Some message".При указании сообщения вы можете воспользоваться масками. Например:
//V_EXCLUDE_PARSING_ERROR:V051:{Message: "Some*"}
Примечание: на данный момент подавление ошибок парсинга доступно только для V051 (C# анализатор).
В глобальном файле конфигурации Settings.xml есть ряд опций, которые влияют на результат анализа. Например, настройки выключения диагностических групп.
Вы можете использовать флаг //V_IGNORE_GLOBAL_SETTINGS ON для того, чтобы настройки из Settings.xml не учитывались при анализе. В этом случае включаются все диагностические группы и не применяются фильтры путей.
Для гибкой настройки анализа используйте файлы конфигурации (.pvsconfig).
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe и плагинов для Visual Studio.
Вы можете использовать флаг //V_SOLUTION_DIR_AS_SOURCE_TREE_ROOT для того, чтобы включить использование каталога решения в качестве значения SourceTreeRoot.
С настройкой SourceTreeRoot можно ознакомиться в отдельной документации.
Параметр является более приоритетным, чем UseSolutionDirAsSourceTreeRoot из файла настроек Settings.xml.
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Начиная с PVS-Studio версии 7.34 вы можете использовать флаг //V_SOLUTION_DIR_AS_DEPENDENCY_CACHE_SOURCE_TREE_ROOT для того, чтобы включить использование каталога решения в качестве корневой части пути, который будет использован для построения относительных путей файлов в кэше зависимостей компиляции.
Этот флаг следует использовать в режиме проверки списка файлов и в режиме проверки модифицированных файлов. Данная настройка позволяет получить файлы кэшей зависимостей компиляции, которые затем можно использовать на машинах с отличающимся расположением проверяемых исходных файлов.
Эта настройка похожа на //V_SOLUTION_DIR_AS_SOURCE_TREE_ROOT, только относительные пути для файлов будут строиться в файлах кэшей зависимостей компиляции, а не в отчёте анализатора.
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
С версии PVS-Studio 7.27 внутреннее содержимое файлов подавления сортируется. Это требуется для корректного использования в системе контроля версий и избегании проблем слияния файлов.
Сообщения сортируются в следующем порядке: имя исходного файла, код диагностики, хэш строки, описание диагностики.
Если вам требуется сохранить старое поведение и отключить сортировку, вы можете указать параметр //V_DISABLE_SUPPRESS_FILE_SORTING.
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Существует возможность задавать отдельные настройки анализа в зависимости от версии PVS-Studio, целевой архитектуры или целевой операционной системы.
Например, чтобы отключить диагностическое правило V501, начиная с версии PVS-Studio 8.00 и выше, нужно написать:
//V_SECTION_BEGIN
//V_WHEN_VERSION: GE 8.0
//-V::501
//V_SECTION_ENDУпрощённо каждая секция содержит как минимум три обязательных элемента:
//V_SECTION_BEGIN;//V_WHEN_VERSION — когда используется указанная версия PVS-Studio;//V_WHEN_TARGET_ARCH — когда используется указанная целевая архитектура;//V_WHEN_TARGET_OS — когда используется указанная целевая операционная система;//V_SECTION_END.Условий применения секции может быть несколько. Они неявно объединяются через логическое И. Например, во фрагменте ниже секция (как и все настройки внутри неё) будет применена только если анализируемый код компилируется для ОС Windows и платформы x64:
//V_SECTION_BEGIN
//V_WHEN_TARGET_ARCH: x64
//V_WHEN_TARGET_OS: Windows
//V_CHEAP_TO_COPY_THRESHOLD=8
//V_SECTION_ENDВсе подвыражения в V_WHEN_* могут быть скомбинированы с помощью символа | (аналог оператора ИЛИ). Каждое подвыражение вычисляется по отдельности. Если хотя бы одно из них истинно, то и всё условие считается истинным.
Например:
//V_WHEN_TARGET_OS: macOS | Linux | WindowsДанное условие позволяет применять настройки анализатора в зависимости от его версии.
Если необходимо указать не точную версию, а диапазон, то можно воспользоваться оператором IN. Значения указываются через запятую включительно. Например, так можно указать все версии с 7.20 до 7.25 (включительно):
....
//V_WHEN_VERSION: in 7.20,7.25
....Поддерживаемые операторы в условиях для версии, их псевдонимы и описание:
|
# |
Оператор |
Alias |
Описание |
|---|---|---|---|
|
1 |
EQ |
== |
Равно |
|
2 |
NE |
!= |
Не равно |
|
3 |
LT |
< |
Меньше |
|
4 |
LE |
<= |
Меньше или равно |
|
5 |
GT |
> |
Больше |
|
6 |
GE |
>= |
Больше или равно |
|
7 |
IN |
отсутствует |
Диапазон значений |
Регистр текстовых операторов не имеет значения. Такая запись условия также будет корректной:
....
//V_WHEN_VERSION: == 7.17 | In 7.20,7.25 | GT 8
....Пример секции:
//V_SECTION_BEGIN
//V_WHEN_VERSION: eq 7.30 | in 7.32,7.35 | gt 8
//+V::860
//V_ASSERT_CONTRACT
//-V::1100
//V_SECTION_ENDСинтаксис условия:
<VERSION_CONDITION_SEQUENCE> ::= <VERSION_CONDITION>
| <VERSION_CONDITION_SEQUENCE>
"|" <VERSION_CONDITION>
<VERSION_CONDITION> ::= <SINGLE_VERSION_COMPARISON>
| <RANGE_VERSIONS_COMPARISON>
<SINGLE_VERSION_COMPARISON> ::= <OP> <VERSION>
<RANGE_VERSIONS_COMPARISON> ::= "IN" <VERSION> "," <VERSION>
<OP> ::= "EQ" | "NE" | "LT" | "LE" | "GT" | "GE"
<VERSION> ::= <NUMBER> [ "." <NUMBER> ]Данное условие позволяет применять настройки анализатора в зависимости от целевой архитектуры (того, для какой архитектуры собирается код).
....
//V_WHEN_TARGET_ARCH: <ARCH>
....Список доступных значений <ARCH>:
x86,x64.Пример секции:
//V_SECTION_BEGIN
//V_WHEN_TARGET_ARCH: x64
//+V::X64
//V_SECTION_ENDСинтаксис условия:
<TARGET_ARCH_CONDITION_SEQUENCE> ::= <TARGET_ARCH_CONDITION>
| <TARGET_ARCH_CONDITION_SEQUENCE>
"|" <TARGET_ARCH_CONDITION>
<TARGET_ARCH_CONDITION> ::= <ARCH>Данное условие позволяет применять настройки анализатора в зависимости от целевой операционной системы (той, для которой собирается код).
....
//V_WHEN_TARGET_OS: <OS>
....Список доступных значений для <OS>:
Windows,Linux,macOS.Пример секции:
//V_SECTION_BEGIN
//V_WHEN_TARGET_OS: macOS | Linux
//-V::716
//V_SECTION_ENDСинтаксис условия:
<TARGET_OS_CONDITION_SEQUENCE> ::= <TARGET_OS_CONDITION>
| <TARGET_OS_CONDITION_SEQUENCE>
"|" <TARGET_OS_CONDITION>
<TARGET_OS_CONDITION> ::= <OS>Ограничения:
Примечания:
Начиная с версии 7.35 PVS-Studio поддерживает возможность вывода позиции, с которой начался сдвиг. Механизм будет полезен, если позиции предупреждений анализатора указывают на неправильные строки.
Чтобы вывести начальные позиции сдвига, добавьте флаг //+V002,VERBOSE. Анализатор будет выдавать расширенное сообщение V002 на каждый первый потенциальный сдвиг в файле. Сообщение будет содержать строку, которую анализатор ожидал увидеть на указанной позиции.
Пример:
#include <iostream>
//+V002,VERBOSE
#pragma \
\
warning(push)
// The message V002 will be output here
void bar(int i) // This is the first line for which we detected a shift
{
auto x = i % 5;
// This would be the wrong position for V609
if ( i/x) // This is the correct position of V609
std::cout << "bar" << std::endl;
}
void x()
{
bar(5);
}Важно: анализатор не всегда может корректно вычислить позицию начала сдвига. Это связано с особенностями сравнения исходного и препроцессированного файла, где требуется учитывать раскрытие макросов и дополнительную информацию, которую подставляет препроцессор в .i файл.
Начиная с PVS-Studio версии 7.35 появилась возможность управлять директорией сохранения и построения относительных путей для файлов кэша зависимостей компиляции.
Для указания директории сохранения файлов кэша используйте флаг //V_DEPENDENCY_CACHE_ROOT. Данная настройка позволяет централизовать хранение кэшей зависимостей компиляции разных проектов.
Используйте флаг //V_DEPENDENCY_CACHE_SOURCE_ROOT для указания директории используемой в качестве корневой части пути, который будет использован для построения относительных путей файлов в кэше зависимостей компиляции. Данная настройка позволяет получить файлы кэшей зависимостей компиляции, которые затем можно использовать на машинах с отличающимся расположением проверяемых исходных файлов.
Эти флаги следует использовать в режиме проверки списка файлов и в режиме проверки модифицированных файлов.
Пример использования:
//V_DEPENDENCY_CACHE_ROOT C:\Project\cache
//V_DEPENDENCY_CACHE_SOURCE_ROOT C:\ProjectВ значениях настроек //V_DEPENDENCY_CACHE_ROOT и //V_DEPENDENCY_CACHE_SOURCE_ROOT также можно использовать переменные {$Configuration} и {$Platform}. Вместо этих переменных в указанных настройках будут подставляться значения свойств конфигурации и платформы для каждого проекта из решения, с которыми он собирается перед анализом.
Например, использование таких переменных в настройке //V_DEPENDENCY_CACHE_ROOT позволяет сохранять файлы кэшей зависимостей для проектов в отдельные поддиректории, в имени которых содержатся значения конфигурации и платформы, с которыми собирается проект:
//V_DEPENDENCY_CACHE_ROOT C:\Project\cache\{$Configuration}_{$Platform}Если необходимо указать в настройке //V_DEPENDENCY_CACHE_ROOT или //V_DEPENDENCY_CACHE_SOURCE_ROOT относительные пути, которые должны разрешаться относительно директории расположения .pvsconfig файла решения вместо директории запуска PVS-Studio_Cmd.exe, укажите в .pvsconfig файле решения настройку //RESOLVE_RELATIVE_PATHS. Важно: эта настройка работает только в .pvsconfig файлах уровня решения.
Например, если .pvsconfig файла решения лежит в поддиректории решения, то следующие настройки в этом файле позволят сохранить файлы кэшей зависимостей проектов в поддиректорию решения с именем cache, а в файлах кэшей зависимостей будут записаны относительные пути, которые будут построены относительно директории решения:
//RESOLVE_RELATIVE_PATHS
//V_DEPENDENCY_CACHE_ROOT ..\cache
//V_DEPENDENCY_CACHE_SOURCE_ROOT ..\Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
В PVS-Studio 7.35 появилась возможность указывать режим отслеживания исходных файлов в кэше зависимостей компиляции. Для этого используется флаг //V_DEPENDENCY_CACHE_TRACKING_MODE. Он может принимать одно из следующих значений:
Если значение этого флага не Disabled, то в плагине для Visual Studio появляется возможность запускать анализ модифицированных файлов через пункт меню Extension > PVS-Studio > Check > Modified Files и пункт Analyze Modified Files with PVS-Studio в контекстном меню решений и проектов.
При использовании этого флага кэш зависимостей компиляции будет обновляться независимо от режима анализа — как при анализе модифицированных файлов, так и в обычном режиме.
Эта опция доступна только в файле конфигурации уровня решения и влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
Начиная с PVS-Studio версии 7.37, появилась возможность выделить дополнительной маркировкой предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207-2024, в поле SAST в результатах анализа. Чтобы сделать это, нужно добавить флаг //V_SEC_ID с режимом SHOW:
//V_SEC_ID: SHOWДля деактивации настройки воспользуйтесь этим же флагом с режимом HIDE:
//V_SEC_ID: HIDEПример:
void func()
{
const wchar_t wstr[] = L"12345";
printf("%s\n", wstr);
}На данный код анализатор выдаст предупреждение: V576 Consider checking the second actual argument of the 'printf' function. The pointer to string of char type symbols is expected.
При включении настройки анализатор добавит идентификатор SEC-STR-FORMAT в поле SAST этого предупреждения.
Начиная с PVS-Studio версии 7.38 для анализа С и С++ проектов используется новая реализация парсера языка. Новый парсер обеспечивает более точную обработку шаблонных конструкций, улучшенный разбор стандартной библиотеки и кода на современных стандартах языка C++.
Если вы столкнулись с ошибками или замедлениями анализа после обновления PVS-Studio на версию 7.38, то вы можете вернуть использование старого варианта парсера. Для этого добавьте флаг //V_USE_OLD_PARSER. Пожалуйста, сообщите в техническую поддержку о любых проблемах с анализом. Это поможет нам улучшить работу нового парсера и сделать его более стабильным.
Отключает подстановку параметров шаблона при анализе C++ кода. Это снижает потребление оперативной памяти, но анализ становится менее тщательным.
Пример использования:
//V_DISABLE_TEMPLATE_INSTANTIATION[Release 7.39] Добавлена возможность перезаписи настроек в файлах с более высоким приоритетом из файлов с менее высоким приоритетом.
Для этого настройку из файла с менее высоким приоритетом (та, которая перезаписывает) нужно обернуть в следующую конструкцию:
```
//V_OVERRIDE ON
//Перезаписывающие настройки
//V_OVERRIDE OFF
```При этом аналогичные настройки из файлов с более высоким приоритетом (те, которые перезаписываются) нужно обернуть в следующую конструкцию:
```
//V_ALLOW_OVERRIDE ON
//Перезаписываемые настройки
//V_ALLOW_OVERRIDE OFF
```В обоих конструкциях можно перечислять несколько настроек.
Механизм перезаписи не будет работать с настройками, которые накапливают значения, потому что значения не перезаписываются, а лишь суммируются. Например:
V_EXCLUDE_PATH
V_EXCLUDE_PROJECT
V_ANALYSIS_PATHS
V_EXCLUDE_PARSING_ERRORЕсли настройки, помеченные конструкцией V_OVERRIDE пытаются перезаписать настройки из файла с более высоким приоритетом которые, в свою очередь, не помечены с помощью конструкции V_ALLOW_OVERRIDE, то выдастся ошибка V020.
Эта опция влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
[Release 7.42] Добавлена возможность добавления псевдонимов для заголовочных файлов.
В некоторых решениях для Visual Studio может находится несколько проектов, включающих в себя одни и те же файлы. Анализ может не проходить корректно на таких проектах из-за особенности препроцессирования (PVS-Studio опирается на препроцессирование файлов для получения единиц трансляции для анализа). Она заключается в том, что при препроцессировании совместно используемого файла включаемые в него заголовки могут раскрываться относительно другого проекта.
Чтобы обойти проблему, можно напрямую сказать анализатору, что в конкретном файле включаемые файлы обозначают именно те файлы, находящиеся в текущем проекте. Для этого используется настройка следующего вида:
//V_INCLUDE_ALIAS source:"..\A.cpp", include-original:"stdafx.h", include-alias:"Project2\stdafx.h"
В этом примере общим файлом является ..\A.cpp: путь до него указывается относительно файла анализируемого проекта. stdafx.h - файл, включаемый внутрь ..\A.cpp. Project2\stdafx.h — файл, который подразумевается при включении и путь до него указывается относительно файла ..\A.cpp.
Эта настройка применяется только к файлам pvsconfig уровня проекта.
Эта опция влияет на работу только PVS-Studio_Cmd.exe/pvs-studio-dotnet и плагинов для Visual Studio.
При проверке проектов с большим количеством сторонних библиотек бывает необходимо отсеять лишний шум и сосредоточиться на потенциальных проблемах в своём коде. Для таких целей в инструментах PVS-Studio предусмотрен механизм исключения файлов из анализа. Благодаря механизму исключений вы можете не только убрать ненужные предупреждения, но и значительно увеличить скорость анализа вашего проекта.
Для Visual Studio откройте настройки плагина Extensions -> PVS-Studio -> Options -> Don't Check Files.
Если Вы используете утилиту C and C++ Compiler Monitoring UI, то откройте Tools -> Option... -> Don't Check Files.
В появившимся окне вы можете указать файлы и каталоги, которые должны быть исключены из анализа. Вы также можете использовать wildcard-маски.
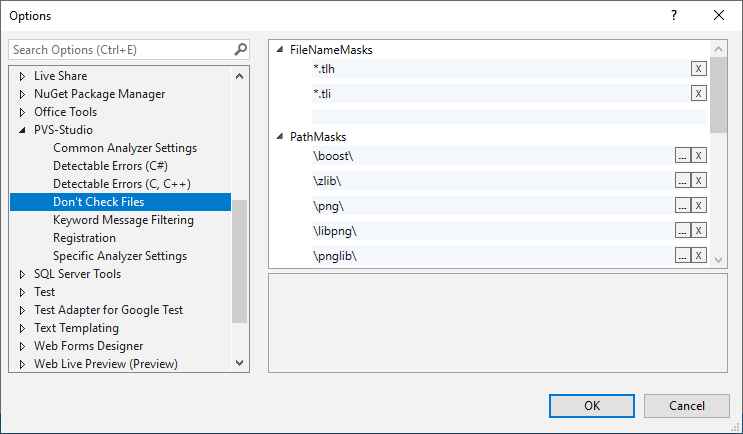
Стоит отметить, что не все маски в плагине для Visual Studio можно применить для фильтрации существующего отчёта. Если маска неприменима для фильтрации, вы получите сообщение о необходимости перезапуска анализа для её применения. Маски, в которых используется символ '*' в начале и/или в конце, сразу применяются для фильтрации предупреждений в таблице плагина.
Подробнее об исключении файлов через настройки плагина для Visual Studio можно прочесть тут.
Вы также можете исключить файлы из анализа через контекстное меню в отчёте анализатора. Для этого щёлкните правой кнопкой мыши по срабатыванию и выберите пункт 'Don't check files and hide all messages from...', в раскрывшемся меню вы сможете выбрать уровень вложенности каталогов, с которого следует исключить файлы.
Обратите внимание, что информация об исключаемых каталогах и файлах записывается в глобальный файл настроек Settings.xml и может быть использована другими инструментами PVS-Studio, если им не передан путь для файла настроек.
Чтобы исключить файлы или каталоги из анализа, перейдите в настройки плагина PVS-Studio (Tools -> PVS-Studio -> Settings) и выберите раздел Excludes.
В этом разделе вы можете управлять масками имён файлов и путей, которые будут исключены из анализа.
Вы также можете исключить из анализа файл или каталог непосредственно через контекстное меню отчёта PVS-Studio. Для этого нажмите правой кнопкой мыши по сообщению и выберите пункт 'Exclude From Analysis', в раскрывшемся меню вы сможете выбрать уровень вложенности каталогов, с которого следует исключить файлы из анализа.
Обратите внимание, что информация об исключаемых каталогах и файлах записывается в глобальный файл настроек Settings.xml и может быть использована другими инструментами PVS-Studio, если им не передан путь для альтернативного файла настроек.
Консольные инструменты могут использовать как глобальный файл настроек Settings.xml, так и специфичный, переданный в качестве аргумента командной строки. Использование специфичного файла может быть полезно, если у вас есть специальные настройки анализа для проекта, которые не должны повлиять на результаты анализа других проектов. Например, список исключаемых каталогов.
Чтобы создать альтернативный файл настроек, скопируйте файл Settings.xml из каталога '%APPDATA%/PVS-Studio/' (Windows) или '~/.config/PVS-Studio' (Linux) в любое место (например, в каталог проверяемого проекта). Затем добавьте исключаемые файлы и каталоги в узел ApplicationSettings/PathMasks (если это каталог) или в ApplicationSettings/FileMasks (если это файл).
Например, так:
<ApplicationSettings ...>
...
<PathMasks>
...
<string>\EU*\Engine\Source</string>
</PathMasks>
...
</ApplicationSettings>Теперь, для того чтобы передать собственный файл настроек в PVS-Studio_Cmd.exe или pvs-studio-dotnet (Linux и macOS), используйте параметр --settings (-s):
PVS-Studio_Cmd.exe -t ProjName.sln -s /path/to/NonDefaultSettings.xmlДля передачи параметра в CLMonitor.exe используйте флаг --settings (-t) в любом режиме запуска:
CLMonitor.exe monitor -t /path/to/NonDefaultSettings.xmlВы можете создать файл .pvsconfig (файл конфигурации диагностик анализатора), в котором с помощью специальных комментариев можно описать файлы и каталоги, исключаемые из анализа. Подробнее про файл .pvsconfig можно узнать тут.
Для исключения файла или каталога файлов из анализа вам достаточно указать до него путь или маску пути, используя специальный комментарий //V_EXCLUDE_PATH.
Например:
//V_EXCLUDE_PATH C:\TheBestProject\ThirdParty
//V_EXCLUDE_PATH *\UE*\Engine\Source\*
//V_EXCLUDE_PATH *.autogen.csНачиная с версии 7.34 PVS-Studio можно использовать комментарий //V_ANALYSIS_PATHS с режимом skip-analysis.
Например:
//V_ANALYSIS_PATHS skip-analysis=C:\TheBestProject\ThirdParty
//V_ANALYSIS_PATHS skip-analysis=*\UE*\Engine\Source\*
//V_ANALYSIS_PATHS skip-analysis=*.autogen.csТеперь вы можете использовать файл .pvsconfig с утилитами PVS-Studio:
Для CLMonitor.exe через флаг -с (--pvsconfig):
CLMonitor.exe analyze ... -c /path/to/.pvsconfigДля PVS-Studio_Cmd.exe и pvs-studio-dotnet через флаг -С (--rulesConfig):
PVS-Studio_Cmd.exe -t target.sln -o PVS-Studio.log -C /path/to/.pvsconfig
pvs-studio-dotnet -t target.csproj -o PVS-Studio.log -C /path/to/.pvsconfigДля CompilerCommandsAnalyzer.exe (Windows) и pvs-studio-analyzer (Linux, macOS) через флаг -R (--rules-config):
CompilerCommandsAnalyzer analyze --cfg /path/to/PVS-Studio.cfg \
-R /path/to/.pvsconfigЕсли вы используете утилиту C and C++ Compiler Monitoring UI, то путь до файла .pvsconfig можно передать через интерфейс запуска мониторинга:
Плагины PVS-Studio (для Visual Studio, Rider) умеют автоматически определять файл .pvsconfig, если он добавлен в Solution или проект и имеет расширение .pvsconfig. Файлы конфигурации, добавленные в Solution, имеют глобальную область видимости и распространяются на все проекты этого Solution'a. Файлы .pvsconfig, добавленные в проект, применяются только для проекта, в который они добавлены.
Если для проверки C и C++ проектов используется кроссплатформенная утилита pvs-studio-analyzer(Linux, macOS) / CompilerCommandsAnalyzer.exe (Windows), то исключить файлы из анализа возможно следующими способами.
Позволяет исключить файлы из анализа, передав пути до них в качестве аргументов запуска pvs-studio-analyzer/CompilerCommandsAnalyzer.exe через флаг -e (--exclude-path):
pvs-studio-analyzer analyze ... -e /third-party/ \
-e /test/ \
-e /path/to*/exclude-pathИли через флаг --analysis-paths с режимом skip-analysis:
pvs-studio-analyzer analyze ... \
--analysis-paths skip-analysis=/third-party/ \
--analysis-paths skip-analysis=/test/ \
--analysis-paths skip-analysis=/path/to*/exclude-pathПри указании пути вы также можете использовать шаблоны командных оболочек (glob).
Создайте текстовый файл (например, MyProject.cfg). Поместите в него список исключаемых каталогов через параметр exclude-path.
Пример:
exclude-path=/third-party/
exclude-path=*/test/*
exclude-path=*/lib-*/*Или используя параметр analysis-paths с режимом skip-analysis:
analysis-paths=skip-analysis=/third-party/
analysis-paths=skip-analysis=*/test/*
analysis-paths=skip-analysis=*/lib-*/*Затем запустите анализ, передав путь до файла конфигурации через флаг --cfg:
pvs-studio-analyzer analyze ... --cfg ./MyProject.cfgВы можете вынести в файл конфигурации и другие параметры запуска. Подробнее об этом написано тут.
ГОСТ Р 71207-2024 "Статический анализ кода" выделят класс дефектов в коде, называемых критическими ошибками. При разработке безопасного программного обеспечения (РБПО) такие дефекты должны в обязательном порядке выявляться и исправляться в приоритетном режиме. Статический анализатор PVS-Studio разрабатывается с учётом этого стандарта и позволяет выявлять все типы критических ошибок в коде программ, написанных на языках C, C++, C#, Java. Рассмотрим эти типы предупреждений и как их можно выделить среди других предупреждений, выдаваемых анализатором.
ГОСТ Р 71207-2024 вводит понятие критические ошибки. Это дефекты программного кода, которые в сравнении с другими ошибками могут быть с большей вероятностью использованы злоумышленником для влияния на процесс работы программы. Если найден способ использования такого дефекта, он становится уязвимостью (vulnerability).
В стандарте приводится следующая формулировка (п. 3.1.13): "Критическая ошибка в программе — ошибка, которая может привести к нарушению безопасности обрабатываемой информации".
Выявление критических ошибок является обязательной составляющей статического анализа кода при построении процесса РБПО.
В ходе конфигурации должны быть выполнены выбор и включение типов предупреждений анализатора, соответствующих списку критических ошибок, приведённых в 6.3. В ходе конфигурации могут быть также включены другие типы предупреждений анализатора, соответствующих другим потенциальным ошибкам, специфичным для анализируемого ПО (дефекты кодирования для языка программирования ПО, принятые стили кодирования и пр.).
...
После анализа результатов первичной разметки конфигурация статического анализатора может быть доработана, в частности могут быть включены дополнительные типы предупреждений, выполнена настройка анализатора на используемые в заданном ПО заимствованные компоненты, доработаны и настроены алгоритмы выдачи конкретных типов предупреждений и пр. Кроме того, статический анализатор может быть по-разному настроен для различных компонентов анализируемого ПО, например для тестов искать только критические ошибки.
Типы критических ошибок, которые должны выявлять статические анализаторы, рассматриваются в 6-м разделе ГОСТ Р 71207-2024. Для компилируемых языков это:
Для интерпретируемых языков это:
Дополнительные типы критических ошибок, для C и C++:
Стандарт ГОСТ Р 71207-2024 наиболее проработан для языков C и C++. Для них перечислено большое количество типов критических ошибок по сравнению с другими языками.
PVS-Studio придерживается расширенной классификации на основании обсуждений по доработке стандарта в рамках мероприятия "Испытания статических анализаторов исходных кодов компилируемых и динамических языков программирования под руководством ФСТЭК России". На испытаниях эти виды ошибок входили в "Дополнительный набор тестов", поэтому было принято решение заранее разметить их как критические ошибки.
Подробнее о мероприятии "Испытания статических анализаторов исходных кодов компилируемых и динамических языков программирования под руководством ФСТЭК России":
Следующие типы диагностических правил дополнительно размечены в анализаторе PVS-Studio как выявляющие критические ошибки.
Для Java, Go и C#:
Для Python:
Статический анализатор PVS-Studio добавляет специальные идентификаторы (флаги) к предупреждениям, которые относятся к критическим типам ошибок. Они относятся к столбцу SAST и начинаются с префикса SEC- (сокращение от SECURITY).
Он означает, что эти предупреждения выявляют ошибки, наиболее связанные с разработкой безопасного программного обеспечения.
Некоторые детекторы анализатора могут выдавать предупреждения, имеющие сразу два идентификатора. Причина в том, что одна и та же ошибка может быть интерпретирована как дефект разного типа. Например, пользователь вводит число, которое без предварительной проверки используется как индекс массива, что может привести к выходу за границу массива. В этом случае предупреждение будет одновременно помечено двумя идентификаторами:
SEC-TAINT — ошибка непроверенного использования чувствительных данных;SEC-BUF-OVERFLOW — ошибка переполнения буфера.Все идентификаторы критических ошибок для языков C и C++:
SEC-TAINT — ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.);SEC-OVERFLOW-OR-INT-UINT — ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел;SEC-BUF-OVERFLOW — ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти);SEC-SECURITY — ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.);SEC-SYNCHRONIZATION — ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.);SEC-NULL — ошибки разыменования нулевого указателя;SEC-DIV-0 — ошибки деления на ноль;SEC-MEMORY — ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти);SEC-STR-FORMAT — ошибки использования форматной строки;SEC-UNINITIALIZED — ошибки использования неинициализированных переменных;SEC-LEAKS — ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений.Все идентификаторы критических ошибок для языков C# и Java:
SEC-TAINT — ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.);SEC-OVERFLOW-OR-INT-UINT — ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел;SEC-BUF-OVERFLOW — ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти);SEC-SECURITY — ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.);SEC-SYNCHRONIZATION — ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.);SEC-NULL — ошибки разыменования нулевой ссылки [расширение: см. предыдущую главу];SEC-DIV-0 — ошибки деления на ноль [расширение: см. предыдущую главу];SEC-MEMORY — ошибки управления динамической памятью (выделения, освобождения, использования освобождённой памяти) [расширение: см. предыдущую главу];SEC-LEAKS — ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [расширение: см. предыдущую главу].Начиная с версии 7.37, в PVS-Studio появилась возможность размечать предупреждения, связанные с безопасностью. Отображение SEC-идентификаторов осуществляется следующим образом.
Включение советующих настроек в интегрированных средах разработки:
Options > PVS-Studio > Specific Analyzer Settings > Analysis > SecurityRelatedIssues.
PVS-Studio Settings > Other > Security Related Issues.
Настройка анализатора в сборочных системах через специальный параметр:
securityRelatedIssues. Подробнее в документации.<securityRelatedIssues>. Подробнее в документации.Запуск анализатора через командную строку с использованием специального флага:
pvs-studio-analyzer): --security-related-issues. Подробнее в документации.PVS-Studio_Cmd): --securityRelatedIssues. Подробнее в документации. pvs-studio.jar): --security-related-issues. Подробнее в документации.Настройка анализатора при помощи файлов конфигурации диагностик (.pvsconfig) через специальный параметр V_SEC_ID. Подробнее в документации.
В плагинах PVS-Studio для сред разработки представлен механизм быстрой фильтрации отчёта анализатора по заданным ключевым словам. Например, в Visual Studio можно открыть панель быстрой фильтрации с помощью кнопки Quick Filters на панели инструментов окна PVS-Studio.
Для того, чтобы в отчёте остались только критические ошибки, имеющие маркировку согласно ГОСТ, следует прописать префикс SEC в поле Filter SAST.
Для отображения одного конкретного типа критических ошибок следует прописать соответствующий идентификатор.
Механизм фильтрации отчёта через конвертер (plog-converter, PlogConverter.exe) осуществляется с помощью флага filterSecurityRelatedIssues. Использование такого метода фильтрации оставляет в итоговом отчёте только сообщения, имеющие маркировку по ГОСТ. Подробнее в документации.
С помощью специализированного расширения PVS-Studio для Visual Studio Code можно просматривать результаты анализа, запускать анализ CMake, MSBuild, Java, JS, TS и Go проектов, а также пользоваться мониторингом компиляции на Windows. Ниже рассмотрим, как пользоваться этим расширением.
Обратите внимание, что предварительно вам потребуется скачать и установить анализатор.
Рассмотрим возможные сценарии установки расширения.
Примечание. Минимальная поддерживаемая версия Visual Studio Code для работы с расширением — 1.100.0.
Чтобы установить расширение PVS-Studio, откройте Visual Studio Code и перейдите на вкладку Extensions, затем введите в поле поиска "PVS-Studio" и кликните по кнопке Install:

Обратите внимание, что с помощью маркетплейса устанавливается только расширение PVS-Studio для Visual Studio Code. Для его работы в системе также должен быть установлен анализатор. Скачать его можно здесь.
При установке анализатора на Windows можно выбрать пункт Integration with Visual Studio Code в меню установщика, и тогда расширение PVS-Studio добавится в Visual Studio Code автоматически при установке анализатора.

Файл расширения PVS-Studio в формате .vsix можно получить со страницы PVS-Studio в Visual Studio Marketplace.
Файл расширения pvs-studio-vscode-*.vsix распаковывается при установке анализатора (путь по умолчанию: PROGRAMFILES(x86)%\PVS-Studio для Windows, /usr/lib/pvs-studio/plugins для Linux и macOS).
Для установки расширения из такого файла необходимо во вкладке Extensions в правом верхнем углу нажать на три точки и выбрать пункт Install from VSIX:

После установки расширения окно PVS-Studio появится в качестве одной из вкладок на нижней панели Visual Studio Code. В случае, если окно PVS-Studio было скрыто, вы можете снова отобразить его с помощью команды PVS-Studio: Show window в палитре команд (Ctrl + Shift + P).

Запустить анализ можно несколькими способами:
1. С помощью кнопки Start analysis:

В этом случае будет запущен анализ всего проекта.
2. Через контекстное меню редактора кода:

В этом случае будет запущен анализ только одного файла. Обратите внимание: отсутствие данного пункта меню означает, что анализ текущего файла не поддерживается.
3. Через контекстное меню проводника:

В этом случае будут проанализированы все поддерживаемые файлы, которые были выделены. Кроме того, если среди выделенных элементов есть папка, то будут проанализированные все файлы, которые находятся в ней и её поддиректориях.
4. Через меню группы вкладок редактора:

В этом случае будут проанализированы все поддерживаемые файлы, открытые в текущей группе вкладок.
5. С помощью команд Run regular analysis и Run intermodular analysis в палитре команд (Ctrl+Shift+P)

Обе команды запускают общий анализ решения. Разница между ними имеет значение только при анализе C и C++ кода. В этом режиме анализатор выполняет более глубокий анализ, но тратит на это больше времени.
Если в открытой в VS Code-директории не найдено подходящей цели для анализа, вы получите соответствующее сообщение.
На Windows:

Для некоторых C и C++ компиляторов на Windows возможно использовать мониторинг компиляции для анализа. О том, как им пользоваться, можно прочитать здесь.
На Linux:

В ином случае вам, возможно, будет предложено настроить параметры, специфичные для анализа проектов, использующих ту или иную сборочную систему. Больше информации об анализе проекта конкретного типа можно найти в разделах документации:
В случае успешного запуска анализа окно PVS-Studio будет выглядеть так:

В правом верхнем углу окна будет отображаться прогресс анализа в процентах. Рядом с ним появится кнопка, которая прерывает анализ. Срабатывания будут появляться в таблице по мере появления.
Для запуска анализа CMake проектов необходимо установить расширение CMake Tools. Перед анализом проекта необходимо собрать его с помощью CMake Tools.
Плагин совместим со следующими генераторами для сборки проектов:
При обнаружении неподдерживаемого генератора или его отсутствии появится сообщение, предлагающее задать этот параметр в настройках CMake Tools:

При нажатии на Edit setting откроется страница с настройкой cmake.generator:

В CMake Tools можно указать предпочитаемый путь до папки с файлами сборки с помощью настройки cmake.buildDirectory (по умолчанию это /build внутри открытой папки проекта):

Данный параметр важен для анализа, поскольку в этой директории PVS-Studio будет ожидать файл compile_commands.json.
Для сборки проекта нужно нажать на кнопку Build в левой нижней части окна IDE:

Примечание. О других возможностях расширения CMake Tools можно подробнее прочитать в его документации.
Перед запуском анализа вам будет предложено выбрать его тип: межмодульный анализ (Intermodular analysis) или обычный анализ (Regular analysis). Их отличие заключается в том, что межмодульный анализ выполняется дольше, но даёт лучший результат. Подробнее про этот режим можно прочитать в документации.
При запуске анализа также учитывается содержимое папки .PVS-Studio в директории исходного кода проекта. Если в ней будут найдены пользовательские файлы конфигурации (с расширением .pvsconfig) или suppress-файлы (с суффиксом .suppress.json), то они будут переданы анализатору для дальнейшей обработки.
Примечание. На данный момент при проверке CMake проектов поддерживается работа только с одним suppress-файлом. Если при запуске будет найдено несколько файлов, то в отчёте появится соответствующая запись. В ней будет указано, какой файл используется при анализе.
При первом анализе решения вы получите уведомление о создании файла в /.PVS-Studio/MSBuildAnalyzerConfig.jsonc внутри открытой в IDE директории. В нём можно задать некоторые настройки анализа, аналогичные параметрам консольной версии анализатора.

Варианты действий:
В этом же файле вы можете указать файлы и параметры, которые будут учитываться при анализе:
.suppress.json);.pvsconfig); .csproj и .vcxproj) и файлы (.cs, .cpp и др.) для анализа; Примечание. При запуске анализа конкретных файлов через контекстные меню или меню групп вкладок редактора будут проанализированы только файлы, включённые в выбранное решение.
Если среди анализируемых файлов окажется файл проекта (с расширением .csproj или .vcxproj), то будет выполнен анализ всех поддерживаемых файлов, которые включены в этот проект.
Чтобы расширение PVS-Studio смогло определить ваш проект в открытой директории, в Visual Studio Code должно быть установлено и активировано расширение Project manager for Java.
По умолчанию расширение PVS-Studio ищет ядро анализатора в одной из следующих директорий:
C:\Users\[User]\AppData\Roaming\PVS-Studio-Java (на Windows);~/.config/PVS-Studio-Java (на Linux и macOS).Если ядро находится в другой папке, следует указать путь к ней в настройках расширения (File > Preferences > Settings > PVS-Studio: Java Projects Analyzer или настройка pvsStudio.javaProjectsAnalyzer.path).
Для запуска ядра анализатора требуется JDK 11-21 версий. По умолчанию используется JDK, путь к которому задан в переменных окружения. Если версия вашего JDK не входит в допустимый диапазон, установите поддерживаемый JDK и укажите путь в настройках Visual Studio Code (File > Preferences > Settings > PVS-Studio: Java For Running Analyzer или настройка pvsStudio.javaProjectsAnalyzer.javaPath).
Перед анализом рекомендуется выполнить команду Java: Reload Projects в палитре команд (Ctrl + Shift + P). Если после этого появится выпадающий список с модулями проекта, убедитесь, что галочкой отмечены все те, которые необходимо проанализировать:

При первом анализе проекта вы получите уведомление о создании файла в /.PVS-Studio/ JavaAnalyzerConfig.jsonc внутри открытой в IDE директории. В нём можно задать некоторые настройки анализа, аналогичные параметрам консольной версии анализатора.
Варианты действий:
В этом файле вы можете указать параметры, которые будут учитываться при анализе, например:
. suppress.json);Для анализа JavaScript и TypeScript проектов не требуется дополнительной конфигурации расширения. Достаточно запустить анализ при открытой в Visual Studio Code директории проекта, в которой находятся .js и/или .ts файлы.
Для дополнительной настройки JavaScript и TypeScript анализатора можно использовать файлы конфигурации pvs-settings.toml, о которых можно подробнее прочитать здесь.
Для анализа Go проектов не требуется дополнительной конфигурации расширения. Достаточно запустить анализ при открытой в Visual Studio Code директории проекта, в которой находятся исходный код проекта и файл go.mod или go.work.
Для дополнительной настройки Go анализатора можно использовать файлы конфигурации pvs-settings.toml, о которых можно подробнее прочитать здесь.
Обратите внимание. Расширение PVS-Studio для Visual Studio Code поддерживает только отчёты в формате JSON. В зависимости от типа проверяемого проекта и способа запуска анализа, PVS-Studio может генерировать отчёт в нескольких форматах. Чтобы отобразить отчёт в расширении, вам потребуется выполнить его преобразование в JSON-формат.
Для преобразования можно воспользоваться утилитами командной строки: PlogConverter.exe для Windows и plog-converter для Linux и macOS. Они позволяют не только конвертировать отчёт PVS-Studio в разные форматы, но и дополнительно обрабатывать его (например, проводить фильтрацию предупреждений). Подробнее можно прочитать здесь.
Пример команды конвертации отчёта PVS-Studio в JSON-формат при помощи PlogConverter.exe (Windows):
PlogConverter.exe path\to\report.plog -t json ^
-n PVS-StudioПример команды конвертации отчёта PVS-Studio в JSON-формат при помощи plog-converter (Linux и macOS):
plog-converter path/to/report/file.plog -t json \
-a ALL \
-o PVS-Studio.jsonДля просмотра отчёта в Visual Studio Code нажмите на кнопку Open report в окне PVS-Studio и выберите нужный файл. Также можно открыть отчёт, выбрав в палитре команд (Ctrl+Shift+P) PVS-Studio: Load Report:

После этого предупреждения из отчёта отобразятся в таблице:

Для удобной работы с таблицей закрепите её на панели. Для этого кликните правой кнопкой мыши на заголовке панели и выберите пункт PVS-Studio, если на нём не установлена галочка:

Для работы с отчётом, содержащим относительные пути, необходимо воспользоваться настройкой Source Tree Root. Для этого откройте окно настроек, во вкладке Other нажмите кнопку Browse и выберите директорию, относительно которой будут разворачиваться все пути в файле отчёта.

Механизмы фильтрации окна вывода PVS-Studio позволяют быстро найти и отобразить как отдельные диагностические сообщения, так и целые группы. Среди инструментов окна есть переключатели, которые позволяют включить/отключить отображение предупреждений из соответствующих им групп.
Все переключатели можно разбить на три группы:
Примечание. Детальное описание уровней достоверности предупреждений и групп диагностических правил приведено в разделе документации "Знакомство со статическим анализатором кода PVS-Studio".
Переключить видимость групп фильтраций можно с помощью соответствующих им кнопок:

Все перечисленные механизмы фильтрации предупреждений можно совмещать между собой. Например, фильтровать сообщения по уровню и группам отображаемых предупреждений, исключать сообщения, помеченные как ложные срабатывания и т. п.
При первом запуске на большом проекте анализатор может выдать много срабатываний. Менее приоритетные можно скрыть при помощи механизма подавления предупреждений.
Для подавления всех предупреждений нужно нажать кнопку Suppress All Messages в правой верхней части окна:

При её активации появится окно с вопросом, какие именно предупреждения вы хотите подавить:

При выборе нужного пункта предупреждения будут подавлены в существующий suppress-файл. Если файл отсутствует/не найден, то он будет создан в директории /.PVS-Studio внутри открытого проекта.
Если предложенный выше вариант не подходит, можно воспользоваться точечным подавлением предупреждений. Для этого необходимо выбрать нужные строки в таблице, открыть контекстное меню и выбрать Add message to suppression file:

Окно вывода результатов PVS-Studio в первую очередь предназначено для упрощения навигации по коду проекта и переходу к участкам кода, содержащим потенциальные ошибки. Двойной щелчок мыши по любому из предупреждений в списке автоматически откроет файл, на который данное сообщение указывает.
Для выделения интересных предупреждений или тех, к которым следует вернуться, можно использовать звёздочку в соответствующей колонке.
Правый клик по заголовку таблицы вызывает контекстное меню, с помощью которого можно настроить отображаемые столбцы:

Таблица поддерживает множественное выделение с помощью стандартных комбинаций Ctrl и Shift.
Контекстное меню таблицы предупреждений содержит несколько подпунктов:


Кнопки в правой части панели предназначены для запуска анализа, подавления предупреждений, сохранения отчёта, открытия нового отчёта, открытия настроек расширения. При наличии изменений в отчёте кнопка станет красной, как на скриншоте:

Для открытия окна настроек нажмите на крайнюю правую кнопку окна PVS-Studio или откройте панель команд (Ctrl+Shift+P) и введите PVS-Studio: Show Settings.
Настройки в панели разделяются на настройки расширения (Extension Settings) и настройки конкретного анализатора (Analyzer Settings):

Выбрать нужный анализатор для настройки можно с помощью выпадающего списка в правой верхней части панели настроек:

Помимо настройки через UI, также можно воспользоваться файлом конфигурации pvs-settings.toml. Подробнее о нём можно прочитать здесь.
В группе настроек Analysis можно настроить:
Для C и C++ анализатора также есть возможность включить использование старой версии парсера C++ кода.

Во вкладке Excluded paths в поле New excluded path wildcard можно ввести пути или маски путей. Сообщения, выданные на файлы, которые удовлетворяют условиям маски, не будут отображаться в таблице срабатываний.

Вкладка Diagnostics позволяет отметить, какие предупреждения должны отображаться в таблице срабатываний.
Все срабатывания разбиты на группы. Для поиска определённого диагностического правила можно воспользоваться полем Code or message.
Кнопки Check all/Uncheck all предназначены для включения/выключения отображения всех диагностик из определённой группы.
При отключении всех диагностик из группы соответствующий ей переключатель перестаёт отображаться в окне плагина.

Данная вкладка настроек позволяет выбрать необходимые версии используемых стандартов кодирования.

Для C и C++ анализатора на Windows дополнительно доступна вкладка настроек Monitoring, используемая для настройки мониторинга компиляции.
В этой вкладке в поле Wrap compilers можно ввести имена файлов компиляторов, которые необходимо отслеживать, разделив их запятой.

Во вкладке Interface можно настроить:

Во вкладке License можно ввести имя лицензии анализатора, привязанное к ключу, и лицензионный ключ из своей лицензии. Если вы ввели валидные данные, то отобразится сообщение с данными лицензии.
У плагина для VS Code есть жёсткая привязка к установленной версии анализатора. Проблема в том, что плагины обновляются автоматически по умолчанию. Это может приводит к рассинхронизации версий плагина и анализатора. Чтобы не возникало проблем в работе плагина, можно отключить его автообновление либо обновить версию анализатора PVS-Studio.
Чтобы отключить автообновление плагина в VS Code, нужно перейти в Extensions, найти плагин PVS-Studio, открыть его и убрать галочку с Auto Update.

VS Code позволяет установить необходимую версию плагина. Для этого нужно нажать на стрелку рядом с кнопкой Uninstall и в появившемся меню выбрать Install Specific Version.

После этого можно выбрать нужную версию, которая установится автоматически.

Любой статический анализатор кода работает медленнее компилятора. Это объясняется тем, что компилятор должен отработать очень быстро, пусть и в ущерб глубине анализа. Статические анализаторы вынуждены хранить дерево разбора, чтобы иметь возможность собрать большее количество информации. Хранение дерева увеличивает расход памяти, а множество проверок делает обход дерева ресурсоемкой и медленной операцией. На самом деле всё это не так критично, так как анализ более редкая операция, чем компиляция и пользователи готовы подождать. Тем не менее, всегда хочется, чтобы инструмент работал быстрее. В статье собраны рекомендации, позволяющие существенно увеличить скорость работы PVS-Studio.
Сначала перечислим коротко все рекомендации для того, чтобы пользователи сразу же могли понять, как им улучшить время работы анализатора:
Рассмотрим все эти рекомендации более подробно, с пояснениями, почему они позволяют работать быстрее.
PVS-Studio давно (с версии 3.00, вышедшей в 2009 году) поддерживает работу в несколько потоков. Распараллеливание выполняется на уровне файлов. Если анализ выполняется на четырех ядрах, то одновременно проверяется четыре файла. Такой уровень параллелизма позволяет обеспечить существенное повышение производительности. По нашим замерам разница во времени работы на тестовых проектах очень заметна. Анализ в один поток выполняется за 3 часа 11 минут, в то время как анализ в четыре потока выполняется за 1 час 11 минут (данные получены на машине с четырьмя ядрами и восемью гигабайтами оперативной памяти). Отличие в 2.7 раза.
Для каждого потока анализатора рекомендуется иметь не менее одного гигабайта оперативной памяти. В противном случае (если будет много потоков и мало оперативной памяти) будет использоваться файл подкачки, что приведет к замедлению работы. При необходимости можно ограничить количество потоков анализатора с помощью настроек PVS-Studio Options > Common Analyzer Settings > Thread Count (документация). По умолчанию запускается столько потоков, сколько ядер в системе.
Рекомендуем использовать машину с четырьмя ядрами и восемью гигабайтами оперативной памяти или мощнее.
Медленный жесткий диск, как ни странно, является очень слабым местом в работе анализатора кода. Но надо пояснить механизм работы анализатора для того, чтобы было понятно, почему это так. Для того, чтобы выполнить анализ файла, необходимо сначала его препроцессировать, т.е. раскрыть все #define, подставить все #include и т.п. Файл после препроцессинга имеет размер в среднем 10 мегабайт и записывается на диск в папку проекта. Затем уже читается анализатором и начинается его разбор. Рост файла происходит как раз за счет вставки содержимого #include-файлов, которые читаются из системных папок.
Привести конкретные результаты измерений влияния SSD на скорость анализа сложно, так как для этого надо тестировать абсолютно одинаковые машины, различающиеся лишь типом диска, однако, на глаз ускорение очень существенно.
Анализатор кода является сложной и подозрительной программой с точки зрения антивируса по характеру своей работы. Сразу оговоримся, что речь не идет о том, что анализатор распознается как вирус - мы это регулярно проверяем. Кроме того, мы используем сертификат подписи кода. Обратимся опять к описанию работы анализатора кода.
На каждый анализируемый файл запускается отдельный процесс анализатора (модуль PVS-Studio.exe). Если в проекте 3000 файлов, то столько раз и будет запущен PVS-Studio.exe. Для своей работы PVS-Studio.exe вызывает настройку переменных окружения Visual C++ (файлы vcvars*.bat). Также во время работы создается большое количество препроцессированных файлов (*.i), по одному на каждый компилируемый файл. Используются вспомогательные командные (.cmd) файлы.
Все это хоть и не является вирусной активностью, тем не менее, заставляет любой антивирус тратить большое количество ресурсов на бесполезную проверку одного и того же.
Мы рекомендуем сделать следующие исключения в настройках антивируса:
cl.exe (разных версий):Возможно, приведенный список избыточен, но он дан именно в таком виде для того, чтобы можно было вне зависимости от конкретного антивируса указать, какие файлы и процессы проверять не надо.
Иногда, может быть, антивирус вообще не используется на машине (например, на специальном компьютере для сборок и запуска анализатора кода). В этом случае скорость работы будет наибольшая. Так как даже если в антивирусе указаны перечисленные выше исключения, на их проверку все равно будет тратиться время.
Наши тестовые измерения показывают, что агрессивно настроенный антивирус может давать замедление работы анализатора кода в два и более раз.
Для препроцессирования файлов в PVS-Studio используется внешний препроцессор. В среде Visual Studio по умолчанию используется нативный препроцессор Microsoft Visual C++ — cl.exe. В PVS-Studio 4.50 появилась поддержка второго независимого препроцессора Clang, который лишен ряда недостатков препроцессора от Microsoft (хотя и имеет свои недостатки).
В некоторых старых версия Visual Studio (2010 и 2012), препроцессор cl.exe работает значительно медленнее, чем clang. Использование препроцессора Clang в этих средах позволяет повысить скорость работы в 1.5–1.7 раз.
Однако, здесь есть нюанс, который надо учитывать. Указать используемый препроцессор можно в настройках PVS-Studio Options > Common Analyzer Settings > Preprocessor (документация). Доступны варианты: VisualCPP, Clang и VisualCPPAfterClang. Первые два варианта очевидны, а третий вариант означает, что сначала будет использоваться Clang. В случае, если при препроцессировании будут ошибки, то затем файл будет заново препроцессирован с помощью Visual C++.
Если ваш проект проверяется без проблем с помощью Clang, то вы можете использовать стандартное значение VisualCPPAfterClang или Clang — без разницы. Однако, если ваш проект может быть проверен только с помощью Visual C++, рекомендуем указать именно это значение, чтобы анализатор не запускал напрасно Clang в попытках препроцессировать им.
Любой крупный программный проект использует много сторонних библиотек, таких как zlib, libjpeg, Boost и др. Иногда эти библиотеки собираются отдельно, и тогда в основном проекте доступны только заголовочные и библиотечные (lib) файлы. А иногда библиотеки очень плотно интегрированы в проект, фактически становясь его частью. В этом случае при компиляции основного проекта компилируются также и файлы с кодом от этих библиотек.
Анализатору PVS-Studio можно указать, чтобы он не проверял код сторонних библиотек. Ведь даже если там и будут найдены какие-то ошибки, то, скорее всего, вы их править не станете. Но исключая из анализа такие папки можно существенно увеличить общую скорость анализа.
Также есть смысл исключить из анализа код, который долгое время не будет гарантированно меняться.
Для того чтобы исключить из анализа какие-то папки или отдельные файлы, используйте настройки PVS-Studio -> Don't Check Files (документация).
Для исключения папок можно указать в списке папок либо одну общую папку вроде c:\external-libs, либо явно перечислить некоторые из них: c:\external-libs\zlib, c:\external-libs\libjpeg и т.д. Можно указывать полный путь, относительный путь или маску. Например, достаточно указать zlib и libjpeg в списке папок - это автоматически будет трактоваться как папка с маской *zlib* и *libjpeg*. Подробнее смотрите в документации.
При работе в WSL (Windows Subsystem for Linux) рекомендуется размещать исходный код и артефакты сборки внутри файловой системы дистрибутива, например в ~/src. Не используйте каталоги Windows, смонтированные в WSL как /mnt/c, /mnt/d и т. п.
Доступ к файловой системе Windows из WSL выполняется через промежуточный слой, который добавляет накладные расходы на файловые операции и существенно увеличивает задержки, особенно при обработке большого количества небольших файлов. Это напрямую влияет на скорость статического анализа, сборки и индексирования.
Перечислим еще раз способы повысить скорость работы PVS-Studio:
~/...), а не в смонтированных каталогах Windows (/mnt/c, /mnt/d), чтобы избежать существенных задержек из‑за промежуточного слоя доступа к файлам.Наибольший эффект достигается при одновременном применении наибольшего числа из этих рекомендаций.
В PVS-Studio можно выделить 2 главных компонента: command-line анализатор PVS-Studio.exe и IDE плагин, интегрирующий этот command-line анализатор в одну из поддерживаемых сред разработки (Microsoft Visual Studio). При этом сам command-line анализатор по принципу своей работы очень схож с компилятором — он вызывается для каждого из проверяемых файлов с параметрами, включающими в себя, в том числе, и оригинальные параметры компиляции этого файла. Затем анализатор вызывает необходимый ему препроцессор (опять, в соответствии с препроцессором, используемым при компиляции проверяемого файла) и производит непосредственный анализ полученного препроцессированного временного файла, т.е. файла, в котором раскрыты все include и define директивы.
Таким образом, command-line анализатор, как, впрочем, и компилятор (например, компилятор Visual C++ cl.exe), не предназначен для непосредственного использования конечным пользователем. Продолжая аналогию, компиляторы используются в большинстве случаев не напрямую, а с помощью специальной сборочной системы. Такая система подготавливает параметры запуска для каждого из собираемых файлов, а также, обычно, осуществляет распараллеливание самой сборки по имеющимся логическим процессорам для оптимизации затрачиваемого времени. Аналогом как раз такой сборочной системы для конечного пользователя и выступает IDE плагин PVS-Studio.
Но использование анализатора PVS-Studio.exe не ограничивается IDE плагинами. Как уже было сказано выше, command-line анализатор очень близок в своём использовании непосредственно к компилятору. Соответственно, его вызов можно встроить, при необходимости, и напрямую в сборочную систему, наравне с самим компилятором. Такой вариант может оказаться полезным при использовании для сборки не поддерживаемого нами сценария, такого как, например, custom-made сборочная система или IDE, отличная от Visual Studio. Заметьте, что PVS-Studio.exe поддерживает проверку исходных файлов, предназначенных для компиляторов gcc, clang и cl (включая специфические ключевые слова и конструкции).
Помимо IDE плагинов в дистрибутиве мы предоставляем также плагин для сборочной системы Microsoft MSBuild, которая используется для сборки Visual C++ проектах в IDE Visual Studio, начиная с версии 2010. Но, не стоит путать этот плагин с IDE плагином для Visual Studio!
Таким образом, проекты в Visual Studio (2010 версии и выше), можно проверить двумя различными способами: напрямую через наш IDE плагин, либо интегрировав проверку в сборочную систему (MSBuild плагин). Но ничто не мешает вам, при необходимости, написать и свой плагин для вызова статического анализа, как для MSBuild, так и для любой другой сборочной системы, либо даже встроить вызов PVS-Studio.exe напрямую, если это возможно, как в случае с make сборочными сценариями.
Если PVS-Studio выдаёт для вашего файла сообщение вида "C/C++ код не найден", убедитесь, что файл, который вы пытаетесь проверить, включён в сборочный проект (исключённые из сборки файлы PVS-Studio игнорирует). Если вы получаете такое сообщение на всём проекте, убедитесь, что ваш проект является C/C++ проектом поддерживаемого типа. В Visual Studio поддерживаются только Visual C++ проекты для версий 2005 и выше, и соответствующие им Platform Toolset. Проверка расширений проектов, использующих другие компиляторы (например, проекты для компилятора C++ от Intel) или параметры (Windows DDK драйверы) не поддерживается. Несмотря на то, что сам command-line анализатор PVS-Studio.exe поддерживает проверку файлов для компиляторов gcc/clang, проектные расширения IDE, использующие данные компиляторы, не поддерживаются.
Если ваш случай не подходит под описанное выше, вы можете обратиться в нашу поддержку. По возможности, предоставьте нам временные конфигурационные файлы для проблемных файлов. Их можно получить, переключив настройку PVS-Studio -> Options -> Common Analyzer Settings -> Remove Intermediate Files в False, файлы с именем вида %SourceFilename.cpp%.PVS-Studio.cfg должны появиться в той же директории, где лежит проектный файл (.vcxproj). Если это возможно, создайте пустой тестовый проект, на котором будет повторяться ваша проблема, и также пришлите его нам.
Если после проверки вашего файла\проекта PVS-Studio выдаёт в окне отчёта сообщения с кодом V008 и\или сообщения об ошибке от препроцессора (clang/cl), удостоверьтесь, что файл(ы), который вы пытаетесь проверять, компилируются без ошибок. Для работы анализатора PVS-Studio требуются корректно компилируемые исходные C/C++ файлы. Ошибки линковки же для работы анализатора не имеют значения.
Ошибка V008 означает, что отработавший препроцессор вернул ненулевой код. Обычно сообщение V008 сопровождается сообщением от самого препроцессора о причине ошибки (например, не найден include файл). Заметьте, что в IDE Visual Studio наш плагин, для оптимизации времени работы, использует специальный режим дуального препроцессирования: сначала файл будет препроцессирован с помощью более быстрого препроцессора clang, а в случае ошибки препроцессирования (clang не поддерживает некоторые специфичные для Visual C++ конструкции) будет запущен стандартный препроцессор cl.exe. Если у вас возникают ошибки препроцессирования clang, вы можете попробовать переключить IDE плагин на постоянное использование одного препроцессора (настройка PVS-Studio -> Options -> Common Analyzer Settings -> Preprocessor).
Иногда V008 может возникать из-за слишком длинных путей к исходным файлам. Если вы используете Windows, то можете попробовать увеличить максимальное значение длины путей. Как это сделать описано вот тут.
Если вы уверены, что ваш файл корректно собирается в IDE/сборочной системе, то, возможно, какие-то из его параметров компиляции некорректно передаются в анализатор PVS-Studio.exe. В таком случае отправьте, пожалуйста, в нашу поддержку временные конфигурационные файлы для этих файлов, а также текст сообщения из лога PVS-Studio. Временные конфигурационные файлы можно получить, переключив настройку PVS-Studio -> Options -> Common Analyzer Settings -> Remove Intermediate Files в False, файлы с именем вида %SourceFilename.cpp%.PVS-Studio.cfg должны появиться в той же директории, где лежит проектный файл (.vcxproj). Если это возможно, создайте пустой тестовый проект, на котором будет повторяться ваша проблема, и также пришлите его нам.
Если вы столкнулись с аварийной остановкой работы плагина с выдачей диалога PVS-Studio Internal Error, пришлите, пожалуйста, в нашу поддержку стек работы анализатора, который можно скопировать из данного диалогового окна.
Если вам удаётся стабильно повторить ошибку, то помимо стека падения пришлите нам лог трассировки работы плагина. Его можно получить, включив режим трассировки в настройках PVS-Studio -> Options -> Specific Analyzer Settings -> TraceMode (режим Verbose). Лог трассировки будет сохранён в стандартную пользовательскую директорию Application Data\Roaming\PVS-Studio с именем PVSTracexxxx_yyy.log, где xxxx- PID процесса devenv.exe / bds.exe, yyy - номер лога для данного процесса.
Если вы наблюдаете систематическое падение вашей среды разработки, предположительно вызванное работой PVS-Studio, проверьте, пожалуйста, системные event логи Windows (Event Viewer) и пришлите в нашу поддержку сигнатуру и стек падения (при наличии) для приложения devenv.exe \ bds.exe (уровень сообщения Error), доступные в списке Windows Logs -> Application.
Если вы наблюдаете систематическое необработанное падение анализатора PVS-Studio.exe, то просим вас повторить шаги, описанные в пункте "Падение IDE при использовании PVS-Studio", только для процесса PVS-Studio.exe.
Ошибка V003 означает, что файл не был проверен анализатором PVS-Studio.exe из-за обработанного внутреннего исключения. Если вы видите в логе анализатора ошибки с кодом V003, просим вас прислать нам временный файл препроцессора (i-файл, содержащий все раскрытые include и define директивы) для файла, который вызывает ошибку v003 (можно посмотреть имя в поле file). Получить такой файл можно, переключив настройку PVS-Studio -> Options -> Common Analyzer Settings -> Remove Intermediate Files в False. Intermediate файлы с именами вида SourceFileName.i будут появляться после перезапуска анализа в директории проверяемого проекта (т.е. директории, где находятся файлы vcproj/vcxproj/cbproj и т.п.).
Также, анализатор не всегда может полностью проанализировать файл с исходным кодом. Это не всегда происходит по вине PVS-Studio и подробнее с причинами можно ознакомиться в документации для ошибки V001. Независимо от причины выдачи сообщения V001, это сообщение не критично. Как правило, неполный разбор файла несущественен с точки зрения анализа. PVS-Studio просто пропускает функцию/класс с ошибкой и продолжает анализ файла. Непроанализированным остается совсем небольшой участок кода. Если же данный участок содержит критичные для вас фрагменты, вы можете также прислать нам i-файл, полученный для данного исходного файла.
Если вам кажется, что анализатор не находит ошибки во фрагменте вашего кода, содержащем её, или же, наоборот, анализатор генерирует ложные срабатывания для фрагмента кода, который, по вашему мнению, корректен, просим вас прислать нам временный файл препроцессора. Получить такой файл можно, переключив настройку PVS-Studio -> Options -> Common Analyzer Settings -> Remove Intermediate Files в False. Intermediate файлы с именами вида SourceFileName.i будут появляться после перезапуска анализа в директории проверяемого проекта (т.е. директории, где находятся файлы vcproj/vcxproj/cbproj и т.п.). Также включите в ваше письмо фрагмент кода из исходного файла, который вызывает проблемы.
Мы обязательно рассмотрим возможность реализации диагностики вашего примера, либо правки имеющихся диагностик для уменьшения числа ложных срабатываний в вашем коде.
Если вы столкнулись с проблемами при работе с отчётом PVS-Studio из окна нашего IDE плагина, а именно: некорректно осуществляется навигация по проверенным исходным файлам и\или файлы вообще не открываются для навигации, происходит некорректная разметка вашего кода маркерами ложных срабатываний или комментариями и т.п. В таком случае просим вас прислать в поддержку лог трассировки работы плагина. Его можно получить, включив режим трассировки в настройках PVS-Studio -> Options -> Specific Analyzer Settings -> TraceMode (режим Verbose). Лог трассировки будет сохранён в стандартную пользовательскую директорию Application Data\Roaming\PVS-Studio с именем PVSTracexxxx_yyy.log, где xxxx- PID процесса devenv.exe /bds.exe, yyy - номер лога для данного процесса.
Также, если это возможно, создайте пустой тестовый проект, на котором будет повторяться ваша проблема, и тоже пришлите его нам.
IDE плагин PVS-Studio способен распараллеливать анализ кода на уровне проверяемых файлов, т.е. возможен параллельный запуск проверки для любых проверяемых файлов, даже внутри одного проекта. По умолчанию плагин устанавливает количество потоков для проверки в соответствии с количеством процессоров в системе. Изменить количество параллельно запускаемых анализаторов можно с помощью настройки PVS-Studio -> Options -> Common Analyzer Settings -> ThreadCount.
Если вам кажется, что не все логические процессоры вашей системы достаточно загружены, вы можете увеличить количество параллельных потоков для анализа. Однако следует учитывать, что статический анализ, в отличие от компиляции, более требователен к ресурсам основной памяти системы: на каждый экземпляр анализатора требуется примерно 1.5 гигабайта памяти.
Если ваша система, даже при наличии многоядерного процессора, не удовлетворяет данным требованиям, возможно резкое проседание производительности анализатора, вызываемое необходимостью задействования файла подкачки. В таком случае мы рекомендуем снизить количество параллельных потоков анализатора до удовлетворения требования в 1.5 гигабайта на поток, даже если это значение будет ниже количества ядер в системе.
Следует учитывать, что при большом количестве параллельных потоков, узким местом может стать жесткий диск, где создаются временные препроцессированные *.i файлы. Иногда размер этих файлов достаточно велик. Одним из способов существенно уменьшить время анализа является использование SSD дисков или RAID массива.
Падение производительности возможно также и при использовании ненастроенного антивирусного ПО. В связи с тем, что плагин PVS-Studio запускает множество экземпляров анализатора и интерпретатора командной строки cmd.exe, антивирус может находить такое поведение подозрительным. Для оптимизации времени выполнения анализа мы рекомендуем добавлять PVS-Studio.exe, а также все соответствующие директории в исключения вашего антивируса, либо отключать real-time защиту на время выполнения анализа.
Если же вы используете антивирус Security Essentials (ставший частью Windows Defender начиная с Windows 8), то возможно резкое падение производительности анализа для некоторых проектов/настроек. Вы можете ознакомиться с соответствующей статьёй нашего блога для более подробного разъяснения причин этого явления.
Не проверяются проекты, выключенные в общей сборке через окно Configuration Manager среды Visual Studio.
Для корректного анализа C или C++ проектов с помощью статического анализатора PVS-Studio эти проекты должны быть компилируемы в Visual C++ и собираться без ошибок. Поэтому при проверке группы проектов или отдельного проекта PVS-Studio произведёт анализ только для проектов, включённых в общую сборку.
Не включённые в сборку проекты будут пропущены. Если ни один из имеющихся проектов не включён в сборку, либо если выбрана проверка одного не включённого в сборку проекта, будет выдано сообщение "Files with C or C++ source code for analysis not found" и анализ не будет запущен. Посмотреть, какие проекты включены, а какие выключены в общей сборке можно с помощью окна Configuration Manager для текущего решения Visual Studio.
Если при проверке анализатором проекта, который компилируется в Visual Studio без ошибок, на некоторых файлах возникают ошибки, связанные с ненайденными заголовочными файлами, некорректно заданными флагами компиляции (например, флаг /MD) или макросами препроцессора, то возможно, что такое поведение является проявлением проблемы с некорректно подставленными при препроцессировании файлами, используемыми для создания предкомпилированных заголовков.
Такая проблема возникает из-за различий в поведении компилятора Visual C++ (cl.exe) в режимах компиляции и препроцессирования. При обычной сборке компилятор работает в "стандартном" режиме компиляции (т.е. результатом его работы являются объектные, бинарные файлы). Однако, для осуществления статического анализа, PVS-Studio запускает компилятор в режиме препроцессора. В таком режиме компилятор осуществляет раскрытие директив подстановки и макросов.
Но, если компилируемый файл использует предкомпилированный заголовок, компилятор не будет использовать сам заголовочный файл, когда он встретится в директиве #include. Вместо этого компилятор возьмёт заранее предкомпилированный pch файл. Однако, в режиме препроцессирования компилятор проигнорирует факт наличия предкомпилированного pch, и попробует раскрыть такой #include "обычным способом", т.е. вставив содержимое самого заголовочного файла.
Очень часто в рамках одного решения Visual Studio сразу несколько проектов используют предкомпилированные заголовки с одинаковыми именами (чаще всего это stdafx.h). Это зачастую может приводить к тому, что, из-за описанного выше различия в поведении компилятора, препроцессор включает в файл предкомпилированный заголовок, относящийся к другому проекту. Это может случиться по разным причинам. Например, файлу корректно указан необходимый pch, но в списке Include директорий содержатся несколько путей, содержащих несколько разных stdafx.h, и неправильная версия оказывается в приоритете для включения (т.е. путь до её директории встретится первым в строке запуска компилятора). Ещё один возможный сценарий - несколько проектов содержат один и тот же C++ файл. Этот файл собирается с разными параметрами в разных проектах и использует, соответственно, разные pch. Но такой файл физически лежит в одном месте, и рядом с ним лежит stdafx.h от одного из проектов, в который он включен. Если же в этот файл stdafx.h включён через директиву #include, использующую кавычки, то препроцессор всегда будет отдавать при включении приоритет файлу из текущей директории, какие бы пути и в каком бы порядке не были указаны в его Include'ах.
Включение неправильного файла предкомпилированных заголовков не всегда будет приводить к ошибке препроцессирования. Однако, если, например, один из проектов использует MFC, а другой не использует, или проекты используют разные наборы Include'ов, файлы предкомпилированных заголовков окажутся несовместимыми и возникнет ошибка - статический анализ для такого файла работать не будет.
К сожалению, со стороны анализатора нет возможности как-либо обойти подобную проблему, т.к. она связана с поведением препроцессора cl.exe. Если вы столкнулись с ней на одном из ваших проектов, вы можете решить её одним из следующих способов, в зависимости от причины её возникновения.
Если файл предкомпилированных заголовков некорректно подхватывается из-за того, что include с путём до его директории передан в командной строке компилятора раньше пути до корректной директории, вы можете просто разместить путь до корректной директории самым первым в списке Include'ов.
Если же некорректный файл предкомпилированных заголовков подхватился из-за нахождения его в одной директории с использующим его исходным файлом, вы можете использовать для его включения директиву #include с угловыми скобками, например:
#include <stdafx.h>При такой форме записи компилятор будет игнорировать файлы из текущей директории при подстановке.
При проверке крупных (более 1000 файлов) проектов в PVS-Studio на операционной системе Windows 8 с использованием Visual Studio 2010 или более поздних версий возможно возникновение ошибок вида 'Library not registered' или остановка анализа в произвольный момент с сообщением 'PVS-Studio is unable to continue due to IDE being busy'.
Подобные ошибки могут возникать из-за нескольких причин: некорректно завершённый процесс установки среды Visual Studio или конфликты совместимости нескольких разных версий среды, установленных в системе. Даже если в вашей системе установлена только одна версия среды Visual Studio, но была раньше установлена и затем удалена другая версия IDE, есть вероятность, что удаление предыдущей версии прошло некорректно. В частности, конфликт совместимости может возникнуть, если в вашей системе установлены одновременно одна из Visual Studio 2010\2012\2013\2015\2017\2019\2022 и Visual Studio 2005 и\или 2008.
К сожалению, PVS-Studio не может самостоятельно обойти подобные ошибки, т.к. они вызваны конфликтами в COM интерфейсах, используемых в API среды Visual Studio. Если вы столкнулись с подобной проблемой, вы можете решить её несколькими способами. Использование PVS-Studio на системе с "чистой" установкой Visual Studio одной версии должно решить данную проблему. Если это невозможно, вы можете попробовать проверить ваш проект частями, в несколько заходов. Также следует заметить, что описанная ошибка возникает обычно в ситуации, когда помимо непосредственной работы анализатора PVS-Studio, IDE выполняет в фоновом режиме ещё какую-либо операцию (например, разбор #include директив системой автодополнения IntelliSense). Если вы дождётесь завершения этой операции перед запуском анализатора, это, возможно, позволит вам проверить проект полностью.
Вы также можете воспользоваться альтернативными способами запуска анализатора для проверки ваших файлов. Например, проверить любой проект с помощью режима отслеживания запусков компилятора из приложения C and C++ Compiler Monitoring UI (Standalone.exe).
К сожалению, из-за особенностей реализации механизма расширений для среды Visual Studio, PVS-Studio не может автоматически "подхватить" вновь установленную версию Visual Studio, если сама инсталляция новой версии запускалась после инсталляции PVS-Studio.
Приведём пример. Предположим, что перед установкой PVS-Studio на машине присутствовала только Visual Studio 2013. После установки анализатора, в меню Visual Studio 2013 появится пункт 'PVS-Studio' (если была выбрана соответствующая опция установщика), который позволит проверять ваши проекты в этой IDE. Теперь если на этой же машине установить Visual Studio 2015 (уже после того, как была установлена PVS-Studio), меню этой версии среды не будет содержать пункта 'PVS-Studio'.
Для того, чтобы добавить во вновь установленную IDE интеграцию анализатора, необходимо перезапустить инсталлятор PVS-Studio (файл PVS-Studio_Setup.exe). Если у вас не осталось этого файла, вы можете скачать его с нашего сайта. На странице выбора версий Visual Studio в инсталляторе, checkbox напротив нужной вам версии должен стать доступен для выбора после установки соответствующей ему версии IDE.
Причины возникновения проблемы и способы её решения описаны в отдельной заметке.
Иногда PVS-Studio может некорректно производить расчёт нужной для анализа версии Visual Studio. Это может приводить к аварийному завершению работы анализатора с различными ошибками.
Пример ошибки:
Can't reevaluate project MyProj.vcxproj with parameters: Project ToolsVersion 'Current'; PlatformToolset 'v142'. Previous evaluation error: 'The imported project "C:\Program Files (x86)\Microsoft Visual Studio\2019\Community\MSBuild\Microsoft\VC\v170\Microsoft.Cpp.Default.props" was not found.
Как видно из сообщения, PVS-Studio неправильно сформировал путь до Microsoft.Cpp.Default.props. Жирным шрифтом выделен некорректный фрагмент. v170 используется для Visual Studio 2022. В данном случае требуется Visual Studio 2019, а следовательно, корректным фрагментом является v160.
Данная проблема может появляться по множеству причин. Вот некоторые из них:
С решением проблем может помочь установка корректного значения переменной окружения VisualStudioVersion. Например, Visual Studio 2019 соответствует значение 16.0, а Visual Studio 2022 – 17.0.
Ошибка маловероятна при использовании плагина для Visual Studio, так как при запуске анализа из IDE нужное значение записывается в VisualStudioVersion автоматически.
Проблему нехватки памяти можно решить увеличением доступного объема памяти и стека.
В плагине для Maven:
<jvmArguments>-Xmx4096m, -Xss256m</jvmArguments>
В плагине для Gradle:
jvmArguments = ["-Xmx4096m", "-Xss256m"]
В плагине для IntelliJ IDEA:
1) Analyze -> PVS-Studio -> Settings
2) Вкладка Environment -> JVM arguments
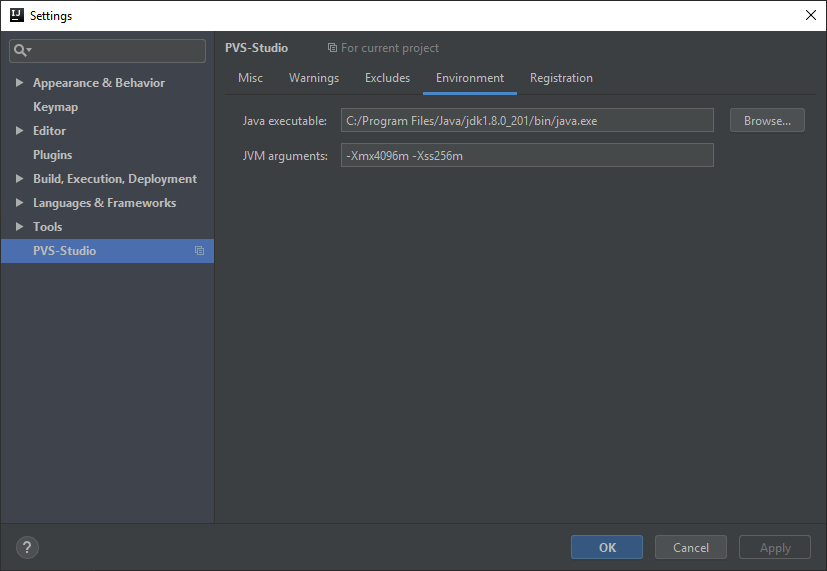
Обычно объема памяти по умолчанию может не хватать при анализе сгенерированного кода с большим количеством вложенных конструкций.
Возможно, стоит исключить этот код из анализа (с помощью exclude), чтобы не тратить на него лишнее время.
В случае если не удается запустить анализ, пожалуйста, напишите нам в поддержку и приложите *.json файлы из директории .PVS-Studio (находится в директории с проектом).
На текущий момент доступно только для утилит pvs-studio-analyzer и PVS-Studio_Cmd.
Диагностическое логирование предназначено для быстрого сбора воспроизводимой информации о запуске анализатора: фактические параметры, окружение, результат выполнения, а также сведения о том, какие файлы были проанализированы или пропущены.
Результат сохраняется в виде структурированного лога (JSON), который удобен для чтения, автоматической обработки и передачи в техническую поддержку.
Если вы столкнулись с проблемами в работе анализатора (падениями, некорректными завершениями работы и прочими ситуациями, которые мешают вам использовать PVS-Studio), то при обращении в техническую поддержку стоит прикрепить полученные логи. Обратиться в техническую поддержку можно через форму на сайте.
Структурированный лог — текстовый файл, содержащий диагностическую информацию в формате JSON. Пригоден для машинной обработки.
Сырой лог — текстовый файл с промежуточной информацией, из которого формируется структурированный лог. Имеет суффикс *-raw.PVS-Studio.log. Не предназначен для использования при самостоятельной диагностике проблем.
Анализатор (frontend) — pvs-studio-analyzer (CompileCommandsAnalyzer) и PVS-Studio_Cmd;
Исполнитель (анализа; запускается анализатором) — pvs-studio.
Рекомендуется включать диагностическое логирование, если:
1) Запуск анализа с формированием структурированного лога:
# Для pvs-studio-analyzer (CompileCommandsAnalyzer):
pvs-studio-analyzer analyze <ваши_обычные_флаги_анализа> \
--enable-logging ./pvs-diag.json
# Для PVS-Studio_Cmd:
PVS-Studio_Cmd <ваши_обычные_флаги_анализа> \
--enable-logging ./pvs-diag.jsonПосле выполнения появятся:
./pvs-diag.json;./*-raw.PVS-Studio.log.2) Если структурированный лог не сформировался (из-за какой-либо ошибки), то конвертацию можно запустить вручную:
pvs-diag-collector convert --input ./pvs-diag-raw.PVS-Studio.log \
--output ./pvs-diag.jsonpvs-diag-collector или отправить в поддержку.--enable-logging <file_path> — обязательный флаг для включения логирования и сохранения структурированного JSON-лога в указанный файл.
Опции логирования
Опции задаются флагом --logging-options <option1,option2,...>. Значения передаются через запятую, без пробелов.
Корректно:
--logging-options skip-sensitive,dump-intermediate-filesНекорректно:
--logging-options skip-sensitive, dump-intermediate-filesДоступные опции:
|
N п/п |
Опция |
Описание |
|---|---|---|
|
1 |
|
Минимизирует и частично маскирует чувствительные данные в логах (например, значения переменных окружения и некоторые артефакты — в зависимости от сценария анализа) |
|
2 |
|
Сохраняет промежуточные файлы после анализа (например, препроцессированные |
|
3 |
|
Добавляет в структурированный лог расширенную информацию о выполненных запусках исполнителей (если они доступны в собранных данных) |
Примеры:
# Для pvs-studio-analyzer (CompileCommandsAnalyzer):
pvs-studio-analyzer analyze <ваши_обычные_флаги> \
--enable-logging ./pvs-diag.json \
--logging-options skip-sensitive,dump-intermediate-files,embed-runs
# Для PVS-Studio_Cmd:
PVS-Studio_Cmd <ваши_обычные_флаги> \
--enable-logging ./pvs-diag.json \
--logging-options skip-sensitive,dump-intermediate-files,embed-runspvs-diag-collector — это утилита для сбора/обработки логов и сопутствующих артефактов работы анализатора PVS-Studio.
Команда convert утилиты pvs-diag-collector преобразует сырой лог анализатора (*-raw.PVS-Studio.log) в структурированный.
При обычном сценарии работы эти действия выполняются анализатором автоматически.
Использование
pvs-diag-collector.exe convert [FILE] [-i <FILE>] [-o <FILE>]
[--embed-runs] [-j <NUM>]Опции утилиты
|
N п/п |
Опция |
Описание |
|---|---|---|
|
1 |
|
Путь до входного сырого лога. |
|
2 |
|
Путь до выходного структурированного лога. Если опция не указана, то результат выводится в |
|
3 |
|
Добавляет в структурированный лог расширенную информацию о выполненных запусках исполнителей (если они доступны в собранных данных). |
|
4 |
|
Количество потоков (по умолчанию 1). При использовании без аргументов или со значением |
Примеры
# Вывод в файл с подробными сведениями о запусках исполнителей
pvs-diag-collector convert --input ./pvs-diag-raw.PVS-Studio.log \
--output ./pvs-diag.json \
-–embed-runs
# Вывод в файл
pvs-diag-collector convert --input ./pvs-diag-raw.PVS-Studio.log \
--output ./pvs-diag.json
# Вывод в консоль
pvs-diag-collector convert --input ./pvs-diag-raw.PVS-Studio.logКоды возврата
0 — успех;1 — ошибка (также будет выведен текст ошибки).Ниже описаны основные поля и подсказки для типовых проблем. Полное описание всех полей находится в JSON schema (см. раздел про просмотр в редакторе).
Обычно полезно начать с:
basicPerformance — время и память;configuration — фактические настройки работы анализатора;environment — ОС/платформа/переменные окружения;input — фактические аргументы запуска, используемые настройки и конфигурации;output — код возврата, stdout/stderr, признаки проблем;runs — какие файлы анализировались/пропускались/завершились с ошибкой.utility — какая утилита сформировала лог, её версия и путь до неё.В процессе конвертации сырых логов анализаторов могут детектироваться "аномалии" — это подсказки о потенциальных проблемах (например, наличие вывода в stderr, неуспешные статусы, несоответствие версий и т.п.).
Их следует искать в output.anomalies.
Аномалия — не всегда ошибка, но почти всегда полезный сигнал для проверки и обращения к технической поддержке.
В данном разделе указаны типовые сценарии использования логирования и наиболее вероятные поля лога, на которые стоит обратить внимание.
Анализ завершился ошибкой / аварийно
output.returnCodeoutput.stderr и output.stdoutoutput.anomalies (если присутствуют)Файл не попал в анализ (пропущен)
runs.skipped[]runs.skipped[].sourceFilePathruns.skipped[].skipReasoninputНужно подтвердить фактическую конфигурацию запуска
input.argumentsconfigurationruns.executed[].stages.analysis.details разделы итоговой конфигурации в логах исполнителяПроблема с производительностью
basicPerformance.elapsedTimebasicPerformance.peakMemoryConsumptionСтруктурированный лог содержит поле $schema. Если редактор может получить JSON schema, он будет:
Рекомендуемый сценарий
$schema доступно (в корпоративной сети/интернете — согласно вашей политике). Если файл по указанной ссылке недоступен, то вы можете изменить ссылку на тот же файл в дистрибутиве анализатора.$schema ограничен корпоративной политикой, обычно помогает публикация схем на внутреннем артефакт-сервере (intranet) или установка схем локально с сопоставлением в настройках VS Code (параметр json.schemas). Также вы можете изменить ссылку на тот же файл в дистрибутиве анализатора.Ссылки на эти файлы вписываются в поле $schema каждого структурированного лога. Если по какой-то причине вы не можете получить к ним доступ локально, то можете воспользоваться ссылками ниже:
Диагностические логи могут содержать информацию, которая относится к конфиденциальной:
Если для вас критична передача такой информации, то рекомендуем использовать --logging-options skip-sensitive (минимизирует и частично маскирует чувствительные данные в логах), а также:
Рекомендуемый комплект:
*.json), указанный в --enable-logging;*.PVS-Studio.i), относящиеся к проблемному файлу (появятся после указания опции --dump-intermediate-files);*.PVS-Studio.cfg), относящиеся к проблемному файлу (появятся после указания опции --dump-intermediate-files);*.PVS-Studio.stacktrace.txt);Структурированный лог анализатора
Сохраняется точно по пути, который вы указали в --enable-logging.
Структурированный лог исполнителей
Не создаётся, встраивается в структурированный лог анализатора при указании опции embed-runs.
Сырой лог анализатора
Сохраняется в той же директории, что файл из --enable-logging, но с суффиксом *-raw.PVS-Studio.log.
Сырой лог исполнителя
Сырые логи исполнителей сохраняются рядом с анализируемыми исходными файлами. Их общий признак — имя файла заканчивается на *-raw.PVS-Studio.log.
Как найти все сырые логи в проекте
Linux/macOS (bash):
find <папка_проекта> -name '*-raw.PVS-Studio.log'Windows PowerShell:
Get-ChildItem -Path <папка_проекта> -Recurse -Filter "*-raw.PVS-Studio.log"Да, все файлы являются текстовыми. Вы можете открыть любой из них и посмотреть содержимое.
Найдите сырой лог анализатора рядом с путём --enable-logging.
Запустите конвертацию вручную:
pvs-diag-collector convert --input <путь_к_сырому_логу> --output ./pvs-diag.jsonЕсли конвертация не удаётся — отправьте сырой лог в поддержку.
По умолчанию временные файлы и сырые логи удаляются по завершении анализа. Сырые логи сохраняются (не удаляются), если выполняется хотя бы одно из условий:
--logging-options dump-intermediate-files;Практическое следствие: даже при падении у вас, как правило, остаются сырые логи, которые можно сконвертировать или отправить в поддержку в исходном виде.
Да. Структурированный лог — валидный JSON, пригодный для парсинга.
Если нужно интегрировать конвертацию в пайплайн, используйте pvs-diag-collector convert и проверяйте код возврата (0/1).
Откройте JSON в VS Code: наличие $schema позволяет видеть подсказки по полям и допустимым значениям. Это ускоряет навигацию и снижает риск ошибок при интерпретации.
Пользовательские аннотации представляют собой комментарии специального вида, которые можно указать в исходном коде для дополнительной настройки диагностических правил. Аннотация может быть расположена в одном из следующих мест:
Далее представлен список пользовательских аннотаций для изменения поведения диагностических правил. Этот функционал доступен только для С и C++ анализатора. При проверке проектов, написанных на других языках, описанные здесь аннотации будут игнорироваться.
Примечание. По умолчанию пользовательские аннотации не применяются к виртуальным функциям. О том, как включить данный функционал, вы можете прочитать здесь.
Если ваш проект основан на игровом движке Unreal Engine, то анализатор также применяет ряд диагностических правил (например, V1100, V1102), находящих характерные UE-проектам ошибки. Диагностические правила активируются лишь тогда, когда анализатор обнаруживает включение заголовочных файлов из директории с исходным кодом UE.
Если в проекте присутствуют компилируемые файлы, которые не включают такие заголовочные файлы, то диагностические правила не применяются даже если они включены. Это сделано для того, чтобы не генерировать нерелевантные предупреждения для проектов, не использующих UE.
Если вы хотите принудительно активировать набор диагностических правил для произвольного компилируемого файла или группы файлов, то добавьте следующий комментарий:
//V_TREAT_AS_UNREAL_ENGINE_FILEСуществует множество системных функций, которые при определённых условиях возвращают нулевой указатель. Хорошими примерами являются такие функции, как 'malloc', 'realloc', 'calloc'. Эти функции возвращают нулевой указатель в случае, когда невозможно выделить буфер памяти указанного размера.
Можно изменить поведение анализатора и заставить его считать, что, например, функция 'malloc' не может вернуть нулевой указатель. Например, это может потребоваться, если пользователь использует системные библиотеки, в которых ситуации нехватки памяти обрабатываются особым образом.
Также возможна обратная ситуация. Пользователь может помочь анализатору, подсказав ему, что определённая системная или его собственная функция может вернуть нулевой указатель.
Для этого существует возможность с помощью пользовательских аннотаций указать анализатору, что функция может или, наоборот, не может вернуть нулевой указатель.
Формат аннотации:
//V_RET_[NOT]_NULL, function: [namespace::][class::]functionNameПредположим, пользователь хочет подсказать анализатору, что функция 'Foo' класса 'Bar', лежащего в пространстве имён 'Space', не может возвращать нулевой указатель. Тогда аннотация будет выглядеть следующим образом:
//V_RET_NOT_NULL, function: Space::Bar::FooАннотации поддерживают вложенные пространства имён и вложенные классы. Предположим, в пространстве имён 'Space1' лежит пространство имён 'Space2'. В пространстве имён 'Space2' лежит класс 'Bar1'. В классе 'Bar1' лежит класс 'Bar2'. У класса 'Bar2' есть функция 'Foo', которая не может возвращать нулевой указатель. Тогда можно проаннотировать эту функцию следующим образом:
//V_RET_NOT_NULL, function: Space1::Space2::Bar1::Bar2::FooДля системных функций аннотация может быть расположена в глобальном заголовочном файле (например, предкомпилированный заголовочный файл) или файле конфигурации диагностических правил.
Для наглядности рассмотрим два примера аннотации системных функций.
Функция не возвращает нулевой указатель:
//V_RET_NOT_NULL, function:mallocТеперь анализатор считает, что функция 'malloc' не может вернуть нулевой указатель и не будет выдавать предупреждение V522 для следующего фрагмента кода:
int *p = (int *)malloc(sizeof(int) * 100);
p[0] = 12345; // okФункция возвращает потенциально нулевой указатель:
//V_RET_NULL, function: Memory::QuickAllocПосле добавления этого комментария анализатор начнёт выдавать предупреждение для следующего кода:
char *p = Memory::QuickAlloc(strlen(src) + 1);
strcpy(p, src); // Warning!В проектах с особыми требованиями качества может понадобится найти все функции, возвращающие указатель. Для этого можно воспользоваться следующим комментарием:
//V_RET_NULL_ALLМы не рекомендуем использовать этот режим из-за выдачи очень большого количества предупреждений. Но если в вашем проекте это действительно необходимо, то вы можете воспользоваться этим специальным комментарием, чтобы добавить в код проверку возвращаемого указателя для всех таких функций.
По умолчанию анализатор одинаково проверяет код, в котором присутствует макрос 'assert', независимо от конфигурации проекта (Debug, Release, ...). А именно – не учитывает, что при ложном условии в макросе выполнение кода прерывается.
Чтобы задать иное поведение анализатора, используйте следующий комментарий в коде:
//V_ASSERT_CONTRACTОбратите внимание, что в таком режиме результаты анализа могут отличаться в зависимости от того, как раскрывается макрос в проверяемой конфигурации проекта.
Для пояснения рассмотрим следующий код:
MyClass *p = dynamic_cast<MyClass *>(x);
assert(p);
p->foo();Оператор 'dynamic_cast' может вернуть значение 'nullptr'. Поэтому в стандартном режиме анализатор выдаст предупреждение, что при вызове функции 'foo' может произойти разыменовывание нулевого указателя.
После добавления комментария '//V_ASSERT_CONTRACT' предупреждение исчезнет.
Можно указать имя макроса, который анализатор будет обрабатывать так же, как 'assert'. Для этого используйте следующую аннотацию:
//V_ASSERT_CONTRACT, assertMacro:[MACRO_NAME]Ключ 'assetMacro' – имя макроса, который анализатор будет обрабатывать как 'assert'. Вместо '[MACRO_NAME]' необходимо подставить имя аннотируемого макроса.
Пример:
//V_ASSERT_CONTRACT, assertMacro:MY_CUSTOM_MACRO_NAMEТеперь анализатор будет обрабатывать макрос 'MY_CUSTOM_MACRO_NAME' как 'assert'.
Если необходимо указать несколько имен макросов, для каждого из них следует добавить отдельную директиву '//V_ASSERT_CONTRACT'.
Иногда в проектах используются собственные реализации разных системных функций, например, 'memcpy', 'malloc' и т.п. В этом случае анализатор не будет понимать, что поведение таких функций идентично стандартным аналогам. Существует возможность ставить имена своих функций в соответствие системным.
Формат записи:
//V_FUNC_ALIAS, implementation:imp, function:f, namespace:n, class:cПример использования:
//V_FUNC_ALIAS, implementation:memcpy, function:MyMemCpyТеперь анализатор будет обрабатывать вызовы функции 'MyMemCpy' так же, как вызовы 'memcpy'.
Можно самостоятельно указать имена своих собственных функций, для которых следует выполнять проверку формата. Подразумевается, что принцип форматирования строк совпадает с функцией 'printf'.
Для этого используется специальная пользовательская аннотация. Пример использования:
//V_FORMATTED_IO_FUNC, function:Log, format_arg:1, ellipsis_arg:2
void Log(const char *fmt, ...);
Log("%f", time(NULL)); // <= V576Формат аннотации:
Наиболее полный пример использования:
namespace A
{
class B
{
void C(int, const char *fmt, ...);
};
}
//V_FORMATTED_IO_FUNC, function:A::B::C, format_arg:2, ellipsis_arg:3Механизм JSON аннотаций — это способ разметки пользовательских функций и типов в файлах формата JSON с целью дать анализатору дополнительную информацию о пользовательском коде. Благодаря этой информации анализатор может как находить больше ошибок, так и выдавать меньше ложных срабатываний.
Использование отдельных файлов с аннотациями позволяет решить следующие проблемы:
В случае, если данные сценарии для вас не актуальны, и вы хотели бы проводить разметку прямо в исходном коде, то стоит ознакомиться с отдельной документацией.
На данный момент механизм доступен для следующих языков:
Для того, чтобы воспользоваться механизмом, необходимо:
Доступный функционал отличается в зависимости от используемого языка. После ознакомления с общей документацией желательно также ознакомиться с языко-специфичной частью:
Подключить уже готовый файл аннотаций можно следующими способами:
Способ N1. Добавить специальный комментарий в исходный код или в файл конфигурации диагностических правил (.pvsconfig):
//V_PVS_ANNOTATIONS, language:%язык_проекта%, path:%путь/до/файла.json%Вместо символа подстановки %язык_проекта% предполагается использование одного из следующих значений:
с;cpp;csharp.Вместо символа подстановки %путь/до/файла.json% предполагается путь до подключаемого файла аннотаций. Поддерживаются как абсолютные, так и относительные пути. Относительные пути раскрываются относительно файла, в котором указан комментарий для подключения аннотации.
Способ N2 (только для С, C++ и Java анализаторов). Указать специальный флаг --annotation-file (-A) при запуске pvs-studio-analyzer, CompilerCommandsAnalyzer или pvs-studio.jar:
Для C и C++:
pvs-studio-analyzer --annotation-file=%путь/до/файла.json%Для Java:
java -jar pvs-studio.jar --annotation-file %путь/до/файла.json%Вместо символа подстановки %путь/до/файла.json% предполагается путь до подключаемого файла аннотаций. Поддерживаются как абсолютные, так и относительные пути. Относительные пути раскрываются относительно текущей рабочей директории (CWD).
Способ N3 (только для Java анализатора). Автоматическое подключение по расширению файла.
Файлами аннотаций считаются все файлы с разрешением .annotations.json, находящиеся в директории .PVS-Studio в проекте.
Если проект находится в директории project-gradle, то все следующие файлы автоматически подтянутся анализатором как файлы аннотаций:
project-gradle/.PVS-Studio/test.annotations.json
project-gradle/.PVS-Studio/user.annotations.json
project-gradle/.PVS-Studio/sql.annotations.json
Примечание 1. Может быть подключено несколько файлов с аннотациями. Для каждого файла необходимо указать отдельный флаг или комментарий.
Примечание 2. До версии 7.33, для языков С и С++ аннотации можно было подключить с помощью комментария следующего вида:
//V_PVS_ANNOTATIONS %путь/до/файла%Начиная с версии 7.33, в таком случае будет выдаться специальное сообщение об использовании устаревшего синтаксиса и предложение перейти на новый.
Для облегчения знакомства с механизмом пользовательских аннотаций мы подготовили коллекцию примеров для наиболее часто встречающихся сценариев.
Больше примеров использования можно увидеть в документации механизма для конкретного языка:
Для каждого доступного языка составлена JSON-схема с поддержкой версионирования. Благодаря этим схемам современные текстовые редакторы и IDE могут проводить валидацию, а также показывать подсказки прямо во время редактирования.
Для этого при составлении собственного файла аннотаций необходимо добавить в него поле $schema, в котором следует указать схему для необходимого языка. Например, для C и С++ анализатора поле будет выглядеть так:
{
"version": 1,
"$schema": "https://files.pvs-studio.com/media/custom_annotations/v1/cpp-annotations.schema.json",
"annotations": [
{ .... }
]
}
Например, так Visual Studio Code сможет давать подсказки при составлении аннотаций:
На данный момент JSON-схемы доступны для аннотаций на следующих языках:
Далеко не все проблемы можно диагностировать на уровне валидации JSON-схемы. Если при работе с файлом с аннотациями произошла ошибка, то анализатор сгенерирует предупреждение V019. Оно даст подсказку, что пошло не так. Например: файл с аннотациями отсутствует, произошла ошибка при разборе, аннотация пропущена из-за допущенных в ней ошибок и т.д.
Механизм пользовательских аннотаций — это способ разметки типов и функций в формате JSON с целью дать анализатору дополнительную информацию. Благодаря этой информации анализатор сможет находить больше ошибок в коде. Механизм работает только для языков С и С++.
Допустим, что в проекте требуется запретить вызов некоторой функции, т.к. она нежелательна к использованию:
void DeprecatedFunction(); // should not be used
void foo()
{
DeprecatedFunction(); // unwanted call site
}Для того, чтобы анализатор сгенерировал предупреждение V2016 в месте вызова этой функции, необходимо создать специальный файл формата JSON со следующим содержимым:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "DeprecatedFunction",
"attributes": [ "dangerous" ]
}
]
}После этого достаточно подключить файл (все способы подключения рассмотрены здесь):
//V_PVS_ANNOTATIONS, language: cpp, path: %path/to/annotations.json%
void DeprecatedFunction();
void foo()
{
DeprecatedFunction(); // <= V2016 will be issued here
}Примечание. По умолчанию диагностическое правило V2016 отключена. Для выдачи предупреждений включите диагностику в настройках.
Подробнее о способе подключения файла аннотаций вы можете узнать в этой документации.
Содержимое файла — JSON-объект, состоящий из двух обязательных полей: version и annotations.
Поле version принимает значение целого типа и задаёт версию механизма. В зависимости от значения файл с разметкой может обрабатываться по-разному. На данный момент поддерживается только одно значение — 1.
Поле annotations — массив объектов "аннотация":
{
"version": 5,
"annotations":
[
{
...
},
{
...
}
]
}Аннотации могут быть двух видов:
Если аннотация объявляется непосредственно в массиве annotations, то она считается аннотацией верхнего уровня. В ином случае считается, что это вложенная аннотация.
Объект аннотации типа состоит из следующих полей:
Обязательное поле. Принимает строку с одним из значений: "record", "class", "struct", "union". Последние три варианта являются псевдонимами "record" и добавлены для удобства.
Обязательное поле. Принимает строку с квалифицированным (полным) именем сущности. Анализатор будет искать эту сущность, начиная с глобальной области видимости. Если сущность находится в глобальной области, то "::" в начале имени может быть опущено.
Опциональное поле. Массив объектов вложенных аннотаций.
Опциональное поле. Массив строк, который задаёт свойства сущности. Для аннотаций типов доступны следующие атрибуты:
"unique_ptr" — тип имеет интерфейс std::unique_ptr;"shared_ptr" — тип имеет интерфейс std::shared_ptr;"auto_ptr" — тип имеет интерфейс std::auto_ptr;"string" — тип имеет интерфейс std::basic_string;"string_view" — тип имеет интерфейс std::basic_string_view;"array" — тип имеет интерфейс std::array;"vector" — тип имеет интерфейс std::vector;"map" — тип имеет интерфейс std::map;"set" — тип имеет интерфейс std::set;"list" — тип имеет интерфейс std::list;"iterator" — тип имеет интерфейс std::iterator;"unordered" — в сочетании с "set" или "map" задаёт типу интерфейс std::unordered_set или std::unordered_map соответственно. "multi" — в сочетании с "map" или "set" задаёт типу интерфейс std::multiset или std::multimap. Если также присутствует "unordered", то типу задаётся семантика std::unordered_multiset или std::unordered_multimap."nullable" — тип имеет семантику nullable-типа. Объекты таких типов могут находиться в одном из двух состояний: "валидный" или "невалидный". Доступ к объекту в состоянии "невалидный" приведёт к ошибке. Примерами таких типов являются указатели, итераторы и std::optional."exception" — тип используется для создания объекта, который будет выброшен как исключение. Пример использования можно посмотреть здесь."cheap_to_copy" — объект типа может передаваться в функцию по копии без накладных расходов;"expensive_to_copy" — объект типа следует передавать в функцию только по указателю/ссылке;"copy_on_write" — тип имеет семантику copy-on-write.Объект аннотации функции состоит из следующих полей:
Обязательное поле. Принимает строку со значением function. Для вложенных аннотаций функций (в поле members аннотаций типов) также становится доступным значение ctor. Оно показывает, что аннотируется конструктор пользовательского типа.
Принимает строку с именем функции. Поле обязательно, если type имеет значение "function", иначе должно быть опущено. По этому имени анализатор будет искать аннотируемую сущность, начиная с глобальной области видимости.
Для аннотаций верхнего уровня указывается квалифицированное (полное) имя, для вложенных — неквалифицированное.
Если функция находится в глобальной области видимости, то '::' в начале имени может быть опущено.
Опциональное поле. Массив объектов, описывающих формальные параметры. Данное поле совместно с name задаёт сигнатуру функции, по которой анализатор будет сравнивать аннотацию с её объявлением в коде программы. В случае с функциями-членами анализатор также рассматривает поле qualifiers.
Каждый объект содержит следующие поля:
"type" (обязательное) — тип формального параметра в виде строки. Например, первый формальный параметр функции memset имеет тип void *. Его и следует записать в строку. Существует возможность пропустить не интересующие параметры и проаннотировать несколько перегрузок функции с помощью одной аннотации: для этого в типе можно написать символ подстановки:* означает, что на его месте может быть 0 или более параметров любого типа. Должен идти последним в списке параметров.? означает, что на его месте может быть параметр любого типа. "attributes" (опциональное) — массив строк, который задаёт свойства параметра. Возможные атрибуты параметров описаны далее в документации."constraint" (опциональное) — объект, содержащий информацию об ограничениях параметра. Если анализатор находит возможное нарушение ограничений, то пользователю будет выдано предупреждение V1108. Возможные поля объекта описаны далее в документации.Если аннотацию нужно применить для всех перегрузок вне зависимости от параметров, то поле можно опустить:
// Code
void foo(); // dangerous
void foo(int); // dangerous
void foo(float); // dangerous
// Annotation
{
....
"type": "function",
"name": "foo",
"attributes": [ "dangerous" ]
....
}Если же интересует перегрузка, не принимающая параметров, следует явно указать пустой массив:
// Code
void foo(); // dangerous
void foo(int); // ok
void foo(float); // ok
// Annotation
{
....
"type": "function",
"name": "foo",
"attributes": [ "dangerous" ],
"params": []
....
}|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
|
Подсказывает анализатору, что после вызова функции переданный аргумент не был модифицирован. Например, функция |
|
2 |
|
Действует только для параметров |
|
3 |
|
Передаваемые аргументы должны отличаться. Например, нет смысла передавать в |
|
4 |
|
Параметр обозначает форматную строку. Анализатор будет проверять аргументы согласно форматной спецификации |
|
5 |
|
Указатель, по которому в функции будет освобождена память с помощью |
|
6 |
|
Указатель, по которому в функции будет освобождена память с помощью |
|
7 |
|
Указатель, по которому в функции будет освобождена память с помощью |
|
8 |
|
Указатель, по которому в функции будет освобождена память с помощью |
|
9 |
|
Указатель, по которому в функции будет освобождена память с помощью |
|
10 |
|
Данные, возвращающиеся через параметр, получены из недостоверного источника. |
|
11 |
|
Данные, передаваемые через параметр, могут привести к эксплуатации уязвимости, если они получены из недостоверного источника. |
|
12 |
|
Параметр должен принимать любую непустую строку. |
|
13 |
|
Параметр обозначает нижнюю границу некоторого диапазона. Например, второй параметр |
|
14 |
|
Параметр обозначает верхнюю границу некоторого диапазона. Например, третий параметр |
|
15 |
|
Значение, переданное в параметр, проверяется на вхождение в диапазон. Например, первый параметр |
Все поля ограничений — опциональные. Далее приведён список полей, которые задают условия ограничения.
Поля, задающие список разрешённых и запрещённых значений параметра:
allowed — массив строк. Задаёт список разрешённых интегральных значений, которые может принимать параметр функции. По умолчанию значения, не перечисленные в этом списке, запрещены.disallowed — массив строк. Задаёт список запрещённых интегральных значений, которые может принимать параметр функции. По умолчанию значения, не перечисленные в этом списке, разрешены.Каждая строка внутри массива — это интервал от минимальной до максимальной границы включительно. Строка с интервалами указывается в формате "x..y", где x и y — это левая и правая границы соответственно. Одну из границ можно опустить. Тогда строка будет иметь вид "x.." или "..y". В таком случае интервал будет от x до плюс бесконечности и от минус бесконечности до y соответственно.
Примеры интервалов:
"0..10" — строка, задающая интервал от 0 до 10 включительно."..10" — строка, задающая интервал от минус бесконечности до 10 включительно."0.." — строка, задающая интервал от 0 до плюс бесконечности.Массив может содержать несколько интервалов. При их чтении анализатор нормализует все интервалы в массиве, т.е. объединяет пересекающиеся и рядом стоящие интервалы, располагая их в порядке возрастания.
Если поля allowed и disallowed указаны одновременно, то анализатор вычитает "disallowed" интервалы из "allowed", чтобы получить множество разрешённых значений. Если значения из поля disallowed полностью перекрывают значения из allowed, то пользователю будет выдано предупреждение V019.
Опциональное поле. Объект, внутри которого возможно использование только поля attributes — массива строк, который позволяет задать атрибуты возвращаемого значения.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
|
Функция всегда возвращает объект |
|
2 |
|
Функция может вернуть объект |
|
3 |
|
Функция может вернуть данные из недостоверного источника. |
|
4 |
|
Функция всегда возвращает объект |
Опциональное поле. Массив строк, позволяющий задать шаблонные параметры функции. Поле необходимо, когда шаблонные параметры используются в сигнатуре функции:
// Code
template <typename T1, class T2>
void MySwap(T1 &lhs, T2 &rhs);
// Annotation
{
....
"template_params": [ "typename T1", "class T2" ],
"name": "MySwap",
"params": [
{ "type": "T1 &", attributes: [ "unique_arg" ] },
{ "type": "T2 &", attributes: [ "unique_arg" ] }
]
....
}Опциональное поле. Позволяет применить аннотацию только к функции-члену с определённым набором cvref-квалификаторов. Доступно только для вложенных аннотаций, у которых поле type имеет значение "function". Данное поле совместно с name и params задаёт сигнатуру нестатической функции-члена, по которой анализатор будет сравнивать аннотацию с её объявлением в коде программы. Принимает массив строк со следующими возможными значениями: "const", "volatile", "&" или "&&".
Пример:
// Code
struct Foo
{
void Bar(); // don't need to annotate this overload
void Bar() const; // want to annotate this overload
void Bar() const volatile; // and this one
};
// Annotation
{
....
"type": "record",
"name": "Foo",
"members": [
{
"type": "function",
"name": "Bar",
"qualifiers": [ "const" ]
},
{
"type": "function",
"name": "Bar",
"qualifiers": [ "const", "volatile" ]
}
]
....
}Если аннотацию надо применить ко всем квалифицированным и неквалифицированным версиям, то нужно опустить поле:
// Code
struct Foo
{
void Bar(); // want to annotate this overload
void Bar() const; // and this one
};
// Annotation
{
....
"type": "record",
"name": "Foo",
"members": [
{
"type": "function",
"name": "Bar",
}
]
....
}Если надо применить аннотацию только к неквалифицированной версии, то значением поля должен быть пустой массив:
// Code
struct Foo
{
void Bar(); // want to annotate this overload
void Bar() const; // but NOT this one
};
// Annotation
{
....
"type": "record",
"name": "Foo",
"members": [
{
"type": "function",
"name": "Bar",
"qualifiers": []
}
]
....
}Опциональное поле. Массив строк, который задаёт свойства сущности.
|
# |
Название атрибута |
Описание атрибута |
Примечание |
|---|---|---|---|
|
1 |
|
Функция считается чистой. |
Функция чистая, когда она не имеет побочных эффектов, не модифицирует переданные аргументы, и результат функции одинаков при исполнении на одном и том же наборе аргументов. |
|
2 |
|
Функция не возвращает управление вызывающей функции. |
|
|
3 |
|
Результат функции должен использоваться. |
|
|
4 |
|
Функция-член пользовательского |
|
|
5 |
|
Функция-член пользовательского |
|
|
6 |
|
Функция-член пользовательского |
|
|
7 |
|
Функция проверяет состояние пользовательского |
|
|
8 |
|
Функция производит доступ к внутренним данным пользовательского |
|
|
9 |
|
Функция пользовательского |
|
|
10 |
|
Функция помечена как опасная, и код программы не должен содержать её вызова. |
Можно использовать в качестве пометки функции как устаревшей (deprecated). Для выдачи предупреждений требуется включить диагностическое правило V2016 в настройках. |
|
11 |
|
Функция, которая выделяет память. |
|
|
12 |
|
Атрибут для указания пары аллокаторов/деаллокаторов. |
Внутри скобок указывается один или несколько тегов через запятую. Память, выделенная аллокатором из группы N, может быть освобождена любым деаллокатором из этой же группы. Для совместимости функции со стандартной библиотекой используется имя группы |
|
13 |
|
Функция, инициализирующая поля класса и трактуемая анализатором как конструктор (инициализатор). |
Ниже приведена таблица применимости различных атрибутов с аннотациями функций:
|
# |
Атрибут |
Свободная функция |
Конструктор |
Функция-член |
|---|---|---|---|---|
|
1 |
pure |
✓ |
✕ |
✓ |
|
2 |
noreturn |
✓ |
✕ |
✓ |
|
3 |
nodiscard |
✓ |
✓ |
✓ |
|
4 |
nullable_uninitialized |
✕ |
✓ |
✓ |
|
5 |
nullable_initialized |
✕ |
✓ |
✓ |
|
6 |
nullable_potentially_initialized |
✕ |
✓ |
✓ |
|
7 |
nullable_checker |
✕ |
✕ |
✓ |
|
8 |
nullable_getter |
✕ |
✕ |
✓ |
|
9 |
nullable_resetter |
✕ |
✕ |
✓ |
|
10 |
dangerous |
✓ |
✕ |
✓ |
|
11 |
memory_allocator |
✓ |
✕ |
✓ |
|
12 |
alloc-group (....) |
✓ |
✕ |
✓ |
|
13 |
constructor_like |
✓ |
✕ |
✓ |
JSON схемы поставляется в дистрибутиве, а также доступны по ссылкам ниже:
Допустим, есть следующий пользовательский nullable-тип:
constexpr struct MyNullopt { /* .... */ } my_nullopt;
template <typename T>
class MyOptional
{
public:
MyOptional();
MyOptional(MyNullopt);
MyOptional(T &&val);
template <typename U>
MyOptional(U &&val);
public:
bool HasValue() const;
T& Value();
const T& Value() const;
void SetValue(T val);
void Reset();
void Reset(T &&val);
private:
/* implementation */
};Примечания по коду:
MyNullopt инициализируют объект в состоянии "невалидный".T&&, инициализирует объект в состоянии "потенциально валидный".U&&, инициализирует объект в состоянии "валидный".HasValue проверяет состояние объекта nullable-типа. Если объект в состоянии "валидный", то возвращается true, в обратном случае — false. Функция не меняет состояния объекта nullable-типа.Value возвращают нижележащий объект. Функции не меняют состояние объекта nullable-типа.SetValue изменяет состояние нижележащего объекта и переводит объект в состояние "потенциально валидный".Reset изменяют состояние нижележащего объекта. Перегрузка без параметров переводит объект в состояние "невалидный". Перегрузка с параметрами переводит объект в состояние, вычисленное на основе значений переданных аргументов.Тогда аннотация класса и его функций-членов будет выглядеть следующим образом:
{
"version": 5,
"language": "cpp",
"annotations": [
{
"type": "class",
"name": "MyOptional",
"attributes": [ "nullable" ],
"members": [
{
"type": "ctor",
"attributes": [ "nullable_uninitialized" ]
},
{
"type": "ctor",
"attributes": [ "nullable_uninitialized" ],
"params": [
{
"type": "MyNullopt"
}
]
},
{
"type": "ctor",
"attributes": [ "nullable_potentially_initialized" ],
"params": [
{
"type": "T &&val"
}
]
},
{
"type": "ctor",
"template_params": [ "typename U" ],
"attributes": [ "nullable_initialized" ],
"params": [
{
"type": "U &&val"
}
]
},
{
"type": "function",
"name": "HasValue",
"attributes": [ "nullable_checker", "pure", "nodiscard" ]
},
{
"type": "function",
"name": "Value",
"attributes": [ "nullable_getter", "nodiscard" ]
},
{
"type": "function",
"name": "SetValue",
"attributes": [ "nullable_potentially_initialized" ]
},
{
"type": "function",
"name": "Reset",
"attributes": [ "nullable_resetter" ]
}
]
}
]
}Допустим, есть следующий код:
namespace Foo
{
template <typaname CharT>
size_t my_strlen(const CharT *ptr);
}Функция Foo::my_strlen имеет следующие свойства:
Тогда аннотация функции будет выглядеть следующим образом:
{
"version": 5,
"annotations":
[
{
"type": "function",
"name": "Foo::my_strlen",
"attributes": [ "pure" ],
"template_params": [ "typename CharT" ],
"params": [
{
"type": "const CharT *",
"attributes": [ "not_null" ]
}
]
}
]
}Допустим, есть следующая функция Foo::LogAtError:
namespace Foo
{
void LogAtError(const char *, ...);
}О ней известны следующие факты:
printf. Аргумент не должен быть нулевым.Анализатор может проверять переданные аргументы согласно форматной строке, а также понимать, что после вызова этой функции код недостижим. Для этого надо разметить функцию следующим образом:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "Foo::LogAtError",
"attributes": [ "noreturn" ],
"params": [
{
"type": "const char *",
"attributes" : [ "format_arg", "not_null", "immutable" ]
},
{
"type": "...",
"attributes": [ "immutable" ]
}
]
}
]
}Допустим, что в предыдущем примере программист добавил несколько перегрузок функции Foo::LogAtExit:
namespace Foo
{
void LogAtExit(const char *fmt, ...);
void LogAtExit(const char8_t *fmt, ...);
void LogAtExit(const wchar_t *fmt, ...);
void LogAtExit(const char16_t *fmt, ...);
void LogAtExit(const char32_t *fmt, ...);
}В этом случае можно не писать аннотации для всех перегрузок, а лишь для одной, воспользовавшись символом подстановки:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "Foo::LogAtExit",
"attributes": [ "noreturn" ],
"params": [
{
"type": "?",
"attributes" : [ "format_arg", "not_null", "immutable" ]
},
{
"type": "...",
"attributes": [ "immutable" ]
}
]
}
]
}Допустим, есть две перегрузки функции Foo::Bar:
namespace Foo
{
void Bar(int i);
void Bar(double d);
}Требуется запретить использование первой перегрузки. Для этого надо разметить функцию следующим образом:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "Foo::Bar",
"attributes": [ "dangerous" ],
"params": [
{
"type": "int"
}
]
}
]
}Допустим, что есть функция, которая возвращает внешние данные через out-параметр и возвращаемое значение.
std::string ReadStrFromStream(std::istream &input, std::string &str)
{
....
input >> str;
return str;
....
}Для того, чтобы пометить эту функцию как источник недостоверных данных, необходимо её разметить следующим образом:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "ReadStrFromStream",
"params": [
{
"type": "std::istream &input"
},
{
"type": "std::string &str",
"attributes": [ "taint_source" ]
}
],
"returns": { "attributes": [ "taint_source" ] }
}
]
}Предположим, что существует функция, при попадании в которую недостоверных данных может быть эксплуатирована какая-либо уязвимость.
void DoSomethingWithData(std::string &str)
{
.... // Some vulnerability
}Чтобы пометить такую функцию как приемник недостоверных данных (функцию-сток), необходимо написать следующую аннотацию:
{
"version": 5,
"annotations": [
{
{
"type": "function",
"name": "DoSomethingWithData",
"params": [ { "type": "std::string &str",
"attributes": [ "taint_sink" ] }]
}
}
]
}В C++ анализаторе есть диагностическое правило V1116, которое срабатывает при обнаружении создания объекта исключения с пустым сообщением. По умолчанию данное правило работает только с типами исключений из стандартной библиотеки C++. Для поддержки пользовательских типов исключений необходимо добавить специальную аннотацию.
Предположим, есть класс, определяющий объекты, которые будут использованы для выброса исключения:
class MyException: public std::runtime_error
{
public:
MyException(const std::string& what_arg )
: std::runtime_error(what_arg){}
MyException(const char *what_arg)
: std::runtime_error(what_arg){}
};В аннотации необходимо определить тип исключения с атрибутом exception и затем конструкторы, способные принимать поясняющие сообщения. Для каждого параметра конструктора, который должен принимать сообщение, следует указать атрибут non_empty_string.
Например, аннотация класса MyException может выглядеть так:
{
"version": 5,
"language": "cpp",
"annotations": [
{
"type": "class",
"name": "MyException",
"attributes": ["exception"],
"members": [
{
"type": "ctor",
"params": [{ "type": "const char*",
"attributes": ["non_empty_string"]}]
},
{
"type": "ctor",
"params": [{ "type": "const std::string&",
"attributes": ["non_empty_string"]}]
}
]
}
]
}В C++ анализаторе есть диагностическое правило V783, которое выдаёт предупреждение при обнаружении использования невалидного (либо потенциально невалидного) итератора. По умолчанию данное правило работает только с контейнерами из стандартной библиотеки С++.
Предположим, есть класс MyIterator, реализующий поведение итератора, и класс-контейнер MyContainer с методами, которые его возвращают:
class MyIterator{....};
class MyContainer
{
public:
typedef MyIterator Iterator;
std::list<MyIterator> vec;
Iterator Begin();
Iterator Find(int i);
Iterator Find(Iterator it);
Iterator End();
....
};Для поддержки данной реализации необходимо проаннотировать тип MyIterator атрибутом iterator, а также разметить методы Begin, Find и End класса MyContainer соответствующими returns атрибутами. Например:
{
"version": 5,
"language": "cpp",
"annotations": [
{
"type": "class",
"name": "MyIterator",
"attributes": [ "iterator" ]
},
{
"type": "class",
"name": "MyContainer",
"members": [
{
"type": "function",
"name": "Begin",
"returns": { "attributes": [ "maybe_null" ] }
},
{
"type": "function",
"name": "End",
"returns": { "attributes": [ "always_null" ] }
},
{
"type": "function",
"name": "Find",
"returns": { "attributes": [ "maybe_null" ] }
}
]
}
]
}В C и С++ анализаторе есть диагностическое правило V611, которое выдаёт предупреждение о том, что память может выделяться и освобождаться несовместимыми между собой способами. По умолчанию это правило не работает с пользовательскими функциями, и их нужно разметить с помощью аннотаций.
Рассмотрим простой пример:
void my_free(void *);
void *my_unique_malloc(size_t);
void foo(size_t count)
{
int *ptr = (int *) my_unique_malloc(count * sizeof(int));
if (!ptr) return;
my_free(ptr); // <= V611
}Аннотация:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "my_unique_malloc",
"attributes": [ "memory_allocator" ]
},
{
"type": "function",
"name": "my_free",
"params": [
{
"type": "void *",
"attributes": [ "pointer_to_free" ]
}
]
}
]
}Чтобы указать анализатору, что my_unique_malloc и my_free принадлежат одной логической группе, нужно добавить атрибут alloc-group с одинаковым тегом. Например, используем тег myAllocGroup:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "my_unique_malloc",
"attributes": [ "memory_allocator", "alloc-group(myAllocGroup)" ]
},
{
"type": "function",
"name": "my_free",
"attributes": [ "alloc-group (myAllocGroup)" ],
"params": [
{
"type": "void *",
"attributes": [ "pointer_to_free" ]
}
]
}
]
}Теперь анализатор поймёт, что my_unique_malloc и my_free — пара, и ложных срабатываний диагностического правила V611 не будет.
Имя группы может быть любым; главное, чтобы оно было одинаковым для всех функций одной логической группы аллокации/деаллокации.
Примечание. Имя группы stdlib зарезервировано анализатором. Этот тег служит для отнесения пользовательской функции к стандартной библиотеке (stdlib.h для C, cstdlib для C++). Например:
#include <cstdlib>
void *my_unique_malloc(size_t);
void foo(size_t count)
{
int *ptr = (int *) my_unique_malloc(count * sizeof(int));
if (!ptr) return;
free(ptr);
}Если вы хотите, чтобы ваша функция аллокации считалась совместимой с free из стандартной библиотеки, достаточно добавить функцию в группу stdlib:
{
"version": 5,
"annotations": [
{
"type": "function",
"name": "my_unique_malloc",
"attributes": [ "memory_allocator", "alloc-group (stdlib)" ]
}
]
}Способы подключения файла c аннотациями
Подробнее о способе подключения файла аннотаций вы можете узнать в этой документации.
Содержимое файла — JSON-объект, состоящий из трёх обязательных полей: language, version и annotations.
Поле language должно иметь значение csharp. Поле version принимает значение целого типа и задаёт версию механизма. В зависимости от значения файл с разметкой может обрабатываться по-разному. Актуальная на данный момент версия — 2.
Поле annotations — массив объектов "аннотация":
{
"language": "csharp",
"version": 2,
"annotations":
[
{
...
},
{
...
}
]
}Аннотации могут быть трёх типов:
В анализаторе существует ряд аннотаций для taint-анализа. С их помощью можно размечать источники и приёмники заражения. Также существует возможность помечать методы/конструкторы, которые производят валидацию taint-данных. Таким образом, если taint-данные прошли валидацию, то при их попадании в приёмник предупреждения анализатора не будет.
За каждый из видов уязвимостей отвечает отдельное диагностическое правило. На данный момент в анализаторе представлены следующие taint-диагностики:
Для каждого из диагностических правил существуют специальные аннотации, которые позволяют разметить приёмники и методы/конструкторы, производящие валидацию.
Что касается источников taint-данных, то они являются общими для всех диагностик. Такие данные также можно разметить с помощью аннотаций.
Примечание. Атрибуты для разметки taint-аннотаций описаны в следующих разделах.
Стоит отметить, что, помимо пользовательских аннотаций, в анализаторе уже имеется ряд taint-аннотаций для различных библиотек. Например, при передаче результата выполнения метода System.Console.ReadLine в конструктор System.Data.SqlClient.SqlCommand возможно возникновение SQL injection. В анализаторе есть аннотации, которые говорят, что System.Console.ReadLine — источник taint-данных, а System.Data.SqlClient.SqlCommand — приёмник, при попадании в который taint-данных может возникнуть SQL injection.
Таким образом, размечая источники taint-данных, анализатор будет учитывать их для уже существующих приёмников и наоборот. Если добавить аннотацию приёмника, то анализатор будет выдавать предупреждение при попадании в него уже размеченных источников taint-данных (например, System.Console.ReadLine).
Примечание. Объект аннотации метода должен содержать хотя бы одно опциональное поле.
Объект аннотации метода состоит из следующих полей:
Обязательное поле. Принимает строку со значением method.
Обязательное поле. Принимает строку с именем пространства имён, которое содержит метод.
Обязательное поле. Принимает строку с именем класса, в котором определён метод.
Обязательное поле. Принимает строку с именем метода.
Опциональное поле. Массив строк, который задаёт свойства сущности.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
not_apply_to_child_class |
Аннотация не будет применяться при вызове проаннотированного метода у объекта дочернего класса. |
|
2 |
caller_is_xml_parser |
Объект, вызывающий метод, является XML-парсером, который может быть уязвим (V5614, V5615). |
|
3 |
use_return |
Необходимо использовать возвращаемое значение метода. |
|
4 |
dispose_equivalent |
Метод работает аналогично методу |
|
5 |
returns_new_value |
При каждом вызове метод возвращает новый объект. |
|
6 |
external_modification |
Метод изменяет что-то внешнее (печать в консоли, создание файлов и т. п.). |
|
7 |
empty_collection_exception |
При вызове этого метода у пустой коллекции будет выброшено исключение. |
Опциональное поле. Данное поле описано в разделе "Аннотации параметров".
Примечание. Объект аннотации возвращаемого значения должен либо содержать поля namespace_name и type_name, либо оба поля должны отсутствовать (или иметь значение null). Если оба поля отсутствуют, то при выборе аннотации не будет учитываться тип возвращаемого значения.
Опциональное поле. Объект возвращаемого значения, состоит из следующих полей:
Опциональное поле. Принимает строку с именем пространства имён, которое содержит тип возвращаемого значения метода.
Опциональное поле. Принимает строку с именем класса, в котором определён тип возвращаемого значения метода.
Опциональное поле. Массив строк, который задаёт свойства возвращаемого значения метода.
Возможные атрибуты возвращаемого значения
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
not_apply_to_child_class |
Аннотация не будет применяться для методов, тип возвращаемого значения которых является дочерним для проаннотированного типа. |
|
2 |
always_taint |
Метод возвращает taint-данные. |
|
3 |
transfer_annotations_from_caller |
Если вызывающий объект содержит аннотацию, она будет перенесена на возвращаемое значение метода. |
|
4 |
not_null |
Метод никогда не возвращает |
|
5 |
file_path |
Метод возвращает путь до файла. |
|
6 |
sensitive_data |
Метод возвращает sensitive-данные. |
При аннотировании методов расширения необходимо указывать тип, в котором определён метод расширения. Например, есть метод расширения для класса System.String — MyNamespace.StringExtensions.CustomizeString(this string str). Нужно писать аннотацию для типа MyNamespace.StringExtensions, а не для System.String. Стоит учесть, что все методы расширения будут иметь как минимум один аргумент.
Существует возможность аннотировать не тип, в котором определён метод расширения, а расширяемый тип. Если обратиться к примеру, описанному выше, то это System.String. Однако данный способ является нежелательным, так как накладывает ряд ограничений на обработку анализатором аннотации такого вида. Например, нельзя сделать аннотацию для первого параметра (с модификатором this).
Примечание. Объект аннотации конструктора должен содержать хотя бы одно опциональное поле.
Объект аннотации конструктора состоит из следующих полей:
Обязательное поле. Принимает строку со значением ctor.
Обязательное поле. Принимает строку с именем пространства имён, которое содержит конструктор.
Обязательное поле. Принимает строку с именем класса, в котором определён конструктор.
Опциональное поле. Массив строк, который задаёт свойства сущности.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
not_apply_to_child_class |
Аннотация не будет применяться для дочерних реализаций проаннотированного конструктора. |
|
2 |
create_taint_object |
Созданный конструктором объект — taint. |
Опциональное поле. Данное поле описано в разделе "Аннотации параметров".
Объект аннотации свойства состоит из следующих полей:
Обязательное поле. Принимает строку со значением property.
Обязательное поле. Принимает строку с именем пространства имён, которое содержит свойство.
Обязательное поле. Принимает строку с именем класса, в котором определено свойство.
Опциональное поле. Массив строк, который задаёт свойства сущности.
Примечание. К каждому из атрибутов taint-приёмников прикреплена ссылка на соответствующую диагностику.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
not_apply_to_child_class |
Аннотация не будет применяться при обращении к проаннотированному свойству у объекта дочернего класса. |
|
2 |
transfer_annotation_to_return_value |
Если на вызывающем объекте есть аннотация, то она будет перенесена на возвращаемое значение. |
|
3 |
transfer_annotation_to_caller |
Если свойству присваивается значение, то аннотации этого значения будут перенесены на вызывающий объект свойства. |
|
4 |
return_taint |
Свойство возвращает taint-данные. |
|
5 |
sql_injection_target |
Запись в это свойство заражённых данных приводит к SQL Injection (V5608). |
|
6 |
path_traversal_target |
Запись в это свойство заражённых данных приводит к Path Traversal (V5609). |
|
7 |
xss_injection_target |
Запись в это свойство заражённых данных приводит к XSS Injection (V5610). |
|
8 |
insecure_deserialization_target |
Запись в это свойство заражённых данных приводит к Insecure Deserialization (V5611). |
|
9 |
command_injection_target |
Запись в это свойство заражённых данных приводит к Command Injection (V5616). |
|
10 |
ssrf_target |
Запись в это свойство заражённых данных приводит к Server-Side Request Forgery (V5618). |
|
11 |
log_injection_target |
Запись в это свойство заражённых данных приводит к Log Injection (V5619). |
|
12 |
ldapi_injection_target |
Запись в это свойство заражённых данных приводит к LDAP Injection (V5620). |
|
13 |
xpath_injection_target |
Запись в это свойство заражённых данных приводит к XPath Injection (V5622). |
|
14 |
open_redirect_target |
Запись в это свойство заражённых данных приводит к Open Redirect (V5623). |
|
15 |
configuration_attack_target |
Запись в это свойство заражённых данных приводит к Configuration Attack (5624). |
|
16 |
nosql_injection_target |
Запись в это свойство заражённых данных приводит к NoSQL Injection (V5627). |
|
17 |
redos_target |
Запись в это свойство заражённых данных приводит к ReDoS (V5626). |
|
18 |
zipslip_target |
Запись в это свойство заражённых данных приводит к ZipSlip (V5628). |
|
19 |
modified_in_another_thread |
Свойство может измениться в другом потоке. |
|
20 |
sensitive_data |
Свойство содержит sensitive-данные. |
|
21 |
file_path |
Свойство содержит путь до файла. |
Примечание 1. Объект аннотации параметра может находиться только внутри массива params, объекта аннотации метода или конструктора.
Примечание 2. Объект аннотации параметра должен либо содержать поля namespace_name и type_name, либо оба поля должны отсутствовать (или иметь значение null).
Примечание 3. Если аннотация метода/конструктора должна применяться ко всем перегрузкам этого метода/конструктора, то поле params должно отсутствовать в аннотации.
Объект аннотации параметра состоит из следующих полей:
Обязательное поле. Принимает строку с именем пространства имён, которое содержит тип параметра.
Обязательное поле. Принимает строку с именем класса, в котором определён тип параметра.
Опциональное поле. Массив строк, который задаёт свойства сущности.
Примечание. К каждому из атрибутов taint-приёмников и taint-валидации прикреплена ссылка на соответствующую диагностику.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
ignore_current_and_next |
При подборе соответствующей аннотации не будут учитываться текущий и следующие параметры (данная аннотация может быть только у последнего аргумента). |
|
2 |
transfer_annotation_to_return_value |
Если параметр содержит аннотацию, она будет перенесена на возвращаемое значение метода. |
|
3 |
object_creation_infector |
Заражение нового созданного объекта происходит через этот параметр (актуально только для конструкторов). |
|
4 |
sql_injection_target |
Передача в этот параметр заражённых данных приводит к SQL Injection (V5608). |
|
5 |
sql_injection_validation |
Вызов метода сбрасывает SQL Injection taint-статус для данного параметра (V5608). |
|
6 |
path_traversal_target |
Передача в этот параметр заражённых данных приводит к Path Traversal (V5609). |
|
7 |
path_traversal_validation |
Вызов метода сбрасывает Path Traversal taint-статус для данного параметра (V5609). |
|
8 |
xss_injection_target |
Передача в этот параметр заражённых данных приводит к XSS Injection (V5610). |
|
9 |
xss_injection_validation |
Вызов метода сбрасывает XSS Injection taint-статус для данного параметра (V5610). |
|
10 |
insecure_deserialization_target |
Передача в этот параметр заражённых данных приводит к Insecure Deserialization (V5611). |
|
11 |
insecure_deserialization_validation |
Вызов метода сбрасывает Insecure Deserialization taint-статус для данного параметра (V5611). |
|
12 |
command_injection_target |
Передача в этот параметр заражённых данных приводит к Command Injection (V5616). |
|
13 |
command_injection_validation |
Вызов метода сбрасывает Command Injection taint-статус для данного параметра (V5616). |
|
14 |
xml_source_to_parse |
Параметр - источник XML, который будет парситься. Это может быть сам XML-файл, путь до него, поток с XML-файлов, парсер, содержащий поток XML-файла, и т. п. (V5614, V5615). |
|
15 |
transfer_xml_settings_to_return |
Передаёт настройки XML-парсера из этого аргумента в возвращаемое значение. (V5614, V5615). |
|
16 |
ssrf_target |
Передача в этот параметр заражённых данных приводит к Server-Side Request Forgery (V5618). |
|
17 |
ssrf_validation |
Вызов метода сбрасывает Server-Side Request Forgery taint-статус для данного параметра (V5618). |
|
18 |
log_injection_target |
Передача в этот параметр заражённых данных приводит к Log Injection (V5619). |
|
19 |
log_injection_validation |
Вызов метода сбрасывает Log Injection taint-статус для данного параметра (V5619). |
|
20 |
ldapi_injection_target |
Передача в этот параметр заражённых данных приводит к LDAP Injection (V5620). |
|
21 |
ldapi_injection_validation |
Вызов метода сбрасывает LDAP Injection taint-статус для данного параметра (V5620). |
|
22 |
xpath_injection_target |
Передача в этот параметр заражённых данных приводит к XPath Injection (V5622). |
|
23 |
xpath_injection_validation |
Вызов метода сбрасывает XPath Injection taint-статус для данного параметра (V5622). |
|
24 |
open_redirect_target |
Передача в этот параметр заражённых данных приводит к Open Redirect (V5623). |
|
25 |
open_redirect_validation |
Вызов метода сбрасывает Open Redirect taint-статус для данного параметра (V5623). |
|
26 |
configuration_attack_target |
Передача в этот параметр заражённых данных приводит к Configuration Attack (5624). |
|
27 |
configuration_attack_validation |
Вызов метода сбрасывает Configuration Attack taint-статус для данного параметра (5624). |
|
28 |
nosql_injection_target |
Передача в этот параметр заражённых данных приводит к NoSQL Injection (V5627). |
|
29 |
nosql_injection_validation |
Вызов метода сбрасывает NoSQL Injection taint-статус для данного параметра (V5627). |
|
30 |
redos_target |
Строка, которая разбирается с помощью регулярного выражения. Передача в этот параметр заражённых данных приводит к ReDoS, если регулярное выражение небезопасно (V5626). |
|
31 |
redos_validation |
Вызов метода сбрасывает ReDoS taint-статус для данного параметра (V5626). |
|
32 |
zipslip_target |
Строка, которая может быть использована как путь для извлечения файла из архива. Передача в этот параметр заражённых данных приводит к ZipSlip (V5628). |
|
33 |
zipslip_validation |
Вызов метода сбрасывает ZipSlip taint-статус для данного параметра (V5628). |
|
34 |
regex |
Параметр является регулярным выражением. |
|
35 |
format_string |
Параметр является строкой формата. |
|
36 |
params |
Параметр имеет модификатор |
|
37 |
ref_or_out |
Параметр имеет модификатор |
|
38 |
file_path |
Параметр является путём до файла. |
|
39 |
greater_than_zero |
Параметр должен быть строго больше нуля. |
|
40 |
greater_than_or_equal_to_zero |
Параметр должен быть больше или равен нулю. |
|
41 |
not_null |
Параметр не должен быть |
|
42 |
not_null_after_method_call |
Значение, соответствующее параметру, точно не будет |
|
43 |
sensitive_data |
Данный параметр не должен содержать sensitive-данные. |
Чтобы проигнорировать тип параметра, не нужно указывать поля namespace_name и type_name или нужно записать в оба поля null.
JSON схемы поставляются в дистрибутиве, а также доступны по ссылкам ниже:
Рассмотрим метод:
namespace MyNamespace
{
public class MyClass
{
public string GetUserInput()
{
....
}
}
}Допустим, данный метод возвращает пользовательский ввод, который может содержать taint-данные. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "method",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"method_name": "GetUserInput",
"returns": {
"attributes": [ "always_taint" ]
}
}
]
}Рассмотрим конструктор:
namespace MyNamespace
{
public class MyClass
{
public MyClass()
{
....
}
}
}Допустим, данный конструктор создаёт объект, который может содержать taint-данные. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "ctor",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"attributes": [ "create_taint_object" ]
}
]
}Рассмотрим свойство:
namespace MyNamespace
{
public class MyClass
{
public string UserInput
{
get
{
....
}
}
}
}Допустим, данное свойство возвращает пользовательский ввод, который может содержать taint-данные. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "property",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"property_name": "UserInput",
"attributes": [ "return_taint" ]
}
]
}Примечание. В качестве примера используется аннотация метода. Игнорирование типа параметров конструктора производится аналогичным образом (не указывать type_name и namespace_name у аннотации параметра).
Рассмотрим две перегрузки метода GetUserInput:
namespace MyNamespace
{
public class MyClass
{
public string GetUserInput(string str)
{
....
}
public string GetUserInput(int index)
{
....
}
}
}Допустим, данный метод возвращает пользовательский ввод, который может содержать taint-данные, вне зависимости от типа параметра. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "method",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"method_name": "GetUserInput",
"params": [
{ }
],
"returns": {
"attributes": [ "always_taint" ]
}
}
]
}В данном случае для первого параметра нет аннотаций. Также при подборе аннотации метода неважно, какой тип будет иметь первый параметр. Поэтому аннотация параметра представлена пустым объектом.
Примечание. В качестве примера используется аннотация метода. Игнорирование параметров конструктора производится аналогичным образом (с помощью аннотации ignore_current_and_next).
Рассмотрим две перегрузки метода GetUserInput:
namespace MyNamespace
{
public class MyClass
{
public string GetUserInput(string str)
{
....
}
public string GetUserInput(string str, bool flag1, bool flag2)
{
....
}
}
}Допустим, данный метод возвращает пользовательский ввод, который может содержать taint-данные, если использована перегрузка с одним или более параметрами. Также, если в первый параметр передать taint-данные, возникнет SQL injection. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "method",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"method_name": "GetUserInput",
"params": [
{
"namespace_name": "System",
"type_name": "String",
"attributes": [ "sql_injection_target" ]
},
{
"attributes": [ "ignore_current_and_next" ]
}
],
"returns": {
"attributes": [ "always_taint" ]
}
}
]
}Для второго параметра есть аннотация ignore_current_and_next. Она позволяет игнорировать количество параметров (включая проаннотированный параметр) при обработке аннотации.
Примечание. В качестве примера используется аннотация метода. Игнорирование всех параметров для конструктора производится аналогичным образом (в аннотации не указывается поле params).
Рассмотрим три перегрузки метода GetUserInput:
namespace MyNamespace
{
public class MyClass
{
public string GetUserInput()
{
....
}
public string GetUserInput(string str)
{
....
}
public string GetUserInput(string str, bool flag)
{
....
}
}
}Допустим, данный метод возвращает пользовательский ввод, который может содержать taint-данные, вне зависимости от перегрузки. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 2,
"language": "csharp",
"annotations": [
{
"type": "method",
"namespace_name": "MyNamespace",
"type_name": "MyClass",
"method_name": "GetUserInput",
"returns": {
"attributes": [ "always_taint" ]
}
}
]
}Данная аннотация будет применена ко всем перегрузкам метода MyNamespace.MyClass.GetUserInput, так как в ней нет поля params.
Способы подключения файла c аннотациями
Подробнее о способе подключения файла аннотаций вы можете узнать в этой документации.
Содержимое файла — JSON-объект, состоящий из трёх обязательных полей: language, version и annotations.
Поле language должно иметь значение java. Поле version принимает значение целого типа и задаёт версию механизма. В зависимости от значения файл с разметкой может обрабатываться по-разному. На данный момент поддерживается только одно значение — 1.
Поле annotations — массив объектов "аннотация":
{
"language": "java",
"version": 1,
"annotations":
[
{
...
},
{
...
}
]
}На данный момент существуют аннотации методов и конструкторов.
В анализаторе существует ряд аннотаций для taint-анализа. С их помощью можно размечать источники и приёмники заражения. Также существует возможность помечать методы/конструкторы, которые производят валидацию taint-данных. Таким образом, если taint-данные прошли валидацию, то при их попадании в приёмник предупреждения анализатора не будет.
За каждый из видов уязвимостей отвечает отдельное диагностическое правило. На данный момент в анализаторе представлены следующие taint-диагностики:
Для каждого из диагностических правил существуют специальные аннотации, которые позволяют разметить приёмники и методы/конструкторы, производящие валидацию.
Что касается источников taint-данных, то они являются общими для всех диагностик. Такие данные также можно разметить с помощью аннотаций.
Примечание. Атрибуты для разметки taint-аннотаций описаны в следующих разделах.
Стоит отметить, что, помимо пользовательских аннотаций, в анализаторе уже имеется ряд taint-аннотаций для различных библиотек. Например, при передаче результата выполнения метода Console.readLine в метод Statement.execute возможно возникновение SQL injection. В анализаторе есть аннотации, которые говорят, что Console.readLine — источник taint-данных, а Statement.execute — приёмник, при попадании в который taint-данных может возникнуть SQL injection.
Таким образом, размечая источники taint-данных, анализатор будет учитывать их для уже существующих приёмников и наоборот. Если добавить аннотацию приёмника, то анализатор будет выдавать предупреждение при попадании в него уже размеченных источников taint-данных (например, Console.readLine).
Примечание. Объект аннотации метода должен содержать хотя бы одно опциональное поле.
Объект аннотации метода состоит из следующих полей:
Обязательное поле. Принимает строку со значением method.
Обязательное поле. Принимает строку с именем пространства имён, которое содержит метод.
Обязательное поле. Принимает строку с именем класса, в котором определён метод.
Обязательное поле. Принимает строку с именем метода.
Примечание. Для аннотирования конструктора необходимо использовать <init>.
Опциональное поле. Массив строк, который задаёт свойства сущности.
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
sql_injection_sink |
Передача заражённых данных в параметры этого метода приводит к SQL Injection |
|
2 |
os_command_injection_sink |
Передача заражённых данных в параметры этого метода приводит к OS Command Injection |
|
3 |
xpath_injection_sink |
Передача заражённых данных в параметры этого метода приводит к XPath Injection |
|
4 |
configuration_injection_sink |
Передача заражённых данных в параметры этого метода приводит к Configuration Injection |
|
5 |
ldap_injection_sink |
Передача заражённых данных в параметры этого метода приводит к LDAP Injection |
|
6 |
reflection_injection_sink |
Передача заражённых данных в параметры этого метода приводит к Reflection Injection |
|
7 |
regex_sink |
Передача заражённых данных в параметры этого метода приводит к Regex Injection |
|
8 |
xss_injection_sink |
Передача заражённых данных в параметры этого метода приводит к XSS Injection |
|
9 |
path_traversal_sink |
Передача заражённых данных в параметры этого метода приводит к Path Traversal Vulnerability |
Опциональное поле.
Аннотирование параметров необходимо для определения нужного для разметки метода. Отсутствие данного поля означает любое количество параметров любых типов. Пустой массив параметров ([ ]) означает отсутствие параметров.
Объект аннотации параметра состоит из следующих полей:
Обязательное поле. Принимает строку с именем пакета, которое содержит тип параметра.
Обязательное поле. Принимает строку с именем класса, в котором определён тип параметра.
Опциональное поле. Объект возвращаемого значения, состоит из единственного поля:
Опциональное поле. Массив строк, который задаёт свойства возвращаемого значения метода.
Возможные атрибуты возвращаемого значения
|
# |
Название атрибута |
Описание атрибута |
|---|---|---|
|
1 |
common_source |
Возвращаемое значение является источником заражённых данных |
|
2 |
web_source |
Возвращаемое значение является веб источником заражённых данных |
|
3 |
potential_sql_sanitization |
Возвращаемое значение является санитизированным т SQL Injection |
|
4 |
potential_os_command_sanitization |
Возвращаемое значение является санитизированным от OS Command Injection |
|
5 |
potential_xpath_sanitization |
Возвращаемое значение является санитизированным от XPath Injection |
|
6 |
potential_log_sanitizaton |
Возвращаемое значение является санитизированным от Log Injection |
|
7 |
potential_configuration_sanitization |
Возвращаемое значение является санитизированным от Configuration Injection |
|
8 |
potential_ldap_sanitization |
Возвращаемое значение является санитизированным от LDAP Injection |
|
9 |
potential_reflection_sanitization |
Возвращаемое значение является санитизированным от Reflection Injection |
|
10 |
regex_sanitization |
Возвращаемое значение является санитизированным от Regex Injection |
|
11 |
xss_input_sanitization |
Возвращаемое значение является санитизированным от XSS Injection |
|
12 |
potential_path_traversal_sanitization |
Возвращаемое значение является санитизированным от Path Traversal Vulnerability |
Схема JSON поставляется в дистрибутиве или доступна по ссылке.
Рассмотрим метод:
package com.example;
public class MyClass {
public string getUserInput() {
....
}
}Допустим, данный метод возвращает пользовательский ввод, который может содержать taint-данные. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 1,
"language": "java",
"annotations": [
{
"type": "method",
"package_name": "com.example",
"type_name": "MyClass",
"method_name": "getUserInput",
"returns": {
"attributes": [ "common_source" ]
}
}
]
}Рассмотрим две перегрузки метода getUserInput:
package com.example;
public class MyClass {
public string getUserInput(string str) {
....
}
public string getUserInput(int index) {
....
}
}Допустим, вне зависимости от типа параметра данный метод возвращает пользовательский ввод, который может содержать taint-данные. Аннотация, которая позволит анализатору понять это, будет выглядеть следующим образом:
{
"version": 1,
"language": "java",
"annotations": [
{
"type": "method",
"namespace_name": "com.example",
"type_name": "MyClass",
"method_name": "getUserInput",
"returns": {
"attributes": [ "common_source " ]
}
}
]
}В данном случае для первого параметра нет аннотаций. Также при подборе аннотации метода неважно, какой тип будет иметь первый параметр, поэтому его аннотация представлена пустым объектом.
Рассмотрим методы с различными параметрами:
package org.example;
public class Sink {
public void sink(String input) {
....
}
public void sink(String input, String sanitization) {
....
}
}Если мы считаем, что стоком является лишь первая версия метода, то её аннотация будет выглядеть следующим образом:
{
"language": "java",
"version": 1,
"annotations": [
{
"type": "method",
"package": "org.example",
"type_name": "Sink",
"method_name": "sink",
"params": [
{
"package": "java.lang",
"type_name": "String"
}
],
"attributes": [
"sql_injection_sink"
]
}
]}
Таким образом, в следующем фрагменте кода анализатор сформирует предупреждение лишь на один из вызовов метода:
package org.example;
public class Main {
public static void main(String[] args) {
var sinkObj = new Sink();
sinkObj.sink(args[0]); // V5309
sinkObj.sink(args[0], "sanitized"); // нет срабатывания
}
}По мере развития анализатора или изменения анализируемого кода ложное предупреждение может перестать генерироваться, и маркеры подавления, содержащиеся в строках исходного кода для этого предупреждения, перестанут быть актуальными.
Накопление неактуальных маркеров подавления засоряет код и может привести к тому, что появившееся в том же месте новое предупреждение останется незамеченным.
Для очистки кодовой базы от неактуальных маркеров в пакете поставки анализатора PVS-Studio предусмотрена специальная утилита — pvs-fp-cleaner.
Анализатор PVS-Studio для подавления ложноположительных (false positive) предупреждений поддерживает управляющие комментарии вида:
//-Vwarning-number
где warning-number — номер диагностического правила.
Примеры маркеров подавления:
if (a == b && a == b && 0 / 0 == 0) //-V501 //-V609Если для подавления ложного срабатывания используется механизм хэш-кода, то для удаления также рассматриваются следующие маркеры:
//-VH"hash"
где hash — hash-код строки без учета комментариев.
Пример маркера с хэш-кодом:
if (a == b && a == b && 0 / 0 == 0) //-V501 //-V609 //-VH"12345678"Первый шаг для удаления неактуальных маркеров — проведение полного анализа проекта в специальном режиме.
На текущий момент сбор информации возможен только с помощью утилит pvs-studio-analyzer / CompilerCommandsAnalyzer.
Утилита pvs-studio-analyzer / CompilerCommandsAnalyzer:
pvs-studio-analyzer analyze --redundant-false-alarms=/path/to/report.json \
--sourcetree-root=/path/to/project-root \
....В результате будет сформирован отчёт о неактуальных маркерах подавления.
Необходимые флаги:
redundant-false-alarms — путь до генерируемого отчёта о неактуальных маркерах подавления;sourcetree-root — флаг для указания корневой директории (/path/to/project) проекта для составления относительных путей.Для автоматического удаления неактуальных маркеров подавления из кодовой базы в составе дистрибутива предоставляется утилита pvs-fp-cleaner.
При анализе кода на разных платформах, генерируемые анализатором предупреждения могут отличаться. Поэтому для кроссплатформенных проектов необходимо получить по экземпляру отчёта на каждую платформу и указать все отчёты в параметрах запуска утилиты очистки.
После анализа проекта и получения отчёта можно запустить утилиту очистки, указав следующие аргументы:
pvs-fp-cleaner cleanup \
--sourcetree-root=/path/to/project \
PATH...где:
cleanup — режим работы утилиты;PATH... — список путей к отчётам о неактуальных маркерах подавления;sourcetree-root — путь к корневой директории проекта для преобразования относительных путей из отчётов с разных платформ.Пример запуска:
pvs-fp-cleaner cleanup \
--sourcetree-root=/home/user/project \
/home/user/windows_report.json \
/home/user/linux_report.json \
/home/user/macOS_report.jsonЗапуск утилиты в режиме автоматического удаления неактуальных маркеров рекомендуется производить для кодовой базы, отслеживаемой системой контроля версий (Git, SVN, Mercurial и т.п.). Если проект не управляется такой системой, то крайне желательно сделать резервную копию исходных файлов.
При необходимости слияния нескольких отчётов о неактуальных маркерах, например, для кроссплатформенного проекта, можно также воспользоваться утилитой pvs-fp-cleaner.
pvs-fp-cleaner merge \
--sourcetree-root=/path/to/project \
--output-file=/path/to/merged_report.json \
PATH...где:
merge — режим работы утилиты;sourcetree-root — путь к корневой директории проекта для преобразования относительных путей из отчётов с разных платформ. Также используется для того, чтобы производить слияние информации на одинаковых файлах при анализе с разных платформ;output-file — путь до результирующего отчёта после слияния;PATH... — список путей к отчётам о неактуальных маркерах подавления.Пример запуска:
pvs-fp-cleaner merge \
--sourcetree-root=/home/user/project \
--output-file=/home/user/merged_report.json \
/home/user/windows_report.json \
/home/user/linux_report.json \
/home/user/macOS_report.jsonПеред удалением маркеров подавления может быть полезно оценить масштаб изменений в кодовой базе. С помощью утилиты можно сформировать отчёт для предварительного просмотра найденных неактуальных маркеров.
Получить такой отчёт можно с помощью режима report:
pvs-fp-cleaner report \
--sourcetree-root=/home/user/project \
--output-file=/home/user/report_for_IDE_plugin.json \
PATH...где:
report — режим работы утилиты;sourcetree-root — путь к корневой директории проекта для преобразования относительных путей из отчётов с разных платформ. В режиме report является обязательным только при формировании отчёта из "сырых" отчётов ядер;output-file — путь до результирующего отчёта;PATH... — список путей к отчётам о неактуальных маркерах подавления.Сформированный отчёт можно открыть в IDE с помощью предоставляемых плагинов:
Наряду со многими другими способами фильтрации и подавления диагностических сообщений, в PVS-Studio есть предопределённый макрос PVS_STUDIO.
Первый случай, когда он может пригодиться — чтобы какой-то код не попадал в анализатор на проверку. Например, анализатор выдаёт диагностическое сообщение на такой код:
int rawArray[5];
rawArray[-1] = 0;Однако, если его "обернуть" с помощью этого макроса, то сообщения не будет:
int rawArray[5];
#ifndef PVS_STUDIO
rawArray[-1] = 0;
#endifВторой случай — переопределение стандартных и пользовательских макросов. Например, на следующем коде будет выдано предупреждение о разыменовании потенциально нулевого указателя:
char *st = (char*)malloc(10);
TEST_MACRO(st != NULL);
st[0] = '\0'; //V522Чтобы подсказать анализатору, что выполнение программы прерывается при неверном условии, можно переопределить макрос следующим образом:
#ifdef PVS_STUDIO
#undef TEST_MACRO
#define TEST_MACRO(expr) if (!(expr)) throw "PVS-Studio";
#endif
char *st = (char*)malloc(10);
TEST_MACRO(st != NULL);
st[0] = '\0';Этот способ позволяет устранить предупреждения анализатора на коде, тестируемом с помощью разных библиотек, а также на любых других макросах, использующихся для отладки и тестирования.
См. также обсуждение "Mark variable as not NULL after BOOST_REQUIRE in PVS-Studio" на сайте StackOverflow.com.
Начиная с версии 7.30, в PVS-Studio были добавлены макросы PVS_STUDIO_MAJOR и PVS_STUDIO_MINOR, которые отражают мажорную и минорную версии ядра анализатора.
При помощи этих макросов можно настраивать поведение анализа для блока кода в зависимости от версии анализатора. Например, можно включать или отключать диагностические правила только для определённых версий PVS-Studio:
// Auxiliary macros
#if defined(PVS_STUDIO) \
&& defined(PVS_VERSION_MAJOR) \
&& defined(PVS_VERSION_MINOR) \
#define PVS_VERSION_MACROS_INTRODUCED 1
#define PVS_MAKE_VERSION(major, minor) ( ((major) << 16) | (minor) )
#define PVS_CURRENT_VERSION \
PVS_MAKE_VERSION(PVS_VERSION_MAJOR, PVS_VERSION_MINOR)
#else
#define PVS_VERSION_MACROS_INTRODUCED 0
#endif
// ....
// Need to disable V691 on code block
#if PVS_VERSION_MACROS_INTRODUCED
#if PVS_CURRENT_VERSION < PVS_MAKE_VERSION(7, 35)
#pragma pvs(push)
#pragma pvs(disable: 591)
#endif
#endif
// code block
#if PVS_VERSION_MACROS_INTRODUCED
#if PVS_CURRENT_VERSION < PVS_MAKE_VERSION(7, 35)
#pragma pvs(pop)
#endif
#endifМакросы PVS_STUDIO, PVS_STUDIO_MAJOR и PVS_STUDIO_MINOR будут автоматически подставлены при проверке кода из IDE и утилит PVS-Studio_Cmd.exe, pvs-studio-analyzer / CompilerCommandsAnalyzer. Если же для проверки проекта вы используете прямой вызов ядра анализатора, то по умолчанию макросы не передаются анализатору, и это нужно сделать вручную.
Многие инструменты PVS-Studio используют XML-файл для хранения конфигурации.
Такой файл может использоваться неявно (глобальный файл Settings.xml, расположенный в специальном каталоге), или передаваться явно инструментам PVS-Studio через специальный флаг.
По умолчанию инструменты PVS-Studio используют глобальный файл конфигурации Settings.xml, расположенный:
Глобальный файл конфигурации используется практически всеми инструментами PVS-Studio, если им не передан альтернативный файл. Ниже перечислены инструменты, которые не используют глобальный файл конфигурации:
Примечание: Плагины PVS-Studio для Visual Studio, Rider и CLion, а также утилита C and C++ Compiler Monitoring UI используют только глобальный файл Settings.xml.
Вы можете вынести настройки анализа для проекта в специальный XML-файл, который затем может быть передан консольным инструментам PVS-Studio через специальный флаг.
Обратите внимание: чтобы не допустить ошибку при написании файла конфигурации, мы рекомендуем скопировать глобальный файл Settings.xml и модифицировать его.
Ниже приведены примеры запуска утилит со специальным файлом конфигурации CustomSettings.xml (вы можете назвать его так, как вам удобно).
Для утилиты PVS-Studio_Cmd.exe:
PVS-Studio_Cmd.exe -t "path\to\Solution.sln" ... \
--settings "path\to\CustomSettings.xml"CLMonitor.exe [analyze|monitor|analyzeFromDump|trace] ... \
--settings "\path\to\CustomSettings.xml"Для утилиты BlameNotifier.exe:
BlameNotifier.exe "path\to\PVS-Studio.plog" \
--VCS Git \
--recipientsList "path\to\recipients.txt" \
--server ... --sender ... \
--login ... --password ... \
--settings "path\to\CustomSettings.xml"Для утилиты PlogConverter.exe (only Windows):
PlogConverter.exe -t json ... --settings "path\to\CustomSettings.xml" \
"path\to\PVS-Studio.plog"Файл конфигурации имеет формат XML со следующей структурой:
<?xml version="1.0" encoding="utf-8"?>
<ApplicationSettings>
...
<Tag>Value</Tag>
...
</ApplicationSettings>Вместо Tag записывается идентификатор опции (например, FileMasks), а вместо Value — её значение. Описание доступных опций и их значений будет приведено ниже.
Значения опций могут быть следующих типов:
Далее будет дано описание ключевых опций файла конфигурации и области их применения.
Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег описывает список файловых масок, которые будут применены для исключения файлов из анализа. Маски данного типа используются только для фильтрации по именам файлов, без учета директорий. Вы можете указать как полное имя файла, так и маску, используя wildcard-символы: '*' - любое число символов, '?' - один любой символ.
Тег FileMasks принимает список тегов <string>, каждый из которых содержит файловую маску.
Например, следующая запись исключает все файлы SourceTest.cpp и C*Test.cpp из анализа:
<FileMasks>
<string>SourceTest.cpp</string>
<string>C*Test.cpp</string>
</FileMasks>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег описывает список Path-масок, используемых для исключения каталогов из анализа. Маски данного типа позволяют исключить файлы из анализа на основе их расположения.
Тег PathMasks принимает список тегов <string>, каждый из которых содержит маску пути.
Например, следующая запись исключит все cpp и hpp файлы, расположенные в каталогах ThirdParty и Tests:
<PathMasks>
<string>*/ThirdParty/*.?pp</string>
<string>*/Tests/*.?pp</string>
</PathMasks>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio.
Данная опция отключает синхронизацию suppress-файлов между проектами одного решения. Это может быть полезно, если вы хотите, чтобы сообщение, подавленное в одном проекте, не подавлялось в других.
Тег DisableSynchronizeSuppressFiles может принимать одно из двух значений: true, false. Если установлено значение true, то автоматическая синхронизация suppress-файлов отключена. По умолчанию устанавливается значение false.
Пример:
<DisableSynchronizeSuppressFiles>true</DisableSynchronizeSuppressFiles>Используется в: PlogConverter.exe (Windows), BlameNotifier, IDE плагины для Visual Studio и Rider
Тег задаёт список диагностик, которые должны быть скрыты в отчёте при его просмотре в IDE плагине PVS-Studio.
Тег DisableDetectableErrors принимает список диагностических правил, разделённый пробелами. Обратите внимание, что после последнего кода должен быть также указан пробел.
Данная опция используется утилитами PlogConverter.exe (Windows) и BlameNotifier ещё и для исключения предупреждений из результирующего отчёта.
Например, можно использовать такую запись, чтобы исключить не интересующие вас диагностики при конвертации отчёта с помощью PlogConverter.exe:
<DisableDetectableErrors>V126 V203 V2001 V2006 </DisableDetectableErrors>Таким образом, вы можете передать файл *.xml в PlogConverter.exe через флаг --setting и получить отчёт без предупреждений V126, V203, V2001, V2006.
Используется в: PVS-Studio_Cmd, CLMonitor, BlameNotifier, IDE плагины для Visual Studio, Rider и СLion.
Тег задает имя пользователя анализатора, привязанное к лицензионному ключу, необходимое для проверки валидности лицензии.
Примечание: вы можете игнорировать данный тег в специальном файле настроек, если вы уже выполняли активацию. Тогда PVS-Studio будет искать лицензионные данные в глобальном файле Settings.xml.
Пример:
<UserName>Name</UserName>Используется в: PVS-Studio_Cmd, CLMonitor, BlameNotifier, IDE плагины для Visual Studio, Rider и СLion.
Тег задаёт лицензионный ключ для проверки валидности лицензии.
Примечание: вы можете игнорировать данный тег в специальном файле настроек, если вы уже выполняли активацию. Тогда PVS-Studio будет искать лицензионные данные в глобальном файле Settings.xml.
Пример:
<SerialNumber>XXXX-XXXX-XXXX-XXXX</SerialNumber>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Данный тег включает/выключает автоматическое удаление временных файлов анализатора, таких как файлы конфигурации ядра анализатора и препроцессированные файлы.
Тег RemoveIntermediateFiles принимает значение true или false. Если true, все временные файлы будут удалены.
По умолчанию принимает значение true. Сохранение временных файлов бывает полезным при исследовании проблем работы анализатора.
Пример:
<RemoveIntermediateFiles>false</RemoveIntermediateFiles>Используется в: PVS-Studio_Cmd, IDE плагины для Visual Studio.
Тег позволяет включать отображение источников подавления предупреждений. Опция помогает узнать, какие механизмы учaствуют в отключении диагностик.
Тег ReportDisabledRules принимает значение true или false. Если true, то отчёт будет содержать сообщения с кодом V012 и информацией об источниках отключения диагностик.
По умолчанию установлено значение false.
Пример:
<ReportDisabledRules>true</ReportDisabledRules>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и СLion.
Тег отключает группу 64-битных диагностик. Диагностические правила из отключённой группы не будут применены.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<Disable64BitAnalysis>true</Disable64BitAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и СLion.
Тег отключает группу диагностик общего назначения для C и C++ (General Analysis).
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableGAAnalysis>true</DisableGAAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег отключает группу диагностик микрооптимизаций для C и C++.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableOPAnalysis>true</DisableOPAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег отключает группу специфичных диагностических правил, добавленных по просьбе пользователей (Customer Specific), для C и C++.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableCSAnalysis>true</DisableCSAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и СLion.
Тег отключает группу диагностик, проверяющих C и C++ код на соответствие стандартам MISRA.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableMISRAAnalysis>true</DisableMISRAAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и СLion.
Тег отключает группу диагностик, проверяющих C++ код на соответствие стандартам AUTOSAR.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableAUTOSARAnalysis>true</DisableAUTOSARAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и СLion.
Тег отключает группу диагностик, проверяющих C и C++ код на соответствие стандарту OWASP ASVS.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableOWASPAnalysis>true</DisableOWASPAnalysis>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и Rider.
Тег отключает группу диагностик, проверяющих C# код на соответствие стандарту OWASP ASVS.
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableOWASPAnalysisCs>true</DisableOWASPAnalysisCs>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio и Rider.
Тег отключает группу диагностик общего назначения для C# (General Analysis).
Если установлено значение true, все диагностики этой группы будут отключены.
Пример:
<DisableGAAnalysisCs>true</DisableGAAnalysisCs>Используется в: PVS-Studio_Cmd, IDE плагины для Visual Studio.
Включение данной настройки позволяет выполнять действия, записанные в секции Custom Build Step проектного файла Visual Studio (vcproj/vcxproj), перед запуском анализа. Заметим, что анализатору для корректной работы необходим компилирующийся код. Так, например, если Custom Build Step используется для генерации *.h файлов перед компиляцией, его необходимо будет выполнить (включив данную настройку) и перед анализом проекта.
Тег PerformPreBuildStep принимает значение true/false.
Если значение true, настройка включена.
Пример:
<PerformPreBuildStep>true</PerformPreBuildStep>Используется в: PVS-Studio_Cmd, CLMonitor, BlameNotifier, IDE плагины для Visual Studio.
Тег включает автоматический импорт настроек (xml-файлов) из каталога '%APPDATA%\PVS-Studio\SettingsImports'. При импорте настройки-флаги (true\false), а также настройки, хранящие одно значение (например, строку), заменяются настройками из 'SettingsImports'. Настройки, имеющие несколько значений (например, исключаемые директории), объединяются.
При наличии в папке 'SettingsImports' нескольких xml-файлов, эти файлы будут применены к текущим настройкам последовательно по порядку, в соответствии с их именем.
Тег AutoSettingsImport принимает значение true/false.
Если значение true, автоматический импорт включён.
Пример:
<AutoSettingsImport>true</AutoSettingsImport>Используется в: PVS-Studio_Cmd, IDE плагины для Visual Studio.
Тег отключает генерацию предупреждений низкого уровня достоверности.
Если установлено значение true, в отчёт не попадут сообщения 3-го уровня достоверности.
Пример:
<NoNoise>false</NoNoise>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion
Тег устанавливает количество параллельно запускаемых процессов ядра анализатора, которые будут задействованы при анализе. По умолчанию устанавливается значение, равное количеству ядер процессора.
Обратите внимание, что не рекомендуется задавать значение данной настройки больше, чем количество процессорных ядер. Также стоит учесть, что для не Enterprise-лицензий действует ограничение в 16 ядер.
Пример:
<ThreadCount>8</ThreadCount>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Опция позволяет указать корневую часть пути до исходных файлов в отчёте анализатора. При формировании отчёта корневая часть будет заменена на специальный маркер |?|. По умолчанию данная опция пуста и анализатор всегда генерирует отчёт с абсолютными путями до файлов. Настройка позволяет получить отчёт анализатора с относительными путями, который затем можно использовать на машинах с отличающимся расположением проверяемых исходных файлов.
Пример:
<SourceTreeRoot>D:\ProjectRoot\</SourceTreeRoot>Подробнее об этом можно узнать в разделе документации "Использование относительных путей в файлах отчётов PVS-Studio".
Используется в: PVS-Studio_Cmd, IDE плагины для Visual Studio, Rider и СLion.
Тег позволяет включить использование каталога решения в качестве значения SourceTreeRoot.
Если значение true, то часть пути, содержащая путь до каталога решения, будет заменена на специальный маркер, параметр SourceTreeRoot будет проигнорирован.
Пример:
<UseSolutionDirAsSourceTreeRoot>false</UseSolutionDirAsSourceTreeRoot>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег задает время, по истечению которого анализ файла будет прерван. Параметр может принимать следующие значения:
Обратите внимание, что снятие временного ограничения может привести к зависанию анализа.
Пример:
<AnalysisTimeout>After_10_minutes</AnalysisTimeout>Используется в: PVS-Studio_Cmd, IDE плагины для Visual Studio, Rider и СLion.
Тег задаёт ограничение по времени для инкрементального анализа. Возможные значения:
Обратите внимание, что снятие ограничения может привести к зависанию анализа.
Пример:
<IncrementalAnalysisTimeout>After_2_minutes</IncrementalAnalysisTimeout>Используется в: PVS-Studio_Cmd, IDE плагин для Visual Studio.
Тег включает добавление маркировки по ГОСТ Р 71207-2024 в поле сообщений SAST. Возможные значения:
Пример:
<SecurityRelatedIssues>true</SecurityRelatedIssues>Используется в: PVS-Studio_Cmd, CLMonitor, IDE плагины для Visual Studio, Rider и СLion.
Тег отключает новый парсер для C++ анализатора и возвращает старый парсер. Выставьте значение наситройки в true, если у вас возникли проблемы с C++ анализатором.
Возможные значения:
Пример:
<UseOldCppParser>true</UseOldCppParser>При разработке PVS-Studio простота использования ставилась во главу угла. Мы учли наш опыт общения с традиционными lint-подобными анализаторами кода. Именно поэтому возможность сразу же приступить к работе является одним из основных преимуществ PVS-Studio по сравнению с другими анализаторами кода. Кроме того, PVS-Studio проектировалась так, чтобы разработчику, который будет использовать анализатор, вообще не пришлось его настраивать. Эту задачу удалось решить: разработчик имеет мощнейший анализатор кода, который нет необходимости настраивать при первом запуске.
Однако надо понимать, что анализатор кода - это мощный инструмент, который нуждается в грамотном применении. Именно грамотное применение анализатора (благодаря системе настроек) позволяет добиться по-настоящему значительных результатов. Работа с анализатором кода предполагает, что есть инструмент (программа), которая делает рутинную работу по поиску потенциально опасных конструкций в коде, и есть мастер (разработчик), который на основе знаний о проверяемом проекте может принимать те или иные решения. Так, например, разработчик может сообщить анализатору о том, что:
Корректная настройка данных параметров может во много раз уменьшить количество диагностических сообщений, выдаваемых анализатором кода. Это означает, что если разработчик поможет анализатору и сообщит ему некоторую дополнительную информацию в виде настроек, то анализатор, в свою очередь, значительно сократит количество мест, на которые разработчик должен будет обратить внимание при анализе результатов проверки.
Настройки PVS-Studio можно открыть через команду главного меню IDE: PVS-Studio -> Options. Выбрав эту команду, Вы увидите диалог настройки PVS-Studio.
Каждая страница настроек подробно описана в документации к PVS-Studio.
На вкладке общих настроек анализатора кода указываются настройки, не зависящие от конкретного используемого модуля анализа.
Анализатор может автоматически проверять наличие своей новой версии на сайте PVS-Studio. Для этого используется собственный модуль обновления.
В случае, если опция CheckForNewVersions имеет значение True, то при запуске проверки кода (команды Check Current File, Check Current Project, Check Solution меню PVS-Studio) выполняется загрузка специального текстового файла с сайта PVS-Studio. В этом файле указан номер самой последней версии PVS-Studio, доступной на сайте. Если версия на сайте окажется новее, чем версия, установленная у пользователя, то пользователь увидит запрос на обновление. В случае разрешения этого обновления, будет запущено специальное отдельное приложение PVS-Studio-Updater, которое автоматически загрузит новый дистрибутив PVS-Studio с сайта и запустит его установку. В случае, если опция CheckForNewVersions установлена в False, проверка новой версии производиться не будет.
Анализ файлов выполняется быстрее на многоядерных машинах. Так, на четырех-ядерном компьютере анализатор может использовать все четыре ядра для своей работы. Однако, если по каким-то причинам надо ограничить количество используемых ядер, то это вполне можно сделать, указав допустимое количество. По умолчанию устанавливается значение, равное минимальному числу из количества ядер процессора или количества оперативной памяти, поделённой на два.
Задание для настройки 'ThreadCount' значения, большего '16' (или большего, чем количество ядер процессора, если у процессора более 16 ядер), доступно только при наличии Enterprise лицензии. Вы можете запросить пробную Enterprise лицензию здесь.
При запуске анализа на одной машине, мы не рекомендуем задавать значение этой настройки более, чем количество процессорных ядер. Задание большего значения может замедлить анализ в целом. Если вы хотите запускать больше одновременных задач анализа, вы можете воспользоваться системой распределённой сборки, например, Incredibuild. Подробнее про такой режим использования PVS-Studio можно почитать в соответствующем разделе документации.
Для своей работы анализатор создает большое количество временных командных файлов для запуска собственно модуля анализа, выполнения препроцессинга и управления общим процессом анализа. Подобные файлы создаются для каждого анализируемого файла проекта. Обычно они не представляют интереса для пользователя и поэтому после анализа сразу же удаляются. Однако, в некоторых случаях может быть полезно посмотреть на эти файлы. Поэтому можно указать анализатору не удалять их. В таком случае можно будет запускать анализатор вне IDE из командной строки.
Данная страница настроек позволяет управлять отображением типов сообщений анализатора в списке результатов PVS-Studio.
Все диагностические предупреждения анализатора разделены на несколько групп. Отображением каждого типа сообщений (показывать/скрывать) можно управлять по отдельности, а для всей группы сообщений можно выполнить следующие действия:
Иногда бывает целесообразно убрать в отчете ошибки с определенными кодами. Например, если вы уверены, что ошибки с кодом V505 и V506 вас не интересуют, то вы можете скрыть их показ, сняв галочку в соответствующей строчке.
Обратите внимание! При включении "Show All" и "Hide All" нет необходимости перезапускать анализ проекта заново. Анализатор всегда выдаёт все типы ошибок, при этом показ тех или иных ошибок задается настройками на этой странице. При включении/выключении отображения ошибок, они сразу будут показаны/скрыты в отчете без перезапуска анализа всего проекта.
Полное отключение группы диагностик (Disabled) можно использовать для того, чтобы ускорить работу анализатора и получить файлы с отчетами (plog-файлы) меньшего размера.
На вкладке "Don't Check Files" настроек можно ввести файловые маски для исключения некоторых файлов или папок из анализа. Анализатор не будет проверять файлы, удовлетворяющие условиям масок.
Например, подобным образом можно исключить из анализа автогенерируемые файлы. Кроме того, можно исключить файлы по имени папки, в которой они находятся.
Маска задается с помощью специальных wildcard символов: "*" (раскрывается в любое количество произвольных символов) и "?" (раскрывается в один произвольный символ).
Регистр символов не имеет значения. Символ "*" может быть добавлен в любой части маски. После задания масок вида '*\mask\*', сообщения из соответствующих им файлов исчезнут из окна вывода PVS-Studio, а в следующую проверку они включены уже не будут. Таким образом, исключение файлов и директорий посредством масок может позволить существенно сократить общее время анализа всего проекта.
Примечание: маски вида 'a*b' будут применены только после перезапуска анализа.
В окне можно задавать 2 типа масок: маски по путям (Path Mask) и маски по именам файлов (FileName Mask). Маски, заданные в списке FileNameMasks, используются для фильтрации сообщений только непосредственно по именам файлов, без учёта директории, в которой эти файлы находятся. Маски из списка PathMasks фильтруют диагностические сообщения с учётом расположения фалов в файловой системе на диске и позволяют подавлять сообщения как для отдельных файлов, так и для целых директорий и поддиректорий. Так, для фильтрации сообщений в одном конкретном файле, полный путь до него необходимо добавить в список PathMasks, а для фильтрации всех файлов с одинаковыми (либо удовлетворяющими wildcard маске) именами можно добавить такое имя или маску в список FileNameMasks.
Примеры допустимых масок для списка FileNameMasks:
Примеры допустимых масок для списка PathMasks:
Примечание. Если в PathMasks символы "*" не указаны, они все равно будут автоматически добавлены.
На вкладке подавления отдельных сообщений по ключевым словам можно настроить фильтрацию ошибок по содержащемуся в них тексту.
При необходимости можно скрыть из отчета сообщения о диагностированных ошибках, содержащих определенные слова или фразы. Например, если в отчете есть ошибки, в которых указаны названия функций printf и scanf, а вы считаете, что ошибок, связанных с ними быть не может, то просто добавьте эти два слова с помощью редактора подавляемых сообщений.
Обратите внимание! При изменении списка скрываемых сообщений нет необходимости перезапускать анализ проекта заново. Анализатор всегда генерирует все диагностические сообщения, при этом показ тех или иных диагностических сообщений управляется с помощью этой страницы настроек. При модификации фильтров сообщений изменения сразу же покажутся в отчете без перезапуска анализа всего проекта.
Откройте страницу настроек PVS-Studio (PVS-Studio Menu -> Options...).
На вкладке регистрации вводится лицензионная информация.
После покупки анализатора вы получите регистрационную информацию: имя пользователя анализатора, привязанное к ключу, и лицензионный ключ. Эти данные должны быть введены на этой странице. При этом в поле LicenseType будет указан режим лицензирования.
Информацию по условиям лицензирования смотрите на странице заказа на сайте.
На вкладке Specific Analyzer Settings размещены дополнительные расширенные настройки анализатора.
Настройка позволяет совсем отключить прерывание анализа по лимиту времени или задать лимит времени, по истечении которого анализ отдельных файлов завершается с ошибкой V006. File cannot be processed. Analysis aborted by timeout. Перед изменением рекомендуем внимательно ознакомиться с описанием ошибки по указанной выше ссылке. Часто таймаут возникает из-за нехватки оперативной памяти. В этом случае рационально не увеличивать время, а уменьшить количество используемых параллельных потоков. Это может дать существенный прирост производительности, когда процессорных ядер много, а оперативной памяти мало.
Настройка отключает генерацию предупреждений низкого уровня достоверности (Low Certainty, 3-ий уровень предупреждений). После перезапуска анализа сообщения этого уровня пропадут из вывода анализатора.
Позже можно выключить режим No Noise: при следующем анализе все пропавшие ранее предупреждения станут вновь доступны.
Настройка отключает новый парсер для C++ анализатора и возвращает старый. Включите её, если у вас возникли проблемы с C++ анализатором.
Настройка позволяет включать вывод исключений правил анализатора, которые можно указать с помощью комментариев в файле .pvsconfig.
Настройка отключает подстановку параметров шаблона при анализе C++. Это снижает потребление оперативной памяти, но анализ становится менее тщательным.
Включение настройки позволяет в столбце SAST в результатах анализа выделить дополнительной маркировкой предупреждения, относящиеся к потенциальным проблемам безопасности и классифицируемые согласно ГОСТ Р 71207-2024.
Настройка определяет режим отслеживания исходных файлов в кэше зависимостей:
Примечание. Начиная с версии PVS-Studio 7.26, настройка убрана. Теперь, чтобы запустить межмодульный анализ для С и С++ проектов, используйте меню запуска анализа.
Включение настройки позволяет анализатору учитывать информацию не только из анализируемого файла, но и из связанных с ним файлов. Это позволяет производить более глубокий и качественный анализ, но увеличивает время проверки.
Режим актуален для C и C++ проектов. C# проекты обеспечивают межмодульный анализ по умолчанию.
Настройка отключает инкрементальный анализ исходных файлов кода на C и C++, затрагиваемых изменениями в предварительно компилируемом заголовочном файле и заголовочных файлах, включённых в него. Полезна в ситуациях, когда эти файлы часто меняются, и из-за этого время инкрементального анализа значительно увеличивается.
При изменении настройки из IDE Visual Studio изменения вступят в силу после следующего открытия решения или проекта. Если анализ запускается через консольную утилиту PVS-Studio_Cmd, то анализатор сразу задействует настройку.
Настройка позволяет задать лимит времени, по истечении которого инкрементальный анализ файлов остановится. Все предупреждения, обнаруженные на момент остановки анализа, будут выданы в окне PVS-Studio. Дополнительно к ним будет выдано предупреждение, что анализатор не успел обработать все изменённые файлы, а также информация о суммарном и проанализированном количестве файлов.
Опция актуальна только при работе из IDE Visual Studio.
Настройка позволяет выбрать версию стандарта MISRA. Для C доступны версии 2012 и 2023.
Включение настройки позволяет перед запуском анализа выполнять действия, записанные в секции Custom Build Step проектного файла Visual Studio (.vcproj/.vcxproj). Для корректной работы анализатору необходим компилирующийся код. Например, если Custom Build Step используется для генерации .h файлов перед компиляцией, необходимо включить настройку и выполнить код перед анализом проекта. Если же на данном шаге выполняются действия, относящиеся, например, к линковке, они не повлияют на результат работы анализатора. Действия Custom Build Step задаются на уровне проекта и будут выполнены PVS-Studio при первоначальном обходе дерева проектов. Если настройка включена и в результате её выполнения получен ненулевой код, проверка такого проекта не будет запущена.
Включение настройки позволяет автоматически выполнять checkout с использованием Team Foundation Version Control Tool при редактировании файлов, содержащих подавленные предупреждения анализатора (.suppress файлы). Её включение не повлияет на работу с проектами, которые не находятся под управлением системы контроля версий TF или не добавлены в workspace Visual Studio.
Дополнительная информация, в случае её наличия (в т.ч. информация об ошибках), будет выводиться в окно PVS-Studio.
Данная опция актуальна только при работе из IDE Visual Studio.
Пометка сообщения как ложного срабатывания. Требует внесения изменений в файлы с исходным кодом. Анализатор по умолчанию сохраняет каждый файл с исходным кодом после пометки. Однако если подобное частое сохранение нежелательно (например, если файлы находятся на другой машине локальной сети), оно может быть отключено с помощью этой настройки.
Изменение настройки требует осторожности, т.к. отсутствие сохранений файлов с исходным кодом после их разметки на ложные срабатывания может привести к потере результатов работы в случае закрытия среды разработки.
Настройка позволяет включить отображение сообщений, размеченных как False Alarms, в окне вывода PVS-Studio. Она будет применена в окне сообщений PVS-Studio сразу, без необходимости запускать анализ повторно. Когда выставлено значение true, специальный индикатор FA, отображающий количество ложных срабатываний, появится на панели окна вывода.
Настройка включает добавление дополнительного хэш-кода к метке ложного срабатывания. Хэш-код вычисляется на основе содержимого строки кода. Если строка кода изменится, предупреждения с тем же хэш-кодом, выданные для этой строки, больше не будут считаться ложными срабатываниями.
Настройка отключает автоматическую синхронизацию suppress-файлов между проектами в рамках одного решения.
По умолчанию синхронизация suppress-файлов включена. Если какой-либо файл исходного кода используется в нескольких проектах, и предупреждения из этого файла были добавлены в suppress-файл хотя бы одного проекта, то при анализе других проектов эти предупреждения автоматически будут дописаны в их suppress-файлы.
Настройка позволяет задать язык для встроенной справки по диагностическим сообщениям (клик по коду ошибки в окне вывода сообщений PVS-Studio) и документации (команда меню PVS-Studio > Help > Open PVS-Studio Documentation (html, online)) PVS-Studio, доступных на нашем сайте.
Настройка не меняет язык интерфейса IDE плагина PVS-Studio или выдаваемых анализатором диагностических сообщений.
Настройка позволяет использовать оффлайн-справку по диагностическим сообщениям (клик по коду ошибки в окне вывода сообщений PVS-Studio).
Опция отвечает за отображение кнопки Best в интерфейсе PVS-Studio. По умолчанию опция включена, и кнопка Best доступна в таблице срабатываний. Используя её, можно просмотреть 10 наиболее интересных предупреждений анализатора. Вы можете скрыть эту кнопку, определив данный параметр как False.
Настройка позволяет управлять уведомлениями о работе анализатора PVS-Studio. После завершения анализа в случае, если окно PVS-Studio Output содержит сообщения об ошибках (они могут быть скрыты фильтрами как ложные срабатывания, по именам проверяемых файлов и т.п.; такие сообщения не попадают в окно PVS-Studio), анализатор проинформирует об их наличии с помощью всплывающего сообщения в области уведомления Windows (notification area, system tray). Одинарный щелчок мыши сообщению либо по значку PVS-Studio откроет окно вывода сообщений PVS-Studio с найденными ошибками.
Настройка задаёт режим отображения уровней сообщений в окне PVS-Studio Output для результатов работы инкрементального анализа. Установка в данном поле глубины уровня отображения (соответственно, только 1 уровень; 1 и 2 уровни; 1, 2 и 3 уровни) приведёт к их автоматическому включению после завершения инкрементального анализа. Значение Preserve_Current_Levels сохранит существующие настройки уровней без изменений.
Опция может быть полезна при регулярном совместном использовании инкрементального и обычного режимов запуска, т.к. случайное отключение, например, 1 уровня анализа при просмотре большого отчёта обычной проверки приведёт к сокрытию результатов работы уже инкрементального анализа. Поскольку инкрементальный анализ работает в фоновом режиме, подобная ситуация может привести к потере диагностик о реальных ошибках, найденных анализатором в этом режиме работы.
Настройка задаёт режим трассировки (протоколирования хода выполнения программы) для IDE-пакета расширения PVS-Studio (плагина для сред Visual Studio). Трассировка имеет несколько уровней детализации вывода (режим Verbose соответствует наиболее подробному протоколированию). При включении режима трассировки PVS-Studio автоматически создаёт лог-файл в директории AppData\PVS-Studio с расширением .log (например, c:\Users\admin\AppData\Roaming\PVS-Studio\PVSTrace2168_000.log). При этом каждый запущенный процесс IDE будет использовать отдельный лог-файл для сохранения результатов своей трассировки.
Настройка позволяет включить автоматический импорт настроек (.xml-файлов) из директории %AppData%\PVS-Studio\SettingsImports\. Настройки импортируются при каждой загрузке сохранённых настроек, т.е. при запуске Visual Studio или command line версии анализатора, при сбросе настроек и т.п. При импорте настройки-флаги (true/false), а также настройки, хранящие одно значение (например, строку), заменяются настройками из SettingsImports. Настройки, имеющие несколько значений (например, исключаемые директории), объединяются.
При наличии в папке SettingsImports нескольких .xml-файлов, они будут применены к текущим настройкам в соответствии с алфавитным порядком.
По умолчанию PVS-Studio предлагает сохранять файл отчёта (.plog) в той же папке, что и .sln-файл.
Изменение настройки позволяет восстановить стандартное поведение файловых диалогов Windows, т.е. диалог будет помнить последнюю открытую в нём папку и использовать именно её в качестве начальной.
Настройка задаёт, как будет отображаться запрос на сохранение отчёта работы анализатора перед началом нового анализа или загрузкой другого отчёта в случае, если окно вывода уже содержит новые, несохранённые или модифицированные результаты работы анализатора. Установка настройки Yes включит автоматическое сохранение результатов в текущий файл отчёта (после того, как он в первый раз будет указан в диалоге о сохранении файла). После установки настройки No IDE-плагин будет перезаписывать текущие результаты работы анализатора без сохранения. Выбор значения Ask_Always (используется по умолчанию) приведёт к выдаче запроса на сохранение отчёта каждый раз, позволяя пользователю сделать выбор.
По умолчанию при генерации диагностических сообщений PVS-Studio выдаёт полные пути до файлов, в которых анализатор нашёл ошибки. С помощью настройки можно задать корневую часть пути, которую анализатор будет автоматически подменять на специальный маркер в случае, если путь до файла, на который сгенерировано сообщение, начинается с заданного корня. Например, абсолютный путь до файла C:\Projects\Project1\main.cpp будет заменён на относительный путь |?|Project1\main.cpp, если C:\Projects\, который был указан в качестве корня.
При работе с отчётом PVS-Studio, содержащем пути до файлов в относительной форме, IDE-плагин автоматически подставляет значение данной настройки вместо маркера |?|. Использование настройки позволит работать с фалом отчёта PVS-Studio на любой машине, имеющей доступ к проверенным исходникам, вне зависимости от их местоположения в файловой системе.
Детальное описание данного режима работы доступно здесь.
Настройка включает или выключает режим использования пути до папки, содержащей файл решения *.sln, в качестве параметра Source Tree Root.
Настройка позволяет автоматически загружать отчёт, полученный в результате анализа Unreal Engine проекта, в окно вывода сообщений PVS-Studio.
Опция актуальна только при работе из IDE Visual Studio.
Анализаторы языков Go, JavaScript и TypeScript, а также плагины PVS-Studio для Visual Studio Code, WebStorm и GoLand используют файл формата TOML для хранения конфигурации. Конфигурация может быть сохранена как на уровне конкретного пользователя, так и на уровне проекта. Для описания конфигурации используется TOML v1.0.0.
Файлы конфигурации могут использоваться неявно или через специальный флаг явно передаваться инструментам.
Путь до файла настроек уровня пользователя:
%APPDATA%/PVS-Studio LLC/PVS-Studio/pvs-settings.toml.$XDG_CONFIG_HOME/PVS-Studio LLC/PVS-Studio/pvs-settings.toml.Примечание. На Linux и macOS при отсутствии переменной окружения XDG_CONFIG_HOME файл настроек располагается по пути ~/.config/PVS-Studio LLC/PVS-Studio/pvs-settings.toml.
Настройки из файла конфигурации применяются автоматически при запуске анализа.
Минимальный файл конфигурации анализа может выглядеть следующим образом:
version = 1
[analyzers.all]
analysis-paths = [ "skip-analysis=*/tests/*" ]
rules = [ "ALL=on" ]
[analyzers.javascript]
analysis-paths.append = [ "skip-analysis=*/third-party/*" ]
rules.override = [ "ALL=off", "OWASP=on" ]В этом примере для всех анализаторов:
*/tests/*;*/third-party/*;Файлы конфигурации предполагают возможность создания иерархий настроек. Более специфичные настройки перезаписывают более базовые. Иерархия настроек от общих к специфичным выглядит следующим образом:
Файл настроек уровня пользователя находится по пути:
%APPDATA%/PVS-Studio LLC/PVS-Studio/pvs-settings.toml. $XDG_CONFIG_HOME/PVS-Studio LLC/PVS-Studio/pvs-settings.toml. Примечание. На Linux и macOS при отсутствии переменной окружения XDG_CONFIG_HOME файл настроек располагается по пути ~/.config/PVS-Studio LLC/PVS-Studio/pvs-settings.toml.
Файл настроек проекта находится в корневой директории проекта:
project/
├── src/
├── tests/
├── README.md
└── pvs-settings.tomlНастройки можно передать напрямую в CLI анализатора. В этом случае они будут иметь наибольший приоритет и переопределят настройки из файлов конфигураций:
pvs-js analyze --analysis-paths skip-analysis=*/test/* \
--rules ALL=off \
--rules GA=on \
/path/to/projectНастройки внутри файла конфигурации делятся на три типа: общие настройки, настройки плагинов ([plugins]) и настройки анализаторов ([analyzers]).
Настройки плагинов и анализаторов подразделяются на общие (секции [plugins.all] и [analyzers.all]) и специфичные.
К специфичным относятся следующие настройки:
[analyzers.javascript][analyzers.golang][plugins.VSCode][plugins.WebStorm][plugins.GoLand]Пример структуры файла уровня пользователя:
# Общие настройки
version = 1
[analyzers.all]
# Общие настройки для всех анализаторов
rules = [ "ALL=off", "OWASP=on" ]
[analyzers.golang]
# Настройки, специфичные для анализатора Go
rules.append = [ "GA=on" ]
[analyzers.javascript]
# Настройки, специфичные для анализатора JavaScript and TypeScript
analysis-paths.override = [ "skip-analysis=*/third-party/*" ]
[plugins.VSCode]
# Настройки, специфичные для плагина Visual Studio Code
show-false-alarms = true
show-best-warnings-button = false
[plugins.WebStorm]
# Настройки, специфичные для плагина WebStorm
show-false-alarms = false
show-best-warnings-button = true
[plugins.GoLand]
# Настройки, специфичные для плагина GoLand
show-false-alarms = false
show-best-warnings-button = trueПример структуры файла уровня проекта:
# Общие настройки
version = 1
# Преобразуем относительные пути через директорию 'src',
# которая находится в той же директории, что и файл проектных настроек
working-directory = 'src'
# Игнорируем пользовательские настройки для проекта
ignore-user-settings = true
[analyzers.all]
# Общие настройки для всех анализаторов
# Отключаем все правила, а затем включаем группу GA и OWASP
rules.override = [ "ALL=off", "GA=on", "OWASP=on" ]
# Исключаем из анализ директорию 'src/third-party'
analysis-paths = [ "skip-analysis=third-party" ]
[analyzers.golang]
# Настройки, специфичные для анализатора Go
# Дополнительно для анализатора Go отключаем правило V8018,
# все остальные правила из группы GA и OWASP активны
rules.append = [ "V8018=off" ]
[analyzers.javascript]
# Настройки, специфичные для анализатора JavaScript and TypeScript
# Дополнительно для анализатора JavaScript и TypeScript
# отключаем правило V7008, все остальные правила из группы
# GA и OWASP активны
rules.append = [ "V7008=off" ]На уровне пользовательской конфигурации каждая настройка, отражающая сущность "путь", должна принимать значение в виде абсолютного пути (начинается с корневой директории /).
Также путь может быть представлен в виде абсолютного glob-паттерна (начинается с корневой директории / или с символа подстановки (* или ?)).
На уровне проектной конфигурации каждая настройка, отражающая сущность "путь", должна принимать значение в виде относительного пути или любого glob-паттерна. Это необходимо для переносимости файла конфигурации между машинами.
Для некоторых настроек типа "массив" важен порядок передаваемых значений. Например, если в поле rules сначала включить диагностические правила общего назначения, а после выключить все правила, ни одно диагностическое правило не будет включено.
rules = ["GA=on", "ALL=off"]Начиная со специфичных настроек уровня пользователя, все настройки типа "массив" становятся таблицами с двумя возможными значениями:
override — полностью переопределяет более базовые настройки;append — дополняет новыми значениями более базовые настройки.Пример
В файле конфигурации уровня пользователя заданы файлы, исключаемые из анализа для всех анализаторов. Для JavaScript и TypeScript анализатора нужно исключить эти пути и ещё один дополнительный. Для Go анализатора эти пути, наоборот, должны попадать в анализ, а исключить нужно другие.
Файл конфигурации в таком случае будет выглядеть так:
version = 1
[analyzers.all]
analysis-paths = [
"skip-analysis=*/excluded/path/*",
"skip-analysis=*/one/more/*",
]
[analyzers.javascript]
analysis-paths.append = [
"skip-analysis=*/additional/path*"
]
[analyzers.golang]
analysis-paths.override = [
"skip-analysis=*/only/this/path/*"
]Определяет схему файла настроек.
Обязательная настройка.
Принимает интегральное значение 1.
Позволяет задать иную рабочую директорию, через которую относительные пути будут преобразовываться в абсолютные. Доступна только на уровне настроек проекта.
Принимает строку с относительным путём. Поддерживаются символы текущей директории . и родительской директории ...
Значение по умолчанию: ".".
Позволяет игнорировать пользовательские настройки и учитывать только настройки, указанные на уровне проекта. Доступна только на уровне настроек проекта.
Значение по умолчанию: false.
Задаёт количество потоков для анализа.
Принимает значения интегрального типа.
Если задано значение 0, анализатор будет распараллеливать анализ на все доступные логические ядра. Если настройка опущена, анализатор сам выберет оптимальное количество потоков для анализа.
Пример:
[analyzers.all]
analysis-threads = 8Определяет поведение диагностических правил.
Представляет собой непустой массив строк формата:
Group=on|off — для настройки групп диагностических правил;Vxxxx=on|off — для настройки отдельных диагностических правил;Vxxxx-Vyyyy=on|off — для настройки диапазона диагностических правил. Значение xxxx должно быть меньше yyyy.Доступные группы для настройки:
ALL — все диагностические правила;GA — диагностические правила общего назначения;OWASP — диагностические правила, ищущие отклонения от OWASP ASVS.Пример:
[analyzers.javascript]
rules.override = [
"ALL=off",
"GA=off",
"V7001-V7005=on",
"V7008=on"
]При заданной настройке анализаторы неявно добавляют в начало списка включение группы правил общего назначения ("GA=on").
Значение по умолчанию: [ "ALL=off", "GA=on" ].
Определяет поведение предупреждений о проблемах при работе анализатора.
Представляет собой непустой массив строк формата:
ALL=on|off — для настройки всей группы;Vxxx=on|off — для настройки отдельных предупреждений;Vxxx-Vyyy=on|off — для настройки диапазонов предупреждений. Значение xxx должно быть меньше yyy.Пример:
[analyzers.javascript]
fails.override = [
"ALL=off",
"V071-V072=on",
"V074=on"
]При заданной настройке анализаторы неявно добавляют в начало списка включение всех предупреждений о проблемах ("ALL=on").
Значение по умолчанию: [ "ALL=on" ].
Определяет поведение анализатора на указанном пути.
Представляет собой непустой массив строк формата:
analyze=path|glob — включает анализ на указанном значении;skip-analysis=path|glob — отключает анализ на указанном значении.Пример:
[analyzers.javascript]
analysis-paths.override = [
"skip-analysis=*/excluded/path/*",
"analyze=/path/to/project/excluded/path/file.js"
]При заданной настройке анализаторы неявно добавляют в начало списка включение всех файлов в анализ ("analyze=*").
Значение по умолчанию: [ "analyze=*" ].
Анализаторы могут заменять заданные пользователем префиксы путей на последовательность |?| (source tree root). Это позволяет генерировать переносимые между машинами отчёты анализа.
Настройка представляет собой таблицу со следующими ключами:
path — использовать заданный путь в виде строки в качестве source tree root;use-project-directory — использовать родительскую директорию файла настроек проекта как source tree root. Принимает значения логического типа. Значение по умолчанию: false.Настройки source-tree-root.path и source-tree-root.use-project-directory могут быть заданы одновременно. В таком случае при выборе заменяемого префикса приоритет будет у последней настройки.
Пример:
[analyzers.javascript]
source-tree-root = { path = "/path/to/projects/js",
use-project-directory = true }
[analyzers.golang]
source-tree-root.path = "/path/to/projects/golang"
source-tree-root.use-project-directory = falseОпределяет время, через которое будет остановлен анализ единичного файла. Принимает строки формата XXhYYmZZs.
Пример:
[analyzers.javascript]
file-analysis-timeout = "1h10m15s"Значение по умолчанию: "10m".
Позволяет отключить генерацию предупреждений низкого уровня достоверности.
Принимает значения логического типа.
Значение по умолчанию: false.
Позволяет включить добавление SEC-меток в поле sastId отчёта анализатора.
SEC-метки отображают группы срабатываний анализатора согласно классификации критических ошибок из ГОСТ Р 71207—2024. Подробнее узнать об этом можно здесь.
Принимает значения логического типа.
Значение по умолчанию: false.
Определяет пути до файлов подавления срабатываний анализатора. Подробнее об этой функциональности можно прочитать здесь.
Доступна только на уровне настроек проекта.
Представляет собой непустой массив строк, содержащих пути до файлов.
Пример:
[analyzers.all]
suppress-files = [ "./suppress_base.suppress.json" ]Позволяет сохранять временные файлы после анализа.
Принимает значения логического типа.
Значение по умолчанию: false.
Настройка для JavaScript анализатора. Определяет путь до NodeJS, с помощью которого будет запущен TypeScript Server.
Представляет собой строку.
Значение по умолчанию: node.
Определяет язык для встроенной документации.
Принимает строку со значением "ru" или "en".
Доступна только на уровне настроек пользователя.
Значение по умолчанию: "en".
Определяет отображение кнопки Best Warnings для показа 10 лучших предупреждений из отчёта анализатора.
Принимает значения логического типа.
Доступна только на уровне настроек пользователя.
Значение по умолчанию: true.
Определяет отображение предупреждений, помеченных как ложноположительные.
Принимает значения логического типа.
Доступна только на уровне настроек пользователя.
Значение по умолчанию: false.
Позволяет плагину сохранять изменения в файле после вставки маркера подавления в строку.
Принимает значения логического типа.
Доступна только на уровне настроек пользователя.
Значение по умолчанию: true.
Примечание. Для установки анализатора на операционных системах семейства Windows можно воспользоваться инсталлятором, доступным на странице загрузки анализатора. Windows инсталлятор поддерживает установку как в графическом, так и в unattended (установка из командной строки) режимах.
Для работы C# анализатора PVS-Studio требуется ряд дополнительных пакетов. В зависимости от того, каким образом будет произведена установка PVS-Studio C#, эти зависимые пакеты будут автоматически установлены пакетным менеджером, либо их нужно будет установить вручную.
Для работы анализатора на машине должен быть установлен .NET SDK 10.0. Инструкции для добавления репозитория .NET в различные дистрибутивы Linux можно найти здесь.
Инсталлятор .NET SDK для macOS можно загрузить с этой страницы.
Примечание. При установке pvs-studio-dotnet с использованием пакетного менеджера на Linux необходимая для работы анализатора версия пакета .NET SDK будет установлена автоматически, но репозиторий .NET необходимо предварительно добавить вручную.
Для работы C# анализатору PVS-Studio требуется наличие C++ анализатора PVS-Studio (pvs-studio).
Примечание. При установке пакета C# анализатора PVS-Studio (pvs-studio-dotnet) через пакетный менеджер, пакет C++ анализатора (pvs-studio) будет установлен автоматически, и этот шаг можно пропустить.
При установке C# анализатора через распаковку архива необходимо также установить C++ анализатор (pvs-studio). С++ анализатор должен быть установлен в следующие директории:
Инструкции по установке pvs-studio доступны в соответствующих разделах документации: Linux; macOS.
Установка из репозитория – рекомендуемый способ, позволяющий автоматически установить необходимые зависимости и получать обновления.
wget -q -O - https://cdn.pvs-studio.com/etc/pubkey.txt | \
sudo apt-key add -
sudo wget -O /etc/apt/sources.list.d/viva64.list \
https://cdn.pvs-studio.com/etc/viva64.list
sudo apt-get update
sudo apt-get install pvs-studio-dotnetwget -O /etc/yum.repos.d/viva64.repo \
https://cdn.pvs-studio.com/etc/viva64.repo
yum update
yum install pvs-studio-dotnetwget -q -O /tmp/viva64.key \
https://cdn.pvs-studio.ru/etc/pubkey.txt
sudo rpm --import /tmp/viva64.key
sudo zypper ar -f https://cdn.pvs-studio.ru/rpm viva64
sudo sed -i \
's|enabled=1|enabled=1\ngpgkey=https://cdn.pvs-studio.ru/etc/pubkey.txt|' \
/etc/zypp/repos.d/viva64.repo
sudo zypper refresh
sudo zypper install pvs-studio-dotnetПрямые ссылки для загрузки пакетов / архива доступны на странице загрузки. Ниже представлены команды установки / распаковки.
sudo gdebi pvs-studio-dotnet-VERSION.debили
sudo apt-get -f install pvs-studio-dotnet-VERSION.debsudo dnf install pvs-studio-dotnet-VERSION.rpmили
sudo zypper install pvs-studio-dotnet-VERSION.rpmили
sudo yum install pvs-studio-dotnet-VERSION.rpmили
sudo rpm -i pvs-studio-dotnet-VERSION.rpmtar -xzf pvs-studio-dotnet-VERSION.tar.gz
sudo ./install.shКоманды установки:
brew install viva64/pvs-studio/pvs-studio
brew install viva64/pvs-studio/pvs-studio-dotnetКоманды обновления:
brew upgrade pvs-studio
brew upgrade pvs-studio-dotnetКоманда распаковки архива:
tar -xzf pvs-studio-dotnet-VERSION.tar.gz
sudo sh install.shПрежде, чем начать использовать анализатор PVS-Studio, нужно ввести лицензию. О том, как сделать это, вы можете подробно прочитать здесь.
Использование анализатора описано в соответствующем разделе документации.
Анализатор PVS-Studio можно использовать при работе в средах разработки JetBrains Rider и CLion. Плагины PVS-Studio для этих IDE предоставляют удобный графический интерфейс для запуска анализа проектов и отдельных файлов, а также для работы с предупреждениями анализатора.
Плагины PVS-Studio для Rider и CLion можно установить из официального репозитория плагинов JetBrains или из репозитория на нашем сайте. Ещё один способ установки — через установщик PVS-Studio для Windows, доступный на странице загрузки.
Для установки плагина PVS-Studio из официального репозитория JetBrains нужно открыть окно настроек с помощью команды File > Settings > Plugins, выбрать в окне вкладку Marketplace, и ввести в строке поиска PVS-Studio. В результатах поиска появится плагин PVS-Studio.
Установка плагина PVS-Studio в Rider:
Установка плагина PVS-Studio в CLion:
Далее нужно нажать кнопку Install напротив найденного плагина PVS-Studio. После того как установка плагина будет завершена, нужно нажать кнопку Restart IDE.
В Rider:
В CLion:
Перезапустив среду разработки, можно начать пользоваться плагином PVS-Studio для проверки кода. Следующим шагом необходимо установить анализатор PVS-Studio.
Помимо официального репозитория JetBrains, плагин PVS-Studio также доступен из собственного репозитория PVS-Studio. Для установки плагина из репозитория PVS-Studio сначала нужно добавить репозиторий в IDE. Для этого нужно открыть окно установки плагинов с помощью команды меню File > Settings > Plugins.
Для Rider это будет выглядеть так:
В CLion:
Далее, нажать на шестеренку в правом верхнем углу и в выпадающем списке выбрать Manage Plugin Repositories.
Для Rider:
Для CLion:
В открывшемся окне добавьте путь:
http://files.pvs-studio.com/java/pvsstudio-rider-plugins/updatePlugins.xmlhttp://files.pvs-studio.com/java/pvsstudio-clion-plugins/updatePlugins.xml.И нажмите OK.
В Rider:
В CLion:
Последний шаг установки аналогичен установке плагина из официального репозитория — нужно открыть вкладку Marketplace, где в поиск ввести PVS-Studio. После применения данного фильтра выбрать плагин PVS-Studio for Rider или PVS-Studio for CLion, нажать Install и перезапустить среду разработки.
Для работы анализатора PVS-Studio в средах Rider и CLion помимо установки IDE плагина также требуется установить ядро анализатора и его зависимости.
Если вы устанавливали плагин через Windows установщик PVS-Studio, то все необходимые для работы компоненты уже должны быть установлены в системе и можно пропустить этот шаг.
Если же плагин ставился отдельно (добавлением репозитория или из официального репозитория JetBrains), необходимо перед началом работы скачать и установить С++ или C# анализатор для необходимой платформы отсюда.
Первое, что нужно сделать после установки — ввести лицензию. Процесс ввода лицензии в Rider/CLion подробно описан в документации.
Панель настроек плагина состоит из нескольких вкладок. Рассмотрим каждую из них подробнее.
Settings — настройки ядра анализатора PVS-Studio. При наведении курсора мыши на название настройки появляется подсказка с описанием того, для чего эта настройка предназначена. Для Rider настройки выглядят так:
Для CLion:
Warnings — список типов всех предупреждений, поддерживаемых анализатором. Если убрать галочку у предупреждения, то все предупреждения данного типа в таблице вывода результатов работы анализатора будут отфильтрованы:
Excludes — содержит маски для имен файлов и путей, которые будут исключены из анализа.
Registration — содержит информацию о действующей лицензии.
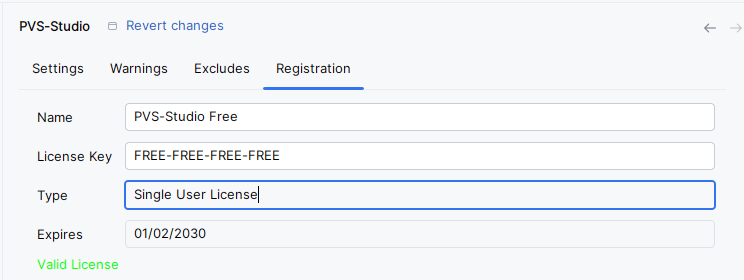
JetBrains Rider может открывать проекты в 2-х режимах — непосредственно проект, и директорию с исходниками. При открытии проекта Rider может открывать как отдельные .csproj файлы, так и solution, содержащий один или несколько таких проектов.
Если открыт файл проекта или solution'а, то имеется возможность анализировать:
Для анализа текущего проекта или solution'а можно воспользоваться пунктом меню Tools > PVS-Studio > Check Current Solution/Project. Также имеется пункт меню для запуска межмодульного анализа. В этом режиме анализатор выполняет более глубокий анализ кода, но тратит на это больше времени:
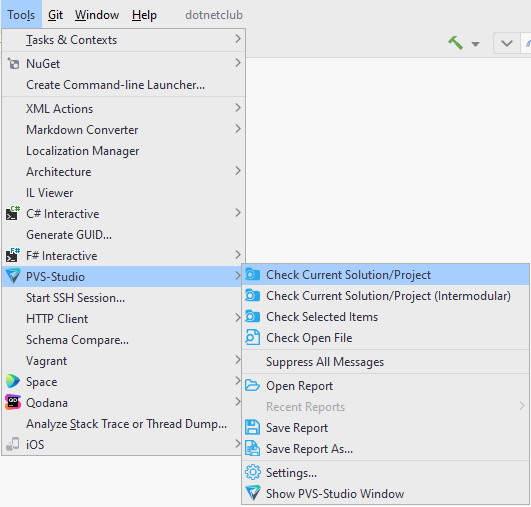
Для анализа файла, открытого на редактирование, можно использовать:
Также можно выбрать несколько элементов в окне Explorer через CTRL/SHIFT + mouse Left Click, после чего выбрать пункт меню Tools > PVS-Studio > Check Selected Items:
Или аналогичный пункт меню Check Selected Items в контекстном меню Explorer, которое вызывается нажатием правой кнопки мыши:
В примерах, приведенных выше, будут проанализированы все *.cs и *.csproj файлы из папок Core, Controllers, а также файл Startup.cs.
Если в Rider открыта директория, PVS-Studio не может точно знать, какой именно проект, файл или решения нужно анализировать, поэтому команда проверки текущего проекта/решения и команда проверки открытого файла не доступны. Доступна только проверка решения при помощи команды Tools > PVS-Studio > Check Selected Items:
Или через контекстное меню в окне Explorer (Check Selected Items):
В Rider есть возможность работать с проектами Unreal Engine. Стандартный сценарий работы отличается от описанного здесь. Подробнее читайте об этом в специальной документации.
JetBrains CLion позволяет открывать CMake проекты.
Имеется возможность анализировать:
Для анализа текущего проекта можно воспользоваться пунктом меню Tools > PVS-Studio > Check Project. Также имеется пункт меню для запуска межмодульного анализа. При межмодульном режиме происходит более глубокий анализ кода проекта, но на это тратится больше времени:
Для анализа файла, открытого на редактирование, можно использовать:
Также можно выбрать несколько элементов в окне Explorer через CTRL/SHIFT + mouse Left Click, после чего нажать правую кнопку мыши и выбрать Analyze with PVS-Studio:
В примерах, приведенных выше, будут проанализированы все *.cpp файлы из папок 3rdparty и parallel, а также файл samples.cpp.
Во время анализа результаты работы анализатора выводятся в таблицу окна PVS-Studio, для Rider окно выглядит так:
Для CLion:
Таблица состоит из 8 столбцов (слева направо: Favorite, Code, CWE, SAST, Message, Position, Projects, False Alarms). Имеется возможность сортировать сообщения в таблице по любому столбцу. Для изменения порядка сортировки необходимо кликнуть на заголовок столбца. Крайний левый столбец (Favorite) используется для пометки предупреждений, которая позволяет быстро найти все помеченные предупреждения, включив сортировку по столбцу Favorite.
При клике на строке в столбце Code / CWE в браузере будет открыта страница с подробным описанием предупреждения или потенциальной уязвимости. В столбце Message содержится краткое описание предупреждения. Столбец Position содержит список файлов, связанных с сообщением. Столбец Projects — список проектов, включающих в себя файл, на который выдано предупреждение анализатора. Крайний правый столбец False Alarms служит для отображения сообщений, помеченных как ложные срабатывания. Подробнее про работу с ложными срабатываниями будет описано дальше, в соответствующем подразделе.
При двойном клике левой кнопкой мыши на строке в таблице будет открыт файл на строке, в которой было найдено предупреждение анализатора:
Также над таблицей имеются кнопки-стрелки, позволяющие переключаться между предыдущим/следующим сообщением анализатора, и открывать файл, на который это предупреждение выдано, в редакторе кода. Над таблицей имеется несколько фильтров по уровню опасности предупреждений: High, Medium, Low и Fails (ошибки анализатора).

При нажатии на кнопку-лупу откроется дополнительная панель с полями ввода для столбцов Code, CWE, Message и Position. Каждое поле — это строковый фильтр для столбца, позволяющий отфильтровать сообщения из таблицы по введённому в эти поля тексту.
В левом верхнем углу, над таблицей, расположена кнопка с тремя горизонтальными полосками. При нажатии на эту кнопку откроется дополнительная панель настроек:
При нажатии на кнопку-шестеренку открывается главное окно настроек плагина, также доступное через команду меню Tools > PVS-Studio > Settings.
Если Вы только начали изучать инструмент статического анализа и хотели бы узнать на что он способен, то можете воспользоваться механизмом Best Warnings. Данный механизм покажет вам наиболее важные и достоверные предупреждения.
Чтобы посмотреть наиболее интересные предупреждения с точки зрения анализатора, нажмите на кнопку Best, как показано на скриншоте ниже:

После чего в таблице с результатами анализа останутся максимум десять наиболее критичных предупреждений анализатора.
Бывают ситуации, когда сообщение анализатора указывает на код, но программисту совершенно очевидно, что в этом коде нет ошибки. Такая ситуация называется ложным срабатыванием (false positive).
В плагине PVS-Studio имеется возможность пометить сообщение анализатора как ложное срабатывание. Такая пометка позволяет скрывать эти сообщения анализатора при последующем анализе кода.
Для разметки ложных срабатываний необходимо выбрать одно или несколько сообщений анализатора в таблице PVS-Studio, кликнуть правой кнопкой мыши на любой строке в таблице и в контекстном меню выбрать пункт Mark selected messages as False Alarms:
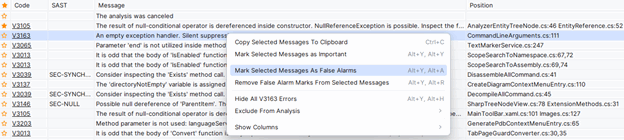
После выполнения данной команды анализатор добавит к строке, на которую выдаётся предупреждение анализатора, комментарий специального вида: \\-Vxxx, где xxx — это номер диагностического правила PVS-Studio. Такой комментарий также можно добавить в код вручную.
Помеченные ранее ложные срабатывания можно показать в таблице окна PVS-Studio с помощью настройки Show False Alarms, доступной через команду меню Tools > PVS-Studio > Settings, для Rider:
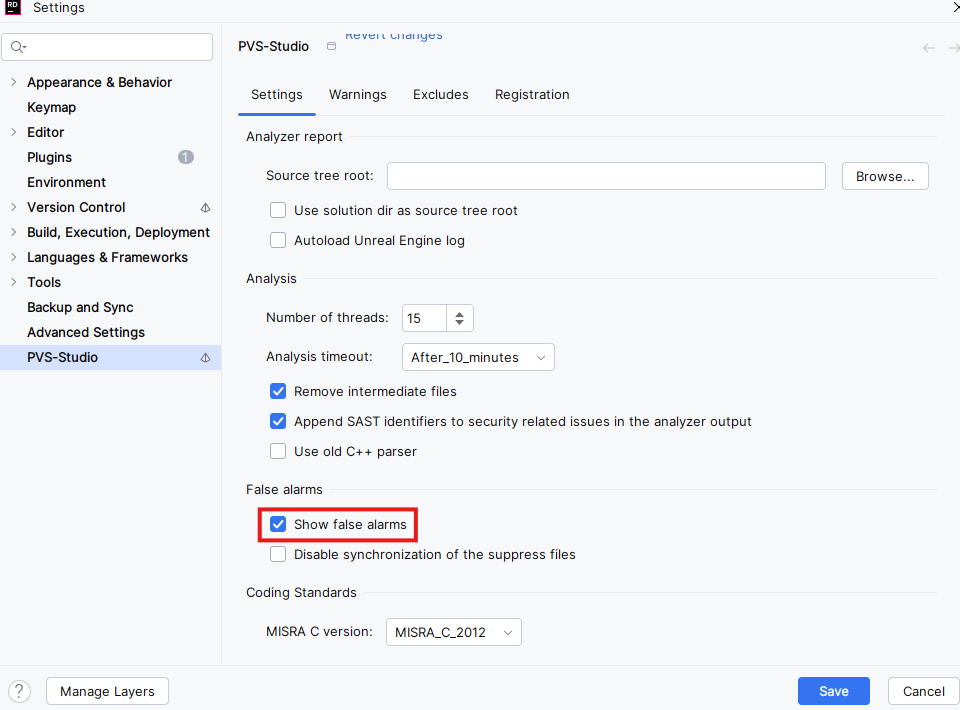
Для CLion:
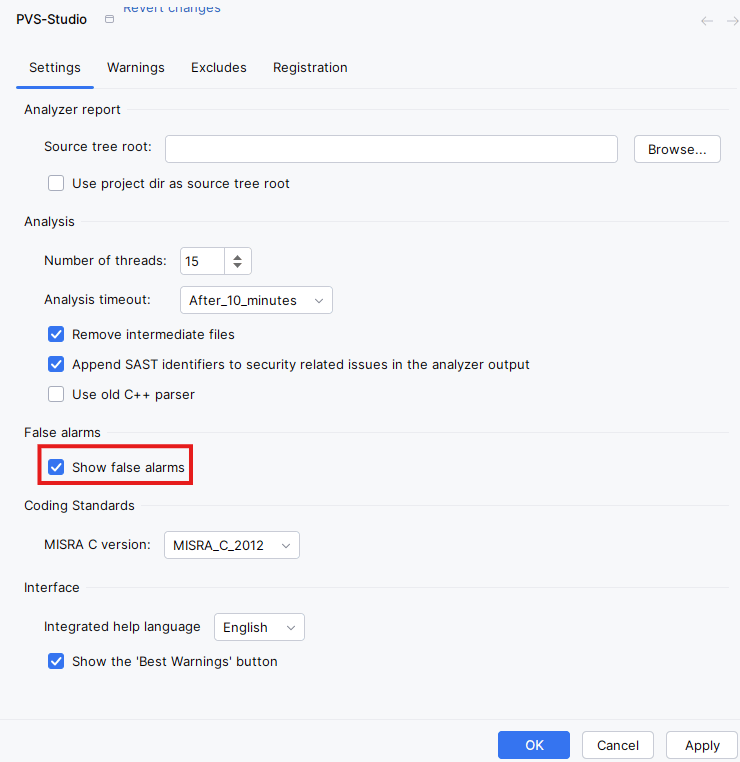
С помощью команды контекстного меню Remove False Alarm marks from selected messages можно удалить отметку ложного срабатывания с выбранных сообщений.
Подробную информацию о подавлении предупреждений, выдаваемых анализатором PVS-Studio, а также сведения о других способах подавления предупреждений анализатора с помощью файлов конфигурации (.pvsconfig), добавляемых в проект, можно найти в разделе документации Подавление ложных предупреждений.
Часто предупреждения, выдаваемые на legacy-код, могут мешать регулярному статическому анализу и просмотру срабатываний на новый/находящийся в разработке код.
Для решения этой проблемы в анализаторе PVS-Studio есть функция "отключения" предупреждений на старом коде. Чтобы подавить предупреждения анализатора на старом коде, можно воспользоваться командой главного меню Tools > PVS-Studio > Suppress All Messages или кнопкой Suppress All Messages на панели окна PVS-Studio. Механизм подавления работает с помощью специальных *.suppress-файлов: в него добавляются подавленные предупреждения анализатора после выполнения команды Suppress All Messages. При последующем запуске анализа все предупреждения, добавленные в такие *.suppress-файлы, не попадут в отчёт анализатора.
При работе с Rider файлы *.suppress создаются на уровне проекта, рядом с каждым проектным файлов, но их также можно добавить в любой проект или solution (например, чтобы использовать один общий suppress-файл для нескольких проектов или всего решения). Чтобы вернуть сообщения в вывод анализатора, необходимо удалить suppress-файлы для соответствующих проектов и перезапустить анализ.
В CLion подавленные предупреждения добавляются в suppress файл suppress_file.suppress.json, который записывается в директорию .PVS-Studio, в корневой директории открытого в CLion проекта. Чтобы вернуть все предупреждения в вывод анализатора, необходимо удалить этот файл и перезапустить анализ.
Более подробное описание подавления предупреждений анализатора, и описание работы с *.suppress файлами, можно прочитать в разделе документации Массовое подавление сообщений анализатора.
Также предлагаем познакомиться со статьёй "Как внедрить статический анализатор кода в legacy проект и не демотивировать команду".
При нажатии правой кнопкой мыши на строке с сообщением анализатора в таблице окна PVS-Studio, откроется контекстное меню, содержащее дополнительные команды для выбранных сообщений анализатора.
Команда Copy Selected Messages To Clipboard копирует все выбранные в окне с результатами анализа плагина PVS-Studio предупреждения в буфер обмена.
Команда Mark Selected Messages As Important позволяет пометить звёздочкой предупреждение, чтобы в дальнейшем легко его найти при сортировке по столбцу Favorite (крайний левый столбец).
Команда Mark Selected Messages As False Alarms / Remove False Alarm Masks From Selected Messages позволяет разметить сообщение анализатора, как ложное срабатывание, добавив в код, на который выдано предупреждение, комментарий специального вида (более подробно про работу с ложными срабатываниями рассказано, в соответствующем подразделе).
Команда Hide All V3163 Errors позволяет скрыть все срабатывания с этим номером.
Команда Exclude From Analysis позволяет добавить путь или часть пути к файлу, в котором найдено предупреждение анализатора, в список исключённых из анализа директорий. Все файлы, пути до которых попадут под данный фильтр, будут исключены из анализа.
Пункт меню Show Columns открывает список с именами столбцов, которые можно скрыть или отобразить.
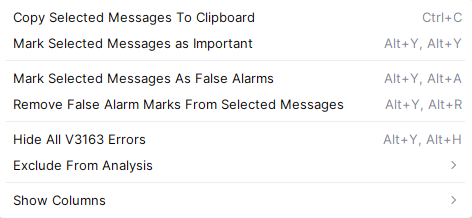
Для сохранения или загрузки результатов работы анализатора можно воспользоваться командами главного меню, доступными через Tools > PVS-Studio:
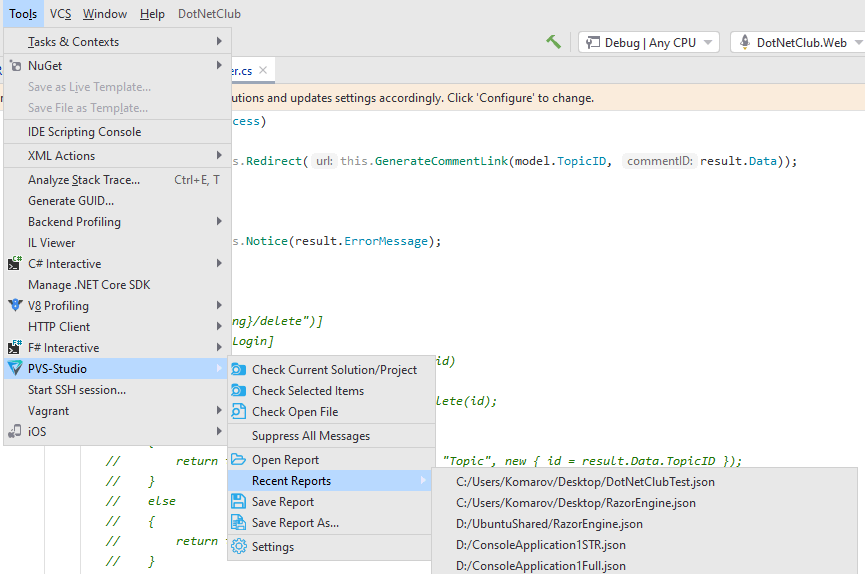
Команда Open Report открывает .json файл отчета и загружает его содержимое в таблицу окна PVS-Studio.
Подменю Recent Reports показывает список из нескольких последних открытых файлов отчетов. При нажатии на элемент в списке будет открыт соответствующий отчет (если отчет еще существует по такому пути), и его содержимое будет загружено в таблицу окна PVS-Studio.
Команда Save Report сохраняет все сообщения из таблицы (даже отфильтрованные) в .json файл отчета. Если текущий результат анализа еще ни разу не сохранялся, то будет предложено задать имя и место для сохранения отчета.
Аналогично, команда Save Report As сохраняет все предупреждения из таблицы (даже отфильтрованные) в .json файл отчета, всегда предлагая выбрать место сохранения отчёта на диске.
Плагины для Rider и CLion добавляют окно просмотра результатов анализа PVS-Studio, которое имеет контекстное меню, появляющееся при нажатии правой кнопкой мыши в окне с результатами анализа:
Некоторым действиям из этого меню назначены горячие клавиши, что позволяет выполнять их без использования мыши.
Кнопки со стрелками, предназначенные для навигации по сообщениям анализатора, также имеют горячие клавиши:
Alt + [;Alt + ].Использование горячих клавиш полезно, потому что позволяет ускорить процесс обработки результатов анализа. Их можно назначать\переопределять в настройках: File > Settings > Keymap. Чтобы быстрее их найти, введите PVS-Studio в поле поиска окна Keymap.
Анализатор не всегда может полностью проанализировать файл с исходным кодом.
Это может произойти по трем причинам:
1) Ошибка в коде
В коде имеется шаблонный класс или шаблонная функция с ошибкой в коде. Если эта функция не инстанцируется, то компилятор не диагностирует в ней наличие некоторых ошибок. Другими словами наличие такой ошибки не мешает компиляции. Анализатор PVS-Studio пытается искать потенциальные ошибки даже в классах и функциях, которые нигде не используются. В случае если анализатор не может разобрать код, то он и выдаст предупреждение V001. Рассмотрим пример кода:
template <class T>
class A
{
public:
void Foo()
{
//Забыли ;
int x
}
};Этот код будет скомпилирован Visual C++, если класс A не будет нигде использоваться. Однако ошибка в нем присутствует, что мешает работе PVS-Studio.
2) Ошибка в препроцессоре Visual C++
Анализатор в процессе своей работы использует препроцессор Visual C++. Этот препроцессор очень редко, но все же допускает ошибки при генерации препроцессированных *.i файлов. В результате анализатор получает на вход некорректные данные. Рассмотрим пример:
hWnd = CreateWindow (
wndclass.lpszClassName, // window class name
__T("NcFTPBatch"), // window caption
WS_OVERLAPPED | WS_CAPTION | WS_SYSMENU | WS_MINIMIZEBOX,
// window style
100, // initial x position
100, // initial y position
450, // initial x size
100, // initial y size
NULL, // parent window handle
NULL, // window menu handle
hInstance, // program instance handle
NULL); // creation parameters
if (hWnd == NULL) {
...Приведенный фрагмент кода, препроцессор Visual C++ превратил в:
hWnd = // window class name// window caption// window style//
initial x position// initial y position// initial x size//
initial y size// parent window handle// window menu handle//
program instance handleCreateWindowExA(0L,
wndclass.lpszClassName, "NcFTPBatch", 0x00000000L | 0x00C00000L |
0x00080000L | 0x00020000L, 100, 100,450, 100, ((void *)0),
((void *)0), hInstance, ((void *)0)); // creation parameters
if (hWnd == NULL) {
...Получается, что в коде написано следующее:
hWnd = // длинный комментарий
if (hWnd == NULL) {
...Этот код некорректен, о чем и выдаст сообщение PVS-Studio. Конечно, это недоработка PVS-Studio и со временем мы это исправим.
Отметим также, что Visual C++ успешно компилирует этот код, так как алгоритмы, используемые в нем для компиляции и для генерации препроцессированных *.i-файлов различны.
3) Недоработка внутри PVS-Studio
В редких случаях PVS-Studio неспособен разобрать сложный шаблонный код.
Какова не была бы причина выдачи сообщения V001, это сообщение не критично. Как правило, неполный разбор файла не несущественен с точки зрения анализа. PVS-Studio просто пропускает функцию/класс с ошибкой и продолжает анализ файла. Непроанализированным остается совсем небольшой участок кода.
Анализатор обнаружил проблему, из-за которой позиции предупреждений могут указывать на некорректные строки кода. Это может происходить либо из-за некорректной работы внешнего препроцессора, либо из-за вставленных разработчиком директив '#line' в исходный код.
Анализатор PVS-Studio для языков C и C++ работает только с препроцессированными файлами, т.е. с файлами, в которых раскрыты все макросы ('#define') и подставлены все включаемые файлы ('#include'). При этом в препроцессированном файле содержится информация о том, какие файлы куда подставились и в какие позиции. Осуществляется это как раз с помощью директив '#line', имеющих следующий формат:
#line linenum "filename" // MSVC
# linenum "filename" // GCC-likeСледующая строка после этой директивы в препроцессированном файле интерпретируется как пришедшая из файла 'filename' и имеющая номер 'linenum'. Таким образом, в препроцессированных файлах помимо готового к анализу кода содержится также информация о том, из какого файла поступил тот или иной участок.
Препроцессирование выполняется в любом случае. Для пользователя эта процедура происходит незаметно. Иногда препроцессор является частью анализатора кода, а иногда (как в случае с PVS-Studio) используется внешний препроцессор. Утилита анализа запускает компилятор, которым собирается проверяемый проект, для каждого проверяемого файла на языке C или C++. С его помощью генерируется препроцессированный файл с расширением '*.PVS-Studio.i'.
Рассмотрим ситуацию, при которой происходит сбой в позиционировании предупреждений анализатора. Речь пойдёт о написании директив '#pragma' в несколько строк с применением лексемы продолжения предыдущей строки ('\'):
#pragma \
warning(push)
void test()
{
int a;
if (a == 1) // V614 должно быть выдано здесь,
return; // а выдастся здесь
}Компилятор MSVC неверно формирует директивы '#line' в препроцессированном файле при написании такого кода, при этом GCC и Clang делают всё верно. Однако если немного изменить пример, то все внешние препроцессоры отрабатывают корректно:
#pragma warning \
(push)
void test()
{
int a;
if (a == 1) // V614 теперь выдаётся корректно
return;
}Наша рекомендация — это либо не использовать многострочные директивы '#pragma', либо писать их так, чтобы они корректно обрабатывались внешним препроцессором.
Анализатор пытается обнаружить сдвиг строк в обрабатываемом файле и сообщить об этом пользователю предупреждением V002. При этом он не пытается скорректировать позиции выданных предупреждений в коде программы. Алгоритм нахождения сдвига строк работает следующим образом.
Шаг N1. Анализатор открывает исходный файл и ищет самую последнюю лексему. Выбираются только те лексемы, которые не короче трех символов. Например, для следующего кода последней лексемой будет считаться 'return':
1 #include "stdafx.h"
2
3 int foo(int a)
4 {
5 assert( a >= 0
6 && a <= 1000);
7 int b = a + 1;
8 return b;
9 }Шаг N2. Найдя последнюю лексему, анализатор определит номер строки, в которой она находится. В примере это строка под номером 8. Далее анализатор ищет последнюю лексему в уже препроцессированном файле. Если последние лексемы не совпадают, то, видимо, в конце файла раскрылся макрос. В такой ситуации анализатор не сможет понять, корректно ли расположены строки. Но подобное происходит крайне редко, и почти во всех случаях последние лексемы в исходном и препроцессированном файле совпадают. Если это так, определяется номер строки, в которой расположена лексема в препроцессированном файле.
Шаг N3. После двух предыдущих шагов имеются номера строк, где расположена последняя лексема в исходном файле и в препроцессированном файле соответственно. Если эти номера строк не совпадают, то произошёл сдвиг в нумерации строк. И в данном случае анализатор сгенерирует предупреждение V002.
Примечание N1. Следует учитывать, что если некорректная директива '#line' будет находиться в файле ниже всех найденных подозрительных участков кода, то все позиции выданных предупреждений будут корректны. И хотя анализатор сгенерирует дополнительно предупреждение V002, это не помешает вам работать с результатами анализа.
Примечание N2. Хоть это и не ошибка непосредственно анализатора кода PVS-Studio, тем не менее, это приводит к его некорректной работе.
Если пользователь хочет попытаться самостоятельно найти строку в исходном файле, из-за которой возник сдвиг, то можно попробовать воспользоваться следующим алгоритмом:
Шаг N1. Перезапустите анализ решения/проекта/файла, сохранив промежуточные файлы анализа (выключив настройку "Remove Intermediate Files").
Шаг N2. Откройте отчёт в одном из плагинов для IDE.
Шаг N3. Отфильтруйте предупреждения согласно файлу, в котором произошёл сдвиг позиций. Если производился анализ единичного файла, то фильтровать ничего не требуется.
Шаг N4. Отсортируйте предупреждения по номерам строк или позиций (колонка 'Line' или 'Positions').
Шаг N5. Найдите первое предупреждение, позиция которого смещена.
Шаг N6. Откройте препроцессированный файл, соответствующий исходному, с расширением '*.PVS-Studio.i'.
Шаг N7. Найдите строку, полученную на шаге N5, в препроцессированном файле.
Шаг N8. Двигайтесь вверх по препроцессированному файлу, начиная от полученной на шаге N7 позиции, и найдите первую ближайшую директиву '#line'.
Шаг N9. В исходном файле перейдите на соответствующую строку, указанную в директиве '#line', полученную на шаге N8. Между этой строкой и строкой, на которой выдано предупреждение, находится код, который приводит к сдвигу. Это могут быть многострочные вызовы макросов, многострочные директивы компиляторов и т.д.
Схематически работу алгоритма можно отобразить следующим образом:
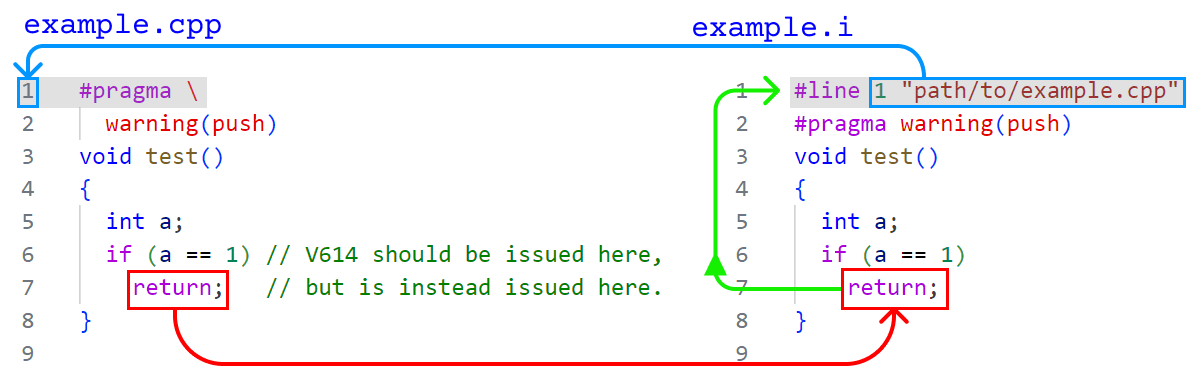
Начиная с версии 7.35 анализатор может сам вычислить приблизительную позицию начала сдвига. В таком случае поиск проблемного фрагмента можно начинать с 6 пункта. Чтобы включить механизм, добавьте специальный комментарий //+V002,VERBOSE в исходный файл или файл конфигурации диагностик. Подробнее об этом можно узнать в документации.
Наличие предупреждения V003 в отчёте означает, что произошла критическая ошибка внутри анализатора. Скорее всего, в этом случае вообще никаких других предупреждений про анализируемый файл не будет выдано.
Хотя предупреждение V003 возникает достаточно редко, мы будем благодарны, если вы поможете нам исправить проблему, которая привела к этому предупреждению. Для этого пришлите, пожалуйста, нам файлы, описанные далее, через форму обратной связи.
При получении предупреждения вида:
V003 Unrecognized error found: stacktrace was written to the file
source.cpp.PVS-Studio.stacktrace.txt 1Вы можете перейти к текстовому файлу, который имеет примерно следующий вид:
PVS-Studio version: 7.XX.XXXXX.XXXX
#NN Object "[0xffffffffffffffff]", at 0xffffffffffffffff, in
....
#1 Object "[0xb39b7e]", at 0xb39b7e, in
#0 Object "[0xcfac19]", at 0xcfac19, inВ файле содержатся только адреса функций, т.к. дистрибутив PVS-Studio распространяется без отладочной информации. Однако мы сможем расшифровать этот файл на нашей стороне и определить источник ошибки.
Примечание. Файл с трассировкой стека не содержит никакой информации об исходном коде.
Анализ исходного кода на языках C и C++ осуществляется на основе препроцессированного ('*.PVS-Studio.i') и конфигурационного ('*.PVS-Studio.cfg') файлов. Препроцессированный файл формируется из исходного файла (например, 'file.cpp') препроцессором путём раскрытия макросов и директив '#include'. Конфигурационный файл содержит настройки, необходимые для корректного запуска анализа на файле. Набор этих файлов позволяет локализовать проблему в ядре C и C++ анализатора.
Далее описаны способы генерации этих файлов различными компонентами продукта.
Плагины для IDE. На вкладке 'Common Analyzer Settings' настроек PVS-Studio установите опцию 'RemoveIntermediateFiles' в 'False' и заново выполните анализ файлов, на которых происходит падение.
PVS-Studio_Cmd / pvs-studio-dotnet. В файле конфигурации анализа ('Settings.xml') установите опцию 'RemoveIntermediateFiles' в 'False' и заново выполните анализ файлов, на которых происходит падение.
CompilerCommandsAnalyzer / pvs-studio-analyzer. Добавьте флаг '--dump-files' в строку запуска анализа:
pvs-studio-analyzer analyze .... --dump-filesПосле этого в папке проекта надо найти соответствующий i-файл (например, 'file.PVS-Studio.i') и соответствующий ему 'file.PVS-Studio.cfg'.
Примечание. Препроцессированные файлы содержат часть исходного кода проекта. Мы понимаем, что политика компании может запрещать распространение фрагментов исходного кода проекта. Поэтому в случае необходимости мы готовы заключить NDA. Передача препроцессированных и конфигурационных файлов может существенно упростить и ускорить процесс исправления ошибки в анализаторе.
Анализатор, выявляя проблемы 64-битного кода, всегда должен проверять именно 64-битную конфигурацию проекта. Ведь именно в 64-битной конфигурации правильно раскрываются типы данных, правильно выбираются ветки вида "#ifdef WIN64" и так далее. Пытаться выявлять проблемы 64-битного кода в 32-битной конфигурации некорректно.
Однако иногда может оказаться полезным проверить 32-битную конфигурацию проекта. Сделать это можно в том случае, когда 64-битной конфигурации пока нет, но требуется оценить предстоящий объем работ по миграции кода на 64-битную платформу. Тогда можно проверить проект в 32-битном режиме. Проверка 32-битной конфигурации вместо 64-битной покажет, сколько диагностических сообщений выдаст анализатор при проверке 64-битной конфигурации. Наши эксперименты показывают, что, конечно же, далеко не все диагностические сообщения выдаются при проверке 32-битной конфигурации. Однако порядка 95% диагностических сообщений при проверке 32-битной конфигурации проекта совпадают с сообщениями при проверке 64-битной конфигурации. Это позволяет оценить предстоящий объем работ.
Обратите внимание! Если вы исправите даже все ошибки, выявленные при проверке 32-битной конфигурации проекта, то нельзя считать код полностью совместимым с 64-битными системами. Необходимо обязательно выполнять окончательную проверку в 64-битной конфигурации проекта.
Сообщение V004 выдается только один раз на каждый проект, который проверяется в режиме 32-битной конфигурации. Предупреждение относится к файлу, который будет проанализирован первым при проверке проекта. Это сделано для того, чтобы не выводить множество однотипных предупреждений в отчет.
Данная проблема в работе PVS-Studio вызвана несоответствием для рассматриваемого проекта платформенных конфигураций заданных в solution файле и платформенных конфигураций в самом файле данного проекта.
В частности, в solution файле рассматриваемого проекта могут присутствовать строки следующего вида:
{F56ECFEC-45F9-4485-8A1B-6269E0D27E49}.Release|x64.ActiveCfg = Release|x64
Однако в самом файле проекта может отсутствовать упоминание конфигурации Release|x64. Поэтому, при попытке проверки данного проекта PVS-Studio не может найти конфигурацию Release|x64. В такой ситуации ожидается, что среда Visual Studio должна добавить в автоматически сгенерированный solution-файл строку следующего вида:
{F56ECFEC-45F9-4485-8A1B-6269E0D27E49}.Release|x64.ActiveCfg = Release|Win32
В данном автоматически сгенерированном файле активной конфигурации solution файла (Release|x64.ActiveCfg) для рассматриваемого проекта приравнивается одна из существующих конфигураций данного проекта (т.е. в данном случае Release|Win32). Подобная ситуация является ожидаемой и отрабатывается PVS-Studio корректно.
Сообщение V006 возникает, когда анализатор не может обработать файл за определённое время и аварийно завершает работу.
Причины возникновения
Первая возможная причина — ошибка в анализаторе, при которой не удаётся разобрать определённый фрагмент кода. Несмотря на то, что подобная ситуация возникает нечасто, она всё же возможна. Хотя сообщение V006 возникает достаточно редко, мы будем благодарны, если вы поможете нам устранить проблему, которая привела к его появлению. Если вы работали с проектом на языках C/C++, пришлите, пожалуйста, препроцессированный i-файл, на котором возникла проблема, и соответствующие ему конфигурационные файлы запуска (*.PVS-Studio.cfg и *.PVS-Studio.cmd) через форму обратной связи.
Примечание. Препроцессированный i-файл формируется из исходного файла (например, file.cpp) после работы препроцессора. Чтобы получить препроцессированный файл и конфигурационные файлы запуска, выставите RemoveIntermediateFiles в значение False во вкладке Common Analyzer Settings настроек PVS-Studio и повторно выполните анализ этого файла После этого в папке проекта появится соответствующий i-файл (например, file.i), а также соответствующие ему file.PVS-Studio.cfg и file.PVS-Studio.cmd.
Вторая возможная причина — недостаточное количество системных ресурсов из-за загруженности процессора. Хотя анализатор мог обработать файл корректно, он не успевает сделать это за отведённое время. По умолчанию запускается столько потоков для анализа, сколько имеется ядер в процессоре. Например, на машине с четырьмя ядрами файлы будут анализироваться одновременно в четыре потока. Каждый экземпляр процесса анализатора требует примерно 1,5 гигабайта оперативной памяти. Если её недостаточно, то из-за использования файла подкачки анализ может работать медленно и не успеть в отведённый временной интервал. Кроме того, если на компьютере кроме анализатора запущены другие ресурсоёмкие приложения, то это тоже может вызвать проблему.
В качестве решения можно ограничить количество использованных ядер. Количество используемых при анализе ядер можно задать в настройках PVS-Studio > Common Analyzer Settings > ThreadCount.
Сообщение V007 возникает, когда для анализа выбираются проекты, использующие спецификацию Microsoft C++/Common Language Infrastructure, которые содержат один из устаревших /clr флагов компилятора. Хотя вы можете продолжать проверять такие проекты, PVS-Studio не поддерживает работу с данными флагами компилятора, поэтому некоторые диагностические сообщения анализатора могут оказаться некорректными.
PVS-Studio не смог запустить анализ указанного файла. Данное сообщение означает, что внешний C++ препроцессор, запущенный анализатором для создания препроцессированного файла с исходным кодом, завершил свою работу с ненулевым выходным кодом ошибки. При этом std error зачастую будет содержать подробное описание произошедшей ошибки, которое также можно увидеть в окне PVS-Studio Output для данного файла.
Ошибка V008 может возникнуть по следующим причинам:
1) Код не компилируется
Если исходный C++ код по какой то причине не компилируется (например, не найден включаемый заголовочный файл), препроцессор завершает свою работу с ненулевым кодом и выдаёт в std error сообщение об ошибке вида "fatal compilation error". PVS-Studio не сможет начать анализ в случае, если C++ файл не был успешно препроцессирован. Для устранения ошибки необходимо обеспечить компилируемость проверяемого файла.
2) Повреждён\заблокирован исполняемый файл препроцессора
Такая ситуация возможна в случаях, когда исполняемый файл препроцессора повреждён или заблокирован системным антивирусом. Окно вывода PVS-Studio может также содержать сообщения вида " The system cannot execute the specified program ". Для устранения ошибки необходимо убедиться в целостности исполняемого файла используемого препроцессора и смягчить политики безопасности системного антивирусного ПО.
3) Заблокирован один из вспомогательных командных файлов PVS-Studio
Анализатор PVS-Studio не запускает C++ препроцессор напрямую, а использует для этого собственные предварительно сгенерированные командные файлы. В случае жёстких системных политик безопасности, антивирусное ПО может препятствовать корректному запуску C++ препроцессора. В этом случае ошибка также может быть устранена путём смягчения политики безопасности в отношении анализатора.
4) Используются файлы, в пути которых присутствуют не латинские символы. Эти символы могут некорректно отображаться для текущей кодовой страницы консоли.
PVS-Studio использует бат-файл 'preprocessing.cmd' (в директории установки PVS-Studio) для запуска препроцессирования. В этом файле можно выставить корректную кодовую страницу (при помощи chcp).
Вы ввели лицензионный ключ, предназначенный для бесплатного использования анализатора.
Примечание. Вариант бесплатного лицензирования, основанный на добавлении в код специальных комментариев, больше не поддерживается.
По всем вопросам просим обращаться в поддержку.
Предупреждение V010 выдаётся при попытке проверки .vcxproj-проектов, имеющих конфигурационный тип Makefile или Utility. PVS-Studio не поддерживает работу с такими проектами при использовании плагина или command line версии анализатора. Это связано с тем, что в Makefile/Utility проектах необходимая анализатору информация (в частности, параметры компиляции) о деталях сборки недоступна.
Это же предупреждение выдаётся, если структура .vcxproj-проекта отличается от стандартного Microsoft Visual C++ проекта или если не удалось определить используемый в проекте набор инструментов. В таком случае текст предупреждения будет отличаться:
Unable to determine platform toolset for project: D:\path\to\project.vcxprojПри необходимости проверки таких проектов, пожалуйста, воспользуйтесь системой мониторинга компиляции или прямой интеграцией анализатора. Также вы можете отключить это предупреждение на странице настроек PVS-Studio (вкладка Detectable Errors (C++), список Fails).
Если PVS-Studio успешно определил набор инструментов, но он им не поддерживается, вы увидите следующее сообщение:
Platform toolset of this project is not supported.
If you wish to discuss the feasibility of PVS-Studio supporting this toolset,
please contact our support service.Вы также можете проверить такие проекты с помощью системы мониторинга компиляции. Если вы хотите, чтобы анализатор поддерживал используемый вами нестандартный набор инструментов, обратитесь к нам в техническую поддержку, чтобы обсудить эту возможность.
Директива #line генерируется препроцессором и предназначена для того, чтобы понять, какому файлу и строке соответствует та или иная строка в препроцессированном файле.
Поясним это с помощью примера.
#line 20 "a.h"
void X(); // Объявление функции X находится в 20 строке в файле a.h
void Y(); // Объявление функции Y находится в 21 строке в файле a.h
void Z(); // Объявление функции Z находится в 22 строке в файле a.h
#line 5 "a.cpp"
int foo; // Переменная foo объявлена в 5 строке в файле a.cpp
int X() { // Реализация функции X начинается в 6 строке в файле a.cpp
return 0; // 7 строка
} // 8 строкаДирективы #line используют различные инструменты, в том числе и анализатор PVS-Studio, чтобы осуществлять навигацию по файлу.
Иногда бывает так, что по какой-то причине директивы #line содержатся в файлах с исходным кодом (*.c; *.cpp; *.h и т.д.). Например, такое может произойти, если файл был сгенерирован каким-либо способом автоматически (пример).
При препроцессировании эти директивы #line будут добавлены в препроцессированный *.i файл. Например, пусть есть файл A.cpp следующего вида:
int a;
#line 30 "My.y"
int b = 10 / 0;После препроцессирования получится файл A.i следующего содержания:
#line 1 "A.cpp"
int a;
#line 30 "My.y"
int b = 10 / 0;В результате, навигация будет сломана. Анализатор обнаружит деление на ноль и выдаст сообщение, что эта ошибка находится в 30 строке в файле My.y. Формально анализатор прав, ведь ошибка действительно появилась из-за некорректного текста программы в файле My.y. Однако навигация сломана, и вы не сможете просмотреть файл My.y, так как этого файла может просто не быть в проекте. При этом вы не узнаете, что сейчас деление на 0 на самом деле возникает в 3 строке файла A.cpp.
Чтобы исправить ситуацию, мы предлагаем удалить все директивы #line, которые присутствуют в исходных файлах вашего проекта. Как правило, эти директивы оказались в файле случайно и никому не помогают, а только вносят путаницу, мешая работе различных инструментов, таких как анализаторы кода.
Чтобы обнаружить вредные #line в исходном коде и предназначена диагностика V011. Анализатор указывает на 10 первых #line в файле. Большее количество указывать не рационально. Вы можете самостоятельно легко найти с помощью поиска в используемом вами редакторе кода все директивы #line и удалить их.
Исправленный вариант кода:
int a;
int b = 10 / 0;После препроцессирования будет получен *.i файл следующего содержания:
#line 1 "A.cpp"
int a;
int b = 10 / 0;Теперь навигация будет работать правильно и анализатор предупредит, что деление на 0 возникнет во второй строке файла A.cpp.
Некоторые способы подавления ложных срабатываний позволяют полностью отключать диагностики анализатора. В результате часть сообщений будет не просто отмечена как ложные срабатывания, а могут совсем не появиться в отчете.
Чтобы выяснить, какие механизмы участвуют в отключении диагностик, можно включить добавление специальных сообщений в отчёт анализатора.
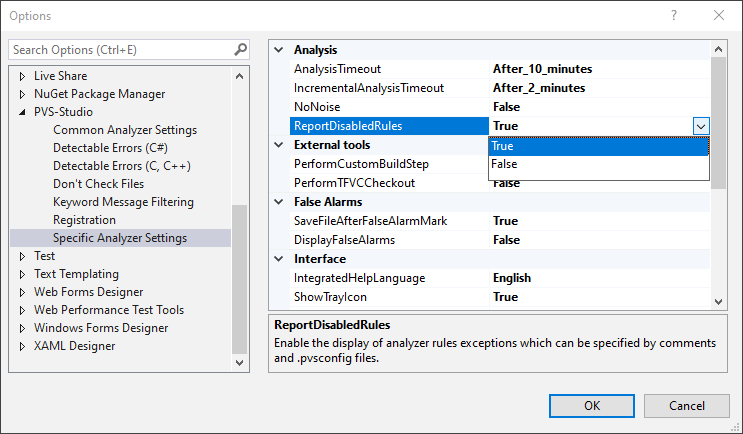
pvs-studio-analyzer analyze ... --cfg source.cpp.PVS-Studio.cfgВ результате, в отчете анализатора появятся сообщения с кодом V012 и информацией об источниках отключения диагностик. IDE плагины PVS-Studio поддерживают навигацию к причине отключения диагностик в файлах исходного кода и файлах конфигурации правил (.pvsconfig). Пути до файлов конфигурации, содержащих правила исключения срабатываний анализатора, также будут добавлены в отчёт анализатора, в виде сообщений V012.
Запуск межмодульного анализа на ограниченном списке файлов проекта приведет к потере межпроцедурной информации. Данное предупреждение актуально только для C и C++ проектов.
Межмодульный анализ выполняется в 3 этапа:
Для обеспечения наибольшей эффективности межмодульного анализа рекомендуется запускать его на всём проекте целиком. В таком случае объем собранных межпроцедурных фактов будет максимальным, и, следовательно, тем более качественным будет анализ и тем больше сообщений гипотетически анализатор сможет найти.
Ваш suppress файл имеет старый формат. Вы все еще можете использовать его для подавления предупреждений, однако для добавления новых вам придется его перегенерировать.
Для создания нового suppress файла вам нужно:
Подробнее про работу с suppress файлом можно прочитать в документации.
Предупреждение V015 говорит о том, что у вас имеются предупреждения анализатора, но они не отображены в окне PVS-Studio. Это может происходить как из-за настроек фильтрации в окне PVS-Studio, так из-за глобальных настроек анализатора.
Чтобы отобразить все "спрятанные" предупреждения, необходимо убедиться в том, что настроенные фильтры ничего не скрывают. Ниже приведено более подробное описание фильтров.
Первое, на что нужно обратить внимание – активные фильтры для просмотра предупреждений. Очень часто именно эти фильтры скрывают от вас предупреждения.
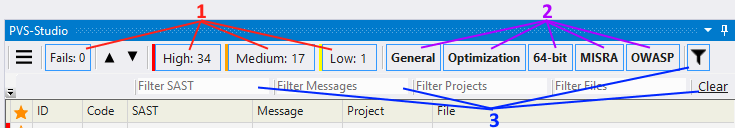
Окно PVS-Studio предоставляет следующие механизмы фильтрации:
Убедитесь в том, что перечисленные фильтры не скрывают срабатывания анализатора. Для этого активируйте кнопки-фильтры, щелкнув на них мышкой, и сбросьте все пользовательские фильтры по предупреждениям, нажав на 'Clear'.
Также на отображение предупреждений влияет настройка вкладки 'PVS-Studio > Options ... > Don't Check Files', в которой прописаны файловые маски для исключения некоторых файлов или папок из анализа. Убедитесь в том, что среди файловых масок нет таких, которые исключают предупреждения по интересующим вас файлам/путям.
Если V015 по-прежнему не пропадает, проверьте предупреждения, помеченные как FA (false alarm). По умолчанию эти предупреждения не отображаются в окне PVS-Studio. Чтобы они отображались, вам нужно активировать соответствующую настройку: 'PVS-Studio > Options ... > Specific Analyzer Settings > False Alarms > DisplayFalseAlarms > True'. После этого в окне PVS-Studio отобразятся предупреждения из группы FA, если они у вас были.
При помощи механизма пользовательских аннотаций можно дополнительно настроить диагностические правила анализатора. Одним из вариантов пользовательских аннотаций являются аннотации функций.
Пример такой аннотации:
//V_FORMATTED_IO_FUNC, function:Log, format_arg:1, ellipsis_arg:2
void Log(const char *fmt, ...);Однако аннотации по умолчанию не применяются к виртуальным функциям. Диагностическое предупреждение V016 сообщает пользователю о том, что его аннотация не была применена к виртуальной функции, и рекомендует исправить это при помощи специальных флагов, которые дописываются в аннотацию:
Например, аннотация для виртуальной функции 'Log' класса 'Base' будет выглядеть следующим образом:
// Комментарий должен быть расположен на одной линии
//V_FORMATTED_IO_FUNC, function:Base::Log,
format_arg:1, ellipsis_arg:2,
enable_on_virtual
struct Base
{
virtual void Log(const char *fmt, ...);
}Вместо 'enable_on_virtual' может быть указан флаг 'propagate_on_virtual'. Тогда аннотация будет применена и к переопределениям функции в дочерних классах:
// Комментарий должен быть расположен на одной линии
//V_FORMATTED_IO_FUNC, function: Base::Log,
format_arg:1, ellipsis_arg:2,
propagate_on_virtual
struct Base
{
virtual void Log(const char *fmt, ...);
}
struct Derived
{
// Аннотация будет действовать и на эту функцию
virtual void Log(const char *fmt, ...) override;
}Наличие предупреждения V017 в отчёте означает, что анализ был экстренно остановлен из-за нехватки свободной оперативной памяти, необходимой для работы. Обычно такое происходит, когда анализ запускается с большим количеством потоков относительно малого количества свободной оперативной памяти.
Для стабильной работы ядра C и C++ анализатора на каждый поток анализа требуется не менее 2 ГБ памяти. Существуют несколько вариантов решения проблемы:
Примечание. Попытка решить проблему только путём увеличения размера файла подкачки может привести к предупреждению V006.
Далее описаны способы снижения числа потоков анализа в различных компонентах продукта.
Плагины для IDE. В настройках плагина PVS-Studio установите опцию 'ThreadCount' в меньшее значение.
PVS-Studio_Cmd / pvs-studio-dotnet. В файле конфигурации анализа ('Settings.xml') установите опцию 'ThreadCount' в меньшее значение.
CompilerCommandsAnalyzer / pvs-studio-analyzer. Уменьшите число, передаваемое в параметр '-j' / '--threads'.
Интеграция с Unreal Build Tool. Воспользуйтесь файлом 'BuildConfiguration.xml' со следующими опциями:
<?xml version="1.0" encoding="utf-8" ?>
<Configuration xmlns="https://www.unrealengine.com/BuildConfiguration">
<ParallelExecutor>
<MaxProcessorCount>1</MaxProcessorCount>
</ParallelExecutor>
</Configuration>Если после применения всех советов в отчёте продолжает появляться предупреждение V017, мы будем благодарны, если вы пришлёте нам файлы, описанные здесь, через форму обратной связи.
Наличие предупреждения V018 в отчёте означает, что в исходном коде анализируемой программы содержатся строчки, отмеченные False Alarm меткой без хэша, и при этом в настройках анализатора включена опция V_HASH_ONLY.
//V_HASH_ONLY ENABLEЕсли включить эту настройку, то в следующем фрагменте False Alarm метка на первой строчке не сработает:
int b = a; //-V614
int* c = nullptr;
b = *c; //-V522 //-VH"1949"Подробнее об этой настройке можно прочитать в документации.
Чтобы исправить данное срабатывание, можно добавить хеши к тем False Alarm меткам, в которых они отсутствуют. В этом случае предупреждения будут выдаваться, только если строчка, содержащая False Alarm метку с хэшем, изменилась после добавления этого хэша. Подробнее об этом режиме можно прочитать в этой и этой документации.
Помимо этого, можно убрать False Alarm метки без хешей.
Если способы, указанные выше, не подходят, то удалите настройку:
//V_HASH_ONLY ENABLEТакже настройку можно выключить через директиву:
//V_HASH_ONLY DISABLEПодобное отключение директивы может быть полезно в случае, если необходимо применить настройку к конкретному блоку кода.
Наличие предупреждения V019 в отчёте означает, что возникли проблемы при работе с пользовательскими аннотациями.
Предупреждение может быть выдано в следующих ситуациях:
Наличие предупреждения V020 в отчёте означает, что анализ был запущен с неправильной конфигурацией. Конкретная причина ошибки указывается вместе с сообщением диагностики.
Если проблему не удалось устранить самостоятельно, мы будем рады вам помочь. Для этого напишите нам через форму обратной связи, какие именно настройки (или их сочетание) привели к появлению проблемы.
Для решения проблемы нам также могут потребоваться логи работы анализатора. О том, как получить диагностические логи, можно узнать в разделе "Диагностика работы анализатора PVS-Studio".
Предупреждение V021 в отчёте означает, что анализ тела функции был прерван на указанной позиции, поскольку были превышены установленные лимиты алгоритма анализа.
Обычно такое происходит, когда исходный код содержит конструкции, анализ которых занимает слишком много времени, например очень глубокие вложенные циклы, написанные вручную, сгенерированные автоматически или полученные путём раскрытия макросов.
Чтобы сохранить производительность и избежать ложных срабатываний, в анализаторе установлены ограничения:
По достижении указанных лимитов анализ потока данных и диагностические правила отключаются, начиная с указанной в предупреждении позиции и до конца функции.
Сообщение V051 означает, что после загрузки в анализатор, C# проект содержит ошибки компиляции. Обычно к таким ошибкам относятся неизвестные типы данных, пространства имён и сборки (dll файлы). Чаще всего подобная ошибка возникает, когда производится попытка проверить проект, имеющий в зависимостях сборки из nuget пакетов, отсутствующие на локальной машине, либо сторонние библиотеки, отсутствующие среди проектов в выбранном решении.
Несмотря на данную ошибку, анализатор попытается проверить ту часть кода, которая не содержит неопределённых типов, однако результаты такого анализа могут быть неполными - часть сообщений анализатора может быть потеряна. Это связано с тем, что для корректной работы большинству диагностик анализатора требуется полная информация обо всех типах данных, встречающихся в проверяемых исходных файлах, в том числе и о типах, реализованных в сторонних сборках.
Даже если восстановление файлов зависимостей проекта включено в его сборочный сценарий, анализатор не будет выполнять полной пересборки проекта самостоятельно. Поэтому перед проверкой проекта мы рекомендуем обеспечить его полную собираемость, включая наличие всех сборок (dll файлов), от которых проект зависит.
Иногда анализатор может ошибаться, и выдавать такое сообщение на полностью компилирующийся проект, содержащий все зависимости. Это может произойти, например, если проект использует нестандартный сборочный сценарий MSBuild. Например, проектные файлы csproj импортируют какие-либо дополнительные props и target файлы. В таком случае вы можете игнорировать сообщение V051 либо отключить его отображение в настройках анализатора.
Если вы хотите узнать, какая именно ошибка компилятора приводит к V051, запустите анализ вашего проекта с помощью cmd версии анализатора, добавив к строке запуска флаг '--logCompilerErrors' (одной строчкой):
PVS-Studio_Cmd.exe –t MyProject.sln –p "Any CPU" –c "Debug"
--logCompilerErrorsВы можете подавить ошибки, которые приводят к выдаче V051, с помощью .pvsconfig файла. Подробнее про это можно почитать в документации.
Сообщение V052 предупреждает, что произошла критическая ошибка в анализаторе. Скорее всего, в этом случае часть файлов не будет проанализирована.
Дополнительную информацию об этой ошибке можно получить из двух источников: файла отчёта анализатора plog и стандартного потока вывода сообщений об ошибках stderr (при использовании command line версии).
При использовании Visual Studio IDE или standalone-приложения PVS-Studio, стек ошибки выводится в окно PVS-Studio, a также записывается в начало файла plog. При этом стек разбивается на подстроки, каждая из которых фиксируется и отображается как отдельная ошибка без номера.
В случае работы из командной строки вы можете проанализировать код возврата command line версии, понять, что произошло исключение, и уже затем изучить plog, не открывая его в Visual Studio IDE или standalone-приложении. Для этого отчёт можно преобразовать, например, в текстовый файл при помощи утилиты PlogConverter. Коды возврата command line версии описаны в разделе документации "Проверка проектов Visual Studio / MSBuild / .NET из командной строки с помощью PVS-Studio". Информацию об использовании PlogConverter можно найти в соответствующей документации: "Просмотр и конвертация результатов анализа (форматы SARIF, HTML и др.)".
Хотя сообщение V052 возникает достаточно редко, мы будем вам благодарны, если вы поможете нам устранить проблему, которая привела к его появлению. Для этого пришлите, пожалуйста, стек ошибки из окна PVS-Studio (или из stderr в случае использования command line версии) через форму обратной связи.
Сообщение V053 означает, что C# анализатор PVS-Studio не смог получить встроенные .NET-типы. К ним относятся: System.Object, System.String, System.Int32 и т. д. На таком проекте нельзя корректно провести анализ, поэтому он не будет проанализирован.
Чаще всего V053 возникает из-за того, что проект не был собран или сборка завершилась некорректно. Основное решение проблемы загрузки встроенных .NET типов — перед анализом собрать проект, для которого выдаётся V053.
Другие ситуации, в которых возможно возникновение ошибки:
.sln) есть global.json, который применяется при сборке решения, global.json не всегда может быть обнаружен при анализе этого решения (даже если его сборка проходит успешно). Чтобы global.json применился при анализе решения, он должен располагаться в одной из родительских директорий для всех проектов (csproj) этого решения.Если ошибка V053 сохраняется, пожалуйста, напишите об этом через форму обратной связи.
Чтобы диагностировать проблему, нам понадобится информация об ошибках компиляции и бинарные логи сборки (содержат информацию о построении модели проекта). Для получения этой информации проблемный проект нужно проанализировать из командной строки. Помимо обязательных аргументов анализатора необходимо передать аргументы --logCompilerErrors и --createBinaryLogs. После завершения анализа в консоль будет выведена информация о расположении логов с ошибками компиляции и бинарных логов.
Сообщение V061 означает, что во время работы анализатора произошла непредвиденная ошибка. Причиной может быть непредусмотренное исключение в анализаторе.
Пожалуйста, напишите нам в поддержку и приложите текстовые файлы из директории .PVS-Studio (находится в директории с проектом), чтобы мы смогли как можно скорее исправить данную ошибку.
Чтобы нам было проще решить проблему, рекомендуем использовать параметр verbose в конфигурации анализатора. Так, анализатор в процессе работы будет сохранять дополнительную информацию в директории .PVS-Studio.
В плагине для Maven:
<verbose>true</verbose>В плагине для Gradle:
verbose = trueВ плагине для IntelliJ IDEA:
1) Analyze > PVS-Studio > Settings
2) Вкладка Misc -> убрать галочку с Remove intermediate files
Сообщение V062 означает, что плагину не удалось запустить ядро анализатора. Скорее всего это связано с тем, что ядро запускалось с некорректной версией Java. Для корректной работы ядро должно запускаться с 64-битной Java версией 11 или выше. По умолчанию анализатор использует Java интерпретатор из переменной окружения PATH.
Путь до требуемого Java интерпретатора можно указать вручную.
В плагине для Maven:
<javaPath>C:/Program Files/Java/jdk11.0.17/bin/java.exe</javaPath>В плагине для Gradle:
javaPath = "C:/Program Files/Java/jdk11.0.17/bin/java.exe"В плагине для IntelliJ IDEA:
1) Analyze -> PVS-Studio -> Settings
2) Вкладка Environment -> Java executable
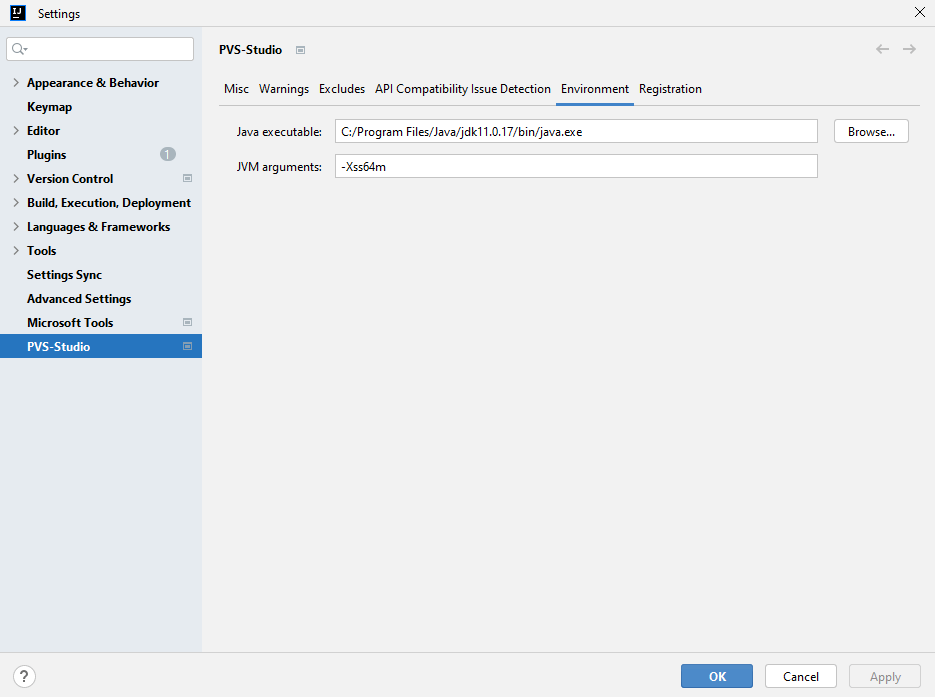
В случае если все же не удается запустить анализ, пожалуйста, напишите нам в поддержку и приложите текстовые файлы из директории .PVS-Studio (находится в директории с проектом). Мы постараемся как можно скорее разобраться в Вашей проблеме.
Сообщение V063 означает, что анализатор не смог проанализировать какой-либо файл за отведенное время (по умолчанию 10 минут). Зачастую подобные сообщения также сопровождаются сообщениями "GC overhead limit exceeded".
Иногда эту проблему можно решить просто увеличив доступный анализатору объем памяти и стека.
В плагине для Maven:
<jvmArguments>-Xmx4096m, -Xss256m</jvmArguments>В плагине для Gradle:
jvmArguments = ["-Xmx4096m", "-Xss256m"]В плагине для IntelliJ IDEA:
1) Analyze -> PVS-Studio -> Settings
2) Вкладка Environment -> JVM arguments
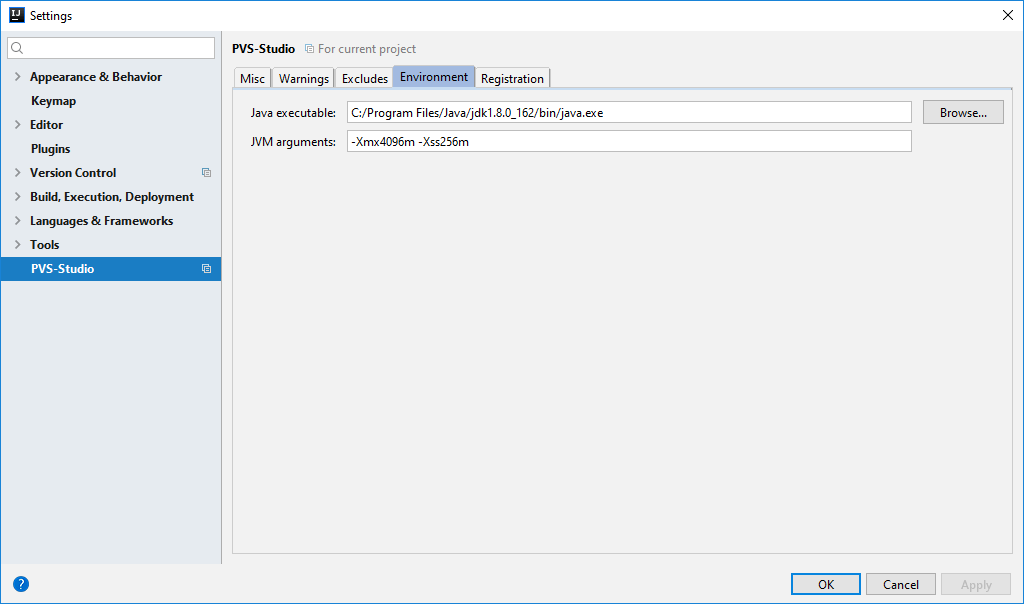
Обычно объема памяти по умолчанию может не хватать при анализе сгенерированного кода с большим количеством вложенных конструкций.
Возможно, стоит исключить этот код из анализа (с помощью 'exclude'), чтобы не тратить на него лишнее время.
Кроме того, V063 может возникать, если из-за загруженности процессора анализатору достается мало системных ресурсов и, хотя файл он мог бы обработать корректно, он не успевает сделать это за отведенное время.
Если все же не удается проверить какой-то файл, это может свидетельствовать об ошибке в анализаторе. В таком случае, пожалуйста, напишите нам в поддержку и приложите текстовые файлы из директории .PVS-Studio (находится в директории с проектом), а также примерный код, на котором возникает проблема, чтобы мы смогли как можно скорее исправить данную ошибку.
Данная ошибка свидетельствует о том, что анализатор не смог проанализировать фрагмент кода указанным диагностическим правилом.
Причиной может быть неполная модель, построенная анализатором. В этом случае следует удалить директорию .PVS-Studio/models (находится в директории с проектом) и заново запустить анализ. Если это не помогло, пожалуйста, напишите нам в поддержку и приложите текстовые файлы из директории .PVS-Studio, чтобы мы смогли как можно скорее исправить данную ошибку.
Кроме того, чтобы получить дополнительную информацию о проблеме, можно использовать verbose режим, как это описано в документации к диагностике V061.
Данная ошибка свидетельствует о том, что анализатор не смог построить модель указанного модуля проекта. Это значит, что модуль не будет проанализирован.
Пожалуйста, напишите нам в поддержку и приложите текстовые файлы из директории .PVS-Studio (находится в директории с проектом), чтобы мы смогли как можно скорее исправить данную ошибку.
Кроме того, чтобы получить дополнительную информацию о проблеме, можно использовать verbose режим, как это описано в документации к диагностике V061.
Наличие предупреждения V066 в отчёте означает, что анализатор был запущен с неправильной версией Java, из-за этого указанный модуль не будет проанализирован.
Для того чтобы устранить данную проблему, рекомендуется обратить внимание на:
Версии Java модуля и анализатора должны либо совпадать, либо версия Java анализатора должна быть выше.
Дополнительная информация об указании версии Java описана здесь:
Если запустить анализ не удаётся, напишите в поддержку и приложите текстовые файлы из директории .PVS-Studio (она находится в директории с проектом). Мы постараемся как можно быстрее разобраться в проблеме.
Предупреждение в отчёте указывает на то, что во время работы анализатора произошла непредвиденная ошибка.
Пожалуйста, обратитесь в поддержку и приложите файлы из директории с логами анализатора и отчёт анализатора, чтобы мы могли как можно скорее исправить данную ошибку. Для сохранения файлов логов запустите анализ с флагом --keep-intermediate-files. Директория с логами находится по следующему пути:
%TEMP%\PVS-Studio LLC\pvs-js\logs\<имя_проекта>_*`~/.local/state/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/ или $XDG_STATE_HOME/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/Предупреждение сообщает, что анализатор не смог провести синтаксический разбор исходного файла, поэтому он не будет проанализирован.
Пожалуйста, обратитесь в поддержку и приложите файлы из директории с логами анализатора и отчёт анализатора, чтобы мы могли как можно скорее исправить данную ошибку. Для сохранения файлов логов запустите анализ с флагом --keep-intermediate-files. Директория с логами находится по следующему пути:
%TEMP%\PVS-Studio LLC\pvs-js\logs\<имя_проекта>_*`~/.local/state/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/ или $XDG_STATE_HOME/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/Предупреждение сообщает, что анализатор не смог проанализировать фрагмент кода. Этот участок кода будет пропущен указанным в сообщении диагностическим правилом, либо файл не будет проанализирован полностью.
Пожалуйста, обратитесь в поддержку и приложите файлы из директории с логами анализатора и отчёт анализатора, чтобы мы могли как можно скорее исправить данную ошибку. Для сохранения файлов логов запустите анализ с флагом --keep-intermediate-files. Директория с логами находится по следующему пути:
%TEMP%\PVS-Studio LLC\pvs-js\logs\<имя_проекта>_*`~/.local/state/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/ или $XDG_STATE_HOME/PVS-Studio LLC/pvs-js/logs/<имя_проекта>_*/Сообщение V074 возникает, когда анализатор не может проанализировать файл за определённое время и аварийно завершает работу.
V074 может возникать из-за загруженности процессора. Анализатору достаётся мало системных ресурсов, и он не успевает обработать файл за отведённое время.
Также V074 может свидетельствовать об ошибке в анализаторе. Вы можете написать нам через форму обратной связи и приложите примерный код, на котором возникает проблема, чтобы мы смогли как можно скорее исправить данную ошибку.
Предупреждение выдаётся, если анализатор не смог запустить анализ исходного файла, поэтому он не будет проанализирован.
Пожалуйста, обратитесь в поддержку и приложите файлы из директории с логами анализатора и его отчётом, чтобы мы могли как можно скорее исправить данную ошибку. Для сохранения файлов логов запустите анализ с флагом --keep-intermediate-files. Директория с логами находится по следующему пути:
%TEMP%\PVS-Studio LLC\pvs-golang\logs\<имя_проекта>_*`~/.local/state/PVS-Studio LLC/pvs-golang /logs/<имя_проекта>_*/ или $XDG_STATE_HOME/PVS-Studio LLC/pvs-golang/logs/<имя_проекта>_*/Сообщение V082 означает, что в анализаторе произошла критическая ошибка. Скорее всего, часть файлов не будет проанализирована.
Мы будем благодарны, если вы поможете нам устранить проблему, которая привела к появлению этого предупреждения. Для этого отправьте нам консольный вывод CLI-версии анализатора через форму обратной связи.
Сообщение V083 возникает, когда анализатор не может проанализировать файл за определённое время и аварийно завершает работу.
V083 может возникать из-за загруженности процессора. Анализатору достаётся мало системных ресурсов, и он не успевает обработать файл за отведённое время.
Также V083 может свидетельствовать об ошибке в анализаторе. Вы можете написать нам через форму обратной связи и приложите примерный код, на котором возникает проблема, чтобы мы смогли как можно скорее исправить данную ошибку.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением типа при выполнении оператора присваивания "=". Ошибка может заключаться в некорректном вычислении значения выражения, стоящего справа от оператора присваивания "=".
Пример кода, вызывающего предупреждение:
size_t a;
unsigned b;
...
a = b; // V101Сама по себе операция приведения 32-битного типа к memsize-типу безопасна, поскольку не происходит потери данных. Например, в переменной типа size_t всегда можно сохранить значение переменной типа unsigned. Но наличие такого приведения типа может указывать на скрытую ошибку, допущенную ранее.
Первой причиной возникновения ошибки на 64-битной системе может служить изменение процесса вычисления выражений. Рассмотрим пример:
unsigned a = 10;
int b = -11;
ptrdiff_t c = a + b; //V101
cout << c << endl;Данный код на 32-битной системе распечатает значение -1, а на 64-битной системе 4294967295. Данное поведение полностью согласуется с правилами приведения типов в языке Си++, но скорее всего приведет к ошибке в реальном коде.
Поясним приведенный пример. Согласно правилам языка Си++ выражение a+b имеет тип unsigned и содержит значение 0xFFFFFFFFu. На 32-битной системе тип ptrdiff_t представляет собой знаковый 32-битный тип. После присвоения 32-битной знаковой переменной значения 0xFFFFFFFFu она будет содержать значение -1. На 64-битной системе тип ptrdiff_t представляет собой знаковый 64-битный тип. Это означает, что число 0xFFFFFFFFu будет представлено как оно есть. То есть значение переменной после присваивания будет равняться 4294967295.
Ошибку можно исправить, исключив смешанное использования memsize и не memsize-типов в одном выражении. Пример исправления кода:
size_t a = 10;
ptrdiff_t b = -11;
ptrdiff_t c = a + b;
cout << c << endl;Еще более корректным способом исправления будет отказ от смешенного использования знаковых и беззнаковых типов данных.
Второй причиной ошибки может стать переполнение, возникающее в 32-битных типах данных. В этом случае ошибка может содержаться раньше самого оператора присваивания, но обнаружить ее можно только косвенно. Такие ошибки часто встречаются в коде, выделяющим большие объемы памяти. Рассмотрим пример:
unsigned Width = 1800;
unsigned Height = 1800;
unsigned Depth = 1800;
// Real error is here
unsigned CellCount = Width * Height * Depth;
// Here we get a diagnostic message V101
size_t ArraySize = CellCount * sizeof(char);
cout << ArraySize << endl;
void *Array = malloc(ArraySize);Предположим, что на 64-битной системе мы решили обрабатывать массивы данных более 4 гигабайт. В этом случае показанный код приведет к выделению ошибочного объема памяти. Программист планирует выделить 5832000000 байт оперативной памяти, а вместо этого получит в свое распоряжение только 1537032704. Это происходит из-за переполнения при вычислении выражения Width * Height * Depth. К сожалению мы не можем диагностировать ошибку в строке с этим выражением, но мы можем косвенно указать на наличие ошибки, обнаружив приведение типа в строке:
size_t ArraySize = CellCount * sizeof(char); //V101Исправление ошибки заключается в использовании типов, позволяющих хранить необходимый диапозон значений. Заметьте, что исправлние следующего вида не является корректным:
size_t CellCount = Width * Height * Depth;Здесь мы по-прежнему имеем переполнение. Приведем два примера корректного исправления кода:
// 1)
unsigned Width = 1800;
unsigned Height = 1800;
unsigned Depth = 1800;
size_t CellCount =
static_cast<size_t>(Width) *
static_cast<size_t>(Height) *
static_cast<size_t>(Depth);// 2)
size_t Width = 1800;
size_t Height = 1800;
size_t Depth = 1800;
size_t CellCount = Width * Height * Depth;Следует учитывать, что ошибка может находиться не просто выше, а вообще в другом модуле. Приведем соответствующий пример. В нем ошибка заключается в некорректном вычислении индекса, если размер массива превысит 4 Гб.
Пусть приложение использует большой одномерный массив, и функция CalcIndex позволяет адресоваться к этому массиву как к двумерному массиву.
extern unsigned ArrayWidth;
unsigned CalcIndex(unsigned x, unsigned y) {
return x + y * ArrayWidth;
}
...
const size_t index = CalcIndex(x, y); //V101Анализатор сообщит о проблеме в строке: const size_t index = CalcIndex(x, y). Но ошибка заключается в неправильной реализации функции CalcIndex. Если взять функцию CalcIndex отдельно, то она абсолютно корректна. Типом выходного и входных значений является unsigned. Вычисления также происходят с участием только типов unsigned. Никаких явных или неявных приведений типов нет, и анализатор не имеет возможности распознать логическую проблему, связанную с функцией CalcIndex. Ошибка заключается в том, что неверно выбран результат, возвращаемый функцией, а возможно и входных значений. Результат функции должен иметь тип memsize.
К счастью анализатор смог обнаружить неявное приведение результата функции CalcIndex к типу size_t. Это позволяет вам проанализировать ситуацию и внести в программу необходимые изменения. Исправление ошибки, например, может выглядеть следующим образом:
extern size_t ArrayWidth;
size_t CalcIndex(size_t x, size_t y) {
return x + y * ArrayWidth;
}
...
const size_t index = CalcIndex(x, y);Если вы уверены, что код верен и размер массива никогда не приблизится к границе в 4Гб, вы можете подавить предупреждение анализатора, используя явное приведение типа:
extern unsigned ArrayWidth;
unsigned CalcIndex(unsigned x, unsigned y) {
return x + y * ArrayWidth;
}
...
const size_t index = static_cast<size_t>(CalcIndex(x, y));В ряде случаев и сам анализатор может понять, что переполнение при вычислении невозможно и предупреждение не будет распечатано.
Рассмотрим последний пример, связанный с некорректными операциями сдвига.
ptrdiff_t SetBitN(ptrdiff_t value, unsigned bitNum) {
ptrdiff_t mask = 1 << bitNum; //V101
return value | mask;
}Выражение " mask = 1 << bitNum " является опасным, так как данный код не может выставить в единицы старшие разряды 64-битной переменной mask. Если попробовать использовать функцию SetBitN для выставления, например, 33-го бита, то произойдет переполнение при выполнении операции сдвига и желаемый результат не будет достигнут.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку в адресной арифметике с указателями. Ошибка может заключаться в переполнении при вычислении выражения.
Рассмотрим пример.
short a16, b16, c16;
char *pointer;
...
pointer += a16 * b16 * c16;Данный пример корректно работает с указателями, если значение выражения "a16 * b16 * c16" не превышает 'INT_MAX' (2Гб). Такой код мог всегда корректно работать на 32-битной платформе, в силу того, что программа никогда не выделяла массивов больших размеров. На 64-битной архитектуре программиста, использующего старый код для работы с массивом большего размера, ждет разочарование. Допустим, мы хотим сдвинуть значение указателя на 3000000000 байт, и по этому переменные 'a16', 'b16' и 'c16' имеют значения 3000, 1000 и 1000 соответственно. При вычислении выражения "a16 * b16 * c16" все переменные, согласно правилам языка Си++, будут приведены к типу int, а уже затем будет произведено их умножение. В ходе выполнения умножения, произойдет переполнение, в результате которого будет получено число -1294967296. Некорректный результат выражения будет расширен до типа 'ptrdiff_t' и произойдет вычисление указателя. В результате нас будет ожидать аварийное завершение программы, при попытке использования некорректного указателя.
Для предотвращения подобных ошибок следует использовать memsize типы. В нашем случае будет корректно заменить типы переменных 'a16', 'b16', 'c16' или использовать их явное приведение к типу 'ptrdiff_t', как показано ниже:
short a16, b16, c16;
char *pointer;
...
pointer += static_cast<ptrdiff_t>(a16) *
static_cast<ptrdiff_t>(b16) *
static_cast<ptrdiff_t>(c16)Хочется отметить, что не всегда использование в арифметике с указателями не memsize типов является ошибочным. Рассмотрим следующую ситуацию:
char ch;
short a16;
int *pointer;
...
int *decodePtr = pointer + ch * a16;Анализатор не выдает на нее сообщения, в силу ее корректности. Здесь не происходит вычислений, которые могли бы привести к переполнению и результат этого выражения всегда будет корректен как на 32-битной, так и на 64-битной платформе.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением memsize типа к 32-битному типу. Ошибка заключается в потере старших бит в 64-битном типе, что влечет потерю значения. Компилятор также диагностирует подобные приведения типов и выдает предупреждения. К сожалению, часто подобные предупреждения отключают, особенно когда в проекте присутствует много старого унаследованного кода или используются старые библиотеки. Чтобы не заставлять программиста просматривать сотни и тысячи подобных предупреждений, выдаваемых компилятором, анализатор информирует только о тех из них, которые могут быть причиной некорректной работы кода на 64-битной платформе.
Первый пример.
Наше приложение работает с видеоизображениями, и мы хотим посчитать, какой размер файла нам потребуется, чтобы сохранить все кадры, находящиеся в памяти, в файл.
size_t Width, Height, FrameCount;
...
unsigned BufferSizeForWrite = Width * Height * FrameCount *
sizeof(RGBStruct);Раньше общий объем видеокадров в памяти никогда не мог превышать 4 Гб (на практике 2-3 Гб, в зависимости от разновидности ОС Windows). На 64-битной платформе мы получили возможность хранить в памяти намного больше кадров, и предположим, что их общий объем составляет 10 Гб. В результате при помещении результата выражения "Width * Height * FrameCount * sizeof(RGBStruct)" в переменную 'BufferSizeForWrite', мы отбросим старшие биты и будем работать с некорректным значением.
Правильным решением будет замена типа переменной 'BufferSizeForWrite' на тип 'size_t'.
size_t Width, Height, FrameCount;
...
size_t BufferSizeForWrite = Width * Height * FrameCount *
sizeof(RGBStruct);Второй пример.
Сохранение в 32-битном типе результата вычитания одного указателя из другого.
char *ptr_1, *ptr_2;
...
int diff = ptr_2 - ptr_1;Если указатели различаются более чем на 'INT_MAX' байт (2 Гб), то произойдет обрезание значения при присваивании. В результате переменная 'diff' будет иметь некорректное значение. Для хранения полученного значения следует использовать тип 'ptrdiff_t' или другой memsize тип.
char *ptr_1, *ptr_2;
...
ptrdiff_t diff = ptr_2 - ptr_1;В тех случаях, когда вы точно уверены в корректности кода, и неявное приведение типа не влечет ошибок при переходе на 64-битную архитектуру, вы можете использовать явное приведение типа для того, чтобы избежать вывода диагностических сообщений в этой строке. Пример:
unsigned BitCount = static_cast<unsigned>(sizeof(RGBStruct) * 8);В том случае, если вы подозреваете наличие в своем коде некорректных явных приведений memsize типов к 32-битным типам, на которые анализатор не выдает предупреждения, то вы можете воспользоваться правилом V202.
Как было сказано ранее, анализатор информирует только о тех приведениях типов, которые могут быть причиной некорректной работы кода на 64-битной платформе. Приведенный ниже код не будет диагностироваться как ошибочный, хотя в нем происходит приведение memsize типов к типу int:
int size = sizeof(float);Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку внутри арифметического выражения, связанную с неявным приведением к типу memsize. Ошибка переполнения может быть связана с изменением допустимого интервала значений переменных, входящих в выражение.
Первый пример.
Некорректные выражения сравнения. Рассмотрим код:
size_t n;
unsigned i;
// Infinite loop (n > UINT_MAX).
for (i = 0; i != n; ++i) { ... }В примере показана ошибка, связанная с неявным приведением типа 'unsigned' к типу 'size_t' при выполнении операции сравнения.
На 64-битной платформе у вас может появиться возможность обрабатывать больший объем данных, и значение переменной 'n' может превысить число 'UINT_MAX' (4 Гб). В результате, условие "i != n" всегда будет истинно, что приведет к вечному циклу.
Пример исправленного кода:
size_t n;
size_t i;
for (i = 0; i != n; ++i) { ... }Второй пример.
char *begin, *end;
int bufLen, bufCount;
...
ptrdiff_t diff = begin - end + bufLen * bufCount;Неявное приведение типа 'int' к типу 'ptrdiff_t' зачастую служит признаком ошибки. Следует обратить внимание, что приведение происходит не при выполнении оператора "=" (так как выражение "begin - end + bufLen * bufCount" имеет тип 'ptrdiff_t'), а внутри этого выражения. Подвыражение "begin - end" согласно правилам языка С++ имеет тип 'ptrdiff_t', а правая "bufLen * bufCount" тип 'int'. При переходе на 64-битную платформу программа может начать обрабатывать больший объем данных, в результате чего может произойти переполнение при вычислении подвыражения "bufLen * bufCount".
Следует изменить тип переменных 'bufLen' и 'bufCount' на memsize тип или использовать явное приведение типа, как показано на примере:
char *begin, *end;
int bufLen, bufCount;
...
ptrdiff_t diff = begin - end +
ptrdiff_t(bufLen) * ptrdiff_t(bufCount);Отметим, что неявное приведение к типу memsize внутри выражений не всегда является ошибочным. Рассмотрим следующую ситуацию:
size_t value;
char c1, c2;
size_t result = value + c1 * c2;Анализатор не выдает сообщения, хотя здесь происходит приведение типа 'int' к 'size_t', так как при вычислении подвыражения "c1 * c2" переполнения произойти не может.
Если вы подозреваете в программе наличие ошибок, связанных с некорректным явным приведением типов в выражениях, то Вы можете воспользоваться правилом V201. Пример ситуации, при которой явное приведение типа к 'size_t' скрывает ошибку, представлен ниже:
int i;
size_t st;
...
st = size_t(i * i * i) * st;Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку внутри арифметического выражения, связанную с неявным приведением к типу memsize. Ошибка переполнения может быть связана с изменением допустимого интервала значений переменных, входящих в выражение. Данное предупреждение практически эквивалентно предупреждению V104, за тем исключением, что неявное приведение типа возникает за счет использования операции '?:'.
Приведем пример неявного приведения типов при использовании операции:
int i32;
float f = b != 1 ? sizeof(int) : i32;В арифметическом выражении используется тернарная операция '?:', имеющая три операнда:
Результатом выражения "b != 1 ? sizeof(int) : i32" является значение типа 'size_t', которое затем преобразуется в значение типа 'float'. Таким образом, неявное приведение типа осуществляется для 3-его операнда операции '?:'.
Рассмотрим пример некорректного кода:
bool useDefaultVolume;
size_t defaultVolume;
unsigned width, height, depth;
...
size_t volume = useDefaultVolume ?
defaultVolume :
width * height * depth;Предположим, мы разрабатываем приложение численного моделирования, для которого требуется трехмерная счетная область. Количество используемых счетных элементов определяется в зависимости от значения переменной 'useDefaultSize' и задается по умолчанию или произведением длинны, высоты и глубины счетной области. На 32-битной платформе объем уже выделенной памяти не может превышать 2-3 Гб (в зависимости от версии ОС Windows) и, соответственно, результат выражения "width * height * depth" всегда будет корректен. На 64-битной платформе, пользуясь возможностью работать с большим объемом памяти, количество счетных элементов может превысить значение 'UINT_MAX' (4 Гб). В этом случае произойдет переполнение при вычислении выражения "width * height * depth", так как результат этого выражения имеет тип 'unsigned'.
Исправление кода может заключаться в изменении типа переменных 'width', 'height' и 'depth' на memsize тип, как показано ниже:
...
size_t width, height, depth;
...
size_t volume = useDefaultVolume ?
defaultVolume :
width * height * depth;Или использовании явного приведения типов:
unsigned width, height, depth;
...
size_t volume = useDefaultVolume ?
defaultVolume :
size_t(width) * size_t(height) * size_t(depth);Дополнительно мы рекомендуем изучить описание аналогичного предупреждения V104, где можно ознакомиться с другими эффектами неявного приведения к типу memsize.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением фактического аргумента функции к memsize типу.
Первый пример.
Программа работает с большими массивами, используя контейнер 'CArray' из библиотеки MFC. На 64-битной платформе количество элементов массиве может превысить значение 'INT_MAX' (2Гб), что приведет к неработоспособности следующего кода:
CArray<int, int> myArray;
...
int invalidIndex = 0;
INT_PTR validIndex = 0;
while (validIndex != myArray.GetSize()) {
myArray.SetAt(invalidIndex, 123);
++invalidIndex;
++validIndex;
}Данный код заполняет все элементы массива 'myArray' значением 123. Он выглядит совершенно корректно, и вы не получите от компилятора никаких предупреждений, несмотря на его неработоспособность на 64-битной архитектуре. Ошибка заключается в использовании в качестве индекса переменной 'invalidIndex' типа 'int'. Когда значение переменной 'invalidIndex' превысит 'INT_MAX', произойдет ее переполнение, и оно получит значение равное "-1". Анализатор диагностирует данную ошибку, предупреждая, что первый аргумент функции 'SetAt' неявно приводится к memsize типу (которым в данном случае является тип 'INT_PTR'). Получив такое предупреждение, вы можете исправить ошибку, изменив тип 'int' на более подходящий.
Данный пример показателен тем, что обвинять программиста в некачественном коде не очень честно. Дело в том, что в старой версии библиотеки MFC функция 'SetAt' в классе 'CArray' была объявлена следующим образом:
void SetAt(int nIndex, ARG_TYPE newElement);А в новой:
void SetAt(INT_PTR nIndex, ARG_TYPE newElement);Даже разработчики Microsoft, создавая MFC, не смогли учесть все возможные последствия использования типа 'int' для индексации в массиве, и можно простить простого разработчика, написавшего такой код.
Приведем исправленный пример:
...
INT_PTR invalidIndex = 0;
INT_PTR validIndex = 0;
while (validIndex != myArray.GetSize()) {
myArray.SetAt(invalidIndex, 123);
++invalidIndex;
++validIndex;
}Второй пример.
Программа вычисляет необходимый ей размер массива данных, а затем выделяет его с использованием функции 'malloc', как показано ниже:
unsigned GetArraySize();
...
unsigned size = GetArraySize();
void *p = malloc(size);Анализатор выдаст предупреждение на строку "void *p = malloc(size);". Посмотрев определение функции 'malloc', мы увидим, что ее формальный аргумент, задающий размер выделяемой памяти, представлен типом 'size_t'. В программе же в качестве фактического аргумента используется переменная 'size' типа 'unsigned'. Если вашей программе на 64-битной архитектуре понадобится массив более 'UINT_MAX' байт (4Гб), то можно с уверенностью утверждать, что приведенный код неверен, так как тип 'unsigned' не может хранить значение более 'UINT_MAX'. Исправление программы заключается в изменении типов переменных и функций, участвующих в вычислении размера массива данных. В приведенном примере необходимо заменить тип 'unsigned' на один из memsize типов, а также, если это необходимо модифицировать код функции 'GetArraySize'.
...
size_t GetArraySize();
...
size_t size = GetArraySize();
void *p = malloc(size);Анализатор выдает предупреждения на неявное приведение типа только в том случае, если оно может привести к ошибке при переносе программы на 64-битную платформу. Ниже приведен код, в котором присутствует неявное приведения типов, но которое не вызывает ошибок:
void MyFoo(SSIZE_T index);
...
char c = 'z';
MyFoo(0);
MyFoo(c);Если вы точно уверены, что неявное приведение типа фактического аргумента функции совершенно корректно, то для подавления предупреждения анализатора вы можете использовать явное приведение типа, как показано ниже:
typedef size_t TYear;
void MyFoo(TYear year);
int year;
...
MyFoo(static_cast<TYear>(year));Иногда явное приведение типа может маскировать ошибку. В этом случае вы можете воспользоваться правилом V201.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением фактического аргумента функции, имеющего тип memsize к 32-битному типу.
Рассмотрим пример кода, в котором реализована функция поиска максимального элемента в массиве:
float FindMaxItem(float *array, int arraySize) {
float max = -FLT_MAX;
for (int i = 0; i != arraySize; ++i) {
float item = *array++;
if (max < item)
max = item;
}
return max;
}
...
float *beginArray;
float *endArray;
float maxValue = FindMaxItem(beginArray, endArray - beginArray);Данный код успешно может работать на 32-битной платформе, но не сможет обрабатывать массивы, состоящие более чем из 'INT_MAX' (2Гб) элементов на 64-битной архитектуре. Это ограничение вызвано использованием типа 'int' для аргумента 'arraySize'. Обратите внимание, что код функции выглядит совершенно корректно не только с точки зрения компилятора, но и анализатора. В этой функции отсутствует приведение типов, и невозможно выявить потенциальную проблему.
Анализатор предупредит о неявном приведении memsize типа к 32-битному типу при вызове функции 'FindMaxItem'. Попробуем разобраться, почему это происходит. Согласно правилам языка Си++, результат вычитания одного указателя из другого имеет тип 'ptrdiff_t'. При вызове функции 'FindMaxItem' произойдет неявное приведение типа 'ptrdiff_t' к типу 'int', в результате чего произойдет потеря старших битов. Это может стать причиной некорректного поведения программы, при обработке большого объема данных.
Правильным решением будет заменить тип 'int' на тип 'ptrdiff_t', так как он позволит хранить весь диапазон допустимых значений. Исправленный код:
float FindMaxItem(float *array, ptrdiff_t arraySize) {
float max = -FLT_MAX;
for (ptrdiff_t i = 0; i != arraySize; ++i) {
float item = *array++;
if (max < item)
max = item;
}
return max;
}Анализатор по возможности старается распознать безопасные приведения типов и не выдавать на них предупреждения. Например, анализатор не выдаст предупреждение на вызов функции FindMaxItem в следующем коде:
float Arr[1000];
float maxValue =
FindMaxItem(Arr, sizeof(Arr)/sizeof(float));В тех случаях, когда вы точно уверены в корректности кода и неявное приведение типа фактического аргумента функции не влечет ошибок, вы можете использовать явное приведение типа для того, чтобы избежать вывода диагностических сообщений. Пример:
extern int nPenStyle
extern size_t nWidth;
extern COLORREF crColor;
...
// Call constructor CPen::CPen(int, int, COLORREF)
CPen myPen(nPenStyle, static_cast<int>(nWidth), crColor);В том случае, если вы подозреваете наличие в своем коде некорректных явных приведений memsize типов к 32-битным типам, на которые анализатор не выдает предупреждения, то вы можете воспользоваться правилом V202.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку индексации больших массивов. Ошибка может заключаться в некорректном вычислении индекса.
Первый пример.
extern char *longString;
extern bool *isAlnum;
...
unsigned i = 0;
while (*longString) {
isAlnum[i] = isalnum(*longString++);
++i;
}Данный код совершенно корректен для 32-битной платформы, где принципиально невозможна обработка массивов более 'UINT_MAX' байт (4 Гб). На 64-битной платформе можно обработать массив размером более 4 Гб, что иногда очень удобно. Но корректно обработать большой массив приведенным алгоритмом невозможно. Ошибка заключается в использовании для индексации массива 'isAlnum' переменной типа 'unsigned'. Когда мы заполним первые 'UINT_MAX' элементов, произойдет переполнение переменной 'i', и она приравняется нулю. В результате мы начнем перезаписывать элементы массива 'isAlnum' расположенные в начале, а часть элементов оставим неинициализированными.
Корректным исправлением является изменения типа переменной 'i' на memsize тип:
...
size_t i = 0;
while (*longString)
isAlnum[i++] = isalnum(*longString++);Второй пример.
class Region {
float *array;
int Width, Height, Depth;
float Region::GetCell(int x, int y, int z) const;
...
};
float Region::GetCell(int x, int y, int z) const {
return array[x + y * Width + z * Width * Height];
}Для программ численного моделирования важным ресурсом является объем оперативной памяти, и возможность на 64-битной архитектуре использовать более 4 Гб памяти существенно увеличивает вычислительные возможности. В таких программах часто используют одномерные массивы, работая затем с ними как с трехмерными. Для этого существуют функции, аналогичные 'GetCell', обеспечивающие доступ к необходимым элементам счетной области. Но приведенный код может корректно работать с массивами, содержащими не более 'INT_MAX' (2 Гб) элементов. Причина заключается в использовании 32-битных типов 'int', участвующих в вычислении индекса элемента. Если количество элементов в массиве 'array' превысит 'INT_MAX' (2 Гб), то произойдет переполнение и значение индекса будет вычислено некорректно. Программисты часто допускают ошибку, пытаясь исправить код следующим образом:
float Region::GetCell(int x, int y, int z) const {
return array[static_cast<ptrdiff_t>(x) + y * Width +
z * Width * Height];
}Они знают, что по правилам языка Си++ выражение для вычисления индекса будет иметь тип 'ptrdiff_t' и надеются за счет этого избежать переполнения. К сожалению, переполнение может произойти внутри подвыражения "y * Width или z * Width * Height" ,так как для их вычисления по-прежнему используется тип 'int'.
Если вы хотите исправить код, не изменяя типов переменных, участвующих в выражении, то вы должны явно привести каждую переменную к memsize типу:
float Region::GetCell(int x, int y, int z) const {
return array[ptrdiff_t(x) +
ptrdiff_t(y) * ptrdiff_t(Width) +
ptrdiff_t(z) * ptrdiff_t(Width) *
ptrdiff_t(Height)];
}Другое решение - изменить типы переменных на memsize тип:
class Region {
float *array;
ptrdiff_t Width, Height, Depth;
float
Region::GetCell(ptrdiff_t x, ptrdiff_t y, ptrdiff_t z) const;
...
};
float Region::GetCell(ptrdiff_t x, ptrdiff_t y, ptrdiff_t z) const
{
return array[x + y * Width + z * Width * Height];
}Если вы используете для индексации выражения, имеющие тип отличный от memsize, но при этом точно уверены в корректности кода, то для подавления диагностирующих сообщений анализатора можно использовать явное приведение типов, как показано ниже.
bool *Seconds;
int min, sec;
...
bool flag = Seconds[static_cast<size_t>(min * 60 + sec)];Если вы подозреваете в программе наличие ошибок, связанных с некорректным явным приведением типов в выражениях, то вы можете воспользоваться предупреждением V201.
По возможности анализатор пытается понять, когда использование не memsize-типа в качестве индекса массива безопасно и не выдавать в этом месте предупреждения. В результате поведение анализатора иногда может показаться странным. В таких ситуациях мы просим не спешить и постараться разобраться, в ситуации. Рассмотрим следующий код:
char Arr[] = { '0', '1', '2', '3', '4' };
char *p = Arr + 2;
cout << p[0u + 1] << endl;
cout << p[0u - 1] << endl; //V108Данный код исправно работает в 32-битном режиме и печатает на экране числа 3 и 1. При проверке этого кода мы получим предупреждение только на одну строку с выражением "p[0u - 1]". И это совершенно верно. Если вы скомпилируете и запустите данный пример в 64-битном режиме, то увидите, как на экране будет распечатано значение 3, после чего произойдет аварийное завершений программы.
Ошибка связана с тем, что индексация "p[0u - 1]" на 64-битной системе некорректна, о чем и предупреждает анализатор. Согласно правилам языка Си++ выражение "0u - 1" будет иметь тип unsigned и равняться 0xFFFFFFFFu. На 32-битной архитектуре сложение указателя с этим числом будет эквивалентно вычитанию единицы. А на 64-битной системе к указателю будет честно прибавлено 0xFFFFFFFFu и произойдет обращение к памяти за приделами массива.
Конечно, часто индексация к массивам с использованием таких типов как int и unsigned безопасна. В этом случае предупреждения анализатора могут казаться не уместными. Но следует учитывать, что такой код все равно может оказаться ненадежным в случае его модернизации для обработки другого набора данных. Код с использованием типов int и unsigned может оказаться менее производительным, чем это возможно на 64-битной архитектуре.
Если вы уверены в корректности индексации, то вы можете воспользоваться функцией "Suppression of false alarms" или использовать фильтры. Можно использовать явное приведение типов в коде:
for (int i = 0; i != n; ++i)
Array[static_cast<ptrdiff_t>(i)] = 0;Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением типа возвращаемого значения. Ошибка может заключаться в некорректном вычислении возвращаемого значения.
Рассмотрим пример.
extern int Width, Height, Depth;
size_t GetIndex(int x, int y, int z) {
return x + y * Width + z * Width * Height;
}
...
array[GetIndex(x, y, z)] = 0.0f;В случае работы с большими массивами (более 'INT_MAX' элементов) данный код будет вести себя некорректно, и мы будет адресоваться не к тем элементам массива 'array', к которым рассчитываем. Но анализатор не выдаст предупреждение на строчку "array[GetIndex(x, y, z)] = 0.0f;",так как она совершенно корректна. Анализатор информирует о потенциальной ошибке внутри функции и совершенно прав, так как ошибка находится именно там и связана с арифметическим переполнением. Несмотря на то, что мы возвращаем значение типа 'size_t', выражение "x + y * Width + z * Width * Height" вычисляется с использованием типа 'int'.
Для исправления ошибки следует использовать явное приведение всех переменных участвующих в выражении к memsize типам.
extern int Width, Height, Depth;
size_t GetIndex(int x, int y, int z) {
return (size_t)(x) +
(size_t)(y) * (size_t)(Width) +
(size_t)(z) * (size_t)(Width) * (size_t)(Height);
}Другим вариантом исправления является использование других типов для переменных, участвующих в выражении.
extern size_t Width, Height, Depth;
size_t GetIndex(size_t x, size_t y, size_t z) {
return x + y * Width + z * Width * Height;
}В тех случаях, когда вы точно уверены в корректности кода, и неявное приведение типа не влечет ошибок при переходе на 64-битную архитектуру, вы можете использовать явное приведение типа для того, чтобы избежать вывода диагностических сообщений в этой строке. Пример:
DWORD_PTR Calc(unsigned a) {
return (DWORD_PTR)(10 * a);
}В том случае, если вы подозреваете, наличие в своем коде некорректных явных приведений к memsize типам, на которые анализатор не выдает предупреждения, то вы можете воспользоваться правилом V201.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным приведением возвращаемого значения. Ошибка заключается в отбрасывании старших бит в 64-битном типе, что влечет потерю значения.
Рассмотрим пример.
extern char *begin, *end;
unsigned GetSize() {
return end - begin;
}Результат выражения "end - begin" имеет тип 'ptrdiff_t'. Но поскольку функция возвращает тип 'unsigned', то происходит неявное приведение типа, при котором старшие биты результата теряются. Таким образом, если указатели 'begin' и 'end' ссылаются на начало и конец массива, по размеру большего 'UINT_MAX' (4 Гб), то функция вернет некорректное значение.
Исправление должно заключаться в модификации программы таким образом, чтобы размеры массивов хранились и передавались в memsize типах. Тогда правильный код функции 'GetSize' должен выглядеть следующим образом:
extern char *begin, *end;
size_t GetSize() {
return end - begin;
}В ряде случаев анализатор не выдает предупреждение на приведение типа, если оно явно корректно. Например, анализатор не выдаст предупреждение на следующий код, где результатом оператора sizeof() хотя и является тип size_t, но результат безопасно может быть помещен в тип unsigned:
unsigned GetSize() {
return sizeof(double);
}В тех случаях, когда вы точно уверены в корректности кода и неявное приведение типа не влечет ошибок при переходе на 64-битную архитектуру, вы можете использовать явное приведение типа для того, чтобы избежать вывода диагностических сообщений. Пример:
unsigned GetBitCount() {
return static_cast<unsigned>(sizeof(TypeRGBA) * 8);
}Если вы подозреваете наличие в своем коде некорректных явных приведений типов возвращаемых значений, на которые анализатор не выдает предупреждения, то вы можете воспользоваться правилом V202.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с передачей фактического аргумента типа memsize в функцию с переменным количеством аргументов. Потенциальная ошибка может заключаться в изменении требований, предъявляемых к функции на 64-битной системе.
Рассмотрим первый пример.
const char *invalidFormat = "%u";
size_t value = SIZE_MAX;
printf(invalidFormat, value);Данный код не учитывает, что тип 'size_t' не эквивалентен типу 'unsigned' на 64-битной платформе. Это приведет к выводу на печать некорректного результата, в случае если "value > UINT_MAX". Анализатор предупреждает вас, что в качестве фактического аргумента используется тип memsize. А это значит, что вам следует проверить строку 'invalidFormat', задающую формат вывода. Исправленный вариант может выглядеть, как показано ниже.
const char *validFormat = "%Iu";
size_t value = SIZE_MAX;
printf(validFormat, value);В коде реального приложения эта ошибка может встретиться, например, в следующем виде:
wsprintf(szDebugMessage,
_T("%s location %08x caused an access violation.\r\n"),
readwrite,
Exception->m_pAddr);Второй пример.
char buf[9];
sprintf(buf, "%p", pointer);Автор этого неаккуратного кода не учел, что размер указателя в будущем может стать более 32 бит. В результате данный код на 64-битной архитектуре приведет к переполнению буфера. Проанализировав код, на который выдано предупреждение V111, вы можете пойти двумя путями. Увеличить размер буфера, или переписать код с использованием безопасных конструкций.
char buf[sizeof(pointer) * 2 + 1];
sprintf(buf, "%p", pointer);
// --- or ---
std::stringstream s;
s << pointer;Третий пример.
char buf[9];
sprintf_s(buf, sizeof(buf), "%p", pointer);Рассматривая второй пример, вы могли справедливо заметить, что для предотвращения переполнения следует использовать функции with security enhancements. В этом случае переполнение буфера не произойдет, но, к сожалению, и не будет получен корректный результат.
Если типы аргументов не изменили своей разрядности, то код считается корректным и предупреждающих сообщений выдано не будет. Пример:
printf("%d", 10*5);
CString str;
size_t n = sizeof(float);
str.Format(StrFormat, static_cast<int>(n));Диагностируя описанный тип ошибок, к сожалению, часто нет возможности отличить корректный код от не корректного кода. Данное предупреждение будет выдаваться на многие вызовы функций с переменным количеством аргументов, даже когда вызов совершенно верен. Это связано с принципиальной опасностью использования таких конструкций языка С++. Чаще всего проблемы возникают с использованием разновидности следующих функций: 'printf', 'scanf', 'CString::Format'. Общепринятой практикой является отказ от них и использование безопасных методик программирования. Мы настоятельно рекомендуем модифицировать код и использовать безопасные методы. Например, можно заменить 'printf' на 'cout', а 'sprintf' на 'boost::format' или 'std::stringstream'.
Примечание. Борьба с ложными срабатываниями при работе с функциями форматированного вывода
Диагностика V111 очень проста. Когда анализатор ничего не знает об эллипсис-функции, то он предупреждает о всех случаях, когда в функцию передается тип, меняющий свой размер. Когда информация о функции доступна анализатору, начинает работать более точная диагностика V576, и диагностика V111 не выдается. Если диагностика V576 отключена, то V111 выдается на всех функциях.
Соответственно, можно сократить количество ложных срабатываний, предоставив анализатору информацию о функциях форматирования. Анализатор сам знает о типовых функциях, таких как 'printf', 'sprintf' и так далее, поэтому речь сейчас идёт о разметке функций, реализованных самостоятельно. Как аннотировать функции рассказывается в описании диагностики V576.
Рассмотрим пример. Пользователь спрашивает: "Почему в случае N1 анализатор не выдает предупреждение V111, а в случае N2 выдаёт?".
void OurLoggerFn(wchar_t const* const _Format, ...)
{
....
}
void Foo(size_t length)
{
wprintf( L"%Iu", length ); // N1
OurLoggerFn( L"%Iu", length ); // N2
}Дело в том, что анализатор знает, как работает стандартная функция 'wprintf'. А вот что такое 'OurLoggerFn' он не знает и на всякий случай предупреждает о передаче memsize-типа данных (в данном случае это тип 'size_t') в качестве фактического аргумента в эллипсис функцию.
Чтобы предупреждение V111 исчезло, следует проаннотировать функцию 'OurLoggerFn' следующим образом:
//+V576, function:OurLoggerFn, format_arg:1, ellipsis_arg:2
void OurLoggerFn(wchar_t const* const _Format, ...)
.....Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил использование опасной магической константы. Потенциальная ошибка может заключаться в использовании числовой константы в качестве специальных значений или размера memsize типа.
Примечание. Данная диагностика предназначена для решения узкоспециализированной задачи: найти магические числа на этапе портирования кода на 64-битную систему. Рационально один раз просмотреть все места, где используются потенциально опасные константы, после чего отключить диагностику. Нет смысла постоянно отвлекаться на предупреждения, сообщающие, что в коде используется, например константа 32. Регулярный просмотр таких сообщений утомляет и не приносит какой-либо пользы.
Рассмотрим первый пример.
size_t ArraySize = N * 4;
size_t *Array = (size_t *)malloc(ArraySize);Программист при написании программы полагался на то, что размер 'size_t' всегда будет равен 4 и записал вычисление размера массива как "N * 4". Данный код не учитывает, что тип 'size_t' на 64-битной системе будет занимать 8 байт и выделит меньшее количество памяти, чем необходимо. Исправление кода заключается в использовании оператора 'sizeof' вместо константы 4.
size_t ArraySize = N * sizeof(size_t);
size_t *Array = (size_t *)malloc(ArraySize);Второй пример.
size_t n = static_cast<size_t>(-1);
if (n == 0xffffffffu) { ... }Иногда в качестве кода ошибки или другого специального маркера используют значение "-1", записывая его как "0xffffffff". На 64-битной платформе записанное выражение некорректно, и следует явно использовать значение "-1".
size_t n = static_cast<size_t>(-1);
if (n == static_cast<size_t>(-1)) { ... }Перечислим магические константы, которые могут влиять на работоспособность приложения при переносе его на 64-битную систему и поэтому диагностируются анализатором.
Следует внимательно изучить код на наличия магических констант и заменить их безопасными константами и выражениями. Для этого можно использовать оператор 'sizeof()', специальные значения из <limits.h>, <inttypes.h> и так далее.
В ряде случаев использование магических констант не считается опасным. Например, на данный код предупреждение выдано не будет:
float Color[4];Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с неявным преобразованием memsize типа в тип 'double' или наоборот. Потенциальная ошибка может заключаться в невозможности хранения всего диапазона значений memsize типа в переменных типа 'double'.
Рассмотрим пример.
SIZE_T size = SIZE_MAX;
double tmp = size;
size = tmp; // x86: size == SIZE_MAX
// x64: size != SIZE_MAXТип 'double' имеет размер 64-бита, и совместим со стандартом IEEE-754 на 32-битных и 64-битных системах. Некоторые программисты используют тип 'double' для хранения и работы с целочисленными типами.
Приведенный пример еще можно пытаться оправдывать на 32-битной системе, так как тип 'double' имеет 52 значащих бит и способен без потери хранить 32-битное целое значение. Но при попытке сохранить в переменной типа 'double' 64-битное целое число точное значение может быть потеряно (см. рисунок).
Если приближенное значение применимо для алгоритма работы вашей программе, то никаких исправлений вносить не требуется. Но мы хотим предупредить вас об эффектах изменения поведения подобного кода на 64-битных системах. И в любом случае не рекомендуется смешивать целочисленную арифметику и арифметику с плавающей точкой.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с опасным явным приведением указателя одного типа к указателю другого типа. Ошибка может заключаться в некорректной работе с объектами, на которые ссылается указатель.
Рассмотрим пример. В нем присутствует явное приведение указателя на 'int' к указателю на 'size_t'.
int array[4] = { 1, 2, 3, 4 };
size_t *sizetPtr = (size_t *)(array);
cout << sizetPtr[1] << endl;Как видите, результат вывода программы отличается в 32-битном и 64-битном варианте. На 32-битной системе доступ к элементам массива осуществляется корректно, так как размеры типов 'size_t' и 'int' совпадают, и мы видим вывод "2". На 64-битной системы мы получили в выводе "17179869187", так как именно значение 17179869187 находится в 1-ом элементе массива 'sizetPtr'.
Исправление описанной ситуации заключается в отказе от опасных приведений типов путем модернизации программы. Другим вариантом является создание нового массива и копирование в него значений из исходного массива.
Естественно, не все явные приведения типов указателей являются опасными. В показанном далее примере результат работы не зависит он разрядности системы, так как типы 'enum' и 'int' имеют одинаковый размер как на 32-битной, так и на 64-битной системе. Соответственно анализатор не выдаст на данный код никаких сообщений.
int array[4] = { 1, 2, 3, 4 };
enum ENumbers { ZERO, ONE, TWO, THREE, FOUR };
ENumbers *enumPtr = (ENumbers *)(array);
cout << enumPtr[1] << endl;Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с использованием memsize типа для генерации исключения. Ошибка может заключаться в некорректном перехвате и обработке таких исключений.
Рассмотрим пример. Рассмотрим код, генерирующий и обрабатывающий исключение.
char *ptr1, *ptr2;
...
try {
throw ptr2 - ptr1;
}
catch(int) {
Foo();
}Ошибка в том, что на 64-битной системе обработчик исключения не сработает и функция 'Foo()' не будет вызвана. Это связано с тем, что выражение "ptr2 - ptr1" имеет тип 'ptrdiff_t', который на 64-битной системе не совпадает с типом 'int'.
Исправление описанной ситуации заключается в использовании корректного типа для перехвата исключения. В данном случае - 'ptrdiff_t', как показано ниже.
try {
throw ptr2 - ptr1;
}
catch(ptrdiff_t) {
Foo();
}Более корректное исправление будет состоять в отказе от подобной практики программирования. Следует использовать специальные классы для передачи информации о возникшей ошибке.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с использованием memsize типа для перехвата исключения. Ошибка может заключаться в некорректном перехвате и обработке исключений.
Рассмотрим пример. Рассмотрим код, генерирующий и обрабатывающий исключение.
try {
try {
throw UINT64(-1);
}
catch(size_t) {
cout << "x64 portability issues" << endl;
}
}
catch(UINT64) {
cout << "OK" << endl;
}Результат работы на 32-битной системе: OK
Результат работы на 64-битной системе: x64 portability issues
Изменение поведения связано с тем, что на 64-битной системе тип 'size_t' начинает совпадать с 'UINT64'.
Исправление описанной ситуации заключается в изменении кода для достижения необходимой логики работы.
Более корректное исправление будет состоять в отказе от подобной практики программирования. Следует использовать специальные классы для передачи информации о возникшей ошибке.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с использованием memsize внутри объединения (union). Ошибка может возникнуть при работе с такими объединениями без учета изменения размеров memsize типов на 64-битной системе.
Следует внимательно относиться к объединениям, имеющим в своем составе указатели и другие члены типа memsize.
Первый пример.
Иногда возникает необходимость работать с указателем, как с целым числом. Приведенный в примере код удобен тем, что для работы с числовым представлением указателя не используются явные приведения типов.
union PtrNumUnion {
char *m_p;
unsigned m_n;
} u;
...
u.m_p = str;
u.m_n += delta;'m_n' на 64-битной системе, мы работаем только с частью указателя 'm_p'. Следует использовать тип, который будет соответствовать размеру указателя, как показано ниже.
union PtrNumUnion {
char *m_p;
size_t m_n; //type fixed
} u;Второй пример.
Другое частое использование объединения заключается в представлении одного члена, набором других более мелких. Например, нам может потребоваться разбить значение типа 'size_t' на байты для реализации табличного алгоритма подсчета количества нулевых битов в байте.
union SizetToBytesUnion {
size_t value;
struct {
unsigned char b0, b1, b2, b3;
} bytes;
} u;
SizetToBytesUnion u;
u.value = value;
size_t zeroBitsN = TranslateTable[u.bytes.b0] +
TranslateTable[u.bytes.b1] +
TranslateTable[u.bytes.b2] +
TranslateTable[u.bytes.b3];Здесь допущена принципиальная алгоритмическая ошибка, заключающаяся в предположении, что тип 'size_t' состоит из 4 байт. Возможность автоматического поиска алгоритмических ошибок на данном этапе развития статических анализаторов не возможна, но осуществляет поиск всех объединений, в которых присутствуют memsize типы. Просмотрев список таких потенциально опасных объединений, пользователь может обнаружить логические ошибки. Найдя приведенное в примере объединение, пользователь может обнаружить алгоритмическую ошибку и переписать код следующим образом.
union SizetToBytesUnion {
size_t value;
unsigned char bytes[sizeof(value)];
} u;
SizetToBytesUnion u;
u.value = value;
size_t zeroBitsN = 0;
for (size_t i = 0; i != sizeof(u.bytes); ++i)
zeroBitsN += TranslateTable[u.bytes[i]];Родственным диагностическим сообщением является V122.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциальную ошибку, связанную с использованием опасного выражения, являющегося фактическим аргументом для функции malloc. Ошибка может заключаться в некорректных представлениях о размерах типов, заданных в виде числовых констант.
Анализатор считает подозрительными те выражения, в которых присутствуют константные литералы кратные четырем, но отсутствует оператор sizeof().
Пример первый.
Некорректный код выделения памяти для матрицы размером 3x3 из элементов типа size_t может выглядеть следующим образом:
size_t *pMatrix = (size_t *)malloc(36); // V118Хотя такой код мог долгое время надежно работать в 32-битной системе, использование магического числа 36 некорректно. При компиляции 64-битной версии необходимо выделить уже 72 байта памяти. Исправление заключается в использовании оператора sizeof ():
size_t *pMatrix = (size_t *)malloc(9 * sizeof(size_t));Второй пример.
Некорректен для 64-битной системы и следующий код, основанный на предположении, что размер структуры Item равен 12 байт:
struct Item {
int m_a;
int m_b;
Item *m_pParent;
};
Item *items = (Item *)malloc(GetArraySize() * 12); // V118Исправление также заключается в использовании оператора sizeof() для корректного вычисления размера структуры:
Item *items = (Item *)malloc(GetArraySize() * sizeof(Item));Приведенные ошибки просты и легки в исправлении. Но от этого они не менее опасны и сложны для поиска в больших приложениях. Именно поэтому диагностика подобных ошибок реализована в виде отдельного правила.
Наличие константы в выражении, являющегося параметром для функции malloc(), вовсе не означает, что на него всегда выдается предупреждение V118. Если в выражении участвует оператор sizeof(), то такая конструкция считается безопасной. Пример кода, считающийся анализатором безопасным:
int *items = (int *)malloc(sizeof(int) * 12);Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил опасное арифметическое выражение, содержащее в себе несколько операторов sizeof(). Подобные выражения потенциально могут содержать ошибки, связанные с некорректным вычислением размеров структур без учета выравнивания полей.
Пример:
struct MyBigStruct {
unsigned m_numberOfPointers;
void *m_Pointers[1];
};
size_t n2 = 1000;
void *p;
p = malloc(sizeof(unsigned) + n2 * sizeof(void *));Для расчета размеры структуры, которая будет содержать 1000 указателей используется на первый взгляд корректное арифметическое выражение. Размеры базовых типов определяются через операторы sizeof(). Это хорошо, но недостаточно, чтобы правильно вычислить необходимый объем памяти. Дополнительно необходимо учитывать выравнивание полей.
Приведенный пример будет корректно работать в 32-битном режиме, так как размер указателей и типа unsigned совпадает. Оба типа имеют размер 4 байта. Выравниваются указатели и тип unsigned также кратно 4 байтам. И размер необходимой памяти будет вычислен корректно.
В 64-битном коде размер указателя составляет 8 байт. Также указатели выравниваются в памяти по границе 8 байт. Это приводит к тому, что после переменной m_numberOfPointers будут располагаться 4 дополнительных байта для выравнивания указателей по границе 8 байт.
Для вычисления корректного размера необходимо использовать функцию offsetof:
p = malloc(offsetof(MyBigStruct, m_Pointers) +
n * sizeof(void *));Во многих случаях использование нескольких операторов sizeof() в рамках одного выражения корректно и анализатор игнорирует подобные конструкции. Пример безопасных выражений с несколькими операторами sizeof:
int MyArray[] = { 1, 2, 3 };
size_t MyArraySize =
sizeof(MyArray) / sizeof(MyArray[0]);
assert(sizeof(unsigned) < sizeof(size_t));
size_t strLen = sizeof(String) - sizeof(TCHAR);Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку при работе с классами, в которых имеется operator[].
Классы с перегруженным operator[] обычно представляют собой разновидность массива и аргументом operator[] является индекс запрашиваемого элемента. Если operator[] имеет формальный аргумент 32-битного типа, а в качестве фактического аргумента используется memsize-тип, то это может свидетельствовать об ошибке. Рассмотрим пример, приводящий к сообщению V120:
class MyArray {
int m_arr[10];
public:
int &operator[](unsigned i) { return m_arr[i]; }
} Object;
size_t k = 1;
Object[k] = 44; //V120Данный пример не содержит ошибки, но может свидетельствовать об архитектурной недоработке. Необходимо или работать с классом MyArray используя 32-битные индексы или модифицировать operator[], чтобы он принимал аргумент типа size_t. Второй вариант предпочтительней, так как использование memsize-типов не только делает программу более надежной, но и в ряде случаев позволяет компилятору построить более эффективный код.
Родственными диагностическими сообщениями являются V108 и V302.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с вызовом оператора new. В качестве аргумента оператору new передается значение не memsize-типа. Оператор new принимает значения типа size_t и передача 32-битного фактического аргумента может свидетельствовать о наличии ошибки переполнения при вычислении объема выделяемой памяти.
Рассмотрим пример.
unsigned a = 5;
unsigned b = 1024;
unsigned c = 1024;
unsigned d = 1024;
char *ptr = new char[a*b*c*d]; //V121В данном случае происходит переполнение при вычислении выражения "a*b*c*d" и в результате программа выделит меньшее количество памяти, чем планировалось. Исправление заключается в использовании типа size_t:
size_t a = 5;
size_t b = 1024;
size_t c = 1024;
size_t d = 1024;
char *ptr = new char[a*b*c*d]; //OkОшибка не будет диагностироваться, если значение задано безопасным 32-битным константным значением. Пример безопасного кода:
char *ptr = new char[100];
const int size = 3*3;
char *p2 = new char[size];Родственным диагностическим сообщением являются V106.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
В некоторых случаях бывает необходимо найти все поля в структурах, имеющих memsize-тип. Такие поля можно обнаружить, используя диагностическое правило V122.
Необходимость просмотреть все memsize-поля может возникнуть при переносе программы, в которой присутствует сериализация структур, например в файл. Рассмотрим пример:
struct Header
{
unsigned m_version;
size_t m_bodyLen;
};
...
size_t size = fwrite(&header, 1, sizeof(header), file);
...Данный код записывает в файл различное количество байт, в зависимости от того скомпилирован он в режиме Win32 или Win64. Это может нарушить совместимость формата файлов или приводить к иным ошибкам.
Автоматизировать выявление подобных ошибок представляется практически не решаемой задачей. Однако, если имеются предпосылки считать, что код содержит подобные ошибки, то разработчики один раз могут проверить все структуры, которые участвую в сериализации. Для этого и может потребоваться проверка правила V122. По умолчанию оно отключено, так как дает ложное предупреждение в более чем 99% случаев.
В приведенном выше примере сообщение V122 будет выдано на строку "size_t m_bodyLen;". Исправление кода может заключаться в использовании типов фиксированного размера:
struct Header
{
My_UInt32 m_version;
My_UInt32 m_bodyLen;
};
...
size_t size = fwrite(&header, 1, sizeof(header), file);
...Рассмотрим другие примеры, где будет выдано сообщение V122:
class X
{
int i;
DWORD_PTR a; //V122
DWORD_PTR b[3]; //V122
float c[3][4];
float *ptr; //V122
};Родственным диагностическим сообщением является V117.
Примечание. Если есть уверенность, что структуры, содержавшие указатели, никогда не сериализуются, то можно использовать следующий комментарий:
//-V122_NOPTRОн подавит все предупреждения, которые относятся к указателям.
Этот комментарий следует вписать в заголовочный файл, который включается во все другие файлы. Например, таким файлом может быть "stdafx.h". Если вписать этот комментарий в "*.cpp" файл, то он будет действовать только для этого файла.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с операцией выделения памяти. При вычислении размера выделяемой памяти используется оператор sizeof(X). Результат, возвращаемый функцией выделения памяти, приводится не к "(X *)", а к другому типу "(Y *)". Это может свидетельствовать о выделении недостаточного или излишнего количества памяти.
Рассмотрим первый пример:
int **ArrayOfPointers = (int **)malloc(n * sizeof(int));Здесь из-за опечатки в 64-битной программе будет выделяться в два раза меньше памяти, чем это необходимо. В 32-битной программе размер типа int и указателя на тип int совпадает и программа, несмотря на опечатку, успешно работает.
Исправленный вариант кода:
int **ArrayOfPointers = (int **)malloc(n * sizeof(int *));Рассмотрим другой пример, где происходит выделение большего количества памяти, чем это необходимо:
unsigned *p = (unsigned *)malloc(len * sizeof(size_t));Программа, содержащая подобный код, скорее всего, будет корректно работать как в 32-битном, так и в 64-битном варианте. Но в 64-битном варианте программа выделяет больше памяти, чем ей необходимо. Корректный вариант:
unsigned *p = (unsigned *)malloc(len * sizeof(unsigned));В ряде случаев, анализатор не выдает предупреждение, хотя типы X и Y не совпадают. Пример подобного корректного кода:
BYTE *simpleBuf = (BYTE *)malloc(n * sizeof(float));Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что размер записываемых или читаемых данных явно задан константой.
При компиляции в 64-битном режиме изменяется размер некоторых типов, а также границы их выравнивания. Размеры основных типов и границы их выравнивания показаны на рисунке:
Анализатор обращает внимание на те места в коде, где размер записываемых/читаемых данных указан явным образом. Эти места программисту следует проверить. Пример кода:
size_t n = fread(buf, 1, 40, f_in);Константа 40 может являться некорректным значением в рамках 64-битной системы. Возможно, более правильно будет написать:
size_t n = fread(buf, 1, 10 * sizeof(size_t), f_in);Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в 64-битном коде присутствует определение зарезервированных типов. При этом они определяются как 32-битные.
Пример:
typedef unsigned size_t;
typedef __int32 INT_PTR;Подобное определение типов может привести к различным ошибкам, так как в разных частях программы и библиотеках эти типы будут иметь различный размер. Следует использовать специальные заголовочные файлы, в которых корректно определены эти типы. Например, тип size_t определен в заголовочном файле stddef.h для языка C и в файле cstddef для языка C++.
Дополнительные ресурсы:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Данное диагностическое сообщение позволяет найти все типы 'long' используемые в программе.
Конечно, наличие типа 'long' в программе не является ошибкой. Однако иногда бывает полезно просмотреть все места в тексте программы, где используется этот тип. Такое может понадобиться при создании переносимого 64-битного кода, который должен функционировать в Windows и в Linux.
Windows и Linux используют различные модели данных для 64-битной архитектуры. Модель данных это соотношения размеров базовых типов данных, таких как int, float, указатель и так далее. Windows использует модель данных LLP64. В Linux используется модель данных LP64. В этих моделях различается размер типа 'long'.
В Windows (LLP64) размер типа 'long' равен 4 байта.
В Linux (LP64) размер типа 'long' равен 8 байт.
Различие размера типа 'long' может привести к несовместимости форматов файлов или ошибкам при разработке кода, выполняемого в Linux и Windows. При желании, используя PVS-Studio мы сможете просмотреть все участки кода, где используется тип 'long'.
Дополнительные ресурсы:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в длинном цикле может переполниться 32-битная переменная.
Анализатор, конечно, не может определить все возможные ситуации, когда происходит переполнение переменных в циклах. Но он поможет найти ряд типовых ошибочных конструкций.
Рассмотрим пример:
int count = 0;
for (size_t i = 0; i != N; i++)
{
if ((A[i] & MASK) != 0)
count++;
}Приведенный код корректно работает в 32-битной программе. Переменной типа 'int' достаточно, чтобы посчитать количество каких-то элементов в массиве. Однако в 64-битной программе количество таких элементов может превысить INT_MAX и произойдет переполнение переменной 'count'. Об этом и предупреждает анализатор, выдавая сообщение V127. Корректный вариант:
size_t count = 0;
for (size_t i = 0; i != N; i++)
{
if ((A[i] & MASK) != 0)
count++;
}Также анализатор содержит ряд дополнительных проверок, чтобы сократить количество ложных срабатываний. Например, сообщение V127 не будет выдано, если мы имеем дело с коротким циклом. Пример кода, который анализатор считает безопасным:
int count = 0;
for (size_t i = 0; i < 100; i++)
{
if ((A[i] & MASK) != 0)
count++;
}Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциальную ошибку, связанную с несовместимостью данных, которыми обменивается 32-битная и 64-битная версия программы. В поток записываются или из потока читаются переменные memsize-типа. Ошибка может заключаться в том, что данные записанные в бинарный файл в 32-х битном приложении будут некорректно прочитаны 64-х битном приложением.
Рассмотрим пример такого кода:
std::vector<int> v;
....
ofstream os("myproject.dat", ios::binary);
....
os << v.size();Функция 'size()' возвращает значение с типом size_t. Его размер различен в 32-х и 64-х битных приложениях. Соответственно, в файл будет записано различное количество байт.
Способов избежать несовместимости данных достаточно много. Самый простой и грубый способ, это жестко задать размер читаемых и записываемых типов. Пример такого кода:
std::vector<int> v;
....
ofstream os("myproject.dat", ios::binary);
....
os << static_cast<__int64>(v.size());Естественно, жёсткий переход на 64-битные типы данных нельзя назвать хорошим решением. Например, этот способ не позволит читать данные, записанные старой 32-битной программой. Если читать и записывать данные как 32-битные значения, возникнет другая проблема. В этом случае, 64-битная программа не сможет записать информацию о массивах, состоящих более чем из 2^32 элементов. Это может быть неприятным ограничением. Ведь часто 64-битные программы создаются именно для того, чтобы работать с огромными массивами данных.
Выходом из этой ситуации может стать внесения понятия версии сохраненных данных. Например, 32-битная программа сможет открывать файлы, созданные только 32-битной версией. А 64-битная программа будет работать с данными, сгенерированными как 32-битной, так и 64-битной версией программы.
Ещё один вариант решения проблемы совместимости данных это хранение их в текстовом виде, или использовании XML формата данных.
Следует отметить, что далеко не во всех программах имеет место проблема совместимости данных. Если программа не создает проекты и иные файлы, которые нужно открывать на других компьютерах, то диагностику V128 можно просто отключить.
Также, нет смысла беспокоиться, если поток используется для распечатки значений на экране. PVS-Studio, по возможности, пытается определить такие ситуации и не выдавать сообщения. Однако, появление ложных сообщений весьма вероятно. В этом случае, вы можете воспользоваться одним из механизмов подавления ложных предупреждений, описанных в документации.
Дополнительные возможности
По просьбе пользователей реализована возможность самостоятельно указать, какие из функций используются для сохранения/чтения данных. Если в эти функции передаются memsize-типы, то это считается опасным кодом.
Формат расширения следующий: возле прототипа функции (или возле её реализации, или в общем заголовочном файле) пишется комментарий специального вида. Начнём с примера использования:
//+V128, function:write, non_memsize:2
void write(string name, char);
void write(string name, int32);
void write(string name, int64);
foo()
{
write("zz", array.size()); // warning V128
}Формат:
Уровень диагностики в случае срабатывания на пользовательской функции – всегда первый.
Напоследок дадим наиболее полный пример использования:
// Предупреждать, когда в метод C класса B
// из пространства имён A во второй или третий
// аргумент была помещена переменная типа memsize:
//+V128,namespace:A,class:B,function:C,non_memsize:3,non_memsize:2Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Предупреждение информирует о наличии явного приведения 32-битного целочисленного типа к memsize типу, что может маскировать одну из следующих ошибок: V101, V102, V104, V105, V106, V108, V109. Вы можете обратиться к приведенному списку предупреждений, чтобы выявить причину появления диагностирующего сообщения V204.
Ранее предупреждение V201 распространялось и на приведение 32-битных целочисленных типов к указателю. Такие приведения весьма опасны. Поэтому они были выделены в отдельное диагностическое правило V204.
Учтите, что, скорее всего, большинство предупреждений этого типа будет выдано на корректный код. Приведем несколько примеров корректного и некорректного кода, на который будет выдано данное предупреждение.
Примеры некорректного кода.
int i;
ptrdiff_t n;
...
for (i = 0; (ptrdiff_t)(i) != n; ++i) { //V201
...
}
unsigned width, height, depth;
...
size_t arraySize = size_t(width * height * depth); //V201Примеры корректного кода.
const size_t seconds = static_cast<size_t>(60 * 60); //V201
unsigned *array;
...
size_t sum = 0;
for (size_t i = 0; i != n; i++) {
sum += static_cast<size_t>(array[i] / 4); //V201
}
unsigned width, height, depth;
...
size_t arraySize =
size_t(width) * size_t(height) * size_t(depth); //V201Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Оно информирует о наличии явного приведения целочисленного memsize типа к 32-битному типу, что может маскировать одну из следующих ошибок: V103, V107, V110. Вы можете обратиться к приведенному списку предупреждений, чтобы выявить причину появления диагностирующего сообщения V202.
Ранее предупреждение V202 распространялось и на приведение указателя к 32-битному целочисленному типу. Такие приведения весьма опасны. Поэтому они были выделены в отдельное диагностическое правило V205.
Учтите, что, скорее всего, большинство предупреждений этого типа будет выдано на корректный код. Приведем несколько примеров корректного и некорректного кода, на который будет выдано данное предупреждение.
Примеры некорректного кода.
size_t n;
...
for (unsigned i = 0; i != (unsigned)n; ++i) { //V202
...
}
UINT_PTR width, height, depth;
...
UINT arraySize = UINT(width * height * depth); //V202Примеры корректного кода.
const unsigned bits =
unsigned(sizeof(object) * 8); //V202
extern size_t nPane;
extern HICON hIcon;
BOOL result =
SetIcon(static_cast<int>(nPane), hIcon); //V202Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с явным преобразованием memsize типа в 'double' тип или наоборот. Потенциальная ошибка может заключаться в невозможности хранения всего диапазона значений memsize типа в переменных типа 'double'.
Эта ошибка полностью аналогична ошибке V113. Отличие заключается только в том, что используется явное приведение типов, как например, показано ниже:
SIZE_T size = SIZE_MAX;
double tmp = static_cast<double>(size);
size = static_cast<SIZE_T>(tmp); // x86: size == SIZE_T
// x64: size != SIZE_TДля ознакомления с данным видом ошибок смотри описание ошибки V113.
Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил явное приведение 32-битного целочисленного типа к указателю. Ранее подобную ситуацию можно было выявить с помощью диагностического правила V201. Однако явное приведение типа int к указателю гораздо опаснее, чем приведение int к типу intptr_t. Поэтому было создано отдельное правило для поиска явного приведения типов при работе с указателями.
Пример некорректного кода.
int n;
float *ptr;
...
ptr = (float *)(n);В 64-битной программе тип int имеет размер 4 байта и не может вместить в себя указатель размером 8 байт. Приведение типа, как показано в примере, практически всегда свидетельствует о наличии ошибки.
Отметим, что такие ошибки очень неприятны тем, что могут не сразу проявить себя. Программа может хранить указатели в 32-битных переменных и некоторое время корректно работать, пока все создаваемые в программе объекты располагаются в младших адресах оперативной памяти.
Если по каким-то причинам необходимо хранить указатель в переменной целочисленного типа, то для этого следует использовать memsize-типы данных. Например: size_t, ptrdiff_t, intptr_t, uintptr_t.
Пример корректного кода:
intptr_t n;
float *ptr;
...
ptr = (float *)(n);Возможна специфическая ситуация, когда указатель допустимо хранить в 32-битных типах. Речь идет о дескрипторах (handles), которые используются в Windows для работы с различными системными объектами. Примеры таких типов: HANDLE, HWND, HMENU, HPALETTE, HBITMAP и так далее. По сути, эти типы являются указателями. Например, HANDLE объявляется в заголовочных файлах как typedef void *HANDLE;.
Хотя дескрипторы являются 64-битными указателями, для большей совместимости (например, для возможности взаимодействия между 32-битынми и 64-битными процессами) в них используются только младшие 32-бита. Подробнее об этом можно прочитать здесь: "Microsoft Interface Definition Language (MIDL): 64-Bit Porting Guide" (USER and GDI handles are sign extended 32b values).
Такие указатели можно хранить в 32-битных типах данных (например, int, DWORD). Для преобразования таких указателей к 32-битным типам и обратно используются специальные функции:
void * Handle64ToHandle( const void * POINTER_64 h )
void * POINTER_64 HandleToHandle64( const void *h )
long HandleToLong ( const void *h )
unsigned long HandleToUlong ( const void *h )
void * IntToPtr ( const int i )
void * LongToHandle ( const long h )
void * LongToPtr ( const long l )
void * Ptr64ToPtr ( const void * POINTER_64 p )
int PtrToInt ( const void *p )
long PtrToLong ( const void *p )
void * POINTER_64 PtrToPtr64 ( const void *p )
short PtrToShort ( const void *p )
unsigned int PtrToUint ( const void *p )
unsigned long PtrToUlong ( const void *p )
unsigned short PtrToUshort ( const void *p )
void * UIntToPtr ( const unsigned int ui )
void * ULongToPtr ( const unsigned long ul )Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил явное приведение указателя к 32-битному целочисленному типу. Ранее подобную ситуацию можно было выявить с помощью диагностического правила V202. Однако явное приведение указателя к типу int, гораздо опаснее, чем приведение intptr_t к типу int. Поэтому было создано отдельное правило для поиска явного приведения типов при работе с указателями.
Пример некорректного кода.
int n;
float *ptr;
...
n = (int)ptr;В 64-битной программе тип int имеет размер 4 байта и не может вместить в себя указатель размером 8 байт. Приведение типа, как показано в примере, практически всегда свидетельствует о наличии ошибки.
Отметим, что такие ошибки очень неприятны тем, что могут не сразу проявить себя. Программа может хранить указатели в 32-битных переменных и некоторое время корректно работать, пока все создаваемые в программе объекты располагаются в младших адресах оперативной памяти.
Если по каким-то причинам необходимо хранить указатель в переменной целочисленного типа, то для этого следует использовать memsize-типы данных. Например: size_t, ptrdiff_t, intptr_t, uintptr_t.
Пример корректного кода:
intptr_t n;
float *ptr;
...
n = (intptr_t)ptr;Возможна специфическая ситуация, когда указатель допустимо хранить в 32-битных типах. Речь идет о дескрипторах (handles), которые используются в Windows для работы с различными системными объектами. Примеры таких типов: HANDLE, HWND, HMENU, HPALETTE, HBITMAP и так далее. По сути, эти типы являются указателями. Например, HANDLE объявляется в заголовочных файлах как typedef void *HANDLE;.
Хотя дескрипторы являются 64-битными указателями, для большей совместимости (например, для возможности взаимодействия между 32-битынми и 64-битными процессами) в них используется только младшие 32-бита. Подробнее об этом можно прочитать здесь: "Microsoft Interface Definition Language (MIDL): 64-Bit Porting Guide" (USER and GDI handles are sign extended 32b values).
Такие указатели можно хранить в 32-битных типах данных (например, int, DWORD). Для преобразования таких указателей к 32-битным типам и обратно используются специальные функции:
void * Handle64ToHandle( const void * POINTER_64 h )
void * POINTER_64 HandleToHandle64( const void *h )
long HandleToLong ( const void *h )
unsigned long HandleToUlong ( const void *h )
void * IntToPtr ( const int i )
void * LongToHandle ( const long h )
void * LongToPtr ( const long l )
void * Ptr64ToPtr ( const void * POINTER_64 p )
int PtrToInt ( const void *p )
long PtrToLong ( const void *p )
void * POINTER_64 PtrToPtr64 ( const void *p )
short PtrToShort ( const void *p )
unsigned int PtrToUint ( const void *p )
unsigned long PtrToUlong ( const void *p )
unsigned short PtrToUshort ( const void *p )
void * UIntToPtr ( const unsigned int ui )
void * ULongToPtr ( const unsigned long ul )Рассмотрим пример:
HANDLE h = Get();
UINT uId = (UINT)h;Анализатор не выдаёт здесь сообщение, хотя HANDLE — это указатель. Его значения всегда помещаются в 32-бита. Следует учитывать, что невалидные дескрипторы (handles) объявлены следующим образом:
#define INVALID_HANDLE_VALUE ((HANDLE)(LONG_PTR)-1)Поэтому некорректно ниже будет написать так:
if (HANDLE(uID) == INVALID_HANDLE_VALUE)Т.к. переменная uID беззнаковая, то значение указателя будет равно не 0xFFFFFFFFFFFFFFFF, а 0x00000000FFFFFFFF.
Для подозрительной проверки, где unsigned будет превращаться в указатель, будет выдано предупреждение V204.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Предупреждение информирует о наличии явного приведения типа void *, byte * к указателю на функцию или к указателю на 32/64-битные целочисленные типы данных, или наоборот. Cамо по себе такое приведение типа не является ошибкой.
Достаточно часто указатель на какой-то буфер памяти передаётся в другую часть программы с помощью указателя на байт или void. Причины написать такой код могут быть различны. Часто это свидетельствует о плохом дизайне. Указатели на функцию тоже часто хранятся как void *.
В каком-то фрагменте программы указатель на массив/функцию сохраняется как void *, а в другом происходит обратное приведение типа. При портировании в таком коде появляются ошибки. В одном месте тип данных может быть изменён, а в другом — нет.
Рассмотрим пример:
size_t array[20];
void *v = array;
....
unsigned* sizes = (unsigned*)(v);Этот код корректно работает в 32-битном режиме, так как размеры типов unsigned и size_t совпадают. В 64-битном режиме размер типов отличается, и поведение программы также будет отличаться от ожидаемого. См. также: паттерн 6 — изменение типа массива.
Анализатор указывает на строку с явным приведением типа, которая содержит ошибку. Исправленный вариант кода может выглядеть так:
unsigned array[20];
void *v = array;
....
unsigned* sizes = (unsigned*)(v);Или так:
size_t array[20];
void *v = array;
....
size_t* sizes = (size_t*)(v);Аналогичную ошибку можно допустить при работе с указателями на функцию.
void Do(void *ptr, unsigned a)
{
typedef void (*PtrFoo)(DWORD);
PtrFoo f = (PtrFoo)(ptr);
f(a);
}
void Foo(DWORD_PTR a) { /*... */ }
void Call()
{
Do(Foo, 1);
}Исправленный вариант кода:
typedef void (*PtrFoo)(DWORD_PTR);Примечание. Анализатор распознает множество случаев, когда явное приведение типа безопасно. Например, он не обращает внимание на явное приведение указателя типа void *, который вернула функция malloc():
int *p = (int *)malloc(sizeof(int) * N);Как было отмечено в начале, явное приведение типа само по себе не является ошибкой. Поэтому несмотря на большое количество исключений из правила, анализатор всё равно генерирует много ложных предупреждений V206. Анализатор не знает, есть ли в программе другие места, где неправильно используются эти указатели, поэтому он выдаёт предупреждения на все потенциально опасные приведения типов.
Например, выше были приведены два примера некорректного кода и способы их исправления. Анализатор будет продолжать выдавать предупреждения на уже исправленный код.
Существует следующий способ работы с предупреждением: один раз внимательно просмотреть все сообщения V206, после чего отключить эту диагностику в настройках. Если ложных срабатываний немного, то можно воспользоваться один из методов подавления ложных предупреждений.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Предупреждение информирует о наличии явного приведения 32-битной целочисленной переменной к типу ссылки на указатель.
Рассмотрим простой синтетический пример:
int A;
(int *&)A = pointer;По какой-то причине в переменную типа 'int' следует поместить указатель. Чтобы это сделать, можно привести тип переменной 'A' к типу 'int *&' (ссылка на указатель).
Этот код волне работоспособен в 32-битной системе, так как размеры переменной 'int' и указателей совпадают. В 64-битной системе произойдёт запись за границу памяти, которую занимает переменная 'A', и дальнейшее поведение программы будет неопределено.
Чтобы исправить ошибку, следует использовать один из memsize-типов данных. Например, можно использовать тип intptr_t:
intptr_t A;
(intptr_t *&)A = pointer;Рассмотрим более сложный пример. Пример, составленный на основе кода, взятого из реального приложения:
enum MyEnum { VAL1, VAL2 };
void Get(void*& data) {
static int value;
data = &value;
}
void M() {
MyEnum e;
Get((void*&)e);
....
}Есть функция, которая возвращает значения, имеющие тип указателя. В одном месте полученное значение помещается в переменную типа 'enum'. Оставим в стороне, почему так было сделано. Нам важно, что этот код корректно работал, когда был 32-битным. Однако 64-битный вариант программы ведёт себя некорректно. Функция Get() меняет не только переменную 'e', но и память по соседству.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Предупреждение информирует о наличии странной последовательности приведений типа. Memsize-тип явно приводится к 32-битному целочисленному типу. А затем тут же вновь явно или неявно приводится к memsize-типу. Такая последовательность приведений приводит к потере значений старших бит. Как правило, это свидетельствует о наличии серьезной ошибки.
Рассмотрим пример:
char *p1;
char *p2;
ptrdiff_t n;
...
n = int(p1 - p2);Здесь присутствует лишнее приведение к типу 'int'. Оно не нужно и может послужить причиной сбоя, если в 64-битной программе указатели p1 и p2 будут отстоять друг от друга больше чем на INT_MAX элементов.
Корректный вариант кода:
char *p1;
char *p2;
ptrdiff_t n;
...
n = p1 - p2;Рассмотрим другой пример:
BOOL SetItemData(int nItem, DWORD_PTR dwData);
...
CItemData *pData = new CItemData;
...
CListCtrl::SetItemData(nItem, (DWORD)pData);Этот код приведёт к ошибке, если объект типа CItemData будет создан за пределами четырех младших гигабайт памяти. Корректный вариант кода:
BOOL SetItemData(int nItem, DWORD_PTR dwData);
...
CItemData *pData = new CItemData;
...
CListCtrl::SetItemData(nItem, (DWORD_PTR)pData);Следует учитывать, что анализатор не выдаёт предупреждение, если конвертации подвергается такие типы данных, как HANDLE, HWND, HCURSOR и так далее. Хотя, по сути, это указатели (void *), их значения всегда вмещаются в младшие 32-бита. Это сделано специально, чтобы эти дескрипторы (handles) можно было передавать между 32-битными и 64-битными процессами. Подробнее: Как корректно привести указатель к int в 64-битной программе?
Рассмотрим пример:
typedef void * HANDLE;
HANDLE GetHandle(DWORD nStdHandle);
int _open_osfhandle(intptr_t _OSFileHandle, int _Flags);
....
int fh = _open_osfhandle((int)GetHandle(sh), 0);Здесь имеет место преобразование вида:
HANDLE -> int -> intptr_t
Т.е. вначале указатель превращается в 32-битный тип 'int', а замет расширяется до 'intptr_t'. Это не очень красиво. Лучше было бы написать "(intptr_t)GetHandle(STD_OUTPUT_HANDLE)". Однако, никакой ошибки здесь и нет, так как значения типа HANDLE помещаются в 'int'. Поэтому анализатор промолчит.
Если будет написано:
int fh = _open_osfhandle((unsigned)GetHandle(sh), 0);То анализатор выдаст предупреждение. Смешивание знаковых и беззнаковых типов всё портит. Представим, что GetHandle() вернёт INVALID_HANDLE_VALUE. Это значение задано в системных заголовочных файлах следующим образом.
#define INVALID_HANDLE_VALUE ((HANDLE)(LONG_PTR)-1)Посмотрим, что получитcя при преобразовании (intptr_t)(unsigned)((HANDLE)(LONG_PTR)-1):
-1 -> 0xffffffffffffffff -> HANDLE -> 0xffffffffu -> 0x00000000fffffffff
Значение -1 превратилось в 4294967295. Это может быть не учтено программистом и программа может работать некорректно, если функция GetHandle() вернёт INVALID_HANDLE_VALUE. Поэтому, для второго случая анализатор выдаст предупреждение.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Предупреждение информирует о наличии странной последовательности приведений типа. Указатель явно приводится к memsize-типу. А затем вновь явно или неявно приводится к 32-битному целочисленному типу. Такая последовательность приведений приводит к потере значений старших бит. Как правило, это свидетельствует о наличии серьезной ошибки.
Рассмотрим пример:
int *p = Foo();
unsigned a, b;
a = size_t(p);
b = unsigned(size_t(p));В обоих случаях указатель преобразовывается в тип 'unsigned'. При этом старшая часть указателя будет потеряна. Если затем переменные 'a' или 'b' вновь превратить в указатель, эти указатели могут оказаться некорректными.
Различие между переменными 'a' и 'b' только в том, что второй случай тяжелей обнаружить. В первом случае, компилятор предупредит о потери значащих бит. Во втором случае он будет молчать, так как используется явное приведение типа.
Исправление ошибки заключается в том, чтобы хранить указатели только memsize-типах, например, в переменных типа size_t:
int *p = Foo();
size_t a, b;
a = size_t(p);
b = size_t(p);Иногда некоторое недопонимание вызывает предупреждение анализатора на код следующего вида:
BOOL Foo(void *ptr)
{
return (INT_PTR)ptr;
}Тип BOOL это не что иное как 32-битный тип 'int'. Поэтому возникает цепочка преобразований вида:
pointer -> INT_PTR -> int.
Может показаться, что здесь ошибки нет. Ведь нам только важно, что указатель равен или не раен нулю. Но на самом деле ошибка есть. Не следует путать как ведёт себя тип BOOL и bool.
Пусть у нас есть 64-битная переменная, значение которой равно 0x000012300000000. Тогда при приведении к bool и BOOL мы получим разные результаты:
int64_t v = 0x000012300000000ll;
bool b = (bool)(v); // true
BOOL B = (BOOL)(v); // FALSE
В случае 'BOOL' просто будут отброшены старшие биты. И ненулевое значение превратится в 0 (FALSE).
Аналогичная ситуация с указателем. При явном приведении указателя к BOOL отпросятся старшие биты и ненулевой указатель превратится в целочисленный 0 (FALSE). Вероятность такого события мала, но есть. Поэтому такой код неверен.
Для того чтобы код стал корректным, можно поступить двумя способами. Первый вариант - использовать тип 'bool':
bool Foo(void *ptr)
{
return (INT_PTR)ptr;
}Хотя конечно лучше и проще написать так:
bool Foo(void *ptr)
{
return ptr != nullptr;
}Показанный выше вариант не всегда возможен. Например, в языке Си нет типа 'bool'. Второй вариант исправления ошибки:
BOOL Foo(void *ptr)
{
return ptr != NULL;
}Следует учитывать, что анализатор не выдаёт предупреждение, если конвертации подвергается такие типы данных, как HANDLE, HWND, HCURSOR и так далее. Хотя по сути это указатели (void *), их значения всегда вмещаются в младшие 32-бита. Это сделано специально, чтобы эти дескрипторы (handles) можно было передавать между 32-битными и 64-битными процессами. Подробнее: Как корректно привести указатель к int в 64-битной программе?
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку, связанную с изменением поведения перекрытых виртуальных функций.
Пример изменения поведения виртуальных функций.
class CWinApp {
...
virtual void WinHelp(DWORD_PTR dwData, UINT nCmd);
...
};
class CSampleApp : public CWinApp {
...
virtual void WinHelp(DWORD dwData, UINT nCmd);
...
};Перед вами классический пример, с которым может столкнуться разработчик, переносящий свое приложение на 64-битную архитектуру. Проследим жизненный цикл разработки некоторого приложения. Пусть первоначально оно разрабатывалось под Visual Studio 6.0. когда, функция 'WinHelp' в классе 'CWinApp' имела следующий прототип:
virtual void WinHelp(DWORD dwData, UINT nCmd = HELP_CONTEXT);Совершенно корректно было осуществить перекрытие виртуальной фукции в классе 'CSampleApp', как показано в примере. Затем проект был перенесен в Visual Studio 2005, где прототип функции в классе 'CWinApp' претерпел изменения, заключающиеся в смене типа 'DWORD' на тип 'DWORD_PTR'. На 32-битной платформе такая программа продолжит совершенно корректно работать, так как здесь типы 'DWORD' и 'DWORD_PTR' совпадают. Неприятности проявят себя при компиляции данного кода под 64-битную платформу. Получатся две функции с одинаковыми именами, но с различными параметрами, в результате чего перестанет вызываться пользовательский код.
Анализатор позволяет обнаруживать подобные ошибки, исправление которых не представляет сложности. Достаточно изменить прототип функции в классе наследника, как показано ниже:
class CSampleApp : public CWinApp {
...
virtual void WinHelp(DWORD_PTR dwData, UINT nCmd);
...
};Дополнительные материалы по данной теме:
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Анализатор обнаружил потенциально возможную ошибку при работе с классами, в которых имеется operator[]. Классы с перегруженным operator[] обычно представляют собой разновидность массива и аргументом operator[] является индекс запрашиваемого элемента. Если operator[] имеет аргумент 32-битного типа, то это может свидетельствовать об ошибке.
Рассмотрим пример, приводящий к сообщению V302:
class MyArray {
std::vector<float> m_arr;
...
float &operator[](int i) //V302
{
DoSomething();
return m_arr[i];
}
} A;
...
int x = 2000;
int y = 2000;
int z = 2000;
A[x * y * z] = 33;Если класс спроектирован для работы с большим количеством аргументов, то такая реализация operator[] является некорректной, так как не позволяет обращаться к элементам с порядковыми номерами более UINT_MAX. Диагностировать ошибку в приведенном примере можно только указав на потенциально опасный operator[]. Выражение "x * y * z" не выглядит подозрительным, так как отсутствует неявное приведение типа. Когда мы исправим operator[] следующим образом:
float &operator[](ptrdiff_t i);анализатор PVS-Studio предупредит о возможной ошибке в строке "A[x * y * z] = 33;" и мы сможем сделать код программы окончательно корректным. Пример исправленного кода:
class MyArray {
std::vector<float> m_arr;
...
float &operator[](ptrdiff_t i) //V302
{
DoSomething();
return m_arr[i];
}
} A;
...
ptrdiff_t x = 2000;
ptrdiff_t y = 2000;
ptrdiff_t z = 2000;
A[x * y * z] = 33;Родственными диагностическими сообщениями являются V108 и V120.
Это правило входит в группу "Диагностика 64-битных ошибок". Разработка правил этой группы больше не ведётся, и в будущем они могут быть отключены. Если вы используете эти правила, свяжитесь с нашей поддержкой — мы поможем найти замену или предложим альтернативное решение.
Ряд функций при переносе приложения на 64-битные системы лучше заменить на их новые варианты. В противном случае работа 64-битного приложения может быть некорректна. Анализатор предупреждает об использовании в коде устаревшей функции и предлагает вариант для замены.
Рассмотрим несколько примеров устаревших функций:
Цитата из MSDN: To control whether a 64-bit application enumerates 32-bit modules, 64-bit modules, or both types of modules, use the EnumProcessModulesEx function.
Цитата из MSDN: This function has been superseded by the SetWindowLongPtr function. To write code that is compatible with both 32-bit and 64-bit versions of Windows, use the SetWindowLongPtr function.
Цитата из MSDN: When lpFileSizeHigh is NULL, the results returned for large files are ambiguous, and you will not be able to determine the actual size of the file. It is recommended that you use GetFileSizeEx instead.
Будьте аккуратны, если захотите заменить функцию 'lstrlen' на 'strlen'. Функция 'lstrlen' не сможет корректно подсчитать длину строки, если эта строка состоит более чем из 'INT_MAX' символов. Однако, на практике вряд ли можно ожидать встречу со столь длинными строками. Зато функция 'lstrlen' в отличии 'strlen' корректно обрабатывает ситуацию, когда ей на вход подаётся нулевой указатель: "If lpString is NULL, the function returns 0".
Если просто заменить 'lstrlen' на 'strlen', то программа может начать работать некорректно. Поэтому обычно менять 'lstrlen' на вызов какой-то другой функции вообще не стоит.
Анализатор обнаружил фрагмент кода, который, скорее всего, содержит логическую ошибку. В тексте программы имеется оператор (<, >, <=, >=, ==, !=, &&, ||, -, /), слева и справа от которого расположены одинаковые подвыражения.
Рассмотрим пример:
if (a.x != 0 && a.x != 0)В данном случае оператор '&&' окружен одинаковыми подвыражениями "a.x != 0", что позволяет обнаружить ошибку, допущенную по невнимательности. Корректный код, который не вызовет подозрений у анализатора, будет выглядеть так:
if (a.x != 0 && a.y != 0)Рассмотрим другой пример ошибки, обнаруженный анализатором в коде реального приложения:
class Foo {
int iChilds[2];
...
bool hasChilds() const { return(iChilds > 0 || iChilds > 0); }
...
}В данном случае, хотя код успешно и без предупреждений компилируется, он не имеет смысла. Корректный код должен был выглядеть следующим образом:
bool hasChilds() const { return(iChilds[0] > 0 || iChilds[1] > 0);}Анализатор выдает предупреждение не во всех случаях, когда слева и справа от оператора находятся одинаковые подвыражения.
Первое исключение относится к конструкциям, где используются оператор инкремента ++, декремента --, а также += и -=. Пример взятый из реального приложения:
do {
} while (*++scan == *++match && *++scan == *++match &&
*++scan == *++match && *++scan == *++match &&
*++scan == *++match && *++scan == *++match &&
*++scan == *++match && *++scan == *++match &&
scan < strend);Данный код анализатор считает безопасным.
Второе исключение относится к сравнению двух одинаковых чисел. Этот прием часто используется программистами, чтобы выключить определенные ветки программы. Пример:
#if defined(_OPENMP)
#include <omp.h>
#else
#define omp_get_thread_num() 0
...
#endif
...
if (0 == omp_get_thread_num()) {Последнее исключение относится к сравнению, где используются макросы:
#define _WINVER_NT4_ 0x0004
#define _WINVER_95_ 0x0004
...
UINT winver = g_App.m_pPrefs->GetWindowsVersion();
if(winver == _WINVER_95_ || winver == _WINVER_NT4_)Следует понимать, что в ряде случаев анализатор может выдать предупреждение на корректную конструкцию. Например, анализатор не учитывает побочные эффекты (side effects) при вызове функций:
if (wr.takeChar() == '\0' && wr.takeChar() == '\0')Другой пример ложного срабатывания анализатора был замечен на юнит-тестах одного проекта, в той его части, где проверялось корректность работы перегруженного оператора '==':
CHECK(VDStringA() == VDStringA(), true);
CHECK(VDStringA("abc") == VDStringA("abc"), true);Диагностическое сообщение не выдается, если сравниваются два идентичных выражения типа float или double. Такое сравнение позволяет определить, является ли значение NaN. Пример кода, реализующего подобную проверку:
bool isnan(double X) { return X != X; }Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V501. |
Анализатор обнаружил фрагмент кода, который, скорее всего, содержит логическую ошибку. В тексте программы имеется выражение, содержащее тернарный оператор '?:' и которое может вычисляться не так, как планировал программист.
Оператор '?:' имеет более низкий приоритет по сравнению с операторами ||, &&, |, ^, &, !=, ==, >=, <=, >, <, >>, <<, -, +, %, /, *. Это можно случайно забыть и написать ошибочный код, подобный приведенному ниже:
bool bAdd = ...;
size_t rightLen = ...;
size_t newTypeLen = rightLen + bAdd ? 1 : 0;Забыв, что оператор '+' более приоритетный, чем оператор '?:' программист ожидает, что код будет эквивалентен: "rightLen + (bAdd ? 1 : 0)". Но на самом деле код эквивалентен выражению: "(rightLen + bAdd) ? 1 : 0".
Анализатор диагностирует возможность существования ошибку, выполняя следующие проверки:
1) Слева от оператора '?:' находится переменная или подвыражение имеющие тип bool.
2) Это подвыражение сравнивается/складывается/умножается/... с переменной с типом отличной от bool.
Если эти условия выполняются, то высока вероятность наличия ошибки и анализатор выдает рассматриваемое предупреждение.
Рассмотрим еще некоторые примеры некорректного кода:
bool b;
int x, y, z, h;
...
x = y < b ? z : h;
x = y + (z != h) ? 1 : 2;Очевидно, что программистом, скорее всего, задумывался следующий корректный код:
bool b;
int x, y, z, h;
...
x = y < (b ? z : h);
x = y + ((z != h) ? 1 : 2);Если слева от оператора '?:' находится тип отличный от bool, то анализатор считает, что код написан в Си стиле (где нет bool), или с использование объектов классов и не может выявить, опасен данный код или нет.
Пример корректного кода в стиле языка Си, который анализатор также считает корректным:
int conditions1;
int conditions2;
int conditions3;
...
char x = conditions1 + conditions2 + conditions3 ? 'a' : 'b';Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V502. |
Анализатор обнаружил фрагмент кода, содержащий бессмысленное сравнение. С большой вероятностью данный код содержит логическую ошибку.
Пример кода:
class MyClass {
public:
CObj *Find(const char *name);
...
} Storage;
if (Storage.Find("foo") < 0)
ObjectNotFound();Кажется практически невероятным, что подобный код может присутствовать в программе. Однако причина его появления может быть достаточно проста. Предположим, что в программе имеется следующий код:
class MyClass {
public:
// Если объект не найден, то функция
// Find возвращает значение -1.
ptrdiff_t Find(const char *name);
CObj *Get(ptrdiff_t index);
...
} Storage;
...
ptrdiff_t index = Storage.Find("ZZ");
if (index >= 0)
Foo(Storage.Get(index));
...
if (Storage.Find("foo") < 0)
ObjectNotFound();Это корректный, но не изящный код. В процессе рефакторинга класс MyClass может быть переписан следующим образом:
class MyClass {
public:
CObj *Find(const char *name);
...
} Storage;После такой модернизации класса, необходимо исправить все места в программе, использующие функцию Find(). Первый участок кода пропустить невозможно, так как он не скомпилируется и следовательно он обязательно будет исправлен:
CObj *obj = Storage.Find("ZZ");
if (obj != nullptr)
Foo(obj);Второй фрагмент кода успешно скомпилируется и его легко пропустить, тем самым создав рассматриваемую ошибку:
if (Storage.Find("foo") < 0)
ObjectNotFound();Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V503. |
Анализатор обнаружил фрагмент кода, в котором возможно пропущена точка с запятой ';'.
Пример кода, который приводит к выдаче диагностического сообщения V504:
void Foo();
void Foo2(int *ptr)
{
if (ptr == NULL)
return
Foo();
...
}В данном коде планировалось завершить работу функции, если указатель ptr == NULL. Однако, после оператора return забыта точка с запятой ';', что приводит к вызову функции Foo(). Функция Foo() и Foo2() ничего не возвращают и поэтому данный код компилируется без ошибок и предупреждений.
Скорее всего, программист планировал написать:
void Foo();
void Foo2(int *ptr)
{
if (ptr == NULL)
return;
Foo();
...
}Если изначальный код все-таки корректен, то его лучше переписать следующим образом:
void Foo2(int *ptr)
{
if (ptr == NULL)
{
Foo();
return;
}
...
}Анализатор считает код безопасным, если отсутствует оператор "if" или вызов функции находится на той же строке, что и оператор "return". Такой код достаточно часто можно встретить в программах. Примеры безопасного кода:
void CPagerCtrl::RecalcSize()
{
return
(void)::SendMessageW((m_hWnd), (0x1400 + 2), 0, 0);
}
void Trace(unsigned int n, std::string const &s)
{ if (n) return TraceImpl(n, s); Trace0(s); }Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V504. |
Анализатор обнаружил использование функции 'alloca' внутри цикла.
Функция 'alloca' выделяет память для заданного буфера внутри фрейма вызывающей функции. Эта область памяти будет очищена только вместе с уничтожением этого фрейма в момент её завершения.
Рассмотрим пример:
void foo ()
{
char *buffer = nullptr;
buffer = (char *) alloca(256); // <= (1)
// using buffer
....
} // <= (2)Пример синтетический, но на нём можно увидеть принцип работы функция 'alloca'. На строчке, помеченной как (1), происходит выделение блока памяти размеров в 256 байт на фрейме стека функции 'foo', который будет создан при её вызове. Фрейм функции будет уничтожен на строчке (2), когда она вернёт поток управления вызывающему коду. Это освободит всю выделенную под него память на стеке и позволит избежать утечек памяти.
Однако неаккуратное использование этой функции может привести к проблеме. Память стека исполняемой программы ограничена, и нужно следить за её переполнением.
Рассмотрим пример:
void bar(int n)
{
for (size_t i = 0; i < n; ++i)
{
char *buffer = nullptr;
if (buffer = (char*) alloca(256)) // <=
{
// using buffer
....
}
}
}Функция 'alloca' вызывается в цикле. Проблема заключается в том, что между его итерациями выделенная память не будет освобождена. При этом, если количество итераций 'n' будет достаточно большим, то стек программы может переполниться.
Исправить некорректный код в данном случае достаточно просто. Для этого можно перенести вызов функции 'alloca' за пределы цикла и использовать 'buffer' повторно на каждой итерации:
void bar(int n)
{
char *buffer = (char*)alloca(256);
for (size_t i = 0; i < n; ++i)
{
// using buffer
....
}
}Ещё один пример опасного кода:
// A2W defined in ATL using alloca
#define A2W(lpa) ....
void AtlExample()
{
....
size_t n = ....;
wchar_t** strings = { '\0' };
LPCSTR* pszSrc = { '\0' };
for (size_t i = 0; i < n; ++i)
{
if (wcscmp(strings[i], A2W(pszSrc[i])) == 0) // <=
{
....
}
}
}Макрос 'A2W' определён в библиотеке 'ATL' версии 3.0. Внутри него используется функция 'alloca'. Приведёт ли данный код к ошибке или нет, будет зависеть от длины обрабатываемых строк, их количества и размера доступного стека. Исправить опасный код можно использовав класс 'CA2W', определённый в библиотеке 'ATL' версии 7.0. В отличии от макроса, он выделяет память на стеке только для маленьких строк. Для длинных она выделяется через 'malloc'. Кроме того, память, выделенная на стеке, будет освобождена при выходе из области видимости объявления переменной. Следовательно, будет освобождаться после сравнения с 'strings[i]'.
Исправленный пример:
// using ATL 7.0
....
for (size_t i = 0; i < n; ++i)
{
if (wcscmp(strings[i], CA2W(pszSrc[i])) == 0) // <=
{
....
}
}Подробнее про функции библиотеки ATL можно почитать в документации.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V505. |
Анализатор обнаружил потенциально возможную ошибку, связанную с хранением указателя на локальную переменную. Предупреждение выдается в том случае, если время жизни объекта меньше, чем время жизни указателя на него.
Первый пример:
class MyClass
{
size_t *m_p;
void Foo() {
size_t localVar;
...
m_p = &localVar;
}
};В данном случае адрес локальной переменной сохраняется внутри класса в переменную m_p и может затем быть по ошибке использован в другой функции, когда переменная localVar будет уже уничтожена.
Второй пример:
void Get(float **x)
{
float f;
...
*x = &f;
}Функция Get() вернет указатель на локальную переменную, которая уже в этот момент не будет существовать.
Это сообщение подобно сообщению V507.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V506. |
Анализатор обнаружил потенциально возможную ошибку, связанную с хранением указателя на локальный массив. Предупреждение выдается в том случае, если время жизни массива меньше, чем время жизни указателя на него.
Первый пример:
class MyClass1
{
int *m_p;
void Foo()
{
int localArray[33];
...
m_p = localArray;
}
};Массив localArray создается в стеке и массив localArray перестанет существовать по завершению функции Foo(). Однако указатель на этот массив будет сохранен в переменной m_p и может по неаккуратности использоваться, что приведет к ошибке.
Второй пример:
struct CVariable {
...
char name[64];
};
void CRendererContext::RiGeometryV(int n, char *tokens[])
{
for (i=0;i<n;i++)
{
CVariable var;
if (parseVariable(&var, NULL, tokens[i])) {
tokens[i] = var.name;
}
}В этом примере указатель на массив, находящийся в переменной типа CVariable, сохраняется во внешнем массиве. В результате массив "tokens" после завершения функции RiGeometryV будет содержать указатели на уже несуществующие объекты.
Предупреждение V507 не всегда свидетельствует о наличии ошибки. Приведем сокращенный фрагмент кода, который анализатор считает опасным, но на самом деле этот код корректен:
png_infop info_ptr = png_create_info_struct(png_ptr);
...
BYTE trans[256];
info_ptr->trans = trans;
...
png_destroy_write_struct(&png_ptr, &info_ptr);В данном коде время жизни объекта info_ptr совпадает с временем жизни trans. Объект создается внутри png_create_info_struct (), а уничтожается внутри png_destroy_write_struct(). Анализатор не может разобрать данный случай и предполагает, что объект png_ptr поступает извне. Пример кода, где анализатор был бы прав:
void Foo()
{
png_infop info_ptr;
info_ptr = GetExternInfoPng();
BYTE trans[256];
info_ptr->trans = trans;
}Это сообщение подобно сообщению V506.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V507. |
Анализатор обнаружил код, который может содержать опечатку и, как следствие, ошибку. Происходит динамическое создание одного единственного объекта целочисленного типа и его инициализация. Высока вероятность, что из-за опечатки используются круглые скобки вместо квадратных.
Пример:
int n;
...
int *P1 = new int(n);Происходит выделение памяти для одного объекта типа int. Это достаточно странно. Вероятно, корректный код должен выглядеть следующим образом:
int n;
...
int *P1 = new int[n];Анализатор выдает предупреждение только в том случае, если память выделяется для простых объектов. При этом аргумент в скобках должен иметь целочисленный тип. В результате, анализатор не будут выдавать предупреждения на следующий корректный код:
float f = 1.0f;
float *f2 = new float(f);
MyClass *p = new MyClass(33);Диагностическое правило классифицируется как:
Если в программе возникает исключение, начинается свертывание стека, в ходе которого объекты разрушаются путем вызова деструкторов. Если деструктор объекта, разрушаемого при свертывании стека, бросает еще одно исключение и это исключение покидает деструктор, библиотека C++ немедленно аварийно завершает программу, вызывая функцию terminate(). Из этого следует, что деструкторы никогда не должны распространять исключения. Исключение, брошенное внутри деструктора, должно быть обработано внутри того же деструктора.
Анализатор обнаружил деструктор, содержащий оператор throw вне блока try..catch. Пример:
LocalStorage::~LocalStorage()
{
...
if (!FooFree(m_index))
throw Err("FooFree", GetLastError());
...
}Данный код следует переписать таким образом, чтобы сообщить об ошибке, возникшей в деструкторе без использования механизма исключений. Если ошибка не критична, то ее можно игнорировать:
LocalStorage::~LocalStorage()
{
try {
...
if (!FooFree(m_index))
throw Err("FooFree", GetLastError());
...
}
catch (...)
{
assert(false);
}
}Так же исключения могут возникать при вызове оператора 'new'. При невозможности выделения памяти будет сгенерировано исключение 'bad_alloc'. Пример:
A::~A()
{
...
int *localPointer = new int[MAX_SIZE];
...
}Появление исключения возможно при использовании dynamic_cast<Type> при работе с ссылками. При невозможности приведения типов будет сгенерировано исключение 'bad_cast'. Пример:
B::~B()
{
...
UserType &type = dynamic_cast<UserType&>(baseType);
...
}Для исправления данных ошибок следует переписать код таким образом, чтобы 'new' или 'dynamic_cast' были помещены в блок 'try{...}'.
Начиная с C++11 функции могут быть размечены как 'noexcept'. Если такие функции выбрасывают исключение, это приводит к аварийному завершению программы. Анализатор обнаруживает вызовы, которые потенциально могут выбросить исключение, в 'noexcept' функциях. Пример:
int noexceptWithNew() noexcept
{
return *(new int{42});
}Анализатор выдаст предупреждение, так как оператор 'new' может выбросить исключение. Вызов 'new' в этом случае нужно обернуть в блок 'try..catch'.
Анализатор также обнаруживает вызовы функций, не размеченных как 'noexcept', из деструкторов и 'noexcept' функций. Такие вызовы потенциально опасны, так как они могут приводить к исключениям. Рассмотрим пример:
int allocate_memory()
{
return *(new int{ 42 });
}
int noexceptFunc() noexcept
{
return allocate_memory();
}Анализатор выдаст предупреждение на строке с вызовом функции 'allocate_memory'.
Обратите внимание, что даже если вызываемая функция не размечена как 'noexcept', но анализатор не нашел в ее коде операций, способных выбросить исключение, предупреждение на ее вызов выдано не будет.
Дополнительные материалы по данной теме:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V509. |
Вариативная функция (функция, последним формальным параметром которой является эллипсис) принимает в качестве фактического аргумента, являющегося частью эллипсиса, объект классового типа, что может свидетельствовать о логической ошибке. В качестве фактического параметра для эллипсиса могут выступать только POD-типы.
POD – это аббревиатура от "Plain Old Data", что можно перевести как "Простые данные в стиле C". Начиная с C++11, к POD-типам относятся:
Если эллипсису функции в качестве параметра передается объект не POD-типа, это практически всегда свидетельствует о наличии ошибки в программе. Согласно стандарту C++11:
Passing a potentially-evaluated argument of class type having a non-trivial copy constructor, a non-trivial move constructor, or a non-trivial destructor, with no corresponding parameter, is conditionally-supported with implementation-defined semantics.
Пример кода с ошибкой:
void bar(size_t count, ...);
void foo()
{
std::string s1 = ....;
std::string s2 = ....;
std::string s3 = ....;
bar(3, s1, s2, s3);
}Начиная с C++11, для исправления ошибки можно воспользоваться вариативными шаблонами, благодаря которым информация о типах переданных аргументов будет сохранена:
template <typename T, typename ...Ts>
void bar(T &&arg, Ts &&...args);
void foo()
{
std::string s1 = ....;
std::string s2 = ....;
std::string s3 = ....;
bar(s1, s2, s3);
}Анализатор не будет выдавать предупреждение, если передача объекта не POD-типа происходит в невычисляемом контексте (например, внутри операторов 'sizeof' / 'alignof'):
int bar(size_t count, ...);
void foo()
{
auto res = sizeof(bar(2, std::string {}, std::string {}));
}На практике диагностическое правило V510 помогает выявлять ошибки при передаче аргументов в функции форматного ввода/вывода из C:
void foo(const std::wstring &ws)
{
wchar_t buf[100];
swprintf(buf, L"%s", ws);
}Вместо указателя на строку в стек попадает содержимое объекта. Такой код приведет к формированию в буфере "абракадабры" или к аварийному завершению программы.
Корректный вариант кода должен выглядеть так:
wchar_t buf[100];
std::wstring ws(L"12345");
swprintf(buf, L"%s", ws.c_str());Вместо printf-подобных функций в C++ рекомендуется использовать более безопасные аналоги. Например, 'boost::format', 'fmt::format', 'std::format' (C++20) и т.п.
Примечание. Диагностическое правило V510 также рассматривает объекты POD-типов при их передаче в функции форматного ввода/вывода. Несмотря на то, что такая передача безопасна, дальнейшая работа функции с такими аргументами может привести к непредвиденным результатам.
Если ложные срабатывания диагностического правила доставляют неудобства, их можно подавить на конкретной функции, вставив в код комментарий специального вида:
//-V:MyPrintf:510Ошибку, аналогичную приведенной выше, мы должны наблюдать и в следующем коде:
void foo()
{
CString s;
CString arg(L"OK");
s.Format(L"Test CString: %s\n", arg);
}Корректный вариант кода должен выглядеть так:
s.Format(L"Test CString: %s\n", arg.GetString());Или, как предлагается в MSDN, для получения указателя на строку можно использовать оператор явного приведения к 'LPCTSTR', реализованный в классе 'CString':
void foo()
{
CString kindOfFruit = "bananas";
int howmany = 25;
printf("You have %d %s\n", howmany, (LPCTSTR)kindOfFruit);
}Однако первый вариант 's.Format(L"Test CString: %s\n", arg);' также является корректным, как и остальные. Подробнее эта тема обсуждается в статье "Большой брат помогает тебе".
Разработчики MFC реализовали тип 'CString' специальным образом, чтобы его можно было передавать в функции вида 'printf' и 'Format'. Сделано это достаточно хитро, и те, кто интересуется, могут ознакомиться с реализацией класса 'CStringT'.
Таким образом, анализатор делает исключение для типа 'CString' и считает следующий код корректным:
void foo()
{
CString s;
CString arg(L"OK");
s.Format(L"Test CString: %s\n", arg);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования форматной строки. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V510. |
Оператор 'sizeof' возвращает размер указателя, а не массива, для случаев, когда массив был передан в функцию по копии.
Есть особенность языка, о которой легко забыть и допустить ошибку. Рассмотрим фрагмент кода:
char A[100];
void Foo(char B[100])
{
}В этом коде объект A является массивам и выражение sizeof(A) вернет значение 100.
Объект B является просто указателем. Значение 100 в квадратных скобках подсказывает программисту, что он работает с массивом из ста элементов. Но в функцию передается вовсе не массив из ста элементов, а только указатель. Таким образом выражение sizeof(B) будет возвращать значение 4 или 8 (размер указателя в 32-битной/64-битной системе).
Предупреждение V511 выдается в том случае, когда вычисляется размер указателя переданного в качестве аргумента в формате "имя_типа имя_массива[N]". Такой код с высокой вероятностью содержит ошибку. Рассмотрим пример:
void Foo(float array[3])
{
size_t n = sizeof(array) / sizeof(array[0]);
for (size_t i = 0; i != n; i++)
array[i] = 1.0f;
}Функция заполнит значением 1.0f не весь массив, а только 1 или 2 элемента, в зависимости от разрядности системы.
В Win32: sizeof(array) / sizeof(array[0]) = 4/4 = 1.
В Win64: sizeof(array) / sizeof(array[0]) = 8/4 = 2.
Для предотвращения подобных ошибок необходимо явно передавать размер массива. Корректный код:
void Foo(float *array, size_t arraySize)
{
for (size_t i = 0; i != arraySize; i++)
array[i] = 1.0f;
}Другой вариант, это использовать ссылку на массив:
void Foo(float (&array)[3])
{
size_t n = sizeof(array) / sizeof(array[0]);
for (size_t i = 0; i != n; i++)
array[i] = 1.0f;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V511. |
Анализатор обнаружил потенциально возможную ошибку, связанную с заполнением, копированием или сравнением буферов памяти. Ошибка может приводить к переполнению буфера (buffer overflow).
Примечание: ранее данная диагностика содержала в себе дополнительный функционал, но позже было решено вынести его в отдельную диагностику V1086. О причинах и последствиях такого решения можно прочитать в специальной заметке.
Это достаточно распространённый вид ошибки, возникающий из-за опечаток или невнимательности. В результате может произойти чтение или запись в область памяти, которая занята другими данными. Такой ошибкой могут воспользоваться злоумышленники для выполнения вредоносного программного кода, чтения чувствительной информации или вызова сбоев в работе операционной системы. Неприятность подобных ошибок заключается в том, что программа долгое время может работать стабильно.
Рассмотрим пример N1:
#define BYTES_COUNT 5
struct Example
{
unsigned char id[BYTES_COUNT];
unsigned char extended[BYTES_COUNT - 2];
unsigned char data[20];
};
void ClearID(Example *data)
{
memset(&data->id, 0, BYTES_COUNT);
memset(&data->extended, 0, BYTES_COUNT);
}В данном примере в функцию 'ClearID' передаётся указатель на объект типа 'Example'. Внутри функции происходит очистка полей 'id' и 'extended' с помощью функции 'memset'. Из-за невнимательного использования макроса 'BYTES_COUNT' при очистке поля 'extended' произойдёт переполнение буфера, которое приведёт к перезаписи соседнего поля 'data'.
Также переполнение буфера можно получить при неправильном приведении типов, как в примере N2:
struct MyTime
{
int timestamp;
....
};
MyTime s;
time((time_t*)&s.timestamp);Данный пример, на первый взгляд, не содержит в себе опасностей и даже будет корректно работать, пока совпадает размер типов 'int' и 'time_t'. Проблема проявится при использовании стандартной библиотеки, где тип 'time_t' может быть 64-битным. При этом переменная 'int' имеет размер 32 бита.
В таком случае при вызове функции 'time' произойдёт запись в переменную 'timestamp', а также в область памяти после неё. Корректный вариант:
struct MyTime
{
time_t time;
....
};
MyTime s;
time(&s.time);Ранее диагностическое правило содержало в себе дополнительный функционал, который был перенесён в диагностику V1086. Новая диагностика выявляет случаи, когда буфер обработан не полностью.
До разделения была возможность тонко настроить поведение диагностики и отключить неактуальную часть с помощью специальных комментариев. В целях обеспечения обратной совместимости, осталась возможность отключить диагностику V512 с помощью специального комментария:
//-V512_OVERFLOW_OFFЭтот комментарий можно вписать в заголовочный файл, который включается во все другие файлы. Например, это может быть "stdafx.h". Если вписать этот комментарий в "*.cpp" файл, то он будет действовать только для этого файла.
Поскольку теперь диагностика V512 ищет только переполнение буфера, то этот комментарий стал эквивалентен полному отключению диагностики (//-V::512).
Иногда анализатор при работе с форматной строкой может не знать точное значение аргумента – к примеру, когда он пришёл из параметра функции:
void foo(int someVar)
{
char buf[2];
sprintf(buf, "%d", someVar);
....
}По умолчанию здесь предупреждение выдаваться не будет. Чтобы включить его выдачу, добавьте следующий комментарий:
//V_512_WARN_ON_UNKNOWN_FORMAT_ARGSВ этом случае для работы анализатор будет использовать диапазон значений из типа аргумента.
Неоднократно к нам в поддержку обращались пользователи, считая, что анализатор выдаёт ложное предупреждение на подобный код:
char buf[5];
strncpy(buf, "X", 100);На первый взгляд может показаться, что функция должна скопировать только 2 байта (символ 'X' и терминальный ноль). Но, на самом деле, здесь действительно произойдёт выход за пределы массива. Причиной тому является важное свойство функции 'strncpy':
Если требуемое количество символов (третий аргумент функции) больше длины исходной строки, то целевая строка будет дополнена нулевыми символами до требуемого размера.
Более подробно с этим или другими свойствами функции 'strncpy' можно ознакомиться на cppreference.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V512. |
В программе обнаружено использование функции CreateThread или ExitThread. Если в параллельных потоках используются функции CRT (C run-time library), то вместо CreateThread/ ExitThread следует вызывать функции _beginthreadex/_endthreadex.
Приведем выдержки из 6-ой главы книги Джеффри Рихтера "Windows для профессионалов: создание эффективных Win32-приложений с учетом специфики 64-разрядной версии Windows" / Пер. с англ. - 4-е изд.
"CreateThread - это Windows-функция, создающая поток. Но никогда не вызывайте ее, если Вы пишете код на С/С++. Вместо нее Вы должны использовать функцию _beginthreadex из библиотеки Visual С++.
Чтобы многопоточные программы, использующие библиотеку С/С++ (CRT), работали корректно, требуется создать специальную структуру данных и связать ее с каждым потоком, из которого вызываются библиотечные функции. Более того, они должны знать, что, когда Вы к ним обращаетесь, нужно просматривать этот блок данных в вызывающем потоке чтобы не повредить данные в каком-нибудь другом потоке.
Так откуда же система знает, что при создании нового потока надо создать и этот блок данных? Ответ очень прост - не знает и знать не хочет Вся ответственность - исключительно на Вас. Если Вы пользуетесь небезопасными в многопоточной среде функциями, то должны создавать потоки библиотечной функцией _beginthreadex, а не Windows-функцией CreateThread .
Заметьте, что функция _beginthreadex существует только в многопоточных версиях библиотеки С/С++. Связав проект с однопоточной библиотекой, Вы получите от компоновщика сообщение об ошибке "unresolved external symbol". Конечно, это сделано специально, потому что однопоточная библиотека не может корректно работать в многопоточном приложении. Также обратите внимание на то, что при создании нового проекта Visual Studio по умолчанию выбирает однопоточную библиотеку. Этот вариант не самый безопасный, и для многопоточных приложений Вы должны сами выбрать одну из многопоточных версий библиотеки С/С++."
Соответственно, для уничтожения потока, созданного с помощью функции _beginthreadex, необходимо использовать функцию _endthreadex.
Дополнительные материалы по данной теме:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V513. |
Анализатор обнаружил потенциально возможную ошибку, связанную с делением размера указателя на некоторое значение. Деление размера указателя является странной операцией, так как не имеет практического смысла и, скорее всего, свидетельствует о наличии в коде ошибки или опечатки.
Рассмотрим пример:
const size_t StrLen = 16;
LPTSTR dest = new TCHAR[StrLen];
TCHAR src[StrLen] = _T("string for V514");
_tcsncpy(dest, src, sizeof(dest)/sizeof(dest[0]));В выражении "sizeof(dest)/sizeof(dest[0])" происходит деление размера указателя на размер элемента, на который ссылается указатель. В результате мы можем получить различное количество скопированных байтов в зависимости от размера указателя и типа TCHAR, но не то количество, что планировал программист.
С учетом того, что функция _tcsncpy сама по себе не является безопасный, корректный и более безопасный код может выглядеть следующим образом:
const size_t StrLen = 16;
LPTSTR dest = new TCHAR[StrLen];
TCHAR src[StrLen] = _T("string for V514");
_tcsncpy_s(dest, StrLen, src, StrLen);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V514. |
В коде оператор delete применяется не к указателю, а к объекту класса. С большой вероятностью это является ошибкой.
Рассмотрим пример кода:
CString str;
...
delete str;Оператор 'delete' можно применить к объекту типа CString,так как класс CString может быть автоматически приведен к указателю. Подобный код может привести к исключению или неопределенному поведению программы.
Корректный код, возможно должен был выглядеть так:
CString *pstr = new CString;
...
delete pstr;В некоторых случаях применение оператора 'delete' к объектам класса не является ошибкой. Подобный код, например, можно встретить при работе с классом QT::QBasicAtomicPointer. Анализатор игнорирует вызов операnора 'delete' для объектов этого типа. Если Вы знаете другие подобные классы, применение к которым оператора 'delete' является стандартной практикой, то сообщите нам о них. Мы добавим их в исключения.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
В коде имеется конструкция сравнения ненулевого указателя на функцию с нулем. Скорее всего, это означает, что в коде присутствует опечатка - забыты круглые скобки.
Рассмотрим пример:
int Foo();
void Use()
{
if (Foo == 0)
{
//...
}
}Условие "Foo == 0" не имеет смысла. Адрес функции 'Foo' всегда не равен нулю, а следовательно результатом сравнение всегда будет значение 'false'. В рассматриваемом коде случайно пропущены круглые скобки. Корректный вариант кода:
if (Foo() == 0)
{
//...
}Если в коде явно написано взятие адреса функции, то такой код считается корректным. Пример:
int Foo();
void Use()
{
if (&Foo != NULL)
//...
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V516. |
Анализатор обнаружил потенциально возможную ошибку в конструкции, состоящей из условных операторов.
Рассмотрим пример:
if (a == 1)
Foo1();
else if (a == 2)
Foo2();
else if (a == 1)
Foo3();В данном примере функции 'Foo3()' никогда не получит управления. Вероятно, мы имеем дело с логической ошибкой и корректный код должен выглядеть так:
if (a == 1)
Foo1();
else if (a == 2)
Foo2();
else if (a == 3)
Foo3()На практике подобная ошибка может выглядеть следующим образом:
if (radius < THRESH * 5)
*yOut = THRESH * 10 / radius;
else if (radius < THRESH * 5)
*yOut = -3.0f / (THRESH * 5.0f) * (radius - THRESH * 5.0f) + 3.0f;
else
*yOut = 0.0f;Трудно сказать, как должно выглядеть корректное условие сравнения, но наличие в коде ошибки очевидно.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V517. |
Анализатор обнаружил потенциально возможную ошибку, связанную с выделением недостаточного количества памяти. В коде подсчитывается длина строки и выделяется буфер памяти данного размера, но не учитывается наличие терминального '\0'.
Рассмотрим пример:
char *p = (char *)malloc(strlen(src));
strcpy(p, src);В данном случае просто забыто про +1. Правильный код:
char *p = (char *)malloc(strlen(src) + 1);
strcpy(p, src);Приведем другой пример некорректного кода, обнаруженный анализатором в одном из приложений:
if((t=(char *)realloc(next->name, strlen(name+1))))
{
next->name=t;
strcpy(next->name,name);
}Здесь по невнимательности неправильно поставлена правая скобочка ')'. В результате мы выделим на 2 байта меньше памяти, чем необходимо. Исправленный вариант:
if((t=(char *)realloc(next->name, strlen(name)+1)))Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V518. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что одной и той же переменной дважды подряд присваивается значение. Причем между этими присваиваниями сама переменная не используется.
Рассмотрим пример:
A = GetA();
A = GetB();То, что переменной 'A' два раза присваивается значение, может свидетельствовать о наличии ошибки. Высока вероятность, что код должен выглядеть следующим образом:
A = GetA();
B = GetB();Если переменная между присваиваниями используется, то этот код считается анализатором корректным:
A = 1;
A = A + 1;
A = Foo(A);Рассмотрим, как подобная ошибка может выглядеть на практике. Следующий код взят из реального приложения, где был реализован свой собственный класс CSize:
class CSize : public SIZE
{
...
CSize(POINT pt) { cx = pt.x; cx = pt.y; }Корректный вариант должен был выглядеть так:
CSize(POINT pt) { cx = pt.x; cy = pt.y; }Рассмотрим еще один пример. Вторая строка была написана для отладки или для того, чтобы посмотреть, как будет смотреться текст другого цвета. И, видимо, потом вторую строку забыли удалить:
m_clrSample = GetSysColor(COLOR_WINDOWTEXT);
m_clrSample = RGB(60,0,0);Иногда анализатор выдает ложные предупреждения, когда запись в переменные используется для отладочных целей. Пример подобного кода:
status = Foo1();
status = Foo2();В данной ситуации можно подавить ложные срабатывания, используя комментарий "//-V519". Можно убрать из кода ничего не значащие присваивания. И последнее. Возможно этот код все же некорректен, и необходимо проверять значение переменной 'status'.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V519. |
Анализатор обнаружил потенциальную ошибку, которая может являться следствием опечатки. В качестве индекса при работе с массивом используется выражение, содержащий оператор запятая ','.
Пример подозрительного кода:
float **array_2D;
array_2D[getx() , gety()] = 0;Скорее всего, здесь имелось в виду:
array_2D[ getx() ][ gety() ] = 0;Подобные ошибки могут быть допущены после работы с языком программирования, где индексы массивов разделяются запятыми.
Рассмотрим пример ошибки, найденный анализатором в одном из проектов:
float **m;
TextOutput &t = ...
...
t.printf("%10.5f, %10.5f, %10.5f,\n%10.5f, %10.5f, %10.5f,\n%10.5f,
%10.5f, %10.5f)",
m[0, 0], m[0, 1], m[0, 2],
m[1, 0], m[1, 1], m[1, 2],
m[2, 0], m[2, 1], m[2, 2]);Так как функция printf из класса TextOutput работает с переменным количеством аргументов, то она не может проверить, что место значений типа float ей будут переданы указатели. В результате мы распечатаем мусор вместо значений элементов матрицы. Корректный вариант:
t.printf("%10.5f, %10.5f, %10.5f,\n%10.5f, %10.5f, %10.5f,\n%10.5f,
%10.5f, %10.5f)",
m[0][0], m[0][1], m[0][2],
m[1][0], m[1][1], m[1][2],
m[2][0], m[2][1], m[2][2]);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V520. |
Оператор запятая ',' используется для выполнения стоящих по обе стороны от него выражений в порядке слева направо и получения значения правого выражения.
Анализатор обнаружил в коде программы выражение, в котором подозрительным образом используется оператор ','. Высока вероятность, что текст программы содержит опечатку.
Рассмотрим пример:
float Foo()
{
double A;
A = 1,23;
float f = 10.0f;
return 3,f;
}В данном коде переменной A будет присвоено значение 1, а вовсе не 1.23. Согласно правилам языка Си/Си++ выражение "A = 1,23" эквивалентно "(A = 1),23". Также функция Foo() вернет значение 10.0f, а не 3.0f. В обоих случаях ошибка связана с использованием символа запятая ',' вместо символа точки '.'.
Исправленный вариант кода:
float Foo()
{
double A;
A = 1.23;
float f = 10.0f;
return 3.f;
}Примечание. Были случаи, когда анализатор не мог разобраться в коде и выдавал предупреждения V521 на совершенно безобидные конструкции. Обычно это связано с использованием шаблонных классов или сложных макросов. Если при работе с анализатором вы заметили подобное ложное срабатывание, то просим сообщить о нем разработчикам. Для подавления ложных срабатываний можно использовать комментарий вида "//-V521".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V521. |
Анализатор обнаружил фрагмент кода, который может привести к использованию нулевого указателя.
Рассмотрим несколько примеров, для которых анализатор выдает диагностическое сообщение V522:
if (pointer != 0 || pointer->m_a) { ... }
if (pointer == 0 && pointer->x()) { ... }
if (array == 0 && array[3]) { ... }
if (!pointer && pointer->x()) { ... }Во всех условиях допущена логическая ошибка, которая приведет к разыменованию нулевого указателя. Ошибка может быть допущена при рефакторинге кода или из-за случайной опечатки.
Корректные варианты:
if (pointer == 0 || pointer->m_a) { ... }
if (pointer != 0 && pointer->x()) { ... }
if (array != 0 && array[3]) { ... }
if (pointer && pointer->x()) { ... }Конечно, это очень простые ситуации. На практике проверка указателя и его использование может находиться в разных местах. Если анализатор выдал предупреждение V522, изучите код расположенный выше и попробуйте понять, почему указатель может быть нулевым.
Пример кода, где проверка и использование указателя находятся в разных строках
if (ptag == NULL) {
SysPrintf("SPR1 Tag BUSERR\n");
psHu32(DMAC_STAT)|= 1<<15;
spr1->chcr = ( spr1->chcr & 0xFFFF ) |
( (*ptag) & 0xFFFF0000 );
return;
}Анализатор предупредит, об опасности в строке "( (*ptag) & 0xFFFF0000 )". Здесь или некорректно написано условие, или вместо 'ptag' должна использоваться другая переменная.
Иногда в тестовых целях программисты сознательно используют разыменование нулевого указателя. Например, анализатор будет генерировать предупреждение там, где используется вот такой макрос:
/// This generate a coredump when we need a
/// method to be compiled but not usabled.
#define elxFIXME { char * p=0; *p=0; }Лишние предупреждения можно отключить, используя комментарий "//-V522" в тех строках, где используется макрос 'elxFIXME'. Альтернативный вариант, это написать рядом с макросом комментарий специального вида:
//-V:elxFIXME:522Комментарий может быть написан как до, так и после макроса. Это не имеет значения. Подробнее с методами подавления ложных предупреждений можно познакомиться здесь.
Частой причиной появления предупреждения является использование указателя, возвращённого такой функцией как 'malloc' и аналогичной ей, без предварительной проверки. Некоторые программисты считают, что проверять указатель необязательно. В случае ошибки выделения памяти программа всё равно не работоспособна, и её аварийное завершение в следствии записи по нулевому указателю является приемлемым сценарием.
Однако, всё гораздо сложнее и опаснее, чем может казаться на первый взгляд. Предлагаем ознакомиться с публикацией: "Почему важно проверять, что вернула функция malloc".
Если по каким-то причинам всё равно не планируете проверять такие указатели, далее рассказано о специализированной настройке анализатора.
Данная диагностика учитывает информацию, может ли тот или иной указатель быть нулевым. В ряде случаев, эта информация берется из таблиц разметки функций, которые находятся внутри самого анализатора.
Примером может служить функция 'malloc'. Эта функция может вернуть 'NULL'. Соответственно, если использовать указатель, который вернула функция 'malloc', без предварительной проверки, это может привести к разыменованию нулевого указателя.
Иногда у наших пользователей возникает желание изменить поведение анализатора и заставить его считать, что, например, функция 'malloc' не может вернуть 'NULL'. Пользователь может использовать системные библиотеки, в которых ситуации нехватки памяти обрабатываются особым образом.
Также может возникнуть желание подсказать анализатору, что определённая функция может вернуть нулевой указатель.
В этом случае вы можете воспользоваться дополнительными настройками, которые описаны в разделе "Как указать анализатору, что функция может или не может возвращать nullptr".
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V522. |
Анализатор обнаружил, что истинная и ложная ветки инструкции if полностью совпадают. Часто это свидетельствует о наличии логической ошибки.
Пример:
if (X)
Foo_A();
else
Foo_A();Независимо от того, будет условие X ложным или истинным, вызов функции Foo_A() всё равно произойдёт.
Корректный вариант кода:
if (X)
Foo_A();
else
Foo_B();Пример подобной ошибки, взятый из реального приложения:
if (!_isVertical)
Flags |= DT_BOTTOM;
else
Flags |= DT_BOTTOM;Наличие двух пустых веток считается корректной и безопасной ситуацией. Подобные конструкции можно часто встретить при использовании макросов. Пример безопасного кода:
if (exp) {
} else {
}Также анализатор считает подозрительным, если инструкция if не содержит блок else, а следующий за ним код идентичен блоку условного оператора. При этом блок кода заканчивается оператором return, break и т.п.
Подозрительный фрагмент кода:
if (X)
{
doSomething();
Foo_A();
return;
}
doSomething();
Foo_A();
return;Возможно, программист забыл исправить скопированный фрагмент кода либо написал лишний код.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V523. |
Анализатор обнаружил две функции, реализованные идентичным образом. Наличие двух одинаковых функций само по себе не является ошибкой, но служит поводом обратить на них внимание.
Смысл данной диагностики в обнаружении следующей разновидности ошибок:
class Point
{
...
float GetX() { return m_x; }
float GetY() { return m_x; }
};Из-за допущенной опечатки две разные по смыслу функции выполняют одинаковые действия. Корректный вариант:
float GetX() { return m_x; }
float GetY() { return m_y; }В приведённом примере идентичность тел функций GetX() и GetY() явно свидетельствует о наличии ошибки. Однако если выдавать предупреждения на все одинаковые функции, то процент ложных срабатываний будет крайне большим. Поэтому анализатор руководствуется целым рядом исключений, когда не стоит предупреждать об одинаковых телах функций. Вот некоторые из них:
bool IsXYZ() { return true; }.int Get() { static int x = 1; return x++; }.Однако в ряде случаев анализатор не может понять, что одинаковые тела функций не являются подозрительной ситуацией. Вот код, который диагностируется как опасный, но таковым не является:
PolynomialMod2 Plus(const PolynomialMod2 &b) const
{return Xor(b);}
PolynomialMod2 Minus(const PolynomialMod2 &b) const
{return Xor(b);}Бороться с ложными срабатываниями можно несколькими способами. Если ложные срабатывания относятся к файлам внешних библиотек, то путь до файлов или каталога с ними можно добавить в исключения. Если предупреждения относятся к вашему коду, то вы можете использовать комментарий вида //-V524, который подавит эти предупреждения. Если ложных срабатываний много, то в настройках анализатора вы можете полностью отключить использование данной проверки. Также вы можете модифицировать код таким образом, чтобы одна функция вызывала другую с тем же самым кодом.
Последний вариант часто является наиболее оптимальным, поскольку, во-первых, сокращает объём кода, а во-вторых, упрощает его сопровождение. Правки достаточно вносить только в одну, а не в две функции.
Пример реального кода, где вызов одной функции из другой будет полезен:
static void PreSave(void) {
int x;
for(x=0;x<TotalSides;x++) {
int b;
for(b=0; b<65500; b++)
diskdata[x][b] ^= diskdatao[x][b];
}
}
static void PostSave (void) {
int x;
for(x=0;x<TotalSides;x++) {
int b;
for(b=0; b<65500; b++)
diskdata[x][b] ^= diskdatao[x][b];
}
}Можно заменить этот код на следующий вариант:
static void PreSave(void) {
int x;
for(x=0;x<TotalSides;x++) {
int b;
for(b=0; b<65500; b++)
diskdata[x][b] ^= diskdatao[x][b];
}
}
static void PostSave (void) {
PreSave();
}В этом фрагменте нет ошибки, но после рефакторинга предупреждение V524 исчезло, а код стал проще.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V524. |
Анализатор обнаружил код, который возможно содержит опечатку. Этот код можно разделить на более мелкие и похожие между собой фрагменты кода. Хотя фрагменты кода похожи, но все же различны. Высока вероятность, что подобный код был создан с использованием подхода Copy-Paste. Сообщение V525 будет выдано в том случае, если есть подозрение, что один из элементов не исправлен в скопированном тексте. Ошибка может находиться в одной из строк, номера которых содержатся в сообщении V525.
Недостатки сообщения V525:
1) Данное диагностическое правило основано на эвристических методах и нередко дает ложное срабатывание.
2) Реализация эвристического алгоритма сложна и занимает более 1000 строк кода на Си++. Поэтому его затруднительно описать в рамках документации. Как следствие пользователю может быть трудно понять, почему выдано то или иное сообщение V525.
3) Диагностическое сообщение относится к нескольким строкам, а не к одной. Указать только одну строку невозможно, так как ошибка может быть в любой из них.
Преимущества сообщения V525:
1) Можно обнаружить ошибки, которые крайне сложно заметить при обзоре кода (code review).
Рассмотрим вначале искусственный пример:
...
float rgba[4];
rgba[0] = object.GetR();
rgba[1] = object.GetG();
rgba[2] = object.GetB();
rgba[3] = object.GetR();Массив 'rgba' представляет собой цвет и прозрачность некоего объекта. При написании кода, заполняющего массив, вначале была написана строчка "rgba[0] = object.GetR();". Затем это строка была несколько раз скопирована и изменена. Однако в последней строке изменения сделаны не до конца и вместо функции 'GetA()' вызывается 'GetR()'. Анализатор выдает на данный код следующее предупреждение:
V525: The code containing the collection of similar blocks. Check items 'GetR', 'GetG', 'GetB', 'GetR' in lines 12, 13, 14, 15.
Просмотрев строки 12, 13, 14 и 15 можно обнаружить ошибку. Исправленный вариант кода:
rgba[3] = object.GetA();Теперь рассмотрим несколько примеров, взятых из кода реальных приложений. Первый пример:
tbb[0].iBitmap = 0;
tbb[0].idCommand = IDC_TB_EXIT;
tbb[0].fsState = TBSTATE_ENABLED;
tbb[0].fsStyle = BTNS_BUTTON;
tbb[0].dwData = 0;
tbb[0].iString = -1;
...
tbb[6].iBitmap = 6;
tbb[6].idCommand = IDC_TB_SETTINGS;
tbb[6].fsState = TBSTATE_ENABLED;
tbb[6].fsStyle = BTNS_BUTTON;
tbb[6].dwData = 0;
tbb[6].iString = -1;
tbb[7].iBitmap = 7;
tbb[7].idCommand = IDC_TB_CALC;
tbb[7].fsState = TBSTATE_ENABLED;
tbb[7].fsStyle = BTNS_BUTTON;
tbb[6].dwData = 0;
tbb[7].iString = -1;Фрагмент кода приведен далеко не полностью. Вырезано более чем половина. Фрагмент писался методом копирования и правки кода. Неудивительно, что в таком большом фрагменте затерялся неверный индекс. Анализатор выдает следующее диагностическое сообщение: "The code containing the collection of similar blocks. Check items '0', '1', '2', '3', '4', '5', '6', '6' in lines 589, 596, 603, 610, 617, 624, 631, 638". Просмотрев данные строки, мы можем исправить дважды повторяющийся индекс '6'. Исправленный вариант кода:
tbb[7].iBitmap = 7;
tbb[7].idCommand = IDC_TB_CALC;
tbb[7].fsState = TBSTATE_ENABLED;
tbb[7].fsStyle = BTNS_BUTTON;
tbb[7].dwData = 0;
tbb[7].iString = -1;Второй пример:
pPopup->EnableMenuItem(
ID_CONTEXT_EDITTEXT,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_CLOSEALL, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_CLOSE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_SAVELAYOUT, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_RESIZE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_REFRESH, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_EDITTEXT, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_SAVE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_EDITIMAGE,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_CLONE,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);Рассматривая данный код, очень сложно найти в нем ошибку. Однако ошибка здесь действительно присутствует. Дважды модифицируется состояние одного и того же пункта меню 'ID_CONTEXT_EDITTEXT'. Выделим две повторяющиеся строки:
------------------------------
pPopup->EnableMenuItem(
ID_CONTEXT_EDITTEXT,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
------------------------------
pPopup->EnableMenuItem(
ID_CONTEXT_CLOSEALL, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_CLOSE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_SAVELAYOUT, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_RESIZE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_REFRESH, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
------------------------------
pPopup->EnableMenuItem(
ID_CONTEXT_EDITTEXT, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
------------------------------
pPopup->EnableMenuItem(
ID_CONTEXT_SAVE, MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_EDITIMAGE,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);
pPopup->EnableMenuItem(
ID_CONTEXT_CLONE,MF_GRAYED|MF_DISABLED|MF_BYCOMMAND);Возможно это несерьезная погрешность, и одна из строк просто лишняя. А возможно, здесь забыли изменить состояние какого-то другого элемента меню.
К сожалению, анализатор, осуществляя данный вид диагностики, часто ошибается и генерирует ложные срабатывания. Пример кода, приводящий к ложному срабатыванию:
switch (i) {
case 0: f1 = 2; f2 = 3; break;
case 1: f1 = 0; f2 = 3; break;
case 2: f1 = 1; f2 = 3; break;
case 3: f1 = 1; f2 = 2; break;
case 4: f1 = 2; f2 = 0; break;
case 5: f1 = 0; f2 = 1; break;
}Здесь анализатору не нравится корректный столбец цифр: 2, 0, 1, 1, 2, 0. В подобных ситуациях можно воспользоваться подавлением предупреждений, вписав комментарий //-V525 в конце строки:
switch (i) {
case 0: f1 = 2; f2 = 3; break; //-V525
case 1: f1 = 0; f2 = 3; break;
case 2: f1 = 1; f2 = 3; break;
case 3: f1 = 1; f2 = 2; break;
case 4: f1 = 2; f2 = 0; break;
case 5: f1 = 0; f2 = 1; break;
}Если ложных предупреждений слишком много, то можно отключить данное диагностическое правило в настройках анализатора. Также мы будем благодарны, если вы напишите нам в поддержку о тех ситуациях, когда происходят ложные срабатывания, и мы постараемся улучшить алгоритм диагностики. Просьба в письме приводить соответствующие фрагменты кода.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V525. |
Данное сообщение носит рекомендательный характер. Оно редко диагностирует логическую ошибку, но помогает сделать код более читабельным для молодых специалистов.
Анализатор обнаружил конструкцию сравнения двух строк, которую рационально записать более понятным способом. Такие функции как strcmp, strncmp, wcsncmp возвращают 0, если строки совпадает. Это может приводить к ошибкам в логике программы. Рассмотрим пример кода:
if (strcmp(s1, s2))Это условие выполнится в том случае, если строки НЕ СОВПАДАЮТ. Возможно, вы хорошо помните, что возвращает strcmp(). Однако человек, редко работающий со строковыми функциями может подумать, что функция strcmp() возвращает значение типа 'bool'. Тогда он прочитает этот код так: "условие истинно, если строки совпадают".
Лучше не экономить на лишних символах в тексте программы и написать так:
if (strcmp(s1, s2) != 0)Подобная запись подсказывает человеку, что функция strcmp() возвращает не тип bool, а некое числовое значение. Так снижается вероятность, что код будет неверно понят.
Если вам не нравится получать данное диагностическое сообщение, вы можете выключить его в настройках анализатора.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V526. |
Подобная ошибка возникает в двух схожих ситуациях.
1) Анализатор обнаружил потенциально возможною ошибку, связанную с тем, что указателю на тип bool присваивается значение false. Высока вероятность, что забыта операция разыменования указателя. Пример:
float Get(bool *retStatus)
{
...
if (retStatus != nullptr)
retStatus = false;
...
}В данном коде забыт оператор '*'. Вместо возвращения статуса произойдет обнуление указателя retStatus. Корректный вариант кода:
if (retStatus != nullptr)
*retStatus = false;2) Анализатор обнаружил потенциально возможною ошибку, связанную с тем, что указателю на тип char/wchar_t присваивается значение '\0' или L'\0'. Высока вероятность, что забыта операция разыменования указателя. Пример:
char *cp;
...
cp = '\0';Корректный вариант:
char *cp;
...
*cp = '\0';Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V527. |
Подобная ошибка возникает в двух схожих ситуациях.
1) Анализатор обнаружил потенциально возможною ошибку, связанную с тем, что указатель на тип bool сравнивается со значением false. Высока вероятность, что забыта операция разыменования указателя. Пример:
bool *pState;
...
if (pState != false)
...В данном коде забыт оператор '*'. И получается, что мы сравниваем значение указателя pState с нулевым указателем nullptr. Корректный вариант кода:
bool *pState;
...
if (*pState != false)
...2) Анализатор обнаружил потенциально возможною ошибку, связанную с тем, что указатель на тип char/wchar_t сравнивается со значением '\0' или L'\0'. Высока вероятность, что забыта операция разыменования указателя. Пример:
char *cp;
...
if (cp != '\0')Корректный вариант:
char *cp;
...
if (*cp != '\0')Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V528. |
Анализатор обнаружил потенциально возможною ошибку, связанную с наличием точки с запятой ';' после оператора if, for или while.
Приведем пример:
for (i = 0; i < n; i++);
{
Foo(i);
}Корректный вариант:
for (i = 0; i < n; i++)
{
Foo(i);
}Использование точки с запятой ';' сразу после оператора for или while само по себе не является ошибкой и часто встречается в коде. Поэтому анализатор отсевает многие случаи, руководствуясь рядом дополнительных факторов. Например, следующий пример кода считается анализатором безопасным:
for (depth = 0, cur = parent; cur; depth++, cur = cur->parent)
;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V529. |
Вызов некоторых функций не имеет смысла, если результат их работы не используется.
Рассмотрим первый пример:
void VariantValue::Clear()
{
m_vtype = VT_NULL;
m_bvalue = false;
m_ivalue = 0;
m_fvalue = 0;
m_svalue.empty();
m_tvalue = 0;
}Этот код очистки значений взят из реального приложения. Ошибка заключается в том, что вместо функции 'clear' объекта 'std::string' случайно вызывается функция 'empty', и содержимое строки остается неизменным. Ошибка диагностируется на основании того, что результат работы функции 'empty' обязательно должен быть использован. Например, результат должен быть с чем-то сравнен или записан в переменную.
Исправленный вариант кода:
void VariantValue::Clear()
{
m_vtype = VT_NULL;
m_bvalue = false;
m_ivalue = 0;
m_fvalue = 0;
m_svalue.clear();
m_tvalue = 0;
}Второй пример:
void unregisterThread() {
Guard<TaskQueue> g(_taskQueue);
std::remove(_threads.begin(), _threads.end(),
ThreadImpl::current());
}Функция 'std::remove' не удаляет элементы из контейнера. Она только сдвигает элементы и возвращает итератор на начало мусора. Пусть мы имеем контейнер 'vector<int>', содержащий элементы 1,2,3,1,2,3,1,2,3. Если выполнить код "remove( v.begin(), v.end(), 2 )", то контейнер будет содержать элементы 1,3,1,3,?,?,?, где ? - некий мусор. При этом функция вернет итератор на первый мусорный элемент, и если мы хотим удалить эти мусорные элементы, то должны написать код: "v.erase(remove(v.begin(), v.end(), 2), v.end())".
Как видно из объяснения, результат 'std::remove' должен быть обязательно использован. Корректный код:
void unregisterThread() {
Guard<TaskQueue> g(_taskQueue);
auto trash = std::remove(_threads.begin(), _threads.end(),
ThreadImpl::current());
_threads.erase(trash, _threads.end());
}Функций, результат которых должен быть обязательно использован, огромное количество. К ним можно отнести: 'malloc', 'realloc', 'fopen', 'isalpha', 'atof', 'strcmp' и многие, многие другие функции. Неиспользуемый результат свидетельствует об ошибке, чаще всего связанной с допущенной опечаткой. Однако анализатор предупреждает только об ошибках, связанных с использованием стандартной библиотеки. На это имеется две причины:
1) Допустить ошибку, не используя результат такой функции, как 'fopen' намного сложней, чем спутать 'std::clear' и 'std::empty'.
2) Данная функциональность будет дублировать возможности Code Analysis for C/C++, входящий в состав некоторых редакций Visual Studio (смотри предупреждение C6031). Однако в Visual Studio эти предупреждения не реализованы для функций стандартной библиотеки.
Если вы хотите предложить расширить список функций, поддерживаемых анализатором, то обратитесь в поддержку. Мы будем благодарны за интересные примеры и советы.
Безопасность
Помимо явных ошибок и опечаток, следует рассмотреть тему безопасности. Существуют функции, связанные с разграничением доступа. В качества примера назовём только функции LogonUser и SetThreadToken, но на самом деле их много. Нужно обязательно проверять статусы, которые возвращают эти функции. Неиспользование значений, которые вернули эти функции, является грубой ошибкой и потенциальной уязвимостью. Именно поэтому для таких функций анализатор также выдает предупреждение V530.
Дополнительные возможности
Можно указать имена пользовательских функций, для которых следует выполнять проверку, используется ли возвращаемое функцией значение.
Для этого используется специальная пользовательская аннотация. Пример использования:
//+V530, function: MyNamespace::MyClass::MyFunc
namespace MyNamespace {
class MyClass {
int MyFunc();
}
....
obj.MyFunc(); // warning V530
}Формат:
В проектах с особыми требованиями качества может понадобиться найти все функции, возвращаемое значение которых не используется. Для этого можно воспользоваться пользовательской аннотацией 'RET_USE_ALL'. Подробнее об этом можно прочитать в документации по пользовательским аннотациям.
Примечание. По умолчанию пользовательские аннотации не применяются к виртуальным функциям. О том, как включить данный функционал, вы можете прочитать здесь.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V530. |
Код, в котором значение, возвращаемое оператором sizeof(), умножается на другой оператор sizeof(), практически всегда свидетельствует о наличии ошибки. Бессмысленно умножать размер одного объекта на размер другого объекта. Чаще всего подобные ошибки встречаются при работе со строками.
Рассмотрим реальный пример кода:
TCHAR szTemp[256];
DWORD dwLen =
::LoadString(hInstDll, dwID, szTemp,
sizeof(szTemp) * sizeof(TCHAR));Функция LoadString в качестве последнего аргумента принимает размер буфера в символах. В Unicode версии приложения мы сообщим функции, что размер буфера больше, чем он есть на самом деле. Это может привести к переполнению буфера. Заметим, что следующее исправление вовсе не является корректным:
TCHAR szTemp[256];
DWORD dwLen =
::LoadString(hInstDll, dwID, szTemp, sizeof(szTemp));Приведем на эту темы выдержку из MSDN:
"Using this function incorrectly can compromise the security of your application. Incorrect use includes specifying the wrong size in the nBufferMax parameter. For example, if lpBuffer points to a buffer szBuffer which is declared as TCHAR szBuffer[100], then sizeof(szBuffer) gives the size of the buffer in bytes, which could lead to a buffer overflow for the Unicode version of the function. Buffer overflow situations are the cause of many security problems in applications. In this case, using sizeof(szBuffer)/sizeof(TCHAR) or sizeof(szBuffer)/sizeof(szBuffer[0]) would give the proper size of the buffer."
Корректный вариант кода:
TCHAR szTemp[256];
DWORD dwLen =
::LoadString(hInstDll, dwID, szTemp,
sizeof(szTemp) / sizeof(TCHAR));Другой корректный вариант:
const size_t BUF_LEN = 256;
TCHAR szTemp[BUF_LEN];
DWORD dwLen =
::LoadString(hInstDll, dwID, szTemp, BUF_LEN);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V531. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в коде присутствует разыменование указателя, но значение, на которое указывает указатель, никак не используется.
Рассмотрим пример:
int *p;
...
*p++;Выражение "*p++" выполняет следующие действия. Указатель "p" будет увеличен на единицу, но прежде этого из памяти будет извлечено значение типа "int". Это значение никак не используется, что странно. Получается, что операция разыменования "*" является лишней. Возможны следующие варианты, как следует поступить с кодом:
1) Удалить лишнее разыменование. Высказывание "*p++;" эквивалентно "p++;":
int *p;
...
p++;2) На самом деле хотели увеличить не указатель, а значение. Тогда следует написать:
int *p;
...
(*p)++;Если результат выражения "*p++" используется, то анализатор считает код корректным. Пример безопасного кода:
while(*src)
*dest++ = *src++;Рассмотрим пример взятый из реального приложения:
STDMETHODIMP CCustomAutoComplete::Next(
ULONG celt, LPOLESTR *rgelt, ULONG *pceltFetched)
{
...
if (pceltFetched != NULL)
*pceltFetched++;
...В данном случае забыты круглые скобки. Корректный вариант:
if (pceltFetched != NULL)
(*pceltFetched)++;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V532. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в операторе 'for' увеличивается переменная, относящаяся к внешнему циклу.
В самом простом виде эта ошибка выглядит следующим образом:
for (size_t i = 0; i != 5; i++)
for (size_t j = 0; j != 5; i++)
A[i][j] = 0;Во внутреннем цикле происходит увеличение переменной 'i' вместо 'j'. В реальном приложении подобная ошибка может быть не так хорошо заметна. Корректный вариант кода:
for (size_t i = 0; i != 5; i++)
for (size_t j = 0; j != 5; j++)
A[i][j] = 0;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V533. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в операторе 'for' в условии используется переменная, относящаяся к внешнему циклу.
В самом простом виде эта ошибка выглядит следующим образом:
for (size_t i = 0; i != 5; i++)
for (size_t j = 0; i != 5; j++)
A[i][j] = 0;Во внутреннем цикле происходит сравнение 'i != 5' вместо 'j != 5'. В реальном приложении подобная ошибка может быть не так хорошо заметна. Корректный вариант кода:
for (size_t i = 0; i != 5; i++)
for (size_t j = 0; j != 5; j++)
A[i][j] = 0;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V534. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что вложенный цикл организован с использованием переменной, которая также используется и во внешнем цикле.
Схематически эта ошибка выглядит следующим образом:
size_t i, j;
for (i = 0; i != 5; i++)
for (i = 0; i != 5; i++)
A[i][j] = 0;Конечно, это искусственный пример и в реальном приложении ошибка может быть не так очевидна. Корректный вариант кода:
size_t i, j;
for (i = 0; i != 5; i++)
for (j = 0; j != 5; j++)
A[i][j] = 0;Использование одной переменной для внешнего и внутреннего цикла не всегда является ошибкой. Рассмотрим пример корректного кода, где анализатор не будет выдавать предупреждение:
for(c = lb; c <= ub; c++)
{
if (!(xlb <= xlat(c) && xlat(c) <= ub))
{
Range * r = new Range(xlb, xlb + 1);
for (c = lb + 1; c <= ub; c++)
r = doUnion(
r, new Range(xlat(c), xlat(c) + 1));
return r;
}
}В этом коде внутренний цикл "for (c = lb + 1; c <= ub; c++)" организован при помощи переменной "c". Внешний цикл также использует переменную "c". Но ошибки здесь нет. После того, как выполнится внутренний цикл, сразу произойдет выход из функции при помощи оператора "return r".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V535. |
Использование констант в восьмеричной системе счисления само по себе не является ошибкой. Эта система удобна при работе с битами и используется в коде, взаимодействующем с сетью или внешними устройствами. Однако средний программист редко использует эту систему счисления и поэтому может написать перед числом 0, забыв, что это превращает значение в восьмеричное.
Анализатор предупреждает о наличии восьмеричных констант, если рядом нет других восьмеричных констант. Такие "одиночные" восьмеричные константы часто являются ошибкой.
Рассмотрим пример, взятый из реального приложения. Пример достаточно большой, но хорошо демонстрирует суть проблемы.
inline
void elxLuminocity(const PixelRGBf& iPixel,
LuminanceCell< PixelRGBf >& oCell)
{
oCell._luminance = 0.2220f*iPixel._red +
0.7067f*iPixel._blue +
0.0713f*iPixel._green;
oCell._pixel = iPixel;
}
inline
void elxLuminocity(const PixelRGBi& iPixel,
LuminanceCell< PixelRGBi >& oCell)
{
oCell._luminance = 2220*iPixel._red +
7067*iPixel._blue +
0713*iPixel._green;
oCell._pixel = iPixel;
}Рассматривая подобный код непросто заметить ошибку, но она есть. Первая функция elxLuminocity корректна и работает со значения типа float. В коде имеются следующие константы: 0.2220f, 0.7067f, 0.0713f. Вторая функция аналогична первой, но работает с целыми значениями. Все целые значения умножены на 10000. Вот эти значения: 2220, 7067, 0713. Ошибка в том, что последняя константа "0713" задана в восьмеричной системе счисления и имеет значение вовсе не 713, а 459. Исправленный вариант кода:
oCell._luminance = 2220*iPixel._red +
7067*iPixel._blue +
713*iPixel._green;Как было сказано выше, предупреждение о восьмеричных константах выдается только в том случае, если вблизи от них нет других восьмеричных констант. Поэтому следующий пример кода считается анализатором безопасным и для него предупреждений выдано не будет:
static unsigned short bytebit[8] = {
01, 02, 04, 010, 020, 040, 0100, 0200 };Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V536. |
Анализатор обнаружил потенциально возможную опечатку в коде, связанную с неверным использованием схожих имен.
Данное правило пытается эвристическим методом обнаружить ошибку схожую со следующей:
int x = static_cast<int>(GetX()) * n;
int y = static_cast<int>(GetX()) * n;Во второй строке вместо функции 'GetY' используется 'GetX'. Корректный код:
int x = static_cast<int>(GetX()) * n;
int y = static_cast<int>(GetY()) * n;Для обнаружения этого подозрительного места анализатор следовал следующей логике. Мы имеем строку, где используется имя, включающее в себя фрагмент 'x'. Рядом с ней есть строка, где используется похожее имя, содержащая 'y'. Но при этом во второй строке также есть и 'X'. Так как выполнилось это и еще некоторые условия, данную конструкцию следует считать нуждающейся в проверке программистом. Если бы, например, слева не было переменных 'x' и 'y', то такой код не считался бы опасным. Пример кода, на который анализатор не обратит внимания:
array[0] = GetX() / 2;
array[1] = GetX() / 2;К сожалению, данное правило часто дает ложное срабатывание, так как анализатор не имеет представления об устройстве программы и предназначении кода. Пример ложного срабатывания:
halfWidth -= borderWidth + 2;
halfHeight -= borderWidth + 2;Анализатор предположил, что возможно второй строкой должно быть иное выражение, например: 'halfHeight -= borderHeight + 2'. На самом деле никакой ошибки нет. Размер границы ('border') одинаков по вертикали и горизонтали. Такой константы как 'borderHeight' просто не существует. Однако подобные высокоуровневые абстракции не доступны анализатору. Чтобы убрать предупреждение вы можете вписать в код комментарий '//-V537'.
Можно использовать и другой приём для предотвращения ложных срабатываний. Возьмём вот такой фрагмент кода:
bsdf->alpha_x = closure->alpha_x;
bsdf->alpha_y = bsdf->alpha_x;Этот код корректен, но выглядит подозрительно, причём не только с точки зрения анализатора. Человеку, который будет сопровождать код, будет сложно понять, ошибочен он или нет. Если переменным 'alpha_x' и 'alpha_y' хочется присвоить одно и тоже значение, то можно написать так:
bsdf->alpha_y = bsdf->alpha_x = closure->alpha_x;Этот код не вызовет вопроса у человека, а анализатор не выдаст предупреждение.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V537. |
В тексте программы встретились управляющие ASCII символы.
Таким символом может быть:
0x0B - LINE TABULATION (vertical tabulation) - Перемещает позицию печати к следующей позиции вертикальной табуляции. На терминалах этот символ обычно эквивалентен переводу строки.
Наличие подобных символов в тексте программы допустимо и такой текст успешно компилируется в Visual C++. Однако, скорее всего эти символы попали в текст программы случайно и лучше от них избавиться. Для этого есть 2 причины:
1) Если подобный управляющий символ находится в первых строках файла, то среда Visual Studio не может понять формат файла и открывает его не с помощью встроенного редактора, а в программе Notepad.
2) Некоторые внешние инструменты, работающие с текстами программ, могут некорректно обработать файлы, содержащие перечисленные управляющие символы.
Символы 0x0B не видны в редакторе Visual Studio 2010. Чтобы найти их в строке и удалить, можно открыть файл в программе Notepad или в другом редакторе, отображающим подобные управляющие символы.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V538. |
Анализатор обнаружил код, выполняющий действия над контейнерами, который с большой вероятностью содержит ошибку. Рекомендуется внимательно проверить данный фрагмент кода.
Рассмотрим несколько примеров, демонстрирующих ситуации, когда будет выдано данное предупреждение:
Пример 1.
void X(std::vector<int> &X, std::vector<int> &Y)
{
std::for_each (X.begin(), X.end(), SetValue);
std::for_each (Y.begin(), X.end(), SetValue);
}В функции происходит заполнение двух массивов некими значениями. Из-за опечатки при втором вызове функции "std::for_each" ей передаются итераторы от различных контейнеров, что приведет к ошибке на этапе исполнения программы. Корректный код:
std::for_each (X.begin(), X.end(), SetValue);
std::for_each (Y.begin(), Y.end(), SetValue);Пример 2.
std::includes(a.begin(), a.end(), a.begin(), a.end());Данный код странен, и скорее всего планировалось обрабатывать две различные последовательности, а не одну. Корректный вариант кода:
std::includes(a.begin(), a.end(), b.begin(), b.end());Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V539. |
В Windows API есть структуры, в которых указатели на строки должны заканчиваться двойным нулем.
В качестве примера можно привести член lpstrFilter в структуре OPENFILENAME.
Описание lpstrFilter в MSDN:
"LPCTSTR
A buffer containing pairs of null-terminated filter strings. The last string in the buffer must be terminated by two NULL characters."
Как следует из этого описания, в конце строки мы должны обязательно написать дополнительный ноль. Пример: lpstrFilter = "All Files\0*.*\0";
Однако многие забывают о дополнительном нуле в конце строки. Пример некорректного кода обнаруженный в одном из приложений:
lofn.lpstrFilter = L"Equalizer Preset (*.feq)\0*.feq";Подобный код приведет к тому, что в диалоге работы с файлом в поле фильтров мы можем увидеть мусор. Исправленный код:
lofn.lpstrFilter = L"Equalizer Preset (*.feq)\0*.feq\0";Мы явно в конце строки написали 0, и еще один ноль добавит компилятор. Некоторые для большей наглядности пишут так:
lofn.lpstrFilter = L"Equalizer Preset (*.feq)\0*.feq\0\0";Но здесь мы получим в конце не два, а три нуля. Это излишне, но зато хорошо заметно программисту.
Есть и другие структуры, помимо OPENFILENAME, в которых можно допустить схожие ошибки. Например, двойным нулем должны заканчиваться строки lpstrGroupNames, lpstrCardNames в структурах OPENCARD_SEARCH_CRITERIA, OPENCARDNAME.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V540. |
Анализатор обнаружил потенциально возможную ошибку, связанную с печатью строки в саму себя. Результат подобного действия может быть весьма неожиданным.
Рассмотрим пример:
char s[100] = "test";
sprintf(s, "N = %d, S = %s", 123, s);В примере буфер 's' одновременно используется как буфер под новую строку и как один из элементов, из которых формируется текст. В результате работы этого кода хочется получить строку:
N = 123, S = test
Но на практике в буфере будет сформирована строка:
N = 123, S = N = 123, S =
В других ситуациях аналогичный код может привести не только к выводу некорректного текста, но и к переполнению буфера или аварийному завершению программы. Код может быть исправлен, если использовать для сохранения результата новый буфер.
Корректный код:
char s1[100] = "test";
char s2[100];
sprintf(s2, "N = %d, S = %s", 123, s1);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования форматной строки, Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V541. |
Анализатор обнаружил очень подозрительное явное приведение типов. Это приведение типов может свидетельствовать о наличии ошибки. Рекомендуется проверить данный фрагмент кода.
Пример:
typedef unsigned char Byte;
void Process(wchar_t ch);
void Process(wchar_t *str);
void Foo(Byte *buf, size_t nCount)
{
for (size_t i = 0; i < nCount; ++i)
{
Process((wchar_t *)buf[i]);
}
}Мы имеем функцию Process, которая умеет обрабатывать как отдельные символы, так и строки. Также мы имеем функцию 'Foo', которая на вход получает указатель на буфер. Этот буфер обрабатывается как массив символов типа wchar_t. Но код содержит ошибку и анализатор предупреждает о том, что тип 'char' явно приводится к типу ' wchar_t *'. Причина в том, что выражение "(wchar_t *)buf[i]" эквивалентно "(wchar_t *)(buf[i])". В начале из массива извлекается значение типа 'char', а затем оно превращается в указатель. Исправленный вариант кода:
Process(((wchar_t *)buf)[i]);Однако не всегда, странные приведения типов являются ошибкой. Рассмотрим пример безопасного кода, взятого из реального приложения:
wchar_t *destStr = new wchar_t[len+1];
...
for (int j = 0 ; j < nbChar ; j++)
{
if (Case == UPPERCASE)
destStr[j] =
(wchar_t)::CharUpperW((LPWSTR)destStr[j]);
...Здесь присутствует явное приведение типа 'wchar_t ' к 'LPWSTR' и обратно от типа 'LPWSTR' к 'wchar_t '. Дело в том, что Windows API функция CharUpperW может работать с входным значением, и как с указателем, и как с символом. Прототип функции:
LPTSTR WINAPI CharUpperW(__inout LPWSTR lpsz);Если старшая часть указателя равна 0, то входное значение считается символом. В противном случае функция обрабатывает строку.
Анализатор знает про поведение функции CharUpperW и считает данный код безопасным. Однако в другой подобной ситуации анализатор может выдать ложное срабатывание.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V542. |
Анализатор обнаружил потенциальную ошибку при работе с переменной типа HRESULT.
HRESULT — это 32-разрядное значение, разделенное на три различных поля: код серьезности ошибки, код устройства и код ошибки. Для работы со значением HRESULT служат специальные константы, такие как S_OK, E_FAIL, E_ABORT и так далее. А для проверки значений тип HRESULT предназначены такие макросы как SUCCEEDED, FAILED.
Предупреждение V543 выдается в том случае, если в переменную типа HRESULT пытаются записать значение -1, true или false. Рассмотрим пример:
HRESULT h;
...
if (bExceptionCatched)
{
ShowPluginErrorMessage(pi, errorText);
h = -1;
}Запись значения "-1" некорректна. Если хочется сообщить о какой-то непонятной ошибке, то следует использовать значение 0x80004005L (Unspecified failure). Эта и аналогичные константы, описаны в "WinError.h". Корректный код:
if (bExceptionCatched)
{
ShowPluginErrorMessage(pi, errorText);
h = E_FAIL;
}Дополнительные ресурсы:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V543. |
Анализатор обнаружил потенциальную ошибку при работе с переменной типа HRESULT.
HRESULT- это 32-разрядное значение, разделенное на три различных поля: код серьезности ошибки, код устройства и код ошибки. Для работы со значением HRESULT служат специальные константы, такие как S_OK, E_FAIL, E_ABORT и так далее. А для проверки значений тип HRESULT предназначены такие макросы как SUCCEEDED, FAILED.
Предупреждение V544 выдается в том случае, если переменную типа HRESULT пытаются сравнить с -1, true или false. Рассмотрим пример:
HRESULT hr;
...
if (hr == -1)
{
}Сравнение со значением "-1" некорректно. Коды ошибок могут быть различны. Например, это может быть 0x80000002L (Ran out of memory), 0x80004005L (unspecified failure), 0x80070005L (General access denied error) и так далее. Для проверки значения HRESULT в данном случае необходимо использовать макрос FAILED, объявленный в "WinError.h". Корректный вариант кода:
if (FAILED(hr))
{
}Дополнительные ресурсы:
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку при работе с переменной типа HRESULT.
HRESULT - это 32-разрядное значение, разделенное на три различных поля: код серьезности ошибки, код устройства и код ошибки. Для работы со значением HRESULT служат специальные константы, такие как S_OK, E_FAIL, E_ABORT и так далее. А для проверки значений тип HRESULT предназначены такие макросы как SUCCEEDED, FAILED.
Предупреждение V545 выдается в том случае, если переменная типа HRESULT используется в операторе 'if' как переменная типа bool. Пример:
HRESULT hr;
...
if (hr)
{
}HRESULT и тип bool это совершенно разные по смыслу типы. Показанный пример сравнения некорректен. Тип HRESULT имеет множество состояний. Это может быть 0L (S_OK), 0x80000002L (Ran out of memory), 0x80004005L (unspecified failure), и так далее. Обратите внимание, что состояние S_OK кодируется как 0.
Для проверки значения HRESULT необходимо использовать макрос SUCCEEDED или FAILED, объявленные в "WinError.h". Корректные варианты кода:
if (FAILED(hr))
{
}
if (SUCCEEDED(hr))
{
}Дополнительные ресурсы:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V545. |
Анализатор обнаружил опечатку, когда член класса инициализируется самим собой.
Рассмотрим пример конструктора:
C95(int field) : Field(Field)
{
...
}Здесь имя параметра и название члена класса отличается только одной буквой. Из-за этого допущена опечатка и член 'Field' останется неинициализированным. Исправленный вариант кода:
C95(int field) : Field(field)
{
...
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V546. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что условие всегда истинно или ложно. Подобные условия не всегда означают наличие ошибки, но эти фрагменты кода следует обязательно проверить.
Пример кода:
LRESULT CALLBACK GridProc(HWND hWnd,
UINT message, WPARAM wParam, LPARAM lParam)
{
...
if (wParam<0)
{
BGHS[SelfIndex].rows = 0;
}
else
{
BGHS[SelfIndex].rows = MAX_ROWS;
}
...
}Здесь ветка "BGHS[SelfIndex].rows = 0;" никогда не будет выполнена. Дело в том, что переменная wParam имеет беззнаковый тип WPARAM, который объявлен как "typedef UINT_PTR WPARAM".
Этот код или содержит логическую ошибку, или может быть сокращен до одной строки: "BGHS[SelfIndex].rows = MAX_ROWS;".
Теперь рассмотрим пример кода, который не является ошибочным, но он потенциально опасен и имеет бессмысленное сравнение:
unsigned int a = _ttoi(LPCTSTR(str1));
if((0 > a) || (a > 255))
{
return(FALSE);
}Программист хотел реализовать следующий алгоритм.
1) Превратить строку в число.
2) Если число лежит вне диапазона [0..255] то вернуть статус ошибки (return FALSE).
Ошибка заключается в использовании типа 'unsigned'. Если функция _ttoi вернет отрицательное значение, то оно превратится в большое положительное значение. Например, значение "-3" превратится в 4294967293. Сравнение '0 > a' всегда вернёт false. Программа корректно работает из-за того, что диапазон значений [0..255] проверяется условием 'a > 255'.
Данный фрагмент кода будет диагностирован так: "V547 Expression '0 > a' is always false. Unsigned type value is never < 0."
Этот фрагмент лучше исправить следующим образом:
int a = _ttoi(LPCTSTR(str1));
if((0 > a) || (a > 255))
{
return(FALSE);
}Рассмотрим один специальный случай. Анализатор выдает предупреждение:
V547 Expression 's == "Abcd"' is always false. To compare strings you should use strcmp() function.
на следующий код:
const char *s = "Abcd";
void Test()
{
if (s == "Abcd")
cout << "TRUE" << endl;
else
cout << "FALSE" << endl;
}Однако это не совсем верно. Этот код может все-таки распечатать "TRUE", если переменная 's' и функция Test() объявлены в одном модуле. Компилятор не плодит множество одинаковых константных строк, а использует одну. В результате, иногда кажется, что код вполне работоспособен. Однако надо понимать, что это очень плохой код и следует использовать специальные функции для сравнения.
Следующий пример:
if (lpszHelpFile != 0)
{
pwzHelpFile = ((_lpa_ex = lpszHelpFile) == 0) ?
0 : Foo(lpszHelpFile);
...
}Этот код работает вполне корректно, но он излишне запутан. Условие "((_lpa_ex = lpszHelpFile) == 0)" всегда ложно, так как указатель lpszHelpFile всегда не равен нулю. Этот код сложен для чтения, и его лучше переписать.
Упрощенный вариант кода:
if (lpszHelpFile != 0)
{
_lpa_ex = lpszHelpFile;
pwzHelpFile = Foo(lpszHelpFile);
...
}Следующий пример:
SOCKET csd;
csd = accept(nsd, (struct sockaddr *) &sa_client, &clen);
if (csd < 0)
....Функция accept в заголовочных файлах Visual Studio возвращает значение, имеющее беззнаковый тип SOCKET. Поэтому проверка 'csd < 0' недопустима, ведь её результат всегда ложь (false). Возвращенные значения надо явно сравнивать с различными константами, например, с SOCKET_ERROR:
if (csd == SOCKET_ERROR)Анализатор предупреждает далеко не про все условия, которые всегда ложны или истинны. Он диагностирует только те ситуации, где высока вероятность наличия ошибки. Рассмотрим некоторые примеры, которые анализатор считает абсолютно корректными:
// 1) Вечный цикл
while (true)
{
...
}
// 2) Развернутый в Release версии макрос
// MY_DEBUG_LOG("X=", x);
0 && ("X=", x);
// 3) assert(false);
if (error) {
assert(false);
return -1;
}Примечание. Время от времени в поддержку приходят однотипные письма, в которых люди пишут, что не понимают предупреждение V547. Попробуем внести ясность. Рассмотрим обобщенный текст письма, которое присылают люди: "Анализатор выдаёт предупреждение "Expression 'i == 1' is always true". Но ведь это не так. Переменная может быть равна не только единице, но и нулю. Наверное, надо исправить поведение анализатора."
for (int i = 0; i <= 1; i++)
{
if(i == 0)
A();
else if(i == 1) // V547
B();
}Даём пояснение. Сообщение анализатора не говорит, что переменная 'i' всегда равна 1. Анализатор говорит, что 'i' равно 1 в конкретном месте, и указывает на эту строчку в программе.
Когда выполняется проверка 'if (i == 1)' точно известно, что переменная 'i' будет равна 1. Других вариантов нет. Конечно, такой код не обязательно содержит ошибку. Однако, это то место программы, которое стоит внимательно проверить.
Как видите, анализатор выдаёт здесь предупреждение совершенно правомерно. Если вы столкнулись с подобным видом предупреждения, есть следующие варианты как с ним поступить:
Упрощенный код:
for (int i = 0; i <= 1; i++)
{
if(i == 0)
A();
else
B();
}Если это избыточная проверка, но не хочется изменять код, то вы можете воспользоваться одним из методов подавления ложных срабатываний.
Рассмотрим еще один пример, в этот раз связанный с перечисляемыми типами.
enum state_t { STATE_A = 0, STATE_B = 1 }
state_t GetState()
{
if (someFailure)
return (state_t)-1;
return STATE_A;
}
state_t state = GetState();
if (state == STATE_A) // <= V547Автор хотел вернуть значение -1, если что-то пошло не так в процессе выполнения функции 'GetState'.
Анализатор выдаёт здесь предупреждение "V547 Expression 'state == STATE_A' is always true". На первый взгляд может показаться, что это ложное срабатывание, ведь мы не можем заранее предсказать, что нам вернёт функция. На самом деле, так сказывается на работе анализатора наличие в коде неопределённого поведения.
В 'state_t' не определена именованная константа со значением -1, и на самом деле 'return (state_t)-1' может вернуть из функции всё что угодно, так как здесь возникает неопределённое поведение. Кстати, анализатор предупредит о возникновении неопределённого поведения с помощью предупреждения "V1016 The value '-1' is out of range of enum values. This causes unspecified or undefined behavior', выданного на строку 'return (state_t)-1".
Итак, поскольку 'return (state_t)-1;' это undefined behavior, то анализатор не учитывает -1 как возможное значение, возвращаемое функцией. С точки зрения анализатора функция 'GetState' возвращает только значение 'STATE_A'. Это и является причиной выдачи сообщения V547.
Чтобы исправить ситуацию, следует добавить в перечисление константу, символизирующую ошибочный результат:
enum state_t { STATE_ERROR = -1, STATE_A = 0, STATE_B = 1 }
state_t GetState()
{
if (someFailure)
return STATE_ERROR;
return STATE_A;
}Теперь одновременно исчезнет предупреждение V547 и V1016.
Дополнительные ссылки:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V547. |
Анализатор обнаружил потенциально возможную ошибку, связанную с явным приведением типа. В программе массив, объявленный условно как "type Array[3][4]", приводится к типу "type **". Это приведение типа, скорее всего, не имеет смысла.
Типы "type[a][b]" и "type **" представляют собой разные структуры данных. Type[a][b] это единый участок памяти с которым можно работать как с двумерным массивом. Type ** - это массив указателей на какие-то участки памяти.
Пример:
void Foo(char **names, size_t count)
{
for(size_t i=0; i<count; i++)
printf("%s\n", names[i]);
}
void Foo2()
{
char names[32][32];
...
Foo((char **)names, 32); //Crash
}Исправленный вариант:
void Foo2()
{
char names[32][32];
...
char *names_p[32];
for(size_t i=0; i<32; i++)
names_p[i] = names[i];
Foo(names_p, 32); //OK
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V548. |
Анализатор обнаружил потенциальную ошибку в программе, связанную с тем, что совпадают два фактических аргумента функции. Передача одного и того же значения в качестве двух аргументов для многих функций является нормальной ситуацией. Но если речь идет о таких функциях как memmove, memcpy, strstr, strncmp, то это очень подозрительная ситуация.
Пример из реального приложения:
#define str_cmp(s1, s2) wcscmp(s1, s2)
...
v = abs(str_cmp(a->tdata, a->tdata));Из-за опечатки функция wcscmp сравнивает строку саму с собой. Корректным вариантом кода должно было быть:
v = abs(str_cmp(a->tdata, b->tdata));Анализатор выдаст предупреждение в случае работы с функциями: memcpy, memmove, memcmp, _memicmp, strstr, strspn, strtok, strcmp, strncmp, wcscmp, _stricmp, wcsncmp и так далее. Если вы обнаружили подобную ошибку, которая не диагностируется анализатором, то просим сообщить нам имя функции, которая также не должна принимать в качестве первого и второго аргумента одинаковые значения.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V549. |
Анализатор обнаружил потенциальную ошибку связанную с тем, что для сравнения чисел с плавающей точкой используется оператор == или !=. Нередко точное сравнение может быть источником ошибки.
Рассмотрим пример:
double a = 0.5;
if (a == 0.5) //OK
x++;
double b = sin(M_PI / 6.0);
if (b == 0.5) //ERROR
x++;Первое сравнение 'a == 0.5' истинно. Второе сравнение 'b == 0.5' может быть как истинно, так и ложно. Результат выражения 'b == 0.5' зависит от используемого процессора, версии и настроек компилятора. Например, значение переменной 'b' было равно 0.49999999999999994 при использовании компилятора Visual C++ 2010. Более корректно этот код можно написать следующим образом:
double b = sin(M_PI / 6.0);
if (fabs(b - 0.5) < DBL_EPSILON)
x++;В данном случае сравнение с погрешностью DBL_EPSILON верно, так как результат функции sin() лежит в диапазоне [-1, 1]. Однако, если мы работаем со значениями больше нескольких единиц, то такие погрешности как FLT_EPSILON, DBL_EPSILON будут слишком малы. И наоборот при работе со значениями типа 0.00001 эти погрешности слишком велики. Каждый раз следует выбирать погрешность адекватную диапазону возможных значений.
Возникает вопрос. Как же все-таки сравнить две переменных типа double?
double a = ...;
double b = ...;
if (a == b) // how?
{
}Одного единственно-правильного ответа нет. В большинстве случаев можно сравнит две переменных типа double, написав код следующего вида:
if (fabs(a-b) <= DBL_EPSILON * fmax(fabs(a), fabs(b)))
{
}Только осторожней с этой формулой, она работает только для чисел с одинаковым знаком. Также в ряде с большим количеством вычислений постоянно набегает ошибка, и константа 'DBL_EPSILON' может оказаться слишком маленьким значением.
А можно ли все-таки точно сравнивать значения в формате с плавающей точкой?
В некоторых случаях да. Но эти ситуации весьма ограничены. Сравнивать можно в том случае, если это и есть, по сути, одно и то же значение.
Пример, где допустимо точное сравнение:
// -1 - признак, что значение переменной не было установлено
float val = -1.0f;
if (Foo1())
val = 123.0f;
if (val == -1.0f) //OK
{
}В данном случае сравнение со значением "-1" допустимо, так как именно точно таким же значением мы инициализировали переменную ранее.
В рамках документации невозможно более подробно раскрыть тему сравнения float/double типов, поэтому мы отсылаем вас к внешнем источникам информации приведенных в конце.
Анализатор может только указать на потенциально опасные участки кода, где сравнение может не дать желаемого результата. Действительно ли код содержит ошибку, может понять только программист. Также мы не можем заранее дать в документации точные рекомендации, так как задачи, в которых используются типы с плавающей точкой слишком различны.
Диагностическое сообщение не выдается, если сравниваются два идентичных выражения типа float или double. Такое сравнение позволяет определить, является ли значение NaN. Пример кода, реализующего подобную проверку:
bool isnan(double X) { return X != X; }Впрочем, такой код нельзя назвать хорошим и лучше использовать стандартную функцию 'std::isnan'.
Дополнительные ресурсы:
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V550. |
Анализатор обнаружил потенциальную ошибку связанную с тем, что одна из ветвей оператора switch() никогда не получит управление. Причина этого в том, что аргумент оператора switch() не может принять значение, которое прописано в операторе case.
Рассмотрим пример:
char ch = strText[i];
switch (ch)
{
case '<':
strHTML += "<";
bLastCharSpace = FALSE;
nNonbreakChars++;
break;
case '>':
strHTML += ">";
bLastCharSpace = FALSE;
nNonbreakChars++;
break;
case 0xB7:
case 0xBB:
strHTML += ch;
strHTML += "<wbr>";
bLastCharSpace = FALSE;
nNonbreakChars = 0;
break;
...
}Здесь ветка расположенная после "case 0xB7:" и "case 0xBB:" никогда не получит управление. Переменная 'ch' имеет тип 'char', а, следовательно, диапазон её значений лежит в пределах [-128..127]. Результатом сравнения "ch == 0xB7" и "ch==0xBB" всегда будет ложь (false). Чтобы код был корректен переменная 'ch' должна иметь тип 'unsigned char'. Исправленный код:
unsigned char ch = strText[i];
switch (ch)
{
...
case 0xB7:
case 0xBB:
strHTML += ch;
strHTML += "<wbr>";
bLastCharSpace = FALSE;
nNonbreakChars = 0;
break;
...
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V551. |
Анализатор обнаружил потенциально опасную конструкция в коде, где происходит инкремент переменной типа bool.
Рассмотрим пример:
bool bValue = false;
...
bValue++;Во-первых, стандарт языка Си++ говорит:
The use of an operand of type bool with the postfix ++ operator is deprecated.
Это значит, что подобную конструкцию лучше не использовать.
Во-вторых, лучше явно присвоить переменной значение типа true. Это более понятный код:
bValue = true;В-третьих, возможно имеется опечатка и на самом деле хотелось увеличить другую переменную. Пример:
bool bValue = false;
int iValue = 1;
...
if (bValue)
bValue++;Случайно использовали не ту переменную и на самом деле должно быть:
bool bValue = false;
int iValue = 1;
...
if (bValue)
iValue++;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V552. |
Анализатор обнаружил в программе объявление класса или тело функции, которые занимают более 2000 строк. Этот класс или функция не обязательно содержат ошибки, но вероятность этого очень высокая. Чем больше функция, тем легче допустить в ней ошибку и тем сложнее ее отлаживать. Чем больше класс, тем сложнее разобраться в его интерфейсах.
Это сообщение хороший повод постараться все-таки найти время для рефакторинга кода. Да, всегда нужно делать что-то срочное. Но чем больше по размеру будут функции и классы, тем больший процент времени будет уходить не на написание новой функциональности, а на поддержание старого кода и устранение в нем ошибок.
Дополнительные материалы по данной теме:
Анализатор обнаружил ситуацию, когда использование умного указателя может привести к неопределенному поведению, в частности, к повреждению кучи, аварийному завершению программы или неполному разрушению объектов. Ошибка заключается в том, что память выделяется и освобождается различными методиками.
Рассмотрим первый пример:
void Foo()
{
struct A
{
A() { cout << "A()" << endl; }
~A() { cout << "~A()" << endl; }
};
std::unique_ptr<A> p(new A[3]);
}По умолчанию класс unique_ptr использует для освобождения памяти оператор 'delete'. Поэтому будет разрушен только один объект класса 'A' и на экране будет распечатан следующий текст:
A()
A()
A()
~A()Чтобы исправить ошибку необходимо указать, что необходимо использовать оператор 'delete []'. Корректный вариант кода:
std::unique_ptr<A[]> p(new A[3]);Теперь будет вызываться равное количество конструкторов и деструкторов и будет распечатан текст:
A()
A()
A()
~A()
~A()
~A()Рассмотрим второй пример:
std::unique_ptr<int []> p((int *)malloc(sizeof(int) * 5));Память выделяется с использованием функции 'malloc()', а освобождается при помощи оператора 'delete []'. Это некорректно и следует указать, что освобождать память надо используя функцию 'free()'. Корректный вариант кода может выглядеть следующим образом:
int *d =(int *)std::malloc(sizeof(int) * 5);
unique_ptr<int, void (*)(void*)> p(d, std::free);Дополнительные материалы по данной теме:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V554. |
Анализатор обнаружил потенциальную ошибку в выражении вида "A - B > 0". Высока вероятность, что условие написано неверно, если подвыражение "A - B" имеет беззнаковый тип.
Условие "A - B > 0" выполняется во всех случаях, когда значение 'A' не равно значению 'B'. Это значит, что вместо выражения "A - B > 0" можно написать "A != B". Но скорее всего программист задумывал совсем другое.
Рассмотрим пример:
unsigned int *B;
...
if (B[i]-70 > 0)Программист хотел проверить, что i-тый элемент массива B больше значения 70. Это можно было записать так: "B[i] > 70". Исходя из каких-то своих соображений, программист записал эту проверку так: "B[i]-70 > 0". И допустил ошибку. Он забыл, что элементы массива 'B' имеют тип 'unsigned'. Это значит, что и выражение "B[i]-70" будет иметь тип 'unsigned'. Получается, что условие всегда истинно, за исключением случая, когда элемент 'B[i]' будет равен 70.
Поясним эту ситуацию.
Если 'B[i]' больше 70, то "B[i]-70" будет больше 0.
Если 'B[i]' меньше 70, то произойдет переполнение типа unsigned и мы получим очень большое значение. Пусть B[i] == 50. Тогда "B[i]-70" = 50u - 70u = 0xFFFFFFECu = 4294967276. Естественно, что 4294967276 > 0.
Демонстрационный пример:
unsigned A;
A = 10; cout << "A=10 " << (A-70 > 0) << endl;
A = 70; cout << "A=70 " << (A-70 > 0) << endl;
A = 90; cout << "A=90 " << (A-70 > 0) << endl;
// Будет распечатано
A=10 1
A=70 0
A=90 1Первый вариант исправленного кода:
unsigned int *B;
...
if (B[i] > 70)Второй вариант исправленного кода:
int *B;
...
if (B[i]-70 > 0)Отметим, что выражение вида "A - B > 0" далеко не всегда означает наличие ошибки. Рассмотрим код, где анализатор выдаст ложное предупреждение:
// Функции GetLength() и GetPosition() возвращают
// значение типа size_t.
while ((inStream.GetLength() - inStream.GetPosition()) > 0)
{ ... }Здесь GetLength() всегда больше или равно GetPosition(). Поэтому код корректен. Чтобы избавиться от ложного срабатывания можно использовать комментарий //-V555 или переписать код следующим образом:
while (inStream.GetLength() != inStream.GetPosition())
{ ... }Вот еще один случай, когда ошибки не возникнет.
__int64 A;
__uint32 B;
...
if (A - B > 0)Здесь подвыражение "A - B" имеет знаковый тип __int64 и ошибки не возникнет. Анализатор не выдает предупреждения в таких ситуациях.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V555. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в коде сравниваются enum значения, имеющие разные типы.
Пример:
enum ErrorTypeA { E_OK, E_FAIL };
enum ErrorTypeB { E_ERROR, E_SUCCESS };
void Foo(ErrorTypeB status) {
if (status == E_OK)
{ ... }
}В сравнении случайно использовано неверное имя, и логика работы программы будет нарушена. Корректный вариант:
void Foo(ErrorTypeB status) {
if (status == E_SUCCESS)
{ ... }
}Сравнение значений различных типов перечислений (enum) не обязательно является ошибкой. Но подобный код нуждается в проверке (code review).
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V556. |
Анализатор обнаружил потенциально возможный доступ к памяти за границами массива. Самым распространённым случаем является ошибка при записи символа \0 после последнего элемента массива.
Рассмотрим соответствующий пример:
struct IT_SAMPLE
{
unsigned char filename[14];
...
};
static int it_riff_dsmf_process_sample(
IT_SAMPLE * sample, const unsigned char * data)
{
memcpy( sample->filename, data, 13 );
sample->filename[ 14 ] = 0;
...
}Последний элемент массива имеет индекс 13, а не 14. Поэтому корректный код должен иметь вид:
sample->filename[13] = 0;В подобных случаях лучше использовать не явное значение индекса, а выражение, использующее оператор sizeof(). Однако следует помнить, что и в этом случае можно допустить ошибку. Рассмотрим пример:
typedef wchar_t letter;
letter name[30];
...
name[sizeof(name) - 1] = L'\0';На первый взгляд выражение sizeof(name) – 1 верно. Но здесь программист забыл, что он работает с типом wchar_t, а не char. В результате символ \0 будет записан далеко за пределами массива.
Корректный вариант:
name[sizeof(name) / sizeof(*name) - 1] = L'\0';Для упрощения записи таких конструкций можно использовать специальный макрос:
#define str_len(arg) ((sizeof(arg) / sizeof(arg[0])) - 1)
name[str_len(name)] = L'\0';Анализатор выявляет некоторые ошибки, когда индексом является переменная, значение которой может выйти за пределы массива.
Пример:
int buff[25];
for (int i=0; i <= 25; i++)
buff[i] = 10;Корректный вариант:
int buff[25];
for (int i=0; i < 25; i++)
buff[i] = 10;Следует учитывать, что при работе с подобными диапазонами значений анализатор может ошибаться и выдавать ложные срабатывания.
Анализатор также может выявлять потенциальный выход за границы массива в ситуациях, когда проверяется только нижняя граница индекса, а верхняя — нет.
Рассмотрим пример:
int arr[6];
void foo(int i)
{
if (i >= 0)
{
arr[i] = 0; // <= V557
}
}Условие i >= 0 лишь гарантирует, что индекс массива неотрицателен, но не защищает от переполнения буфера. Если переменная i будет иметь значение больше 5, то произойдёт выход за границу массива arr.
Корректный код:
int arr[6];
void foo(int i)
{
if (i >= 0 && i < 6)
{
arr[i] = 0; //ok
}
}По умолчанию проверка верхней границы массива отключена. Чтобы её включить, добавьте комментарий в файл конфигурации(.pvsconfig) или в файл с исходным кодом:
//+V557 CHECK_UPPER_BOUND:ONДля её отключения используйте комментарий:
//+V557 CHECK_UPPER_BOUND:OFFВыявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти), Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V557. |
Анализатор обнаружил ситуацию, когда функция возвращает указатель на локальный объект. Этот объект будет уничтожен при выходе из функции, и использовать указатель на него будет нельзя.
В самом простом виде данное диагностическое сообщение будет выдано на следующий код:
float *F()
{
float f = 1.0;
return &f;
}Конечно, в таком виде ошибка вряд ли будет существовать. Рассмотрим более реальный пример кода.
int *Foo()
{
int A[10];
// ...
if (err)
return 0;
int *B = new int[10];
memcpy(B, A, sizeof(A));
return A;
}Мы работали с временным массивом A. При некотором условии мы должны вернуть указатель на новый массив B. Однако из-за опечатки мы возвращаем массив A, что повлечет за собой непредсказуемое поведение программы или её аварийное завершение. Исправленный вариант кода:
int *Foo()
{
...
int *B = new int[10];
memcpy(B, A, sizeof(A));
return B;
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V558. |
Анализатор обнаружил ситуацию, когда в условии оператора 'if' или 'while' присутствует оператор присваивания '='. Подобная конструкция часто свидетельствует о наличии ошибок. Высока вероятность, что вместо оператора '=' планировалось использовать оператор '=='.
Рассмотрим пример:
const int MAX_X = 100;
int x;
...
if (x = MAX_X)
{ ... }В коде допущена опечатка: вместо сравнения переменной 'x' c константной MAX_X произойдет изменение значения переменной 'x'. Корректный вариант кода:
if (x == MAX_X)
{ ... }Конечно, присваивание внутри условия часто ошибкой не является. Такой приём используется многими программистами для сокращения размера кода. Стоит отметить, что это плохая практика, так как работая с подобным кодом всегда подолгу приходится изучать его, чтобы понять: является ли он следствием опечатки или желанием сократить программу.
Мы предлагаем отказаться от присваивания внутри условия и использовать присваивание в качестве отдельной операции. Другой вариант - использовать дополнительные скобки вокруг присваивания:
while ((x = Foo()))
{
...
}Подобный код анализатор и многие компиляторы воспринимают как безопасный. Заодно, это подсказка человеку, что код не содержит ошибку.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V559. |
Анализатор обнаружил потенциально возможную ошибку внутри логического условия. Часть логического выражения всегда истинно и оценено как опасное.
Рассмотрим пример:
#define REO_INPLACEACTIVE (0x02000000L)
...
if (reObj.dwFlags && REO_INPLACEACTIVE)
m_pRichEditOle->InPlaceDeactivate();Программист хотел проверить состояние определенного бита в переменной dwFlags. Но из-за опечатки он написал оператор '&&', вместо оператора '&'. Корректный код:
if (reObj.dwFlags & REO_INPLACEACTIVE)
m_pRichEditOle->InPlaceDeactivate();Рассмотрим другой пример:
if (a = 10 || a == 20)Случайно вместо оператора сравнения '==' написан оператор присваивания '='. С точки зрения языка Си++, это выражение будет идентично выражению вида "if (a = (10 || a == 20))".
Выражение "10 || a == 20" анализатор считает опасным, так как левая его часть представляет собой константу. Корректный код:
if (a == 10 || a == 20)Иногда предупреждение V560 выявляет не ошибку, а просто избыточный код. Рассмотрим пример:
if (!mainmenu) {
if (freeze || winfreeze ||
(mainmenu && gameon) ||
(!gameon && gamestarted))
drawmode = normalmode;
}Анализатор предупредит, что в подвыражении (mainmenu && gameon) переменная mainmenu всегда равна 0. То, что переменная mainmenu равна нулю, следует из вышестоящей проверки " if (!mainmenu)". Этот код может быть вполне корректен. Однако он избыточен, и лучше его упростить. Это сделает программу более простой для понимания другими разработчиками.
Упрощенный вариант кода:
if (!mainmenu) {
if (freeze || winfreeze ||
(!gameon && gamestarted))
drawmode = normalmode;
}Рассмотрим более интересный случай.
int16u Integer = ReadInt16u(Liste);
int32u Exponent=(Integer>>10) & 0xFF;
if (Exponent==0 || Exponent==0xFF) // V560
return 0;Пользователь, приславший этот пример, был озадачен, почему анализатор выдаёт предупреждение, в котором утверждается, что подвыражение 'Exponent==0xFF' всегда ложное. Давайте разберемся. Для этого нам надо внимательно посчитать.
16-битная беззнаковая переменная 'Integer' имеет диапазон возможных значений [0..0b1111111111111111] или [0..0xFFFF].
При сдвиге вправо на 10 бит, диапазон возможных значений уменьшается: [0..0b111111] или [0..0x3F].
Далее выполняется операция '& 0xFF'.
В результате, никак невозможно получить значение '0xFF'. Максимум, это будет '0x3F'.
Ряд конструкций на языке Си++ анализатор считает безопасными, даже если в них часть выражения представляется константой. Примеры некоторых ситуаций, когда анализатор не считает код опасными:
Особые настройки диагностики V560
По дополнительной просьбе пользователей появилась возможность управлять поведением диагностики V560. В общем заголовочном файле или pvsconfig-файле можно написать комментарий специального вида:
//+V560 ENABLE_PEDANTIC_WARNINGSРежим 'ENABLE_PEDANTIC_WARNINGS' ослабляет исключения диагностики. Рассмотрим пример:
void foo()
{
bool debugCheck = false; // maybe in macros
if (x)
{
if (debugCheck)
{
....
}
}
}По умолчанию анализатор не будет считать такой код опасным, так как часто он пишется для отладки. Комментарий позволит ослабить исключение диагностики, чтобы анализатор мог сообщить о проблеме.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V560. |
Анализатор обнаружил потенциально возможную ошибку, найдя в коде переменную, которая объявляется и инициализируется, но далее не используется. При этом во внешней области видимости имеется переменная, имеющая такое же имя и такой же тип. Высока вероятность, что следовало использовать уже имеющуюся переменную, а не объявлять новую.
Рассмотрим пример:
BOOL ret = TRUE;
if (m_hbitmap)
BOOL ret = picture.SaveToFile(fptr);Программист случайно объявил новую переменную 'ret', в результате чего предыдущая всегда будет иметь значение TRUE, вне зависимости от того успешно будет сохранена картина в файл или нет. Исправленный вариант кода:
BOOL ret = TRUE;
if (m_hbitmap)
ret = picture.SaveToFile(fptr);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V561. |
Анализатор обнаружил ситуацию, когда значение типа bool сравнивается с числом. Скорее всего, это свидетельствует о наличии в коде ошибки.
Рассмотрим пример:
if (0 < A < 5)Этим кодом программист, недостаточно хорошо знакомый с языком Си++, пытался определить, лежит значение в диапазоне от 0 до 5 или нет. На самом деле, вычисления будут происходить в следующей последовательности: ((0 < A) < 5). Результат выражения "0 < A" имеет тип bool, а значит всегда меньше 5.
Корректный вариант проверки:
if (0 < A && A < 5)Предыдущий пример, напоминает ошибку, которые делают студенты. Однако от подобных ошибок не застрахованы и профессиональные разработчики.
Рассмотрим второй пример:
if (! (fp = fopen(filename, "wb")) == -1) {
perror("opening image file failed");
exit(1);
}Здесь сразу 2 ошибки разного плана. Во-первых, функция "fopen" возвращает указатель, и сравнивать возвращаемое значение следует с NULL. Программист спутал функцию "fopen" с "open", которая как раз возвращает "-1" в случае ошибки. Второй недочет в коде связан с тем, что вначале выполняется операция отрицания "!", а только затем сравнение с "-1". Значение типа bool не имеет смысла сравнивать с "-1" и именно поэтому анализатор и обратил внимание на приведенный код.
Корректный вариант:
if ( (fp = fopen(filename, "wb")) == NULL) {
perror("opening image file failed");
exit(1);
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V562. |
Анализатор обнаружил потенциально возможную ошибку в логических условиях. Логика работы кода не совпадает с тем, как этот код отформатирован.
Рассмотрим пример:
if (X)
if (Y) Foo();
else
z = 1;Форматирование кода сбивает с толку, и кажется, что присваивание "z = 1" произойдет в том случае, если X == false. Однако ветка 'else' относится к ближайшему оператору 'if'. Другими словами приведенный код на самом деле эквивалентен следующему коду:
if (X)
{
if (Y)
Foo();
else
z = 1;
}Таким образом, код работает не так, как может показаться на первый взгляд.
Если выдано предупреждение V563, то это может означать две вещи:
1) Код плохо отформатирован и ошибки на самом деле нет. Тогда, чтобы предупреждение V563 не выдавалось, а код был более понятен, его нужно отформатировать. Пример корректного форматирования:
if (X)
if (Y)
Foo();
else
z = 1;2) Найдена логическая ошибка. Тогда, код можно исправить, например, так:
if (X) {
if (Y)
Foo();
} else {
z = 1;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V563. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что операторы '&' и '|' работают со значениями типа bool. Подобные выражения не обязательно являются ошибочными, но часто свидетельствуют об опечатках или об ошибках в условиях.
Рассмотрим пример:
int a, b;
#define FLAG 0x40
...
if (a & FLAG == b)
{
}Этот пример считается классическим. Очень легко ошибиться в приоритетах операций. Кажется, что последовательность вычислений следующая - "(a & FLAG) == b". Но на самом деле, последовательность вычислений будет следующая - "a & (FLAG == b)". И скорее всего, это ошибка.
Анализатор выдаст здесь предупреждение, так как странно использовать оператор '&' для переменных типа int и bool.
Если выяснится, что код содержит ошибку, то его можно исправить следующим образом:
if ((a & FLAG) == b)Конечно, код может оказаться корректным и работать именно так, как нужно. Однако и в этом случае рационально переписать его, чтобы он стал проще для понимания. Лучше использовать оператор && или дополнительные скобки:
if (a && FLAG == b)
if (a & (FLAG == b))После таких исправлений предупреждение V564 более выдаваться не будет, а код станет более прост для чтения.
Рассмотрим другой пример:
#define SVF_CASTAI 0x00000010
if ( !ent->r.svFlags & SVF_CASTAI ) {
...
}Здесь мы имеем дело с явной ошибкой. В начале будет вычислено подвыражение "!ent->r.svFlags" и получен результат true или fasle. Но это не имеет значения. Будем мы выполнять операцию "true & 0x00000010" или "false & 0x00000010", результат будет одинаков. Условие в данном примере всегда ложно.
Исправленный вариант:
if ( ! (ent->r.svFlags & SVF_CASTAI) )Примечание. Анализатор не будет выдавать предупреждение, если слава и справа от оператора '&' или '|' находятся значения типа bool. Такой код хотя и не очень красив, но корректен. Пример кода, который анализатор считает безопасным:
bool X, Y;
...
if (X | Y)
{ ... }Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V564. |
Найден обработчик исключения, который ничего не делает.
Пример кода:
try {
...
}
catch (MyExcept &)
{
}Конечно, такой код вовсе не обязательно ошибочен. Но очень странно просто подавлять исключение, ничего не делая. Такая обработка исключений может скрывать дефекты в программе и усложнить тестирование программы.
Следует, как то реагировать на исключения. Например, рационально вписать хотя бы "assert(false)":
try {
...
}
catch (MyExcept &)
{
assert(false);
}Иногда подобные конструкции используют, чтобы вернуть управление из множества вложенных циклов или рекурсивных функций. Но это плохая практика, так как исключение очень ресурсоемкая операция. Исключения следует использовать по назначению, а именно при возникновении нештатных ситуаций, которые должны быть обработаны на более высоком уровне.
Единственное место, где допустимо просто подавлять исключения, это деструкторы. Деструктор не должен бросать исключений. Однако, в деструкторах часто не понятно, что делать с исключениями и обработчик вполне может быть пуст. Анализатор не предупреждает о пустых обработчиках внутри деструкторов:
CClass::~ CClass()
{
try {
DangerousFreeResource();
}
catch (...) {
}
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V565. |
Анализатор обнаружил явное приведение числового значения к типу указателя. Чаще всего это предупреждение выдается для участков кода, где числа используются как статус состояния объекта. Подобные приемы не всегда являются ошибкой, но, как правило, свидетельствуют о плохом дизайне.
Рассмотрим пример:
const DWORD SHELL_VERSION = 0x4110400;
...
char *ptr = (char*) SHELL_VERSION;
...
if (ptr == (char*) SHELL_VERSION)В указателе сохраняется константное значение, которое отмечает некоторое специальное состояние. Подобный код может долгое время успешно работать. Но если будет создан объект по адресу 0x4110400, то не будет возможность отличить, это магический флаг или просто объект. Если хочется использовать специальный флаг, то лучше написать так:
const DWORD SHELL_VERSION = 0x4110400;
...
char *ptr = (char*)(&SHELL_VERSION);
...
if (ptr == (char*)(&SHELL_VERSION))Примечание. Чтобы сократить количество ложных срабатываний, сообщение V566 не выдается в целом ряде случаев. Например, если магическим числом являются такие значения, как: -1, 0, 0xcccccccc, 0xdeadbeef. Предупреждение не выдается, если число лежит в диапазоне от 0 до 65535 и приводится к указателю на строку. Это позволяет пропустить корректный код следующего вида:
CString sMessage( (LPCSTR)IDS_FILE_WAS_CHANGED ) ;Подобный способ загрузки строки из ресурсов достаточно распространен, хотя, конечно, лучше использовать MAKEINTRESOURCE. Есть и другие исключения.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил выражение, которое приводит к неопределённому поведению программы. Переменная неоднократно используется между двумя точками следования, при этом её значение изменяется. В результате невозможно предсказать результат работы такого выражения. Рассмотрим понятия "неопределённое поведение" и "точка следования" более подробно.
Неопределённое поведение (англ. undefined behavior) — свойство некоторых языков программирования (наиболее заметно в C и C++) в определённых ситуациях выдавать результат, зависящий от реализации компилятора. Другими словами, спецификация не определяет поведение языка в любых возможных ситуациях, а говорит: "При условии А результат операции Б не определён". Допускать такую ситуацию в программе считается ошибкой, даже если на некотором компиляторе программа успешно выполняется, она не будет кроссплатформенной и может отказать на другой машине, в другой ОС и даже при других настройках компилятора.
Точка следования (англ. sequence point) — в императивном программировании любая точка программы, в которой гарантируется, что все побочные эффекты предыдущих вычислений уже проявились, а побочные эффекты последующих ещё отсутствуют.
Их часто упоминают, говоря о C и C++, поскольку в этих языках особенно просто записать выражение, значение которого может зависеть от неопределённого порядка проявления побочных эффектов. Добавление одной или нескольких точек следования задаёт порядок более жестко и является одним из методов достижения устойчивого (т.е. корректного) результата.
В C++11 вместо точек следования ввели понятия sequenced before/after, sequenced и unsequenced. Многие выражения, приводящие к неопределённому поведению в C++03, стали определены (например, i = ++i). Эти правила также дополнялись в C++14 и C++17. Анализатор выдаёт срабатывание в зависимости от используемого стандарта.
Примеры неопределённого поведения в зависимости от стандартов:
i = ++i + 2; // undefined behavior until C++11
i = i++ + 2; // undefined behavior until C++17
f(i = -2, i = -2); // undefined behavior until C++17
f(++i, ++i); // undefined behavior until C++17,
// unspecified after C++17
i = ++i + i++; // undefined behavior
cout << i << i++; // undefined behavior until C++17
a[i] = i++; // undefined behavior until C++17
n = ++i + i; // undefined behaviorТочки следования необходимы в ситуации, когда одна и та же переменная изменяется в выражении более одного раза. Часто в качестве примера приводят выражение i=i++, в котором происходит присваивание переменной i и её же инкремент. Какое значение примет i? Стандарт языка должен либо указать одно из возможных поведений программы как единственно допустимое, либо указать диапазон допустимых поведений, либо указать, что поведение программы в данном случае совершенно не определено. В языке C вычисление выражения i = i++ приводит к неопределённому поведению, поскольку это выражение не содержит внутри себя ни одной точки следования.
В C и C++ определены следующие точки следования:
&& (логическом И), || (логическом ИЛИ) и операторах-запятых. Например, в выражении *p++ != 0 && *q++ != 0 все побочные эффекты левого операнда *p++ != 0 проявятся до начала каких-либо действий в правом.a = (*p++) ? (*p++) : 0 точка находится после первого операнда *p++. При вычислении второго выражения, переменная p уже увеличена на 1.a=b;), выражения в инструкциях return, управляющие выражения в круглых скобках инструкций ветвления if или switch и циклов while или do-while и все три выражения в круглых скобках цикла for.f(i++) + g(j++) + h(k++) каждая из трёх переменных: i, j и k, принимает новое значение перед входом в f, g и h соответственно. Однако порядок вызова функций f(), g(), h() не определён, следовательно, не определён и порядок инкремента i, j, k. Значения j и k в теле функции f оказываются неопределенными. Следует отметить, что вызов функции нескольких аргументов f(a,b,c) не является случаем применения оператора-запятой и не определяет порядок вычисления значений аргументов.(1+i++) в int a = (1+i++);.Рассмотрим пример кода, взятого из реального приложения:
while (!(m_pBitArray[m_nCurrentBitIndex >> 5] &
Powers_of_Two_Reversed[m_nCurrentBitIndex++ & 31]))
{}
return (m_nCurrentBitIndex - BitInitial - 1);Компилятор может вычислить вначале как левый, так и правый аргумент оператора &. Это значит, что переменная m_nCurrentBitIndex может быть уже увеличена на единицу при вычислении m_pBitArray[m_nCurrentBitIndex >> 5]. А может быть ещё и не увеличена.
Этот код может долго и исправно работать. Однако следует учитывать, что гарантированно корректно он будет себя вести только при сборке определённой версией компилятора с неизменным набором параметров компиляции. Корректный вариант кода:
while (!(m_pBitArray[m_nCurrentBitIndex >> 5] &
Powers_of_Two_Reversed[m_nCurrentBitIndex & 31]))
{ ++m_nCurrentBitIndex; }
return (m_nCurrentBitIndex - BitInitial);Этот код более не содержит неоднозначностей. Заодно исчезла магическая константа -1.
Программисты часто считают, что неопределённое поведение может возникать только при использовании постинкремента, в то время как преинкремент безопасен. Это не так. Рассмотрим пример общения на эту тему.
Вопрос:
Скачал ознакомительную версию вашей студии, прогнал свой проект и получил такое предупреждение: V567 Undefined behavior. The 'i_acc' variable is modified while being used twice between sequence points.
Код:
i_acc = (++i_acc) % N_acc;Как мне кажется, здесь нет undefined behavior, так как переменная i_acc не участвует в выражении дважды.
Ответ:
Для языка C и для языка C++ до стандарта C++11 неопределённое поведение здесь есть, хотя вероятность проявления ошибки весьма мала. Оператор = не является точкой следования. Это значит, что сначала компилятор может поместить значение переменной i_acc в регистр, затем увеличить значение в регистре, вычислить выражение и записать результат в переменную i_acc, после чего вновь записать в эту переменную регистр с увеличенным значением. В результате мы получим код вида:
REG = i_acc;
REG++;
i_acc = (REG) % N_acc;
i_acc = REG;Компилятор имеет на это полное право. Конечно, на практике, скорее всего, он сразу увеличит значение переменной и тогда всё посчитается так, как ожидает программист, но полагаться на это нельзя.
Рассмотрим ещё одну ситуацию, связанную с вызовом функций.
Порядок вычисления аргументов функции не определён. Если аргументами является изменяющаяся переменная, то результат будет непредсказуем. Это неуточнённое поведение. Рассмотрим пример:
int A = 0;
Foo(A = 2, A);Функция Foo может быть вызвана как с аргументами (2, 0), так и с аргументами (2, 2). Порядок вычисления аргументов функции зависит от компилятора и настроек оптимизации.
Дополнительные ресурсы
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V567. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что аргументом оператора sizeof() является подозрительное выражение.
Подозрительные выражения можно разделить на три группы:
1. В выражении пытаются изменить какую-то переменную.
Оператор sizeof() вычисляет тип выражения и возвращает размер этого типа. Но само выражение не вычисляется. Пример подозрительного кода:
int A;
...
size_t size = sizeof(A++);Данный код не увеличивает переменную 'A'. Если необходимо увеличить 'A' то следует переписать код следующим образом:
size_t size = sizeof(A);
A++;2. В выражении используются такие операции, как сложение, умножение и так далее.
Сложные выражения являются признаком наличия ошибки. Чаще всего эти ошибки связаны с опечатками. Пример:
SendDlgItemMessage(
hwndDlg, RULE_INPUT_1 + i, WM_GETTEXT,
sizeof(buff - 1), (LPARAM) input_buff);Вместо "sizeof(buff) - 1" программист случайно написал "sizeof(buff - 1)". Корректный вариант:
SendDlgItemMessage(
hwndDlg, RULE_INPUT_1 + i, WM_GETTEXT,
sizeof(buff) - 1, (LPARAM) input_buff);Другой пример опечатки в тексте программы:
memset(tcmpt->stepsizes, 0,
sizeof(tcmpt->numstepsizes * sizeof(uint_fast16_t)));Корректный вариант:
memset(tcmpt->stepsizes, 0,
tcmpt->numstepsizes * sizeof(uint_fast16_t));3. Аргументом оператора sizeof() является указатель на класс. Чаще всего это означает, что программист забыл разыменовать указатель.
Пример:
class MyClass
{
public:
int a, b, c;
size_t getSize() const
{
return sizeof(this);
}
};Метод getSize() возвращает размер указателя, а не размер объекта. Корректный вариант:
size_t getSize() const
{
return sizeof(*this);
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V568. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что константное значение усекается при помещении в переменную.
Рассмотрим пример:
int A[100];
unsigned char N = sizeof(A);Размер массива 'A' (в Win32/Win64) составляет 400 байт. Диапазон значений типа unsigned char: 0..255. Следовательно, переменная 'N' не может хранить размер массива 'A'.
Предупреждение V569 указывает на то, что для хранения размера выбран неверный тип. Или что на самом деле планировалось вычислить количество элементов в массиве, а не размер массива.
Если выбран неверный тип, то код может быть исправлен следующим образом:
size_t N = sizeof(A);Если планировалось вычислить количество элементов в массиве, то код следует изменить так:
unsigned char N = sizeof(A) / sizeof(*A);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V569. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что переменная присваивается сама себе.
Рассмотрим пример:
dst.m_a = src.m_a;
dst.m_b = dst.m_b;Из-за опечатки значение переменной dst.m_b не изменится. Исправленный вариант кода:
dst.m_a = src.m_a;
dst.m_b = src.m_b;Анализатор выдаёт предупреждение не только на копирующее присваивание, но и на перемещающее.
Пример:
dst.m_a = std::move(src.m_a);Анализатор не всегда выдаёт предупреждение, если встречает присваивание переменной самой себе. Например, если переменные взяты в скобки. Подобный приём часто используется для подавления предупреждений компилятора.
Пример:
int Foo(int foo)
{
UNREFERENCED_PARAMETER(foo);
return 1;
}Макрос UNREFERENCED_PARAMETER объявлен в файле WinNT.h следующим образом:
#define UNREFERENCED_PARAMETER(P) \
{ \
(P) = (P); \
}Анализатор распознаёт такие ситуации и не выдаст предупреждение V570 на присваивание следующего вида:
(foo) = (foo);Если в вашем проекте такой подход не используется, то можно добавить следующий комментарий, чтобы включить предупреждение:
//V_WARN_ON_ARGUMENT_SELF_ASSIGNПримечание. Если предупреждение V570 относится к макросам, которые нельзя исправить, то можно воспользоваться механизмом подавления предупреждений в макросах. Достаточно написать специальный комментарий в файле, используемом во всём проекте (например, в StdAfx.h).
Пример:
//-V:MY_MACROS:V570Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V570. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что дважды проверяется одно и тоже условие.
Рассмотрим два примера:
// Example N1:
if (A == B)
{
if (A == B)
...
}
// Example N2:
if (A == B) {
} else {
if (A == B)
...
}В первом случае вторая проверка "if (A==B)" всегда истинна. Во втором случае, вторая проверка всегда ложна.
Высока вероятность, что подобный код содержит ошибку. Например, из-за опечатки используется ошибочное имя переменной. Корректный код:
// Example N1:
if (A == B)
{
if (A == C)
...
}
// Example N2:
if (A == B) {
} else {
if (A == C)
...
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V571. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что объект, созданный с помощью оператора 'new', явным образом приводится к другому типу.
Рассмотрим пример:
T_A *p = (T_A *)(new T_B());
...
delete p;Возможны три варианта, как появился такой код и что с ним делать.
1) T_B не является наследником от класса T_A.
Скорее всего, это досадная опечатка или грубая ошибка. Способ её исправления зависит от того, что должен делать данный код.
2) T_B наследуется от класса T_A. Класс T_A не имеет виртуального деструктора.
В этом случае приводить T_B к T_A нельзя, так как потом невозможно корректно уничтожить созданный объект. Корректный код:
T_B *p = new T_B();
...
delete p;3) T_B наследуется от класса T_A. Класс T_A имеет виртуальный деструктор.
В этом случае код корректен, но явное приведение типа не имеет смысла. Можно написать проще:
T_A *p = new T_B();
...
delete p;Бывают и другие ситуации, когда будет выдано предупреждение V572. Рассмотрим пример кода, взятый из реального приложения:
DWORD CCompRemoteDriver::Open(HDRVR,
char *, LPVIDEO_OPEN_PARMS)
{
return (DWORD)new CCompRemote();
}Программа для своих нужд работает с указателем, как с дескриптором. Для этого она явно приводит указатель к типу DWORD. Такой код будет корректно работать в 32-битных системах, но может привести к сбою в 64-битной программе. Можно избежать 64-битной ошибки, используя более подходящий тип данных DWORD_PTR:
DWORD_PTR CCompRemoteDriver::Open(HDRVR,
char *, LPVIDEO_OPEN_PARMS)
{
return (DWORD_PTR)new CCompRemote();
}Иногда, причиной для предупреждения V572 является атавизм, оставшийся со времен, когда код был написан на языке Си. Рассмотрим пример такого кода:
struct Joint {
...
};
joints=(Joint*)new Joint[n]; //malloc(sizeof(Joint)*n);Комментарий подсказывает нам, что раньше для выделения памяти использовалась функция 'malloc'. Теперь для этого используется оператор 'new'. Но удалить приведение забыли. Код корректен, но приведение типа здесь совершенно излишне. Можно написать более короткий код:
joints = new Joint[n];Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V572. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что объявляемая переменная для инициализации использует саму себя.
Рассмотрим простой синтетический пример:
int X = X + 1;Переменная X будет инициализирована случайным значениям. Конечно, этот пример надуман, но зато он прост и хорошо демонстрирует смысл предупреждения. На практике подобная ошибка может встречаться в более сложных выражениях. Рассмотрим пример:
void Class::Foo(const std::string &FileName)
{
if (FileName.empty())
return;
std::string FullName = m_Dir + std::string("\\") + FullName;
...
}Из-за опечатки в выражении случайно используется имя FullName, а не FileName. Корректный вариант кода:
std::string FullName = m_Dir + std::string("\\") + FileName;Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V573. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, переменная используется одновременно как указатель на один объект и как массив.
Рассмотрим пример ошибки, которую анализатор нашёл сам в себе:
TypeInfo *factArgumentsTypeInfo =
new (GC_QuickAlloc) TypeInfo[factArgumentsCount];
for (size_t i = 0; i != factArgumentsCount; ++i)
{
Typeof(factArguments[i], factArgumentsTypeInfo[i]);
factArgumentsTypeInfo->Normalize();
}Подозрительно, что с переменной factArgumentsTypeInfo мы работаем как с массивом "factArgumentsTypeInfo[i]" и как с указателем на один объект "factArgumentsTypeInfo ->". На самом деле необходимо вызвать функцию Normalize() для всех элементов. Исправленный вариант кода:
TypeInfo *factArgumentsTypeInfo =
new (GC_QuickAlloc) TypeInfo[factArgumentsCount];
for (size_t i = 0; i != factArgumentsCount; ++i)
{
Typeof(factArguments[i], factArgumentsTypeInfo[i]);
factArgumentsTypeInfo[i].Normalize();
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V574. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в качестве фактического аргумента в функцию передаётся очень странное значение.
Рассмотрим пример:
bool Matrix4::operator==(const Matrix4 &other) const
{
if (memcmp(this, &other, sizeof(Matrix4) == 0))
return true;
....
}Здесь мы имеем дело с опечаткой. Круглая скобка поставлена не там, где нужно. К сожалению, это плохо заметно, и такая ошибка может очень долго присутствовать в коде. Из-за опечатки размер сравниваемой памяти вычисляется выражением sizeof(Matrix4) == 0. Так как результат выражение false, то сравнивается ноль байт памяти. Корректный вариант:
bool Matrix4::operator==(const Matrix4 &other) const
{
if (memcmp(this, &other, sizeof(Matrix4)) == 0)
return true;
....
}Другой пример. Диагностическое правило определяет случаи, когда массив, состоящий из элементов enum, заполняется с помощью функции memset. При этом подразумевается, что размер элемента не равен одному байту. Такое заполнение будет некорректным, т.к. в этом случае значением заполнится каждый байт, а не каждый элемент массива.
Некорректный код:
enum E { V0, V1, V2, V3, V4 };
E array[123];
memset(array, V1, sizeof(array));Если компилятор сделает размер каждого элемента равным, например, 4 байта, то все элементы массива будут равны значению 0x01010101, а вовсе не 0x00000001 (V1), как ожидает программист.
Корректный код для заполнения массива:
for (size_t i = 0; i < sizeof(array) / sizeof(array[0]); ++i)
{
array[i] = V1;
}Или:
std::fill(begin(array), end(array), V1);Примечание. NULL - странный аргумент.
Иногда программисты пытаются вычислить, сколько требуется выделить памяти под буфер, используя код вот такого типа:
const char* format = getLocalizedString(id, resource);
int len = ::vsprintf(NULL, format, args);
char* buf = (char*) alloca(len);
::vsprintf(buf, format, args);Учтите, что вызов ::vsprintf(NULL, format, args) некорректен. Вот что про это сказано в MSDN:
int vsprintf(*buffer, char *format, va_list argptr);
....vsprintf and vswprintf return the number of characters written, not including the terminating null character, or a negative value if an output error occurs. If buffer or format is a null pointer, these functions invoke the invalid parameter handler, as described in Parameter Validation. If execution is allowed to continue, these functions return -1 and set errno to EINVAL.
Есть несколько вариантов дополнительной настройки данного диагностического правила.
Диагностическое правило учитывает информацию, может ли тот или иной указатель быть нулевым. В ряде случаев, эта информация берется из таблиц разметки функций, которые находятся внутри самого анализатора.
Примером может служить функция malloc. Эта функция может вернуть нулевой указатель. Соответственно, использование указателя, который вернула функция malloc, без предварительной проверки может привести к разыменованию нулевого указателя.
Иногда у наших пользователей возникает желание изменить поведение анализатора и заставить его считать, что, например, функция malloc не может вернуть нулевой указатель. Пользователь может использовать системные библиотеки, в которых ситуации нехватки памяти обрабатываются особым образом.
Также может возникнуть желание подсказать анализатору, что определённая функция может вернуть нулевой указатель.
В этом случае вы можете воспользоваться дополнительными настройками, которые описаны в разделе "Как указать анализатору, что функция может или не может возвращать nullptr".
Если функция принимает в качестве параметров границы некоторого диапазона, то можно разметить соответствующие параметры как верхнюю и нижнюю границу. Это даст анализатору дополнительную информацию, которая поможет найти нарушения предусловий функции (например, значение нижней границы больше, чем верхней).
Чтобы разметить параметры как нижнюю и верхнюю границы, необходимо воспользоваться механизмом пользовательских аннотаций в формате JSON и атрибутами lower_bound и upper_bound соответственно. Также, если есть параметр, значение которого проверяется на вхождение в диапазон, его нужно разметить как in_range_value (если такого параметра нет, то достаточно разметить только нижнюю и верхнюю границы).
Пример. Есть функция, семантически схожая с std::clamp, со следующей сигнатурой:
bool foo(int v, int lo, int hi);Эта функция проверяет, что значение первого параметра лежит в диапазоне, переданном в качестве второго (нижняя граница) и третьего (верхняя граница) параметров.
Предположим, что есть следующий вызов данной функции:
if (foo(x, 100, 0))
{
....
}Как мы видим, в вызове перепутаны местами аргументы для нижней и верхней границы. Тогда, чтобы получить срабатывание в месте вызова функции, необходимо разметить первый параметр функции foo как in_range_value, второй как lower_bound, а третий как upper_bound.
Исправленный код:
if (foo(x, 0, 100))
{
....
}Примеры разметки параметров функций можно посмотреть здесь.
Примечание. Данная разметка необходима только для пользовательских функций.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java], Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти), Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java], Ошибки использования неинициализированных переменных, Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V575. |
Анализатор обнаружил потенциальную ошибку при использовании функций форматного вывода ('printf', 'sprintf', 'wprintf' и так далее). Строка форматирования не соответствует передаваемым в функцию фактическим аргументам.
Рассмотрим простой пример:
int A = 10;
double B = 20.0;
printf("%i %i\n", A, B);Согласно строке форматирования, функция 'printf' ожидает два фактических аргумента типа 'int'. Однако второй аргумент имеет значение типа 'double'. Подобное несоответствие приводит к неопределённому поведению программы. Например, к распечатке бессмысленных значений.
Корректный вариант:
int A = 10;
double B = 20.0;
printf("%i %f\n", A, B);Ошибочных вариантов использования функции 'printf' можно привести огромное количество. Рассмотрим только несколько типовых примеров, которые чаще всего можно встретить в программах.
Распечатка адреса
Очень часто значение указателя пытаются распечатать, используя следующий код:
int *ptr = new int[100];
printf("0x%0.8X\n", ptr);Этот код ошибочен, поскольку будет работать только в тех системах, где размер указателя совпадает с размером типа 'int'. А, например, в Win64 этот код уже распечатает только младшую часть указателя 'ptr'. Корректный вариант кода:
int *ptr = new int[100];
printf("0x%p\n", ptr);Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в качестве фактического аргумента в функцию передаётся очень странное значение.
Неиспользуемые аргументы
Часто в программах можно встретить вызов функций, где часть аргументов не используется. Пример:
int nDOW;
#define KEY_ENABLED "Enabled"
...
wsprintf(cDowKey, L"EnableDOW%d", nDOW, KEY_ENABLED);Очевидно, что параметр 'KEY_ENABLED' здесь лишний, или код должен был выглядеть следующим образом:
wsprintf(cDowKey, L"EnableDOW%d%s", nDOW, KEY_ENABLED);Недостаточное количество аргументов
Намного более опасной ситуацией является, когда в функцию передаётся меньше аргументов, чем необходимо. Это может легко привести к ошибке доступа к памяти, переполнению буфера или распечатке мусора. Рассмотрим пример функции выделения памяти, взятой из одной реальной программы:
char* salloc(register int nbytes)
{
register char* p;
p = (char*) malloc((unsigned)nbytes);
if (p == (char *)NULL)
{
fprintf(stderr, "%s: out of memory\n");
exit(1);
}
return (p);
}Если функция 'malloc' вернёт значение 'NULL', то программа не сможет корректно сообщить о нехватке памяти и завершить свою работу. Она аварийно завершится или распечатает непонятный текст. В любом случае, подобное поведение усложнит анализ причины неработоспособности программы.
Путаница с signed/unsigned
Очень часто программисты используют спецификатор печати знаковых значений (например '%i') для печати переменных типа 'unsigned'. И наоборот. Эта ошибка, как правило, не критична и так сильно распространена, что в анализаторе она имеет низкий приоритет. Во многих случаях подобный код успешно работает и даёт сбой только при больших или отрицательных значениях. Рассмотрим код, который хотя не корректен, но успешно работает:
int A = 10;
printf("A = %u\n", A);
for (unsigned i = 0; i != 5; ++i)
printf("i = %d\n", i);Хотя здесь имеется несоответствие, это код на практике печатает корректные значения. Конечно, всё равно так лучше не делать и написать корректно:
int A = 10;
printf("A = %d\n", A);
for (unsigned i = 0; i != 5; ++i)
printf("i = %u\n", i);Ошибка проявит себя в том случае, если в программе имеются большие или отрицательные значения. Пример:
int A = -1;
printf("A = %u", A);Вместо строки "A = -1" программа распечатает "A = 4294967295". Корректный вариант:
printf("A = %i", A);Широкие строки (Wide character string)
У Visual Studio есть неприятная особенность, что он нестандартно интерпретирует формат строки для печати широких символов. В результате анализатор помогает диагностировать ошибку, например, в таком коде:
const wchar_t *p = L"abcdef";
wprintf(L"%S", p);В Visual C++ считается, что '%S' предназначен для печати строки типа 'const char *'. Поэтому с точки зрения Visual C++ правильным является код:
wprintf(L"%s", p);Начиная с Visual Studio 2015 предлагается решение этой проблемы, чтобы писать переносимый код. Для совместимости с ISO C (C99) следует указать препроцессору макрос _CRT_STDIO_ISO_WIDE_SPECIFIERS.
В этом случае, код:
const wchar_t *p = L"abcdef";
wprintf(L"%S", p);является правильным.
Анализатор знает про '_CRT_STDIO_ISO_WIDE_SPECIFIERS' и учитывает его при анализе.
Кстати, если вы включили режим совместимости с ISO C (объявлен макрос '_CRT_STDIO_ISO_WIDE_SPECIFIERS'), вы можете в отдельных местах вернуть старое приведение, используя спецификатор формата '%Ts'.
Вся эта история с широкими символами достаточно запутанная и выходит за пределы документации. Чтобы лучше разобраться в вопросе, предлагаем ознакомиться со следующими ссылками:
Дополнительная настройка диагностики
Чтобы самостоятельно указать имена своих собственных функций, для которых следует выполнять проверку формата, можно использовать пользовательские аннотации. Подробнее об этом можно почитать здесь.
Дополнительные ресурсы:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования форматной строки, Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V576. |
Анализатор обнаружил потенциальную ошибку внутри оператора switch. Используется метка с именем похожим на 'default'. Возможно это опечатка.
Рассмотрим пример:
int c = 10;
int r = 0;
switch(c){
case 1:
r = 3; break;
case 2:
r = 7; break;
defalt:
r = 8; break;
}Кажется после того, как этот код отработает, значение переменной 'r' будет 8. Но на самом деле значение 'r' останется равно нулю. Дело в том, что "defalt" это метка, а не оператор "default". Исправленный вариант кода:
int c = 10;
int r = 0;
switch(c){
case 1:
r = 3; break;
case 2:
r = 7; break;
default:
r = 8; break;
}Эта диагностика срабатывает также, когда имя метки начинается с "case". Есть вероятность, что пропущен пробел. Например, вместо метки "case1:", должно быть написано "case 1:".
Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку в выражении, работающем с битами. Часть выражения не имеет смысла или является избыточным. Как правило, такие ошибки возникают из-за опечатки.
Рассмотрим пример:
if (up & (PARAMETER_DPDU | PARAMETER_DPDU | PARAMETER_NG))Здесь два раза используется константа PARAMETER_DPDU. В корректном коде должны использоваться две разных константы: PARAMETER_DPDU и PARAMETER_DPDV. Буква 'U' похожа на 'V' поэтому и возникла такая опечатка. Исправленный вариант:
if (up & (PARAMETER_DPDU | PARAMETER_DPDV | PARAMETER_NG))Другой пример. Здесь ошибки нет, но код избыточен:
if (((pfds[i].dwFlags & pPFD->dwFlags) & pPFD->dwFlags)
!= pPFD->dwFlags)Сокращенный вариант:
if ((pfds[i].dwFlags & pPFD->dwFlags) != pPFD->dwFlags)Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V578. |
Анализатор обнаружил в коде подозрительный вызов функции. В качестве аргументов в функцию передается указатель и размер этого указателя. На самом деле, разработчики часто хотят передать в функцию не размер указателя, а размер буфера.
Рассмотрим, как подобная ошибка может возникнуть в коде. Предположим, в начале имелся код следующего вида:
char buf[100];
...
memset(buf, 0, sizeof(buf));Код корректен. Функция memset() очищает массив из 100 байт. Затем, код изменился, и буфер стал переменного размера. Код очистки буфера изменить забыли:
char *buf = new char[N];
...
memset(buf, 0, sizeof(buf));Теперь код некорректен. Оператор sizeof() возвращает размер указателя, а не размер буфера с данными. Как результат, функция memset() очищает только часть массива.
Рассмотрим другой пример, взятый из реального приложения:
apr_size_t ap_regerror(int errcode,
const ap_regex_t *preg, char *errbuf,
apr_size_t errbuf_size)
{
...
apr_snprintf(errbuf, sizeof errbuf,
"%s%s%-6d", message, addmessage,
(int)preg->re_erroffset);
...
}В таком коде заметить ошибку непросто. Функция apr_snprintf() принимает в качестве аргумента указатель 'errbuf' и размер этого указателя 'sizeof errbuf'. Анализатор считает этот код подозрительным и абсолютно прав. Размер буфера находится в переменной 'errbuf_size' и именно эту переменную следует использовать. Корректный код:
apr_snprintf(errbuf, errbuf_size,
"%s%s%-6d", message, addmessage,
(int)preg->re_erroffset);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V579. |
Анализатор обнаружил подозрительное явное приведение типа. Это может быть ошибкой или потенциальной ошибкой.
Рассмотрим пример:
DWORD errCode = 0;
void* dwErrParams[MAX_MESSAGE_PARAMS];
dwErrParams[0] = *((void**)&errCode);Код содержит 64-битную ошибку. Тип 'DWORD' превращается в тип 'void *' . Этот код некорректно работает в 64-битных системах, где размер указателя не совпадает с размером типа DWORD. Корректный вариант:
DWORD_PTR errCode = 0;
void* dwErrParams[MAX_MESSAGE_PARAMS];
dwErrParams[0] = (void *)errCode;Диагностическое правило классифицируется как:
|
Анализатор обнаружил код, в котором рядом находятся два оператора 'if' с одинаковыми условиями. Это является потенциальной ошибкой или избыточным кодом.
Рассмотрим пример:
if (strlen(S_1) == SIZE)
Foo(A);
if (strlen(S_1) == SIZE)
Foo(B);Содержит этот код ошибку или нет, зависит от того, что хотел сделать программист. Если во втором условии нужно вычислить длину другой строки, то это ошибка. Исправленный код:
if (strlen(S_1) == SIZE)
Foo(A);
if (strlen(S_2) == SIZE)
Foo(B);Код может быть корректен. Но тогда он неэффективен, так как два раза приходится вычислять длину одной и той же строки. Оптимизированный код:
if (strlen(S_1) == SIZE) {
Foo(A);
Foo(B);
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V581. |
Анализатор обнаружил потенциальную ошибку при работе с контейнером фиксированного размера. Эту диагностику нам предложил реализовать один из наших пользователей. Вот как он сформулировал задачу.
Для работы с массивами константного размера мы используем следующий шаблонный класс:
template<class T_, int numElements > class idArray
{
public:
int Num() const { return numElements; };
.....
inline const T_ & operator[]( int index ) const {
idassert( index >= 0 );
idassert( index < numElements );
return ptr[index];
};
inline T_ & operator[]( int index ) {
idassert( index >= 0 );
idassert( index < numElements );
return ptr[index];
};
private:
T_ ptr[numElements];
};Класс позволяет обнаружить ошибки выхода за пределы массива при запуске DEBUG версии. При этом производительность RELESE версии не снижается. Пример некорректного кода:
idArray<int, 1024> newArray;
newArray[-1] = 0;
newArray[1024] = 0;Ошибки будут обнаружены при запуске отладочной версии. Однако хочется иметь возможность обнаруживать подобные ошибки с помощью статического анализа ещё на этапе компиляции.
Для выявления подобных ошибочных ситуаций и предназначена диагностика V582. Если в программе используется класс, реализующий функциональность контейнера фиксированного размера, то анализатор пытается проверить, что индекс не выходит за его границу. Пример диагностики:
idArray<float, 16> ArrA;
idArray<float, 8> ArrB;
for (size_t i = 0; i != 16; i++)
ArrA[i] = 1.0f;
for (size_t i = 0; i != 16; i++)
ArrB[i] = 1.0f;Здесь анализатор выдаст предупреждение:
V582 Consider reviewing the source code which operates the 'ArrB' container. The value of the index belongs to the range: [0..15].
Ошибка в том, что оба цикла обрабатывают 16 элементов, хотя второй массив содержит только 8 элементов. Корректный вариант:
for (size_t i = 0; i != 16; i++)
ArrA[i] = 1.0f;
for (size_t i = 0; i != 8; i++)
ArrB[i] = 1.0f;Следует отметить, что передача слишком больших или маленьких индексов не всегда означает ошибку в программе. Например, оператор [] может быть реализован следующим образом:
inline T_ & operator[]( int index ) {
if (index < 0) index = 0;
if (index >= numElements) index = numElements - 1;
return ptr[index];
};Если вы используете подобные классы и получаете много ложных срабатываний, то очевидно вам следует отключить диагностику V582.
Примечание. Анализатор не обладает искусственным интеллектом и поэтому его возможности поиска дефектов при работе с контейнерами ограничены. Мы работаем над усовершенствованием алгоритмов, поэтому если вы заметили явные ложные срабатывания или наоборот ситуации, в которых анализатор не выдал предупреждение, просим написать нам и прислать соответствующий пример кода.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку при использовании тернарного оператора "?:". Независимо от условия, будет выполнено одно и тоже действие. Скорее всего, в коде имеется опечатка.
Рассмотрим самый простой пример:
int A = B ? C : C;В любом случае переменной A будет присвоено значение переменной C.
Рассмотрим, как подобная ошибка может выглядеть в коде реального приложения:
fovRadius[0] =
tan(DEG2RAD((rollAngleClamped % 2 == 0 ?
cg.refdef.fov_x : cg.refdef.fov_x) * 0.52)) * sdist;Здесь код отформатирован. В тексте программы это одна строка, и не удивительно, что легко просмотреть опечатку. Ошибка заключается, что два раза используется член структуры "fov_x". Корректный вариант:
fovRadius[0] =
tan(DEG2RAD((rollAngleClamped % 2 == 0 ?
cg.refdef.fov_x : cg.refdef.fov_y) * 0.52)) * sdist;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V583. |
Анализатор обнаружил выражение, которое можно упростить. С большой вероятностью это выражение содержит опечатку.
Рассмотрим пример:
float SizeZ;
if (SizeZ + 1 < SizeZ)Анализатор считает, что это условие содержит ошибку, так как не имеет практического смысла. Скорее всего, хотелось выполнить совсем другую проверку. Корректный код:
if (SizeZ + 1 < maxSizeZ)Конечно, иногда программисты используют приемы, которые корректны, но выглядят странно. Анализатор по возможности старается распознать такие ситуации и не выдавать диагностические сообщения. Например, анализатор считает безопасными следующие проверки:
//Тест на переполнение при суммировании
int a, b;
if (a + b < a)
//Проверка, что X не равен 0, +бесконечность или -бесконечность.
double X;
if (X * 0.5f != X)Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V584. |
Анализатор обнаружил попытку освободить память, занятую локальной переменной. Подобные ошибки могут возникать в ходе неаккуратного рефакторинга или опечатки.
Рассмотрим пример некорректного кода:
void Foo()
{
int *p;
...
free(&p);
}Корректный код:
void Foo()
{
int *p;
...
free(p);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку повторного освобождения какого-то ресурса. При определённых обстоятельствах этот код может стать дефектом безопасности.
Ресурсом может быть память, файл или, например, объект HBRUSH.
Рассмотрим пример некорректного кода:
float *p1 = (float *)malloc(N * sizeof(float));
float *p2 = (float *)malloc(K * sizeof(float));
...
free(p1);
free(p1);В тексте программы имеется опечатка, из-за которой дважды освобождается одна и та же область памяти. Последствия выполнения такого кода предсказать сложно. Возможно, программа аварийно завершит свою работу. Или, возможно, продолжит свою работу, но возникнет утечка памяти (memory leak).
Более того, подобный код является дефектом безопасности и может привести к возникновению уязвимости. Например, уязвимости подвержена функция 'malloc' ('dmalloc') Дуга Ли (Doug Lea), которая используется в некоторых библиотеках как 'malloc' по умолчанию. Для возникновения уязвимости, связанной с двойным освобождением памяти, требуется несколько условий: блоки памяти, смежные с освобождаемым, не должны быть свободны, а список свободных блоков памяти должен быть пуст. В этом случае возможно создание эксплойта. Несмотря на то что подобные уязвимости сложно использовать из-за необходимости специфичной конфигурации памяти, существуют реальные примеры уязвимого кода, который был успешно взломан.
Корректный вариант:
float *p1 = (float *)malloc(N * sizeof(float));
float *p2 = (float *)malloc(K * sizeof(float));
...
free(p1);
free(p2);Иногда ошибка двойного освобождения ресурсов не является опасной:
vector<unsigned> m_arrStack;
...
m_arrStack.clear();
m_arrBlock.clear();
m_arrStack.clear();Случайно два раза очищаем массив. Код работает правильно, но его всё равно следует посмотреть и поправить. В процессе его изучения может выясниться, что забыли очистить другой массив.
Корректный вариант:
vector<unsigned> m_arrStack;
...
m_arrStack.clear();
m_arrBlock.clear();Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V586. |
Анализатор обнаружил потенциальную ошибку, связанную с бессмысленным взаимным присваиванием переменных.
Рассмотрим пример:
int A, B, C;
...
A = B;
C = 10;
B = A;Здесь присваивание "B = A" не имеет никакого практического смысла. Возможно, это опечатка или просто лишнее действие. Корректный вариант кода:
A = B;
C = 10;
B = A_2;Рассмотренный выше пример был искусственным. Рассмотрим, как эта ошибка может выглядеть в коде реального приложения:
// Swap; exercises counters
{
RCPFooRef temp = f2;
f2 = f3;
f3 = f2;
}Корректный вариант:
// Swap; exercises counters
{
RCPFooRef temp = f2;
f2 = f3;
f3 = temp;
}Взгляните на примеры ошибок, обнаруженных с помощью диагностики V587. |
Анализатор обнаружил потенциальную ошибку, так как в программе имеется последовательность символов '=+'. Возможно, это опечатка и следует использовать оператор '+='.
Рассмотрим пример:
size_t size, delta;
...
size=+delta;Этот код может быть корректен. Но с большой вероятностью имеется опечатка и на самом деле, хотели использовать оператор '+='. Исправленный вариант:
size_t size, delta;
...
size+=delta;Если код корректен, то чтобы убрать предупреждение V588 можно удалить '+' или поставить дополнительный пробел. Вариант корректного кода, где предупреждение не выдается:
size = delta;
size = +delta;Примечание. Для поиска опечаток вида 'A =- B' используется диагностическая проверка V589. Эта проверка сделана отдельно, так как возможно большое количество ложных срабатываний, и может возникнуть желание отключить её.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V588. |
Анализатор обнаружил потенциальную ошибку, так как в программе имеется последовательность символов '=-'. Возможно, это опечатка и следует использовать оператор '-='.
Рассмотрим пример:
size_t size, delta;
...
size =- delta;Этот код может быть корректен. Но с большой вероятностью имеется опечатка и на самом деле, хотели использовать оператор '-='. Исправленный вариант:
size_t size, delta;
...
size -= delta;Если код корректен, то чтобы убрать предупреждение V589 можно использовать дополнительный пробел между символами '=' и '-'. Вариант корректного кода, где предупреждение не выдается:
size = -delta;Чтобы уменьшить количество ложных срабатываний, для правила V589 действует ряд специфичных исключений. Например, анализатор не будет выдавать предупреждение, если программист не использует пробелов между переменными и операторами. Ряд примеров, код которых анализатор считает безопасным:
A=-B;
int Z =- 1;
N =- N;Примечание. Для поиска опечаток вида 'A =+ B' используется диагностическая проверка V588.
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку, так как в коде имеется избыточное сравнение.
Поясним на простом примере:
if (Aa[42] == 10 && Aa[42] != 3)Условие будет выполнено в том случае, если 'Aa[42] == 10'. Вторая часть выражения бессмысленна. Проанализировав код, можно прийти к одному из двух выводов:
1) Выражение можно упросить. Исправленный код:
if (Aa[42] == 10)2) Выражение содержит ошибку. Исправленный код:
if (Aa[42] == 10 && Aa[43] != 3)Рассмотрим практический пример. Здесь ошибки нет, но выражение избыточно, что может затруднять чтение кода:
while (*pBuff == ' ' && *pBuff != '\0')
pBuff++;Проверка " *pBuff != '\0' " не имеет смысла. Сокращенный вариант кода:
while (*pBuff == ' ')
pBuff++;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V590. |
Анализатор обнаружил non-void функцию, для которой существует путь исполнения, не возвращающий значение. Вызов такой функции ведёт к неопределённому поведению.
Если при исполнении тела non-void функции достигнут конец её тела без 'return', то произойдёт неопределённое поведение.
Рассмотрим пример:
int GetSign(int arg)
{
if (arg > 0)
{
return 1;
}
else if (arg < 0)
{
return -1;
}
}Если в функцию 'GetSign' передать 0, то произойдёт неопределённое поведение. Исправленный вариант:
int GetSign(int arg)
{
if (arg > 0)
{
return 1;
}
else if (arg < 0)
{
return -1;
}
return 0;
}Исключением из правила являются функции 'main' и 'wmain'. Для этих функций достижение конца тела эквивалентно выполнению конструкции 'return 0;', поэтому неопределённого поведения не будет. Рассмотрим такой пример:
....
int main()
{
AnalyzeFile(FILE_NAME);
}В данном случае имеем дело с функцией 'main'. Здесь не будет неопределённого поведения. Соответственно, не будет и выдано предупреждение анализатора. Фрагмент кода эквивалентен следующему:
....
int main()
{
AnalyzeFile(FILE_NAME);
return 0;
}Заметим, что неопределённое поведение происходит, только если конец non-void функции действительно достигнут. В частности, если на пути исполнения тела такой функции произошёл бросок исключения, которое не было перехвачено в теле этой же функции, то неопределённого поведения не будет.
Анализатор не выдаст предупреждение на следующем фрагменте кода:
int Calc(int arg);
int Bar(int arg)
{
if (arg > 0)
{
return Calc(arg);
}
throw std::logic_error { "bad arg was passed to Bar" };
}Также неопределённого поведения не будет, если в ходе выполнения тела такой функции произошел вызов другой функции, которая не возвращает управление. Такие функции обычно помечают '[[noreturn]]'. Поэтому анализатор не выдаст предупреждение на следующем примере:
[[noreturn]] void exit(int exit_code);
int Foo()
{
....
exit(10);
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V591. |
Анализатор обнаружил двойные круглые скобки вокруг выражения. Есть вероятность, что одна из скобок поставлена не там, где надо.
Хочется подчеркнуть, что анализатор не ищет фрагменты кода, где два раза повторяются круглые скобки. Например, анализатор считает проверку "if ((A = B))" безопасной. Здесь дополнительные скобки используются, чтобы подавить предупреждения некоторых компиляторов. В этом выражении невозможно расставить скобки так, чтобы возникла ошибка.
Анализатор пытается обнаружить те ситуации, когда изменив местонахождение одной скобки, можно изменить смысл выражения. Рассмотрим пример:
if((!osx||howmanylevels))Этот код подозрителен. Непонятно, зачем здесь дополнительные круглые скобки. Возможно, выражение должно выглядеть так:
if(!(osx||howmanylevels))Если даже выражение корректно, то всё равно лучше убрать лишние круглые скобки. На это есть две причины.
1) Человек читающий код, может усомниться в его корректности, увидев дублирующиеся круглые скобки.
2) Если убрать лишние скобки, то анализатор перестанет выдавать ложное предупреждение.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V592. |
Анализатор обнаружил потенциальную ошибку в выражении, которое, скорее всего, работает не так, как задумывал программист. Данный тип ошибок чаще всего можно встретить в выражениях, где одновременно проверяется результат работы функции и выполняется присваивание.
Рассмотрим простой пример:
if (handle = Foo() != -1)Создавая такой код, программист, как правило, хочет выполнить действия в следующем порядке:
if ((handle = Foo()) != -1)
Но приоритет оператора '!=' выше, чем приоритет оператора '='. Поэтому выражение вычистится так:
if (handle = (Foo() != -1))
Чтобы исправить ошибку, можно использовать скобки. Ещё лучше не жадничать на количестве строк кода. Текст вашей программы станет более читабелен, если написать так:
handle = Foo();
if (handle != -1)Рассмотрим, как подобная ошибка может выглядеть на практике:
if (hr = AVIFileGetStream(pfileSilence,
&paviSilence, typeAUDIO, 0) != AVIERR_OK)
{
ErrMsg("Unable to load silence stream");
return hr;
}Проверка в коде, что произошла ошибка, работает корректно и будет выдано сообщение "Unable to load silence stream". Беда в том, что переменная 'hr' будет хранить не код ошибки, а значение 1. Исправленный вариант кода:
if ((hr = AVIFileGetStream(pfileSilence,
&paviSilence, typeAUDIO, 0)) != AVIERR_OK)
{
ErrMsg("Unable to load silence stream");
return hr;
}Анализатор не всегда выдает предупреждения, обнаруживая конструкцию вида "if (x = a == b)". Например, анализатор понимает, что данный код безопасен:
char *from;
char *to;
bool result;
...
if (result = from == to)
{}Примечание. Если анализатор все-таки выдал ложное предупреждение, то есть два способа устранить его:
1) Добавить дополнительные скобки. Пример: "if (x = (a == b))".
2) Использовать комментарий для подавления предупреждения. Пример: "if (x = a == b) //-V593".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V593. |
Анализатор обнаружил потенциальную ошибку при работе с указателями. В программе есть выражение, при вычислении которого получается, что указатель вышел за границу массива.
Проясним это простым примером:
int A[10];
fill(A, A + sizeof(A), 33);Мы хотим присвоить всем элементам массива значение 33. Ошибка в том, что указатель "A + sizeof(A)" ссылается далеко за пределы массива. В результате, мы изменим больше ячеек памяти, чем планировалось. Результат этой ошибки непредсказуем.
Правильный вариант кода:
int A[10];
fill(A, A + sizeof(A) / sizeof(A[0]), 33);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V594. |
Анализатор обнаружил потенциальную ошибку, которая может привести к разыменовыванию нулевого указателя.
Анализатор заметил в коде следующую ситуацию. В начале, указатель используется. А уже затем этот указатель проверяется на значение NULL. Это может означать одно из двух:
1) Возникнет ошибка, если указатель будет равен NULL.
2) Программа всегда работает корректно, так как указатель всегда не равен NULL. Проверка является лишней.
Рассмотрим первый вариант. Ошибка есть.
buf = Foo();
pos = buf->pos;
if (!buf) return -1;Если указатель 'buf' окажется равен NULL, то выражение 'buf->pos ' приведёт к ошибке. Анализатор выдаст предупреждение на этот код, указав 2 строки. Первая строка - это то место, где используется указатель. Вторая строка - это то место, где указатель сравнивается со значением NULL.
Исправленный вариант кода:
buf = Foo();
if (!buf) return -1;
pos = buf->pos;Рассмотрим второй вариант. Ошибки нет.
void F(MyClass *p)
{
if (!IsOkPtr(p))
return;
printf("%s", p->Foo());
if (p) p->Clear();
}Этот код всегда работает корректно. Указатель всегда не равен NULL. Однако анализатор не разобрался в этой ситуации и выдал предупреждение. Чтобы оно исчезло, следует удалить проверку "if (p)". Она не имеет практического смысла и только может запутать программиста, читающего код.
Исправленный вариант:
void F(MyClass *p)
{
if (!IsOkPtr(p))
return;
printf("%s", p->Foo());
p->Clear();
}В случае если анализатор ошибается, то кроме изменения кода, можно использовать комментарий для подавления предупреждений. Пример: "p->Foo(); //-V595".
Примечание N1.
Некоторые пользователи сообщают, что анализатор выдает предупреждение V595 на корректный код, Пример:
static int Foo(int *dst, int *src)
{
*dst = *src; // V595 !
if (src == 0)
return 0;
return Foo(dst, src);
}
...
int a = 1, b = 2;
int c = Foo(&a, &b);Да, здесь анализатор выдает ложное срабатывание. Код корректен и указатель 'src' не может быть равен NULL в тот момент, когда выполняется присваивание "*dst = *src". Возможно, в дальнейшем мы реализуем исключение для подобных случаев, но пока не спешим это делать. Хотя здесь нет ошибки, анализатор выявил избыточность кода. Функцию можно сократить. При этом пропадет предупреждение V595, а код станет проще.
Улучшенный вариант:
int Foo(int *dst, int *src)
{
assert(dst && src);
*dst = *src;
return Foo(dst, src);
}Примечание N2.
Иногда в программах можно встретить код следующего вида:
int *x=&p->m_x; //V595
if (p==NULL) return(OV_EINVAL);Вычисляется указатель на член класса. Этот указатель не разыменовывается и кажется, что анализатор зря выдаёт диагностическое сообщение V595. Однако, этот код приводит к неопределённому поведению. Если программа работает, это везение и не более того. Нельзя вычислять выражение, если "&p->m_x", если указатель 'p' равен нулю.
С аналогичной ситуацией программист может встретиться, желая отсортировать массив:
int array[10];
std::sort(&array[0], &array[10]); // Undefined behaviorИспользование &array[10] приводит к неопределенному поведению, так как элемент array[10] уже лежит за границами массива. Но использование арифметики указателей вполне допустимо. Можно обратиться к указателю, который адресует конечный элемент массива. Поэтому, необходимо написать следующий корректный код:
int array[10];
std::sort(array, array+10); //okВыявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V595. |
Анализатор обнаружил потенциальную ошибку, связанную с использованием класса std::exception или наследуемого от него класса. Анализатор выдает предупреждение в том случае, если создается объект типа std::exception / CException, но не используется.
Пример:
if (name.empty())
std::logic_error("Name mustn't be empty");Ошибка заключается в том, что случайно забыто ключевое слово 'throw'. В результате данный код не генерирует исключение в случае ошибочной ситуации. Исправленный вариант кода:
if (name.empty())
throw std::logic_error("Name mustn't be empty");Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V596. |
Анализатор обнаружил потенциальную ошибку, когда массив, содержащий приватную информацию, не будет очищен.
Рассмотрим пример кода.
void Foo()
{
char password[MAX_PASSWORD_LEN];
InputPassword(password);
ProcessPassword(password);
memset(password, 0, sizeof(password));
}Функция на стеке создает временный буфер, предназначенный для хранения пароля. По окончанию работы с паролем, мы хотим очистить этот буфер. Если это не сделать, пароль останется в памяти, что может привести к неприятным последствиям. На эту тему есть хорошая статья "Перезаписывать память - зачем?".
К сожалению, приведенный код может оставить буфер неочищенным. Обратите внимание, что массив 'password' очищается в конце и более не используется. Поэтому при сборке Release версии программы, компилятор, скорее всего, удалит вызов функции memset(). На это компилятор имеет полное право. Такое изменение не влияет на наблюдаемое поведение, которое описано в Стандарте как последовательность вызова функций ввода-вывода и чтения-записи volatile данных. То есть с точки зрения языка Си/Си++, если удалить вызов функции memset(), это ничего не изменит!
Для очистки буферов содержащих приватную информацию необходимо использовать специальную функцию RtlSecureZeroMemory или memset_s (см. также статью "Безопасная очистка приватных данных").
Исправленный вариант кода:
void Foo()
{
char password[MAX_PASSWORD_LEN];
InputPassword(password);
ProcessPassword(password);
RtlSecureZeroMemory(password, sizeof(password));
}Кажется, что на практике, компилятор не может удалить вызов такой важной функции memset(). Может возникнуть впечатление, что речь идет о редких экзотических компиляторах. Нет, это не так. Возьмем для примера компилятор Visual C++ 10, входящий в состав Visual Studio 2010.
Рассмотрим две функции.
void F1()
{
TCHAR buf[100];
_stprintf(buf, _T("Test: %d"), 123);
MessageBox(NULL, buf, NULL, MB_OK);
memset(buf, 0, sizeof(buf));
}
void F2()
{
TCHAR buf[100];
_stprintf(buf, _T("Test: %d"), 123);
MessageBox(NULL, buf, NULL, MB_OK);
RtlSecureZeroMemory(buf, sizeof(buf));
}Функции отличаются тем, как они очищают буфер. Первая использует функцию memset(), а вторая RtlSecureZeroMemory(). Скомпилируем оптимизированный код, указав для компилятора Visual C++ 10 ключ "/O2". Рассмотрим получившийся ассемблерный код:
Рисунок 1. Функция memset() удалена.
Рисунок 2. Функция RtlSecureZeroMemory() заполняет память нулями.
Как видно в ассемблерном коде, вызов функции memset() был удалён компилятором при оптимизации. В отличии от memset(), вызов функции RtlSecureZeroMemory() сохранился, поэтому в этом случае массив успешно обнуляется.
Дополнительные ссылки:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V597. |
Анализатор обнаружил, что для работы с объектом класса используются такие низкоуровневые функции, как 'memset', 'memcpy', 'memmove', 'memcmp', 'memchr'. Это недопустимо, если класс содержит указатель на таблицу виртуальных функций (vtable).
Если указатель на объект передается в качестве целевого функциям 'memset', 'memcpy' или 'memmove', то они могут испортить vtable. Если указатель передается в качестве источника функциям 'memcpy' или 'memmove', то результат такого копирования может быть непредсказуемым. В случае с функциями 'memcmp' и 'memchr' сравнение или поиск при наличии vtable также может привести к нежелательному результату.
Рассмотрим пример кода:
class MyClass
{
public:
MyClass();
virtual ~MyClass();
private:
int A, B, C;
char buf[100];
};
MyClass::MyClass()
{
memset(this, 0, sizeof(*this));
}Обратите внимание, что в классе есть виртуальный деструктор. Это значит, что в классе присутствует vtable. Программист поленился очищать члены класса по отдельности. Для очистки он использовал функцию 'memset'. Это привет к порче vtable, так как функция 'memset' ничего про него не знает.
Корректный код:
MyClass::MyClass() : A(0), B(0), C(0)
{
memset(buf, 0, sizeof(buf));
}Начиная с C++11, можно переписать этот код следующим образом, если требуется инициализировать поля нулями:
class MyClass
{
public:
MyClass() = default;
virtual ~MyClass() = default;
private:
int A = {}, B = {}, C = {};
char buf[100] = {};
};Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V598. |
Анализатор обнаружил потенциальную ошибку, связанную с отсутствием в базовом классе виртуального деструктора.
Чтобы анализатор выдал предупреждение V599 необходимо, чтобы выполнились следующие условия:
delete.Наличие виртуальных функций говорит о том, что класс могут использовать полиморфно. В этом случае виртуальный деструктор необходим, чтобы корректно разрушить объект.
Рассмотрим пример кода.
class Father
{
public:
Father() { .... }
~Father() { .... }
virtual void Foo() { .... }
};
class Son : public Father
{
public:
int *buffer;
Son() : Father() { buffer = new int[1024]; }
~Son() { delete[] buffer; }
virtual void Foo() { .... }
};
....
Father *object = new Son();
delete object; // Calls object->~Father(),
// not object->~Son()!!Нижеприведённый код является некорректным и приводит к утечке памяти. В момент уничтожения объекта (delete object;) вызывается только деструктор в классе Father. Чтобы вызвать деструктор класса 'Son' необходимо сделать деструктор виртуальным.
Корректный код:
class Father
{
public:
Father() { .... }
virtual ~Father() { .... }
virtual void Foo() { .... }
};Диагностическое правило V599 помогает выявить далеко не все проблемы, связанные с отсутствием виртуальных деструкторов. Приведем соответствующий пример: "Вы разрабатываете библиотеку. В ней есть класс XXX, в котором есть виртуальные функции, но нет виртуального деструктора. Вы в библиотеке сами не работаете с этим классом, и анализатор не предупредит об опасности. Проблема может возникнуть у программиста, использующего вашу библиотеку и наследующего свои классы от класса XXX."
Намного больше проблем позволяют выявлять предупреждения компиляторов, например, C4265 в MSVC и Wdelete-non-virtual-dtor в GCC/Clang. Это очень полезные предупреждения, но по умолчанию они выключены. Возможная причина: они дают много срабатываний в коде, где используется паттерн примесь (подмешивание, mixin). При использовании этого паттерна возникает множество интерфейсных классов. Они содержат виртуальные функции, но виртуальный деструктор в них не нужен.
Можно сказать, что диагностическое правило V599 является частным случаем описанных ранее предупреждений компиляторов. Оно дает меньше ложных срабатываний, но, к сожалению, позволяет выявить меньшее количество дефектов. Если вы хотите провести более тщательный анализ своего кода, то включите предупреждение C4265.
P.S. К сожалению, всегда объявлять деструктор виртуальным не является идеальной практикой программирования. Это приводит к дополнительным накладным расходам, так как в классе появляется указатель на таблицу виртуальных методов.
P.P.S. Родственным диагностическим правилом является V689.
Дополнительная информация:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java], Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V599. |
Анализатор обнаружил сравнение адреса массива с нулем. Такое сравнение не имеет смысла и может говорить о наличии ошибки в программе.
Рассмотрим пример кода.
void Foo()
{
short T_IND[8][13];
...
if (T_IND[1][j]==0 && T_IND[5]!=0)
T_buf[top[0]]= top[1]*T_IND[6][j];
...
}Программа обрабатывает двумерный массив. Код сложен для чтения и ошибка на первый взгляд не заметна. Однако анализатор предупредит, что сравнение "T_IND[5]!=0" не имеет смысла. Указатель "T_IND[5]" всегда не равен нулю.
Изучив предупреждения V600 можно найти ошибки, которые, как правило, связаны с опечатками. Например, может оказаться, что данный код должен выглядеть так:
if (T_IND[1][j]==0 && T_IND[5][j]!=0)Предупреждение V600 далеко не всегда означает наличие настоящей ошибки. Часто причиной появления V600 является неаккуратный рефакторинг. Рассмотрим наиболее распространенный случай. В начале код выглядел так:
int *p = (int *)malloc(sizeof(int) *ARRAY_SIZE);
...
if (!p)
return false;
...
free(p);Код менялся. Стало ясно, что значение ARRAY_SIZE небольшое и массив можно создавать на стеке. В результате получился следующий код:
int p[ARRAY_SIZE];
...
if (!p)
return false;
...Здесь выдается предупреждение V600. Однако код корректно работает. Просто получилось, что поверка "if (!p)" потеряла смысл и её можно удалить.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V600. |
Анализатор обнаружил подозрительное неявное приведение типа. Такое приведение типа может говорить о наличии ошибки или о неаккуратности в коде.
Рассмотрим первый пример.
std::string str;
bool bstr;
...
str = true;Любой программист удивится, увидев как переменной типа 'std::string' присваивают значение 'true'. Однако это вполне допустимая и работающая конструкция. Здесь программист просто ошибся и написал в коде не ту переменную.
Корректный вариант кода:
std::string str;
bool bstr;
...
bstr = true;Рассмотрим второй пример:
bool Ret(int *p)
{
if (!p)
return "p1";
...
}Строковый литерал "p1" превращается в значение 'true' и возвращается из функции. Это очень странный код.
Общие рекомендации по правке подобного кода дать сложно и каждый случай надо рассматривать отдельно.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V601. |
Анализатор обнаружил потенциальную ошибку, которая может возникнуть из-за опечатки. Высока вероятность, что в выражении вместо оператора '<' должен использоваться оператор '<<'.
Рассмотрим пример кода.
void Foo(unsigned nXNegYNegZNeg, unsigned nXNegYNegZPos,
unsigned nXNegYPosZNeg, unsigned nXNegYPosZPos)
{
unsigned m_nIVSampleDirBitmask =
(1 << nXNegYNegZNeg) | (1 < nXNegYNegZPos) |
(1 << nXNegYPosZNeg) | (1 << nXNegYPosZPos);
...
}Код содержит ошибку, так как случайно в выражении написан оператор '<'. Корректный вариант кода должен выглядеть так:
unsigned m_nIVSampleDirBitmask =
(1 << nXNegYNegZNeg) | (1 << nXNegYNegZPos) |
(1 << nXNegYPosZNeg) | (1 << nXNegYPosZPos);Примечание.
Анализатор считает подозрительными сравнения ('<', '>'), если полученный результат используется в двоичных операциях, таких как '&', '|' или '^'. Диагностика устроена более сложно, но надеемся, что общая идея понятна. Найдя такие выражения, анализатор выдает предупреждение V602.
Если анализатор выдает ложное срабатывание, то вы можете подавить его, используя комментарий "//-V602". Но чаще всего, этот код лучше переписать. С выражениями, которые имеют тип 'bool' лучше не работать, используя двоичные операторы. Это делает код неочевидным и затрудняет его чтение.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V602. |
Анализатор обнаружил потенциальную ошибку, связанную с неправильным использованием конструктора. Программисты часто ошибаются, пытаясь явно вызвать конструктор для инициализации объекта.
Рассмотрим типичный пример, взятый из реального приложения:
class CSlideBarGroup
{
public:
CSlideBarGroup(CString strName, INT iIconIndex,
CListBoxST* pListBox);
CSlideBarGroup(CSlideBarGroup& Group);
...
};
CSlideBarGroup::CSlideBarGroup(CSlideBarGroup& Group)
{
CSlideBarGroup(Group.GetName(), Group.GetIconIndex(),
Group.GetListBox());
}В классе есть два конструктора. Для сокращения размера исходного кода программист решил вызвать один конструктор из другого, но этот код делает совсем не то, что ожидает разработчик.
Создаётся новый неименованный объект типа CSlideBarGroup и тут же разрушается. В результате поля класса остаются неинициализированными.
Правильным вариантом будет создать функцию инициализации и вызывать её из конструкторов. Корректный код:
class CSlideBarGroup
{
void Init(CString strName, INT iIconIndex,
CListBoxST* pListBox);
public:
CSlideBarGroup(CString strName, INT iIconIndex,
CListBoxST* pListBox)
{
Init(strName, iIconIndex, pListBox);
}
CSlideBarGroup(CSlideBarGroup& Group)
{
Init(Group.GetName(), Group.GetIconIndex(),
Group.GetListBox());
}
...
};Если требуется вызвать именно конструктор, то это можно записать следующим образом:
CSlideBarGroup::CSlideBarGroup(CSlideBarGroup& Group)
{
this->CSlideBarGroup::CSlideBarGroup(
Group.GetName(), Group.GetIconIndex(), Group.GetListBox());
}Другой аналогичный вариант:
CSlideBarGroup::CSlideBarGroup(CSlideBarGroup& Group)
{
new (this) CSlideBarGroup(
Group.GetName(), Group.GetIconIndex(),
Group.GetListBox());
}Приведённые примеры являются очень опасным кодом, и нужно хорошо понимать, как они работают!
Такой код приносит больше вреда, чем пользы. Рассмотрим пример, где такой вызов конструктора допустим, а где нет.
class SomeClass
{
int x,y;
public:
SomeClass() { SomeClass(0,0); }
SomeClass(int xx, int yy) : x(xx), y(yy) {}
};Код содержит ошибку. В конструкторе SomeClass() создаётся временный объект. В результате поля x и y остаются неинициализированными. Исправить код можно так:
class SomeClass
{
int x,y;
public:
SomeClass() { new (this) SomeClass(0,0); }
SomeClass(int xx, int yy) : x(xx), y(yy) {}
};Код безопасен и работает, так как класс содержит простые типы данных и не наследуется от других классов. В этом случае двойной вызов конструктора ничем не грозит.
Рассмотрим другой код, где явный вызов конструктора приводит к ошибке:
class Base
{
public:
char *ptr;
std::vector vect;
Base() { ptr = new char[1000]; }
~Base() { delete [] ptr; }
};
class Derived : Base
{
Derived(Foo foo) { }
Derived(Bar bar) {
new (this) Derived(bar.foo);
}
}Когда вызывается конструктор new (this) Derived(bar.foo);, объект Base уже создан и поля инициализированы. Повторный вызов конструктора приведёт к двойной инициализации. В ptr записывается указатель на вновь выделенный участок памяти. Результатом будет утечка памяти. Сложно предсказать, к чему приведёт двойная инициализация объекта типа std::vector, но такой код недопустим.
Вместо явного вызова конструктора рекомендуется создание функции инициализации. Явный вызов конструктора требуется только в крайне редких случаях.
Новый стандарт позволяет вызывать одни конструкторы класса из других (так называемая делегация). Это даёт возможность писать конструкторы, использующие поведение других конструкторов без внесения дублирующего кода.
Пример корректного кода:
class MyClass {
int m_x;
public:
MyClass(int X) : m_x(X) {}
MyClass() : MyClass(33) {}
};Конструктор MyClass без аргументов вызывает конструктор того же класса с целочисленным аргументом.
В C++03 объект считается до конца созданным, когда его конструктор завершает выполнение. В C++11 после выполнения хотя бы одного делегирующего конструктора остальные конструкторы будут работать уже над полностью сконструированным объектом. Несмотря на это объекты производного класса начнут конструироваться только после выполнения всех конструкторов базовых классов.
Дополнительная информация
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V603. |
Анализатор обнаружил потенциальную ошибку в конструкции, образующий цикл. Цикл подозрителен тем, что количество итераций, которое он выполняет, равно sizeof(указатель). Высока вероятность, что количество итераций должно соответствовать размеру массива, на который ссылается указатель.
Рассмотрим, как может возникнуть подобная ошибка. В начале, программа выглядела так:
char A[N];
for (size_t i=0; i < sizeof(A); ++i)
A[i] = 0;Затем, код программы менялся и массив 'A' стал иметь переменный размер. Код стал некорректен:
char *A = (char *)malloc(N);
for (size_t i=0; i < sizeof(A); ++i)
A[i] = 0;Теперь выражение "sizeof(A)" возвращает размер указателя, а не размер массива.
Корректный вариант кода:
char *A = (char *)malloc(N);
for (size_t i=0; i < N; ++i)
A[i] = 0;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V604. |
Анализатор обнаружил потенциальную ошибку в выражении, где беззнаковая переменная сравнивается с отрицательным числом. Это достаточно редкая ситуация и не всегда такое сравнение является ошибкой. Однако предупреждение V605, это хороший повод, чтобы посмотреть и проверить код.
Пример кода, где будет выдано предупреждение V605:
unsigned u = ...;
if (u < -1)
{ ... }Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V605. |
Анализатор обнаружил потенциальную ошибку, найдя в коде лишнюю лексему. Чаще всего, такие "потерянные" лексемы появляются в коде, когда забыли написать ключевое слово return.
Рассмотрим пример:
bool Run(int *p)
{
if (p == NULL)
false;
...
}Здесь случайно забыли написать "return". Код компилируется, но не имеет практического смысла.
Исправленный вариант:
bool Run(int *p)
{
if (p == NULL)
return false;
...
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V606. |
Анализатор обнаружил в коде потенциально бессмысленное выражение. Обычно такие конструкции возникают, когда результаты работы переменных, вызовов методов, операторов и т. д. нигде не используются. Такие ситуации могут быть следствием неаккуратного рефакторинга кода.
Рассмотрим пример:
void Run(int &a, int b, int c, bool X)
{
if (X)
a = b + c;
else
b - c;
}Из-за опечатки текст программы не закончен. Код компилируется, но не имеет практического смысла.
Исправленный вариант:
void Run(int &a, int b, int c, bool X)
{
if (X)
a = b + c;
else
a = b - c;
}Рассмотрим другой пример:
typedef struct data_format {
int day;
int month;
};В данном фрагменте ключевое слово typedef использовано некорректно, поскольку для объявляемого типа не задано имя псевдонима, из-за чего оно не выполняет своей основной функции и является избыточным.
Правильный вариант:
typedef struct data_format {
int day;
int month;
} data_format_t; //< = Добавили название для typedefСуществуют исключения, когда анализатор не станет срабатывать на избыточные конструкции, например, при намеренном подавлении предупреждения компилятора о неиспользуемых переменных:
void Foo(int a, int b)
{
a, b;
}Здесь анализатор не выдаст предупреждение V607.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V607. |
Анализатор обнаружил повторяющиеся последовательности, состоящие из операторов явного приведения типов. Как правило, подобный код появляется из-за опечаток и не приводит к возникновению ошибок. Однако разумно проверить фрагменты кода, где анализатор выдает предупреждение V608. Возможно, ошибка всё-таки есть. Или, по крайней мере, код можно упростить.
Рассмотрим пример:
m_hIcon = AfxGetApp()->LoadStandardIcon(
MAKEINTRESOURCE(IDI_ASTERISK));Анализатор выдаст предупреждение: V608 "Recurring sequence of explicit type casts: (LPSTR)(ULONG_PTR)(WORD) (LPSTR)(ULONG_PTR)(WORD)."
Давайте разберемся, откуда взялись две цепочки "(LPSTR)(ULONG_PTR)(WORD)".
Константное значение IDI_ASTERISK представляет собой макрос вида:
#define IDI_ASTERISK MAKEINTRESOURCE(32516)Это значит, что приведенный выше код эквивалентен этому:
m_hIcon = AfxGetApp()->LoadStandardIcon(
MAKEINTRESOURCE(MAKEINTRESOURCE(32516)));Макрос MAKEINTRESOURCE разворачивается в (LPSTR)((DWORD)((WORD)(i))). В результате получается следующая последовательность:
m_hIcon = AfxGetApp()->LoadStandardIcon(
(LPSTR)((DWORD)((WORD)((LPSTR)((DWORD)((WORD)((32516))))))
);Этот код будет корректно работать, но он избыточен. Код можно переписать без лишних приведений типов:
m_hIcon = AfxGetApp()->LoadStandardIcon(IDI_ASTERISK);Диагностическое правило классифицируется как:
Анализатор обнаружил ситуацию, когда может произойти деление на ноль.
Рассмотрим пример:
for (int i = -10; i != 10; ++i)
{
Foo(X / i);
}В процессе выполнения цикла, переменная 'i' примет значение, равное 0. В этот момент произойдёт деление на 0. Чтобы исправить ситуацию, необходимо специально обработать случай, когда итератор 'i' равен нулю.
Исправленный вариант:
for (int i = -10; i != 10; ++i)
{
if (i != 0)
Foo(X / i);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки деления на ноль [* см. примечание касательно языков C#, Java], Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V609. |
Анализатор обнаружил операцию сдвига, которая приводит к неопределенному или к неуточненному поведению (undefined behaviour/unspecified behavior).
Стандарт Си++11 описывает работу операторов сдвига следующим образом:
"The shift operators << and >> group left-to-right.
shift-expression << additive-expression
shift-expression >> additive-expression
The operands shall be of integral or unscoped enumeration type and integral promotions are performed.
1. The type of the result is that of the promoted left operand. The behavior is undefined if the right operand is negative, or greater than or equal to the length in bits of the promoted left operand.
2. The value of E1 << E2 is E1 left-shifted E2 bit positions; vacated bits are zero-filled. If E1 has an unsigned type, the value of the result is E1 * 2^E2, reduced modulo one more than the maximum value representable in the result type. Otherwise, if E1 has a signed type and non-negative value, and E1*2^E2 is representable in the result type, then that is the resulting value; otherwise, the behavior is undefined.
3. The value of E1 >> E2 is E1 right-shifted E2 bit positions. If E1 has an unsigned type or if E1 has a signed type and a non-negative value, the value of the result is the integral part of the quotient of E1/2^E2. If E1 has a signed type and a negative value, the resulting value is implementation-defined."
Приведем примеры, которые приводят к undefined или unspecified behavior:
int A = 1;
int B;
B = A << -3; // undefined behavior
B = A << 100; // undefined behavior
B = -1 << 5; // undefined behavior
B = -1 >> 5; // unspecified behaviorКонечно, это упрощенные примеры. В реальных программах ситуации сложнее. Рассмотрим практический пример:
SZ_RESULT
SafeReadDirectUInt64(ISzInStream *inStream, UInt64 *value)
{
int i;
*value = 0;
for (i = 0; i < 8; i++)
{
Byte b;
RINOK(SafeReadDirectByte(inStream, &b));
*value |= ((UInt32)b << (8 * i));
}
return SZ_OK;
}Функция пытается побайтно прочитать 64-битное значение. К сожалению, у неё это не получится, если число было больше 0x00000000FFFFFFFF. Обратите внимание на сдвиг "(UInt32)b << (8 * i)". Размер левого операнда составляет 32 бита. При этом сдвиг происходит от 0 до 56 бит. На практике это приведёт к тому, что старшая часть 64-битного значения останется заполнена нулями. Теоретически здесь вообще имеет место неопределенное поведение и результат непредсказуем.
Корректный код должен выглядеть так:
*value |= ((UInt64)b << (8 * i));Чтобы получить больше информации по рассмотренному вопросу предлагаю познакомиться со статьёй "Не зная брода, не лезь в воду. Часть третья".
Рассмотрим более подробно ситуацию, когда левый операнд отрицателен. Как правило, создаётся впечатление, что такой код всегда работает правильно. Можно подумать, что хотя это неопределённое поведение (undefined behavior), фактически все компиляторы ведут себя одинаковым образом. Это не так. Правильнее говорить, что большинство компиляторов ведут себя одинаковым образом. Если вас заботит переносимость кода, вы не должны использовать сдвиги отрицательных значений.
Подкрепим свои слова примером. Неожиданный результат можно получить, используя компилятор GCC для микропроцессора MSP430. Здесь описывается подобная ситуация. Хотя программист заявляет, что это ошибка компилятора, фактически мы имеем тот самый случай, когда компилятор ведёт себя по-другому.
Тем не менее, мы понимаем желание программистов отключить предупреждение для случаев, когда левый операнд отрицателен. Для этого можно вписать где-то в текст программы специальный комментарий:
//-V610_LEFT_SIGN_OFFЭтот комментарий следует вписать в заголовочный файл, который включается во все другие файлы. Например, таким файлом может быть "stdafx.h". Если вписать этот комментарий в "*.cpp" файл, то он будет действовать только для этого файла.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел, Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V610. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что память может выделятьcя и освобождаться несовместимыми между собой способами.
Например, анализатор предупредит, если память выделена с помощью оператора 'new', а освобождается с помощью функции 'free'.
Рассмотрим пример некорректного кода:
int *p = (int *)malloc(sizeof(int) * N);
...
...
delete [] p;Исправленный вариант:
int *p = (int *)malloc(sizeof(int) * N);
...
...
free(p);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V611. |
Анализатор обнаружил подозрительный цикл. В теле цикла используется один из следующих операторов: break, continue, return, goto. Эти операторы выполняются всегда, без каких либо условий.
Рассмотрим соответствующие примеры:
do {
X();
break;
} while (Foo();)
for (i = 0; i < 10; i++) {
continue;
Foo();
}
for (i = 0; i < 10; i++) {
x = x + 1;
return;
}
while (*p != 0) {
x += *p++;
goto endloop;
}
endloop:Показанные выше примеры циклов конечно искусственны и малоинтересны. Давайте рассмотрим фрагмент кода, найденный в одном из настоящих приложений. Для большей наглядности код функции сокращён.
int DvdRead(....)
{
....
for (i=lsn; i<(lsn+sectors); i++){
....
// switch (mode->datapattern){
// case CdSecS2064:
((u32*)buf)[0] = i + 0x30000;
memcpy_fast((u8*)buf+12, buff, 2048);
buf = (char*)buf + 2064; break;
// default:
// return 0;
// }
}
....
}Часть строк в функции закомментировано. Беда в том, что забыли закомментировать оператор "break".
Когда комментариев не было, "break" был внутри тела "switch". Когда "switch" закомментировали, оператор "break" стал досрочно завершать цикл. В результате тело цикла выполняется только один раз.
Корректный вариант кода:
buf = (char*)buf + 2064; // break;Следует отметить, что диагностическое правило V612 достаточно сложно. Учитывается множество ситуаций, когда использование оператора break/continue/return/goto совершенно корректно. Рассмотрим для примера несколько ситуаций, когда предупреждение V612 выводиться не будет.
1) Наличие условия.
while (*p != 0) {
if (Foo(p))
break;
}2) Специальные приёмы, как правило, используемые в макросах:
do { Foo(x); return 1; } while(0);3) Обход оператора 'continue' с помощью 'goto':
for (i = 0; i < 10; i++) {
if (x == 7) goto skipcontinue;
continue;
skipcontinue: Foo(x);
}Возможны и другие приёмы, которые используются на практике, но про которые мы не знаем. Если вы заметили, что анализатор выдаёт ложное предупреждение V612, просим написать нам и прислать соответствующие примеры. Мы изучим их и постараемся реализовать исключения для подобных случаев.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V612. |
Анализатор обнаружил потенциальную ошибку в коде, выделяющем память. Указатель, который возвращается функцией 'malloc' или аналогичной ей, складывается с каким-то числом. Это очень подозрительно и высока вероятность, что в коде имеется опечатка.
Рассмотрим пример:
a = ((int *)(malloc(sizeof(int)*(3+5)))+2);В выражении много лишних скобок и вероятно программист в них запутался. Давайте упростим этот код для наглядности:
a = (int *)malloc(sizeof(int)*8);
a += 2;Очень странно, прибавлять к указателю число 2. Даже если так надо и код правильный, он очень опасен. Например, очень легко забыть, что освобождать память надо так: "free(a - 2);".
Корректный вариант кода:
a = (int *)malloc(sizeof(int)*(3+5+2));Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил использование неинициализированной переменной. Использование неинициализированной переменной приводит к непредсказуемым результатам. Опасность подобных дефектов заключается в том, что они могут не проявляться годами, пока благодаря удачному стечению обстоятельств в неинициализированных переменных оказываются подходящие значения.
Рассмотрим простейший пример:
int Aa = Get();
int Ab;
if (Ab) // Ab - uninitialized variable
Ab = Foo();
else
Ab = 0;Будет или нет вызвана функция Foo(), зависит от стечения различных обстоятельств. Как правило, ошибки использования неинициализированных переменных, возникают из-за опечаток. Например, может оказаться, что в этом месте следовало использовать другую переменную. Корректный вариант кода:
int Aa = Get();
int Ab;
if (Aa) // OK
Ab = Foo();
else
Ab = 0;Предупреждение V614 выдается не только при использовании простых типов. Анализатор может выдавать предупреждение для переменных типа класс, которые имеют конструктор и, по сути, являются инициализированными. Однако их использование без предварительного присваивания не имеет смысла. Примером таких классов являются умные указатели и итераторы.
Рассмотрим примеры:
std::auto_ptr<CLASS> ptr;
UsePtr(ptr);
std::list<T>::iterator it;
*it = X;Корректный вариант кода:
std::auto_ptr<CLASS> ptr(Get());
UsePtr(ptr);
std::list<T>::iterator it;
it = Get();
*it = X;Бывает, что анализатор выдаёт ложные сообщения V614. Но иногда в этом виноват сам программист, написавший коварный код. Рассмотрим пример кода, взятый из реального приложения:
virtual size_t _fread(const void *ptr, size_t bytes){
size_t ret = ::fread((void*)ptr, 1, bytes, fp);
if(ret < bytes)
failbit = true;
return ret;
}
int read32le(uint32 *Bufo, EMUFILE *fp)
{
uint32 buf;
if(fp->_fread(&buf,4)<4) // False alarm: V614
return 0;
....
}Обратите внимание, что буфер, куда читаются данные из файла, объявлен как "const void *ptr". Чтобы код компилировался, используется явное приведение указателя к типу "(void*)". Неизвестно, что побудило программиста написать такой код. Бессмысленный квалификатор "const" путает анализатор. Анализатор считает, что функция _fread() будет использовать переменную 'buf' только для чтения. Так как переменная 'buf' не инициализирована, анализатор выдаёт предупреждение.
Этот код работает. Однако его нельзя назвать хорошим. Рационально будет его переписать. Во-первых, код станет короче и понятней. Во-вторых, исчезнет предупреждение V614.
Исправленный вариант кода:
virtual size_t _fread(void *ptr, size_t bytes){
size_t ret = ::fread(ptr, 1, bytes, fp);
if(ret < bytes)
failbit = true;
return ret;
}Есть ещё одна ситуация, когда предупреждение V614 может показаться ложным. Рассмотрим следующий синтетический пример:
std::shared_ptr<foo> GetFoo()
{
std::shared_ptr<foo> Bar;
return Bar; // V614
}Здесь создается умный указатель 'Bar' типа 'std::shared_ptr', для которого будет вызван конструктор по умолчанию. Поэтому 'Bar' всегда будет инициализирован 'nullptr'. Анализатор считает опасным использование умных указателей, созданных конструктором по умолчанию. Тем не менее, такой код имеет право на жизнь. Есть несколько способов убрать подобные предупреждения анализатора.
Можно поправить код следующим образом:
std::shared_ptr<foo> GetFoo()
{
std::shared_ptr<foo> Bar { nullptr };
return Bar; // no V614
}Такой код лучше читается, потому что теперь сразу понятно, что функция 'GetFoo' возвращает объект типа 'std::shared_ptr', содержащий нулевой указатель. В этом случае ревьюверу будет более очевидно, что предполагается именно нулевой указатель. Такая запись также является знаком анализатору, что программист знает, что он делает, и нулевой указатель возвращается осознанно, а не по ошибке.
Однако, если анализатор выдал на вашем коде много подобных предупреждений, и вы не хотите их видеть, то можно воспользоваться специальным комментарием:
//-V614_IGNORE_SMART_POINTERSЭтот комментарий следует вписать в заголовочный файл, который включается во все другие файлы. Например, таким файлом может быть "stdafx.h". Если вписать этот комментарий в "*.с" или "*.cpp" файл, то он будет действовать только для этого файла.
В ином случае можно воспользоваться механизмом подавления ложных срабатываний.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V614. |
Анализатор обнаружил подозрительное приведение типов указателей. Подобными подозрительными ситуациями является, когда указатель на float пытаются привести к указателю на double или наоборот. Дело в том, что типы float и double имеют различный размер и подобное приведение типов, скорее всего, свидетельствует об ошибке.
Рассмотрим простейший пример:
float *A;
double* B = (double*)(A);Несоответствие размеров приводимых типов приведет к тому, что 'B' будет указывать на некорректный для типа double формат числа. Такие ошибки приведения типов указателей возникают из-за опечаток или невнимательности. Например, может оказаться, что в этом месте следует использовать другой тип данных или другой указатель.
Корректный вариант кода:
double *A;
double* B = A;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V615. |
Анализатор обнаружил использование нулевой константы в битовой операции И ( & ). Результатом такого выражения всегда будет нулевое значение. Это может привести к неправильной логике работы программы, если такое выражение используется в условиях или циклах.
Рассмотрим простейший пример:
enum { FirstValue, SecondValue };
int Flags = GetFlags();
if (Flags & FirstValue)
{...}Выражения в условии оператора 'if' всегда равно нулю. Это приводит к неверной логике выполнения программы. Как правило, ошибки использования нулевых констант в битовых операциях, возникают из-за опечаток или некорректного объявления констант. Например, может оказаться, что в этом месте следовало использовать другую константу. Корректный вариант кода:
enum { FirstValue, SecondValue };
int Flags = GetFlags();
if (Flags & SecondValue)
{...}Так же корректным может быть вариант, когда константа будет объявлена ненулевой. Пример кода:
enum { FirstValue = 1, SecondValue };
int Flags = GetFlags();
if (Flags & FirstValue)
{...}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V616. |
Анализатор обнаружил использование ненулевой константы в битовой операции ИЛИ ( | ). Результатом такого выражения всегда будет ненулевое значение. Это может привести к неправильной логике работы программы, если данное выражение будет использоваться в условиях или циклах.
Рассмотрим простейший пример:
enum { FirstValue, SecondValue };
int Flags = GetFlags();
if (Flags | SecondValue)
{...}Выражение в условии оператора 'if' всегда истинно. Как правило, ошибки использования ненулевых констант в битовых операциях, возникают из-за опечаток. Например, может оказаться, что в этом месте следовало использовать другую битовую операцию, например И ( & ). Корректный вариант кода:
enum { FirstValue, SecondValue };
int Flags = GetFlags();
if (Flags & SecondValue)
{...}Рассмотрим пример кода, найденный анализатором в реальном приложении:
#define PSP_HIDEHEADER 0x00000800
BOOL CResizablePageEx::NeedsRefresh(....)
{
if (m_psp.dwFlags | PSP_HIDEHEADER)
return TRUE;
...
return
CResizableLayout::NeedsRefresh(layout, rectOld, rectNew);
}Очевидно, что оператор 'if' будет всегда выполнять ветку 'return TRUE;', что не корректно. Исправленный вариант кода:
#define PSP_HIDEHEADER 0x00000800
BOOL CResizablePageEx::NeedsRefresh(....)
{
if (m_psp.dwFlags & PSP_HIDEHEADER)
return TRUE;
...
return
CResizableLayout::NeedsRefresh(layout, rectOld, rectNew);
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V617. |
Анализатор обнаружил, что вызов функции форматного вывода может привести к некорректному результату. Более того, подобный код может стать объектом для атаки (подробнее см. эту статью).
Вывод строки осуществляется напрямую без использования спецификатора "%s". В результате, если в строке случайно или преднамеренно встретиться управляющий символ это приведёт к сбою в работе программы. Рассмотрим простейший пример:
char *p;
...
printf(p);Вызов функции printf(p) некорректен, поскольку отсутствует форматная строка вида "%s". Если в строке 'p' встретится спецификатор формата, то такой вывод скорее всего окажется некорректным. Безопасный вариант кода:
char *p;
...
printf ("%s", p);Предупреждение V618 может показаться несущественным. Но на самом деле это очень важный момент в создании качественных и надёжных программ.
Учтите, что совершенно неожиданно в строке вдруг могут встретиться спецификаторы формата (%i, %p и так далее). Это может произойти случайно, когда пользователь введёт некорректные входные данные. Это может произойти умышленно, когда некорректные данные будут поданы специально. Отсутствие спецификатора "%s" может привести к падению программы или в выводе куда-то приватных данных. Прежде чем отключить диагностику V618 ещё раз настаиваем на том, чтобы обязательно прочитать статью "Не зная брода, не лезь в воду. Часть вторая". Исправления в коде будут не так велики, чтобы проигнорировать данный вид дефекта.
Примечание. Анализатор старается не выдавать предупреждение V618, когда вызов функции не может привести к каким либо плохим последствиям. Пример, где анализатор не выдаёт предупреждение:
printf("Hello!");Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.), Ошибки использования форматной строки. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V618. |
Анализатор обнаружил, что к переменной, объявленной как массив данных, применяется оператор '->'. Подобный код может свидетельствовать о некорректном использовании структур данных, приводящее к неправильному заполнению полей структуры.
Рассмотрим пример некорректного кода:
struct Struct {
int r;
};
...
Struct ms[10];
for (int i = 0; i < 10; i++)
{
ms->r = 0;
...
}Такое использование некорректно, поскольку будет проинициализирован только первый элемент массива. Возможно, произошла опечатка или должна быть использована другая переменная. Корректный вариант кода:
Struct ms[10];
for (int i = 0; i < 10; i++)
{
ms[i].r = 0;
...
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V619. |
Анализатор обнаружил, что к переменной типа указатель прибавляется выражение, содержащее оператор sizeof(T). Такое использование может свидетельствовать о некорректной адресной арифметике.
Рассмотрим простейший пример:
int *p;
size_t N = 5;
...
p = p + sizeof(int)*N;Такое использование некорректно. Ожидается, что мы переместимся на N элементов структуры данных. Вместо этого происходит смещение на 20 элементов, поскольку sizeof(int) имеет значение 4 в 32-битных программах. В результате мы получим: "p = p + 20;". Возможно допущена опечатка или иная ошибка. Корректный вариант кода:
int *p;
size_t N = 5;
...
p = p + N;Примечание. Анализатор считает код корректным, если в нём работают с типом char. Рассмотрим пример, где анализатор не выдаёт предупреждение:
char *c;
size_t N = 5;
...
c = c + sizeof(float)*N;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V620. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в операторе 'for' используются странные начальное и конечное значения счетчика. Это может приводить к некорректному выполнению цикла и нарушению логики работы программы.
Рассмотрим пример:
signed char i;
for (i = -10; i < 100; i--)
{
...
};Возможно, произошла опечатка и перепутаны начальные и конечные значения. Так же ошибка может возникнуть, если перепутаны операторы '++' и '--'.
Корректный вариант кода:
for (i = -10; i < 100; i++)
{
...
};Также корректным будет следующий код:
for (i = 100; i > -10; i--)
{
...
};Рассмотрим код, найденный анализатором в реальном приложении:
void CertificateRequest::Build()
{
...
uint16 authCount = 0;
for (int j = 0; j < authCount; j++) {
int sz = REQUEST_HEADER + MIN_DIS_SIZE;
...
}
}Переменная 'authCount' инициализируется неправильным значением или здесь вообще должна быть использована другая переменная.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V621. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в блоке оператора 'switch' первым оператором не является оператор 'case'. Это приводит к тому, что фрагмент кода никогда не получит управление.
Рассмотрим пример:
char B = '0';
int I;
...
switch(I)
{
B = '1';
break;
case 2:
B = '2';
break;
default:
B = '3';
break;
}Присваивание "B = '1';" никогда не будет выполнено. Корректный вариант кода:
switch(I)
{
case 1:
B = '1';
break;
case 2:
B = '2';
break;
default:
B = '3';
break;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V622. |
Анализатор обнаружил возможную ошибку при работе с тернарным оператором '?:'. Если при работе с оператором '?:' совместно используются объект типа класс и любой другой тип, который может быть преобразован к данному классу, то создаются временные объекты. Временные объекты будут удалены по завершению оператора '?:'. Ошибка возникает, если мы при этом сохраняем результат в переменную типа указатель.
Рассмотрим пример:
CString s1(L"1");
wchar_t s2[] = L"2";
bool a = false;
...
const wchar_t *s = a ? s1 : s2;В результате выполнения этого кода переменная 's' будет указывать на данные, находящиеся внутри временного объекта. Беда в том, что этот объект уже уничтожен!
Корректный вариант кода:
wchar_t s1[] = L"1";
wchar_t s2[] = L"2";
bool a = false;
...
const wchar_t *s = a ? s1 : s2;Другой вариант корректного кода:
CString s1(L"1");
wchar_t s2[] = L"2";
bool a = false;
...
CString s = a ? s1 : s2;Предупреждение V623 требует со стороны программиста повышенного внимания. Беда в том, что ошибки данного типа хорошо прячутся. Код, содержащий подобные ошибки может успешно работать многие годы. Но это только иллюзия, что он работает. На самом деле используется освобождённая память. То, что в памяти находятся корректные данные - это только везение. Поведение программы может поменяться в любой момент. Это может произойти при смене версии компилятора. Это может произойти, после рефакторинга кода, когда появляется новый объект, использующий ту же область памяти. Рассмотрим это на примере.
Напишем, скомпилируем и запустим следующий код:
bool b = false;
CComBSTR A("ABCD");
wchar_t *ptr = b ? A : L"Test OK";
wcout << ptr << endl;Этот код мы скомпилировали с помощью Visual Studio 2010 и он распечатал "Test OK". Может показаться, что всё работает правильно. Но внесём в код небольшую правку:
bool b = false;
CComBSTR A("ABCD");
wchar_t *ptr = b ? A : L"Test OK";
wchar_t *tmp = b ? A : L"Error!";
wcout << ptr << endl;Кажется строчка, где инициализируется переменная 'tmp' ничего не изменит. Но это не так. Теперь программа печатает на экран: "Error!".
Дело в том, что новый временный объект использовал ту же области памяти, что и предыдущий. Кстати, следует учитывать, что данный код по стечению обстоятельств вполне может работать. Всё зависит от везения и фазы луны. Предугадать, где будут создаваться временные объекты невозможно. Поэтому не отказывайтесь от правки кода, основываясь на утверждении "этот код правильно работал несколько лет и значит, ошибки в нём нет".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V623. |
Анализатор обнаружил возможную ошибку при работе с константами типа double. Возможно, для математических расчетов используются константы недостаточной точности или константа записана с ошибкой.
Рассмотрим пример:
double pi = 3.141592654;Такая запись не совсем корректна и лучше использовать математические константы из заголовочного файла 'math.h'. Корректный вариант кода:
#include <math.h>
...
double pi = M_PI;Анализатор не считает ошибочной явную запись констант в формате 'float'. Это связано с тем, что тип 'float' имеет меньше значащих разрядов, по сравнению с типом 'double'. Пример кода:
float f = 3.14159f; //okДиагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V624. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в операторе 'for' совпадают начальное и конечное значения счетчика. Такое использование оператора 'for' приведет к тому, что цикл не будет выполнен ни разу или выполнен только один раз.
Рассмотрим пример:
void beginAndEndForCheck(size_t beginLine, size_t endLine)
{
for (size_t i = beginLine; i < beginLine; ++i)
{
...
}Тело цикла никогда не выполняется. Скорее всего, произошла опечатка и следует заменить "i < beginLine" на корректное выражение "i < endLine". Корректный вариант кода:
for (size_t i = beginLine; i < endLine; ++i)
{
...
}Другой пример:
for (size_t i = A; i <= A; ++i)
...Тело этого цикла будет выполнено только один раз. Скорее всего, это не то, что задумывал программист.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V625. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что вместо точки запятой ';' случайно написана запятая ','. Такая опечатка может привести к неправильной логике выполнения программы.
Рассмотрим пример:
int a;
int b;
...
if (a == 2)
a++,
b = a;В результате выражение "b = a;" будет выполняться только когда верно условие оператора 'if', скорее всего произошла опечатка и следует заменить ',' на ';'. Корректный вариант кода:
if (a == 2)
a++;
b = a;Анализатор не будет обнаруживать ошибку, если форматирование фрагмента кода отражает преднамеренное использовать оператор ','. Пример кода:
if (a == 2)
a++,
b = a;
if (a == 2)
a++, b = a;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V626. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что аргументом оператор 'sizeof' является макрос, раскрывающийся в число. Такое использование оператора может привести к выделению некорректного размера памяти и иным ошибкам.
Рассмотрим пример:
#define NPOINT 100
...
char *point = (char *)malloc(sizeof(NPOINT));В результате выполнения данного кода будет выделен недостаточный объем памяти. Корректный вариант кода:
#define NPOINT 100
...
char *point = (char *)malloc(NPOINT);Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V627. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что два последовательно идущих оператора 'if' оказались разделены закомментированной строкой. Высока вероятность, что неаккуратно был закомментирован фрагмент кода. Неаккуратность привела к тому, что существенно изменилась логика работы программы.
Рассмотрим пример:
if(!hwndTasEdit)
//hwndTasEdit = getTask()
if(hwndTasEdit)
{
...
}Программа потеряла смысл. Условие второго оператора 'if' никогда не выполняется. Корректный вариант кода:
//if(!hwndTasEdit)
//hwndTasEdit = getTask()
if(hwndTasEdit)
{
...
}Анализатор не выдает ошибки в коде, где форматирование кода соответствует преднамеренному использованию последовательно двух операторов 'if', разделенных строкой комментария. Пример кода:
if (Mail == ready)
// comment
if (findNewMail)
{
...
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V628. |
Анализатор обнаружил потенциальную ошибку в выражении, содержащем операцию сдвига. В программе выполняется сдвиг 32-битного значения. Затем полученный 32-битный результат явно или неявно преобразуется в 64-битный тип.
Рассмотрим пример некорректного кода:
unsigned __int64 X;
X = 1u << N;Данный код вызывает неопределенное поведение, если значение N больше 32. На практике это означает, что с помощью этого кода не получится записать в переменную 'X' значение более 0x80000000.
Код можно исправить, если тип левого аргумента будет 64-битным.
Исправленный вариант кода:
unsigned __int64 X;
X = 1ui64 << N;Обратите внимание, что диагностика V629 не относится к 64-битным ошибкам. Под 64-битными ошибками понимаются те ситуации, когда 32-битная версия программы работает корректно, а 64-битная некорректно.
Рассматриваемая здесь ситуация приводит к ошибке как в 32-битной, так и в 64-битной программе. Поэтому диагностика V629 относится к правилам общего назначения.
Анализатор не будет выдавать предупреждение, если результат выражения со сдвигом укладывается в 32-битный тип. Это означает, что значащие биты не потеряны и код корректен.
Пример безопасного кода:
char W = 7;
long long Q = W << 10;Этот код работает следующим образом. Вначале переменная 'W' расширяется до 32-битного типа 'int'. Затем происходит сдвиг и получается значение 0x00001C00. Это число помещается в 32-битный тип, а значит ошибки не возникнет. На последнем этапе это значение расширяется до 64-битного типа 'long long' и записывается в переменную 'Q'.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V629. |
Анализатор обнаружил потенциальную ошибку, связанную с использованием одной из функций динамического выделения памяти, такой как malloc, calloc, realloc. С выделенной памятью работают как с массивом объектов, имеющих конструктор или деструктор. При таком выделении памяти для класса не будет вызван конструктор. При освобождении памяти с помощью функции free не будет вызван деструктор. Это крайне подозрительно. Подобный код может привести к работе с неинициализированными переменными и другим ошибкам.
Рассмотрим пример некорректного кода:
class CL
{
int num;
public:
CL() : num(0) {...}
...
};
...
CL *pCL = (CL*)malloc(sizeof(CL) * 10);В результате переменная 'num' будет не инициализирована. Конечно, можно вызвать конструктор для каждого объекта "вручную", но более правильным будет использование оператора 'new'.
Исправленный вариант:
CL *pCL = new CL[10];Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V630. |
Анализатор обнаружил потенциальную ошибку при вызове функции, предназначенную для работы с файлами. В одном из фактических аргументов в функцию передаётся абсолютный путь до файла или директории. Такое использование функции является опасным, поскольку могут встретиться случаи, когда данного пути не будет существовать на компьютере пользователя.
Рассмотрим пример некорректного кода:
FILE *text = fopen("c:\\TEMP\\text.txt", "r");Более корректным будет вариант получения пути к файлу исходя из определенных условий.
Исправленный вариант кода:
string fullFilePath = GetFilePath() + "text.txt";
FILE *text = fopen(fullFilePath.c_str(), "r");Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V631. |
Анализатор обнаружил потенциальную ошибку, связанную с передачей подозрительного аргумента в функцию. В функцию был передан аргумент в формате числа с плавающей точкой, хотя ожидался целочисленный тип данных. Такое использование является некорректным, поскольку значение аргумента будет приведено к целочисленному типу.
Рассмотрим пример некорректного кода:
double buf[N];
...
memset(buf, 1.0, sizeof(buf));Программист планировал заполнить массив значениями '1.0'. Однако этот код заполнит массив мусором.
Второй аргумент функции 'memset' имеет целочисленный тип. Этот аргумент определяет, каким значением заполнить каждый байт массива.
Произойдет приведение '1.0' к целочисленному значению '1'. Массив данных 'buf' будет заполнен побайтно единичными значениями. Такой результат отличается от заполнения каждого элемента массива значением '1.0'.
Исправленный вариант кода:
double buf[N];
...
for (size_t i = 0; i != N; ++i)
buf[i] = 1.0;Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку. Возможно вместо оператора '=!' следует написать '!=' или '==!'. Подобные ошибки чаще всего возникают из-за опечатки.
Рассмотрим пример некорректного кода:
int A, B;
...
if (A =! B)
{
...
}С большой вероятностью здесь должна быть проверка, что переменная 'A' не равна 'B'. Если это так, то корректный вариант кода должен выглядеть следующим образом:
if (A != B)
{
...
}Анализатор учитывает форматирование в выражении. Поэтому если действительно требуется выполнить присваивание, а не сравнение, необходимо указать, используя скобки или пробелы. Следующие примеры кода считаются анализатором корректными:
if (A = !B)
...
if (A=(!B))
...Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку, связанную с тем, что операции сложения, вычитания, деления и умножения имеют более высокий приоритет, чем операции сдвига. Про это часто забывают. В результате выражение может давать совсем не тот результат, на который рассчитывал программист.
Рассмотрим пример некорректного кода:
int X = 1<<4 + 2;Скорее всего, программист ожидал, что результат сдвига '1' на '4' будет сложен с '2'. Но согласно приоритету операций в языке Си/Си++ вначале произойдет сложение, а уже потом сдвиг.
Можно порекомендовать во всех выражениях с редко используемыми вами операторами, писать скобки. Даже если скобки окажутся лишними, это не страшно. Зато код станет более легким для чтения и понимания и будет меньше подвержен ошибкам.
Корректный вариант кода:
int X = (1<<4) + 2;А как убрать ложное предупреждение, если действительно планировалась последовательность вычислений: сначала сложение, затем сдвиг?
Есть 3 варианта:
1) Самый плохой вариант. Можно использовать комментарий "//-V634" для подавления предупреждения в нужной строке.
int X = 1<<4 + 2; //-V6342) Можно добавить дополнительные скобки:
int X = 1<<(4 + 2);3) Можно уточнить ваши намерения, используя пробелы:
int X = 1 << 4+2;Дополнительные ресурсы:
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V634. |
Анализатор обнаружил потенциальную ошибку, связанную c выделением некорректного размера памяти для хранения строки в формате UNICODE.
Как правило, такая ошибка возникает, если для вычисления размера массива используется функция 'strlen' или 'wcslen'. Нередко полученное количество символов забывают умножить на sizeof(wchar_t). В результате в программе может возникнуть доступ за границу массива.
Рассмотрим пример некорректного кода:
wchar_t src[] = L"abc";
wchar_t *dst = (wchar_t *)malloc(wcslen(src) + 1);
wcscpy(dst, src);В данном случае будет выделено всего 4 байта памяти. Так как тип 'wchar_t' имеет размер 2 или 4 байта в зависимости от модели данных, этой памяти может не хватить. Для исправления ошибки требуется умножить выражение внутри 'malloc' на 'sizeof(wchar_t)'.
Корректный вариант кода:
wchar_t *dst =
(wchar_t *)malloc((wcslen(src) + 1) * sizeof(wchar_t));Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V635. |
В выражении присутствует операция умножения или деления целочисленных типов данных. Полученное значение неявно преобразуется к типу с плавающей точкой. Обнаружив такую ситуацию, анализатор предупреждает о наличии потенциальной ошибки, которая может привести к переполнению или к вычислению неточного результата.
Рассмотрим возможные ошибки на примерах.
Ситуация первая. Переполнение.
int LX = 1000;
int LY = 1000;
int LZ = 1000;
int Density = 10;
double Mass = LX * LY * LZ * Density;Мы хотим вычислить массу объекта, зная его плотность и размеры. Мы знаем, что результирующее значение может быть большим. Поэтому, переменная 'Mass' имеет тип 'double'. Однако этот код не учитывает, что перемножаются переменные типа 'int'. В результате, в правой части выражения произойдет целочисленное переполнение и результат будет некорректен.
Исправить ситуацию можно двумя способами. Можно изменить типы переменных:
double LX = 1000.0;
double LY = 1000.0;
double LZ = 1000.0;
double Density = 10.0;
double Mass = LX * LY * LZ * Density;Другой способ - это использовать явное приведение типов:
int LX = 1000;
int LY = 1000;
int LZ = 1000;
int Density = 10;
double Mass = (double)(LX) * LY * LZ * Density;Достаточно привести к типу 'double' только первую переменную. Поскольку операция умножения относится к лево-ассоциативным операторам, то вычисление будет происходить следующим образом: (((double)(LX) * LY) * LZ) * Density. В результате каждый из операндов перед умножением будет преобразовываться к типу 'double' и мы получим корректный результат.
P.S. Напомним, что вот так, делать неправильно: Mass = (double)(ConstMass) + LX * LY * LZ * Density. Выражение справа от оператора '=' будет иметь тип 'double'. Но перемножаться будут по-прежнему переменные типа 'int'.
Ситуация вторая. Потеря точности.
int totalTime = 1700;
int operationNum = 900;
double averageTime = totalTime / operationNum;Программист может ожидать, что переменная 'averageTime' будет иметь значение '1.888(8)', однако при выполнении программы будет получен результат равный '1.0'. Это происходит потому, что операция деления выполняется с целочисленными типами и только затем приводится к типу с плавающей точкой.
Как и в предыдущем случае, ошибку можно исправить 2 способами.
Первый способ - изменить типы переменных:
double totalTime = 1700;
double operationNum = 900;
double averageTime = totalTime / operationNum;Второй способ - использовать явное приведение типов.
int totalTime = 1700;
int operationNum = 900;
double averageTime = (double)(totalTime) / operationNum;Примечание
Естественно, в некоторых случаях нужно произвести именно целочисленное деление. В таких случаях, чтобы скрыть ложное предупреждение, можно использовать комментарий вида:
//-V636
См. также: Документация. Подавление ложных предупреждений.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V636. |
Анализатор обнаружил возможную логическую ошибку в программе. Ошибка заключается в том, что два условных оператора, идущих последовательно, содержат взаимоисключающие условия.
Примеры взаимоисключающих условий:
Как правило, такая ошибка возникает вследствие опечатки или неудачного рефакторинга. В результате логика выполнения программы нарушается.
Рассмотрим пример некорректного кода:
if (A == B)
if (B != A)
B = 5;В данном случае высказывание "B = 5;" никогда не будет выполнено. Скорее всего, в первом или втором условиях используется некорректная переменная. Следует посмотреть логику выполнения программы.
Корректный вариант кода:
if (A == B)
if (B != C)
B = 5;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V637. |
Анализатор обнаружил потенциальную ошибку, связанную с наличием внутри строки терминального нулевого символа.
Как правило, такая ошибка возникает вследствие опечатки. Например, последовательность "\0x0A" будет восприниматься как следующая последовательность из четырёх байт: { '\0', 'x', '0', 'A' }.
Если хочется задать код символа в шестнадцатеричном виде, то символ 'x' должен стоять сразу после символа '\'. Если написать "\0", то это будет воспринято как ноль (в формате восьмеричного числа). См. также:
Рассмотрим пример некорректного кода:
const char *s = "string\0x0D\0x0A";Если попробовать распечатать эту строку, то управляющие символы для перевода строки использованы не будут. Функции вывода остановятся на символе конца строки '\0'. Для устранения этой ошибки следует заменить "\0x0D\0x0A" на "\x0D\x0A".
Корректный вариант кода:
const char *s = "string\x0D\x0A";Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V638. |
Анализатор обнаружил потенциальную ошибку, связанную c подозрительным вызовом функции, за которой следуют запятые и выражения. Возможно, эти выражения должны быть частью вызова функции.
Как правило, такая ошибка возникает, если происходит вызов функции внутри условного оператора и функция имеет аргументы по умолчанию. В таком случае легко по ошибке поставить закрывающую скобку не в том месте, где необходимо. Опасность такого рода ошибок в том, что код компилируется без ошибок и выполняется. Рассмотрим пример некорректного кода:
bool rTuple(int a, bool Error = true);
....
if (rTuple(exp), false)
{
....
}Неправильно поставленная закрывающаяся скобка приведут сразу к двум ошибкам:
1) Аргумент 'Error' при вызове функции 'rTuple' будет равен 'true', хотя хотели 'false'.
2) Оператор запятая ',' возвращает значение правой части. Значит условие (rTuple(exp), false) будет всегда равно значению 'false'
Корректный вариант кода:
if (rTuple(exp, false))
{
....
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V639. |
Анализатор обнаружил потенциальную ошибку, связанную c тем, что форматирование кода, следующих за условным оператором, не соответствует логике выполнения программы. Высока вероятность, что пропущены открывающиеся и закрывающиеся фигурные скобки.
Рассмотрим пример некорректного кода:
if (a == 1)
b = c; d = b;В данном случае присваивание 'd = b;' будет выполняться всегда, независимо от условия 'a == 1'.
Если код ошибочен, то ситуацию можно исправить, используя фигурные скобки. Корректный вариант кода:
if (a == 1)
{ b = c; d = b; }Другой пример некорректного кода:
if (a == 1)
b = c;
d = b;Для исправления ошибки так же следует использовать фигурные скобки. Корректный вариант кода:
if (a == 1)
{
b = c;
d = b;
}Если код корректен, то чтобы исчезло предупреждение V640, следует отформатировать код следующим образом:
if (a == 1)
b = c;
d = b;Нередко данный класс ошибок можно встретить в программах, активно использующих макросы. Рассмотрим ошибку, найденную в реальном приложении:
#define DisposeSocket(a) shutdown(a, 2); closesocket(a)
...
if (sockfd > 0)
(void) DisposeSocket(sockfd);Вызов функции 'closesocket(a);' будет выполняться всегда. Это приведет к сбою, если переменная 'sockfd' окажется <= 0.
Можно исправить ошибку, используя в макросе фигурные скобки. Но лучше написать полноценную функцию. Код без макросов безопаснее и удобней при отладке.
Корректный пример кода может выглядеть следующим образом:
inline void DisposeSocket(int a) {
shutdown(a, 2);
closesocket(a);
}
...
if (sockfd > 0)
DisposeSocket(sockfd);
Вы нашли спрятанный ссееккрреетт и, возможно, успеете забрать один из ппррииззоовв. Подробнее.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V640. |
Анализатор обнаружил потенциальную ошибку, связанную c приведением указателя на исходный буфер к указателю на другой тип, при этом размер исходного буфера некратен размеру одного элемента полученного типа. Рассмотрим два класса ошибок, допускаемых при приведениях типов.
Первый класс ошибок связан с выделением некорректного размера памяти для хранения элементов массива с помощью функций 'malloc', 'calloc', 'alloca', 'realloc' и т.д.
Как правило, такие ошибки возникают, если размер выделяемой памяти задается константой (константами в случае 'calloc'). Для правильного выделения памяти под 'N' элементов массива типа 'T' рекомендуется использовать оператор 'sizeof(T)'. В зависимости от функции, аллоцирующей память, конструкция может иметь следующий вид:
int *p = (int*)malloc(N * sizeof(int));или
int *p = (int*)calloc(N, sizeof(int));В результате неправильного выделения памяти в программе может возникнуть выход за границу массива.
Рассмотрим пример некорректного кода с использованием функции 'malloc':
int *p = (int*)malloc(70);В данном случае будет выделено 70 байт памяти. Обращение к элементу 'p[17]' приведет к неопределенному поведению, поскольку произойдет выход за границу (необходимо 72 байта для корректного чтения 18-го элемента). Корректный вариант кода будет следующим:
p = (int*)malloc(72);Также возможен случай, когда требуется выделить память для хранения 70 элементов. Корректным будет такой вариант кода:
p = (int*)malloc(70 * sizeof(int));Рассмотрим пример некорректного кода из реального проекта с использованием функции 'calloc':
int data16len = MultiByteToWideChar(CP_UTF8,
0,
data,
datalen,
NULL,
0);
if (!data16)
{
data16 = (wchar_t*)calloc(data16len + 1, 1);
}
MultiByteToWideChar(CP_UTF8, 0, data, -1, data16, data16len);В данном случае хотели создать буфер для сохранения широкой (wide) строки после конвертации из UTF-8 строки. Однако размер 'wchar_t' не равен 1 байту (Windows - 2 байта, Linux - 4 байта). Корректный вариант кода будет выглядеть следующим образом:
data16 = (wchar_t*)calloc(data16len + 1, sizeof(wchar_t));Примечание к функции 'calloc'. Несмотря на то, что прототип функции выглядит следующим образом:
void* calloc(size_t num, size_t size );некоторые программисты полагают, что размер выделяемой памяти равен num*size и часто меняют аргументы местами. Такой код может приводить к ошибкам. Цитата из документации: "Due to the alignment requirements, the number of allocated bytes is not necessarily equal to num*size.".
Второй класс ошибок связан с преобразованием указателя на объект типа 'A' к указателю на объект типа 'B'. Рассмотрим пример:
struct A
{
int a, b;
float c;
unsigned char d;
};
struct B
{
int a, b;
float c;
unsigned short d;
};
....
A obj1;
B *obj2 = (B*)&obj1; //V641
std::cout << obj2->d;
....Как видно из примера, две структуры отличаются друг от друга последним полем. Поле 'd' у приведённых структур имеет разный размер типа. При преобразовании указателя 'A*' к 'B*' можно получить неопределенное поведение при обращении к полю 'd'. Отметим, что преобразование указателя 'B*' к 'A*' возможно (хотя это плохой код), и неопределенного поведения не будет.
Анализатор не будет выдавать предупреждения на преобразование указателя 'A*' к 'B*', если два класса (структуры) находятся в иерархии наследования.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V641. |
Анализатор обнаружил потенциальную ошибку, связанную c сохранением результата работы функции в переменную, которая занимает всего 8 или 16 бит. Для некоторых функций, которые возвращают статус типа 'int', это может быть недопустимо. Могут быть потеряны значащие биты.
Рассмотрим пример некорректного кода:
char c = memcmp(buf1, buf2, n);
if (c != 0)
{
...
}Функция 'memcmp' возвращает следующие значения типа 'int':
Обратите внимание. "Больше 0", означает любые числа, а вовсе не 1. Этими числами могут быть: 2, 3, 100, 256, 1024, 5555, и так далее. Это значит, что этот результат нельзя поместить в переменную типа 'char'. Могут быть отброшены значащие биты, что приведет к нарушению логики выполнения программы.
Опасность такого рода ошибок заключается в том, что возвращаемое значение может зависеть от архитектуры и реализации конкретной функции на данной архитектуре. Например, программа будет корректно работать в 32-битном варианте и некорректно в 64-битном.
Корректный вариант кода:
int c = memcmp(buf1, buf2, n);
if (c != 0)
{
...
}Возможно, кому-то данная опасность покажется надуманной. Однако такая ошибка послужила причиной серьезной уязвимости в MySQL/MariaDB до версий 5.1.61, 5.2.11, 5.3.5, 5.5.22. Суть в том, что при подключении пользователя MySQL /MariaDB вычисляется токен (SHA от пароля и хэша), который сравнивается с ожидаемым значением функцией 'memcmp'. На некоторых платформах возвращаемое значение может выпадать из диапазона [-128..127]. В итоге, в 1 случае из 256 процедура сравнения хэша с ожидаемым значением всегда возвращает значение 'true', независимо от хэша. В результате, простая команда на bash даёт злоумышленнику рутовый доступ к уязвимому серверу MySQL, даже если он не знает пароль. Причиной этому стал такой код в файле 'sql/password.c':
typedef char my_bool;
...
my_bool check(...) {
return memcmp(...);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.), Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V642. |
Анализатор обнаружил потенциальную ошибку, связанную c некорректным прибавлением символьной константы к указателю на строковый литерал.
Как правило, такая ошибка возникает в случае попытки объединения строкового литерала с символом.
Рассмотрим простейший пример некорректного кода:
std::string S = "abcd" + 'x';Ожидалось, что будет получена строка "abcdx", однако в данном случае к указателю на строку "abcd" будет прибавлено значение 120. Это гарантировано приведет к выходу за границу строкового литерала. Для предотвращения такой ситуации, следует избегать подобных арифметических операций со строковыми и символьными переменными.
Корректный вариант кода:
std::string S = std::string("abcd") + 'x';Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V643. |
Анализатор обнаружил потенциальную ошибку, связанную c неправильным созданием объекта типа 'T'.
Как правило, такая ошибка возникает, если пропущен аргумент вызова конструктора данного типа. В таком случае вместо создания объекта нужного типа, получится объявление функции, возвращающей тип 'T'. Данная ошибка, как правило, возникает при использовании вспомогательных классов, упрощающих блокирование и разблокирование мьютексов. Например, в библиотеке 'Qt' таким классом является 'QMutexLocker', который упрощает работу с классом 'QMutex'.
Рассмотрим пример некорректного кода:
QMutex mutex;
...
QMutexLocker lock();
++objectVarCounter;Опасность такого рода ошибок в том, что данный код компилируется и выполняется без ошибок. Однако требуемого результата получено не будет. То есть не происходит блокирование других потоков, использующих переменную 'objectVarCounter'. Поэтому выявление таких ошибок может занять много времени и сил.
Корректный вариант кода:
QMutex mutex;
...
QMutexLocker lock(&mutex);
++objectVarCounter;Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку, связанную c конкатенацией строк. Ошибка может приводить к переполнению буфера. Неприятность подобных ошибок заключается в том, что программа долгое время может работать стабильно, если на вход функции поступают только короткие строки.
Данному виду уязвимости подвержены такие функции, как 'strncat', 'wcsncat' и так далее [1].
Описание функции 'strncat':
char *strncat(
char *strDest,
const char *strSource,
size_t count
);Где:
Функция 'strncat', пожалуй, одна из самых опасных строковых функций. Опасность возникает из-за того, что принцип её работы отличается от того, как представляют его себе программисты.
Третий аргумент указывает не размер буфера, а сколько ещё символов в него можно поместить. Вот цитата из описания этой функции в MSDN: "strncat does not check for sufficient space in strDest; it is therefore a potential cause of buffer overruns. Keep in mind that count limits the number of characters appended; it is not a limit on the size of strDest."
К сожалению, про это редко помнят и используют 'strncat' неправильными способами. Можно выделить три типа ошибок:
1) Разработчики считают, что аргумент 'count' — это размер буфера 'strDest'. В результате, можно видеть в программах следующий некорректный код:
char newProtoFilter[2048] = "....";
strncat(newProtoFilter, szTemp, 2048);
strncat(newProtoFilter, "|", 2048);Программист предполагает, что, передавая в качестве третьего аргумента число 2048, он защищает код от переполнения. Это не так. Он указывает, что к строке можно добавить ещё до 2048 символов!
2) Забывают, что после копирования символов, функция 'strncat' добавит терминальный 0. Пример опасного кода:
char filename[NNN];
...
strncat(filename,
dcc->file_info.filename,
sizeof(filename) - strlen(filename));На первый взгляд, кажется, что теперь программист защитился от переполнения буфера 'filename'. Но это не так. Он вычел из размера массива длину строки. Это значит, что если вся строка уже заполнена, выражение 'sizeof(filename) - strlen(filename)' вернет единицу. В результате к строке будет прибавлен ещё один символ, а терминальный ноль будет записан уже за границы буфера.
Поясним эту ошибку на более простом примере:
char buf[5] = "ABCD";
strncat(buf, "E", 5 - strlen(buf));В буфере уже нет места для новых символов. В нём находится 4 символа и терминальный ноль. Выражение "5 - strlen(buf)" равно 1. Функция strncpy() скопирует символ "E" в последний элемент массива 'buf'. Терминальный 0 будет записан уже за пределами буфера!
3) Забывают о факторе целочисленного переполнения. Рассмотрим пример такой ошибки:
struct A
{
....
char consoleText[512];
};
void foo(A a)
{
char inputBuffer[1024];
....
strncat(a.consoleText, inputBuffer,
sizeof(a.consoleText) - strlen(a.consoleText) - 5);
}Здесь в качестве третьего аргумента используется инфиксное выражение. При невнимательном изучении кода может показаться, что значение выражения "sizeof(a.consoleText) - strlen(a.consoleText) – 5" лежит в диапазоне [0, 507], и код корректен. Однако это не так:
Чтобы исправить приведённые выше примеры, их нужно переписать следующим образом:
// Sample N1
char newProtoFilter[2048] = "....";
strncat(newProtoFilter, szTemp,
2048 - 1 - strlen(newProtoFilter));
strncat(newProtoFilter, "|",
2048 - 1 - strlen(newProtoFilter));
// Sample N2
char filename[NNN];
...
strncat(filename,
dcc->file_info.filename,
sizeof(filename) - strlen(filename) - 1);
// Sample N3
void foo(A a)
{
char inputBuffer[1024];
....
size_t textSize = strlen(a.consoleText);
if (sizeof(a.consoleText) - textSize > 5u)
{
strncat(a.consoleText, inputBuffer,
sizeof(a.consoleText) - textSize - 5);
}
else
{
// ....
}
}Этот код нельзя назвать красивым или по-настоящему надежным. Гораздо лучшим решением будет отказ от функций типа 'strncat' в пользу более безопасных. Например, можно использовать класс 'std::string' или такие функции, как 'strncat_s', и так далее [2].
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V645. |
Оператор if расположен на той же строке, что и закрывающаяся скобка от предыдущего if. Возможно, в этом месте пропущено ключевое слово 'else' и программа работает не так, как ожидал программист.
Рассмотрим простой пример некорректного кода:
if (A == 1) {
Foo1(1);
} if (A == 2) {
Foo2(2);
} else {
Foo3(3);
}В случае если переменная 'A' принимает значение 1, то произойдет вызов не только функции 'Foo1', но и вызов функции 'Foo3'. Следует обратить внимание на логику выполнения программы, возможно так и должно быть. В случае ошибки следует добавить ключевое слово 'else'.
Корректный вариант кода:
if (A == 1) {
Foo1(1);
} else if (A == 2) {
Foo2(2);
} else {
Foo3(3);
}Так же корректным анализатор считает код, в котором в 'then' части первого условного оператора 'if' есть безусловный оператор 'return'. Поскольку в таком случае логика выполнения программы не нарушается, а присутствует только не совсем корректное форматирование кода. Пример такого кода:
if (A == 1) {
Foo1(1);
return;
} if (A == 2) {
Foo2(2);
} else {
Foo3(3);
}Если ошибки нет, то устранить предупреждение V646 можно, если перенести оператор 'if' на следующую строку. Пример такого кода:
if (A == 1) {
Foo1(1);
}
if (A == 2) {
Foo2(2);
} else {
Foo3(3);
}В приведенных выше примерах ошибка очевидна, и, кажется, что вряд ли она встретится в реальных программах. Однако, если код сложен, очень легко не заметить отсутствие оператора 'else'. Вот пример этой ошибки, взятый из реального приложения:
if( 1 == (dst->nChannels) ) {
ippiCopy_16s_C1MR((Ipp16s*)pDstCh, dstStep,
(Ipp16s*)pDst, dst->widthStep, roi, pMask, roi.width);
} if( 3 == (dst->nChannels) ) { //V646
ippiCopy_16s_C3R((Ipp16s*)pDst-coi, dst->widthStep,
(Ipp16s*)pTmp, dst->widthStep, roi);
ippiCopy_16s_C1C3R((Ipp16s*)pDstCh, dstStep,
(Ipp16s*)pTmp+coi, dst->widthStep, roi);
ippiCopy_16s_C3MR((Ipp16s*)pTmp, dst->widthStep,
(Ipp16s*)pDst-coi, dst->widthStep, roi, pMask, roi.width);
} else {
ippiCopy_16s_C4R((Ipp16s*)pDst-coi, dst->widthStep,
(Ipp16s*)pTmp, dst->widthStep, roi);
ippiCopy_16s_C1C4R((Ipp16s*)pDstCh, dstStep,
(Ipp16s*)pTmp+coi, dst->widthStep, roi);
ippiCopy_16s_C4MR((Ipp16s*)pTmp, dst->widthStep,
(Ipp16s*)pDst-coi, dst->widthStep, roi, pMask, roi.width);
}Этот код очень сложен для чтения и понимания. Однако анализатор не теряет бдительности.
В данном примере условия '3 == (dst->nChannels)' и '1 == (dst->nChannels)' не могут выполниться одновременно, и форматирование кода указывает на пропущенное ключевое слово 'else'. Корректный вариант должен выглядеть следующим образом:
if( 1 == (dst->nChannels) ) {
....
} else if( 3 == (dst->nChannels) ) {
....
} else {
....
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V646. |
Анализатор обнаружил, что выполняется некорректная операция с указателем. В указатель на целочисленный тип записывается целочисленное значение или константа. Скорее всего, в указатель следует поместить адрес переменной. Или следует поместить значение по адресу, который содержит указатель.
Рассмотрим пример некорректного кода:
void foo()
{
int *a = GetPtr();
int b = 10;
a = b; // <=
Foo(a);
}В данном случае указателю 'a' будет присвоено значение 10. Фактически мы получим не валидный указатель. Для исправления следует разыменовать указатель 'a' или взять адрес переменной 'b'.
Корректный вариант кода:
void foo()
{
int *a = GetPtr();
int b = 10;
*a = b;
Foo(a);
}Так же корректным будет такой код:
void foo()
{
int *a = GetPtr();
int b = 10;
a = &b;
Foo(a);
}Анализатор считает безопасным, когда в переменную типа указатель записываются такие магические значения, как: -1, 0xcccccccc, 0xbadbeef, 0xdeadbeef, 0xfeeefeee, 0xcdcdcdcd и т.д. Эти значения часто используются в целях отладки или как специальные маркеры.
Примечание N1.
Подобная ошибка возможна только в языке Си. В Си++ неявное приведение целочисленного значения (кроме 0) к указателю невозможно.
Примечание N2.
Иногда сообщения анализатора могут казаться странными. Рассмотрим такой случай:
char *page_range_split = strtok(page_range, ",");Анализатор выдаёт предупреждение, что значение типа 'int' помещается в указатель. Но ведь функция 'strtok' возвращает указатель, как же так?
Дело в том, что функция 'strtok' может быть не объявлена ранее! Разработчик мог забыть подключить нужный заголовочный файл. В языке C считается, что по умолчанию функция возвращает тип 'int'. Именно исходя из этих предположений и будет скомпилирован код. Это серьёзная ошибка, которая будет приводить к порче указателей в 64-битных программах. Подробнее эта тема разбирается в статье "Красивая 64-битная ошибка на языке Си".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V647. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что приоритет логической операций '&&' выше приоритета логической операции '||'. Про это часто забывают. В результате логическое выражение может давать совсем не тот результат, на который рассчитывал программист.
Рассмотрим пример некорректного кода:
if ( c == 'l' || c == 'L' &&
!( token->subtype & TT_LONG ) )
{ .... }Скорее всего, программист ожидал, что вначале выполнится проверка равенства переменной 'c' значению 'l' или 'L'. И только затем выполнится операция '&&'. Но согласно приоритету операций в языке Си/Си++ вначале произойдет выполнение операции '&&', а уже потом '||'.
Можно порекомендовать во всех выражениях с редко используемыми вами операторами или там где нет уверенности, писать скобки. Даже если скобки окажутся лишними, это не страшно. Зато код станет более легким для понимания и будет меньше подвержен ошибкам.
Корректный вариант кода:
if ( ( c == 'l' || c == 'L' ) &&
!( token->subtype & TT_LONG ) )А как убрать ложное предупреждение, если действительно планировалась последовательность вычислений: сначала логическое '&&', затем логическое '||'?
Есть несколько вариантов:
1) Плохой вариант. Можно использовать комментарий "//-V648" для подавления предупреждения в нужной строке.
if ( c == 'l' || c == 'L' && //-V648
!( token->subtype & TT_LONG ) )2) Хороший вариант. Можно добавить дополнительные скобки:
if ( c == 'l' || ( c == 'L' &&
!( token->subtype & TT_LONG ) ) )Дополнительные скобки помогут вашим коллегам понять, что этот код корректен.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V648. |
Анализатор обнаружил ситуацию, когда 'then' часть оператора 'if' никогда не получит управления. Это происходит из-за того, что ранее уже встречается оператор 'if' с таким же условием, содержащий в 'then' части безусловный оператор 'return'. Это может свидетельствовать как о логической ошибке в программе, так и избыточном втором операторе 'if'.
Рассмотрим пример некорректного кода:
if (l >= 0x06C0 && l <= 0x06CE) return true;
if (l >= 0x06D0 && l <= 0x06D3) return true;
if (l == 0x06D5) return true; // <=
if (l >= 0x06E5 && l <= 0x06E6) return true;
if (l >= 0x0905 && l <= 0x0939) return true;
if (l == 0x06D5) return true; // <=
if (l >= 0x0958 && l <= 0x0961) return true;
if (l >= 0x0985 && l <= 0x098C) return true;В данном случае условие 'l == 0x06D5' дублируется и для исправления кода достаточно убрать одно из них. Однако возможно, что во втором случае проверяемое значение должно отличаться от первого случая.
Корректный вариант кода:
if (l >= 0x06C0 && l <= 0x06CE) return true;
if (l >= 0x06D0 && l <= 0x06D3) return true;
if (l == 0x06D5) return true;
if (l >= 0x06E5 && l <= 0x06E6) return true;
if (l >= 0x0905 && l <= 0x0939) return true;
if (l >= 0x0958 && l <= 0x0961) return true;
if (l >= 0x0985 && l <= 0x098C) return true;Предупреждение V649 косвенно может указать на наличие ошибок совсем иного типа. Рассмотрим интересный пример некорректного кода:
AP4_Result AP4_StscAtom::WriteFields(AP4_ByteStream& stream)
{
AP4_Result result;
AP4_Cardinal entry_count = m_Entries.ItemCount();
result = stream.WriteUI32(entry_count);
for (AP4_Ordinal i=0; i<entry_count; i++) {
stream.WriteUI32(m_Entries[i].m_FirstChunk);
if (AP4_FAILED(result)) return result;
stream.WriteUI32(m_Entries[i].m_SamplesPerChunk);
if (AP4_FAILED(result)) return result;
stream.WriteUI32(m_Entries[i].m_SampleDescriptionIndex);
if (AP4_FAILED(result)) return result;
}
return result;
}Имеющиеся в цикле проверки 'if (AP4_FAILED(result)) return result;' бессмысленны. Переменная 'result' не изменяется при чтении данных из файлов.
Исправленный вариант кода:
AP4_Result AP4_StscAtom::WriteFields(AP4_ByteStream& stream)
{
AP4_Result result;
AP4_Cardinal entry_count = m_Entries.ItemCount();
result = stream.WriteUI32(entry_count);
for (AP4_Ordinal i=0; i<entry_count; i++) {
result = stream.WriteUI32(m_Entries[i].m_FirstChunk);
if (AP4_FAILED(result)) return result;
result = stream.WriteUI32(m_Entries[i].m_SamplesPerChunk);
if (AP4_FAILED(result)) return result;
result = stream.WriteUI32(m_Entries[i].m_SampleDescriptionIndex);
if (AP4_FAILED(result)) return result;
}
return result;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V649. |
Анализатор обнаружил потенциальную ошибку в выражении с адресной арифметикой. Операции сложения/вычитания выполняется с выражением, представляющим собой двойное приведение типов. Это может быть опечаткой - забыли заключить первое приведение типа и операцию сложения в скобки.
Рассмотрим пример некорректного кода:
ptr = (int *)(char *)p + offset_in_bytes;Скорее всего, программист ожидал, что переменная 'p' будет приведена к типу 'char *' и к ней будет добавлено смещение в байтах. Затем новый указатель будет приведен к типу 'int *'.
Однако пропущенные скобки превращают это выражение в двойное приведение типов и добавление смещения к указателю на 'int'. Полученный результат будет отличаться от ожидаемого результата. Подобная ошибка вполне может привести к выходу за границы массива.
Корректный вариант кода:
ptr = (int *)((char *)p + offset_in_bytes);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V650. |
Анализатор обнаружил потенциальную ошибку в выражении вида 'sizeof(X)/sizeof(X[0])'. Подозрительно то, что объект 'X' является экземпляром класса.
Как правило, выражение 'sizeof(X)/sizeof(X[0]) применяется для определения количества элементов в массиве 'X'. Ошибка может возникнуть в ходе неаккуратного рефакторинга кода. Переменная 'X' изначально была обыкновенным массивом и была заменена на класс-контейнер, но вычисление числа элементов осталось прежним.
Рассмотрим пример некорректного кода:
#define countof( x ) (sizeof(x)/sizeof(x[0]))
Container<int, 4> arr;
for( int i = 0; i < countof(arr); i++ )
{ .... }Программист ожидал, что будет вычислено число элементов переменной 'arr'. Однако полученное значение будет представлять собой: размер класса, разделённый на размер переменной типа 'int'. Это значение, скорее всего, никак не связано с количеством элементов данных, хранящихся в контейнере.
Пример корректного кода:
const size_t count = 4;
Container<int, count> arr;
for( int i = 0; i < arr.size(); i++ )
{ .... }Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку, связанную с тем, что одна из операций '!', '~', '-' или '+' повторяется три или более раз. Такая ошибка может произойти в случае опечатки. Такое дублирование операторов бессмысленно и может содержать ошибку.
Рассмотрим пример некорректного кода:
if(B &&
C && !!!
D) { .... }Скорее всего, такая ошибка возникла вследствие опечатки. Например, были пропущены символы комментария или напечатан лишний символ операции.
Корректный вариант кода:
if (B &&
C && //!!!
D) { .... }Так же корректным будет следующий вариант кода:
if (B &&
C && !!D) { .... }Такой приём часто используется для приведения целочисленных типов данных к типу 'bool'.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V652. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что в объявлении, состоящем из строковых литералов, две строки объединяются в одну. Ошибка может быть следствием опечатки, когда пропущена запятая между строковыми литералами.
Такая ошибка может долго оставаться незамеченной. Например, она может редко проявлять себя, если массив строковых литералов используется для формирования сообщений об ошибках.
Рассмотрим пример некорректного кода:
const char *Array [] = {
"Min", "Max", "1",
"Begin", "End" "2" };Между литералами "End" и "2" пропущена запятая, и поэтому они будут объединены в один строковый литерал "End2". Для исправления такой ошибки следует разделить строковые литералы запятой.
Корректный вариант кода:
const char *Array [] = {
"Min", "Max", "1",
"Begin", "End", "2" };Анализатор не выдает предупреждающих сообщений, если объединённая строка окажется слишком большой (более 50 символов) или состоит более чем из двух фрагментов. Такой прием часто используется при оформлении кода с длинными строковыми литералами.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V653. |
Анализатор обнаружил ситуацию, когда условие в операторе 'for' или 'while' всегда истинно или ложно. Подобная ситуация часто свидетельствует о наличии ошибок. Высока вероятность того, что произошла опечатка и следует обратить внимание на этот фрагмент кода.
Рассмотрим пример некорректного кода:
for (i = 0; 1 < 50; i++)
{ .... }В коде допущена опечатка. В условии вместо переменной 'i' была напечатана константа '1'. Исправить такой код не представляет больших трудностей. Корректный вариант кода:
for (i = 0; i < 50; i++)
{ .... }Анализатор не будет выдавать предупреждающее сообщение, если условие задано явно в виде константного выражения '1' или '0', 'true' или 'false'. Пример такого кода:
while (true)
{ .... }Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V654. |
Анализатор обнаружил потенциальную ошибку, найдя в коде неиспользуемое объединение строковых переменных. Тип переменных: std::string, CString, QString, wxString. Чаще всего, такие выражения появляются в коде, когда пропускается оператор присваивания или в процессе неаккуратного рефакторинга кода.
Рассмотрим пример некорректного кода:
void Foo(std::string &s1, const std::string &s2)
{
s1 + s2;
}Код содержит опечатку. Вместо '+=' написано '+'. Код компилируется, но не имеет практического смысла. Исправленный вариант кода:
void Foo(std::string &s1, const std::string &s2)
{
s1 += s2;
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V655. |
Анализатор обнаружил потенциальную ошибку, найдя в коде инициализацию двух различных переменных одинаковыми выражениями. Анализатор считает опасными не все выражения, а только в которых используется вызов функций.
Рассмотрим наиболее простой случай:
x = X();
y = X();Возможны три варианта действий:
1) Код содержит ошибку. Необходимо исправить ошибку, заменив 'X()' на 'Y()'.
2) Код верен, но работает медленно. Если функция 'X()' требует много вычислений, то лучше написать 'y = x;'.
3) Код верен и работает быстро. Или функция 'X()' читает значение из файла. Тогда чтобы избавиться от ложного срабатывания, можно использовать комментарий "//-V654".
Теперь рассмотрим реальный пример:
while (....)
{
if ( strstr( token, "playerscale" ) )
{
token = CommaParse( &text_p );
skin->scale[0] = atof( token );
skin->scale[1] = atof( token );
continue;
}
}В данном коде нет ошибки. Однако код не оптимален. Его можно переписать таким образом, что бы исключить лишний вызов функции 'atof'. Учитывая то, что присваивание находится в цикле и может быть вызвано много раз, такое изменение может привести к заметному выигрышу в быстродействии функции. Исправленный вариант кода:
while (....)
{
if ( strstr( token, "playerscale" ) )
{
token = CommaParse( &text_p );
skin->scale[1] = skin->scale[0] = atof( token );
continue;
}
}Рассмотрим ещё один пример:
String path, name;
SplitFilename(strSavePath, &path, &name, NULL);
CString spath(path.c_str());
CString sname(path.c_str());В данном примере присутствует явная ошибка. Переменная 'path' используется два раза: для инициализации переменных 'spath' и 'sname'. Однако, по логике программы видно, что для инициализации переменной 'sname' должна быть использована переменная 'name'. Исправленный вариант кода:
....
CString spath(path.c_str());
CString sname(name.c_str());Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V656. |
Анализатор обнаружил странную функцию. Функция не имеет состояния, не изменяет глобальных переменных. При этом она имеет несколько точек возврата, возвращающих одно и то же числовое значение.
Такой код крайне подозрителен и может свидетельствовать о возможной ошибке. Скорее всего, функция должна возвращать различные числовые значения.
Рассмотрим простой пример такого кода:
int Foo(int a)
{
if (a == 33)
return 1;
return 1;
}Данный код содержит ошибку. Для ее исправления изменим одно из возвращаемых значений. Определить необходимые возвращаемые значения, как правило, можно только зная логику работы всего приложения в целом.
Вариант корректного кода:
int Foo(int a)
{
if (a == 33)
return 1;
return 2;
}Если код верен, то чтобы избавиться от ложного срабатывания следует использовать комментарий "//-V657".
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку, связанную с переполнением.
Выполняются следующие действия:
Если при вычитании возможно переполнение, то результат проверки может отличаться от ожиданий программиста.
Рассмотрим наиболее простой случай:
unsigned A = ...;
int B = ...;
if (A - B > 1)
Array[A - B] = 'x';Такая проверка по замыслу программиста должна защитить от выхода за границу массива. Однако эта проверка не поможет, если переменная A < B.
Пусть: A = 3, B = 5;
Тогда: 0x00000003u - 0x00000005i = FFFFFFFEu
Выражение "A - B" согласно правилам языка Си++ имеет тип "unsigned int". Значит, "A - B" будет равно FFFFFFFEu. Это число больше единицы. В результате произойдёт обращение к памяти за границей массива.
Исправить код можно двумя способами. Во-первых, вычисления можно производить в переменных знаковых типов:
intptr_t A = ...;
intptr_t B = ...;
if (A - B > 1)
Array[A - B] = 'x';Во-вторых, можно изменить условие. Как именно следует изменить условие, зависит от желаемого результата и входных значений. Если B >= 0, то достаточно будет написать:
unsigned A = ...;
int B = ...;
if (A > B + 1)
Array[A - B] = 'x';Если код корректен, то можно отключить вывод диагностического сообщения в данной строке, используя комментарий "//-V658".
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V658. |
Анализатор обнаружил в коде две функции с одинаковыми именами. Функции различаются константностью.
Объявления функции могут различаться:
Хотя имена функций совпадают, они работают по-разному. Это может свидетельствовать об ошибке.
Рассмотрим простой случай:
class CLASS {
DATA *m_data;
public:
char operator[](size_t index) const {
if (!m_data || index >= m_data->len)
throw MyException;
return m_data->data[index];
}
char &operator[](size_t index) {
return m_data->data[index];
}
};В константной функции 'operator[]' существует проверка и генерируется исключение в случае ошибки. В неконстантной функции такой поверки нет. Скорее всего, это недочёт, который должен быть исправлен.
Анализатор учитывает набор различных ситуаций, когда различия в телах функций оправданы. Однако всё исключительные ситуации учесть невозможно. Если анализатор выдал ложное срабатывание, то его можно подавить, используя комментарий "//-V659".
Анализатор обнаружил потенциальную ошибку, когда из-за опечатки написано ':', хотя необходимо '::'.
В коде метода класса найдена неиспользуемая метка. Вслед за этой меткой следует вызов функции. Анализатор считает опасным, если функция с таким именем находится в одном из базовых классов.
Рассмотрим пример:
class Employee {
public:
void print() const {}
};
class Manager: public Employee {
void print() const;
};
void Manager::print() const {
Employee:print();
}С большой вероятностью строчка 'Employee:print();' является ошибочной. Ошибка заключается в том, что будет вызвана функция не из класса 'Employee', как планировалось, а из своего же класса 'Manager'. Для исправления ошибки достаточно заменить ':' на '::'.
Корректный вариант кода:
void Manager::print() const {
Employee::print();
}Рассмотрим ещё один пример:
namespace Abcd
{
void Foo() {}
}
class Employee {
void Foo() {}
void X() { Abcd:Foo(); }
};Здесь ошибка заключается в том, что должна была быть вызвана функция, находящаяся в области видимости 'Abcd'. Ошибку легко исправить:
void X() { Abcd::Foo(); }Диагностическое правило классифицируется как:
Анализатор обнаружил подозрительный фрагмент кода, в котором осуществляется доступ к элементу массива. В качестве индекса массива используется логическое выражение.
Примеры таких выражений: Array[A >= B], Array[A != B]. Возможно, что закрывающаяся квадратная скобка стоит не на своем месте. Подобные ошибки, чаще всего возникают из-за опечатки.
Рассмотрим пример некорректного кода:
if ((bs->inventory[INVENTORY_ROCKETLAUNCHER] <= 0 ||
bs->inventory[INVENTORY_ROCKETS < 10]) && <<== ERROR!
(bs->inventory[INVENTORY_RAILGUN] <= 0 ||
bs->inventory[INVENTORY_SLUGS] < 10)) {
return qfalse;
}Такой код компилируется, но работает неправильно. С большой вероятностью, здесь должно быть написано:
if ((bs->inventory[INVENTORY_ROCKETLAUNCHER] <= 0 ||
bs->inventory[INVENTORY_ROCKETS] < 10) &&
(bs->inventory[INVENTORY_RAILGUN] <= 0 ||
bs->inventory[INVENTORY_SLUGS] < 10)) {
return qfalse;
}Примечание. Анализатор выдает предупреждения не всегда, когда в квадратных скобках находится логическое выражение. Иногда это оправдано. Например, исключение составляет случай, когда массив состоит всего из двух элементов:
int A[2];
A[x != y] = 1;Взгляните на примеры ошибок, обнаруженных с помощью диагностики V661. |
Анализатор обнаружил подозрительный цикл. Для инициализации итератора используется контейнер A. Затем, этот итератор сравнивается с концом контейнера B. Высока вероятность, что это опечатка и код некорректен.
Рассмотрим пример, когда будет выдано данное предупреждение:
void useVector(vector<int> &v1, vector<int> &v2)
{
vector<int>::iterator it;
for (it = v1.begin(); it != v2.end(); ++it)
*it = rand();
....
}В цикле 'for' происходит заполнение массива. Для инициализации итератора и для проверки границы используются различные переменные (v1 и v2). Если на самом деле ссылки v1 и v2 указывают на разные массивы, это приведет к ошибке на этапе исполнения программы.
Исправить ошибку очень просто. Необходимо использовать один и тот же контейнер в обоих случаях. Корректный вариант кода:
void useVector(vector<int> &v1, vector<int> &v2)
{
vector<int>::iterator it;
for (it = v1.begin(); it != v1.end(); ++it)
*it = rand();
....
}Если переменная v1 и v2 ссылаются на один и тот же контейнер, то код корректен. В этом случае можно использовать механизм подавления ложных срабатываний анализатора. Но скорее всего, более удачным решением является рефакторинг кода. Такой код может запутать не только анализатор, но и программистов, которые будут сопровождать этот код.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V662. |
Анализатор обнаружил потенциальную ошибку, из-за которой может возникнуть бесконечный цикл. При работе с классом 'std::istream' недостаточно вызова функции 'eof()' для завершения цикла. В случае возникновения сбоя при чтении данных, вызов функции 'eof()' будет всегда возвращать значение 'false'. Для завершения цикла в этом случае необходима дополнительная проверка значения, возвращаемого функцией 'fail()'.
Рассмотрим пример некорректного кода:
while (!cin.eof())
{
int x;
cin >> x;
}Исправить ошибку можно усложнив условие. Корректный вариант кода:
while (!cin.eof() && !cin.fail())
{
int x;
cin >> x;
}Впрочем, у этого варианта тоже есть недостатки. Наиболее простой и правильный вариант кода выглядит так:
int x;
while(cin >> x) {
....;
}Подробно вопрос чтения из потока разбирается здесь: Why is iostream::eof inside a loop condition (i.e. 'while (!stream.eof())') considered wrong?
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V663. |
Указатель разыменовывается в списке инициализации конструктора, а затем проверяется в теле конструктора на неравенство нулю. Это может свидетельствовать о скрытой ошибке, которая может не проявляться долгое время.
Рассмотрим пример некорректного кода:
Layer(const Canvas *canvas) :
about(canvas->name, canvas->coord)
{
if (canvas)
{
....
}
}При разыменовании нулевого указателя возникает неопределенное поведение, то есть дальнейшее нормальное выполнение программы становится невозможным. Для исправления ошибки следует перенести инициализацию в тело конструктора в блок кода, где указатель заведомо неравен нулю. Корректный вариант кода:
Layer(const Canvas *canvas)
{
if (canvas)
{
about.set(canvas->name, canvas->coord);
}
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V664. |
Анализатор обнаружил, что в коде находится некорректная последовательность директив '#pragma warning'.
Программисты часто считают, что после директивы "pragma warning(default : X)" опять начнут действовать предупреждения, отключенные ранее помощью "pragma warning(disable: X)". Это не так. Директива 'pragma warning(default : X)' устанавливает предупреждение с номером 'X' в состояние, которое действует ПО УМОЛЧАНИЮ. Это далеко не одно и то же.
Предположим, что файл компилируется с ключом /Wall. В этом случае, должно выдаваться предупреждение C4061. Если написать "#pragma warning(default : 4061)", то это предупреждение перестанет выдаваться, так как по умолчанию оно является отключенным.
Правильным способом возвращения предыдущего состояние предупреждения является использование "#pragma warning(push[ ,n ])" и "#pragma warning(pop)". С описанием этих директив можно познакомиться в документации к Visual C++: Pragma Directives. Warnings.
Рассмотрим пример некорректного кода:
#pragma warning(disable: 4001)
....
//Корректный код, выдающий предупреждение 4001
....
#pragma warning(default: 4001)В данном примере предупреждение 4001 будет установлено в значение по умолчанию. Но, скорее всего, планировалось вернуть предыдущее значение, которое было до его отключения. Для этого следует воспользоваться директивой 'pragma warning(push)' до отключения предупреждения и директивой 'pragma warning(pop)' после корректного кода.
Корректный вариант кода:
#pragma warning(push)
#pragma warning(disable: 4001)
....
// Корректный код, выдающий предупреждение 4001
....
#pragma warning(pop)Особенное внимание предупреждению V665 должны уделять разработчики библиотек. Неаккуратная работа с настройками предупреждений может вызвать массу неприятных моментов у пользователей такой библиотеки.
Вы нашли спрятанный ссееккрреетт и, возможно, успеете забрать один из ппррииззоовв. Подробнее.
Хорошая статья по данной теме: "Итак, вы хотите заглушить это предупреждение в Visual C++".
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V665. |
Анализатор предполагает, что в функцию мог быть передан некорректный аргумент. Некорректным считается аргумент, числовое значение которого не совпадает с длиной строки, которая находится в предыдущем аргументе. Анализатор строит такие предположения, анализируя пары аргументов, состоящих из строкового литерала и целочисленной константы. Анализ производится по всем одноименным вызовам функций.
Рассмотрим пример некорректного кода:
if (!_strnicmp(szDir, "My Documents", 11)) // <<== Error!
nFolder = 1;
if (!_strnicmp(szDir, "Desktop", 7))
nFolder = 2;
if (!_strnicmp(szDir, "Network Favorites", 17))
nFolder = 3;В данном случае в первом вызове функции числовое значение 11 некорректно. Это может привести к тому, что если переменная 'szDir' будет указывать на строковый литерал "My Document", то сравнение пройдет успешно. Для исправления достаточно изменить длину строки на корректное значение, то есть 12.
Корректный вариант кода:
if (!_strnicmp(szDir, "My Documents", 12))
nFolder = 1;Диагностика V666 носит эмпирический характер. Если вы хотите понять его суть, то, к сожалению, придется прочитать сложное объяснение. Это можно не делать, но тогда просим внимательно проверить аргументы функции. Если вы уверены, что код совершенно корректен, то можно отключить вывод диагностического сообщения, добавив комментарий, вида "//-V666".
Давайте попробуем разобраться, как работает это диагностическое правило. Рассмотрим код:
foo("1234", 1, 4);
foo("123", 2, 3);
foo("321", 2, 2);Анализатор выберет пары аргументов: строковый литерал и числовое значение. Для них будут проанализированы все вызовы данной функции и построена таблица совпадения длины строки и числового аргумента.
{ { "1234", 1 }, { "1234", 4 } } -> { false, true }
{ { "123", 2 }, { "123", 3 } } -> { false, true }
{ { "321", 2 }, { "321", 2 } } -> { false, false }
Первый столбец не интересен. Не похоже, что это длина строки. А вот второй столбец, кажется, представляет собой длину строки. При этом один из вызовов содержит ошибку.
Конечно, это описание очень схематично, но позволяет понять общий принцип работы. Такой анализ, конечно же, не идеален и будут появляться ложные срабатывания. Однако он позволяет иногда находить интересные ошибки.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V666. |
Анализатор обнаружил, что оператор 'throw' не имеет аргументов и не находится внутри блока 'catch'. Такой код может являться ошибочным. Оператор 'throw' без аргументов используется внутри блока 'catch' для проброса пойманного исключения на верхний уровень. Согласно стандарту, вызов оператора 'throw' без аргумента, если еще не поймано исключение приведет к вызову функции 'std::terminate()'. Это означает, что программа будет завершена.
Рассмотрим пример некорректного кода:
try
{
if (ok)
return;
throw;
}
catch (...)
{
}Для исправления ошибки необходимо передать оператору 'throw' аргумент.
Корректный вариант кода:
try
{
if (ok)
return;
throw exception("Test");
}
catch (...)
{
}Однако, вызов оператора 'throw' вне 'catch' блока - это не всегда ошибка. Например, если функция вызывается из блока 'catch' и занимается перебросом исключения на верхний уровень, то ошибки не будет. Однако анализатор не может понять такого поведения программы и все равно будет выдано диагностическое сообщение. Пример такого кода:
void error()
{
try
{
....
if (ok)
return;
throw; <<== на самом деле здесь ошибки нет
}
catch (...)
{
throw;
}
}
void foo()
{
try
{
....
if (ok)
return;
throw exception("Test");
}
catch (...)
{
error();
}
}В таком случаем вывод диагностического сообщения анализатора можно подавить, используя комментарий вида '//-V667'.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил ситуацию, когда значение указателя возвращаемого оператором 'new' сравнивается с нулём. Как правило, это значит, что программа при невозможности выделить память будет вести себя не так, как ожидает программист.
Если оператор 'new' не смог выделить память, то согласно стандарту языка Си++, генерируется исключение std::bad_alloc(). Таким образом проверять указатель на равенство нулю не имеет смысла. Рассмотрим простейший случай:
MyStatus Foo()
{
int *p = new int[100];
if (!p)
return ERROR_ALLOCATE;
...
return OK;
}Указатель 'p' никогда не будет равен нулю. Функция никогда не вернет константное значение ERROR_ALLOCATE. Если выделить память невозможно, то возникнет исключение. Исправим код наиболее простым образом:
MyStatus Foo()
{
try
{
int *p = new int[100];
...
}
catch(const std::bad_alloc &)
{
return ERROR_ALLOCATE;
}
return OK;
}Отметим, что приведенный пример исправленного кода очень плох. Идеология работы с исключениями совсем иная. Исключения как раз позволяют избавиться от множества проверок и возвращаемых статусов. Лучше позволить исключению выйти за пределы функции 'Foo' и обработать его где-то на более высоком уровне. К сожалению, рассмотрение использования исключений выходит за рамки документации.
Рассмотрим, как подобная ошибка может выглядеть на практике. Вот код, взятый из реального приложения:
// For each processor; spawn a CPU thread to access details.
hThread = new HANDLE [nProcessors];
dwThreadID = new DWORD [nProcessors];
ThreadInfo = new PTHREADINFO [nProcessors];
// Check to see if the memory allocation happenned.
if ((hThread == NULL) ||
(dwThreadID == NULL) ||
(ThreadInfo == NULL))
{
char * szMessage = new char [128];
sprintf(szMessage,
"Cannot allocate memory for "
"threads and CPU information structures!");
MessageBox(hDlg, szMessage, APP_TITLE, MB_OK|MB_ICONSTOP);
delete szMessage;
return false;
}Пользователь никогда не увидит окошка с сообщением об ошибке. Если не удастся выделить память, программа аварийно завершится или выдаст неподходящее сообщение, обработав исключение в другом месте.
Частой причиной описанных проблем, является изменение в поведении оператора 'new'. Во времена Visual C++ 6.0, оператор 'new' в случае ошибки возвращал NULL. Следующие версии Visual C++ следуют стандарту и генерируют исключение. Помните про это изменение поведения. Таким образом, если вы адаптируете старый проект для сборки современным компилятором, вам стоит уделить повышенное внимание диагностике V668.
Примечание N1. Анализатор не будет выдавать предупреждение, если используется placement new или "new (std::nothrow) T". Пример такого кода:
T * p = new (std::nothrow) T; // OK
if (!p) {
// An error has occurred.
// No storage has been allocated and no object constructed.
...
}Примечание N2. Есть возможность слинковать проект с nothrownew.obj. В этом случае, оператор new не будет генерировать исключение. Такой возможностью, например, пользуются разработчики драйверов. Подробнее: new and delete operators. В этом случае, просто отключите предупреждение V668.
Дополнительные материалы по данной теме:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V668. |
Анализатор обнаружил, что аргумент передается в функцию по ссылке, но не модифицируется в теле функции. Это может свидетельствовать о наличии ошибки.
Например, виной тому может быть опечатка.
Рассмотрим пример некорректного кода:
void foo(int &a, int &b, int c)
{
a = b == c;
}Из-за опечатки оператор присваивания ('=') превратился в оператор сравнения ('=='). В результате, переменная 'b' используется только для чтения, хотя это не константная ссылка. Как исправить некорректный код будет зависеть от каждого конкретного случая. Самое главное, такой код требует более подробного изучения.
Корректный вариант кода:
void foo(int &a, int &b, int c)
{
a = b = c;
}Примечание. Анализатор может ошибаться, пытаясь понять, модифицируется переменная в теле функции или нет. Если вы заметили явно ложное срабатывание, просьба прислать нам соответствующий пример кода.
Вы также можете комментарий "//-V669", чтобы подавить ложное предупреждение в конкретном месте.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V669. |
Анализатор обнаружил возможную ошибку в списке инициализации конструктора класса. Согласно стандарту порядок инициализация членов класса в конструкторе происходит в порядке их объявления в классе. В программе есть конструктор, где инициализация одного члена класса зависит от другого. При этом используемая для инициализации переменная, в этот момент ещё не инициализирована.
Рассмотрим пример такого конструктора:
class Foo
{
int foo;
int bar;
Foo(int i) : bar(i), foo(bar + 1) { }
};Переменная 'foo' будет инициализироваться первой! В этот момент переменная 'bar' еще не инициализирована. Для исправления ошибки следует перенести объявление члена класса 'foo' выше объявления члена класса 'bar'. Исправленный вариант кода:
class Foo
{
int bar;
int foo;
Foo(int i) : bar(i), foo(bar + 1) { }
};Если изменить последовательность полей в классе нельзя, то следует изменить выражения для инициализации:
class Foo
{
int foo;
int bar;
Foo(int i) : bar(i), foo(i + 1) { }
};Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V670. |
Анализатор обнаружил потенциальную ошибку, которая может возникнуть при вызове функции с именем 'swap'. В функцию переданы одинаковые фактические аргументы. Передача для этой функции одного и того же аргумента очень подозрительная ситуация. Скорее всего, произошла опечатка.
Пример некорректного кода:
int arg1, arg2;
....
swap(arg1, arg1);
....Из-за опечатки функция swap() обменивает значение переменной 'arg1' само с собой. Корректным вариантом кода должно было быть:
swap(arg1, arg2);Так же подозрительным анализатор будет считать следующий код:
MyClass arg1, arg2;
....
arg1.Swap(arg1);
....Исправить его можно аналогичным образом:
arg1.Swap(arg2);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V671. |
Анализатор обнаружил возможную ошибку в программе, связанную с объявлением переменной, с таким же именем, что и один из аргументов. Если аргумент является ссылкой, то эта ситуация очень подозрительна. Анализатор накладывает и другие условия, чтобы сократить количество ложных срабатываний, но описывать их в документации не имеет смысла.
Что бы лучше понять данный вид ошибки, рассмотрим пример:
bool SkipFunctionBody(Body*& body, bool t)
{
body = 0;
if (t)
{
Body *body = 0;
if (!SkipFunctionBody(body, true))
return false;
body = new Body(body);
return true;
}
return false;
}Для работы функции с функцией SkipFunctionBody () потребовалась временная переменная. Из-за невнимательности в блоке 'if' повторно объявляется временная переменная с именем 'body'. Это значит что аргумент 'body' не будет модифицирован внутри блока 'if'. Вместо него будет изменена локальная переменная. При выходе из функции значение переменной 'body' всегда будет равно NULL. Ошибка может проявиться не в данном месте программы, а где то далее, когда произойдет разыменование нулевого указателя. Для исправления ошибки следует создавать локальную переменную с другим именем. Корректный вариант кода:
bool SkipFunctionBody(Body*& body, bool t)
{
body = 0;
if (t)
{
Body *tmp_body = 0;
if (!SkipFunctionBody(tmp_body, true))
return false;
body = new Body(tmp_body);
return true;
}
return false;
}Взгляните на примеры ошибок, обнаруженных с помощью диагностики V672. |
Анализатор обнаружил потенциальную ошибку в выражении, где используются операции сдвига (shift operations). В процессе сдвига возникает переполнение, и значения старших бит будут потеряны.
Для начала рассмотрим эту ситуацию на простом примере:
std::cout << (77u << 26);Значение выражения 77u << 26 равно 5167382528 (0x134000000). При этом выражение 77u << 26 имеет тип unsigned int. Это значит, что старшие биты будут отброшены, и на экран будет напечатано значение 872415232 (0x34000000).
Переполнения, возникающие при сдвигах, часто указывают на наличие логической ошибки или просто опечатки. Например, может быть, что число 77u хотели задать в восьмеричной системе счисления. Тогда корректный код должен выглядеть так:
std::cout << (077u << 26);Здесь переполнения уже не возникает. Значение выражения 077u << 26 равно 4227858432 (0xFC000000).
Если хочется распечатать на экране значение 5167382528, то число 77 должно быть задано с помощью 64-битного типа. Например, так:
std::cout << (77ui64 << 26);Перейдём к случаям, с которыми можно встретиться на практике. Для этого рассмотрим две ошибки, обнаруженные в реальных приложениях.
Первый пример.
typedef __UINT64 Ipp64u;
#define MAX_SAD 0x07FFFFFF
....
Ipp64u uSmallestSAD;
uSmallestSAD = ((Ipp64u)(MAX_SAD<<8));Программист хотел записать в 64-битную переменную uSmallestSAD значение 0x7FFFFFF00. Но на самом деле переменная будет иметь значение 0xFFFFFF00. Старшие биты будут отброшены, так как выражение MAX_SAD<<8 имеет тип int. Программист знал про это, поэтому решил использовать явное приведение типа, но ошибся, расставляя скобки. Этот пример хорошо демонстрирует, что подобные ошибки могут возникать из-за простой опечатки. Корректный код:
uSmallestSAD = ((Ipp64u)(MAX_SAD))<<8;Второй пример.
#define MAKE_HRESULT(sev,fac,code) \
((HRESULT) \
(((unsigned long)(sev)<<31) | \
((unsigned long)(fac)<<16) | \
((unsigned long)(code))) )
*hrCode = MAKE_HRESULT(3, FACILITY_ITF, messageID);Функция должна сформировать информацию об ошибке в переменной типа HRESULT. Для этого программист использовал макрос MAKE_HRESULT, но сделал это неправильно, посчитав, что первый параметр severity может лежать в приделах от 0 до 3. Вероятно, он перепутал это со способом формирования кодов ошибки, используемых при работе с функциями GetLastError()/SetLastError().
Макрос MAKE_HRESULT в качестве первого аргумента может принимать только 0 (success) или 1 (failure). Подробнее этот вопрос рассматривался на форуме сайта CodeGuru: Warning! MAKE_HRESULT macro doesn't work.
Так как в качестве первого фактического аргумента используется число 3, то возникает переполнение. Число 3 "превратится" в 1. Из-за этой случайности ошибка не повлияет на работу программы. Однако приведённый пример показывает, что нередко код работает исключительно благодаря везению, а не потому, что написан правильно.
Правильный код:
*hrCode = MAKE_HRESULT(SEVERITY_ERROR, FACILITY_ITF, messageID);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V673. |
Анализатор обнаружил потенциальную ошибку в выражении, где совместно используются целочисленные и real-типы данных. Под real-типами понимаются такие типы, как float/double/long double.
Рассмотрим для начала самый простой случай. Литерал, имеющий тип 'double' неявно приводится к целочисленному типу. Это может указывать на наличии программной ошибки.
int a = 1.1;Этот код не имеет практического смысла. Скорее всего, переменная должна была быть инициализирована другим значением.
Показанный выше пример надуманный и не интересен. Давайте посмотрим, как проявляет себя эта ошибка на практике.
Пример 1.
int16u object_layer_width;
int16u object_layer_height;
if (object_layer_width == 0 ||
object_layer_height == 0 ||
object_layer_width/object_layer_height < 0.1 ||
object_layer_width/object_layer_height > 10)Здесь целочисленное значение сравнивается с константой '0.1'. Это очень подозрительно. Предположим, что переменные имеют следующие значения:
Программист ожидает, что при делении этих чисел результат будет равен '0.2'. Это подходящее значение, так оно попадает в диапазон [0.1..10].
На самом деле, результат деления будет равен 0. Деление осуществляется над целочисленными типами данных. Потом, при сравнении с '0.1' произойдет расширение до типа 'double', но будет уже поздно. Чтобы исправить код необходимо заранее использовать явное приведение типов:
if (object_layer_width == 0 ||
object_layer_height == 0 ||
(double)object_layer_width/object_layer_height < 0.1 ||
(double)object_layer_width/object_layer_height > 10.0)Второй пример.
// be_aas_reach.c
ladderface1vertical =
abs( DotProduct( plane1->normal, up ) ) < 0.1;Аргумент функции abs() имеет тип 'double'. На первый взгляд, код кажется абсолютно правильным и хочется заявить "анализатор здесь сглупил".
Но давайте разберёмся более детально. Давайте посмотрим, как объявлена функция abs() в заголовочных файлах.
int __cdecl abs( int _X);
#ifdef __cplusplus
extern "C++" {
inline long __CRTDECL abs(__in long _X) { .... }
inline double __CRTDECL abs(__in double _X) { .... }
inline float __CRTDECL abs(__in float _X) { .... }
}
#endifДа, в Си++ функции abs() перегружены для различных типов. Однако, мы имеем дело с кодом на языке Си (файл be_aas_reach.c).
Это значит, что выражение типа 'float' будет неявно преобразовано к типу 'int'. И результат работы функции abs() тоже будет иметь тип 'int'. Значение типа 'int' нет смысла сравнивать с '0.1'. Об этом и предупреждает анализатор.
В программах на языке Си для правильного вычисления модуля потребуется другая стандартная функция:
double __cdecl fabs(__in double _X);Исправленный код:
ladderface1vertical =
fabs( DotProduct( plane1->normal, up ) ) < 0.1;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V674. |
Анализатор обнаружил попытку записи в память, которая предназначена только для чтения.
Рассмотрим пример.
char *s = "A_string";
if (x)
s[0] = 'B';Здесь указатель 's' ссылается на область памяти, предназначенной только для чтения. Изменение этой памяти приведёт к неопределённому поведению программы. Скорее всего, это неопределенное поведение программы будет представлять собой access violation.
Исправленный вариант программы:
char s[] = "A_string";
if (x)
s[0] = 'B';На стеке создастся массив 's' и в него будет скопирована строка из read-only памяти. Теперь строку 's' можно изменять.
P.S.
Если "A_string" представляет собой "const char *", то почему этот тип неявно приводится к "char *"?
Такое поведение существует из-за соображений совместимости. Было написано ОЧЕНЬ много кода на Си, где используются не константные указатели. Разработчики стандарта/компиляторов не нашли в себе силы в этом месте сломать обратную совместимость с имеющимся кодом.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V675. |
Анализатор обнаружил, что значение типа BOOL сравнивается с константой TRUE (или 1). Это является потенциальной ошибкой, так как значение "истина" может быть любым числом, отличным от нуля.
Для начала вспомним, в чем отличие типа 'bool' и 'BOOL'.
Конструкция вида:
bool x = ....;
if (x == true) ....совершенно корректна. Тип 'bool' может принимать только два значения: true и false.
В случае с типом BOOL такие проверки недопустимы. Тип BOOL представляет на самом деле тип 'int'. Это значит, что он может хранить значения, отличные от нуля и единицы. Любое значение, отличное от нуля считается "истинным".
Отличные от 1 значения могут возвращаться, например, функциями из Windows SDK.
Константы FALSE/TRUE объявлены следующим образом:
#define FALSE 0
#define TRUE 1Это значит, что следующее сравнение может дать сбой:
BOOL ret = Some_SDK_Function();
if (TRUE == ret)
{
// do something
}Нет гарантии, что функция Some_SDK_Function() вернет именно единицу, если будет успешно выполнена. Правильно будет написать:
if (FALSE != ret)или:
if (ret)По данной тематике также можно порекомендовать познакомиться с FAQ на сайте CodeGuru: Visual C++ General: What is the difference between 'BOOL' and 'bool'?
В реальном приложении, ошибка может выглядеть следующим образом:
if (CDialog::OnInitDialog() != TRUE )
return FALSE;В описании функции CDialog::OnInitDialog() сказано: "If OnInitDialog returns nonzero, Windows sets the input focus to the default location, the first control in the dialog box. The application can return 0 only if it has explicitly set the input focus to one of the controls in the dialog box."
Обратите внимание, нигде не сказано про TRUE или про 1. Правильный код:
if (CDialog::OnInitDialog() == FALSE)
return FALSE;Этот код может долго и успешно работать, но нет никакой гарантии, что так будет всегда.
Относительно ложных срабатываний. Иногда, программист точно знает, что переменная типа BOOL всегда будет иметь значение 0 или 1. В этом случае, можно подавить ложное срабатывание, одним из нескольких методов. Однако, намного лучше все-таки поправить код. Код станет более надежен по отношению к будущим рефакторингам.
Близкой по смыслу к этой диагностике является V642.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V676. |
Анализатор обнаружил, что в программе объявляется один из стандартных типов данных. Это избыточный код, который потенциально может привести к ошибкам. Следует использовать системные файлы, где объявлены соответствующие типы.
Рассмотрим пример некорректного объявления типа:
typedef unsigned *PSIZE_T;Тип PSIZE_T объявлен как указатель на тип 'unsigned'. Такое объявление может привести к проблемам при попытке собрать 64-битное приложение. Программа не скомпилируется или будет вести себя не так, как задумано. В файле "BaseTsd.h" тип PSIZE_T объявлен следующим образом: "typedef ULONG_PTR SIZE_T, *PSIZE_T;". Однако следует не менять объявление типа, а включить соответствующий заголовочный файл.
Корректный код:
#include <BaseTsd.h>Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V677. |
Анализатор обнаружил вызов нестатической функции-члена класса, которой одним из аргументов передали этот же объект, на котором она была вызвана.
Рассмотрим пример:
A.Foo(A);Есть вероятность, что этот подозрительный код содержит ошибку. Например, из-за опечатки используется неверное имя переменной. Тогда, корректный код должен был быть таким:
A.Foo(B);или таким:
B.Foo(A);Давайте посмотрим, как такие опечатки проявляют себя на практике. Код реального приложения:
CXMLAttribute* pAttr1 =
m_pXML->GetAttribute(CXMLAttribute::schemaName);
CXMLAttribute* pAttr2 =
pXML->GetAttribute(CXMLAttribute::schemaName);
if ( pAttr1 && pAttr2 &&
!pAttr1->GetValue().CompareNoCase(pAttr1->GetValue()))
....Этот код должен сравнивать два атрибута. Но из-за опечатки, значение "pAttr1->GetValue()" сравнивается само с собой.
Корректный код:
if ( pAttr1 && pAttr2 &&
!pAttr1->GetValue().CompareNoCase(pAttr2->GetValue()))Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V678. |
Анализатор обнаружил ситуацию, когда неинициализированная переменная передаётся в функцию по ссылке или по указателю. При этом функция читает значение из этой неинициализированной переменной.
Рассмотрим пример.
void Copy(int &x, int &y)
{
x = y;
}
void Foo()
{
int x, y;
x = 1;
Copy(x, y);
}Это конечно очень простой придуманный пример. Однако он хорошо показывает суть ошибки. Переменная 'y' является неинициализированной. Ссылка на эту переменную передаётся в функцию Copy(). Там происходит чтение из этой неинициализированной переменной.
Корректный код, может выглядеть так:
void Copy(int &x, int &y)
{
x = y;
}
void Foo()
{
int x, y;
y = 1;
Copy(x, y);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил подозрительную конструкцию, при которой подразумевалось освобождение памяти для произвольного числа указателей, но будет освобождена память только для первого.
Рассмотрим пример:
delete p1, p2;Такую конструкцию мог написать неопытный программист или человек давно не работавший с языком Си++. На первый взгляд, может показаться, что этот код должен удалить два объекта, адреса которых хранятся в указателях 'p1' и 'p2'. На самом деле, здесь два оператора. Первый - оператор 'delete'. Второй - оператор запятая ','.
В начале, выполнится оператор 'delete'. Затем, оператор запятая ',' вернет значение второго аргумента (а именно, 'p2').
Другими словами, этот код эквивалентен: (delete p1), p2;
Корректный код, должен выглядеть так:
delete p1;
delete p2;Примечание. Анализатор не выдает сообщение, если оператор запятая используется в практических целях. Пример безопасного кода:
if (x)
delete p, p = nullptr;После удаления объекта указатель обнуляется. Чтобы не писать фигурные скобки, два действия были объединены с помощью оператора запятая ','.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциальную ошибку, связанную с последовательностью вызова функций.
Согласно стандарту языка Си++, не определена последовательность вычисления фактических аргументов функции. Для выражения 'A(B(), C())' нельзя сказать, вызовется в начале функция 'B()' или 'C()'. Какая функция будет вызвана первой, зависит от компилятора, параметров компиляции и так далее.
Изредка, это может порождать проблемы. Анализатор выдает предупреждения на код, который выглядит наиболее подозрительно. К сожалению, набор случаев, когда выдаётся предупреждение, сознательно сильно ограничен. Это сделано для того, чтобы он не выдавал ложные срабатывания. Уж очень часто, в качестве фактических аргументов используется вызовы других функций. И в большинстве случаев это безопасно.
Пример кода, для которого PVS-Studio выдаст предупреждение:
Point ReadPoint()
{
return Point(ReadFixed(), ReadFixed());
}Этот код может привести к тому, что значение X и Y могут быть перепутаны. Неизвестно, какой из аргументов начнет вычисляться первым.
Корректный код:
Point ReadPoint()
{
float x = ReadFixed();
return Point(x, ReadFixed());
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V681. |
Анализатор обнаружил потенциальную ошибку, связанную с использованием прямого слеша.
Легко ошибиться и перепутать прямой и обратный слеш.
Пример:
if (x == '/n')Программист планировал сравнить переменную 'x' с кодом 0xA (перевод строки). Но он ошибся и использовал прямой слеш. В результате, переменная сравнивается со значением 0x2F6E.
Корректный код:
if (x == '\n')Такую ошибку можно допустить при работе со следующими управляющими последовательностями символов (escape sequences):
Анализатор обнаружил потенциальную ошибку в цикле. Возможно, из-за опечатки увеличивается/уменьшается не та переменная.
Пример подозрительного кода:
void Foo(float *Array, size_t n)
{
for (size_t i = 0; i != n; ++n)
{
....
}
}Вместо переменной 'i' увеличивается переменная 'n'. В результате, программа ведёт себя не так, как ожидал программист.
Исправленный вариант кода:
for (size_t i = 0; i != n; ++i)Диагностическое правило классифицируется как:
Анализатор обнаружил подозрительное выражение. Выражение написано для того, чтобы изменить определённые биты в переменной. Но значение переменной останется прежним.
Пример подозрительного кода:
MCUCR&=~(0<<SE);Код взят из программы для микроконтроллера ATtiny2313. Бит SE должен быть установлен в единицу для того, чтобы по команде SLEEP микроконтроллер перешел в спящий режим. Чтобы избежать случайного перехода в спящий режим, рекомендуется устанавливать бит SE в единичное состояние непосредственно перед вызовом команды SLEEP и сбрасывать его после пробуждения. Именно такой сброс и хотели сделать после пробуждения. Но из-за опечатки значение регистра MCUCR не изменится. Получается, что хотя программа работает, она менее безопасна, чем могла быть.
Исправленный вариант кода:
MCUCR&=~(1<<SE);Примечание. Иногда возникает множественное ложное предупреждение V684. Как правило, это связано с использованием больших и сложных макросов. Способы подавления ложных срабатываний для макросов описаны в соответствующем разделе документации.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V684. |
Анализатор посчитал подозрительным значение, возвращаемое из функции. В нём используется оператор ',' (запятая). Это не всегда ошибка, но этот код стоит проверить.
Пример подозрительного кода:
int Foo()
{
return 1, 2;
}Функция вернёт значение 2. Наличие числа 1 здесь избыточно и не оказывает никакого влияния на поведение программы.
Если это просто опечатка, то следует убрать лишнюю единицу:
int Foo()
{
return 2;
}Но возможно, здесь скрывается настоящая ошибка. И именно поэтому, анализатор обращает внимание на такие конструкции. Например, вдруг в процессе рефакторинга случайно удалили вызов функции.
Тогда, исправленный вариант кода может быть таким:
int Foo()
{
return X(1, 2);
}Запятая иногда может быть полезна при работе с оператором 'return'. Например, следующий код можно сократить, использую запятую.
Длинный код:
if (A)
{
printf("hello");
return X;
}Сокращённый код:
if (A)
return printf("hello"), X; // Нет предупрежденияМы не считаем короткий вариант кода красивым и не рекомендуем его использовать. Однако, так часто пишут и такой код имеет смысл. Поэтому, анализатор не выдаёт предупреждение, если стоящее слева от запятой выражение, оказывает влияние на работу программы.
Диагностическое правило классифицируется как:
Анализатор обнаружил выражение, которое можно упросить. Иногда это может означать, что выражение содержит логическую ошибку.
Пример подозрительного кода:
int k,n,j;
...
if (n || (n && j))Это выражение избыточное. Если "n==0", то условие всегда ложно. Если "n!=0", то условие всегда истинно. Таким образом, условие не зависит от значения переменной 'j' и его можно упростить:
if (n)Иногда, избыточность означает наличие опечатки. Вдруг, например, на самом деле, условие должно быть таким:
if (k || (n && j))Рассмотрим более реальный пример, благодаря которому и появилась эта диагностика:
const char *Name = ....;
if (Name || (Name && Name[0] == 0))Здесь сразу есть и ошибка и избыточность. Условие должно выполняться, если строка, на которую ссылается указатель 'Name', пустая. Пустая строка может обозначаться нулевым указателем.
Из-за ошибки условие выполнится всегда, если Name != nullptr. Исправленный код:
if (!Name || (Name && Name[0] == 0))Теперь ошибки нет. Но дополнительно можно сократить количество проверок:
if (!Name || Name[0] == 0)Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V686. |
Анализатор обнаружил, что к указателю, прибавляется размер массива. Это подозрительно. Возможно следовало прибавлять значение, равное количеству элементов в массиве, а не его размеру.
Примечание. Безопасным считается работа с массивами, состоящими из байт (char/unsigned char).
Пример ошибки:
int A[10];
...
std::sort(A, A + sizeof(A));Первый аргумент функции - итератор, указывающий на первый элемент сортируемой последовательности.
Второй аргумент функции - итератор, указывающий на элемент, стоящий после последнего сортируемого элемента.
Вызов функции написан с ошибкой. К указателю прибавляется размер массива, в результате чего, функция попытается отсортировать больше данных, чем следует.
Чтобы исправить ошибку, следует прибавлять количество элементов в массиве:
int A[10];
...
std::sort(A, A + sizeof(A) / sizeof(A[0]));Диагностическое правило классифицируется как:
|
Анализатор обнаружил, что имя локальной переменной совпадает с именем члена класса. Часто, это не ошибка. Однако, такой код ОЧЕНЬ опасен. В процессе рефакторинга такого кода, в нём очень легко возникают ошибки. Программист думает, что работает с членом класса, а на самом деле использует локальную переменную.
Пример подозрительного кода:
class M
{
int x;
void F() { int x = 1; foo(x); }
....
};Класс содержит член с именем 'x'. С таким же именем объявляется локальная переменная в функции F().
Когда функция маленькая как в этом примере, всё просто и понятно. И диагностика V688 кажется неинтересной. Но когда функции большие, неудачное именование переменных может доставить массу головной боли разработчикам, сопровождающим код.
Можно исправить ситуацию, используя другое имя для локальной переменной:
class M
{
int x;
void F() { int value = 1; foo(value); }
....
};Или можно использовать прифекс 'm_' для обозначения членов класса:
class M
{
int m_x;
void F() { int x = 1; foo(x); }
....
};Анализатор выдаёт предупреждение не всегда. Он использует некоторые эвристики, чтобы предотвратить ложные срабатывания. Например, этот код анализатор посчитает безопасным:
class M
{
int value;
void SetValue(int value) { this->value = value; }
....
};Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V688. |
Анализатор обнаружил, что умный указатель может неправильно разрушить объект. Причина ошибки в том, что в базовом классе отсутствует виртуальный деструктор.
Рассмотрим пример:
class Base
{
public:
~Base() { }
};
class Derived : public Base
{
public:
Derived()
{
data = new int[5];
}
~Derived()
{
delete [] data;
}
int* data;
};
void GO()
{
std::auto_ptr<Base> smartPtr(new Derived);
}Обратите внимание, что создаётся объект класса 'Derived'. Однако, умный указатель хранит ссылку на класс Base. В классе Base деструктор не является виртуальным. В результате возникнет ошибка, когда умный указатель попробует разрушить объект, отданный ему на хранение.
Исправленный вариант класса Base:
class Base
{
public:
virtual ~Base() { }
};P.S.
Родственным диагностическим сообщением является V599.
Дополнительная информация:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил класс, в котором реализован конструктор копирования, но не реализован 'operator =', или наоборот, реализован 'operator =', но не реализован конструктор копирования.
Работать с такими классами очень опасно. Другими словами, нарушен "Закон Большой Двойки". Про этот закон, будет рассказано ниже.
Рассмотрим пример опасного класса. Пример длинный. Но сейчас важно только то, что в классе есть оператор присваивания, но нет конструктора копирования.
class MyArray
{
char *m_buf;
size_t m_size;
void Clear() { delete [] m_buf; }
public:
MyArray() : m_buf(0), m_size(0) {}
~MyArray() { Clear(); }
void Allocate(size_t s)
{ Clear(); m_buf = new char[s]; m_size = s; }
void Copy(const MyArray &a)
{ Allocate(a.m_size);
memcpy(m_buf, a.m_buf, a.m_size * sizeof(char)); }
char &operator[](size_t i) { return m_buf[i]; }
MyArray &operator =(const MyArray &a)
{ Copy(a); return *this; }
};Оставим в стороне практичность и полезность такого класса. Это всего лишь пример. Нам важно, что вот такой код, будет корректно работать:
{
MyArray A;
A.Allocate(100);
MyArray B;
B = A;
}Массив успешно копируется с помощью оператора присваивания.
Следующий фрагмент кода приведёт к неопределенному поведению. Приложение упадёт или его работа будете нарушена как-то ещё.
{
MyArray A;
A.Allocate(100);
MyArray C(A);
}Дело в том, что в классе не реализован конструктор копирования. При создание объекта 'C', указатель на массив будет просто скопирован. Это приведёт к двоёному освобождению памяти при разрушении объектов A и C.
Аналогичная проблема будет, если реализован конструктор копирования, но нет оператора копирования.
Что-бы исправить класс, следует добавить конструктор копирования:
MyArray &operator =(const MyArray &a)
{ Copy(a); return *this; }
MyArray(const MyArray &a) : m_buf(0), m_size(0)
{ Copy(a); }Если анализатор выдал предупреждение V690, то не ленитесь и реализуйте недостающий метод. Сделайте это, даже если код сейчас работает правильно, и вы помните, об особенностях класса. Пройдёт время, забудется отсутствие operator= или конструктора копирования. И вы или ваш коллега допустите ошибку, которую будет сложно найти. Когда поля класса скопированы автоматически, то часто, такой класс "почти работает". Неприятности проявляют себя позже в сосем другом месте программы.
Как было сказано в начале, диагностика V690 находит классы, в которых нарушен "Закон Большой Двойки". Рассмотрим это подробнее. Но начать надо с "Правило трёх". Обратимся к Wikipedia:
Правило трёх (также известное как "Закон Большой Тройки" или "Большая Тройка") — правило в C++, гласящее, что если класс или структура определяет один из следующих методов, то они должны явным образом определить все три метода:
Эти три метода являются особыми членами-функциями, автоматически создаваемыми компилятором в случае отсутствия их явного объявления программистом. Если один из них должен быть определен программистом, то это означает, что версия, сгенерированная компилятором, не удовлетворяет потребностям класса в одном случае и, вероятно, не удовлетворит в остальных случаях.
Поправка к этому правилу заключается в том, что если используется RAII (от англ. Resource Acquisition Is Initialization), то используемый деструктор может остаться неопределённым (иногда упоминается как "Закон Большой Двойки").
Так как неявно определённые конструкторы и операторы присваивания просто копируют все члены-данные класса, определение явных конструкторов копирования и операторов присваивания копированием необходимо в случаях, когда класс инкапсулирует сложные структуры данных или может поддерживать эксклюзивный доступ к ресурсам. А также в случаях, когда класс содержит константные данные или ссылки.
Сам "Закон Большой Двойки" подробно рассматривается в этой статье: The Law of The Big Two.
Как видите, "Закон Большой Двойки" очень важен и поэтому мы реализовали соответствующую диагностику в анализаторе кода.
Начиная с C++11 появилась семантика перемещения, поэтому это правило расширилось до "Большой пятерки". Список методов, которые нужно определить все, если определён, хотя бы один из них:
Поэтому всё, что справедливо для конструктора/оператора копирования, справедливо и для конструктора/оператора перемещения.
Всегда ли диагностика V690 говорит о наличии проблемы? Нет. Иногда никакой ошибки нет, но есть лишняя функция. Рассмотрим пример из реального приложения:
struct wdiff {
int start[2];
int end[2];
wdiff(int s1=0, int e1=0, int s2=0, int e2=0)
{
if (s1>e1) e1=s1-1;
if (s2>e2) e2=s2-1;
start[0] = s1;
start[1] = s2;
end[0] = e1;
end[1] = e2;
}
wdiff(const wdiff & src)
{
for (int i=0; i<2; ++i)
{
start[i] = src.start[i];
end[i] = src.end[i];
}
}
};В этом классе есть конструктор копирования, но нет оператора присваивания. Но это не страшно. Массивы 'start' и 'end' состоят из простых типов 'int'. Они будут корректно скопированы компилятором. Что-бы устранить предупреждение V690 нужно удалить бессмысленный конструктор копирования. Компилятор построит код, копирует элементы класса не медленней, а возможно даже быстрее.
Исправленный вариант:
struct wdiff {
int start[2];
int end[2];
wdiff(int s1=0, int e1=0, int s2=0, int e2=0)
{
if (s1>e1) e1=s1-1;
if (s2>e2) e2=s2-1;
start[0] = s1;
start[1] = s2;
end[0] = e1;
end[1] = e2;
}
};Взгляните на примеры ошибок, обнаруженных с помощью диагностики V690. |
Если анализатор находит два одинаковых строковых литерала, он пытается понять, является ли это последствием неудачного Copy-Paste. Хочется сразу предупредить, диагностика основана на эмпирическом алгоритме и иногда может выдавать странные ложные срабатывания.
Рассмотрим пример ошибки:
static const wchar_t left_str[] = L"Direction: left.";
static const wchar_t right_str[] = L"Direction: right.";
static const wchar_t up_str[] = L"Direction: up.";
static const wchar_t down_str[] = L"Direction: up.";Код писался с использованием Copy-Paste. В конце забыли изменить строковый литерал "up" на "down". Анализатор заподозрит неладное и укажет на подозрительное слово "up" в последней строчке.
Исправленный код:
static const wchar_t left_str[] = L"Direction: left.";
static const wchar_t right_str[] = L"Direction: right.";
static const wchar_t up_str[] = L"Direction: up.";
static const wchar_t down_str[] = L"Direction: down.";;Взгляните на примеры ошибок, обнаруженных с помощью диагностики V691. |
Анализатор обнаружил интересный паттерн ошибки. Чтобы записать терминальный ноль в конец строки, вычисляют её длину с помощью функции strlen(). Результат такого действия непредсказуем. Ведь для работы функции strlen() строка уже должна заканчиваться терминальным нулём.
Пример некорректного кода:
char *linkname;
....
linkname[strlen(linkname)] = '\0';Этот код не имеет смысла. Ноль будет записан как раз в ту ячейку, где был найден 0. При этом, функция strlen() может выйти далеко за пределы буфера, что приведет неопределенному поведению программы.
Чтобы исправить код, надо вычислить длину строки каким-то другим способом:
char *linkname;
size_t len;
....
linkname[len] = '\0';Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V692. |
Анализатор обнаружил опечатку в условии остановки цикла.
Пример:
for (size_t i = 0; v.size(); ++i)
sum += v[i];Если массив 'v' не является пустым, то возникнет бесконечный цикл.
Исправленный вариант кода:
for (size_t i = 0; i < v.size(); ++i)
sum += v[i];Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V693. |
Анализатор обнаружил очень подозрительное условие. К указателю прибавляется или из указателя вычитается константное значение. Результат сложения/вычитания сравнивается с нулём. Высока вероятность, что в коде имеется опечатка.
Рассмотрим пример со сложением:
int *p = ...;
if (p + 2)Это условие будет всегда истинным. Единственный случай, когда выражение будет равно 0, если специально записать в указатель магическое число "-2".
Исправленный вариант кода:
int *p = ...;
if (*p + 2)Теперь рассмотрим пример с подозрительным вычитанием:
char *begin = ...;
char *end = ...;
....
const size_t ibegin = 1;
....
if (end - ibegin)Из переменной 'end' следовало вычитать переменную 'begin'. Из-за неудачного именования переменных, случайно используется константная переменная 'ibegin', имеющая целочисленный тип.
Исправленный вариант кода:
char *begin = ...;
char *end = ...;
....
if (end - begin)Примечание. Предупреждение выводится только в том случае, если указатель является "настоящим". Например, он указывает на память, выделенную с помощью функции "malloc()". Если анализатор не знает, чему равен указатель, он не выдаст предупреждение, чтобы сократить число ложных срабатываний. Иногда, в указателях действительно передают "магические числа" и условия вида (ptr - 5 == 0) имеют смысл.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V694. |
Анализатор обнаружил потенциальную ошибку в условии. Программа должна совершать различные действия, в зависимости от того, в какой диапазон значений попадает некая переменная.
Для этого в коде используется следующая конструкция:
if ( MIN_A < X && X < MAX_A ) {
....
} else if ( MIN_B < X && X < MAX_B ) {
....
}Анализатор выдаёт предупреждение, если диапазоны, проверяемые в условиях, пересекаются. Пример:
if ( 0 <= X && X < 10)
FooA();
else if ( 10 <= X && X < 20)
FooB();
else if ( 20 <= X && X < 300)
FooC();
else if ( 30 <= X && X < 40)
FooD();Код содержит опечатку. Рука программиста дрогнула, и вместо условия "20 <= X && X < 30" была написано "20 <= X && X < 300". Если переменная X будет хранить, например, значение 35, то будет вызвана функция FooC(), а не FooD().
Исправленный код:
if ( 0 <= X && X < 10)
FooA();
else if ( 10 <= X && X < 20)
FooB();
else if ( 20 <= X && X < 30)
FooC();
else if ( 30 <= X && X < 40)
FooD();Рассмотрим ещё один пример:
const int nv_ab = 5;
const int nv_bc = 10;
const int nv_re = 15;
const int nv_we = 20;
const int nv_tw = 25;
const int nv_ww = 30;
....
if (n < nv_ab) { AB(); }
else if (n < nv_bc) { BC(); }
else if (n < nv_re) { RE(); }
else if (n < nv_tw) { TW(); } // <=
else if (n < nv_we) { WE(); } // <=
else if (n < nv_ww) { WW(); }В зависимости от значения переменной 'n' выполняются различные действия. Из-за неудачных названий переменных, легко запутаться. Так и получилось. В начале надо было сравнить переменную 'n' с 'nv_we', а только затем с 'nv_tw'.
Чтобы ошибка стала понятна, подставим значения констант:
if (n < 5) { AB(); }
else if (n < 10) { BC(); }
else if (n < 15) { RE(); }
else if (n < 25) { TW(); }
else if (n < 20) { WE(); } // Условие никогда не выполняется
else if (n < 30) { WW(); }Исправленный код:
if (n < nv_ab) { AB(); }
else if (n < nv_bc) { BC(); }
else if (n < nv_re) { RE(); }
else if (n < nv_we) { WE(); } // <=
else if (n < nv_tw) { TW(); } // <=
else if (n < nv_ww) { WW(); }Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V695. |
Анализатор обнаружил код, который может ввести в заблуждение программиста. Оператор continue в цикле do { ... } while(0) останавливает цикл, а не возобновляет его.
Вот что говорит стандарт:
§6.6.2 in the standard: "The continue statement (...) causes control to pass to the loop-continuation portion of the smallest enclosing iteration-statement, that is, to the end of the loop." (Not to the beginning.)
Таким образом, после вызова оператора continue будет проверено условие (0) и цикл завершится, так как условие ложно.
Рассмотрим пример:
int i = 1;
do {
std::cout << i;
i++;
if(i < 3) continue;
std::cout << 'A';
} while(false);Программист может ожидать, что программа напечатает 12A. На самом деле будет напечатано 1.
Если именно так задумано и ошибки нет, то код всё равно лучше изменить. Можно воспользоваться оператором break:
int i=1;
do {
std::cout << i;
i++;
if(i < 3) break;
std::cout << 'A';
} while(false);Код стал более понятным. Сразу видно, что если условие (i < 3) выполняется, то цикл будет остановлен. Анализатор не будет выдавать предупреждение на этот код.
Если код некорректен, то его следует переписать. Здесь нельзя дать точных рекомендаций, всё зависит от логики работы кода. Например, чтобы напечатать 12A, лучше написать:
for (i = 1; i < 3; ++i)
std::cout << i;
std::cout << 'A';Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V696. |
Количество элементов в массиве, выделяемого с помощью оператора 'new' равно размеру указателя в байтах. Это очень подозрительный участок кода.
Рассмотрим пример, как в программе может появиться такой код. В начале, в программе был фиксированный массив, состоящий из байт. Необходимо создать массив такого-же размера, но из элементов float. В результате был написан следующий код:
void Foo()
{
char A[10];
....
float *B = new float[sizeof(A)];
....
}Оставим в стороне качество этого кода. Главное, что в процессе рефакторинга, массив 'A' стал тоже динамическим. Фрагмент, где создаётся массив 'B' изменить забыли. В результате, появляется следующий некорректный код:
void Foo(size_t n)
{
char *A = new char[n];
....
float *B = new float[sizeof(A)];
....
}Количество элементов в массиве 'B' равно 4 или 8, в зависимости от разрядности платформы. Именно эту ситуацию и выявит анализатор кода.
Исправленный вариант кода:
void Foo(size_t n)
{
char *A = new char[n];
....
float *B = new float[n];
....
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил в коде сравнение результата функции strcmp() или ей подобной с единицей или с минус единицей. В свою очередь, в спецификации языков C/С++ сказано, что функция strcmp() может вернуть любое положительное или любое отрицательное значение в случае неравенства строк, не только единицу или минус единицу.
В зависимости от реализации, функция strcmp() может в результате неравенства строк возвращать:
Работоспособность конструкций вида strcmp() == 1 зависит от библиотек, компилятора, его настроек, операционной системы, её разрядности и так далее; требуется всегда в таком случае писать strcmp() > 0.
В качестве примера можно привести следующий некорректный код:
std::vector<char *> vec;
....
std::sort(vec.begin(), vec.end(), [](
const char * a, const char * b)
{
return strcmp(a, b) == 1;
});При смене компилятора, целевой операционной системы или разрядности компилируемого приложения данный код может начать работать некорректно.
Исправленный вариант кода:
std::vector<char *> vec;
....
std::sort(vec.begin(), vec.end(), [](
const char * a, const char * b)
{
return strcmp(a, b) > 0;
});Анализатором также считает код ошибочным, если в нём сравнивается результат работы двух strcmp() функций. Подобный код встречается крайне редко, однако на него в любом случае стоит обратить внимание.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V698. |
Анализатор обнаружил в коде выражение вида 'foo = bar = baz ? xyz : zzy'. Вполне возможно, что это является ошибкой: имелось в виду выражение вида 'foo = bar == baz ? xyz : zzy', однако по недосмотру программиста вместо сравнения выполняется присваивание.
В качестве примера можно привести следующий некорректный код:
int newID = currentID = focusedID ? focusedID : defaultID;Программист совершил ошибку и вместо оператора сравнения написал оператор присваивания. Исправленный вариант кода выглядит следующим образом:
int newID = currentID == focusedID ? focusedID : defaultID;Отметим, что приведённый ниже код не вызовет предупреждения, поскольку выражение перед тернарным оператором явно имеет тип bool, из-за чего анализатор предполагает, что именно так и было задумано.
result = tmpResult = someVariable == someOtherVariable? 1 : 0;Этот код достаточно очевиден. Он эквивалентен следующему более многословному коду:
if (someVariable == someOtherVariable)
tmpResult = 1;
else
tmpResult = 0;
result = tmpResult;Диагностическое правило классифицируется как:
|
Анализатор обнаружил в коде выражение вида 'T foo = foo = X'. Переменная при инициализаторе сама же участвует в присваивании. В отличие от диагностики V573, переменная foo является инициализированной выражением X, однако этот код является крайне подозрительным: скорее всего, имелось в виду что-то другое.
В качестве примера можно привести следующий некорректный код:
int a = a = 3;Сложно сказать, что имелось в виду в этом случае. Возможно, корректный код выглядит так:
int a = 3;Также возможно, что подразумевалось инициализация через присваивание значения некоторой другой переменной:
int a = b = 3;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V700. |
Анализатор обнаружил в коде выражение вида 'foo = realloc(foo, ...)'. Данное выражение является потенциально опасным: рекомендуется результат функции realloc сохранять в другой переменной.
Функция realloc(ptr, ...) производит изменение размера некоторого блока памяти. В случае, если размер блока памяти изменить удалось, не прибегая к перемещению данных, результирующий указатель совпадёт с исходным ptr. В случае, если изменение размера блока памяти осуществить невозможно без его перемещения, функция вернёт указатель на новый блок памяти, а старый блок памяти будет освобождён. Однако в том случае, если изменение размера блока памяти в данный момент вообще невозможно даже с перемещением, функция вернёт нулевой указатель. Такая ситуация может возникнуть в случае выделения большого массива данных, размер которого сопоставим с размером ОЗУ компьютера, а также при сильной сегментации памяти. Этот случай и является потенциально опасным: если realloc(ptr, ...) возвращает нулевой указатель, блок данных по адресу ptr не изменяет своего размера. Главная проблема заключается в том, что при использовании конструкции вида "ptr = realloc(ptr, ...)" указатель ptr на этот блок данных будет утерян.
В качестве примера можно привести следующий некорректный код, взятый из реального приложения:
void buffer::resize(unsigned int newSize)
{
if (capacity < newSize)
{
capacity = newSize;
ptr = (unsigned char *)realloc(ptr, capacity);
}
}Функция realloc(...) производит изменение размера буфера в случае, если требуемый размер буфера больше текущего. Однако, что случится, если realloc() не сможет выделить память? В результат ptr будет помещён NULL, что само по себе может привести к многочисленным проблемам, но более того: указатель на исходную область памяти будет утерян. Корректный код будет выглядеть следующим образом:
void buffer::resize(unsigned int newSize)
{
if (capacity < newSize)
{
capacity = newSize;
unsigned char * tmp = (unsigned char *)realloc(ptr, capacity);
if (tmp == NULL)
{
/* Handle exception; maybe throw something */
} else
ptr = tmp;
}
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V701. |
Анализатор обнаружил класс, унаследованный от класса std::exception (или аналогичных классов) через модификатор private или protected. Данное наследование опасно тем, что при непубличном наследовании при попытке поймать исключение std::exception оно будет пропущено.
Ошибка часто возникает из-за того, что забывают указать тип наследования. В соответствии с правилами языка, наследование по умолчанию - приватное. Как результат, обработчики исключений ведут себя не так, как задумывалось.
В качестве примера можно привести следующий некорректный код:
class my_exception_t : std::exception // <=
{
public:
explicit my_exception_t() { }
virtual const int getErrorCode() const throw() { return 42; }
};
....
try
{ throw my_exception_t(); }
catch (const std::exception & error)
{ /* Can't get there */ }
catch (...)
{ /* This code executed instead */ }Код, который должен будет перехватывать все стандартные и пользовательские исключения "catch (const std::exception & error)", не сможет отработать правильно, потому что приватное наследование исключает неявное преобразование типов.
Для того, чтобы код работал корректно, требуется добавить перед родительским классом std::exception в списке базовых классов модификатор public:
class my_exception_t : public std::exception
{
....
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V702. |
Анализатор обнаружил в коде класса-наследника поле, совпадающее по типу и по имени с некоторым полем родительского класса. Такое объявление может быть ошибочным. Технология наследования сама по себе предполагает наличие всех полей родительского класса в дочернем. При объявлении в наследнике поля с таким же именем вносится путаница и усложняется жизнь программистам, которые будут сопровождать код.
В качестве примера можно привести следующий некорректный код:
class U {
public:
int x;
};
class V : public U {
public:
int x; // <=
int z;
};Данный код может быть опасен, поскольку теперь в классе V существует две переменных x: собственно V::x и U::x. Последствия, к которым это может привести, могут быть проиллюстрированы следующим кодом:
int main() {
V vClass;
vClass.x = 1;
U *uClassPtr = &vClass;
std::cout << uClassPtr->x << std::endl; // <=
....
}Здесь будет произведена печать неинициализированной переменной.
Для исправления проблемы достаточно удалить объявление переменной в классе-наследнике. Корректный код приведён ниже:
class U {
public:
int x;
};
class V : public U {
public:
int z;
};Существует некоторое количество спорных случаев, которые анализатором не считаются ошибочными:
static;private;#define;Рекомендуем всегда проводить рефакторинг кода, где анализатор выдаёт предупреждение V703. Использование переменной с одним именем в базовом классе и в наследнике далеко не всегда является ошибкой. Однако такой код очень опасен, и даже если сейчас программа корректно работает, в дальнейшем при модификации классов очень легко допустить ошибку.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V703. |
Анализатор обнаружил в коде выражение вида this == 0. Данное выражение может оказаться работоспособным в ряде случаев, однако его использование крайне опасно по некоторым соображениям.
Рассмотрим простой пример:
class CWindow {
HWND handle;
public:
HWND GetSafeHandle() const
{
return this == 0 ? 0 : handle;
}
};Вызов метода CWindow::GetSafeHandle() для нулевого указателя this по стандарту С++ ведёт к неопределённому поведению. Однако, поскольку во время работы метода не производится доступа к полям этого класса, метод может работать. С другой стороны, существует два возможных неблагоприятных сценария выполнения данного кода. Во-первых, согласно стандарту С++, указатель this никогда не может быть нулевым; следовательно, компилятор может оптимизировать вызов метода, упростив его до:
return handle;Во-вторых, предположим, что существует следующий код:
class CWindow {
.... // CWindow из предыдущего примера
};
class MyWindowAdditions {
unsigned long long x; // 8 bytes
};
class CMyWindow: public MyWindowAdditions, public CWindow {
....
};
....
void foo()
{
CMyWindow * nullWindow = NULL;
nullWindow->GetSafeHandle();
}Этот код приведёт к чтению из памяти по адресу 0x00000008. В этом можно убедиться, написав следующую строку:
std::cout << nullWindow->handle << std::endl;Будет выведен адрес 0x00000008, поскольку исходный указатель NULL (0x00000000) был скорректирован таким образом, чтобы указывать на начало подобъекта класса CWindow. Для этого его надо сместить на sizeof(MyWindowAdditions) байт.
Теперь проверка this == 0 полностью теряет смысл. Указатель thisвсегда по меньшей мере равен значению 0x00000008.
С другой стороны, ошибка не проявит себя, если поменять местами базовые классы в объявлении CMyWindow:
class CMyWindow: public CWindow, public MyWindowAdditions{
....
};Всё это может приводить к крайне неочевидным ошибкам.
Исправление кода достаточно нетривиально. Корректным выходом в данном случае будет изменение метода класса на статический. Это повлечёт за собой большое количество изменений во всех местах, где встречался вызов метода.
class CWindow {
HWND handle;
public:
static HWND GetSafeHandle(CWindow * window)
{
return window == 0 ? 0 : window->handle;
}
};Второй вариант — использование паттерна Null Object, что тоже повлечёт за собой значительный объём работ.
class CWindow {
HWND handle;
public:
HWND GetSafeHandle() const
{
return handle;
}
};
class CNullWindow : public CWindow {
public:
HWND GetSafeHandle() const
{
return nullptr;
}
};
....
void foo(void)
{
CNullWindow nullWindow;
CWindow * windowPtr = &nullWindow;
// Выведет 0
std::cout << windowPtr->GetSafeHandle() << std::endl;
}Примечание. Данный дефект опасен тем, что на его обработку почти никогда нет времени, поскольку "всё и так работает", а затраты на рефакторинг велики. Однако то, что работало годами, может неожиданно дать сбой при малейшем изменении условий: сборка под другую ОС, изменение версии компилятора (в том числе и его обновление) и так далее.
Например: начиная с версии 4.9.0, компилятор GCCнаучился выбрасывать проверку на неравенство нулю разыменованного выше по коду указателя (см. диагностику V595):
int wtf( int* to, int* from, size_t count ) {
memmove( to, from, count );
if( from != 0 ) // <= после оптимизации условие всегда истинно
return *from;
return 0;
}Примеров проблемного кода из реальных приложений, оказавшегося "сломанным" из-за undefined behavior, достаточно много. Вот некоторые из них, чтобы подчеркнуть важность проблемы:
Пример N1. Уязвимость в ядре Linux
struct sock *sk = tun->sk; // initialize sk with tun->sk
....
if (!tun) // <= всегда false
return POLLERR; // if tun is NULL return errorПример N2. Некорректная работа srandomdev():
struct timeval tv;
unsigned long junk; // <= Не инициализирована специально
gettimeofday(&tv, NULL);
// LLVM: аналог srandom() от неинициализированной переменной,
// т.е. tv.tv_sec, tv.tv_usec и getpid() не учитываются.
srandom((getpid() << 16) ^ tv.tv_sec ^ tv.tv_usec ^ junk);Пример N3. Синтетический пример, очень наглядно показывающий и возможности компиляторов по агрессивной оптимизации в связи с undefined behavior, и новые возможности "прострелить себе ногу":
#include <stdio.h>
#include <stdlib.h>
int main() {
int *p = (int*)malloc(sizeof(int));
int *q = (int*)realloc(p, sizeof(int));
*p = 1;
*q = 2;
if (p == q)
printf("%d %d\n", *p, *q); // <= Clang r160635: Вывод: 1 2
}Насколько нам известно, на момент выхода этой диагностики вызов проверки this == 0 ещё не проигнорирован ни одним компилятором, однако в стандарте С++ явным образом написано (§9.3.1/1): "If a nonstatic member function of a class X is called for an object that is not of type X, or of a type derived from X, the behavior is undefined.". Иными словами, результат вызова любой нестатической функции для класса с this == 0 не определён. Это лишь дело времени, когда компиляторы начнут вместо (this == 0) подставлять false на этапе компиляции.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V704. |
Данная диагностика похожа на диагностику V628, однако относится к ветви else оператора if. Анализатор обнаружил подозрительное место в коде – возможно, забытый или некорректно закомментированный блок else.
Данную ситуацию лучше всего разобрать на примерах.
if (!x)
t = x;
else
z = t;В данном примере форматирование кода не совпадает с его логикой: выражение z = t выполнится лишь в случае, если (x == 0) – вряд ли это имелось в виду. Подобная же ситуация может возникнуть при неудачно закомментированном фрагменте кода:
if (!x)
t = x;
else
//t = -1;
z = t;В данном случае требуется либо исправить форматирование, превратив его в более удобочитаемое, либо исправить логическую ошибку, добавив недостающую ветвь оператора if.
Правда, иногда существуют случаи, в которых тяжело определить, является ли подобный код некорректным или таким образом стилизованным. Анализатор пытается уменьшать количество ложных срабатываний, связанных со стилизацией, путём некоторого эвристического анализа. К примеру, следующий код не приведёт к срабатыванию диагностического правила:
if (x == 1)
t = 42;
else
if (x == 2)
t = 84;
else
#ifdef __extended__x
if (x == 3)
t = 741;
else
#endif
t = 0;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V705. |
Анализатор обнаружил в коде подозрительное деление результата оператора sizeof() на другой оператор sizeof() или число. Причём оператор sizeof() применяется к массиву и размер элемента не совпадает с значением делителя. Скорее всего, в коде присутствует ошибка.
Пример:
size_t A[10];
n = sizeof(A) / sizeof(unsigned);В режиме сборки 32-битной программы типы unsigned и size_t совпадают по своему размеру и 'n' будет равно десяти. Однако в режиме сборки 64-битной программы тип size_t имеет размер 8 байт, а тип unsigned имеет размер всего 4 байта. В итоге в переменную n будет записано число 20, что вряд ли является тем, чего хотел программист.
Также ошибочным будет считаться код следующего вида:
size_t A[9];
n = sizeof(A) / 7;Размер массива в случае компиляции 32-битной программы равен 4 * 9 = 36 байтам. Делить 36 на 7 очень странно. Что хотел программист? С эти кодом что-то не так.
Какие-то конкретные рекомендации в этом случае давать сложно, поскольку каждый случай требует индивидуального подхода - возможно, изменился размер типа, размер массива задан с ошибкой и так далее. Часто это ошибка бывает последствием опечатки или простой невнимательности.
Анализатор не будет выдавать предупреждение, если массив имеет тип char или uchar, поскольку подобные массивы часто используются в качестве буферов для хранения каких-либо данных другого типа. Пример кода, который анализатор считает безопасным:
char A[9];
n = sizeof(A) / 3;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V706. |
Анализатор обнаружил в коде глобально объявленную переменную с коротким именем. Это, если и не приведёт к ошибкам, то является плохим стилем программирования и усложняет понимание программы.
Начнём с примера:
int i;Проблема в коротких именах переменных заключается в том, что достаточно легко ошибиться и использовать вместо локальной переменной глобальную внутри тела функции или метода класса. Например, вместо
void MyFunc()
{
for (i = 0; i < N; i++)
AnotherFunc();
....
}должно быть:
void MyFunc()
{
for (int i = 0; i < N; i++)
AnotherFunc();
....
}В данных ситуациях анализатор будет предлагать изменить имя переменной на более длинное. Минимальная длина, которая не является подозрительной для анализатора - три символа. Также анализатор не будет выдавать предупреждения на переменные с именами PI, SI, CR, LF.
Анализатор не выдаёт предупреждения на переменные с коротким именем, если они представляют собой структуры. Хотя это тоже плохой стиль кодирования, но случайно неправильно использовать структуру сложнее. Например, если случайно написать так:
struct T { int a, b; } i;
void MyFunc()
{
for (i = 0; i < N; i++)
AnotherFunc();
....
}То код просто не скомпилируется.
А вот на константы с короткими именами анализатор ругается. Их нельзя менять, но ничто не мешает сделать неправильную проверку. Пример:
const float E = 2.71828;
void Foo()
{
S *e = X[i];
if (E)
{
e->Foo();
}
....
}Исправленный код:
const float E = 2.71828;
void Foo()
{
S *e = X[i];
if (e)
{
e->Foo();
}
....
}Но лучше использовать более длинное имя или обернуть такие константы в специальный namesapce:
namespace Const
{
const float E = 2.71828;
}Взгляните на примеры ошибок, обнаруженных с помощью диагностики V707. |
Анализатор обнаружил в коде программы случай неопределённого поведения, связанного с контейнерами типа map или схожими с ним.
Пример некорректного кода:
std::map<size_t, size_t> m;
....
m[0] = m.size();Этот пример приводит к неопределённому поведению, поскольку порядок вычисления операндов у оператора присваивания не определён. В случае, если в объекте уже существует элемент, ассоциированный с нулём, то проблем не возникнет. Однако в случае его отсутствия действия программы могут пойти по двум различным сценариям в зависимости от версии компилятора, операционной системы и так далее.
Предположим, что компилятор сначала вычисляет правый операнд и лишь потом – левый операнд операции присваивания. Поскольку контейнер пуст, m.size() возвращает ноль. Затем с нулём ассоциируется ноль. В итоге имеем, что m[0] == 0.
Теперь предположим, что компилятор сначала вычисляет левый операнд и лишь потом – правый. Сначала будет взят m[0]. Поскольку с нулём ничего не ассоциировано, будет создана пустая ассоциация. Затем вычисляется m.size(). Поскольку контейнер уже не пуст, m.size() возвращает единицу. После этого единица ассоциируется с нулём. В итоге имеем, что m[0] == 1.
Правильным решением для исправления кода будет использования временной переменной и заранее связать какое-то значение с нулём:
std::map<size_t, size_t> m;
....
m[0] = 0;
const size_t mapSize = m.size();
m[0] = mapSize;Несмотря на то, что данная ситуация может возникать достаточно редко в реальном коде, она опасна тем, что фрагмент кода, приводящий к неопределённому поведению, часто очень сложно выявить.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V708. |
В коде обнаружено логическое выражение вида a == b == c. К сожалению, иногда программисты забывают, что правила языков С и С++ не совпадают с правилами, принятыми в математике (и на первый взгляд – со здравым смыслом) и таким сравнением можно проверить равенство трёх переменных. Однако на самом деле вместо проверки на равенство будет вычислено несколько не то, что хотелось.
Разберём пример.
if (a == b == c) ....Предположим, что a == 2, b == 2 и c == 2. Первое сравнение (a == b) окажется истинным, поскольку 2 == 2. В результате данное сравнение возвращает значение true (1). Второе же сравнение (... = c) вернёт уже значение false, поскольку true != 2. Для того, чтобы сравнение трёх (и более) переменных давало корректный результат, следует воспользоваться следующим выражением:
if (a == b && b == c) ....В данном случае действительно a == b вернёт true, b == c вернёт true, и результат логической операции AND будет также равен true.
Однако часто выражения, подобные ошибочным, пишутся для сокращения количества кода. Анализатор не выдаст предупреждение в случаях, если:
1) Третья переменная имеет тип bool, BOOL и т.п. или сама по себе равна 0, 1, true или false. В этом случае ошибка крайне маловероятна – скорее всего, программист написал правильный код:
bool compare(int a, int b, bool res)
{
return a == b == res;
}2) В выражении присутствуют скобки. В этом случае очевидно, что программист понимает логику и хочет, чтобы выражение выполнялось именно так, как написано:
if ((a == b) == c) ....В случае, если анализатор выдал ложное срабатывание V709, рекомендуемым путём его устранения является добавление скобок как в примере выше. Это позволить указать другим программистам, что код корректен.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V709. |
Анализатор обнаружил в коде подозрительный участок кода, где создаётся константная ссылка на числовой литерал. Это действие не имеет практического смысла и скорее всего является последствием какой-то опечатки. Возможно, используется не тот макрос или что-то ещё.
Пара примеров:
const int & u = 7;
const double & v = 4.2;Данное предупреждение лучше всего не подавить, а исправить путём удаления знака амперсанда, превращая ссылку в обычное константное значение (предварительно, разумеется, проверив, действительно ли так всё и задумывалось):
const int u = 7;
const double v = 4.2;В теле цикла обнаружено объявление переменной, совпадающей с переменной, используемой для контроля цикла. В то время, как для цикла for и цикла foreach (C++11) это может и не нести серьёзной опасности, всё равно это является нехорошим стилем программирования. С циклами же do {} while и while {} всё намного опаснее. Возможно случайное изменение новой переменной в теле цикла вместо изменения переменной в условии цикла.
Разберём пример.
int ret;
....
while (ret != 0)
{
int ret;
ret = SomeFunctionCall();
while (ret != 0)
{
DoSomeJob();
ret--;
}
ret--;
}В данной ситуации может возникнуть вечный цикл, поскольку внешняя переменная 'ret' в теле цикла не изменяется вообще. Очевидным решением в данном случае будет изменить имя внутренней переменной:
int ret;
....
while (ret != 0)
{
int innerRet;
innerRet = SomeFunctionCall();
while (innerRet != 0)
{
DoSomeJob();
innerRet--;
}
ret--;
}Анализатор не всегда выдаёт предупреждение V711 в случае, если видит переменную с тем же именем, что используется в теле цикла. К примеру, следующий код не вызовет подозрений:
int ret;
....
while (--ret != 0)
{
int ret;
ret = SomeFunctionCall();
while (ret != 0)
{
DoSomeJob();
ret--;
}
}Также анализатор не выдаст предупреждения в случае, если подозрительные переменные имеют явно несоответствующие друг другу типы (к примеру, класс и указатель на int). В таком случае ошибиться намного сложнее.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V711. |
Анализатор обнаружил в коде цикл с пустым телом, который может быть превращён компилятором после оптимизации в вечный цикл или убран из кода программы. Чаще всего подобные циклы используются для ожидания какого-либо события извне.
Пример:
bool AllThreadsCompleted = false; // Глобальная переменная
....
while (!AllThreadsCompleted);В данной ситуации оптимизирующий компилятор сделает цикл вечным. Посмотрим на ассемблерный код из Debug-версии:
; 8 : AllThreadsCompleted = false;
mov BYTE PTR ?AllThreadsCompleted@@3_NA, 0
; AllThreadsCompleted
$LN2@main:
; 9 :
; 10 : while (!AllThreadsCompleted);
movzx eax, BYTE PTR ?AllThreadsCompleted@@3_NA
; AllThreadsCompleted
test eax, eax
jne SHORT $LN1@main
jmp SHORT $LN2@main
$LN1@main:В данном случае проверка, очевидно, присутствует. Теперь же обратимся к Release-версии:
$LL2@main:
; 8 : AllThreadsCompleted = false;
; 9 :
; 10 : while (!AllThreadsCompleted);
jmp SHORT $LL2@mainВ Release-версии переход был оптимизирован в безусловный. Из-за подобного различия Debug-версии и Release-версии могут возникать сложные и трудно детектируемые ошибки.
Путей корректировки данной ситуации несколько. Если эта переменная и впрямь используется для контроля логики многопоточной программы, то лучше использовать средства синхронизации операционной системы, такие как мьютексы и семафоры. Другим вариантом исправления может стать добавление модификатора 'volatile' к объявлению переменной, запрещающему оптимизацию:
volatile bool AllThreadsCompleted; // Глобальная переменная
....
while (!AllThreadsCompleted);Соответствующий ассемблерный код в Release-версии:
$LL2@main:
; 9 :
; 10 : while (!AllThreadsCompleted);
movzx eax, BYTE PTR ?AllThreadsCompleted@@3_NC
; AllThreadsCompleted
test al, al
je SHORT $LL2@mainОднако иногда диагностика V712 выдаётся "совсем не там" и указывает на места, где вечного цикла вообще быть не должно. В таком случае, скорее всего, пустой цикл появился случайно из-за опечатки. В подобной ситуации диагностика часто (но не всегда) пересекается с диагностикой V715.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V712. |
Анализатор обнаружил в коде ситуацию, при котором проверка на nullptr некоторого указателя производится после его использования. В отличие от диагностики V595, данная диагностика работает в пределах одного логического выражения.
Ниже представлен некорректный пример.
if (P->x != 0 && P != nullptr) ....В этом случае вторая проверка бессмысленна. В случае, если 'P' равен nullptr, то произойдёт ошибка доступа к памяти при попытке разыменовывания нулевого указателя. В таком коде что-то явно не так. Наиболее простой рекомендацией будет поменять местами проверки в логическом выражении:
if (P != nullptr && P->x != 0) ....Однако в подобном случае всегда рекомендуется провести дополнительный обзор кода. Действительно ли имелось в виду именно это? Возможно, указатель сам по себе не может быть равен nullptr и проверка лишняя. Возможно, разыменовывается или проверяется на nullptr не та переменная. Подобные случаи индивидуальны и трудно дать какую-то общую рекомендацию по исправлению кода.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V713. |
Анализатор обнаружил в коде подозрительную ситуацию. Присутствует foreach, в котором имеется присваивание контрольной переменной цикла (loop control variable) некоторого значения. В то же время, передача контрольной переменной цикла идёт по значению. Скорее всего, имелась в виду передача по ссылке.
Пример:
for (auto t : myvector)
t = 17;Это приведёт к копированию переменной 't' на каждой итерации и изменению локальной копии, что вряд ли то, что хотел программист. Скорее всего, хотелось изменить значения в контейнере 'myvector'. Корректно данный участок кода будет выглядеть следующим образом:
for (auto & t : myvector)
t = 17;Данная диагностика диагностирует лишь самые простые случаи некорректного использования цикла foreach, поскольку в них проще всего совершить ошибку. В случае более сложных конструкций программист наверняка лучше знает, что он делает и следующие ситуации иногда встречаются в реальном коде:
for (auto t : myvector)
{
function(t); // Использовали t по назначению
// Далее t используется как локальная переменная
t = anotherFunction();
if (t)
break;
}На этот код анализатор не будет выдавать предупреждение V714.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V714. |
Анализатор обнаружил странный код, связанный с наличием оператора while с пустым телом в неожиданном месте. Оператор 'while' находится после закрывающейся скобки, относящейся к телу оператора 'if', 'for' или другого 'while'. Подобные ошибки могут возникать при работе со сложным кодом с высоким уровнем вложенности. Данная диагностика может иногда пересекаться с диагностикой V712.
Пример из реального приложения:
while (node != NULL) {
if ((node->hashCode == code) &&
(node->entry.key == key)) {
return true;
}
node = node->next;
} while (node != NULL);Пример полностью синтаксически корректен с точки зрения языка C++: первый цикл 'while' заканчивается закрывающей фигурной скобкой, следом за ним идёт второй цикл while с пустым телом. Более того, второй цикл никогда не станет вечным циклом, поскольку по выходу из первого цикла Node уже точно будет не равен NULL. Однако очевидно, что с этим кодом что-то не так. Возможно, программист сначала хотел написать цикл while, а затем передумал и решил сделать цикл do .... while, однако по какой-то причине не поменял первое условие на do. Возможно, сначала был реализован цикл do .... while, а затем не до конца исправлен на while. Вывод здесь может быть только один: требуется провести обзор кода, а затем переписать его таким образом, чтобы устранить бессмысленный цикл while.
В случае же, если код написан так, как и задумывался, мы советуем не размечать ложное срабатывание, а перенести while на следующую строку для того, чтобы явно указать, что while не относится к предыдущему блоку, и тем самым упростить труд других программистов, которые будут потом работать с проектом.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V715. |
Анализатор обнаружил в коде ситуацию, при которой явным или неявным образом производится преобразование типа bool или BOOL к HRESULT или наоборот. В то время, как такая операция вполне допустима с точки зрения языка C++, она не имеет практического смысла. Тип HRESULT предназначен для хранения статуса, имеет достаточно сложный формат и не имеет ничего общего с типом bool или BOOL.
Можно привести следующий пример из реального приложения:
BOOL WINAPI DXUT_Dynamic_D3D10StateBlockMaskGetSetting(....)
{
if( DXUT_EnsureD3D10APIs() &&
s_DynamicD3D10StateBlockMaskGetSetting != NULL )
....
else
return E_FAIL;
}Опасность заключается в том, что тип HRESULT представляет собой, на самом деле, тип 'long', а тип BOOL – это ни что иное как 'int'. Эти типы легко преобразуются друг в друга, и компилятор не видит ничего подозрительного в приведённом выше коде.
Однако с точки зрения программиста эти типы означают совершенно разное. В то время как BOOL обозначает логическую переменную, тип HRESULT устроен достаточно сложно и должен сигнализировать о том, прошла ли операция успешно, какой результат был возвращён после выполнения операции, в случае ошибки – где произошла ошибка, обстоятельства этой ошибки и так далее.
О типе HRESULT. Первый бит слева (то есть самый старший бит) хранит успешность операции: в случае, если операция прошла успешно, первый бит устанавливается в ноль, иначе – в единицу. Дальнейшие четыре бита характеризуют вид ошибки. Одиннадцать бит далее характеризуют модуль, в котором произошла исключительная ситуация. Последние, самые младшие шестнадцать бит характеризуют статус выполнения операции: в случае ошибки он может указывать на код ошибки, в случае успешного выполнения – статус успешного выполнения. Таким образом, неотрицательные значения обычно сигнализируют об успешном выполнении операции. При этом часто применяется макро константа 'S_OK', равная 0.
Более подробное описание HRESULT можно увидеть в статье на сайте MSDN. А на этой странице список наиболее часто применяемых значений.
Тип BOOL для индикации значения "ложь" должен быть равен нулю, в противном случае он указывает на значение "истина". Иными словами, эти два типа крайне похожи друг на друга в плане типов и их приведение друг к другу не влечёт за собой с точки зрения языка ничего страшного, однако операция приведения лишена смысла. Ведь по первоначальному замыслу тип HRESULT хранит в себе не только информацию об успехе или неудаче (и код ошибки в случае неудачи), но и может сохранять в себе некоторую дополнительную информацию в случае успешного вызова. Особенно подпортить жизнь может значение S_FALSE, равное 0x1. То, что ненулевые значения возвращаются в случае успешного вызова крайне редко, может стать причиной мучительных поисков ошибок, проявляющихся очень иногда и совсем изредка. Зачастую можно встретить конструкцию вида:
HRESULT result = someWinApiFunction(....);
if (!result)
{
// This is an error!
}Такой код абсолютно ошибочен, поскольку проверка на ошибку сработает, если функция вернёт 0 в случае успеха. При этом код обработки ошибки не сработает, когда функция просигнализирует о проблеме, вернув отрицательное число. При этом подобные неявные преобразования между целочисленным и логическим типом могут происходить в более сложных выражениях, где ошибку сложно заметить невооруженным глазом.
Для контроля возвращаемого значения типа HRESULT настоятельно предлагаем воспользоваться макросами SUCCEEDED и FAILED.
HRESULT someFunction(int x);
....
BOOL failure = FAILED(someFunction(q));В остальных случаях рефакторинг не так уж и прост, как кажется, и требует по крайней мере вдумчивого чтения и анализа кода.
Ещё раз о главном. Помните, что:
Никогда не смешивайте HRESULT и BOOL. Смешивание этих типов является серьёзной ошибкой в логике работы программы. Для проверки значений типа HRESULT используйте специальные макросы.
Для поиска ситуаций, когда в переменную типа HRESULT помещается true или false, существует родственная диагностика V543.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V716. |
Анализатор заметил в коде ситуацию необычного приведения типов: указатель на объект базового класса жёстко приводится к указателю на производный класс. Причём известно, что указатель на базовый класс действительно указывает на объект базового класса.
Приведение указателей производного класса к базовому – вполне типичная ситуация. А вот приведение базового класса к одному из производных, может иногда быть ошибочным. Если приведение типов выполнено неправильно, то попытка обращения к членам производного класса может привести к Access Violation или ко всему чему угодно.
Иногда программисты допускают ошибки, приводя к производному классу указатель именно на базовый класс. Пример из реального приложения:
typedef struct avatarCacheEntry { .... };
struct CacheNode : public avatarCacheEntry,
public MZeroedObject
{
....
BOOL loaded;
DWORD dwFlags;
int pa_format;
....
};
avatarCacheEntry tmp;
....
CacheNode *cc = arCache.find((CacheNode*)&tmp);
// Далее при попытке обращения, например, к
// cc->loaded, произойдёт ошибка времени выполнения.К сожалению, в данном случае сложно привести какие-то конкретные рекомендации по устранению некорректной ситуации – скорее всего, потребуется заняться рефакторингом кода с целью его улучшения и увеличения удобочитаемости, а также для предотвращения потенциальных ошибок в будущем. Например, если обращение к новым полям не требуется, то тогда можно подменить указатель на базовый класс на указатель на производный.
Следующий код анализатором считается корректным:
base * foo() { .... }
derived *y = (derived *)foo();Здесь дело в том, что функция foo() может на самом деле всегда возвращать указатель на один из производных классов, и приведение её результата к производному классу – вполне обыденное явление. Вообще, анализатор выдаёт предупреждение V717 только в том случае, если точно известно, что именно базовый класс приводится к производному. Однако, анализатор не будет выдавать предупреждение V717 в том случае, если в производном классе нет новых нестатических членов (хотя всё равно так делать нехорошо, но это уже ближе к нарушению хорошего стиля кода, нежели к настоящей ошибке):
struct derived : public base
{
static int b;
void bar();
};
....
base x;
derived *y = (derived *)(&x);Диагностическое правило классифицируется как:
Внутри функции DllMain() нельзя вызывать многие функции, так как это может привести к зависанию приложения или иным ошибкам. Именно такой опасный вызов функции и был обнаружен анализатором.
Ситуация с DllMain хорошо описана в статье на сайте MSDN: Dynamic-Link Library Best Practices. Процитируем из неё некоторые фрагменты:
При вызове функции DllMain происходит блокировка загрузчика. По этой причине на функции, которые могут быть вызваны внутри DllMain, накладываются существенные ограничения. Как таковая, функция DllMain предназначена для выполнения задач по минимальной инициализации за счет использования небольшого подмножества Microsoft Windows API. Внутри нее нельзя вызывать функции, которые прямо или косвенно пытаются использовать загрузчик. В противном случае, Вы рискуете создать в программе такие условия, при которых произойдет ее аварийное завершение либо взаимная блокировка потоков. Ошибка в реализации DllMain может подвергнуть опасности весь процесс целиком и все его потоки.
В идеале функция DllMain должна представлять собой всего лишь пустую заглушку. Однако, учитывая сложность многих приложений, данное ограничение было бы слишком строгим. Поэтому на практике при работе с этой функцией следует откладывать инициализацию как можно дольше. Отложенная инициализация повышает надежность работы приложения, поскольку она не происходит, пока загрузчик заблокирован. Кроме того, отложенная инициализация позволяет безопасно использовать Windows API в значительно большем объеме.
Некоторые задачи инициализации не могут быть отложены. Например, DLL-библиотека, которая зависит от файла конфигурации, должна прерывать свою загрузку, если файл оказывается неправильно сформированным или содержит мусор. При таком типе инициализации DLL-библиотеки должны предпринимать попытку выполнить запланированное действие и в случае неудачи сразу же завершаться вместо того, чтобы тратить ресурсы, выполняя какую-то другую работу.
В любом случае никогда не выполняйте следующие задачи в пределах функции DllMain:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V718. |
Анализатор обнаружил подозрительный оператор switch. Выбор варианта осуществляется по переменной enum-типа. При этом рассмотрены не все возможные варианты.
Пример:
enum TEnum { A, B, C, D, E, F };
....
TEnum x = foo();
switch (x)
{
case A: Y(11); break;
case B: Y(22); break;
case C: Y(33); break;
case D: Y(44); break;
case E: Y(55); break;
}Перечисление TEnum содержит 6 именованных констант. Но в операторе switch используется только 5 из них. Высока вероятность, что это ошибка.
Такая проблема часто возникает в ходе рефакторинга. В TEnum добавили константу F. После этого какие-то switch поправили, а про какие-то забыли. В результате значение F начинает обрабатываться неправильно.
Анализатор предупредит о том, что константа F не используется. И тогда программист может исправить ошибку:
switch (x)
{
case A: Y(11); break;
case B: Y(22); break;
case C: Y(33); break;
case D: Y(44); break;
case E: Y(55); break;
case F: Y(66); break;
}Анализатор выдаёт предупреждение далеко не всегда, когда в switch используется не все константы из перечисления. Иначе было бы слишком много ложных срабатываний. По умолчанию действует целый ряд исключений эмпирического типа. Основные:
switch не используется более чем 4 константы;switch не используется половина и более элементов;None, Unknown и т.п.end, num, count и т. п.Описанные исключения являются взвешенным решением, проверенным на практике. Если вам нужно другое поведение, его можно изменить с помощью настроек, описанных в следующем разделе.
Для изменения поведения диагностического правила добавьте в файл .pvsconfig одну или несколько следующих команд.
По умолчанию анализатор не выдаёт предупреждения о неиспользуемых значениях enum при наличии default ветки. Это решение связано с большим количеством потенциально ложных срабатываний в случаях, когда в default-ветке находится assert или бросок исключения.
Пример:
enum TEnum { A, B, C, D, E, F };
....
TEnum x = foo();
switch (x)
{
case A: Y(11); break;
case B: Y(22); break;
case C: Y(33); break;
case D: Y(44); break;
case E: Y(55); break;
default:
throw MyException("Ай! Забыли рассмотреть один из вариантов!");
}Тем не менее, если вам необходимо искать все неиспользуемые значения, невзирая на наличие default-ветки, то вы можете воспользоваться следующей настройкой:
`//+V719 IGNORE_DEFAULT:ON` (по умолчанию)
`//+V719 IGNORE_DEFAULT:OFF`По умолчанию анализатор не выдаёт предупреждение, если неиспользуемый элемент находится в enum, который состоит всего из одного или двух элементов. Изменить это поведение можно с помощью следующей настройки:
`//+V719 IGNORE_SMALL_ENUM:ON` (по умолчанию)
`//+V719 IGNORE_SMALL_ENUM:OFF`По умолчанию анализатор не будет выдавать предупреждение на отсутствующий элемент, если он находится последним в enum и содержит в названии подстроки end, num, count, max, last и т.п.
Если необходимо, вы можете определить свой список имен с помощью следующей настройки:
`//-V719_COUNT_NAME:NAME1, *END,LAST?ELEMENT*`Примечания:
* (ноль и более любых символов);? (один любой символ). * и ?), то будет искаться подстрока.По умолчанию анализатор перестанет выдавать предупреждение, если в switchпропущено более четырёх констант. Изменить это количество можно с помощью настройки:
//+V719 MAX_UNCOVERED_ENUMERATORS: 2
Чтобы полностью убрать это ограничение, задайте значение, равное нулю:
//+V719 MAX_UNCOVERED_ENUMERATORS: 0
С помощью указанной ниже настройки вы можете задать имена констант, пропуск которых анализатор не будет считать ошибкой:
//-V719_IGNORE_ENUMERATORS: WithN?, *_DONT_USE, ExactName
Примечания:
* (ноль и более любых символов);? (один любой символ). Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V719. |
Анализатор обнаружил, что в программе используется функция SuspendThread() или Wow64SuspendThread(). Сам по себе вызов этих функций не является ошибкой. Однако разработчики часто используют их не по назначению. Из-за этого программа может вести себя не так, как ожидает программист.
Функция SuspendThread() должна помогать разрабатывать отладчики и подобные им приложения. Если вы используете эту функцию в прикладном программном обеспечении для задач синхронизации, то высока вероятность, что в вашей программе есть ошибка.
Суть проблемы неправильного использования функции SuspendThread() изложена в следующих статьях:
Если в вашем коде функция SuspendThread() используется неправильно, то необходимо его переписать. Если всё хорошо, то просто отключите диагностику V720 в настройках анализатора.
Статьи в интернете иногда пропадают или меняют своё расположение. Поэтому, мы на всякий случай приводим в документации текст обеих статей.
Примечание. Для российских пользователей мы перевели текст статей. Ознакомиться с оригиналом вы можете, перейдя по ссылкам, приведённым ниже или переключить язык нашего сайта.
Это практически так же плохо, как уничтожение потока.
Рассмотрим такую программу на (вздох) C#:
using System.Threading;
using SC = System.Console;
class Program {
public static void Main() {
Thread t = new Thread(new ThreadStart(Program.worker));
t.Start();
SC.WriteLine("Press Enter to suspend");
SC.ReadLine();
t.Suspend();
SC.WriteLine("Press Enter to resume");
SC.ReadLine();
t.Resume();
}
static void worker() {
for (;;) SC.Write("{0}\r", System.DateTime.Now);
}
}Когда вы запускаете эту программу и жмёте Enter, программа зависает. Но если вы измените функцию worker просто на "for(;;) {}", программа будет работать совершенно нормально. Давайте разберёмся, почему так происходит.
Рабочий поток тратит практически всё время своей работы на вызовы System.Console.WriteLine, поэтому, когда вы зовёте Thread.Suspend(), поток с наибольшей вероятностью и находится в System.Console.WriteLine.
Вопрос: Является ли метод System.Console.WriteLine потокобезопасным?
Да. Даже не нужно залезать в документацию, чтобы понять это. Наша программа зовёт его из двух разных потоков без какой-либо синхронизации, так что лучше бы ему быть потокобезопасным, иначе у нас начались бы большие неприятности ещё до того, как мы дошли до приостановки потока.
Вопрос: Каким образом обычно объекты делают потокобезопасными?
Вопрос: Каков результат приостановки потока в момент выполнения им потокобезопасной операции?
Вопрос: Что случится, если вы, в дальнейшем, попытаетесь обратиться к тому же объекту (в данном случае – к консоли) из другого потока?
Такой результат не специфичен именно для C#. Подобная логика применима как к потоковой модели Win32, так и к любой другой. В Win32, структура кучи процесса является потокобезопасным объектом, и, поскольку сложно что-либо сделать в Win32 без обращений к куче, приостановка потока в Win32 имеет большую вероятность привести к блокировке вашего процесса.
Но тогда зачем вообще появилась функция SuspendThread?
Отладчики используют её для "заморозки" всех потоков процесса в момент, когда происходит его отладка. Отладчики также могут использовать её при остановке всех потоков процесса, кроме одного, чтобы вы могли отлаживать потоки по одному. Это не создаёт взаимоблокировок в отладчике, ведь он является отдельным процессом.
Итак, коллега решил игнорировать совет, потому что он прогонял несколько экспериментов с потоковой безопасностью и взаимоблокирующими операциями, и приостановка потока была удобным способом обнаружения "окон", в которых могут возникать гонки доступа к объектам.
В процессе этих экспериментов, он обнаружил некоторое странное поведение.
LONG lValue;
DWORD CALLBACK IncrementerThread(void *)
{
while (1) {
InterlockedIncrement(&lValue);
}
return 0;
}
// This is just a test app, so we will abort() if anything
// happens we don't like.
int __cdecl main(int, char **)
{
DWORD id;
HANDLE thread = CreateThread(NULL, 0, IncrementerThread,
NULL, 0, &id);
if (thread == NULL) abort();
while (1) {
if (SuspendThread(thread) == (DWORD)-1) abort();
if (InterlockedOr(&lValue, 0) != InterlockedOr(&lValue, 0))
{
printf("Huh? The variable lValue was modified by a suspended
thread?\n");
}
ResumeThread(thread);
}
return 0;
}Странным здесь является то, что сообщение "Huh?" было распечатано. Разве может приостановленный поток модифицировать переменную? Возможно ли, что InterlockedIncrement начнёт увеличивать значение переменной, затем окажется "замороженным", но каким-то образом всё же закончит начатое позже?
Но ответ гораздо проще. Функция SuspendThread говорит планировщику заморозить поток, но не ждёт подтверждения от него о том, что "заморозка" уже произошла. На это намекает документация на SuspendThread, где говорится:
"Эта функция в основном разработана для использования отладчиками. Она не предназначена для синхронизации потоков".
Не следует использовать SuspendThread для синхронизации двух потоков, т.к. не предоставляется гарантий для такой синхронизации. На самом деле, SuspendThread просто сигнализирует планировщику приостановить поток и сразу выходит. Если планировщик занят чем-то другим, то возможно он и не сможет обработать запрос на "заморозку" сразу, поэтому приостанавливаемый поток продолжает работать, пока планировщик не обработает запрос, и поток наконец-то не окажется приостановленным на самом деле.
Если вы хотите убедиться в том, что поток на самом деле приостановлен, вам нужно выполнить синхронную операцию, которая зависит от факта приостановки потока. Это принуждает выполнение обработки запроса на приостановку, т.к. этот запрос является необходимым условием для вашей операции. И поскольку ваша операция синхронна, вы знаете, что к моменту, когда она завершится, приостановка потока гарантированно произойдёт.
Традиционный способ сделать это — вызвать GetThreadContext, поскольку ядру необходимо прочитать контекст приостановленного потока. Для этого требуется сохранить контекст, а значит — приостановить поток.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Анализатор обнаружил, что неправильно используется значение типа VARIANT_BOOL. Дело в том, что значение истина (VARIANT_TRUE) обозначается как -1. Многие программисты не ожидают такого подвоха и используют тип неправильно.
Вот как объявлен тип VARIANT_TRUE и константы для обозначения "истина" и "ложь":
typedef short VARIANT_BOOL;
#define VARIANT_TRUE ((VARIANT_BOOL)-1)
#define VARIANT_FALSE ((VARIANT_BOOL)0)Рассмотрим несколько примеров неправильной работы с типом VARIANT_TRUE. Во всех случаях программист ожидает, что условие будет истинно. Но на самом деле условие всегда ложно.
Пример N1.
VARIANT_BOOL variantBoolTrue = VARIANT_TRUE;
if (variantBoolTrue == true) // falseЕсли подставить значение в выражение, то мы получим: ((short)(-1) == true). При вычислении выражения, 'true' превратится в '1'. Условие (-1 == 1) ложно.
Правильный вариант:
if (variantBoolTrue == VARIANT_TRUE)Пример N2.
VARIANT_BOOL variantBoolTrue = TRUE;
if (variantBoolTrue == VARIANT_TRUE) //falseЗдесь программист ошибся и использовал TRUE вместо VARIANT_TRUE. В результате переменной variantBoolTrue будет присвоено значение 1. Это недопустимое значение для переменных типа VARIANT_BOOL.
Если подставить значение в выражение, то мы получим: (1 == (short)(-1)).
Правильный вариант:
VARIANT_BOOL variantBoolTrue = VARIANT_TRUE;Пример N3.
bool bTrue = true;
if (bTrue == VARIANT_TRUE) //falseРаскроем выражение: (true == (short)(-1)). При вычислении выражения 'true' превратится в '1'. Условие (1 == -1) ложно.
Правильный вариант привести затруднительно. Код в принципе неверен. Нельзя смешивать переменные типа 'bool' и значения типа 'VARIANT_TRUE'.
Подобных примеров можно придумать достаточно много. Например, формальный аргумент функции имеет тип VARIANT_BOOL. А в качестве фактического аргумента будет передано значение 'true'. Ещё вариант - функция возвращает неправильно значение. И так далее.
Самое главное - не смешивать тип VARIANT_BOOL с типами BOOL, bool и BOOLEAN.
Дополнительные ссылки:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V721. |
Анализатор обнаружил подозрительное условие, которое может содержать ошибку.
Диагностика носит эмпирический характер, поэтому проще показать на примере, как она работает, чем объяснить сам принцип работы анализатора.
Рассмотрим реальный пример:
if (obj.m_p == p &&
obj.m_forConstPtrOp == forConstVarOp &&
obj.m_forConstPtrOp == forConstPtrOp)Из-за того, что имена переменных очень похожи, в коде допущена опечатка. Ошибка находится во второй строке. Переменную 'forConstVarOp' следовало сравнить с 'm_forConstVarOp', а не с 'm_forConstPtrOp'. Даже читая этот текст сложно заметить ошибку. Обратите внимание на 'Var' и 'Ptr' внутри названий переменных.
Правильный вариант:
if (obj.m_p == p &&
obj.m_forConstVarOp == forConstVarOp &&
obj.m_forConstPtrOp == forConstPtrOp)Если анализатор выдал предупреждение V722, то внимательно изучите соответствующий фрагмент кода. Иногда опечатку бывает сложно заметить.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил ситуацию, когда функция возвращает указатель на внутренний строковый буфер локального объекта. Такой объект будет автоматически уничтожен вместе со своим буфером при выходе из функции, и использовать указатель на него будет нельзя.
В самом простом виде данное диагностическое сообщение будет выдано на следующий код:
const char* Foo()
{
std::string str = "local";
return str.c_str();
}Здесь из функции Foo() возвращается C-строка, хранящаяся во внутреннем буфере объекта str, который будет автоматически уничтожен. В итоге мы получим неправильный указатель, использование которого в программе приведет к неопределённому поведению. Исправленный вариант кода:
const char* Foo()
{
static std::string str = "static";
return str.c_str();
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил в коде ситуацию, при которой преобразование указателей или переменных целочисленного типа к типу BOOL может приводить к потере старших разрядов. В результате ненулевое значение, которое по сути означает TRUE, может неожиданно превратиться в FALSE.
В программах тип BOOL (gboolean, UBool и т.д.) определяется как целочисленный тип. Любое отличное от нуля значение интерпретируется как истина, а равное нулю – ложь. Поэтому потеря старших битов при преобразовании типов вызовет ошибку в логике работы программы.
Рассмотрим пример:
typedef long BOOL;
__int64 lLarge = 0x12300000000i64;
BOOL bRes = (BOOL) lLarge;Здесь отличная от нуля переменная при преобразовании в BOOL срезается до нуля, что означает FALSE.
Рассмотрим другие случаи ошибочного преобразования:
int *p;
size_t s;
long long w;
BOOL x = (BOOL)p;
BOOL y = s;
BOOL z = (BOOL)s;
BOOL q = (BOOL)w;Для исправления таких ошибок необходимо выполнить проверку на ненулевое значение перед преобразованием в BOOL.
Различные способы исправления:
int *p;
size_t s;
long long w;
BOOL x = p != nullptr;
BOOL y = s != 0;
BOOL z = s ? TRUE : FALSE;
BOOL q = !!w;Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V724. |
Анализатор обнаружил опасные приведения указателя this к типу void* и последующее обратное приведение void* к типу класса. Само по себе преобразование this к типу void* не является ошибкой, но в ряде случаев ошибочным является обратное преобразование — от void* к типу указателя на класс. В результате таких преобразований возможно получение некорректного указателя.
Рассмотрим пример, где используется приведение this к void*, а после — некорректное обратное приведение к типу класса:
class A
{
public:
A() : firstPart(1){}
void printFirstPart() { std::cout << firstPart << " "; }
private:
int firstPart;
};
class B
{
public:
B() : secondPart(2){}
void* GetAddr() const { return (void*)this; }
void printSecondPart() { std::cout << secondPart << " "; }
private:
int secondPart;
};
class C: public A, public B
{
public:
C() : A(), B(), thirdPart(3){}
void printThirdPart() { std::cout << thirdPart << " "; }
private:
int thirdPart;
};
void func()
{
C someObject;
someObject.printFirstPart();
someObject.printSecondPart();
someObject.printThirdPart();
void *pointerToObject = someObject.GetAddr();
....
auto pointerC = static_cast<C*>(pointerToObject);
pointerC->printFirstPart();
pointerC->printSecondPart();
pointerC->printThirdPart();
}Можно было бы предположить, что вывод будет следующим:
1 2 3 1 2 3Однако на самом деле на экране отобразится это:
1 2 3 2 3 -858993460В итоге вывод для всех данных после преобразований является некорректным. Проблема кроется в том, что теперь указатель pointerC указывает не на начало объекта C, а на блок памяти, выделенной под объект B.
Кажется, что такая ошибка маловероятна и её трудно допустить, однако она очевидна только из-за того, что пример маленький и простой. В реальных программах со сложными иерархиями классов можно легко запутаться. Cложность в том, что если функцию GetAddr() расположить в классе A, то всё работает, а если в классе B, то нет. Давайте разберёмся в ситуации подробнее.
Чтобы было проще понять, из-за чего возникла ошибка, необходимо знать, как конструируются и располагаются в памяти объекты классов, созданных в результате множественного наследования.
Схематичный пример изображён на рисунке 1.
Рисунок 1 — Расположение в памяти объекта класса, полученного путём множественного наследования.
Из рисунка 1 видно, что объект класса С (который и получен в результате множественного наследования) состоит из объектов классов A и B, а также части объекта C.
Указатель this содержит адрес начала выделенного под объект блока памяти. На рисунке 2 изображены указатели this для всех трёх объектов.
Рисунок 2 — Указатели this и блоки памяти.
Так как объект класса C состоит из трёх частей, this для него будет указывать не на блок памяти, который добавлен дополнительно к базовым классам, а на начало всего непрерывного блока памяти. То есть в данном случае указатели this для классов A и C совпадут.
Указатель this для объекта класса B указывает на начало выделенного под него блока памяти, но при этом адрес начала этого участка памяти будет отличен от адреса начала участка памяти, выделенной под объект класса C.
Таким образом, при вызове метода GetAddr() будет возвращён адрес объекта B, и при обратном преобразовании этого указателя к типу C* будет получен некорректный указатель.
Т.е., если бы функция GetAddr() располагалась в классе A, то всё бы работало так, как и ожидал программист. Но если она расположена в B, то происходит сбой.
Во избежание подобных ошибок необходимо продумать, действительно ли стоит выполнять приведение this к void*, и если да, то тщательно проверить иерархию наследования, а также дальнейшие операции обратного преобразования от void* к типу указателя на класс.
Дополнительные ссылки:
Диагностическое правило классифицируется как:
Анализатор обнаружил ошибочный код, в котором осуществляется попытка удаления массива через функцию free() или схожую с ней. При этом, память под этот массив не была выделена при помощи специальных функций, таких как malloc(). Подобные действия являются причиной неопределённого поведения.
Пример:
class A
{
int a[50];
public:
A(){}
~A(){ free(a); }
};Так как память не была выделена каким-то специальным образом, не стоит также и вызывать каких-либо специальных функций для её очистки – она будет произведена автоматически при уничтожении объекта. Следовательно, в данном случае корректный код должен был выглядеть следующим образом:
class A
{
int a[50];
public:
A(){}
~A(){}
};Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V726. |
Анализатор обнаружил выражение, которое на его взгляд предназначается для вычисления размера буфера в байтах, требуемого для хранения строки. В этом выражении допущена ошибка.
Когда стоит задача получения размера строки типа char, стандартным решением является использование конструкции "strlen(str) + 1". Функция strlen() вычисляет длину некой строки, а единица означает резервирование одного байта для терминального нуля. Но если речь идет о строке типа wchar_t, char16_t или char32_t, то следует не забывать умножать "длину строки + 1" на размер одного символа, то есть на 'sizeof(T)'.
Рассмотрим несколько синтетических примеров ошибок.
Пример N1:
wchar_t *str = L"Test";
size_t size = wcslen(str) + 1 * sizeof(wchar_t);Из-за пропущенных скобок происходит умножение 'sizeof' на единицу, а затем сложение с функцией, вычисляющей длину строки. Корректный код:
size_t size = (wcslen(str) + 1) * sizeof(wchar_t);Пример N2:
Выражение может быть записано и в другой последовательности, при которой сначала будет происходить умножение результата функции на 'sizeof', а затем сложение с единицей.
.... = malloc(sizeof(wchar_t) * wcslen(str) + 1);Порой может случиться такая ситуация, когда программист в процессе написания вспомнил, что длину строки следует умножать на "sizeof(wchar_t)", но по привычке добавил 1. В результате памяти будет выделено на 1 байт меньше, чем необходимо.
Корректные варианты кода:
.... = malloc(wcslen(str) * sizeof(wchar_t) + 1 * sizeof(wchar_t));
.... = malloc((wcslen(str) + 1) * sizeof(wchar_t));Диагностическое правило классифицируется как:
|
Анализатор обнаружил код, который можно упростить. Слева и справа от оператора '||' стоят противоположные по смыслу выражения. Данный код является избыточным, поэтому его можно упростить, сократив количество проверок.
Пример избыточного кода:
if (!Name || (Name && Name[0] == 0))В выражении "Name && Name[0] == 0" проверка 'Name' является избыточной, так как перед этим проверятся противоположное ему условие '!Name', причём эти выражения разеделены оператором '||'. Следовательно, излишнюю проверку в скобках можно опустить, упростив код:
if (!Name || Name[0] == 0)Наличие избыточности может свидетельствовать о наличии ошибки. Возможно, что в выражении случайно используется не та переменная. И корректный код на самом деле должен быть, например, таким:
if (!Foo || (Name && Name[0] == 0))Анализатор выдаёт предупреждения не только на конструкции вида 'x' и '!x', но и на прочие противоположные по смыслу выражения, например:
if (a > 5 || (a <= 5 && b))Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V728. |
Анализатор обнаружил в теле функции метку, на которую не ссылается ни один оператор 'goto'. Возможно, программист ошибся и использует где-то переход не на ту метку.
Синтетический пример некорректного кода:
string SomeFunc(const string &fStr)
{
string str;
while(true)
{
getline(cin,str);
if (str == fStr)
goto retRes;
else if(str == "stop")
goto retRes;
}
retRes:
return str;
badRet:
return "fail";
}В теле функции есть метка 'badRet' на которую не ссылается ни один оператор 'goto', но при этом присутствует другая метка 'retRes', на которую есть ссылка. Программист ошибся и вместо перехода на метку 'badRet' продублировал переход на метку 'retRes'.
Тогда корректный код мог бы выглядеть так:
string SomeFunc(const string &fStr)
{
string str;
while(true)
{
getline(cin,str);
if (str == fStr)
goto retRes;
else if(str == "stop")
goto badRet;
}
retRes:
return str;
badRet:
return "fail";
}Другой пример некорректного кода:
int DeprecatedFunc(size_t lhs, size_t rhs, bool cond)
{
if (cond)
return lhs*3+rhs;
else
return lhs*2 + rhs*7;
badLbl:
return -1;
}В данном случае будет выдано сообщение с низким уровнем опасности, так как метка 'badLbl' осталась после изменения функции, а операторы 'goto', ссылающиеся на неё, были удалены.
Анализатор не будет выдавать предупреждение в случае, если в теле функции есть оператор 'goto', ссылающийся на данную метку, но он закомментирован или этот участок кода не компилируется из-за директивы '#ifdef'.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V729. |
Анализатор обнаружил конструктор, который по всей видимости инициализирует не все члены класса.
Рассмотрим простой синтетический пример:
struct MyPoint
{
int m_x, m_y;
MyPoint() { m_x = 0; }
void Print() { cout << m_x << " " << m_y; }
};
MyPoint Point;
Point.Print();При создании объекта Point вызовется конструктор, в котором не инициализируется член m_y. Соответственно при вызове функции Print будет использована неинициализированная переменная, и последствия этого непредсказуемы.
Корректный конструктор может выглядеть следующим образом:
MyPoint() { m_x = 0; m_y = 0; }Мы рассмотрели простой синтетический пример, где сразу всё понятно. Однако в реальном коде всё бывает гораздо сложнее. Поиск неинициализированных членов класса является набором эмпирических алгоритмов. Во-первых, члены классов можно инициализировать разнообразнейшими способами, и анализатор не всегда может понять, инициализирован член класса или нет. Во-вторых, не всегда нужно инициализировать все члены, и сообщения анализатора могут быть ложными, так как он не может угадать задумку программиста.
Поиск неинициализированных членов класса является сложным и неблагодарным занятием. Подробнее этот вопрос рассмотрен в статье: "Поиск неинициализированных членов класса". Поэтому просим в случае ложных срабатываний отнестись к анализатору с пониманием и использовать один из механизмов подавления ложных срабатываний.
Вы можете подавить предупреждение, отметив конструктор комментарием "//-V730". Вы также можете использовать базу данных для разметки ложных предупреждений. В крайнем случае, если ложных срабатываний слишком много, то разумно полностью отключить диагностику V730.
Однако это крайние меры. На практике разумно отключать анализ отдельных членов структур, не требующих инициализации в конструкторе. Рассмотрим искусственный пример:
const size_t MAX_STACK_SIZE = 100;
class Stack
{
size_t m_size;
int m_array[MAX_STACK_SIZE];
public:
Stack() : m_size(0) {}
void Push(int value)
{
if (m_size == MAX_STACK_SIZE)
throw std::exception("overflow");
m_array[m_size++] = value;
}
int Pop()
{
if (m_size == 0)
throw std::exception("underflow");
return m_array[--m_size];
}
};Этот класс реализует стек. Массив 'm_array' не инициализируется в конструкторе и это корректно, так как изначально стек считается пустым.
Анализатор выдаст предупреждение V730, так как не может понять принцип работы этого класса. Вы можете подсказать анализатору, пометив член 'm_array' комментарием "//-V730_NOINIT". Это укажет анализатору, что массив 'm_array' не требуется обязательно инициализировать.
Теперь, анализируя класс:
class Stack
{
size_t m_size;
int m_array[MAX_STACK_SIZE]; //-V730_NOINIT
public:
Stack() : m_size(0) {}
.....
};Анализатор не выдаст предупреждение.
Существует способ отключить предупреждения V730 на все поля классов определённого типа.
Рассмотрим пример:
class Field
{
public:
int f;
};
class Test
{
public:
Test() {}
Field field;
};На этом фрагменте кода будет выдано предупреждение: V730 Not all members of a class are initialized inside the constructor. Consider inspecting: field.
Чтобы исключить все предупреждения поля класса типа 'Field', следует добавить следующий комментарий в код или файл настроек:
//+V730:SUPPRESS_FIELD_TYPE, class:FieldФормат комментария:
//+V730:SUPPRESS_FIELD_TYPE, class:className, namespace:nsNameили
//+V730:SUPPRESS_FIELD_TYPE, class:className.NestedClassName, namespace:nsNameДиагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V730. |
Анализатор обнаружил сравнение переменной типа char с указателем на строку. Такое использование переменной вызвано тем, что были перепутаны одинарные (') и двойные кавычки (").
Рассмотрим пример подобной ошибки:
char ch = 'd';
....
if(ch == "\n")
....Этим кодом невнимательный программист хотел сравнить переменную 'ch' с символом новой строки, но по ошибке поставил не те кавычки. В результате значение переменной 'ch' сравнивается с адресом, по которому располагается строка "\n". Подобный код компилируется и выполняется в Си, но как правило не имеет смысла. В данном примере корректный код должен содержать одинарные кавычки вместо двойных:
char ch = 'd';
....
if(ch == '\n')
....Такая же ошибка может быть допущена при инициализации или присваивании переменной, которая в результате будет хранить младший байт адреса присваиваемой строки.
char ch = "d";В корректном коде должны использоваться одинарные кавычки.
char ch = 'd';Диагностическое правило классифицируется как:
Анализатор обнаружил, что операция унарного минуса применяется к значению типа bool, BOOL, _Bool, и т.п.
Пример ошибки:
bool a;
....
bool b = -a;Этот код не имеет смысла. Вычисление происходит следующим образом:
Если a == false, тогда 'false' превращается в значение типа int, равное 0. К этому значению применяется оператор '-'. На значение это, естественно, не влияет и в 'b' будет записано 0 (т.е. false).
Если a == true, тогда 'true' превращается в значение типа int, равное 1. К этому значению применяется оператор '-' и получается значение -1. Однако, -1 != 0, а значит при записи -1 в переменную типа bool мы вновь получим 'true'.
Таким образом значение 'false' останется 'false', а 'true' останется 'true'.
В корректном присваивании должен использоваться оператор '!':
bool a;
....
bool b = !a;Другой пример (BOOL есть не что иное как тип int):
BOOL a;
....
BOOL b = -a;Унарный минус может изменить численное значение переменной типа BOOL, но не её логическое значение. Всякое ненулевое значение будет обозначать истину, а ноль так и останется ложью.
Корректный вариант:
BOOL a;
....
BOOL b = !a;Примечание. Некоторые программисты могут умышленно использовать конструкции следующего вида:
int val = Foo();
int s;
s = -(val<0);Анализатор выдает предупреждение на подобные конструкции. Здесь нет ошибки, но подобный код нельзя рекомендовать к использованию.
В зависимости от значения 'val' переменной "s" хотят присвоить либо 0, либо -1. Применение унарного минуса к логическому выражению только усложняет чтение кода. Более подходящим будет использование тернарного оператора.
s = (val < 0) ? -1 : 0;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V732. |
Анализатор обнаружил потенциальную ошибку в коде, связанную с использованием макросов, раскрывающихся в арифметическое выражение. Обычно ожидается, что подвыражение, переданное как параметр в макрос будет выполняться в конечном выражении первым. Но это может быть не так, что приводит к трудно обнаруживаемым ошибкам.
Рассмотрим пример:
#define RShift(a) a >> 3
....
y = RShift(x & 0xFFF);Если раскрыть макрос, то мы получим:
y = x & 0xFFF >> 3;
Приоритет операции ">>" выше, чем у "&". Будет вычислено выражение "x & (0xFFF >> 3)", в то время, как программист рассчитывал получить "(x & 0xFFF) >> 3".
Для устранения недостатка требуется взять аргумент 'a' в круглые скобки:
#define RShift(a) (a) >> 3Однако, стоит сделать ещё одно усовершенствование. Полезно взять всё выражение в макросе ещё в одни скобки. Это является хорошим тоном и может предотвратить некоторые другие ошибки. Улучшенный вариант:
#define RShift(a) ((a) >> 3)Примечание. Родственной по смыслу диагностикой является V1003. Диагностика V1003 работает менее точно и даёт больше ложных срабатываний, так как анализирует объявление макроса, а не его использование. С другой стороны, не смотря на свои недостатки диагностика V1003 может помочь выявить ошибки, которые диагностика V733 бессильная обнаружить.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V733. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что в выражении ищется более длинная подстрока и более короткая. При этом более короткая строка, является частью более длинной. Получается, что одно из сравнений избыточно или допущена какая-то ошибка.
Рассмотрим пример:
if (strstr(a, "abc") != NULL || strstr(a, "abcd") != NULL)В случае если подстрока "abc" будет найдена, то дальнейшая проверка не будет выполняться. Если подстрока "abc" не будет найдена, то и поиск более длинной подстроки "abcd" не имеет смысла.
Для исправления ошибки необходимо проверить правильность подстрок или убрать из кода лишние проверки. Пример корректного варианта:
if (strstr(a, "abc") != NULL)Другой пример:
if (strstr(a, "abc") != NULL)
Foo1();
else if (strstr(a, "abcd") != NULL)
Foo2();В данном случае функция Foo2() никогда не будет вызвана. Устранить ошибку можно путем замены порядка проверки. То есть сначала следует искать более длинную подстроку, а потом более короткую:
if (strstr(a, "abcd") != NULL)
Foo2();
else if (strstr(a, "abc") != NULL)
Foo1();Взгляните на примеры ошибок, обнаруженных с помощью диагностики V734. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что в коде задан строковый литерал, в котором содержится разметка HTML с ошибками. Был открыт тег для элемента, которому требуется завершающий тег. Но следующим в строке обнаружен закрывающий тег, который не соответствует открывающему тегу.
Рассмотрим пример:
string html = "<B><I>This is a text, in bold italics.</B>";В данном случае открывающему тегу "<I>" должен соответствовать закрывающий тег "</I>", но при дальнейшем анализе HTML мы обнаружим закрывающий тег "</B>", что является ошибкой. В таком виде часть HTML кода является невалидной.
Для исправления ошибки необходимо проверить корректность последовательности открывающих и закрывающих тегов и устранить найденные ошибки.
Пример корректного варианта:
string html = "<B><I>This is a text, in bold italics.</I></B>";Взгляните на примеры ошибок, обнаруженных с помощью диагностики V735. |
Поведение не определено, если выполняется сравнение или арифметические операции над указателями, которые ссылаются на элементы, относящиеся к различным массивам.
Рассмотрим пример:
int a[10], b[20];
fill(a, b);
if (&a[1] > &b[2])Этот код содержит какую-то ошибку. Например, этот код мог получиться в результате неудачной автозамены фрагментов строк. Предположим, что здесь операторы '&' являются лишними. Тогда корректный код должен выглядеть так:
if (a[1] > b[2])Диагностическое правило классифицируется как:
|
Анализатор заподозрил, что в списке инициализации массива случайно пропущена одна из запятых.
Рассмотрим пример:
int a[3][6] = { { -1, -2, -3
-4, -5, -6 },
{ ..... },
{ ..... } };После "-3" случайно пропущена запятая. Далее следует значение "-4". Получается выражение "-3-4". В результате код успешно и без предупреждений компилируется, но массив инициализирован неправильно. Значения "-5", и "-6" будут записаны не на свои позиции, а в последний элемент будет записан 0.
В итоге, на самом деле массив инициализируется так:
int a[3][6] = { { -1, -2, -7,
-5, -6, 0 },
..............Правильный вариант (добавлена пропущенная запятая):
int a[3][6] = { { -1, -2, -3,
-4, -5, -6 },
..............Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V737. |
Анализатор обнаружил, что используется временный анонимный объект, получившийся в результате работы постфиксного оператора ++ или --. Иногда это имеет смысл. Но когда речь заходит о изменении этого временного объекта или взятии его адреса, то это ошибка.
Рассмотрим первый пример:
vector<float>::iterator it = foo();
it++ = x;Создаётся временная копия итератора. Итератор инкрементируется. После чего к временному объекту применяется оператор присваивания. Этот код не имеет смысла. Автор кода хотел явно сделать что-то другое. Например, он хотел в начале выполнить присваивание, а уже затем воспользоваться инкрементом.
В этом случае корректный код должен выглядеть так:
it = x;
it++;Однако постфиксная операция для итераторов не эффективна. И будет лучше написать так:
it = x;
++it;Есть ещё один вариант:
it = x + 1;Рассмотрим второй пример:
const vector<int>::iterator *itp = &it++;Указатель 'itp' использовать нельзя. Он указывает на временный неименованный объект, который уже разрушен. Корректный вариант кода:
++it;
const vector<int>::iterator *itp = Диагностическое правило классифицируется как:
|
Анализатор обнаружил, что константа EOF сравнивается с переменной типа 'char' или 'unsigned char'. Это свидетельствует о том, что некоторые символы будут обрабатываться программой неверно.
Рассмотрим, как объявлен EOF:
#define EOF (-1)Как видите, EOF есть ни что иное как '-1' типа 'int'. Посмотрим, к каким последствиям это может приводить. Первый пример:
unsigned char c;
while ((c = getchar()) != EOF)
{ .... }Беззнаковая переменная 'c' никогда не будет равна отрицательному значению '-1'. Поэтому выражение ((c = getchar) != EOF) всегда истинно, и возникает вечный цикл. Такая ошибка будет сразу замечена и исправлена. Поэтому не будем продолжать обсуждать тип 'unsigned char'.
Рассмотрим более интересный случай:
signed char c;
while ((c = getchar()) != EOF)
{ .... }Функция getchar() возвращает значения типа 'int'. А именно - она может вернуть число от 0 до 255 или -1 (EOF). Прочитанные значение помещаются в переменную типа 'char'. Из-за этого символ со значением 0xFF (255) превращается в -1 и интерпретируется точно также как конец файла (EOF).
Пользователи, использующие Extended ASCII Codes, иногда сталкиваются с ошибкой, когда один из символов их алфавита некорректно обрабатывается программами.
Например, последняя буква русского алфавита в кодировке Windows-1251 как раз имеет код 0xFF и воспринимается некоторыми программами как конец файла.
Исправленный вариант кода:
int c;
while ((c = getchar()) != EOF)Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V739. |
Анализатор обнаружил, что будет сгенерировано исключение, имеющее тип 'int', в то время как программист планировал сгенерировать исключение типа "указатель".
Рассмотрим пример кода:
if (unknown_error)
throw NULL;В случае возникновения неизвестной ошибки программист решил "бросить" нулевой указатель. Однако он не учёл, что NULL это не что иное, как обыкновенный 0. Вот как определён макрос NULL в C++ программах:
#define NULL 0Ноль '0' имеет тип 'int'. Поэтому будет сгенерировано исключения типа 'int'.
Оставим в стороне вопрос, что использовать указатели для генерации исключений плохо и опасно. Предположим, что в этом есть настоящая необходимость. Тогда исправленный вариант кода может выглядеть так:
if (unknown_error)
throw nullptr;Почему не стоит использовать указатели при работе с исключениями хорошо описано в книге:
Стефан К. Дьюхэрст. Скользкие места С++. Как избежать проблем при проектировании и компиляции ваших программ. – М.: ДМК Пресс. – 264 с.: ил. ISBN 5-94074-083-9.
Анализатор обнаружил, что после ключевого слова throw следуют круглые скобки, в которых через запятую перечислены различные значения. Высока вероятность, что забыли указать тип генерируемого исключения.
Рассмотрим пример:
throw ("foo", 123);Хотя код выглядит странно, он успешно компилируется. В данном случае, результатом выполнения оператора запятая ',' является значение 123. В результате будет сгенерировано исключение типа 'int'.
Другими словами, приведённый код эквивалентен следующему:
throw 123;Правильный вариант кода:
throw MyException("foo", 123);Диагностическое правило классифицируется как:
Анализатор обнаружил ошибку, связанную с тем, что в функцию, работающую со строкой, передается адрес переменной типа 'char', вместо указателя на буфер символов. Это может привести к ошибкам времени исполнения программы, так как функции, работающие с указателями на буфер символов, ожидают несколько символов и, иногда, терминальный ноль в конце такого буфера.
Рассмотрим пример:
const char a = 'f';
size_t len = strlen(&a);В данном случае в функцию, которая должна вернуть длину строки передается указатель на переменную 'а'. Функция будет считать строкой всю область памяти, следующую за адресом этой переменной до встречи символа, который будет соответствовать терминальному нулю. Результат выполнения этой функции не определён. Функция может вернуть произвольное значение или возникнет исключение из-за ошибки доступа к памяти.
Описанный тип ошибки встречается крайне редко и обычно связан с неаккуратным редактированием кода или с массовой заменой каких-то подстрок.
Для исправления ошибки необходимо использовать набор данных соответствующий буферу символов или применять функции, обрабатывающие одиночные символы.
Пример корректного кода:
const char a[] = "f";
size_t len = strlen(a);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V742. |
Анализатор обнаружил ошибку, связанную с тем, что в функции memcpy перекрываются области памяти источника и приемника. Использование функции memcpy в таком случае приведет к неопределенному поведению программы во время исполнения [1, 2].
Рассмотрим пример:
void func(int *x){
memcpy(x, x+2, 10 * sizeof(int));
}В данном случае указатель на источник данных (x+2) смещен относительно приемника данных на 8 байт (sizeof(int) * 2). Попытка копирования 40 байт в приемник из источника приведет к частичному перекрытию области памяти источника.
Для исправления ошибки необходимо использовать специальную функцию для таких операций – memmove(...) или скорректировать заданные смещения источника и приемника, чтобы не происходило перекрытия областей памяти.
Пример корректного кода:
void func(int *x){
memmove(x, x+2, 10 * sizeof(int));
}Дополнительные ссылки:
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V743. |
Анализатор обнаружил ошибку, связанную с тем, что при создании объекта ему забыли дать имя. В этом случае будет сконструирован временный анонимный объект и тут же разрушен. Иногда в этом нет ничего плохого, и именно этого и хотел добиться программист. Но если речь идёт о таких классах как 'CWaitCursor' или 'CMultiLock', то это явная ошибка.
Рассмотрим пример:
void func(){
CMutex mtx;
CSingleLock(&mtx, TRUE);
foo();
}В данном примере будет создан временный анонимный объект типа 'CSingleLock', которой будет сразу же разрушен, еще до вызова функции foo(). В примере программист хотел обеспечить синхронизацию при исполнении функции foo(), но на самом деле функция будет вызвана без синхронизации, что может привести к серьезным ошибкам.
Для исправления ошибки необходимо дать создаваемому объекту имя.
Пример корректного кода:
void func(){
CMutex mtx;
CSingleLock lock(&mtx, TRUE);
foo();
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Анализатор обнаружил, что со строкой типа wchar_t * начинают работать как со строкой типа BSTR. Это очень подозрительно, и код, скорее всего, содержит ошибку. Чтобы лучше понять, в чем заключается опасность, сначала вспомним, что такое BSTR.
Далее мы процитируем статью с сайта MSDN. Важно понять, в чём проблема, так как предупреждение V745 часто сигнализирует о серьёзных ошибках.
typedef wchar_t OLECHAR;
typedef OLECHAR * BSTR;BSTR (basic string или binary string) — это строковый тип данных, который используется в COM, Automation и Interop-функциях. Тип BSTR следует использовать во всех интерфейсах. Представление BSTR:
Тип BSTR является указателем, который указывает на первый символ строки, а не на префикс длины.
Память для BSTR-строк выделяется с помощью функций выделения памяти COM, поэтому они могут возвращаться методами без необходимости контроля над выделением памяти.
Представленный ниже код является неправильным:
BSTR MyBstr = L"I am a happy BSTR";Данный пример собирается (компилируется и линкуется) успешно, но не будет работать должным образом, поскольку у строки отсутствует префикс длины. Если проверить расположение в памяти данной переменной с помощью отладчика, он покажет отсутствие префикса длины размером 4 байта перед началом строки данных.
Правильный вариант кода должен выглядеть так:
BSTR MyBstr = SysAllocString(L"I am a happy BSTR");Теперь отладчик покажет наличие префикса длины, который равен значению 34. Оно соответствует 17 символам, которые приводится к wide-character строке с помощью строкового модификатора L. Отладчик также покажет двухбайтовый символ-ограничитель (0x0000) в конце строки.
Если передать простую Unicode-строку в качестве аргумента функции COM, которая ожидает BSTR-строку, произойдёт сбой в работе этой функции.
Примечание. Анализатор не может точно предсказать, есть в коде настоящая ошибка или нет. Если неправильная BSTR-строка передаётся куда-то вовне, то произойдёт сбой. Если же BSTR-строка превращается обратно в wchar_t *, то всё хорошо.
Речь идет о подобном коде:
wchar_t *wstr = Foo();
BSTR tmp = wstr;
wchar_t *wstr2 = tmp;Здесь нет настоящей ошибки, но это "код с запахом", который следует поправить. Так он вызовет меньше недоумения у программиста, сопровождающего код, и анализатор не будет выдавать предупреждение. Следует использовать правильные типы данных:
wchar_t *wstr = Foo();
wchar_t *tmp = wstr;
wchar_t *wstr2 = tmp;Рекомендуем также ознакомиться со ссылками, приведёнными в конце статьи. Они помогут разобраться с BSTR-строками и тем, как их можно конвертировать в строки других типов.
Рассмотрим ещё один пример:
wchar_t *wcharStr = L"123";
wchar_t *foo = L"12345";
int n = SysReAllocString(&wcharStr, foo);Описание функции SysReAllocString:
INT SysReAllocString(BSTR *pbstr, const OLECHAR *psz);Она выделяет новую BSTR и копирует в неё заданную строку, затем освобождает BSTR, на которую указывает pbstr, и помещает по этому адресу указатель на новую BSTR.
В качестве первого аргумента функция ожидает указатель на переменную, содержащую адрес строки в формате BSTR. Но вместо этого ей передают указатель на обыкновенную строку. Так как тип wchar_t ** с точки зрения компилятора — то же самое, что и BSTR *, то этот код успешно компилируется. Но на практике он не имеет смысла и приведёт к ошибке на этапе исполнения.
Правильный вариант кода:
BSTR wcharStr = SysAllocString(L"123");
wchar_t *foo = L"12345";
int n = SysReAllocString(&wcharStr, foo);Дополнительно рассмотрим ситуацию, когда используется ключевое слово auto. Анализатор выдаёт предупреждение на следующий безобидный код:
auto bstr = ::SysAllocStringByteLen(foo, 3);
ATL::CComBSTR value;
value.Attach(bstr); // Warning: V745Это ложное срабатывание, но формально анализатор прав, выдавая предупреждение. Переменная bstr имеет тип wchar_t *. Компилятор языка C++ при выведении типа для auto-переменной не учитывает, что функция возвращает значение типа BSTR. При выведении auto, тип BSTR — это просто синоним whar_t *. Получается, что написанный код эквивалентен:
wchar_t *bstr = ::SysAllocStringByteLen(foo, 3);
ATL::CComBSTR value;
value.Attach(bstr);Поэтому анализатор PVS-Studio и выдаёт предупреждение, так как не рекомендуется хранить указатель на BSTR строку в обыкновенном wchar_t * указателе. Чтобы устранить предупреждение, следует отказаться в данном месте от auto и написать тип явно:
BSTR *bstr = ::SysAllocStringByteLen(foo, 3);
ATL::CComBSTR value;
value.Attach(bstr);Это интересный случай, когда оператор auto не помогает, а наоборот — теряет информацию о типе и ухудшает ситуацию.
Другой вариант устранить предупреждение — использовать один из механизмов подавления ложных срабатываний, описанных в документации.
Дополнительные ссылки:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V745. |
Анализатор обнаружил потенциальную ошибку, связанную с перехватом исключения по значению. Намного лучше и безопасней перехватывать исключение по ссылке.
Вообще, перехват исключения по значению порождает две разновидности ошибок. Рассмотрим их поочередно.
Проблема N1. Срезка (slicing).
class Exception_Base {
....
virtual void Print() { .... }
};
class Exception_Ex : public Exception_Base { .... };
try
{
if (error) throw Exception_Ex(1, 2, 3);
}
catch (Exception_Base e)
{
e.Print();
throw e;
}Объявлено 2 класса: исключение базового типа и расширенное исключение, которое наследуется от первого.
Генерируется расширенное исключение. Это исключение планируется перехватить, распечатать о нём информацию и пробросить исключение дальше.
Исключение перехвачено по значению. Это значит, что с помощью конструктора копирования будет сконструирован новый объект 'e' типа Exception_Base. Это порождает сразу 2 ошибки.
Во-первых, часть информации об исключении потеряна. Всё что хранилось Exception_Ex нам более недоступно. Виртуальная функция Print() позволит вывести базовую информацию о проблеме.
Во-вторых, дальше будет проброшено уже новое исключение типа Exception_Base. Таким образом мы передали дальше урезанную информацию о возникшей проблеме.
Правильно будет использовать следующий код:
catch (Exception_Base &e)
{
e.Print();
throw;
}Теперь функция Print() распечатает всю нужную информацию. Оператор "throw" будет пробрасывать далее уже существующее исключение, и информация не будет потеряна (срезана).
Проблема N2. Изменение временного объекта.
catch (std::string s)
{
s += "Additional info";
throw;
}Программист хочет перехватить исключение, добавить какую-то дополнительную информацию и пробросить это исключение дальше. Ошибка в том, что изменяется переменная 's', а оператор "throw;" пробрасывает далее исходное исключение. Таким образом мы не изменили информацию о исключении.
Правильный вариант:
catch (std::string &s)
{
s += "Additional info";
throw;
}Подробнее про преимущества перехвата исключения по ссылке можно прочитать здесь:
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V746. |
Анализатор обнаружил подозрительное выражение в скобках. В круглых скобках через запятую перечислены различные переменные и значение. При этом не похоже, что оператор запятая ',' использовался для сокращения кода.
Рассмотрим пример:
if (memcmp(a, b, c) < 0 && (x, y, z) < 0)При написании текста программы случайно забыли написать имя функции 'memcmp'. Тем не менее код успешно компилируется, хотя работает не так, как задумывалось. В правой части результатом работы двух операторов запятая (comma operator) является переменная 'z'. Именно она сравнивается с нулём. В итоге, приведённый выше код, эквивалентен следующему:
if (memcmp(a, b, c) < 0 && z < 0)Правильный вариант кода:
if (memcmp(a, b, c) < 0 && memcmp(x, y, z) < 0)Примечание. Иногда оператор ',' используется для сокращения кода. Поэтому анализатор далеко не всегда ругается на запятые внутри скобок. Например, он считает корректным следующий код:
if (((std::cin >> A), A) && .....)Мы не рекомендуем писать такие сложные выражения, так как вашим коллегам потом будет тяжело читать такой код. Но и ошибки здесь явно нет. Разработчику просто захотелось совместить в одном выражении и получение значения, и его проверку.
Ещё один аналогичный пример:
if (a)
return (b = foo(), fooo(b), b);Диагностическое правило классифицируется как:
|
Анализатор обнаружил ошибку, связанную с тем, что память для функции getline() была выделена без использования функции malloc()/realloc(). Функция getline() написана таким образом, что если в процессе работы не хватает выделенной ранее памяти, getline() вызовет realloc() для её увеличения (ISO/IEC TR 24731-2). Поэтому выделять память необходимо только при помощи malloc() или realloc().
Рассмотрим пример:
char* buf = new char[count];
getline(&buf, &count, stream);В данном примере память для функции getline() выделена с помощью оператора new. Если getline() не хватит выделенной памяти, она вызовет realloc(). Результат такого вызова непредсказуем.
Для исправления ошибки необходимо переписать код таким образом, чтобы память для функции getline() выделялась только с использованием malloc() или realloc().
Корректный код:
char* buf = (char*)malloc(count * sizeof(char));
getline(&buf, &count, stream);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил ошибку, связанную с повторным вызовом деструктора. Если объект создается на стеке, то при выходе за пределы области видимости будет вызван деструктор. Анализатор обнаружил вызов деструктора для такого объекта напрямую.
Рассмотрим пример:
void func(){
X a;
a.~X();
foo();
}В данном примере для объекта 'a' напрямую вызывается деструктор. Но когда функция 'func' закончит свою работу, деструктор для объекта 'a' будет вызван еще раз.
Для исправления ошибки необходимо удалить ошибочный код или скорректировать код в соответствии с используемой моделью управления памятью.
Пример корректного кода:
void func(){
X a;
foo();
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V749. |
Анализатор обнаружил, что над указателем на строку в формате BSTR выполняются недопустимые операции. Указатель типа BSTR всегда должен ссылаться на первый символ строки. Если сдвинуть указатель хотя бы на один символ, то получим некорректную BSTR строку.
Такой код крайне опасен:
BSTR str = foo();
str++;Теперь 'str' нельзя использовать как BSTR строку. Если нужно пропустить один символ, следует написать следующий код:
BSTR str = foo();
BSTR newStr = SysAllocString(str + 1);Если вам не нужна BSTR строка, то можно написать следующий код:
BSTR str = foo();
const wchar_t *newStr = str;
newStr++;Или так:
BSTR str = foo();
const wchar_t *newStr = str + 1;Чтобы понять, почему недопустимо менять значение указателя типа BSTR, процитируем статью с сайта MSDN.
typedef wchar_t OLECHAR;
typedef OLECHAR * BSTR;BSTR (basic string или binary string) — это строковый тип данных, который используется в COM, Automation и Interop функциях. Тип BSTR следует использовать во всех интерфейсах. Представление BSTR:
Тип BSTR является указателем, который указывает на первый символ строки, а не на префикс длины.
Память для BSTR-строк выделяется с помощью функций выделения памяти COM, поэтому они могут возвращаться методами без необходимости контроля над выделением памяти.
Представленный ниже код является неправильным:
BSTR MyBstr = L"I am a happy BSTR";Данный пример собирается (компилируется и линкуется) успешно, но не будет работать должным образом, поскольку у строки отсутствует префикс длины. Если проверить расположение в памяти данной переменной с помощью отладчика, он покажет отсутствие префикса длины размером 4 байта перед началом строки данных.
Правильный вариант кода должен выглядеть так:
BSTR MyBstr = SysAllocString(L"I am a happy BSTR");Теперь отладчик покажет наличие префикса длины, который равен значению 34. Оно соответствует 17 символам, которые приводится к wide-character строке с помощью строкового модификатора L. Отладчик также покажет двухбайтовый символ-ограничитель (0x0000) в конце строки.
Если передать простую Unicode-строку в качестве аргумента функции COM, которая ожидает BSTR-строку, произойдёт сбой в работе этой функции.
Когда мы пишем код:
BSTR str = foo();
str += 3;Мы портим BSTR строку. Указатель ссылается не на начало строки, а куда-то в середину. Соответственно, если мы попытаемся взять длину строки по отрицательному смещению, то мы прочитаем случайное значение. Вернее, предыдущие символы будут интерпретированы как длина строки.
Дополнительные ссылки:
Анализатор обнаружил подозрительную функцию, один из параметров которой ни разу не используется. При этом другой его параметр используется несколько раз, что, возможно, свидетельствует о наличии ошибки.
Рассмотрим пример:
static bool CardHasLock(int width, int height)
{
const double xScale = 0.051;
const double yScale = 0.0278;
int lockWidth = (int)floor(width * xScale);
int lockHeight = (int)floor(width * yScale);
....
}Из кода видно, что параметр 'height' ни разу не используется в теле функции, при этом параметр 'width' используется дважды, в том числе при инициализации переменной 'lockHeight'. Скорее всего, здесь допущена ошибка, и код инициализации переменной 'lockHeight' должен был выглядеть следующим образом:
int lockHeight = (int)floor(height * yScale);Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V751. |
Анализатор обнаружил, что происходит попытка создать объект с помощью placement new, но размера выделенной для этого памяти не хватит для размещения создаваемого объекта. Будет использована память за пределами выделенного блока, что может привести к аварийному завершению программы или ее неправильному поведению.
Пример некорректного размещения объекта:
struct T { float x, y, z, q; };
char buf[12];
T *p = new (buf) T;В этом примере объект, размер которого составляет 16 байт, пытаются разместить в буфере 'buf', размер которого 12 байта. При использовании этого объекта произойдёт изменение памяти, лежащей за приделами буфера. Результат непредсказуем.
Для исправления ошибки необходимо скорректировать размер буфера или убедиться, что правильно задано смещение относительно начала буфера.
Вариант правильного кода:
struct T { float x, y, z, q; };
char buf[sizeof(T)];
T *p = new (buf) T;Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти), Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил, что в результате выполнения побитового оператора "И" значение переменной будет установлено в ноль, что выглядит подозрительно, так как нулевое значение можно получить простым присвоением.
Если же выполняются последовательные вычисления, то возможно данная операция выполняется некорректно, например, из-за опечатки используется не та переменная, что задумывалось или справа используется неправильная константа.
Возможны несколько вариантов возникновения данного предупреждения.
Первый пример - последовательное применение оператора к переменной с неизвестным значением с такими константами, с которыми результирующее значение будет равно нулю:
void foo(int A)
{
A &= 0xf0;
....
A &= 1;
// Теперь 'A' всегда равно 0.
}Результатом выполнения двух операций будет нулевое значение независимо от изначального значения переменной 'A'. Возможно этот код ошибочен, и программисту необходимо проверить правильность используемых констант.
Второй случай - это применение оператора к переменной, значение которой заведомо известно:
void foo()
{
int C;
....
C = 1;
....
C &= 2;
// C == 0
}В данном случае при применении оператора к переменной, значение которой известно, также будет получено нулевое значение. Как и в предыдущем случае программисту необходимо проверить правильность используемой константы.
Диагностика может сработать и в следующем, довольно часто использующемся, варианте применения оператора:
void foo()
{
int flags;
....
flags = 1;
....
flags &= ~flags;
....
}Этот прием программисты иногда используют для сброса набора флагов в нулевое значение. На наш взгляд такой способ не оправдан и может только запутать ваших коллег. Лучше использовать простое присвоение:
void foo()
{
int flags;
....
flags = 1;
....
flags = 0;
....
}Диагностическое правило классифицируется как:
Анализатор обнаружил, что фактическим аргументом функции является вызов этой-же функции.
Пример некорректного кода:
char lower_ch = tolower(tolower(ch));В этом примере второй вызов функции избыточен. Возможно в коде допущена опечатка и подразумевался вызов другой функции. Если ошибки нет, то следует убрать лишний вызов, так как подобное выражение выглядит подозрительно:
char lower_ch = tolower(ch);Другой пример:
if (islower(islower(ch)))
do_something();Функция 'islower' возвращает значение типа int и может быть использовано в качестве аргумента к самой себе. Данное выражение содержит ошибку и не имеет практического смысла.
Анализатор обнаружил, что в буфер копируются данные из небезопасного источника.
Примерами таких источников являются:
Пример небезопасной работы с аргументами командной строки:
int main(int argc, char *argv[])
{
....
const size_t buf_size = 1024;
char *tmp = (char *) malloc(buf_size);
....
strcpy(tmp, argv[0]);
....
}В случае, когда размер копируемых данных превысит размер буфера, произойдёт его переполнение. Для того чтобы избежать этого, лучше вычислить требуемый объём памяти заранее:
int main(int argc, char *argv[])
{
....
char buffer[1024];
errno_t err = strncpy_s(buffer, sizeof(buffer), argv[0], 1024);
....
}Также можно выделять память по мере необходимости, используя функцию 'realloc'. В C++ для работы со строками можно использовать классы, такие как 'std::string'.
До стандарта С++20 была доступна возможность использовать C-строку в качестве буфера-приёмника для стандартных потоков ввода ('std::cin', 'std::ifstream'):
void BadRead(char *receiver)
{
std::cin >> receiver;
}К счастью, в С++ 20 такую возможность убрали, и теперь потоки ввода стандартной библиотеки можно использовать только с массивами известного размера. При этом происходит неявное ограничение максимально считываемого количества символов.
void Exception2Cpp20()
{
char *buffer1 = new char[10];
std::cin >> buffer1; // Won't compile since C++20
char buffer2[10];
std::cin >> buffer2; // no overflow
// max 9 chars will be read
}Более подробно это изменение (с примерами и применением) освещено в предложении P0487R1 к стандарту С++ 20.
Злоумышленники могут манипулировать значением, возвращаемым некоторыми функциями, поэтому следует быть предельно аккуратными при работе с ними:
void InsecureDataProcessing()
{
char oldLocale[50];
strcpy(oldLocale, setlocale(LC_ALL, nullptr));
....
}В данном примере создаётся буфер фиксированного размера, в который происходит чтение из переменной окружения 'LC_ALL'. Если у злоумышленника имеется возможность повлиять на неё, то чтение может привести к переполнению буфера.
Предупреждение не выдаётся в случаях, если источник данных неизвестен:
void Exception1(int argc, char *argv[])
{
char *src = GetData();
char *tmp = (char *)malloc(1024);
strcpy(tmp, src);
....
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку, связанную с тем, что при написании двух и более вложенных циклов 'for', из-за опечатки не используется счётчик одного из циклов.
Рассмотрим синтетический пример некорректного кода:
for (int i = 0; i < N; i++)
for (int j = 0; j < M; j++)
sum += matrix[i][i];В коде планировали обойти все элементы матрицы и найти их сумму, но случайно написали переменную 'i' вместо 'j' при обращении к матрице.
Корректный вариант кода:
for (int i = 0; i < N; i++)
for (int j = 0; j < M; j++)
sum += matrix[i][j];В отличии от диагностических правил V533, и V534, здесь анализатор ищет ошибки с использованием индекса только в теле циклов.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V756. |
Анализатор обнаружил потенциальную ошибку, которая может привести к доступу по нулевому адресу.
Анализатор заметил в коде следующую ситуацию. Сначала указатель на базовый класс приводится к указателю на производный класс с помощью 'dynamic_cast'. А затем этот же указатель проверяется на значение 'nullptr', хотя в этом случае, скорее всего, предполагалось проверить на 'nullptr' указатель, полученный в результате приведения.
Рассмотрим следующий пример. Здесь возможна ситуация, когда указатель 'baseObj' не будет ссылаться на экземпляр класса 'Derived'. В этом случае при вызове функции произойдёт разыменование нулевого указателя. Анализатор выдаст предупреждение на этот код, указав две строки. Первая строка - это то место, где указатель проверяется на 'nullptr'. Вторая строка - это то место, где указатель на базовый класс приводится к указателю на производный класс.
Base *baseObj;
....
Derived *derivedObj = dynamic_cast<Derived *>(baseObj);
if (baseObj != nullptr)
{
derivedObj->Func();
}Скорее всего в этом примере перед использованием предполагалось проверить на 'nullptr' указатель, полученный в результате приведения. Исправленный вариант кода:
Base *baseObj;
....
Derived *derivedObj = dynamic_cast<Derived *>(baseObj)
if (derivedObj != null)
{
derivedObj->Func();
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V757. |
Анализатор обнаружил ссылку, которая может стать недействительной. Она ссылается на объект, находящийся под управлением умного указателя или контейнера, который возвращают из функции по значению. После разрушения временного объекта, при возврате из функции, будет разрушен и контролируемый им объект. Ссылка на него станет недействительной. Попытка использования такой ссылки приведет к неопределенному поведению.
Рассмотрим пример с умным указателем 'unique_ptr':
std::unique_ptr<A> Foo()
{
std::unique_ptr<A> pa(new A());
return pa;
}
void Foo2()
{
const A &ra = *Foo();
ra.foo();
}Ссылка указывает на объект, который находится под управлением умного указателя 'unique_ptr'. После выхода из функции временный объект 'unique_ptr' разрушается, и ссылка становится недействительной.
Чтобы избежать подобных проблем, необходимо отказаться от использования ссылки и переписать функцию 'Foo2()' следующим образом:
void Foo2()
{
A a(*Foo());
a.foo();
}Теперь мы используем не ссылку, а создаём новый объект типа 'A'. Причем, начиная с C++11, для инициализации переменной 'a' может использоваться конструктор перемещения и никаких потерь в производительности не произойдет.
Также можно использовать следующий вариант:
void Foo2()
{
std::unique_ptr<A> pa = Foo();
pa->foo();
}В данной ситуации произойдет передача владения объектом типа 'A'.
Рассмотрим пример с контейнером 'std::vector':
std::vector<A> Foo();
void Foo2()
{
const A &ra = Foo()[42];
ra.foo();
}Проблема точно такая же, что и с 'unique_ptr': временный объект 'vector' разрушается, и ссылка на его элемент становится недействительной.
То же самое относится и к методам, которые возвращают ссылки на элементы внутри контейнера: front(), back() и другие:
void Foo2()
{
const A &ra = Foo().front();
ra.foo();
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V758. |
Анализатор обнаружил множественные обработчики исключений с нарушенным порядком следования. Обработчик для базового класса исключений размещен перед обработчиком для производного класса. В таком случае все исключения, предназначенные для перехвата обработчиком производного класса, будут перехвачены обработчиком для базового класса.
Рассмотрим пример:
class Exception { .... };
class DerivedException : public Exception { ... };
void foo()
{
throw DerivedException;
}
void bar()
{
try
{
foo();
}
catch (Exception&)
{
// Все исключения, имеющие тип DerivedException попадут сюда
}
catch (DerivedException&)
{
// Код в этом обработчике никогда не выполняется
}
}Так как класс Exception является базовым для класса DerivedException, исключения, которые генерирует функция foo, перехватываются первым обработчиком.
Чтобы исправить ошибку, нужно поменять обработчики исключений местами:
void bar()
{
try
{
foo();
}
catch (DerivedException&)
{
// Перехватывает исключения типа DerivedException
}
catch (Exception&)
{
// Перехватывает исключения типа Exception
}
}Теперь каждый обработчик перехватывает исключения, предназначенные только для него.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил код, который возможно содержит опечатку. Высока вероятность, что подобный код был создан с использованием подхода Copy-Paste. Сообщение V760 выдаётся на два одинаковых блока текста, идущих один за другим. Данная диагностика в основном опирается на эвристический метод и поэтому может выдавать ложные срабатывания.
Рассмотрим пример:
void Example(int *a, int *b, size_t n)
{
....
for (size_t i = 0; i != n; i++)
a[i] = 0;
for (size_t i = 0; i != n; i++)
a[i] = 0;
....
}Код писался с помощью Copy-Paste. Во втором блоке забыли изменить имя массива. На самом деле, код должен быть таким:
void Example(int *a, int *b, size_t n)
{
....
for (size_t i = 0; i != n; i++)
a[i] = 0;
for (size_t i = 0; i != n; i++)
b[i] = 0;
....
}Анализатор не выдаёт сообщение, если найдено больше двух блоков текста. Пример:
void Foo();
void Example()
{
....
Foo();
Foo();
Foo();
Foo();
....
}Иногда может быть непонятно, что не нравится анализатору. Рассмотрим такой пример:
switch(t) {
case '!': InvokeMethod(&obj_Sylia, "!", 1); break;
case '~': InvokeMethod(&obj_Sylia, "~", 1); break;
case '+': InvokeMethod(&obj_Sylia, "+", 1); break;
case '-': InvokeMethod(&obj_Sylia, "-", 1); break;
break;
default:
SCRIPT_ERROR(PARSE_ERROR);
}Нужно присмотреться. В данном случае мы имеем дело с очень коротким повторяющимся блоком. Этот блок - оператор 'break'. Один из операторов здесь лишний. В данном примере это не приводит к настоящей ошибке, но лишний 'break' стоит удалить:
switch(t) {
case '!': InvokeMethod(&obj_Sylia, "!", 1); break;
case '~': InvokeMethod(&obj_Sylia, "~", 1); break;
case '+': InvokeMethod(&obj_Sylia, "+", 1); break;
case '-': InvokeMethod(&obj_Sylia, "-", 1); break;
default:
SCRIPT_ERROR(PARSE_ERROR);
}Примечание
Дублирование кода само по себе не является ошибкой. Однако, даже если ошибки нет, предупреждение V760 может служить подсказкой, что одинаковые блоки кода стоит вынести в функцию. См. также диагностику V761.
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V760. |
Анализатор обнаружил код, который можно улучшить рефакторингом. Данная диагностика ищет одинаковые блоки текста, которые повторяются три или более раз. Вряд ли такой код содержит ошибку, но лучше постараться вынести одинаковый код в отдельную функцию.
В случае, когда код использует много локальных переменных, облегчить ситуацию могут лямбда-функции, с помощью который можно захватить данные по ссылке.
Диагностика может выдавать большое количество срабатываний на коде, где применяется большое количество ручных оптимизаций (например, ручная развёртка циклов). Если вы считаете, что диагностика V761 не актуальна в вашем проекте, то вы можете её отключить.
Рассмотрим синтетический пример, на который анализатор выдаёт предупреждение:
void process(char *&buf);
void func(size_t n, char *arr)
{
size_t i;
i = n;
while (i--)
arr[i] = 1;
for (i = 0; i != 10; i++)
arr[i] = 'a';
process(arr);
i = n;
while (i--)
arr[i] = 1;
for (i = 0; i != 10; i++)
arr[i] = 'a';
process(arr);
i = n;
while (i--)
arr[i] = 1;
for (i = 0; i != 10; i++)
arr[i] = 'a';
process(arr);
i = n;
while (i--)
arr[i] = 1;
for (i = 0; i != 10; i++)
arr[i] = 'a';
process(arr);
}Будет полезно вынести общий код в отдельную функцию:
void process(char*& buf);
void func_impl(size_t i, size_t *&arr)
{
while (i--)
arr[i] = 1;
for (i = 0; i != 10; i++)
arr[i] = 'a';
process(arr);
}
void func(size_t n, char *arr)
{
for (size_t i = 0; i < 4; ++i)
func_impl(n, arr);
}См. также диагностику V760.
Диагностика выявляет ошибки при переопределении виртуальных функций. Рассмотрим два возможных варианта.
Вариант N1. В базовом классе имеется виртуальная функция, в которой один из параметров имеет один тип. В наследнике есть точно такая же функция, но этот параметр имеет другой тип. При этом типы могут быть либо целочисленными типами, либо перечислениями, либо указателями или ссылками на базовый и унаследованный классы.
Эта диагностика помогает выявить ошибки, когда при большом рефакторинге меняют тип функции в одном из классов, но забывают изменить эту функцию в другом классе.
Рассмотрим пример:
struct Q { virtual int x(short) { return 1; } };
struct W : public Q { int x(int) { return 2; } };На самом деле, код должен быть таким:
struct Q { virtual int x(short) { return 1; } };
struct W : public Q { int x(short) { return 2; } };Если в базовом классе будет две функции 'x' с аргументами 'int' и 'short', то анализатор предупреждение V762 выдавать не будет.
Вариант N2. Диагностика выдаётся в случае, когда в функции базового класса добавили новый аргумент или наоборот удалили. При этом забыли поменять объявление функции в одном из классов-наследников.
Пример подобной ситуации:
struct Q { virtual int x(int, int=3) { return 1; } };
struct W : public Q { int x(int) { return 2; } };Корректный код:
struct Q { virtual int x(int, int=3) { return 1; } };
struct W : public Q { int x(int, int) { return 2; } };Сценарий возникновения ошибки может быть следующим. Есть иерархия классов. В какой-то момент в функцию базового класса или класса-наследника добавляют аргумент. В итоге объявляется новая функция, никак не связанная с функцией из базового класса.
Это выглядит подозрительно и может быть ошибкой. Может быть забыли поправить один из классов, может быть забыли про то, что функция является виртуальной. Но анализатор не может понять по смыслу функции, что данный код корректен. Если же данное поведение предусмотрено и ошибкой не является, можно воспользоваться одним из механизмов подавления ложных срабатываний.
Пример подозрительного кода:
struct CA
{
virtual void Do(int Arg);
};
struct CB : CA
{
virtual void Do(int Arg1, double Arg2);
};Для того чтобы избежать подобных ошибок при использовании C++11 и выше рекомендуется использовать ключевое слово 'override', которое предотвратит несовпадение сигнатур на этапе компиляции.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V762. |
Анализатор нашёл потенциальную ошибку в теле функции. Один из его параметров перезаписывается перед тем, как используется. Таким образом, значение, пришедшее в функцию, попросту теряется.
Рассмотрим пример кода:
void Foo(Node A, Node B)
{
A = SkipParenthesize(A);
B = SkipParenthesize(A); // <=
AnalyzeNode(A);
AnalyzeNode(B);
}Здесь допущена опечатка, так как перепутаны параметры 'A' и 'B', из-за чего переменная 'B' примет неверное значение. Исправленный код выглядит так:
void Foo(Node A, Node B)
{
A = SkipParenthesize(A);
B = SkipParenthesize(B);
AnalyzeNode(A);
AnalyzeNode(B);
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V763. |
Анализатор обнаружил подозрительную передачу аргументов в функцию. Некоторые имена аргументов не соответствуют именам параметров, в качестве которых они передаются. Это может свидетельствовать об ошибочной передаче значений в функцию.
Пусть имеется объявление функции следующего вида:
void SetRGB(unsigned r, unsigned g, unsigned b);Пример ошибочного кода:
void Foo()
{
unsigned R = 0, G = 0, B = 0;
....
SetRGB(R, B, G);
....
}Во время задания цвета объекта, перепутали значения синего и зелёного цветов.
Исправленный вариант кода должен выглядеть следующим образом:
SetRGB(R, G, B);Если функция принимает в качестве параметров границы некоторого диапазона, то можно разметить соответствующие параметры как верхнюю и нижнюю границу. Тогда в случае нарушения порядка передачи аргументов при вызове функции можно получить соответствующее срабатывание.
Пример. Есть функция, семантически схожая с 'std::clamp', со следующей сигнатурой:
bool foo(int v, int lo, int hi);Эта функция проверяет, что значение первого параметра лежит в диапазоне, переданном в качестве второго (нижняя граница) и третьего (верхняя граница) параметров.
Предположим, что есть следующий вызов данной функции:
if (foo(v, max, min))
{
....
}Как мы видим, в вызове перепутаны местами аргументы для нижней и верхней границы. Тогда, чтобы получить срабатывание в месте вызова функции, необходимо разметить второй параметр функции foo как lower_bound, а третий как upper_bound. Также для дополнительной настройки диагностики V575 можно разметить первый параметр функции foo как in_range_value.
Исправленный код:
if (foo(x, min, max))
{
....
}Примеры разметки параметров функций можно посмотреть здесь.
Примечание. Данная разметка необходима только для пользовательских функций.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V764. |
Анализатор нашёл потенциальную ошибку в арифметическом или логическом выражении. В составном присваивании переменная стоит и слева, и справа от оператора.
Рассмотрим пример кода:
void Foo(int x, int y, int z)
{
x += x + y;
....
}Возможно, что здесь допущена опечатка, и правильный код должен выглядеть так:
void Foo(int x, int y, int z)
{
x = x + y;
....
}Или так:
void Foo(int x, int y, int z)
{
x += z + y;
....
}Конечно, подобные выражения используют для того, чтобы хитро умножить число на два. Тем не менее такой код подозрителен, и его стоит перепроверить. Такие операции выглядят довольно запутанно и, возможно, стоит написать гораздо более простой и понятный код:
void Foo(int x, int y, int z)
{
x = x * 2 + y;
....
}Есть и более подозрительные выражения, работу которых стоит внимательно проверить:
void Foo(int x, int y)
{
x -= x + y;
}Данное выражение можно упростить следующим образом:
Не понятно, является ли такое поведение преднамеренным или же это опечатка. В любом случае, этот код следует проверить.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V765. |
Анализатор обнаружил подозрительную ситуацию, когда в словарь (контейнеры типа 'map' и т.п.) или в множество (контейнеры типа 'set' и т.п.) добавляются элементы с ключами, уже присутствующими в этих контейнерах. В результате добавление нового элемента будет проигнорировано. Это может свидетельствовать об опечатке и привести к неверному заполнению контейнера.
Рассмотрим пример со словарём:
map<char, int> dict = map<char, int>{
make_pair('a', 10),
make_pair('b', 20),
make_pair('a', 30) // <=
};В последней строке инициализации была допущена ошибка, так как ключ 'a' уже содержится в словаре. В результате данный словарь будет содержать 2 значения, причём значение, связанное с ключом 'a', будет равно 10.
Исправить ошибку можно, использовав правильное значение ключа:
map<char, int> dict = map<char, int>{
make_pair('a', 10),
make_pair('b', 20),
make_pair('c', 30)
};Схожую ошибку можно допустить и при инициализации множества:
set<string> someSet = set<string>{
"First",
"Second",
"Third",
"First", // <=
"Fifth"
};Из-за ошибки вместо ключа 'Fourth' в множество 'someSet' пытаются записать строку 'First', но так как такой ключ уже содержится в множестве, он будет проигнорирован.
Для исправления ошибки необходимо исправить список инициализации:
set<string> someSet = set<string>{
"First",
"Second",
"Third",
"Fourth",
"Fifth"
};Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V766. |
Анализатор обнаружил возможную ошибку, связанную с тем, что в цикле 'for' на каждой итерации к элементу массива или контейнера обращаются по одному и тому же константному индексу.
Рассмотрим пример некорректного кода:
void Foo(vector<size_t> &vect)
{
for (size_t i = 0; i < vect.size(); i++)
vect[0] *= 2;
}В данной функции хотели изменить все значения, хранящиеся в векторе, однако из-за опечатки доступ к элементам вектора осуществляется не по счётчику цикла 'i', а по константному значению - 0. В итоге будет изменено только одно значение (если вектор не пустой).
Для исправления ошибки необходимо правильно переписать обращение к элементам контейнера:
void Foo(vector<size_t> &vect)
{
for (size_t i = 0; i < vect.size(); i++)
vect[i] *= 2;
}Взгляните на примеры ошибок, обнаруженных с помощью диагностики V767. |
Анализатор обнаружил подозрительный фрагмент кода, в котором именованная константа из перечисления либо переменная типа перечисления используется как булевое значение. Скорее всего, это свидетельствует о наличии ошибки в логике программы.
Рассмотрим пример.
enum Offset { left=10, right=15, top=20, bottom=25 };
void func(Offset offset)
{
....
if (offset || i < 10)
{
....
}
}В данном случае переменная типа перечисления 'offset' используется как булевое значение, но поскольку в перечислении 'Offset' все значения ненулевые, то условие будет выполняться всегда. Предупреждение анализатора в данном случае подсказывает, что выражение написано неверно и его следует исправить, например, так:
void func(Offset offset)
{
....
if (offset == top || i < 10)
{
....
}
}Рассмотрим еще один пример. Пусть у нас имеется перечисление следующего вида:
enum NodeKind
{
NK_Identifier = 64,
....
};И класс вида
class Node
{
public:
NodeKind _kind;
bool IsKind(ptrdiff_t kind) const { return _kind == kind; }
};Тогда ошибка может выглядеть следующим образом:
void foo(Node node)
{
if (node.IsKind(!NK_Identifier))
return;
....
}Подразумевалось прекращение выполнения функции, если текущий узел не является идентификатором. Но результат выражения '!NK_Identifier' будет равен '0', а перечисление 'NodeKind' не содержит элемента с таким значением. Как итог, метод 'IsKind' всегда будет возвращать значение 'false', и функция продолжит выполнение, независимо от того, чем является текущий узел.
Исправленный вариант кода выглядит так:
void foo(Node node)
{
if (!node.IsKind(NK_Identifier))
return;
....
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V768. |
Анализатор обнаружил подозрительную операцию, применяемую к нулевому указателю. Полученный указатель не имеет смысла. Скорее всего, это свидетельствует о наличии ошибки в логике программы.
Пример:
void foo(bool isEmpty, char *str)
{
char *begin = isEmpty ? str : nullptr;
char *end = begin + strlen(str);
....
}Если указатель begin равен nullptr, то выражение nullptr + len не имеет смысла: использовать его всё равно нельзя. Возможно, переменная дальше не используется. Тогда стоит провести рефакторинг кода таким образом, чтобы данная операция не осуществлялась над нулевым указателем: это потенциальный источник ошибок, если кто-то об этом забудет и попытается обратиться по указателю.
Исправленный вариант:
void foo(bool isEmpty, char *str)
{
char *begin = isEmpty ? str : nullptr;
if (begin != nullptr)
{
char *end = begin + strlen(str);
....
}
....
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V769. |
Анализатор обнаружил потенциально возможную опечатку в коде, связанную с тем, что в условии цикла вместо операторов '<' и '<=' используются '<<' и '<<=', соответственно.
Рассмотрим пример такого кода:
void Foo(std::vector<int> vec)
{
for (size_t i = 0; i << vec.size(); i++) // <=
{
// Something
}
}Выражение "i << vec.size()" будет равно нулю. Это явно ошибка, поскольку тело цикла ни разу не выполняется. Корректный вариант кода:
void Foo(std::vector<int> vec)
{
for (size_t i = 0; i < vec.size(); i++)
{
// Something
}
}Примечание. Сдвиги вправо (>>, >>=) считаются нормальной ситуацией, так как они используются в различных алгоритмах, например, вычисление количества бит, равных 1. Пример:
size_t num;
unsigned short var = N;
for (num = var & 1 ; var >>= 1; num += var & 1);Диагностическое правило классифицируется как:
Анализатор обнаружил потенциально возможную ошибку в коде, связанную с тем, что в тернарном операторе '?:' в качестве второго и третьего операндов используются константные значения из разных перечислений.
Рассмотрим пример такого кода:
enum OnlyOdd { Not_Odd, Odd };
enum OnlyEven { Not_Even, Even };
int isEven(int a)
{
return (a % 2) == 0 ? Even : Odd;
}Функция проверяет число на четность, но в возвращающемся значении используются константы из двух разных перечислений (OnlyEven::Even и OnlyOdd::Odd), приводимые к типу 'int'. В результате, независимо от переданного аргумента 'a', функция всегда будет возвращать 1 (истину). Корректный код должен выглядеть следующим образом:
enum OnlyOdd { Not_Odd, Odd };
enum OnlyEven { Not_Even, Even };
int isEven(int a)
{
return (a % 2) == 0 ? Even : Not_Even;
}Примечание. Нормальной ситуацией считается применение двух разных перечислений без имени, например:
enum
{
FLAG_FIRST = 0x01 << 0,
FLAG_SECOND = 0x01 << 1,
....
};
enum
{
FLAG_RW = FLAG_FIRST | FLAG_SECOND,
....
};
....
bool condition = ...;
int foo = condition ? FLAG_SECOND : FLAG_RW; // нет V771
....Анализатор обнаружил потенциальную ошибку в коде, связанную с тем, что оператор delete или delete[] применяется для нетипизированного указателя (void*). Согласно стандарту C++20 (п. п. $7.6.2.8/3) такое применение ведет к неопределенному поведению.
Рассмотрим пример:
class Example
{
int *buf;
public:
Example(size_t n = 1024) { buf = new int[n]; }
~Example() { delete[] buf; }
};
....
void *ptr = new Example();
....
delete ptr;
....Подобный код опасен тем, что компилятор в реальности не знает, к каком типу относится указатель ptr. Поэтому, при удалении такого нетипизированного указателя могут произойти различные неприятности, например, может возникнуть утечка памяти: оператор delete не вызовет деструктор объекта типа Example, на который ссылается указатель ptr.
Если подразумевалась именно работа с нетипизированным указателем, то перед применением оператора delete (delete[]) его необходимо привести к изначальному типу, например так:
....
void *ptr = new Example();
....
delete (Example*)ptr;
....Иначе, во избежание ошибок, рекомендуется использовать только типизированные указатели совместно с оператором delete (delete[]):
....
Example *ptr = new Example();
....
delete ptr;
....Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V772. |
Анализатор обнаружил потенциально возможную утечку памяти в коде. Такая ситуация возникает, когда память, выделенная с помощью 'malloc' или 'new', не была далее освобождена.
Рассмотрим пример такого кода:
int *NewInt()
{
int *p = new (std::nothrow) int;
....
return p;
}
bool Test()
{
int *p = NewInt();
int res = *p;
return res;
}В данном примере, выделение памяти спрятано в вызове другой функции. Соответственно после вызова нужно соответствующим образом освободить память.
Исправленный код, где не возникает утечка памяти:
int *NewInt()
{
int *p = new int;
....
return p;
}
bool Test()
{
int *p = NewInt();
int res = *p;
delete p;
return res;
}Часто подобные ошибки можно встретить в обработчиках ошибочных ситуаций, так как к ним невнимательно относятся при обзорах кода и слабо тестируют. Пример:
bool Test()
{
int *p = (int*)malloc(sizeof(int));
int *q = (int*)malloc(sizeof(int));
if (p == nullptr || q == nullptr)
{
std::cerr << "No memory";
return -1;
}
int res = *p + *q;
free(p);
free(q);
return res;
}Может сложиться ситуация, когда указатель 'p' будет хранить указатель на выделенную память, а 'q' будет равен 'nullptr'. Тогда выделенная память освобождена не будет. Кстати, может быть и наоборот. В параллельной программе реальна ситуация, когда первый раз не удастся выделить память, а потом удастся.
Помимо утечек памяти, анализатор может находить утечки ресурсов: незакрытые дескрипторы, файлы и т.д. Такие ошибки не сильно отличаются друг от друга, поэтому к ним относится всё вышесказанное. Приведём небольшой пример:
void LoadBuffer(char *buf, size_t len)
{
FILE* f = fopen("my_file.bin", "rb");
fread(buf, sizeof(char), len, f);
}Примечание. В современном C++ лучше обходиться без ручного управления ресурсами и использовать умные указатели. Например, можно рекомендовать использовать 'std::unique_ptr'. В этом случае вся память будет освобождена корректно во всех точках выхода функции. Также такое решение будет exception-safe.
У статического анализатора меньше информации об указателях, чем у динамического, поэтому анализатор может выдавать ложные предупреждения, если память освобождается нетривиально или далеко от места, где выделяется. Для отключения таких предупреждений предусмотрен специальный комментарий:
//+V773:SUPPRESS, class:className, namespace:nsNameПараметр 'namespace' является необязательным.
Рассмотрим пример:
void foo()
{
EVENT* event = new EVENT;
event->send();
}Объект класса 'EVENT' не должен удаляться в этой функции, поэтому отключить все предупреждения V773 на этот класс можно с помощью комментария:
//+V773:SUPPRESS, class:EVENTВыявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V773. |
Анализатор обнаружил использование указателя, который ссылается на освобождённый участок памяти. Это является неопределённым поведением и может привести к разнообразнейшим последствиям.
Некоторые возможные варианты:
Рассмотрим пример такого кода:
for (node *p = head; p != nullptr; p = p->next)
{
delete p;
}В данном примере при выполнении выражения 'p = p->next' произойдёт разыменование указателя p, удалённого в теле цикла. Необходимо было сначала вычислить это выражение и только потом освободить память. Исправленный вариант кода:
node *p = head;
while (p != nullptr)
{
node *prev = p;
p = p->next;
delete prev;
}Неприятное в таких ошибках, что долгое время может казаться, что программа работает корректно. При этом, всё может сломаться после простого рефакторинга кода, добавлении новой переменной, смены компилятора и так далее.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V774. |
Анализатор обнаружил подозрительное сравнение элемента BSTR-типа, при помощи операторов отношения: >, <, >=, <=.
BSTR (basic string или binary string) - это строковый тип данных, который используется в COM, Automation и Interop функциях. Этот тип данных включает в себя префикс длины, строку данных и терминальный ноль.
Тип BSTR является указателем, который всегда указывает на первый символ строки данных, а не на префикс длины. По этой причине, каждый BSTR объект является уникальным и один BSTR не может быть частью другого, как это возможно с обычными строками.
Однако, обычная строка может являться частью BSTR (но не наоборот), поэтому сравнения вида "wchar_t* > BSTR" допустимы.
Рассмотрим пример:
void func(BSTR a, BSTR b)
{
if (a > b)
{
....
}
}Данный код является ошибочным, так как сравнение указателей 'a' и 'b' не имеет смысла.
Подробнее про BSTR можно прочитать на MSDN.
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциально бесконечный цикл, условие выхода из которого зависит от переменной, значение которой никогда не меняется в теле цикла.
Рассмотрим пример:
int Do(int x);
....
int n = Foo();
int x = 0;
while (x < n)
{
Do(x);
}Условие выхода из цикла зависит от переменной x, значение которой в цикле всегда будет равно нулю. При n > 0, проверка x < n всегда будет истинной, что приведет к бесконечному циклу.
Исправленный вариант:
int Do(int x);
....
int n = Foo();
int x = 0;
while (x < n)
{
x = Do(x);
}Рассмотрим еще один пример. Условие выхода из цикла зависит от переменной, изменение значения которой зависит от других переменных, которые никогда не меняются в теле цикла.
int Foo(int a)
{
int j = 0;
while (true)
{
if (a >= 32)
{
return j * a;
}
if (j == 10)
{
j = 0;
}
j++;
}
}Условие выхода из цикла зависит от параметра a. В случае если параметр a не будет удовлетворять условию проверки a >= 32, то цикл будет бесконечным, так как значение a в теле цикла не изменяется.
Корректный вариант:
int Foo(int a)
{
int j = 0;
while (true)
{
if (a >= 32)
{
return j * a;
}
if (j == 10)
{
j = 0;
a++; // <=
}
j++;
}
}Таким образом изменение параметра a будет зависеть от локальной переменной j.
Диагностическое правило классифицируется как:
Анализатор обнаружил потенциально возможную ошибку в коде, связанную с тем, что массив производных классов адресуется через указатель на базовый класс. При попытке доступа к ненулевому элементу массива через указатель на базовый класс произойдет ошибка.
Рассмотрим пример такого кода:
class Base
{
int buf[10];
public:
virtual void Foo() { ... }
virtual ~Base() { }
};
class Derived : public Base
{
char buf[10];
public:
virtual void Foo() override { ... }
virtual ~Derived() { }
};
....
size_t n = 5;
Base *ptr = new Derived[n]; // <=
....
for (size_t i = 0; i < n; ++i)
(ptr + i)->Foo();
....В примере объявлены базовый класс "Base" и производный от него "Derived". Каждый объект этих классов будут занимать в памяти 48 и 64 байта соответственно (вследствие выравнивания классов по ширине 8 байт; компилятор MSVC, 64-bit). При "i >= 1" для обращения к ненулевому элементу необходимо каждый раз перемещать указатель на "i * 64" байта, но, поскольку массив адресуется указателем на базовый класс Base, смещение на самом деле будет вычисляться как "i * 48" байт.
Так должно было вычисляться смещение указателя:
Однако вычислено смещение указателя будет так:
Фактически, программа начинает работать с объектами, содержащими случайный набор данных.
Корректный вариант кода:
....
size_t n = 5;
Derived *ptr = new Derived[n]; // <=
....
for (size_t i = 0; i < n; ++i)
(ptr + i)->Foo();
....Ошибочно также приводить указатель на указатель на производный класс к указателю на указатель на базовый класс:
....
Derived arr[3];
Derived *pDerived = arr;
Class5 **ppDerived = &pDerived;
....
Base **ppBase = (Derived**)ppDerived; // <=
....Для правильного хранения массива объектов производного класса полиморфически необходимо размещать объекты следующим образом:
Корректный код при этом будет выглядеть следующим образом:
....
size_t n = 5;
Base **ppBase = new Base*[n]; // <=
for (size_t i = 0; i < n; ++i)
ppBase[i] = new Derived();
....Если мы хотим подчеркнуть, что будем работать только с одним объектом, то можно написать так:
....
Derived *derived = new Derived[n];
Base *base = &derived[i];
....Такой код считается анализатором безопасным, и он не выдаёт предупреждение.
Не является также ошибкой применение указателя, который адресуется на массив объектов производного класса, содержащий один элемент.
....
Derived arr[1];
Derived *new_arr = new Derived[1];
Derived *malloc_arr = static_cast<Base*>(malloc(sizeof(Derived)));
....
Base *base = arr;
base = new_arr;
base = malloc_arr;
....Примечание. В случае одинакового размера базового и производного классов допускается адресоваться на массив объектов производного класса указателем на базовый класс, однако так делать не рекомендуется.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил код, который, возможно, содержит опечатку. Высока вероятность, что подобный код был создан с использованием подхода Copy-Paste.
Данная диагностика выявляет два схожих по структуре блока текста, идущих один за другим и отличающихся именем одной переменной. Предупреждение V778 предназначено для выявления тех случаев, если второй блок был получен путем копирования первого, при этом во втором блоке были переименованы не все переменные.
Рассмотрим пример:
void Example(int a, int b)
{
....
if (a > 50)
doSomething(a);
else if (a > 40)
doSomething2(a);
else
doSomething3(a);
if (b > 50)
doSomething(b);
else if (a > 40) // <=
doSomething2(b);
else
doSomething3(b);
....
}Код писался с помощью Copy-Paste. Во втором блоке не уследили и забыли заменить все переменные 'a' на 'b'. На самом деле, код должен быть таким:
void Example(int a, int b)
{
....
if (a > 50)
doSomething(a);
else if (a > 40)
doSomething2(a);
else
doSomething3(a);
if (b > 50)
doSomething(b);
else if (b > 40)
doSomething2(b);
else
doSomething3(b);
....
}Теперь рассмотрим пример, взятый из реального проекта:
....
if(erendlinen>239) erendlinen=239;
if(srendlinen>erendlinen) srendlinen=erendlinen;
if(erendlinep>239) erendlinep=239;
if(srendlinep>erendlinen) srendlinep=erendlinep; // <=
....Заметить ошибку не так уж и просто по сравнению с предыдущим примером. Имена переменных похожи друг на друга, и поэтому выявление ошибки усложняется в разы. На самом деле во втором блоке вместо переменной 'erendlinen' должна стоять 'erendlinep'.
Имена переменных 'erendlinen' и 'erendlinep' выбраны явно неудачно. Такую ошибку почти невозможно заметить при Code Review. Да что уж там, даже когда анализатор указывает на строку с ошибкой и то сложно её заметить. Поэтому, встретив предупреждение V778, рекомендуем не спешить и внимательно изучить код.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V778. |
Анализатор обнаружил код, который никогда не будет выполнен. Возможно допущена ошибка в логике программы.
Данная диагностика находит блоки кода, до которых никогда не дойдёт управление.
Рассмотрим пример:
void Error()
{
....
exit(1);
}
FILE* OpenFile(const char *filename)
{
FILE *f = fopen(filename, "w");
if (f == nullptr)
{
Error();
printf("No such file: %s", filename);
}
return f;
}Функция 'printf(....)' никогда не напечатает сообщение об ошибке, так как функция 'Error()' не возвращает управление. Как правильно исправить код зависит от того, какую логику поведения задумывал программист изначально. Возможно, функция должна возвращать управление. Возможно, нарушен порядок выражений и корректный код должен быть таким:
FILE* OpenFile(const char *filename)
{
FILE *f = fopen(filename, "w");
if (f == nullptr)
{
printf("No such file: %s", filename);
Error();
}
return f;
}Рассмотрим ещё один пример:
void f(char *s, size_t n)
{
for (size_t i = 0; i < n; ++i)
{
if (s[i] == '\0')
break;
else
return;
s[i] = toupper(s[i]);
}
}Весь код, стоящий после 'if', не будет выполнен, так как обе ветви не возвращают управление. Скорее всего, нужно внести код в одну из ветвей или убрать noreturn выражение.
Например, можно исправить код следующим образом:
void f(char *s, size_t n)
{
for (size_t i = 0; i < n; ++i)
{
if (s[i] == '\0')
break;
s[i] = toupper(s[i]);
}
}Если реализация функции находится в другом файле, анализатору требуется подсказка, чтобы понять, что она всегда прекращает работу программы. В противном случае, он может не заметить ошибку. Для подсказки можно воспользоваться аннотациями при объявлении функции:
[[noreturn]] void my_abort(); // C++11
__declspec(noreturn) void my_abort(); // MSVC
__attribute__((noreturn)) void my_abort(); // GCCЕсть некоторые фрагменты кода, на которые анализатор не будет выдавать предупреждение, несмотря на формальное наличие ошибки. Пример:
int test()
{
throw 0;
return 0;
}Это связано с тем, что такой код часто пишут для подавления предупреждений компилятора или других анализторов.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V779. |
Анализатор обнаружил опасную работу со сложными типами. Если объект не является Passive Data Structure (PDS), то нельзя использовать низкоуровневые функции по работе с памятью: memset, memcpy и т.д. Это может нарушить логику работы класса и привести к утечке памяти, двойному очищению одного ресурса или Undefined Behavior.
Пример классов, над которыми нельзя совершать такие действия: std::vector, std::string и другие подобные контейнеры.
Иногда такая диагностика находит опечатки. Рассмотрим пример:
struct Buffer {
std::vector<char>* m_data;
void load(char *buf, size_t len) {
m_data->resize(len);
memcpy(&m_data[0], buf, len);
}
};Функция 'memcpy' копирует данные не в содержимое контейнера, а в объект, на который указывает 'm_data'. Такой код нужно переписать следующим образом:
memcpy(&(*m_data)[0], buf, len);или:
memcpy(m_data->data(), buf, len);Другой способ ошибиться - это использовать memset/memcpy для структуры, полями которой являются non-PDS объекты. Рассмотрим пример:
struct Buffer {
std::vector<char> m_data;
....
};
void F() {
Buffer a;
memset(&a, 0, sizeof(Buffer));
....
}Чтобы избежать таких ошибок можно рекомендовать использовать value initialization. Такой подход корректно работает и с POD-данными, и с объектами с нетривиальным конструктором.
Для копирования можно положиться на генерируемый компилятором конструктор копирования или написать свой.
Анализатор также ищет структуры, использование memset/memcpy над которыми может быть опасно, исходя из их логики или представления в памяти. К первому случаю относятся классы, в которых одновременно есть указатели, конструкторы и деструкторы. Если в классе содержится нетривиальная работа с указателями (например, управление памятью или ресурсом), то нельзя использовать для него memcpy/memset. Пример такого класса:
struct Buffer {
char *buf;
Buffer() : buf(new char[16]) {}
~Buffer() { delete[] buf; }
};
Buffer buf1, buf2;
memcpy(&buf1, &buf2, sizeof(Buffer));Ко второму случаю относятся классы, не являющиеся standard layout:
struct BufferImpl {
virtual bool read(char *, size_t) { return false; }
};
struct Buffer {
BufferImpl impl;
};
Buffer buf1, buf2;
memcpy(&buf1, &buf2, sizeof(Buffer));Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V780. |
Анализатор заметил в коде следующую ситуацию. В начале, значение переменной используется в качестве размера или индекса массива. А уже затем это значение сравнивается с 0 или с размером массива. Это может указывать на наличие логической ошибки в коде или опечатку в одном из сравнений.
Рассмотрим пример
int idx = GetPos(buf);
buf[idx] = 42;
if (idx < 0) return -1;Если значение 'idx' окажется меньше нуля, то выражение 'buf[idx] ' приведёт к ошибке. Анализатор выдаст предупреждение на этот код, указав 2 строки. Первая строка - это то место, где используется переменная. Вторая строка - это то место, где переменная сравнивается с другим значением.
Исправленный вариант кода:
int idx = GetPos(buf);
if (idx < 0) return -1;
buf[idx] = 42;Точно также анализатор выдаёт предупреждение, если переменная сравнивается с размером массива:
int buf[10];
buf[idx] = 42;
if (idx < countof(buf)) return -1;Правильный вариант кода:
int buf[10];
if (idx < countof(buf)) return -1;
buf[idx] = 42;Помимо индексов, анализатор смотрит на использование переменных в качестве аргументов к функциям, которые принимают неотрицательные значения (memset, malloc и т.д.). Рассмотрим пример:
bool Foo(char *A, int size_A, char *B, int size_B)
{
if (size_A <= 0)
return false;
memset(A, 0, size_A);
....
if (size_A <= 0) // Error
return false;
memset(B, 0, size_B);
....
}В коде допущена опечатка, которая будет выявлена косвенным образом. В коде всё хорошо с массивом 'A'. Однако, размер массива 'B' проверяется неправильно. В результате возникает ситуация, что 'size_A' проверяется уже после использования.
Корректный код:
bool Foo(char *A, int size_A, char *B, int size_B)
{
if (size_A <= 0)
return false;
memset(A, 0, size_A);
....
if (size_B <= 0) // FIX
return false;
memset(B, 0, size_B);
....
}Так же анализатор может увидеть проблему, если использование переменной в качестве индекса массива и её проверка находятся в одном выражении:
void f(int *arr, const int size)
{
for (int i = 0; arr[i] < 10 && i < size; ++i)
arr[i] = 0;
}В этом случае на последней итерации цикла мы будем проверять значение, взятое за границей массива, а это является неопределённым поведением.
Исправленный вариант:
void f(int *arr, const int size)
{
for (int i = 0; i < size && arr[i] < 10; ++i)
arr[i] = 0;
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V781. |
Анализатор обнаружил бессмысленный код для вычисления расстояния между элементами разных массивов.
Рассмотрим пример:
ptrdiff_t offset()
{
char path[9] = "test.txt";
char resources[9] = "resr.txt";
return path - resources;
}Вычитание адресов двух массивов, выделенных на стеке, не имеет никакого практического смысла и скорее всего является ошибкой.
Для рассмотрения всех подозрительных операций с указателями на массивы, разделим типы указателей на две условные группы:
new или malloc, над которыми не были произведены операции смещения указателя.new или malloc, над которыми были совершенны операции смещения указателя. Либо это указатель, о котором у анализатора нет информации.Тогда получим таблицу операций над указателями на массивы, вычисление которых не имеет практического смысла (таблица 1).
Таблица 1 — Бессмысленные операции над указателями.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил фрагмент кода, который может привести к использованию невалидного итератора.
Рассмотрим несколько примеров, для которых анализатор выдает данное диагностическое сообщение:
if (iter != vec.end() || *iter == 42) { ... }
if (iter == vec.end() && *iter == 42) { ... }Во всех условиях допущена логическая ошибка, которая приведет к разыменованию невалидного итератора. Ошибка может быть допущена при рефакторинге кода или из-за случайно опечатки.
Корректные варианты:
if (iter != vec.end() && *iter == 42) { ... }
if (iter == vec.end() || *iter == 42) { ... }Конечно, это очень простые ситуации. На практике проверка итератора и его использование может находиться в разных местах. Если анализатор выдал предупреждение V783, изучите код расположенный выше и попробуйте понять, почему итератор может быть невалидным.
Пример кода, где проверка и использование итератора находятся в разных строках:
if (iter == vec.end()) {
std::cout << "Error: " << *iter << std::endl;
throw std::runtime_error("foo");
}Анализатор предупредит об опасности в выражении '*iter'. Здесь или некорректно написано условие, или вместо 'iter' должна использоваться другая переменная.
Анализатор также находит ошибки, когда использование итератора находится до его проверки.
Пример:
std::cout << "Element is " << *iter << std::endl;
if (iter == vec.end()) {
throw std::runtime_error("");
}Здесь проверка не имеет смысла, так как если итератор невалидный, то выше по коду произойдёт его разыменование. Скорее всего нужно добавить дополнительную проверку итератора:
if (iter != vec.end()) {
std::cout << "Element is " << *iter << std::endl;
}
if (iter == vec.end()) {
throw std::runtime_error("");
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V783. |
Анализатор обнаружил подозрительную операцию при работе с битовыми масками. В качестве битовой маски используется переменная меньшей разрядности, чем другой операнд. Это приведёт к гарантированной потере старших бит.
Рассмотрим несколько примеров, для которых анализатор выдает данное диагностическое сообщение:
unsigned long long x;
unsigned y;
....
x &= ~y;Посмотрим подробнее, что происходит с битами после каждой операции на примере выражения:
x = 0xffff'ffff'ffff'ffff;
y = 0xff;
x &= ~y;
Как правило это не тот результат, который планировал получить программист:
0xffff’ffff’ffff’ff00 – ожидалось
0x0000’0000’ffff’ff00 – получилосьКод можно поправить, явно приведя переменную y к типу, которая имеет переменная x:
x &= ~(unsigned long long)y;Cначала произойдёт преобразование типов, а потом отрицание. После операции все старшие биты будут равны единице. Рассмотрим, как изменится пример выше при данном порядке вычислений:
Анализатор также предупреждает о таком коде:
unsigned long long x;
unsigned y;
....
x &= y;Несмотря на то, что здесь не используются дополнительные операции, этот код всё равно выглядит подозрительно. Следует явно преобразовать типы, чтобы поведение когда было более очевидным, как для анализатора, так и для ваших коллег.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V784. |
Анализатор обнаружил константное выражение в условии 'switch'. Чаще всего это сигнализирует о логической ошибке.
Рассмотрим синтетический пример:
int i = 1;
switch (i)
{
....
}В качестве условия 'switch' стоит переменная, значение которой может быть посчитано во время компиляции. Такая ситуация могла возникнуть в результате рефакторинга: раньше был код, который менял значение переменной, а потом его поменяли и оказалось, что переменной больше не присваивается никакое значение.
Анализатор не выдаёт предупреждение, когда переменная константная или в условии используется макросы. Такие конструкции часто используют намеренно для включения/выключения функционала во время компиляции.
Например, могут выполняться различные действия, в зависимости от того для какой операционной системы скомпилирован код:
switch (MY_PROJ_OS)
{
case MY_PROJ_WINDOWS:
....
case MY_PROJ_LINUX:
....
case MY_PROJ_MACOS:
....
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V785. |
Анализатор обнаружил, что переменной пытаются присвоить значение, которое не входит в её диапазон возможных значений.
Рассмотрим несколько примеров, для которых анализатор выдает данное диагностическое сообщение:
bool b;
....
b = 100;Нет никакого смысла присваивать значение 100 переменной типа bool. Возможно, мы имеем дело с опечаткой и вместо b должна использоваться другая переменная.
Рассмотрим другой пример:
struct S
{
int flag : 1;
}
....
S s;
s.flag = 1;Битовое поле flag может принимать значения из диапазона [-1, 0], а не [0, 1], как может показаться на первый взгляд. Причина в том, что тип переменной знаковый. Если вам нужно битовое поле с диапазоном в [0, 1], используйте тип unsigned:
struct S
{
unsigned flag : 1;
}
....
S s;
s.flag = 1;Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V786. |
Анализатор обнаружил, что счётчик в цикле используется в условии выхода из цикла в качестве индекса. Такой код выглядит подозрительно.
Рассмотрим пример:
for (int i = 0; i < n; ++i)
for (int j = 0; j < arr[j]; ++j)
....Скорее всего, вместо переменной 'j' нужно использовать 'i':
for (int i = 0; i < n; ++i)
for (int j = 0; j < arr[i]; ++j)
....Анализатор обнаружил подозрительный захват переменной в лямбда функции.
Рассмотрим несколько случаев срабатывания анализатора.
Пример 1:
int x = 0;
auto f = [x] { };
....
x = 42;
f();
....Переменную, значение которой может быть точно вычислено в compile-time, захватывают в лямбда функции по значению. Внутри этой функции значение переменной будет таким, которым оно было в момент захвата, а не то, которая имеет эта переменная в момент вызова лямбда функции. Возможно, необходимо захватить переменную по ссылке.
int x = 0;
auto f = [&x] { };
....
x = 42;
f();
....Также возможно, что в ходе рефакторинга был удалён код, который присваивал переменной какое-либо значение.
int x = 0;
if (condition) x = 42;
else x = 43;
auto f = [x] { };Если необходимо захватить некую константу, следует явно указать в типе переменной const или constexpr.
constexpr int x = 0;
auto f = [x] { };Пример 2:
int x;
auto f = [x] { };Неинициализированная переменная захватывается по значению. Её использование приведёт к неопределенному поведению. Если предполагалось, что вызов функции должен проинициализировать переменную, её необходимо захватить по ссылке.
int x;
auto f = [&x] { x = 42; };Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил инвалидацию итератора в range-based for цикле.
Пример:
std::vector<int> numbers;
for (int num : numbers)
{
numbers.push_back(num * 2);
}Данный код аналогичен следующему:
for (auto __begin = begin(numbers), __end = end(numbers);
__begin != __end; ++__begin) {
int num = *__begin;
numbers.push_back(num * 2);
}Теперь видно, что при операции 'push_back' может произойти инвалидация итераторов '__begin' и '__end', если произойдёт реаллокация памяти внутри вектора.
Если необходимо модифицировать контейнер и одновременно читать из него значения, лучше воспользоваться функциями, которые возвращают новый итератор после модификации, или индексами в случае класса 'std::vector'.
Дополнительные ссылки:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V789. |
Анализатор обнаружил, что оператор присваивания принимает объект по неконстантной ссылке и именно его возвращает.
Пример:
class C {
C& operator = (C& other) {
....
return other;
}
};Если оператор присваивания будет реализован таким способом, то можно получить неожиданные и неприятные эффекты. Допустим, программист напишет код:
(A = B)++;Оставим в стороне тот факт, что такой код вообще лучше не писать. Предположим, что этот код нужен. Программист, возможно, ожидает, что код будет работать следующим образом:
A = B;
A++;Однако из-за неправильного оператора присваивания он работает так:
A = B;
B++;Чтобы предотвратить появление таких ошибок, лучше передавать аргумент по константной ссылке. Тогда код с реализаций оператора просто бы не скомпилировался.
Корректный код:
class C {
C& operator = (const C& other) {
....
return *this;
}
};Анализатор выявил цикл, который может содержать ошибку или быть неоптимальным. Используется типичный паттерн кода, когда для всех пар элементов массива выполняется некая операция. При этом, как правило, нет смысла выполнять операцию для пары, состоящей из одного и того-же элемента при 'i == j'.
Пример:
for (int i = 0; i < size; i++)
for (int j = i; j < size; j++)
...Есть большая вероятность, что правильнее или эффективнее использовать следующий код для обхода массивов:
for (int i = 0; i < size; i++)
for (int j = i + 1; j < size; j++)
...Далее приведён пример кода из реального приложения, в котором реализовали собственный алгоритм сортировки устройств по приоритету и сделали это не оптимально:
/* Simple bubble sort */
for (i = 0; i < n_devices; ++i) {
for (uint32_t j = i; j < n_devices; ++j) {
if (devices[i]->prio > devices[j]->prio) {
struct device_t *tmp;
tmp = devices[i];
devices[i] = devices[j];
devices[j] = tmp;
}
}
}Исправленный вариант:
/* Simple bubble sort */
for (i = 0; i < n_devices - 1; ++i) {
for (uint32_t j = i + 1; j < n_devices; ++j) {
if (devices[i]->prio > devices[j]->prio) {
struct device_t *tmp;
tmp = devices[i];
devices[i] = devices[j];
devices[j] = tmp;
}
}
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V791. |
Анализатор обнаружил возможную опечатку в логическом выражении. Вместо логического оператора (&& или ||) написали битовый оператор (& или |). Это означает, что правая часть будет выполнена независимо от результата левой части.
Пример:
if (foo() | bar()) {}Если в качестве операндов стоят довольно ресурсоемкие операции, то использование битовых операций не оптимально. Кроме того, такой код может привести к ошибке из-за разных типов выражения и разных приоритетов операций. Также возможна ситуация, когда правая часть не должна быть выполнена, если левая завершилась неудачно. В таком случае может произойти обращение к неинициализированным ресурсам. Также битовые операции не гарантируют порядок вычисления операндов.
Корректный код:
if (foo() || bar()) {}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V792. |
Анализатор обнаружил возможную опечатку в логическом выражении. В качестве условного выражения используется арифметическая операция.
Пример:
int a;
int b;
if (a + b) {}Несмотря на то, что поведение такого кода может быть понятно его автору, лучше использовать явные проверки. Такой код аналогичен 'a + b != 0'. Человек, который будет читать и сопровождать этот код, постоянно будет задавать себе вопрос: "А не забыли ли сравнить с чем-то полученную сумму?". Возможно, результат операции хотели сравнить с некой константой, например, 42, и корректный код должен был быть таким:
if (a + b == 42) {}Пример из кода реального проекта:
// verify that time is well formed
if ( ( hh / 24 ) || ( mm / 60 ) ) {
return false;
}Код работает, как и задумывалось. Но он бы выглядел намного понятнее, если бы использовались операции сравнения.
// verify that time is well formed
if ( hh >= 24 || mm >= 60 ) {
return false;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V793. |
Анализатор обнаружил опасный оператор копирования/перемещения. В нём нет проверки на присвоение объекта самому себе. При этом в таком операторе есть операции, которые могут привести к утечкам памяти, использованию указателей после их освобождения и другим проблемам, если этому оператору передать ссылку на '*this' в качестве аргумента.
Пример:
class C {
char *p;
size_t len;
public:
C& operator = (const C& other) {
delete p;
len = other.len;
p = new char[len];
std::copy(other.p, other.p + len, p);
return *this;
}
};Ошибка проявится, если 'this == &other', а соответственно 'p == other.p'. В таком случае, при вызове 'std::copy' произойдёт копирование неинициализированного массива самого в себя.
Корректный код:
C& operator = (const C& other) {
if (this == std::addressof(other))
return *this;
delete p;
len = other.len;
p = new char[len];
std::copy(other.p, other.p + len, p);
return *this;
}Если же такой ситуации не может быть, то есть у этого оператора есть неявный контракт, то лучше формализовать его в виде 'assert':
C& operator = (const C& other) {
MyAssert(this != std::addressof(other));
....
}Примечание: в проверке на равенство самому себе лучше использовать функцию 'std::addressof' вместо оператора '&'. Такая проверка будет работать корректно, даже если класс содержит перегруженный оператор '&'.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V794. |
Анализатор обнаружил, что в проекте используются 32-битные типы данных для хранения времени. Данная проблема затрагивает программы, использующие типы данных, представляющие собой количество секунд, прошедшее с 1 января 1970 года. Таким образом не удастся корректно работать с датами после 19 января 2038. Рекомендуется использовать 64-битные типы данных для хранения времени.
Стандарт языка С/C++ не определяет размер типа 'time_t', поэтому в зависимости от платформы и настроек проекта он может быть определён по-разному:
typedef /* unspecified */ time_t;В старых версиях Visual C++ тип 'time_t' являлся 32-разрядным типом в 32-разрядных версиях Windows. Начиная с Visual C++ 2005 тип 'time_t' по умолчанию представляет собой 64-разрядное целое число. В современных версиях Visual C++ можно принудительно установить размер типа 'time_t' равным 32 битам с помощью директивы '_USE_32BIT_TIME_T'. По возможности стоит избавиться от этой директивы и использовать 64-битный тип time_t.
В Linux тип 'time_t' является 64-разрядным типом только в 64-разрядных версиях ОС. На 32-битных Linux-системах, к сожалению, пока не существует стандартного способа сделать тип 'time_t' 64-разрядным. Возможно стоит отказаться от использования типа 'time_t' в пользу сторонних решений.
Дополнительные ресурсы:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V795. |
В операторе 'switch' анализатор обнаружил ветвь, в которой отсутствует оператор 'break'. В таком случае поток управления перейдёт к следующему 'case'. Возможно, допущена опечатка, и необходимо добавить 'break'.
Пример:
for (char c : srcString)
{
switch (c)
{
case 't':
*s++ = '\t';
break;
case 'n':
*s++ = '\n';
break;
case 'f':
*s++ = '\f'; // <=
case '0':
*s++ = '\0';
}
}Если это ошибка, то следует добавить оператор 'break'. Если ошибки нет, то следует оставить подсказку анализатору и коллегам, которые будут поддерживать код в будущем.
Существует несколько вариантов указать, что данное поведение намеренное. Можно добавить комментарий:
case A:
foo();
// fall through
case B:
bar();Также поддерживаются атрибуты 'fallthrough':
__attribute__((fallthrough));
[[fallthrough]];
[[gnu::fallthrough]];
[[clang::fallthrough]];В диагностике также реализовано несколько эвристических правил, чтобы сократить количество ложных срабатываний. Например, в случае разворачивания цикла:
switch(num) {
case 3:
sum += arr[i + 2];
case 2:
sum += arr[i + 1];
case 1:
sum += arr[i];
}В этом случае диагностическое предупреждение не будет выдано.
Если в 'switch' уже есть комментарии или атрибуты 'fallthrough', то такие исключения не будут срабатывать, т.к. такой код выглядит ещё более подозрительным.
Диагностическое предупреждение не выдаётся, если вместо 'break' уже используются другие операторы, прерывающие работу 'switch' (это 'return', 'throw' и т.д.).
Т.к. анализатор не может однозначно определить, является ли найденное место ошибкой, возможны ложные срабатывания. Для их устранения рекомендуется пользоваться 'fallthrough' комментариями или атрибутами. Оставленные пояснения в первую очередь будут полезны для других разработчиков, которые будут заниматься поддержкой кода. Также такие пометки смогут считывать компиляторы и статические анализаторы.
Если срабатываний слишком много, то можно отключить эту диагностику или воспользоваться механизмом подавления ложных срабатываний.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V796. |
Анализатор обнаружил ошибку при поиске подстрок или символов в строке.
Пример:
std::string s = foo();
if (s.find("42")) { .... }Функция 'std::string::find' возвращает число типа 'std::string::size_type'. В случае, когда ничего не найдено, возвращается 'std::string::npos', равный '(size_t)-1'. Соответственно, для того чтобы проверить наличие подстроки, необходимо написать следующий код:
if (s.find("42") != std::string::npos) { .... }Несмотря на то, что код 'if (s.find(...))' компилируется и работает, логика работы такого кода крайне подозрительна. Он проверяет, что искомая подстрока не встречается или она не является началом строки 's'. Если действительно нужно такое поведение, то лучше написать явно:
const auto pos = s.find("42");
if (pos == std::string::npos || pos != 0) { .... }Также можно воспользоваться функцией 'boost::starts_with' или её аналогом.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V797. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что размер динамического массива может оказаться меньше количества элементов в его инициализаторе. В этом случае при создании массива, в зависимости от того, какая версия оператора 'new' используется, будет либо выброшено исключение 'std::bad_array_new_length', либо возвращен нулевой указатель.
Рассмотрим пример:
int n = 2;
...
int* arr = new int[n] { 1, 2, 3 };Значение переменной 'n' меньше количества элементов в инициализаторе. Корректный код должен иметь вид:
int n = 3;
...
int* arr = new int[n] { 1, 2, 3 };Диагностическое правило классифицируется как:
|
Анализатор обнаружил, что переменная не используется после того, как для нее была динамически выделена память. Стоит проверить код на наличие ошибки, либо удалить неиспользуемую переменную.
Рассмотрим пример:
void Func()
{
int *A = new int[X];
int *B = new int[Y];
int *C = new int[Z];
Foo(A, X);
Foo(B, Y);
Foo(B, Z); // <=
delete [] A;
delete [] B;
delete [] C;
}Здесь была допущена опечатка, и вместо массива 'C' третий вызов функции 'Foo' использует массив 'B'. Анализатор обнаруживает здесь аномалию, что выделяется и освобождается память, но при этом она никак не используется. Исправленный вариант кода выглядит следующим образом:
void Func()
{
int *A = new int[X];
int *B = new int[Y];
int *C = new int[Z];
Foo(A, X);
Foo(B, Y);
Foo(C, Z); // <=
delete [] A;
delete [] B;
delete [] C;
}Взгляните на примеры ошибок, обнаруженных с помощью диагностики V799. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что перед выходом из функции в локальную переменную присваивается значение, которое потом нигде не используется.
Возможно, эта переменная должна участвовать в последующих операциях или возращена как результат функции, но из-за опечатки используется другая переменная, или программист забыл написать соответствующий код. Рассмотрим примеры.
Пример 1.
bool IsFitRect(TPict& pict)
{
TRect pictRect;
...
pictRect = pict.GetRect();
return otherRect.dx >= 16 && otherRect.dy >= 16;
}В этом примере в операторе 'return' вместо размеров 'pictRect' по ошибке используются размеры 'otherRect', в то время как переменная 'pictRect' больше нигде не участвует в вычислениях. Правильный код выглядит следующим образом:
bool IsFitRect(TPict& pict)
{
TRect pictRect;
...
pictRect = pict.GetRect();
return pictRect.dx >= 16 && pictRect.dy >= 16;
}Пример 2.
bool CreateMiniDump()
{
BOOL bStatus = FALSE;
CString errorMsg;
...
if (hDbgHelp == NULL)
{
errorMsg = _T("dbghelp.dll couldn't be loaded");
goto cleanup;
}
...
if (hFile == INVALID_HANDLE_VALUE)
{
errorMsg = _T("Couldn't create minidump file");
return FALSE;
}
...
cleanup:
if (!bStatus)
AddToReport(errorMsg);
return bStatus;
}В этом примере во всех блоках 'if' кроме одного после создания сообщения об ошибке выполняется переход в конец функции, где эта ошибка добавляется в отчёт. А при обработке одного из условий выполняется выход из функции сразу без добавления сообщения в отчёт, которое в итоге теряется. Корректный код выглядит следующим образом:
bool CreateMiniDump()
{
BOOL bStatus = FALSE;
CString errorMsg;
...
if (hDbgHelp == NULL)
{
errorMsg = _T("dbghelp.dll couldn't be loaded");
goto cleanup;
}
...
if (hFile == INVALID_HANDLE_VALUE)
{
errorMsg = _T("Couldn't create minidump file");
goto cleanup;
}
...
cleanup:
if (!bStatus)
AddToReport(errorMsg);
return bStatus;
}Иногда при работе с криптографическими функциями программисты очищают в конце переменные, записывая в них нулевое значение. Это неправильный подход, так компилятор скорее всего выбросит такой код при оптимизации, если переменная больше не используется. Например:
void ldns_sha256_update(...)
{
size_t freespace, usedspace;
...
/* Clean up: */
usedspace = freespace = 0;
}Для очистки памяти следует использовать специальные функции, которые не будут удалены компилятором во время оптимизации:
void ldns_sha256_update(...)
{
size_t freespace, usedspace;
...
/* Clean up: */
RtlSecureZeroMemory(&usedspace, sizeof(usedspace));
RtlSecureZeroMemory(&freespace, sizeof(freespace));
}Подробнее об этой ошибке можно прочитать в описании диагностики V597.
В некоторых случаях при борьбе с предупреждениями компилятора о неиспользуемых переменных, программисты присваивают им какие-то значения или присваивают значение переменной самой себе. Это не самый лучший способ, так как при отсутствии комментариев может вводить в заблуждение тех, кто будет потом сопровождать этот код:
static stbi_uc *stbi__tga_load(...)
{
// read in the TGA header stuff
int tga_palette_start = stbi__get16le(s);
int tga_palette_len = stbi__get16le(s);
int tga_palette_bits = stbi__get8(s);
...
// the things I do to get rid of an error message,
// and yet keep Microsoft's C compilers happy... [8^(
tga_palette_start = tga_palette_len = tga_palette_bits =
tga_x_origin = tga_y_origin = 0;
// OK, done
return tga_data;
}Для таких случаев есть более красивые решения, например, можно использовать функцию:
template<class T> void UNREFERENCED_VAR( const T& ) { }
static stbi_uc *stbi__tga_load(...)
{
// read in the TGA header stuff
int tga_palette_start = stbi__get16le(s);
...
UNREFERENCED_VAR(tga_palette_start);
...
// OK, done
return tga_data;
}Или использовать специальные макросы, объявленные в системных заголовочных файлах. Например, в Visual C++ таким макросом является UNREFERENCED_PARAMETER. В этом случае анализатор также не будет выдавать предупреждения.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1001. |
Анализатор обнаружил потенциальную ошибку, связанную с вызовом конструктора копирования или оператора присваивания, которые сгенерированы автоматически.
Перечислим условия, при выполнении которых такой вызов автоматически сгенерированных компилятором функций считается опасным:
Высока вероятность, что указатель ссылается на буфер памяти, которая выделяется в конструкторе, а затем освобождается в деструкторе. Подобные объекты нельзя копировать с помощью таких функций как 'memcpy' или с помощью автосгенерированных функций (конструктор копирования, оператор присваивания).
Рассмотрим пример:
class SomeClass
{
int m_x, m_y;
int *m_storagePtr;
public:
SomeClass(int x, int y) : m_x(x), m_y(y)
{
m_storagePtr = new int[100];
....
}
....
~SomeClass()
{
delete[] m_storagePtr;
}
};
void Func()
{
SomeClass A(0, 0);
SomeClass B(A); // <=
....
}В данном примере при копировании объекта 'A' в объект 'B', происходит копирование указателя 'm_storagePtr' из объекта 'A' в объект 'B'. Вероятнее всего, это не является ожидаемым поведением, а программист задумывал, что при копировании объектов произойдет копирование данных, а не просто указателей. Корректный код должен выглядеть следующим образом:
class SomeClass
{
int m_x, m_y;
int *m_storagePtr;
public:
SomeClass(int x, int y) : m_x(x), m_y(y)
{
m_storagePtr = new int[100];
....
}
SomeClass(const SomeClass &other) : m_x(other.m_x), m_y(other.m_y)
{
m_storagePtr = new int[100];
memcpy(m_storagePtr, other.m_storagePtr, 100 * sizeof(int));
}
....
~SomeClass()
{
delete[] m_storagePtr;
}
};Аналогичным образом диагностика находит потенциальные ошибки, связанные с использованием оператора присваивания, определенного по умолчанию.
Конечно, анализатор может ошибиться и выдать предупреждение на вполне безопасный класс, однако лучше подстраховаться и изучить все предупреждения V1002. Если окажется, что ошибки нет, то лучше всего явно указать, что программист предполагал использование автосгенерированных функций и это безопасно. Для этого следует использовать ключевое слово 'default':
T(const T &x) = default;
SomeClass &operator=(const T &x) = default;В этом случае, человеку, который будет сопровождать код будет легче понять, что ошибки нет. А анализатор PVS-Studio не будет выдавать ложные предупреждения.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1002. |
Анализатор обнаружил потенциально возможную ошибку в записи макроса.
Пример:
#define sqr(x) x * xЭтот макрос стоит переписать таким образом:
#define sqr(x) ((x) * (x))В изначальной реализации макроса есть две проблемы, которые могут привезти к ошибке. Во-первых, сам макрос стоит обернуть в скобки. Если этого не сделать, то это приведёт к ошибке при написании такого коде:
double d = 1.0 / sqr(M_PI); // 1.0 / M_PI * M_PI == 1.0По той же причине стоит поставить в скобки аргументы:
sqr(M_PI + 0.42); // M_PI + 0.42 * M_PI + 0.42Из-за того, что препроцессор работает на уровне лексем, не всегда получается получить корректное синтаксическое дерево из текста макроса. Рассмотрим пример:
#define FOO(A,B) A * BВ зависимости от контекста, это может быть, как умножением A на B, так и объявлением переменной B, которая будет являться указателем на A. Так как в момент объявления макроса нет никакой информации о его использовании, анализатор может выдать ложное срабатывание на корректны код. В таком случае, для подавления ложного срабатывания, вы можете воспользоваться одним из способов, описанных в документации.
Примечание. Родственной по смыслу диагностикой является V733. Диагностика V733 работает более точно и даёт меньше ложных срабатываний, так как анализирует уже раскрытый макрос, а не его объявлении. С другой стороны, возможности V733 более ограничены и диагностика не предупредит о многих ошибках.
Другой тип искомых ошибок может выглядеть следующим образом:
#if A
doA();
#else doB();
#endifВо время редактирования код был случайно удалён перенос строки и функция 'doB()' перестала вызываться. При этом код остался компилируемым.
Исправленный вариант кода:
#if A
doA();
#else
doB();
#endifВзгляните на примеры ошибок, обнаруженных с помощью диагностики V1003. |
Анализатор обнаружил потенциальное разыменование нулевого указателя. Сначала этот указатель проверялся на ноль, а потом использовался без проверки.
Пример:
if (p != nullptr)
{
*p = 42;
}
....
*p += 33;В случае, если указатель 'p' был равен нулю, в выражении '*p += 33' произойдёт разыменование нулевого указателя. Поэтому нужно добавить проверку:
if (p != nullptr)
{
*p = 42;
}
....
if (p != nullptr)
{
*p += 33;
}Либо в этом коде 'p' всегда ненулевой и тогда проверку стоит удалить:
*p = 42;
....
*p += 33;Анализатор может выдать ложное срабатывание в следующем случае:
if (p == nullptr)
{
MyExit();
}
....
*p += 42;Это происходит, потому что анализатор не может понять, возвращает ли функция 'MyExit' управление или нет. Чтобы подсказать ему эту информацию, следует проаннотировать функцию одним из следующих способов:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки разыменования нулевого указателя/нулевой ссылки [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1004. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что ресурс может создаваться и освобождаться несовместимыми между собой способами.
Например, анализатор предупредит, если файл открыт с помощью функции 'fopen_s', а закрыт с помощью функции 'CloseHandle'.
Рассмотрим пример некорректного кода.
FILE* file = nullptr;
errno_t err = fopen_s(&file, "file.txt", "r");
...
CloseHandle(file);Невозможно предсказать, к каким последствиям приведёт выполнение такого кода. Возможно, функция 'CloseHandle' вернёт статус ошибки и в результате просто произойдёт утечка ресурса (файл не будет закрыт). Возможны и более серьезные последствия. При некорректном вызове некоторых функций возникает неопределённое поведение, что влечёт непредсказуемые последствия, вплоть до аварийного завершения работы приложения.
Исправленный вариант:
FILE* file = nullptr;
errno_t err = fopen_s(&file, "file.txt", "r");
...
fclose(file);Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1005. |
Анализатор обнаружил ошибку, связанную с тем, что один и тот же указатель инициализирует сразу несколько объектов типа 'shared_ptr'. Это может привести к неопределённому поведению программы в момент, когда второй объект, имеющий тип 'shared_ptr', попытается освободить память, которая уже была освобождена благодаря первому объекту.
Рассмотрим пример некорректного кода.
void func()
{
S *rawPtr = new S(10, 20);
std::shared_ptr<S> shared1(rawPtr);
std::shared_ptr<S> shared2(rawPtr);
....
}При выходе из функции, объект 'shared1' освободит указатель 'rawPtr', после чего объект 'shared2' также попытается освободить его еще раз, что приведет к некорректной работе программы.
Корректный код:
void func()
{
std::shared_ptr<S> shared1(new S(10, 20));
std::shared_ptr<S> shared2(new S(10, 20));
....
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил обращение к значению объекта класса optional, который ранее не был проинициализирован, т.е. не хранит никакого значения. Формально это приводит к неопределенному поведению, а также служит источником других ошибок.
Рассмотрим пример некорректного кода:
std::optional<Value> opt;
if (cond)
{
opt->max = 10;
opt->min = 20;
}
if (opt)
{
....
}В данном примере opt так и не был проинициализирован, что в свою очередь приводит к тому, что код под условием if (opt) никогда не выполняется.
Исправленный вариант:
std::optional<Value> opt;
if (cond)
{
opt = Value(10, 20);
}
if (opt)
{
....
}Также, анализатор умеет обнаруживать обращение к значению потенциально неинициализированного объекта типа optional. Например:
boost::optional<int> opt = boost::none;
opt = interpret(tr);
if (cond)
opt = {};
process(*opt);Исправленный вариант:
boost::optional<int> opt = boost::none;
opt = interpret(tr);
if (!cond)
process(*opt);Примечание. Диагностическое правило имеет дополнительные настройки. Для включения какой-либо настройки необходимо добавить соответствующий комментарий в файл с исходным кодом или в файл конфигурации диагностических правил (.pvsconfig).
Расширенное сообщение. Данная настройка позволяет выдавать расширенное сообщение: в нём будет содержаться список функций, при помощи которых следует проверить объект опционального типа перед получением значения:
//+V1007 PRINT_CHECKERSЧувствительный режим. При включении данной настройки анализатор будет выдавать предупреждение V1007 в любом месте, где используется непроверенный объект опционального типа:
//+V1007 PEDANTIC_MODEВыявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1007. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что в операторе 'for' используются странные начальное и конечное значения счетчика. Это может приводить к нарушению логики работы программы.
Рассмотрим пример подозрительного кода:
int c = 0;
if (some_condition)
{
....
c = 1;
}
for (int i = 0; i < c; ++i) {
....
}В данном случае цикл выполнится 0 или 1 раз. Следовательно, цикл можно заменить на оператор 'if'.
int c = 0;
if (some_condition)
{
....
c = 1;
}
if (c != 0)
{
....
}Возможно, что в коде допущена ошибка при вычислении значения переменной, с которой сравнивается счётчик. Например, возможно требовалось написать такой код:
int c = 0;
if (some_condition)
{
....
c = 1 + n;
}
for (int i = 0; i < c; ++i)
{
....
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1008. |
Анализатор обнаружил потенциально возможную ошибку, связанную с тем, что при объявлении массива указано значение только для одного элемента. Таким образом, остальные элементы будут инициализированы неявно нулём или конструктором по умолчанию.
Рассмотрим пример подозрительного кода:
int arr[3] = {1};Возможно, программист ожидал, что 'arr' будет состоять из одних единиц, но это не так. Массив будет состоять из значений 1, 0, 0.
Корректный код:
int arr[3] = {1, 1, 1};Подобная путаница может произойти из-за схожести с конструкцией "arr = {0}", которая инициализирует весь массив нулями.
Если в вашем проекте активно используются подобные конструкции, вы можете отключить эту диагностику.
Также не рекомендуется пренебрегать наглядностью кода.
Например, код для кодирования значений цвета записан следующим образом:
int White[3] = { 0xff, 0xff, 0xff };
int Black[3] = { 0x00 };
int Green[3] = { 0x00, 0xff };Благодаря неявной инициализации, все цвета заданы правильно, но лучше переписать код более наглядно:
int White[3] = { 0xff, 0xff, 0xff };
int Black[3] = { 0x00, 0x00, 0x00 };
int Green[3] = { 0x00, 0xff, 0x00 };Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1009. |
Анализатор обнаружил использование данных, полученных извне, без предварительной проверки. Такой сценарий излишнего доверия может привести к различным негативным последствиям, в том числе - стать причиной уязвимостей.
На данный момент диагностическое правило V1010 выявляет ошибки по нескольким паттернам:
Примечание. Начиная с версии 7.32, пользователь может самостоятельно разметить необходимые функции как источники и приёмники недостоверных данных. Примеры аннотаций можно увидеть здесь.
Рассмотрим все паттерны более подробно.
Пример подозрительного кода при использовании недостоверных данных в аргументе функции.
char buf[1024];
char username [256];
....
if (scanf("%255s", username) == 1)
{
if (snprintf(buf, sizeof(buf) - 1, commandFormat, username) > 0)
{
int exitCode = system(buf); // <=
....
}
....
}Этот код является уязвимым, т.к. пользовательский ввод передаётся командному интерпретатору без проверки полученных данных. Например, введя "&cmd", на Windows можно получить доступ к командному интерпретатору.
Правильный код должен осуществлять дополнительную проверку считанных данных:
if (IsValid(username))
{
if (snprintf(buf, sizeof(buf) - 1, commandFormat, username) > 0)
{
int exitCode = system(buf);
....
}
....
}
else
{
printf("Invalid username: %s", username);
....
}Пример подозрительного кода, связанного с порчей указателя.
size_t offset = 0;
int *pArr = arr;
....
if (scanf("%zu", &offset) == 1)
{
pArr += offset; // <=
....
DoSomething(pArr);
}В данном случае портится значение указателя 'pArr', т.к. в результате прибавления непроверенного значения 'offset' указатель может начать ссылаться за пределы массива. В результате можно испортить какие-то данные (на которые будет ссылаться 'pArr') с непредсказуемыми последствиями.
Правильный код проверяет допустимое смещение:
if (offset <= allowableOffset)
{
pArr += offset;
....
DoSomething(pArr);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки непроверенного использования чувствительных данных (ввода пользователя, файлов, сети и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1010. |
Анализатор обнаружил использование функции 'std::async', поведение которой может отличаться от того, которое было задумано программистом. 'std::async' принимает в качестве аргументов функцию, аргументы функции и, опционально, флаг, который влияет на политику вызова 'std::async'. Возвращаемым значением 'std::async' является 'std::future', значение которого будет выставлено по завершению функции.
Поведение 'std::async', зависит от переданных флагов следующим образом:
1) 'std::launch::async' - будет немедленно создан объект класса 'thread', с функцией и её аргументами в качестве аргументов нового потока. Т.е. 'std::async' инкапсулирует создание потока, получение 'std::future' и предоставляет однострочную запись для выполнения такого кода.
2) 'std::launch::deferred' - поведение функции поменяется, т.к. никакого асинхронного вызова не произойдёт. Вместо исполнения функции в новом потоке, она, вместе с аргументами, будет сохранена в 'std::future', чтобы быть вызванными позже. Это позже наступит тогда, когда кто-либо вызовет метод 'get' или 'wait' на 'future', которое вернул 'std::async'. При этот вызываемый объект выполнится в потоке, который вызывал 'get/wait'! Это поведение есть ни что иное, как отложенный вызов функции.
3) Флаг не выставлен (std::launch::async | std::launch::deferred ) - в этом случае будет выбрано одно из двух поведений описанных выше. Какое из двух? Неизвестно и зависит от имплементации.
Если используется функция 'std::async' без указания политики, то используется как раз третий случай. Чтобы избежать возможной неизвестности, анализатор выявляет такие случаи использования функции.
Future<int> foo = std::async(MyFunction, args...);После такого вызова функции есть вероятность, что на разных компьютерах с разными реализациями библиотек возможны отличные поведения функции.
Советуем обратить на это внимание и разрешить потенциальную неопределенность, указав первым параметром конкретную реализацию поведения функции. Надёжный вариант явного задания политики выполнения:
Future<int> foo = std::async(launch::async, MyFunction, args...)Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Анализатор обнаружил неправильный способ определения переполнения, которое может возникать при сложении переменных типов 'unsigned short' или переменных типов 'unsigned char'.
Пример некорректно написанного кода:
bool IsValidAddition(unsigned short x, unsigned short y)
{
if (x + y < x)
return false;
return true;
}При сложении двух переменных типов 'unsigned short', обе переменные приводятся к типу 'int'. Результат сложения также будет иметь тип 'int'. Поэтому, независимо от того, какие значения будут в переменных 'x' и 'y', в результате их сложения переполнения никогда не возникнет. Далее выполняется операция сравнения. При этом правый операнд (переменная 'x') вновь расширяется до типа 'int'. В итоге, приведённый выше код эквивалентен этому:
bool IsValidAddition(unsigned short x, unsigned short y)
{
if ((int)(x) + (int)(y) < (int)(x))
return false;
return true;
}Получается, что выражение "x + y < x" всегда будет ложно. Вероятнее всего, компилятор оптимизирует функцию, подставив в места ее вызова значение 'true'. Итог: функция ничего на самом деле не проверяет и не защищает от переполнения.
Примечание: Если вы используете модель данных, где размер типа 'short' и типа 'int' совпадают, то такая проверка будет работать корректно и анализатор не будет выдавать предупреждение.
Чтобы получить корректно работающий код, нужно явно выполнить приведение результата сложения к типу 'unsigned short':
if ((unsigned short)(x + y) < x)
{
...
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил фрагмент кода, который, скорее всего, содержит опечатку. В цепочке однотипных сравнений членов класса имеется выражение не похожее на остальные тем, что в нем сравниваются члены с разными именами, в то время как остальные выражения в цепочке сравнивают одноименные члены.
Рассмотрим пример:
if (a.x == b.x && a.y == b.y && a.z == b.y)В данном случае выражение 'a.z == b.y' отличается от остальных выражений в цепочке. Скорее всего, это выражение является ошибочным из-за опечатки при редактировании скопированного участка текста. Корректный код, который не вызовет подозрений у анализатора, будет выглядеть так:
if (a.x == b.x && a.y == b.y && a.z == b.z)Анализатор выдает предупреждение в тех случаях, когда длина цепочки сравнений более двух звеньев.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1013. |
Анализатор обнаружил подозрительный способ сравнения двух структур, которые содержат в себе члены типа float или double.
Пример:
struct Object
{
int Length;
int Width;
int Height;
float Volume;
};
bool operator == (const Object &p1, const Object &p2)
{
return memcmp(&p1, &p2, sizeof(Object)) == 0;
}Так как структура 'Object' содержит числа с плавающей точкой, то их сравнение через 'memcmp' может привести к неожиданному результату. Например, числа -0.0 и 0.0 эквивалентны, но имеют разное битовое представление. Два NaN имеют одинаковое представление, но они не эквивалентны. Возможно стоит использовать оператор == или сравнивать эти переменные с определённой точностью.
Допустим, мы хотим сравнивать члены классы с помощью оператора ==. В этом случае можно вообще удалить 'operator ==', так как компилятор сделает сам всё правильно, реализуя оператор сравнения по умолчанию. Однако, допустим мы хотим написать именно свою функцию, где будем сравнивать члены 'Volume' с определённой точностью. Тогда, исправленный вариант может выглядеть так:
bool operator == (const Object &p1, const Object &p2)
{
return p1.Length == p2.Length
&& p1.Width == p2.Width
&& p1.Height == p2.Height
&& fabs(p1.Volume - p2.Volume) <= FLT_EPSILON;
}Диагностическое правило классифицируется как:
|
Анализатор обнаружил подозрительное выражение, в котором смешаны логические и битовые операции. Возможно, в одной из них допущена опечатка.
Пример:
void write(int s);
void write(unsigned char a, unsigned char b,
unsigned char c, unsigned char d)
{
write((a << 24) | (b << 16) || (c << 8) | d);
}Это явная опечатка. В одном месте, вместо оператора '|' случайно воспользовались оператором '||'. Корректный код:
void write(unsigned char a, unsigned char b,
unsigned char c, unsigned char d)
{
write((a << 24) | (b << 16) | (c << 8) | d);
}Диагностическое правило классифицируется как:
|
Анализатор обнаружил опасное приведение числа к перечислению. Указанное число может не входить в диапазон значений 'enum'.
Примечание 1: Данное правило актуально только для языка C++. В качестве нижележащего типа 'enum' в языке C всегда используется тип 'int'.
Примечание 2: Данное правило актуально только для C++ компиляторов, рассчитывающих фактический размер 'enum' согласно стандарту. Например, такими компиляторами являются GCC и Clang. MSVC не является таким компилятором, так как рассчитывает размер 'enum' в целях обратной совместимости по правилам языка C и в качестве нижележащего типа всегда использует тип 'int', если специально не указан иной тип.
Результат приведения числа, чьё значение не входит в диапазон элементов 'enum', является неуточненным поведением до C++17 и неопределенным поведением, начиная с C++17.
Если у 'enum' указан нижележащий тип, то к типу этого 'enum' можно приводить все значения, которые можно уместить в этот тип.
Пример 1:
enum class byte : unsigned char {}; // Range: [0; 255]
byte b1 = static_cast<byte>(255); // okЧисло 256 уже не вмещается в тип 'char', и этот код некорректен:
byte b2 = static_cast<byte>(256); // UBЕсли не указан нижележащий тип, то, согласно стандарту, компилятор пытается уместить значения в зависимости от инициализатора в следующие типы:
int -> unsigned int -> long -> unsigned long ->
long long -> unsigned long longПри этом внутри выбранного типа компилятор использует минимально необходимое число бит (n), способное уместить максимальное число в перечислении. В такой 'enum' можно уместить диапазон значений [- (2^n) / 2; 2^n / 2 - 1] для 'enum' со знаковым нижележащим типом и [0; 2^n - 1] для 'enum' с беззнаковым нижележащим типом. Выход за границы этого диапазона является неуточненным поведением (до C++17) или неопределенным поведением (с C++17).
Пример 2:
enum foo { a = 0, b = UINT_MAX }; // Range: [0; UINT_MAX]
foo x = foo(-1); // UBНа первый взгляд, такой код является корректным, но на самом деле он может приводить к проблемам. Нижележащим типом 'enum' выбирается 'unsigned int'. Число '-1' не попадает в диапазон этого типа, поэтому такое присвоение может привести к неуточнённому или неопределённому поведению.
Пример 3:
enum EN { low = 2, high = 4 }; // Uses 3 bits, range: [0; 7]
EN a1 = static_cast<EN>(7); // okСогласно стандарту нижележащим типом для этого enum выберется 'int'. Внутри этого типа компилятор использует минимальное количество битовых полей, которое сможет вместить в себя все значения enum-констант.
В данном случае для вмещения всех значений (2 = 0b010 и 4 = 0b100) понадобится минимум 3 бита, поэтому переменная типа EN может вместить в себя числа от 0 (0b000) до 7 (0b111) включительно. Число 8 занимает уже четыре бита (0b1000), поэтому в тип EN оно уже не вмещается:
EN a2 = static_cast<EN>(8); // UBUndefinedBehaviorSanitizer также находит ошибку в этом примере: https://godbolt.org/z/GGYo7z.
При этом, если для EN указать нижележащий тип, например 'unsigned char', то это уже будет корректный вариант кода:
enum EN : unsigned char { low = 2, high = 4 }; // Range: [0; 255]
EN a2 = static_cast<EN>(8); // okВыявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил инициализацию экземпляра класса 'std::string_view' временным объектом или присваивание экземпляру класса 'std::string_view' временного объекта.
Рассмотрим пример:
std::string hello = "Hello, ";
std::string_view helloWorldPtr = hello + "world\n";
std::cout << helloWorldPtr;В данном случае, во второй строке будет создан временный объект типа 'std::string', указатель на который будет скопирован при инициализации экземпляра класса 'std::string_view'. Далее, после вычисления выражения инициализации, временный объект будет уничтожен и в третьей строке произойдет использование указателя на освобожденную память.
Правильный вариант кода:
std::string hello = "Hello, ";
const std::string helloWorld = hello + "world\n";
std::string_view helloWorldPtr = helloWorld;
std::cout << helloWorldPtr;Диагностическое правило классифицируется как:
Анализатор обнаружил ошибку при использовании обёртки над мьютексом (std::unique_lock и т.п.).
Рассмотрим пример:
std::unique_lock<std::mutex> lck;
lck.lock();В данном случае, во второй строке будет брошено исключение 'std::system_error', так как с обёрткой не связан мьютекс. Необходимо передать его в конструкторе:
std::unique_lock<std::mutex> lck(m, std::defer_lock);
lck.lock();или инициализировать методом 'swap()':
std::unique_lock<std::mutex> lck_global(mtx, std::defer_lock);
....
std::unique_lock<std::mutex> lck;
lck.swap(lck_global);
lck.lock();Также диагностика ищет случаи, когда критическая секция объявлена, но блокировка мьютекса по какой-то причине не выполняется:
std::unique_lock<std::mutex> lck(m, std::defer_lock);
//lck.lock();Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Анализатор обнаружил использование составного оператора присваивания внутри выражения, имеющего тип 'bool'.
Рассмотрим пример:
if (adj_number == (size_t)(roving->adj_count - 1) &&
(total_quantity += quantity_delta) < 0)
{
/* ... */
}В данном случае переменная 'total_quantity' изменяется внутри блока условия оператора 'if'. Дополнительную подозрительность этому коду придает тот факт, что изменение переменной 'total_quantity' произойдет только в том случае, если будет выполнено условие слева от оператора '&&'. Возможно, имеет место опечатка, и вместо составного оператора присваивания '+=' предполагается оператор сложения '+':
if (adj_number == (size_t)(roving->adj_count - 1) &&
(total_quantity + quantity_delta) < 0)
{
/* ... */
};Даже если первоначальный код был верен, всё равно крайне не рекомендуется писать такие сложные выражения. В логике подобного кода сложно разобраться и очень легко допустить ошибку, модифицируя подобный код.
Анализатор не может однозначно определить, содержит ли выявленный с помощью данной диагностики код настоящую ошибку, или программист перестарался, сокращая код. Мы изучили большое количество открытых проектов и выдели ряд паттернов программирования, когда используются рассмотренные конструкции кода и это не является ошибкой. С целью сокращения числа ложных срабатываний, предупреждение не выдаётся в следующих случаях:
Если в вашем проекте срабатываний слишком много, то можно отключить эту диагностику или воспользоваться механизмом подавления ложных срабатываний.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил в теле функции путь выполнения, начинающийся и заканчивающийся вызовом функций, имена которых содержат слова-антагонисты. При этом, между вызовами есть условие, которое приводит к возврату из анализируемой функции без вызова функции-эпилога.
Рассмотрим пример:
int pthread_cond_destroy(pthread_cond_t * cond)
{
EnterCriticalSection(&ptw32_cond_list_lock);
/* ... */
if (sem_wait (&(cv->semBlockLock)) != 0)
{
return errno; // <= V1020 Warning
}
/* ... */
LeaveCriticalSection(&ptw32_cond_list_lock);
return 0;
}В данном случае, в начале и конце функции присутствуют вызовы 'EnterCriticalSection' и 'LeaveCriticalSection' с соответствующими словами - антагонистами 'Enter' и 'Leave'. Между вызовами есть возврат из функции, перед которым по ошибке пропущен вызов 'LeaveCriticalSection'. Корректный код будет выглядеть следующим образом:
int pthread_cond_destroy(pthread_cond_t * cond)
{
EnterCriticalSection(&ptw32_cond_list_lock);
/* ... */
if (sem_wait (&(cv->semBlockLock)) != 0)
{
LeaveCriticalSection(&ptw32_cond_list_lock);
return errno;
}
/* ... */
LeaveCriticalSection(&ptw32_cond_list_lock);
return 0;
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1020. |
Анализатор обнаружил подозрительное присвоение в цикле, который может привести к бесконечному циклу.
Рассмотрим пример:
static void f(Node *n)
{
for (Node *it = n; it != nullptr; it = n->next)
....
}Это типичный код для обхода списков. В случае, когда 'n' не модифицируется,
этот цикл либо не выполнится ни разу, либо будет выполняться бесконечно.
Корректный код:
static void f(Node *n)
{
for (Node *it = n; it != nullptr; it = it->next)
....
}Диагностическое правило классифицируется как:
Анализатор обнаружил исключение, брошенное по указателю. Чаще всего принято бросать исключения по значению, а перехватывать по ссылке. Бросание указателя может привести к тому, что исключение не будет поймано, так как перехватывать его будут по ссылке. Также использование указателя вынуждает перехватывающую сторону вызвать оператор 'delete' для уничтожения созданного объекта, чтобы не возникали утечки памяти.
Пример:
throw new std::runtime_error("error");Корректный код:
throw std::runtime_error("error");Конечно, само по себе бросание исключения по указателю не является ошибкой. Такое исключение можно правильно перехватить и обработать. Однако на практике это неудобно и провоцирует ошибки. Недостатки использования указателя:
Таким образом, бросание исключения по указателю можно считать ошибочным паттерном и такой код следует переписать.
Дополнительные ссылки:
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1022. |
Анализатор обнаружил код добавления в контейнер умных указателей с помощью 'emplace_back(new X)'. Этот код может привести к утечке памяти.
Пример:
std::vector<std::unique_ptr<int>> pointers;
pointers.emplace_back(new int(42));В случае, если вектору понадобится реаллокация и он не сможет выделить память под новый массив, то он бросит исключение и указатель будет потерян.
Корректный код:
pointers.push_back(std::unique_ptr<int>(new int(42)));
pointers.push_back(std::make_unique<int>(42));Давайте разберёмся с этим видом ошибки более подробно.
Для добавлении элемента в конец контейнера типа 'std::vector<std::unique_ptr<X>>' нельзя просто написать 'v.push_back(new X)', так как нет неявного преобразования из 'X*' в 'std::unique_ptr<X>'.
Распространенным решением является написание 'v.emplace_back(new X)', так как он компилируется: метод 'emplace_back' конструирует элемент непосредственно из аргументов и поэтому может использовать явные конструкторы.
Тем не менее, это не безопасно. Если вектор полон, то происходит перевыделение памяти. Операция перевыделения памяти может закончиться неудачей, в результате чего будет сгенерировано исключение 'std::bad_alloc'. В этом случае указатель будет потерян, и созданный объект никогда не будет удален.
Безопасным решением является создание 'unique_ptr', который будет владеть указателем до того, как вектор попытается перевыделить память:
v.push_back(std::unique_ptr<X>(new X))Начиная с C++14 можно использовать 'std::make_unique':
v.push_back(std::make_unique<X>())Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки утечек памяти, незакрытых файловых дескрипторов и дескрипторов сетевых соединений [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1023. |
Анализатор обнаружил возможное использование некорректных данных при их чтении.
Пример неправильного кода:
while (!in.eof()) {
in >> x;
foo(x);
}В случае, если операция чтения закончится неудачей, переменная 'x' будет содержать некорректные данные. При этом функция 'foo' всё равно будет вызвана. Необходимо либо добавить ещё одну проверку перед использованием переменной 'x', либо переписать цикл так, как показано дальше.
Корректный код:
while (in >> x) {
foo(x);
}Дополнительные ссылки:
Диагностическое правило классифицируется как:
|
Анализатор обнаружил неправильное использование класса 'std::unique_lock', что может приводить к состоянию гонки.
Пример кода с ошибкой:
class C {
std::mutex m_mutex;
void foo() {
std::unique_lock <std::mutex>(m_mutex);
}
};В данном примере создаётся новая переменная с именем 'm_mutex', инициализированная по умолчанию. Соответственно, мьютекс захвачен не будет.
Корректный код:
void foo() {
std::unique_lock <std::mutex> var(m_mutex);
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Анализатор обнаружил возможное переполнение знаковой переменной в цикле. Переполнение знаковых переменных приводит к неопределённому поведению.
Пример:
int checksum = 0;
for (....) {
checksum += ....;
}Перед нами абстрактный алгоритм подсчёта контрольной суммы. Алгоритм подразумевает возможность переполнения переменной 'checksum'. Однако переменная имеет знаковый тип, а, следовательно, её переполнение приводит к неопределённому поведению. Код некорректен и должен быть модифицирован.
Следует использовать беззнаковые типы, семантика переполнения которых определена.
Корректный код:
unsigned checksum = 0;
for (....) {
checksum += ...
}Некоторые программисты считают, что в переполнении знаковых переменных ничего страшного нет и они могут предсказать, как программа будет работать. Это не так. Может происходить всё что угодно.
Давайте рассмотрим, как могут проявляться ошибки этого типа на практике. Разработчик на форуме жалуется, что GCC глючит и неправильно компилирует его код в режиме оптимизации. Он приводит код следующей функции для подсчёта хеша строки:
int foo(const unsigned char *s)
{
int r = 0;
while(*s) {
r += ((r * 20891 + *s *200) | *s ^ 4 | *s ^ 3) ^ (r >> 1);
s++;
}
return r & 0x7fffffff;
}Претензия разработчика в том, что компилятор не генерирует код для оператора побитового И (&). Из-за этого функция возвращает отрицательные значения, хотя не должна.
Разработчик считает, что это глюк в компиляторе. Но это не так, неправ программист, который написал такой код. Функция работает неправильно из-за того, что в ней возникает неопределённое поведение.
Компилятор видит, что в переменной 'r' считается некоторая сумма. Согласно стандартам языков C и C++, переполнения знаковой переменной 'r' произойти не может. Иначе в программе содержится неопределённое поведение, которое компилятор никак не должен рассматривать и учитывать.
Итак, компилятор считает, что раз переменная 'r' после окончания цикла не переполняется, то она не сможет стать отрицательной. Следовательно, операция 'r & 0x7fffffff' для сброса знакового бита является лишней, и компилятор её удаляет. Он просто возвращает из функции значение переменной 'r'.
Диагностика V1026 как раз и предназначена для выявления подобных ошибок. Чтобы исправить код, достаточно считать хеш, используя для этого беззнаковую переменную.
Исправленный вариант кода:
int foo(const unsigned char *s)
{
unsigned r = 0;
while(*s) {
r += ((r * 20891 + *s *200) | *s ^ 4 | *s ^ 3) ^ (r >> 1);
s++;
}
return (int)(r & 0x7fffffff);
}Дополнительные ссылки:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил подозрительное приведение типов. Указатель на класс приводится к указателю на другой класс, при этом классы никак не связаны между собой наследованием.
Подозрительный код:
struct A {};
struct B {};
struct C : B {};
void f(A *a, B *b) {
C *c = (C*)a;
}Возможно, нужно было привести другую переменную. Исправленный код:
void f(A *a, B *b) {
C *c = (C*)b;
}Если же такое поведение является ожидаемым, то следует использовать 'reinterpret_cast':
void f(A *a, B *b) {
C *c = reinterpret_cast<C*>(a);
}В этом случае анализатор не будет выдавать предупреждение.
Примечание. В некоторых проектах, особенно выполняющих низкоуровневые операции, можно встретить очень много приведений между различными структурами, не связанных между собой наследованием, но связанных логически. Другими словами, такие приведения типов используются сознательно и необходимы. В этом случае предупреждения анализатора будут только создавать ненужный шум и будет рационально просто отключить диагностику V1027.
Диагностическое правило классифицируется как:
Анализатор обнаружил подозрительное приведение типов. Результат бинарной операции над 32-битными числами приводят к 64-битному типу.
Пример кода с ошибкой:
unsigned a;
unsigned b;
....
uint64_t c = (uint64_t)(a * b);Такое преобразование избыточно. Тип 'unsigned' и так бы автоматически расширился до типа 'uint64_t' при присваивании.
Скорее всего, программист хотел защититься от переполнения, но не достиг цели. При перемножении переменных типа 'unsigned' всё равно произойдёт переполнение, и только уже бессмысленный результат умножения будет явно расширен до типа 'uint64_t'.
Следовало привести один из аргументов к этому типу, чтобы избежать переполнения. Корректный код:
uint64_t c = (uint64_t)a * b;Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1028. |
Анализатор обнаружил, что длину контейнера или строки кладут в 16-битную или 8-битную переменную. Это опасно, так как даже на не очень больших данных может произойти ошибка из-за того, что размер не помещается в заданную переменную.
Некорректный код:
std::string str;
....
short len = str.length();Необходимо использовать тип 'size_t', который точно вместит в себя размер любой строки/контейнера:
size_t len = str.length();Или, если быть более точными и педантичными, то тип 'std::string::size_type':
std::string::size_type len = str.length();Или можно воспользоваться ключевым словом auto:
auto len = str.length();Рассмотренная ошибка может показаться безобидной. Программист может исходить из предположения, что строка просто не может быть длинной при любых адекватных сценариях работы программы. Но программист не учитывает, что подобные усечения данных могут сознательно использоваться как уязвимости. Т.е. злоумышленник может неким образом подать некорректные входные данные, чтобы получить очень длинные строки. Некорректная обработка очень длинных строк может открыть ему возможность как-то влиять на поведение программы. Другими словами, данная ошибка может представлять собой потенциальную уязвимость и должна быть обязательно исправлена.
Некоторые пользователи говорят, что анализатор неправ, выдавая предупреждение на следующий код:
size = static_cast<unsigned short>(array->size());Они считают, что раз есть 'static_cast', то всё хорошо и программист знает, что делает. Однако возможно, что с помощью приведения типа кто-то боролся с предупреждением компилятора. Таким образом, 'static_cast' только маскирует, а не устраняет проблему.
Если в проекте много кода, где используются подобные приведения типа, и вы доверяете этому коду, то можно просто отключить диагностику 1029. Другой вариант - это отключить предупреждения именно там, где используется 'static_cast'. Для этого вы можете написать в одном из глобальных заголовочных файлов или файле конфигурации диагностик (.pvsconfig) следующий комментарий:
//-V:static_cast:1029Примечание. Диагностика V1029 не ищет случаи, когда размер кладут в 32-битную переменную. Поиском подобных ситуаций занимаются диагностики для выявления паттернов 64-битных ошибок. См. в документации набор диагностик "Diagnosis of 64-bit errors (Viva64, C++)".
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки целочисленного переполнения и некорректного совместного использования знаковых и беззнаковых чисел. |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил, что переменная используется после того, как она была перемещена.
std::string s1;
std::string s2;
....
s2 = std::move(s1);
return s1.size();После перемещения переменная существует в неуточнённом, но валидном для вызова деструктора состоянии. Полагаться на такое состояние объектов в своих программах опасно. Исключением является ряд классов, например, 'std::unique_ptr', поведение которых указано.
Диагностическое правило классифицируется как:
|
Анализатор обнаружил в файле использование функции без её предварительного объявления. В языке Си это допустимо, но такая возможность опасна, т.к. может стать причиной некорректной работы программы.
Рассмотрим простой пример.
char *CharMallocFoo(int length)
{
return (char*)malloc(length);
}Поскольку заголовочный файл <stdlib.h> не подключен, компилятор языка Си посчитает, что функция 'malloc' вернет тип 'int'. Неверная интерпретация возвращаемого значения компилятором может привести к проблемам во время выполнения программы, в том числе и к аварийному завершению.
Если программа 64-битная, то, скорее всего, будут потеряны старшие 32-бита возвращаемого адреса. Поэтому программа некоторое время будет работать корректно. Однако, когда свободная память в 4-х младших гигабайтах адресного пространства закончится или будет сильно фрагментирована, то будет выделен буфер за пределами 4-х младших гигабайт. Так как будут потеряны старшие биты указателя, то последствия будут крайне неприятны и непредсказуемы. Подробнее эта ситуация рассматривается в статье "Красивая 64-битная ошибка на языке Си".
Исправленный вариант кода:
#include <stdlib.h>
....
char *CharMallocFoo(int length)
{
return (char*)malloc(length);
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1031. |
Анализатор обнаружил преобразование указателя из одного типа в другой, которое приводит к неопределённому поведению. Разные типы объектов могут быть по-разному выравнены, и после приведения типа указателя выравнивание может быть изменено на некорректное. Если неправильный указатель будет разыменован, то программа может аварийно завершиться. Также операции с таким указателем могут приводить к потере информации.
Рассмотрим пример.
void foo(void) {
char ch = '1';
int *int_ptr = (int *)&ch;
char *char_ptr = (char *)int_ptr;
}При взятии адреса у переменой 'ch' и записи его в указатель типа 'int' возможна потеря данных. При обратном преобразовании выравнивание может быть изменено.
Обезопасить себя можно, например, используя одинаковые типы для операций:
void func(void) {
char ch = '1';
int i = ch;
int *int_ptr = &i;
}или вручную задав выравнивание:
#include <stdalign.h>
void func(void) {
alignas(int) char ch = '1';
int *int_ptr = (int *)&ch;
char * char_ptr = (char *)int_ptr;
}Рассмотрим другой случай, который можно встретить в коде приложений. На стеке выделен буфер байт, и его хотят использовать для хранения структуры. Такое бывает при работе с такими структурами, как BITMAPINFO. Вот как устроена эта структура:
typedef struct tagBITMAPINFOHEADER {
DWORD biSize;
LONG biWidth;
LONG biHeight;
WORD biPlanes;
WORD biBitCount;
DWORD biCompression;
DWORD biSizeImage;
LONG biXPelsPerMeter;
LONG biYPelsPerMeter;
DWORD biClrUsed;
DWORD biClrImportant;
} BITMAPINFOHEADER, *PBITMAPINFOHEADER;
....
typedef struct tagBITMAPINFO {
BITMAPINFOHEADER bmiHeader;
RGBQUAD bmiColors[1];
} BITMAPINFO, *LPBITMAPINFO, *PBITMAPINFO;Как видите, структура содержит переменные типа DWORD, LONG и т.д., которые должны быть правильно выравнены. Также, 'bmiColors' на самом деле это массив вовсе не из одного элемента. Элементов будет столько, сколько нужно, именно поэтому для создания этой структуры может использоваться массив байт. В результате, в приложениях можно встретить вот такой опасный код:
void foo()
{
BYTE buffer[sizeof(BITMAPINFOHEADER) + 3 * sizeof(RGBQUAD)] = {0};
BITMAPINFO *pBMI = (BITMAPINFO*)buffer;
....
}Скорее всего, буфер на стеке будет выравнен по границе 8 байт, и этот код будет работать. Однако этот код очень ненадёжен! Достаточно добавить в начало функции одну переменную, и можно всё сломать.
Неправильный код:
void foo()
{
char x;
BYTE buffer[sizeof(BITMAPINFOHEADER) + 3 * sizeof(RGBQUAD)] = {0};
BITMAPINFO *pBMI = (BITMAPINFO*)buffer;
....
}Теперь велик шанс, что 'buffer' будет начинаться с невыравненного адреса. Размер переменной 'x' и размер элементов массива 'buffer' равны. Следовательно, буфер можно расположить в стеке сразу после переменной 'x' без какого-либо отступа (выравнивания).
Конечно, всё зависит от компилятора. И программисту может вновь повезти, и код будет работать хорошо. Однако надеемся, что нам удалось объяснить, почему лучше так не делать.
Решить проблему можно, создавая массив в динамической памяти. Выделенный блок памяти всегда будет выравнен под любой тип.
Корректный код:
void foo()
{
char x;
BITMAPINFO *pBMI = (BITMAPINFO *)
calloc(sizeof(BITMAPINFOHEADER) + 3 * sizeof(RGBQUAD),
sizeof(BYTE));
....
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1032. |
Анализатор обнаружил переменную, объявленную с помощью ключевого слова 'auto' в языке Си. Ключевое слово 'auto' может запутать человека, привыкшего работать с C++11 и более старшими версиями языка C++. Вместо выведения типа компилятор будет интерпретировать ключевое слово 'auto' как тип 'int'.
Это может привести к неожиданным результатам для программиста, например, в арифметических операциях. Рассмотрим простой пример:
float d = 3.14f;
int i = 1;
auto sum = d + i;Значение переменной 'sum' будет равно '4', а не '4.14', как мог ожидать разработчик. В программах на языке Си необходимо явно объявить тип переменной:
float d = 3.14f;
int i = 1;
float sum = d + i;Первый пример полностью корректен для языка Си++. Эта диагностика поможет не ошибиться в проекте, который разрабатывается с использованием двух языков.
Анализатор обнаружил переменную вещественного типа в качестве счётчика цикла 'for'. Поскольку числа с плавающей точкой не могут точно отобразить все действительные числа, использование таких переменных в цикле может дать непостоянное количество итераций.
Рассмотрим пример:
void foo(void) {
for (float A = 0.1f; A <= 10.0f; A += 0.1f) {
....
}
}Количество итераций в этом цикле может быть 99 или 100. Точность операций с вещественными числами может зависеть от компилятора, режима оптимизации и многого другого.
Лучше переписать цикл следующим образом:
void foo(void) {
for (int count = 1; count <= 100; ++count) {
float A = count / 10.0f;
}
}Этот цикл выполнит ровно 100 итераций, а переменную 'A' можно использовать для необходимых вычислений.
Диагностическое правило классифицируется как:
|
Согласно стандарту языка Си, вызов функции 'fsetpos' с аргументом, полученным не из функции 'fgetpos', приводит к неопределённому поведению (UB, Undefined behavior).
Рассмотрим пример:
int foo()
{
FILE * pFile;
fpos_t position;
pFile = fopen("file.txt", "w");
memset(&position, 0, sizeof(position));
fputs("That is a sample", pFile);
fsetpos(pFile, &position);
fputs("This", pFile);
fclose(pFile);
return 0;
}Значение переменной 'position' не было получено функцией 'fgetpos', что может привести к сбою программы.
Исправленный вариант:
int foo()
{
FILE * pFile;
fpos_t position;
pFile = fopen("file.txt", "w");
fgetpos(pFile, &position);
fputs("That is a sample", pFile);
fsetpos(pFile, &position);
fputs("This", pFile);
fclose(pFile);
return 0;
}Диагностическое правило классифицируется как:
|
Анализатор обнаружил потенциальную ошибку, связанную с небезопасным использованием паттерна "блокировки с двойной проверкой" (double checked locking). Блокировка с двойной проверкой - это паттерн, предназначенный для уменьшения накладных расходов получения блокировки. Сначала проверяется условие блокировки без синхронизации. И только если условие выполняется, поток попытается получить блокировку. Таким образом, блокировка будет выполнена только если она действительно была необходима.
Рассмотрим пример с ошибкой:
static std::mutex mtx;
class TestClass
{
public:
void Initialize()
{
if (!initialized)
{
std::lock_guard lock(mtx);
if (!initialized) // <=
{
resource = new SomeType();
initialized = true;
}
}
}
/* .... */
private:
bool initialized = false;
SomeType *resource = nullptr;
};
}В этом примере, оптимизация компилятором порядка назначений переменных 'resource' и 'initialized' может привести к ошибке. Т.е. в начале переменной 'initialized' будет присвоено значение 'true', а уже потом будет выделена память под объект типа 'SomeType' и проинициализирована переменная 'resource'.
Такая перестановка может привести к ошибке при доступе к объекту из параллельного потока. Получается, что переменная 'resource' будет еще не проинициализирована, а флаг 'intialized' уже будет выставлен в 'true'.
Одна из опасностей таких ошибок состоит в том, что часто кажется, будто программа работает корректно. Это происходит из-за того, что рассмотренная ситуация будет возникать не очень часто, в зависимости от архитектуры используемого процессора.
Дополнительные ссылки:
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки при работе с многопоточными примитивами (интерфейсами запуска потоков на выполнение, синхронизации и обмена данными между потоками и пр.). |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1036. |
Анализатор обнаружил, что в операторе switch разные метки case содержат одинаковые фрагменты кода. Часто это свидетельствует об избыточном коде, который можно улучшить объединением меток. Но нередко одинаковые фрагменты кода могут быть причиной copy-paste программирования и являться настоящими ошибками.
Рассмотрим пример с избыточным кодом:
switch (wParam)
{
case WM_MOUSEMOVE:
::PostMessage(hWndServer, wParam, 0, 0);
break;
case WM_NCMOUSEMOVE:
::PostMessage(hWndServer, wParam, 0, 0);
break;
....
default:
break
}Действия для нескольких событий мыши действительно могут быть одинаковыми, поэтому код можно написать более компактно:
switch (wParam)
{
case WM_MOUSEMOVE:
case WM_NCMOUSEMOVE:
::PostMessage(hWndServer, wParam, 0, 0);
break;
....
default:
break
}Рассмотрим пример из реального приложения, где разработчик допустил ошибку из-за опечатки:
GLOBAL(void)
jpeg_default_colorspace (j_compress_ptr cinfo)
{
switch (cinfo->in_color_space) {
case JCS_GRAYSCALE:
jpeg_set_colorspace(cinfo, JCS_GRAYSCALE);
break;
case JCS_RGB:
jpeg_set_colorspace(cinfo, JCS_YCbCr);
break;
case JCS_YCbCr:
jpeg_set_colorspace(cinfo, JCS_YCbCr);
break;
....
}
....
}В коде метки JCS_RGB допущена опечатка. Следовало передавать в функцию значение JCS_RGB, а не JCS_YCbCr.
Исправленный код:
GLOBAL(void)
jpeg_default_colorspace (j_compress_ptr cinfo)
{
switch (cinfo->in_color_space) {
case JCS_GRAYSCALE:
jpeg_set_colorspace(cinfo, JCS_GRAYSCALE);
break;
case JCS_RGB:
jpeg_set_colorspace(cinfo, JCS_RGB);
break;
case JCS_YCbCr:
jpeg_set_colorspace(cinfo, JCS_YCbCr);
break;
....
}
....
}Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1037. |
Анализатор обнаружил ситуацию, когда к символьному литералу прибавляется указатель. Скорее всего, это ошибка.
Например, к строке, имеющей тип 'const char*', программист хочет дописать символ:
const char* Foo()
{
return "Hello world!\n";
}
int main()
{
const char* bar = 'g' + Foo();
printf("%s", bar);
return 0;
}В этом случае произойдет прибавление к указателю числового значения символа 'g', в результате чего возможен выход за границы строки. Для исправления этой ошибки следует использовать, по возможности, специальный класс 'std::string' или производить операции с памятью:
const char* Foo()
{
return "Hello world!\n";
}
int main()
{
std::string bar = 'g' + std::string(Foo());
printf("%s", bar.c_str());
return 0;
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки переполнения буфера (записи или чтения за пределами выделенной для буфера памяти). |
Диагностическое правило классифицируется как:
Анализатор обнаружил код, в котором multicharacter-литерал содержит одновременно символы и escape-коды.
Multicharacter-литерал является implementation-defined, поэтому различные компиляторы могут кодировать эти литералы по-разному. К примеру, GCC и Clang задают значение основываясь на порядке символов в литерале, тогда как MSVC перемещает их в зависимости от типа символа (обычный или escape).
Рассмотрим пример. Код ниже, скомпилированный различными компиляторами, будет вести себя по-разному:
#include <stdio.h>
void foo(int c)
{
if (c == 'T\x65s\x74') // <= V1039
{
printf("Compiled with GCC or Clang.\n");
}
else
{
printf("It's another compiler (for example, MSVC).\n");
}
}
int main(int argc, char** argv)
{
foo('Test');
return 0;
}Программа, скомпилированная разными компиляторами, может напечатать разные сообщения на экран.
Для проекта, использующего определенный компилятор, это не будет заметно, однако при портировании могут возникнуть проблемы, поэтому следует заменить такие литералы простыми числовыми константами, к примеру, 'Test' поменять на '0x54657374'.
Чтобы продемонстрировать разницу между компиляторами, можно взять последовательности из 3-х и 4-х символов, например, 'GHIJ' и 'GHI', и вывести на экран их представление в памяти после компиляции.
Вывод утилиты, скомпилированной Visual C++:
Hex codes are: G(47) H(48) I(49) J(4A)
'GHIJ' : JIHG
'\x47\x48\x49\x4A' : GHIJ
'G\x48\x49\x4A' : HGIJ
'GH\x49\x4A' : JIHG
'G\x48I\x4A' : JIHG
'GHI\x4A' : JIHG
'GHI' : IHG
'\x47\x48\x49' : GHI
'GH\x49' : IHG
'\x47H\x49' : HGI
'\x47HI' : IHGВывод утилиты, скомпилированной GCC или Clang:
Hex codes are: G(47) H(48) I(49) J(4A)
'GHIJ' : JIHG
'\x47\x48\x49\x4A' : JIHG
'G\x48\x49\x4A' : JIHG
'GH\x49\x4A' : JIHG
'G\x48I\x4A' : JIHG
'GHI\x4A' : JIHG
'GHI' : IHG
'\x47\x48\x49' : IHG
'GH\x49' : IHG
'\x47H\x49' : IHG
'\x47HI' : IHGАнализатор обнаружил возможную опечатку в записи предопределенного макроса.
Пример:
#if defined (__linux__) || defined (__APPLE_)Это выражение без ошибки выглядит следующим образом:
#if defined (__linux__) || defined (__APPLE__)Ещё один пример возможной опечатки:
#ifdef __WLN32__Исправленный вариант:
#ifdef __WIN32__Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1040. |
Диагностика выявляет случаи инициализации членов класса "плохим" указателем или ссылкой.
Пример:
class Foo {
int *x;
int &y;
Foo(int a, int b);
};
Foo::Foo(int a, int b) :
x(&a), // <=
y(b) // <=
{};Переменная 'x' является указателем, при инициализации ей присваивается адрес переменной 'a'. Переменная 'a' - аргумент и является локальной для конструктора, поэтому область ее видимости короче, чем у 'x'. После выхода из конструктора 'x' будет иметь неверный указатель.
То же самое верно и для ссылки 'y'.
Правильный вариант будет выглядеть таким образом:
class Foo {
int *x;
int &y;
Foo(int *a, int &b) :
x(a),
y(b)
{}
};
Foo::Foo(int *a, int &b) :
x(a),
y(b),
{}
};Теперь конструктору передаются адрес и ссылка напрямую, их область видимости все так же ограничена областью видимости конструктора, но область видимости их значений - нет.
Диагностическое правило классифицируется как:
|
Правило актуально только для C/C++. Аналогичные правила существуют для C# и Java анализаторов: V3144 и V6071 соответственно.
Анализатор обнаружил в файле copyleft-лицензию, которая может накладывать требования на раскрытие исходного кода при распространении или модификации. В зависимости от типа лицензии (strong или weak copyleft) эти требования могут распространяться как на весь проект, так и только на его отдельные части, что может быть критично для коммерческого использования.
Если вы разрабатываете открытый проект, то можно просто игнорировать это предупреждение и отключить его.
Пример комментария, на который анализатор выдаст предупреждение:
/* This program is free software: you can redistribute it and/or modify
* it under the terms of the GNU General Public License as published by
* the Free Software Foundation, either version 3 of the License, or
* (at your option) any later version.
*
* This program is distributed in the hope that it will be useful,
* but WITHOUT ANY WARRANTY; without even the implied warranty of
* MERCHANTABILITY or FITNESS FOR A PARTICULAR PURPOSE. See the
* GNU General Public License for more details.
*
* You should have received a copy of the GNU General Public License
* along with this program. If not, see <https://www.gnu.org/licenses/>.
*/Примечание N1. Диагностическое правило поддерживает обнаружение лицензий по SPDX-идентификаторам.
Примечание N2. Если указано несколько SPDX-идентификаторов и хотя бы один из них соответствует copyleft-лицензии, то анализатор выдаст предупреждение. Это обусловлено тем, что анализатор не может достоверно определить, какая именно лицензия применяется в производном проекте.
Пример SPDX-идентификатора, на который анализатор выдаст предупреждение:
// spdx-license-identifier: MPL-2.0Если в закрытый проект добавить файл с сильной (strong) copyleft-лицензией, например GPL, то остальной исходный код необходимо будет открыть из-за особенностей данной лицензии.
Сильные (strong) copyleft-лицензии называют "вирусными" лицензиями из-за их свойства распространяться на остальные файлы проекта. Проблема в том, что использование хотя бы одного файла с подобной лицензией в закрытом проекте автоматически делает весь исходный код открытым и обязывает распространять его вместе с бинарными файлами.
Если в закрытый проект добавить файл или библиотеку со слабой (weak) copyleft-лицензией, например LGPL, то при определённых условиях может потребоваться раскрыть код самой библиотеки и её модификаций, тогда как остальная часть проекта может оставаться закрытой.
На данный момент диагностическое правило поддерживает следующие лицензии:
|
Тип |
Список лицензий |
|---|---|
|
Strong copyleft |
AGPL, EUPL, GPL, NGPL, NPOSL-3.0, OSL, RPL, SSPL |
|
Weak copyleft |
Artistic-2.0, CATOSL-1.1, CDDL, CPL, EPL, LGPL, MPL |
Есть следующие варианты, как вы можете поступить, обнаружив в закрытым проекте использование файлов с copyleft-лицензий:
Мы понимаем, что это диагностическое правило неуместно для открытых проектов. Команда PVS-Studio способствует развитию открытых проектов, помогая исправлять в них ошибки и предоставляя бесплатные варианты лицензий. Однако наш продукт является B2B решением, и поэтому это правило включено по умолчанию.
Если же ваш код распространяется под одной из указанных выше copyleft-лицензий, то вы можете отключить это правило следующими способами:
Если вам известны другие copyleft-лицензии, требующие раскрытия исходного кода, и которые в данный момент не выявляет инструмент, то вы можете сообщить нам о них через форму обратной связи. Мы добавим их выявление в последующих релизах.
Диагностическое правило классифицируется как:
Анализатор обнаружил в объявление константного экземпляра класса в заголовочном файле. При включении такого файла через 'include' произойдет создание множественных копий объекта. Если в классе есть конструктор, его код выполнится при каждом включении заголовочного файла, что может привести к нежелательным побочным эффектам.
Пример:
//some_header.h
class MyClass
{
int field1;
int field2;
MyClass (int a, int b)
{
// ....
}
};
// ....
const MyClass object{1, 2}; // <=Диагностика не распространяется на классы и структуры, у которых не определены конструкторы. Следующий код не приведет к срабатыванию:
//some_header.h
struct MyStruct
{
int field1;
int field2;
};
// ....
const MyStruct object{1, 2};Также, чтобы избежать ошибки, можно объявить переменную как 'inline' (начиная с C++17) или 'extern'. В этом случае инициализация и вызов конструктора произойдет один раз.
Корректный пример:
//some_header.h
class MyClass
{
// ....
};
// ....
inline const MyClass object{1, 2};Примечание: использование ключевого слова 'constexpr' вместо 'const' при объявлении переменной не изменяет данное поведение. Согласно стандарту С++17, только constexpr-функции и constexpr-статические поля классов/структур объявляются со спецификатором inline неявно.
Более подробно данная проблема рассмотрена в статье "What Every C++ Developer Should Know to (Correctly) Define Global Constants".
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1043. |
Анализатор обнаружил цикл, условия выхода которого не зависят от количества итераций. Такой цикл может выполнится 0, 1, либо бесконечное количество раз.
Пример такого цикла:
void sq_settop(HSQUIRRELVM v, SQInteger newtop)
{
SQInteger top = sq_gettop(v);
if(top > newtop)
sq_pop(v, top - newtop);
else
while(top < newtop) sq_pushnull(v); // <=
}Ошибка здесь в цикле while - переменные, которые находятся в условии, никак не меняют своих значений, поэтому цикл никогда не завершится, либо никогда не запустится (если их значения равны).
Цикл может выполнятся всегда только один раз, если его первая итерация меняет условие:
while (buf != nullptr && buf != ntObj)
{
ntObj = buf;
}Если такое поведение является корректным, то цикл лучше заменить на if:
if (buf != nullptr && buf != ntObj)
{
ntObj = buf;
}Еще один пример:
#define PEEK_WORD(ptr) *((uint16*)(ptr))
....
for(;;)
{
// Verify the packet size
if (dwPacketSize >= 2)
{
dwMsgLen = PEEK_WORD(pbytePacket);
if ((dwMsgLen + 2) == dwPacketSize)
break;
}
throw CString(_T("invalid message packet"));
}Любой путь этого цикла ведет к выходу из него, а переменные, используемые в цикле, не меняются. Такой цикл, скорее всего, содержит ошибку, либо его просто стоит убрать.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1044. |
Анализатор обнаружил код, выбрасывающий и не перехватывающий исключение в теле функции DllMain.
При загрузке динамической библиотеки в процесс эта функция принимает значение DLL_PROCESS_ATTACH в качестве аргумента 'fwdReason'. Если DllMain завершается с ошибкой, она обязана вернуть значение FALSE. В этом случае загрузчик вызывает эту функцию снова со значением DLL_PROCESS_DETACH в 'fwdReason', что приводит к выгрузке DLL. Если функция DllMain завершается в результате исключения, выгрузка библиотеки не происходит.
Пример:
BOOL WINAPI DllMain(HINSTANCE hinstDLL, DWORD fdwReason, LPVOID lpvReserved)
{
....
throw 42;
....
}Ошибку следует обработать в блоке try...catch и корректно вернуть FALSE.
Корректный пример:
BOOL __stdcall DllMain(HINSTANCE hinstDLL, DWORD fdwReason, LPVOID lpvReserved)
{
try
{
....
throw 42;
....
}
catch(...)
{
return FALSE;
}
}Также исключения могут возникать при вызове оператора 'new'. При невозможности выделения памяти будет сгенерировано исключение 'bad_alloc'. Пример:
BOOL WINAPI DllMain(HINSTANCE hinstDLL, DWORD fdwReason, LPVOID lpvReserved)
{
....
int *localPointer = new int[MAX_SIZE];
....
}Появление исключения возможно при использовании dynamic_cast<Type> при работе со ссылками. При невозможности приведения типов будет сгенерировано исключение 'bad_cast'. Пример:
BOOL WINAPI DllMain(HINSTANCE hinstDLL, DWORD fdwReason, LPVOID lpvReserved)
{
....
UserType &type = dynamic_cast<UserType&>(baseType);
....
}Для исправления данных ошибок следует переписать код таким образом, чтобы 'new' или 'dynamic_cast' были помещены в блок try...catch.
Анализатор также обнаруживает в DllMain вызовы функций, которые потенциально могут выбросить исключение. Пример:
BOOL WINAPI DllMain(HINSTANCE hinstDLL, DWORD fdwReason, LPVOID lpvReserved)
{
....
potentiallyThrows();
....
}Если анализатор не нашел в коде вызываемой функции операций, способных выбросить исключение, предупреждение на ее вызов выдано не будет.
Аналогично предыдущим примерам, вызовы функций, потенциально бросающих исключения, следует обернуть в блок try...catch.
Диагностическое правило классифицируется как:
Анализатор обнаружил небезопасное использование типа 'bool' и целочисленного типа вместе в операции побитового И. Проблема в том, что побитовое И вернет 'false' для четных чисел, так как младший разряд всегда равен нулю. Если же привести вручную численный тип к 'bool', то всё будет в порядке.
Рассмотрим синтетический пример:
int foo(bool a)
{
return a ? 0 : 2;
}
....
bool var = ....;
var &= foo(false);Независимо от начального значения переменной 'var', после выполнения операции '&=' эта переменная будет иметь значение 'false'. Допустим, функция 'foo' вернёт значение 2. Тогда операция 'var & 2' всегда даёт в результате 0, так как возможные значения 'var' это только 0 или 1.
Этот код следует исправить так:
var &= foo(false) != 0;или же можно изменить и возвращаемое функцией значение:
int foo(bool a)
{
return a ? 0 : 1;
}Если, например, функция будет возвращать только значения из диапазона [0;1], то всё в порядке, так как мы можем привести их без потерь к bool.
Пример ошибки, найденной с помощью этой диагностики в реальном проекте:
template<class FuncIterator>
bool SetFunctionList( FuncIterator begin, FuncIterator end) {
bool ret = true;
for (FuncIterator itr = begin; itr != end; ++itr) {
const ROOT::Math::IMultiGenFunction *f = *itr;
ret &= AddFunction(*f);
}
return ret;
}
int AddFunction(const ROOT::Math::IMultiGenFunction & func) {
ROOT::Math::IMultiGenFunction *f = func.Clone();
if (!f) return 0;
fFunctions.push_back(f);
return fFunctions.size();
}Предполагалось, что функция 'SetFunctionList' проверяет валидность переданных ей итераторов и возвращает 'false', если хоть один из них невалидный, иначе 'true'. Но программист допустил ошибку при работе с оператором '&='. Правый аргумент – функция, которая возвращает целое число в диапазоне от 0 до SIZE_MAX. При возвращении чётных чисел из функции 'AddFunction', переменная 'ret' будет обнуляться, хотя должна это делать только для невалидных итераторов.
Исправленная функция 'SetFunctionList', где результат функции 'AddFunction' предварительно приводится к типу 'bool':
template<class FuncIterator>
bool SetFunctionList( FuncIterator begin, FuncIterator end) {
bool ret = true;
for (FuncIterator itr = begin; itr != end; ++itr) {
const ROOT::Math::IMultiGenFunction *f = *itr;
ret &= (bool)AddFunction(*f);
}
return ret;
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1046. |
Анализатор обнаружил подозрительный захват переменной в лямбда функции.
Рассмотрим варианты срабатывания диагностики:
Пример 1:
function lambda;
{
auto obj = dummy<int>{ 42 };
lambda = [&obj]() { .... };
}Переменную, которая будет уничтожена при выходе из блока, захватывают по ссылке. Время жизни лямбда функции при этом превышает время жизни объекта. Это приведет к использованию ссылки на уничтоженный объект при вызове лямбда функции.
Вероятно, объект нужно захватить по значению:
function lambda;
{
auto obj = dummy<int>{ 42 };
lambda = [obj]() { .... };
}Пример 2:
function lambda;
{
auto obj1 = dummy<int>{ 42 };
auto obj2 = dummy<int>{ 42 };
lambda = [&]() { .... };
}В этом случае диагностика определит, что обе переменные захвачены по ссылке и выдаст предупреждение на каждую из них.
Также возможно, что функция возвращает лямбду, захватившую локальную переменную по ссылке.
Пример 3:
auto obj = dummy<int>{ 42 };
return [&obj]() { .... };В этом случае вызывающий код получит из функции лямбду, вызов которой приведет к использованию невалидной ссылки.
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1047. |
Анализатор обнаружил присваивание переменной значения, которое уже содержится в ней. Скорее всего, это логическая ошибка.
Рассмотрим пример:
int i = foo();
if (i == 0)
{
i = 0; // <=
}Отмеченное присваивание не изменяет значение переменной, и код, скорее всего, содержит ошибку.
Анализатор также может находить случаи, когда точные значения переменных неизвестны:
void foo(int x, int y)
{
if (x == y)
{
x = y; // <=
}
}Хотя переменные 'x' и 'y' могут принимать любые значения, присваивание всё равно не имеет смысла из-за имеющейся выше проверки на равенство.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1048. |
Анализатор обнаружил объявление одного и того же include guard в разных заголовочных файлах, включенных в одну единицу трансляции. Это приводит к тому, что произойдёт "вставка" тела только одного файла, включенного первым.
Это диагностическое правило применяется к проектам на языке C.
Рассмотрим пример заголовочного файла header1.h:
// header1.h
#ifndef _HEADER_H_
#define _HEADER_H_
....
#endifи header2.h:
// header2.h
#ifndef _HEADER_H_
#define _HEADER_H_ // <=
....
#endifПри создании второго заголовочного файла, программист скопировал код из первого файла и забыл переименовать макрос '_HEADER_H_'.
Таким образом, при компиляции следующего фрагмента, код из header2.h не будет включён в итоговый файл:
....
#include "header1.h"
#include "header2.h"
...На первый взгляд кажется, что проблемы нет, так как должны возникать ошибки компиляции. Но на самом деле файл может успешно компилироваться.
Язык C позволяет вызывать необъявленные функции. В таких случаях предполагается, что функция возвращает значение типа 'int', и аргументы тоже имеют тип 'int'. Если заголовочный файл с объявлениями функций был исключен из компиляции, сборка проекта может пройти успешно, но во время выполнения программа будет работать некорректно. Подобная ситуация, например, описана в статье "Красивая 64-битная ошибка на языке Си".
Чтобы исправить ошибку, необходимо использовать уникальные имена include guard в заголовочных файлах.
См. также родственную диагностику: V1031. Function is not declared. The passing of data to or from this function may be affected.
Анализатор обнаружил, что вызов базового конструктора в списке инициализации выполняется с использованием неинициализированных полей дочернего класса.
Рассмотрим пример:
struct C : public Base
{
C(int i) : m_i(i), Base(m_i) {};
....
int m_i;
};Согласно стандарту, сперва инициализируются базовые классы в порядке, указанном в объявлении. На момент вызова конструктора 'Base' переменная 'm_i' ещё не инициализирована, поэтому исправить код можно, например, так:
struct C : public Base
{
C(int i) : m_i(i), Base(i) {};
....
int m_i;
};Также анализатор может обнаружить использование неинициализированных переменных, находящихся не только внутри класса, но и внутри базовых классов:
struct Base1
{
Base1(int i) : m_base1(i) { };
virtual ~Base1() = default;
....
int m_base1;
};
struct Base2
{
Base2(int i) : m_base2(i) { };
virtual ~Base2() = default;
....
int m_base2;
};
struct C : public Base1, public Base2
{
C(int i) : m_i(i), Base1(m_base2), Base2(i) {};
....
int m_i;
};Если нужно инициализировать один из базовых классов полем другого, то нужно убедиться в том, что они инициализируются в нужном порядке:
struct C : public Base2, public Base1
{
C(int i) : m_i(i), Base1(m_base2), Base2(i) {};
....
int m_i;
};Похожие проблемы способна искать диагностика V670. Однако она занимается поиском проблем, связанных с порядком инициализации полей одного класса, когда порядок инициализации переменных зависит от порядка их объявления в классе.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки использования неинициализированных переменных. |
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1050. |
Анализатор обнаружил ситуацию, когда проверка переменной может быть пропущена в следующем 'if' после присваивания или инициализации.
К примеру, ошибочным можно считать такой код:
int ret = syscall(....);
if (ret != -1) { .... }
....
int ret2 = syscall(....);
if (ret != -1) { .... } // <=Часто бывают случаи, когда надо проверить возвращаемое значение какой-либо функции. Однако можно допустить ошибку, указав другую переменную внутри условия 'if'. Чаще всего подобная ошибка возникает, когда фрагмент кода копируется, но в нём забывают заменить имя переменной в условии. В рассмотренном примере в условии забыли заменить имя 'ret' на 'ret2'.
Исправленный вариант:
int ret2 = syscall(....);
if (ret2 != -1) { .... }Или же можно допустить ошибку в таком случае:
obj->field = ....;
if (field) ....;Переменная и член класса имеют одинаковые имена, из-за чего их легко перепутать.
Диагностика является эвристической. Во время своей работы диагностика разбивает имена переменных на составные части, сравнивает их и на основании этого делает предположения о наличии опечатки. Также производится базовая проверка типов. Это сделано для того, чтобы сократить число ложных срабатываний.
Часто диагностика может выдавать срабатывание на подобные случаи:
var->m_abc = ....;
var->m_cba = ....;
if (var->m_abc) // <=
{
....
}Как правило это корректный код и ошибки нет. Можно либо подавить диагностику, либо поменять переменные местами, чтобы присваивание проверяемой переменной находилось перед 'if':
var->m_cba = ....;
var->m_abc = ....;
if (var->m_abc)
{
....
}Такая запись может сделать код более читаемым, т.к. присваивание и проверка находятся рядом.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1051. |
Анализатор обнаружил присутствие виртуального метода в классе, помеченном как 'final'.
После рефакторинга или вследствие ошибочного проектирования класса могло получиться так, что класс был объявлен как завершенный ('final'), но при этом в него были добавлены непереопределенные виртуальные методы.
Такая структура класса не имеет смысла, и стоит проверить, не была ли нарушена логика наследования самого класса. Кроме этого, создание такого класса может приводить к хранению лишнего указателя на виртуальную таблицу методов и падению производительности.
Анализатор выдаст предупреждение для следующего класса:
struct Cl final // <= V1052
{
virtual ~Cl() {}
};
struct BaseClass
{
virtual void foo(int);
};
struct DerivedClass final : BaseClass // <= V1052
{
virtual void bar(float);
};Если виртуальный метод / деструктор завершенного класса переопределяет виртуальный метод / деструктор базового класса, предупреждение выдано не будет:
struct BaseClass
{
virtual void foo();
virtual ~BaseClass();
};
struct DerivedClass final : BaseClass // ok
{
virtual void foo() override;
virtual ~DerivedClass();
};Анализатор обнаружил вызов виртуальной функции в конструкторе или деструкторе класса.
Рассмотрим пример:
struct Base
{
Base()
{
foo();
}
virtual ~Base() = default;
virtual void foo() const;
};Сам по себе вызов виртуального метода 'foo' в конструкторе класса 'Base' может не являться ошибкой, однако проблемы могут проявить себя в производных классах.
struct Child : Base
{
Child() = default;
virtual ~Child() = default;
virtual void foo() const override;
};Во время создания объекта типа 'Child' будет вызван метод 'Base::foo()' из конструктора базового класса, но не переопределенный метод 'Child::foo()' из производного класса.
Для исправления этой проблемы нужно уточнить вызов метода. Например, для класса 'Base':
struct Base
{
Base()
{
Base::foo();
}
virtual ~Base() = default;
virtual void foo() const;
};Теперь одного взгляда на код достаточно чтобы понять, какой именно метод будет вызван.
Также отметим, что использование указателя на себя 'this' при вызове виртуального метода не решает исходную проблему, и при использовании 'this' все также необходимо уточнить, из какого класса следует позвать виртуальную функцию:
struct Base
{
Base()
{
this->foo(); // bad
this->Base::foo(); // good
}
virtual ~Base() = default;
virtual void foo() const;
};Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1053. |
Анализатор обнаружил потенциальную ошибку, связанную с тем, что объект производного класса был скопирован в объект базового класса, т.е. произошла срезка типа.
Если базовый и производный классы являются полиморфными (т.е. содержат виртуальные функции), то при таком копировании информация о переопределенных виртуальных функциях в производных классах будет утеряна. Это может привести к нарушению полиморфного поведения.
Другим фактом является то, что объект базового класса теряет информацию о полях производного класса, если конструктор копирования сгенерирован компилятором неявно (возможно даже и в случае определенного пользователем).
Рассмотрим следующий пример:
struct Base
{
int m_i;
Base(int i) : m_i { i } { }
virtual int getN() { return m_i; }
};
struct Derived : public Base
{
int m_j;
Derived(int i, int j) : Base { m_i }, m_j { j } { }
virtual int getN() { return m_j; }
};
void foo(Base obj) { std::cout << obj.getN() << "\n"; }
void bar()
{
Derived d { 1, 2 };
foo(d);
}При передаче переменной 'd' в функцию 'foo' произойдет копирование, а функция 'getN' будет вызвана из класса 'Base'.
Чтобы избежать проблем, связанных со срезкой типа, стоит использовать указатели/ссылки:
void foo(Base &obj) { std::cout << obj.getN() << "\n"; }В этом случае копирования не произойдет, и 'getN' будет вызвана из класса 'Derived'.
Если срезка типа все же необходима, то желательно определить явную операцию, которая это делает. Это спасет читателей кода от путаницы:
struct Base
{
....
};
struct Derived : public Base
{
....
Base copy_base();
....
};
void foo(Base obj);
void bar()
{
Derived d { .... };
foo(d.copy_base());
}Анализатор не выдает срабатывание в случае, если иерархия классов не содержит виртуальных функций и все нестатические поля располагаются в базовом классе:
struct Base
{
int m_i;
int m_j;
Base(int i, int j) : m_i { i }, m_j { j } { }
int getI() { return m_i; }
int getJ() { return m_j; }
};
struct Derived : public Base
{
Derived(int i, int j) : Base(i, j) { }
virtual int getN() { return m_j; }
};Диагностическое правило классифицируется как:
|
Анализатор обнаружил в качестве аргумента оператора 'sizeof' переменную типа "STL-подобный контейнер".
Рассмотрим следующий пример:
#include <string>
void foo(const std::string &name)
{
auto len = sizeof(name) / sizeof(name[0]);
....
}Выражение 'sizeof(name)' возвращает не суммарный размер элементов в контейнере в байтах (или просто количество элементов), а именно размер типа контейнера, отведенный для имплементации. Например, типичная имплементация 'std::string' может содержать 3 указателя (стандартная библиотека libc++, 64-битная система), т.е. 'sizeof(name) == 24'. Размер же реальной хранимой строки чаще всего отличается от этого значения.
Ошибка подобного рода может появиться в проекте в результате рефакторинга старого кода:
#define MAX_LEN(str) ( sizeof((str)) / sizeof((str)[0]) - 1 )
typedef char MyString[256];
void foo()
{
MyString str { .... };
....
size_t max_len = MAX_LEN(str);
}При замене псевдонима 'MyString' с типа 'char[256]' на 'std::string' вычисление максимально допустимой длины строки станет некорректным.
Для получения реального размера STL-подобных контейнеров стоит использовать публичную функцию-член '.size()':
#include <string>
void foo(const std::string &name)
{
auto len = name.size();
}Если подразумевалось именно вычисление размера имплементации контейнера, то для лучшего понимания кода предпочтительнее передавать в качестве операнда оператора 'sizeof' тип контейнера, прямым способом или через оператор 'decltype' (C++11) для переменных:
#include <string>
void foo(const std::string &str)
{
auto string_size_impl1 = sizeof(std::string);
auto string_size_impl2 = sizeof(decltype(str));
}Диагностика также знает о существовании контейнера 'std::array' и не выдает на нем срабатывание при его использовании в качестве операнда оператора 'sizeof':
template <typename T, size_t N>
void foo(const std::array<T, N> &arr)
{
auto size = sizeof(arr) / sizeof(arr[0]); // ok
}Начиная со стандарта C++17, рекомендуется использовать свободную функцию 'std::size()', которая умеет работать как встроенными массивами, так и всеми типами контейнеров, имеющими публичную функцию-член '.size()':
#include <vector>
#include <string>
#include <set>
#include <list>
void foo()
{
int arr[256] { .... };
std::vector vec { .... };
std::string str { .... };
std::set set { .... };
std::list list { .... };
auto len1 = std::size(arr);
auto len2 = std::size(vec);
auto len3 = std::size(str);
auto len4 = std::size(set);
auto len5 = std::size(list);
}Диагностическое правило классифицируется как:
Анализатор обнаружил использование идентификатора '__func__' в теле перегруженного оператора '()'.
Рассмотрим пример:
class C
{
void operator()(void)
{
std::cout << __func__ << std::endl;
}
};
void foo()
{
C c;
c();
}При запуске будет выведено 'operator()'. На первый взгляд, это вполне ожидаемое поведение для подобного кода, поэтому перейдем к более неочевидному примеру:
void foo()
{
auto lambda = [] () { return __func__; };
std::cout << lambda() << std::endl;
}Важно учитывать тот факт, что '__func__' не является переменной в привычном смысле этого слова, поэтому следующие варианты не сработают, и по-прежнему будет выведено 'operator()':
void fooRef()
{
auto lambda = [&] () { return __func__; };
std::cout << lambda() << std::endl;
}
void fooCopy()
{
auto lambda = [=] () { return __func__; };
std::cout << lambda() << std::endl;
}Чтобы исправить это в случае с лямбдой, необходимо передать '__func__' явно через список захвата:
void foo()
{
auto lambda = [func = __func__] () { return func; };
std::cout << lambda() << std::endl;
}Для более полноценного вывода имени функции даже внутри перегруженного 'operator()' или тела лямбды можно воспользоваться специфичными для платформы/компилятора макросами. Так, компилятор MSVC предоставляет следующие три макроса:
Для компиляторов Clang и GCC доступны следующие макросы:
Анализатор обнаружил подозрительный код, инициализирующий генератор псевдослучайных чисел константным значением.
// C
srand(0);
// C++
std::mt19937 engine(1);Числа, сгенерированные таким генератором, можно предугадать, либо же они будут воспроизводиться снова и снова при каждом запуске программы.
Чтобы этого избежать, стоит использовать какое-либо случайное число. К примеру, можно воспользоваться текущим системным временем:
srand(time(0));Но такой подход может вызвать проблемы в многопоточных программах – 'time(0)' может вернуть одинаковые значения в разных потоках. Также стоит учесть, что время может меняться пользователем.
Начиная с C++11, можно воспользоваться генератором 'std::random_device', реализующим интерфейс к генератору истинно случайных чисел:
std::random_device rd;
std::mt19937 engine(rd());Однако если таковой в системе отсутствует, то будет использован обычный генератор псевдослучайных чисел.
Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки некорректного использования системных процедур и интерфейсов, связанных с обеспечением информационной безопасности (шифрования, разграничения доступа и пр.). |
Диагностическое правило классифицируется как:
|
Анализатор обнаружил подозрительное сравнение адресов двух функций.
Пример:
namespace MyNamespace
{
int one() noexcept;
int two() noexcept;
}
using namespace MyNamespace;
void SomeFunction()
{
if (one != two)
{
// do something
}
....
}Сравнение в данном случае всегда вернет 'true', так как 'one' и 'two' – имена функций с совместимыми сигнатурами, объявленных в пространстве имен 'MyNamespace'. Вероятно, что в этом случае предполагалось сравнение возвращаемых значений, но автор кода забыл добавить к именам функций круглые скобки:
namespace MyNamespace
{
int one() noexcept;
int two() noexcept;
}
using namespace MyNamespace;
void SomeFunction()
{
if (one() != two())
{
// do something
}
}Также подобный код может быть результатом неудачного рефакторинга. Если внутри функции сравнивались локальные переменные, которые в какой-то момент были удалены из кода, при этом само условие сохранилось, то вполне возможно, что будет происходить сравнение функций с такими же именами.
Пример кода до рефакторинга:
namespace MyNamespace
{
int one() noexcept;
int two() noexcept;
}
using namespace MyNamespace;
void SomeFunction(int one, int two)
{
if (one != two)
{
// do something
}
}Диагностическое правило классифицируется как:
|
Анализатор обнаружил макрос, имя которого перекрывает ключевое слово или зарезервированный стандартом идентификатор.
Пример:
#define sprintf std::printfЗдесь из-за коллизии имен вызовы стандартной функции 'sprintf' после препроцессирования заменятся на вызовы 'printf'. Такая замена приведет к некорректной работе программы.
Диагностика также сообщает об удалении предопределенных макросов.
Пример:
#undef assertДиагностика игнорирует переопределения ключевых слов, если они идентичны с точки зрения семантики.
Примеры:
#define inline __inline
#define inline __forceinline
#define template extern templateДиагностическое правило классифицируется как:
|
Анализатор обнаружил передачу строки типа 'BSTR' в функцию 'SysAllocString'.
BSTR FirstBstr = ....;
BSTR SecondBstr = SysAllocString(FirstBstr);Если необходимо скопировать 'BSTR' строку, то ее передача в функцию 'SysAllocString' может привести к логической ошибке.
BSTR (basic string или binary string) – это строковый тип данных, который используется в COM, Automation и Interop функциях. Представление BSTR:
Тип BSTR является указателем, который указывает на первый символ строки, а не на префикс длины.
Функция 'SysAllocString' работает с 'BSTR' строкой также, как с обычной широкой C-строкой. Это значит, что если строка содержит множественные вложенные нулевые символы, то 'SysAllocString' создаст урезанную строку. Избежать непредвиденного поведения можно, переписав код, используя классы-обёртки над 'BSTR', такие как 'CComBSTR' или '_bstr_t'.
Например, правильно скопировать одну 'BSTR' строку в другую можно так:
CComBstr firstBstr(L"I am a happy BSTR.");
BSTR secoundBstr = firstBstr.Copy();или так:
_bstr_t firstBstr(L"I am a happy BSTR too.");
BSTR secoundBstr = firstBstr.copy();Анализатор обнаружил расширение пространства имён 'std' или 'posix'. Несмотря на то, что такая программа успешно компилируется и исполняется, модификация данных пространств имён может привести к неопределённому поведению программы, если иное не указано стандартом.
Содержимое пространства имен 'std' определяется исключительно комитетом стандартизации, и стандарт запрещает добавлять в него:
Стандарт разрешает добавлять следующие специализации шаблонов, определенных в пространстве имен 'std', если они зависят хотя бы от одного определенного в программе типа (program-defined type):
Однако, специализации шаблонов, лежащих внутри классов или шаблонов классов, запрещены.
Наиболее частым вариантом, когда пользователь расширяет пространство имен 'std', является добавление своей перегрузки функции 'std::swap' и полной/частичной специализации шаблона класса 'std::hash'.
Рассмотрим фрагмент кода с добавлением перегрузки 'std::swap':
template <typename T>
class MyTemplateClass
{
....
};
class MyClass
{
....
};
namespace std
{
template <typename T>
void swap(MyTemplateClass<T> &a, MyTemplateClass<T> &b) noexcept // UB
{
....
}
template <>
void swap(MyClass &a, MyClass &b) noexcept // UB since C++20
{
....
};
}Первый шаблон функции не является специализацией 'std::swap', и такая декларация ведет к неопределенному поведению. Второй шаблон функции является специализацией, и до C++20 поведение программы определено. Однако, в данном случае можно поступить иначе: можно вынести обе функции из пространства имен 'std' и поместить их в то пространство имен, где определены классы:
template <typename T>
class MyTemplateClass
{
....
};
class MyClass
{
....
};
template <typename T>
void swap(MyTemplateClass<T> &a, MyTemplateClass<T> &b) noexcept
{
....
}
void swap(MyClass &a, MyClass &b) noexcept
{
....
};Теперь, когда необходимо написать шаблон функции, который применяет функцию swap для двух объектов типа T, можно написать следующий код:
template <typename T>
void MyFunction(T& obj1, T& obj2)
{
using std::swap; // make std::swap visible for overload resolution
....
swap(obj1, obj2); // best match of 'swap' for objects of type T
....
}Теперь, компилятор выберет нужную перегрузку функции на основе поиска с учетом аргументов (argument-dependent lookup, ADL) – пользовательские функции 'swap' для класса 'MyClass' и для шаблона класса 'MyTemplateClass' и стандартную версию 'std::swap' для остальных типов.
Разберем следующий пример со специализацией шаблона класса 'std::hash':
namespace Foo
{
class Bar
{
....
};
}
namespace std
{
template <>
struct hash<Foo::Bar>
{
size_t operator()(const Foo::Bar &) const noexcept;
};
}С точки зрения стандарта этот код является валидным, и анализатор в этой ситуации не выдает предупреждение. Однако, начиная с C++11, можно и в этом случае поступить иначе, написав специализацию шаблона класса за пределами пространства имен 'std':
template <>
struct std::hash<Foo::Bar>
{
size_t operator()(const Foo::Bar &) const noexcept;
};В отличие от пространства имен 'std', стандарт C++ запрещает абсолютно любую модификацию пространства имён 'posix':
namespace posix
{
int x; // UB
}Дополнительная информация:
Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1061. |
Это диагностическое правило основано на пункте R.15 CppCoreGuidelines.
В классе определен оператор 'new' или 'delete', но при этом не определен обратный оператор.
Пример:
class SomeClass
{
....
void* operator new(size_t s);
....
};Для динамической аллокации объекта такого класса будет использоваться перегруженный оператор 'new', а для удаления – оператор 'delete', определенный по умолчанию.
Для симметрии операций аллокации/деаллокации следует определить также оператор 'delete':
class SomeClass
{
....
void* operator new(size_t s);
void operator delete(void*);
....
};Также операторы можно пометить как удаленные ('= delete'), если по какой-то причине необходимо запретить аллокацию или деаллокацию для объектов класса. При этом желательно одновременно запретить и аллокацию и деаллокацию, чтобы вызов любого из этих операторов приводил к ошибке времени компиляции, а не к трудно уловимому багу:
#include <cstddef>
class AutoTransaction
{
public:
/// Mark 'operator new' as deleted to prevent heap allocation
void* operator new (std::size_t) = delete;
};
void foo()
{
auto ptr = new AutoTransaction; // code doesn't compile
}
void bar()
{
AutoTransaction obj;
delete &obj; // code compiles, but contains an error
}Если также запретить деаллокацию, то компилятор не позволит совершить ошибку:
class SomeClass
{
....
void* operator new(size_t s) = delete;
void operator delete(void*) = delete;
....
};
void foo()
{
auto ptr = new AutoTransaction; // code doesn't compile
}
void bar()
{
AutoTransaction obj;
delete &obj; // code doesn't compile
}Выявляемые диагностикой ошибки классифицируются согласно ГОСТ Р 71207–2024 как критические и относятся к типу: Ошибки управления динамической памятью (выделения, освобождения, использования освобожденной памяти) [* см. примечание касательно языков C#, Java]. |
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1062. |
Анализатор обнаружил странное выражение, в котором производится деление по модулю 1. Результатом такого выражения всегда будет 0.
Частым паттерном данной ошибки является проверка делимости числа на что-то без остатка. Для этого необходимо поделить число по модулю и сравнить результат с 0 или 1. В этом месте легко сделать опечатку, так как раз ожидается значение 1, то кажется, что и поделить надо на 1. Пример:
if (x % 1 == 1)
{
....
}Здесь переменную 'x' поделили по модулю '1', и теперь вне зависимости от значения 'x' выражение 'x % 1' всегда будет равно 0. Следовательно, условие всегда будет ложным. Наиболее вероятно, что переменную 'x' следовало поделить по модулю '2':
if (x % 2 == 1)
{
....
}Рассмотрим пример из реального проекта (stickies):
void init (....)
{
srand(GetTickCount() + rand());
updateFreq1 = (rand() % 1) + 1;
updateFreq2 = (rand() % 1) + 1;
updateFreq3 = (rand() % 1) + 1;
updateFreq4 = (rand() % 1) + 1;
waveFreq1 = (rand() % 15);
waveFreq2 = (rand() % 3);
waveFreq3 = (rand() % 16);
waveFreq4 = (rand() % 4);
// ....
}Здесь переменные 'updateFreq1', 'updateFreq2', 'updateFreq3' и 'updateFreq4' будут всегда инициализированы значением 1. Возможно, что каждая переменная вероятно должна была быть проинициализирована каким-то псевдослучайным числом. И скорее всего, это [1..2]. Тогда корректный код должен быть таким:
updateFreq1 = (rand() % 2) + 1;
updateFreq2 = (rand() % 2) + 1;
updateFreq3 = (rand() % 2) + 1;
updateFreq4 = (rand() % 2) + 1;Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1063. |
Анализатор обнаружил подозрительное выражение, в котором производится целочисленное деление, при котором левый операнд всегда меньше правого. Результат такого выражения всегда будет равен нулю.
Давайте рассмотрим пример:
if ( nTotal > 30 && pBadSource->m_nNegativeVotes / nTotal > 2/3 )
{
....
}Так как литералы '2' и '3' имеют целочисленный тип, результат их деления тоже будет целочисленным и, соответственно, равен нулю. А значит, данное условие эквивалентно следующему:
if ( nTotal > 30 && pBadSource->m_nNegativeVotes / nTotal > 0 )
{
....
}Правильным в данной ситуации будет явно привести один из операндов к типу с плавающей точкой. Примеры исправленного кода:
if ( nTotal > 30 && pBadSource->m_nNegativeVotes / nTotal >
static_cast<float>(2)/3 )
{
....
}Или:
if ( nTotal > 30 && pBadSource->m_nNegativeVotes / nTotal > 2.0f/3 )
{
....
}Также анализатор выдаст предупреждение, если он обнаружил подозрительное выражение, в котором производится взятие остатка по модулю, при котором делимое всегда меньше делителя. Результат такого выражения всегда будет равен значению делимого.
Давайте рассмотрим пример:
void foo()
{
unsigned int r = 12;
const unsigned int r3a = (16 + 5 - r) % 16;
}Здесь выражение '16+5-r' будет равно 9. Это значение меньше делителя '16'. Поэтому взятие остатка по модулю в данном случае не имеет смысла, результатом будет 9.
Рассмотрим более сложный пример:
int get_a(bool cond)
{
return cond ? 3 : 5;
}
int get_b(bool cond)
{
return cond ? 7 : 9;
}
int calc(bool cond1, bool cond2)
{
return get_a(cond1) % get_b(cond2);
}В функции 'calc' производится взятие остатка по модулю. Делимое принимает значения 3 или 5. Делитель принимает значения 7 или 9. Получаем четыре варианта вычислений операции взятия остатка по модулю: '3 % 7', '5 % 7', '3 % 9', '5 % 9'. В каждом из вариантов делимое меньше делителя. Значит, операция бессмысленна.
Если анализатор выдал предупреждение на вашем коде, рекомендуем изучить этот фрагмент кода на наличие логических ошибок. Возможно, вычисление одного из операндов взятия остатка по модулю происходит не так, как ожидалось. Также может быть, что вместо операции взятия остатка по модулю нужно использовать другую операцию.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1064. |
Анализатор обнаружил подозрительное выражение, в котором операнды могут быть сокращены. Это может свидетельствовать о наличии в коде логической ошибки или опечатки.
Рассмотрим простой синтетический пример:
void Foo(int A, int B, int C)
{
if (A - A + 1 < C)
Go(A, B);
}Из-за опечатки получилось избыточное выражение, которое можно сократить до '1 < C'. На самом деле, планировалось написать, например, так:
void Foo(int A, int B, int C)
{
if (A - B + 1 < C)
Go(A, B);
}В других случаях могут быть выявлены выражения, которые, хотя и не содержат ошибку, будет полезно упростить. Это может сделать выражения более простыми и понятными. Пример:
if ((rec.winDim.left + (rec.winDim.right - rec.winDim.left)) < inset) // <=
{
rec.winDim.left = -((rec.winDim.right – rec.winDim.left) - inset);
rec.winDim.right = inset;
}
if ((rec.winDim.top + (rec.winDim.bottom – rec.winDim.top)) < inset) // <=
{
rec.winDim.top = -((rec.winDim.bottom – rec.winDim.top) - inset);
rec.winDim.bottom = inset;
}В обоих условиях выражения могут быть упрощены путем устранения операндов 'rec.winDim.left' и 'rec.winDim.top' соответственно. Сокращённый вариант кода:
if (rec.winDim.right < inset)
{
rec.winDim.left = -((rec.winDim.right – rec.winDim.left) - inset);
rec.winDim.right = inset;
}
if (rec.winDim.bottom < inset)
{
rec.winDim.top = -((rec.winDim.bottom – rec.winDim.top) - inset);
rec.winDim.bottom = inset;
}Примечание. Иногда избыточность вовсе не уменьшает, а увеличивает читабельность кода. Например, избыточность может нести поясняющий смысл в математических формулах. В этом случае есть смысл не сокращать выражение, а использовать один из механизмов подавления ложных срабатываний.
Диагностическое правило классифицируется как:
Взгляните на примеры ошибок, обнаруженных с помощью диагностики V1065. |
Анализатор обнаружил вызов функции 'SysFreeString' для объекта, тип которого отличен от 'BSTR'.
Функция 'SysFreeString' предназначена только для работы с типом 'BSTR'. Нарушение этого условия может привести к проблемам с освобождением памяти.
Рассмотрим простой синтетический пример:
#include <atlbase.h>
void foo()
{
CComBSTR str { L"I'll be killed twice" };
// ....
SysFreeString(str); //+V1066
}Здесь в функцию 'SysFreeString' передаётся объект типа 'CComBSTR'. Этот класс является обёрткой над типом 'BSTR' и имеет перегруженный оператор неявного преобразования 'operator BSTR()', который возвращает указатель на обёрнутую BSTR-строку. Поэтому приведённый выше код скомпилируется без предупреждений.
Однако, этот код содержит ошибку. После того, как функция 'SysFreeString' освободит ресурс, принадлежащий объекту 'str', произойдет выход из области видимости, и будет вызван деструктор объекта 'str'. Деструктор произведёт повторное освобождение уже освобождённого ресурса, что приведет к неопределённому поведению.
Иногда подобное поведение может случиться даже при передаче в 'SysFreeString' именно объекта типа 'BSTR'. Например, PVS-Studio также выдаст предупреждение на такой код:
#include <atlbase.h>
void foo()
{
CComBSTR str = { L"a string" };
BSTR bstr = str;
str.Empty();
SysFreeString(bstr); //+V1066
}Так как 'CComBSTR::operator BSTR()' возвращает указатель на собственное поле, после присвоения 'BSTR bstr = str;' оба объекта будут владеть одним и тем же ресурсом. Вызов метода 'str.Empty();' освободит этот ресурс, а 'SysFreeString(bstr)' попытается освободить уже освобождённый ресурс.
Одним из способов избежать общего владения ресурсом является создание копии или использование метода 'CComBSTR::Detach()'. Например, анализатор не будет выдавать предупреждение на следующий код:
#include <atlbase.h>
void foo()
{
CComBSTR ccombstr = { L"I am a happy CComBSTR" };
BSTR bstr1 = ccombstr.Copy();
SysFreeString(bstr1); // OK
BSTR bstr2;
ccombstr.CopyTo(&bstr2);
SysFreeString(bstr2); // OK
BSTR bstr3 = ccombstr.Detach();
SysFreeString(bstr3); // OK
}Диагностическое правило классифицируется как:
|
Анализатор обнаружил конструктор исключения, из которого может быть брошено другое исключение. Использование такого класса может привести к неожиданному поведению программы при обработке исключений.
Рассмотрим синтетический пример:
#include <stdexcept>
class divide_by_zero_error : public std::invalid_argument
{
public:
divide_by_zero_error() : std::invalid_argument("divide_by_zero")
{
....
if (....)
{
throw std::runtime_error("oops!"); // <=
}
}
};
void example(int a, int b)
{
try
{
if (b == 0)
throw divide_by_zero_error ();
....
}
catch (const divide_by_zero_error &e)
{
....
}
// my_exception thrown and unhandled
}В коде функции 'example' программист пытается обработать возникшее исключение 'divide_by_zero_error', однако вместо этого будет сформировано исключение 'std::runtime_error' и не перехвачено последующим 'catch'-блоком. Это приведет к тому, что исключение покинет функцию 'example', что может привести к следующим ситуациям:
При разработке и использовании собственных классов исключений нужно проявлять особую бдительность, поскольку исключения в их конструкторах могут возникнуть в неожиданных местах, например при вызове других функций. В следующем примере при создании логирующего исключения может возникнуть второе исключение из функции 'Log':
#include <ios>
static void Log(const std::string& message)
{
....
// std::ios_base::failure may be thrown by stream operations
throw std::ios_base::failure("log file failure");
}
class my_logging_exception : public std::exception
{
public:
explicit my_logging_exception(const std::string& message)
{
Log(message); // <=
}
};Диагностическое правило классифицируется как:
Анализатор обнаружил анонимное пространство имен, объявленное в заголовочном файле. Такой заголовочный файл создаёт копии символов с "внутренним связыванием" (internal linkage) в каждой единице трансляции, включающей этот заголовочный файл. Это приводит к "раздуванию" объектных файлов, что может быть нежелательным поведением.
Рассмотрим простой пример заголовочного файла с анонимным пространством имен:
// utils.hpp
#pragma once
#include <iostream>
namespace
{
int global_variable;
void set_global_variable(int v)
{
std::cout << global_variable << std::endl;
global_variable = v;
}
}Каждая единица трансляции при включении заголовочного файла 'utils.hpp' получит свой экземпляр переменной 'global_variable', не связанной с другими экземплярами и не доступной из других единиц трансляции. Также будет сгенерировано несколько избыточных функций 'set_global_variable'. До стандарта C++17 такой код мог встречаться в header-only библиотеках для того, чтобы не нарушать One Definition Rule при включении заголовочных файлов в несколько единиц трансляции. Также подобный код может появиться из-за неаккуратного рефакторинга, например, при переносе анонимного пространства имен из компилируемого файла в заголовочный файл.
Стоит отметить, что данное правило распространяется и на безымянные пространства имен, вложенные в другие пространства имен:
namespace my_namespace
{
int variable1; // namespace-scope non-const variable
// 'variable1' has external linkage
namespace // <=
{
int variable2; // unnamed namespace applies 'static'
// 'variable2' has internal linkage
}
}Если необходимо создать ровно один экземпляр символа для header-only библиотеки, то можно воспользоваться спецификатором 'inline' (начиная с C++17, действует и для переменных):
// utils.hpp
#pragma once
#include <iostream>
inline int global_variable; // ok since C++17
inline void set_global_variable(int v)
{
std::cout << global_variable << std::endl;
global_variable = v;
}Если используется более ранняя версия стандарта, но библиотека не header-only, то можно объявить символы как 'extern' в заголовочном файле и определить их в одном из юнитов трансляции:
// utils.hpp
#pragma once
extern int global_variable;
void set_global_variable(int v); // functions implicitly
// have external linkage ('extern')// utils.cpp
#include "utils.hpp"
#include <iostream>
int global_variable;
void set_global_variable(int v)
{
std::cout << global_variable << std::endl;
global_variable = v;
}В том случае, когда используется более старая версия стандарта, но библиотека должна быть header-only, срабатывание можно подавить комментарием:
// utils.hpp
#pragma once
#include <iostream>
namespace //-V1068
{
int global_variable;
void set_global_variable(int v)
{
std::cout << global_variable << std::endl;
global_variable = v;
}
}Диагностическое правило классифицируется как:
|
Взгляните на примеры ошибок, обнаруженных с помощью д |